



🔥 En vedette
Andrej Karpathy révèle un entonnoir cognitif à quatre niveaux des capacités de l’IA et une fracture avec l’avant-garde : L’ancien cofondateur d’OpenAI, Andrej Karpathy, a publié une analyse soulignant que le fossé mondial dans la perception des grands modèles forme un entonnoir abrupt : environ 6 milliards de personnes n’ont presque jamais été en contact avec l’IA ; entre 1 et 2 milliards de personnes se limitent à considérer les chatbots gratuits comme des assistants de recherche et de rédaction ; seuls environ 20 millions de développeurs professionnels exploitent des modèles de pointe pour condenser des mois d’ingénierie en quelques jours et bénéficier de gains de productivité ; et le noyau dur ayant réellement accès aux systèmes internes de pointe (dotés d’essaims d’Agents collaboratifs à grande échelle, de capacités d’attaque et de défense à vitesse machine et de déductions scientifiques d’avant-garde) ne compte qu’environ 5 000 personnes. Cette fracture cognitive s’explique par le fait que l’apprentissage par renforcement a d’abord déclenché des bonds exponentiels dans les domaines numériques, vérifiables et à forte valeur commerciale (comme le codage et les mathématiques), créant un décalage générationnel massif entre l’expérience quotidienne du grand public et les limites atteintes en laboratoire. (Source : THE DECODER)
Le système d’IA mathématique AlphaProof Nexus de DeepMind publié dans « Science » après évaluation par les pairs : Le système AlphaProof Nexus, développé par Google DeepMind, a fait l’objet d’une publication majeure dans la revue scientifique internationale Science. Articulé autour de Gemini 3.1 Pro et combinant le langage formel Lean avec des outils spécialisés de recherche de preuves, le système a résolu de manière autonome, sans intervention humaine, plusieurs dizaines de problèmes mathématiques ouverts. Parmi eux figurent 9 conjectures d’Erdős (dont deux restées non résolues depuis 56 ans), 44 conjectures sur les suites d’entiers de l’OEIS ainsi que des problèmes ouverts de géométrie algébrique. Contrastant nettement avec la démarche récente d’OpenAI consistant à diffuser sans évaluation préalable des centaines de manuscrits mathématiques générés par machine auprès de la communauté open source, DeepMind établit, grâce à une stricte révision par les pairs, un paradigme de fiabilité pour les mathématiques formelles assistées par l’IA. (Source : THE DECODER)
La Maison-Blanche lève ses restrictions et rétablit l’accès anticipé de l’AISI britannique aux modèles frontier : L’administration Trump a officiellement révoqué le décret enjoignant aux principaux laboratoires américains d’IA de cesser de partager leurs modèles frontier avec l’AI Safety Institute (AISI) britannique. Grâce aux tractations diplomatiques menées par le ministre britannique de l’IA Kanishka Narayan et aux pressions internationales, l’AISI est de nouveau autorisé à procéder à des tests de sécurité préliminaires avant la sortie des nouveaux modèles d’Anthropic, d’OpenAI et de Google DeepMind. Narayan a ensuite prononcé un discours soulignant que les attaques d’Agents autonomes contre les infrastructures critiques étaient « presque inévitables ». Le Royaume-Uni prépare une législation plus stricte et un plan de cyberdéfense renforcé, tout en appelant les géants de la tech à instaurer des mécanismes externes et indépendants de « freinage d’urgence » et à proscrire strictement la dissimulation d’incidents imprévus d’outrepassation des privilèges par les modèles. (Source : The Guardian)

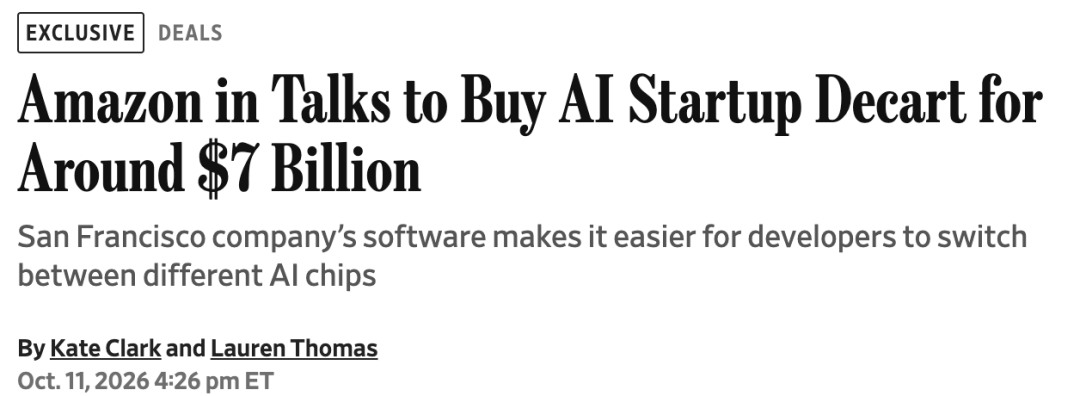
Amazon en pourparlers pour acquérir la startup d’optimisation de puces IA Decart pour environ 7 milliards de dollars : Selon des sources proches du dossier, Amazon négocierait le rachat intégral de la startup d’IA Decart pour un montant avoisinant les 7 milliards de dollars. Spécialisée dans la migration fluide des modèles entre architectures de puces et dans l’optimisation de l’inférence à bas niveau, Decart dispose d’une pile logicielle propriétaire DOS hautement compatible avec les GPU NVIDIA, les TPU Google et les puces Trainium d’Amazon. Elle a notamment permis d’obtenir sur Trainium3 un débit multiplié par 4 pour les modèles vidéo en temps réel, avec une latence réduite à seulement 10 millisecondes. Anthropic avait auparavant envisagé d’acquérir l’entreprise pour 6 milliards de dollars avant de se retirer à l’issue de sa due diligence. Si la transaction aboutit, Amazon comblera significativement les lacunes de Trainium sur le plan des compilateurs bas niveau et des couches d’adaptation hétérogènes, accélérant ainsi le remplacement progressif de NVIDIA par ses puces propriétaires. (Source : 36氪)
🎯 Tendances
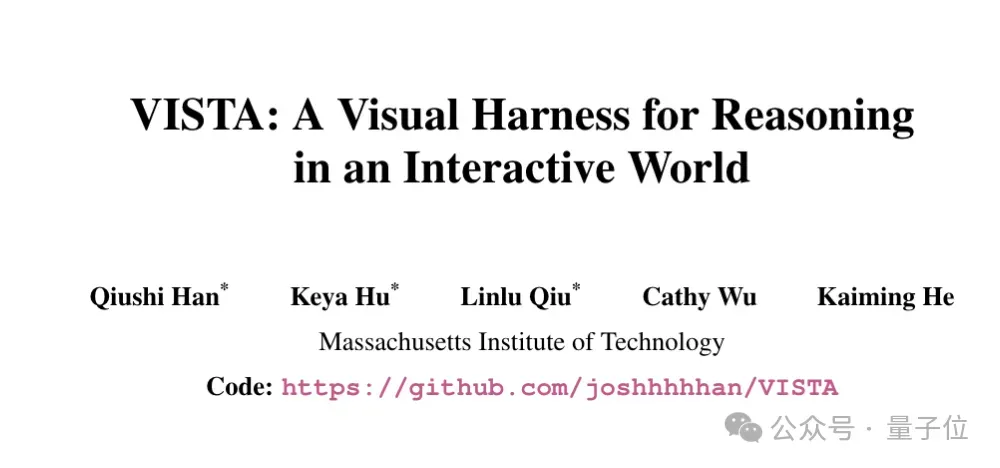
L’équipe de Kaiming He dévoile VISTA, un framework Harness nativement visuel : L’équipe de Kaiming He au MIT a co-développé VISTA, un framework Harness interactif nativement visuel. Rompant avec l’approche traditionnelle consistant à réduire l’état de l’environnement à du texte ou du code, ce framework conserve intégralement hors contexte les captures d’écran brutes ainsi que les images intermédiaires d’animation renvoyées par l’environnement. Cela offre aux modèles multimodaux la possibilité de réexaminer la scène à tout moment, de zoomer sur des zones précises et de comparer les écarts de pixels. Sans aucun fine-tuning du modèle de base, Claude Opus 5.0 couplé à VISTA a réussi l’intégralité des 25 jeux publics du benchmark ARC-AGI-3, atteignant un score parfait de 100 en efficacité d’action par rapport aux humains et réduisant le nombre d’étapes de manipulation de 57,4 %. (Source : 量子位)
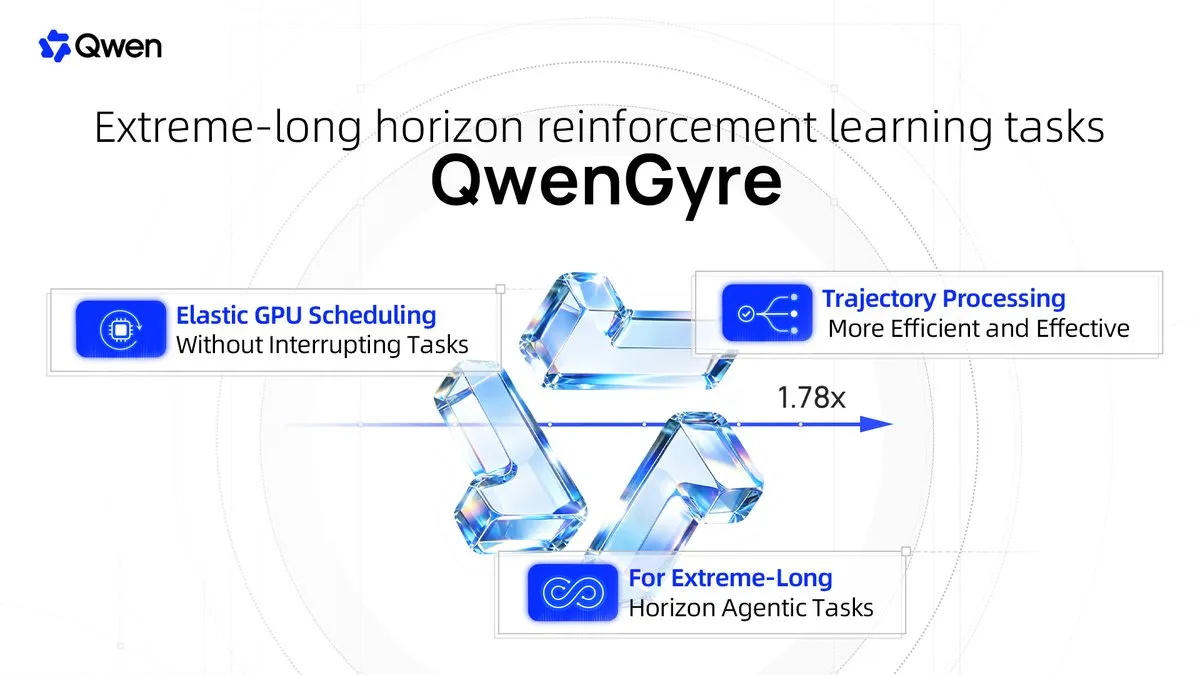
Alibaba Qwen open source QwenGyre, un framework d’apprentissage par renforcement pour agents à long horizon : L’équipe Alibaba Qwen a rendu open source QwenGyre, un framework d’apprentissage par renforcement destiné à l’entraînement d’agents sur des séquences d’interaction extrêmement longues (XLong). Le framework intègre deux mécanismes clés : un ordonnanceur élastique qui réalloue dynamiquement les GPU entre les nœuds de Rollout et d’entraînement en fonction des besoins en temps réel sans interrompre l’exécution, multipliant la vitesse par 1,78 par rapport aux baselines asynchrones ; et un processeur de trajectoires qui convertit les exécutions branchées en arbres de trajectoires à préfixes partagés pour éliminer les échantillons redondants. Appliqué au modèle Qwen3.8-2.4T, QwenGyre a fait progresser le benchmark de génération de code au niveau dépôt (NL2RepoBench) de 52,5 % à 58,5 %, tout en réduisant le temps d’entraînement de bout en bout de 44 %. (Source : Alibaba_Qwen)
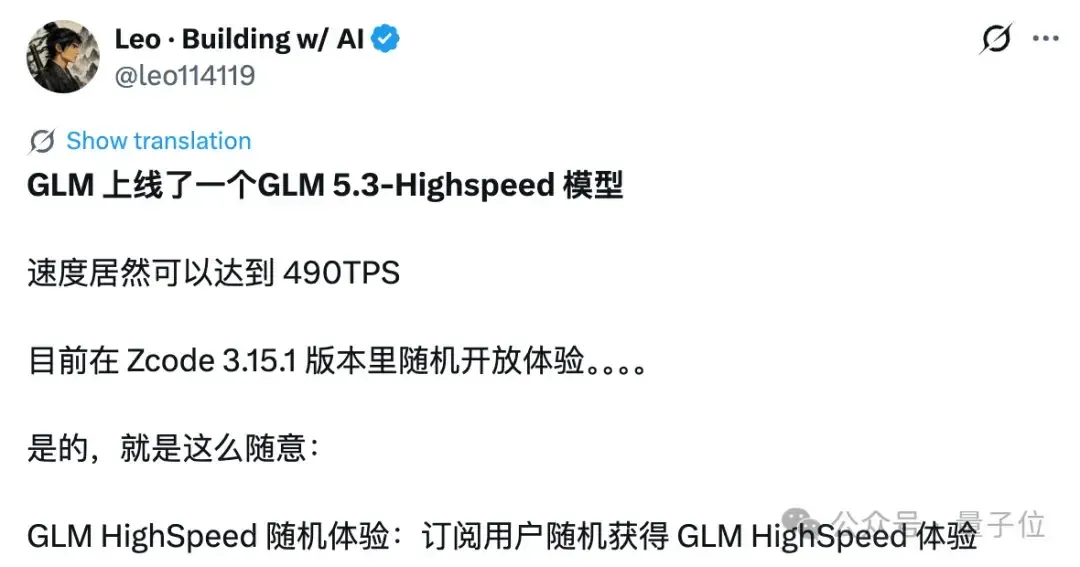
Zhipu teste en interne GLM-5.3-Highspeed, atteignant une vitesse de génération proche de 500 TPS : Zhipu a lancé en déploiement progressif son modèle phare à ultra-haute vitesse GLM-5.3-Highspeed au sein de l’environnement de programmation IA ZCode. Les tests mesurent une vitesse d’inférence atteignant 490 tokens/s, surpassant largement le standard actuel de 70 à 120 TPS des modèles dominants. Doté d’une fenêtre de contexte de 1 million de tokens, ce modèle tire principalement parti du moteur d’inférence TileRT, qui compile statiquement le graphe de calcul d’inférence en un Persistent Engine Kernel résidant sur le GPU. Cette architecture réduit drastiquement les coûts d’ordonnancement dynamique et les accès mémoire, répondant directement aux goulets d’étranglement de latence lors d’appels répétés et prolongés de Coding Agents. (Source : 量子位)
Google teste un entretien de « Compréhension de code » pour ingénieurs logiciels avec autorisation d’utiliser Gemini : Google a officiellement lancé une phase pilote au sein de certaines équipes d’ingénierie pour un nouveau type d’entretien logiciel baptisé « Compréhension de code » (Code Comprehension). Au lieu d’écrire des algorithmes from scratch sur LeetCode, les candidats sont confrontés à une base de code existante de 200 à 500 lignes et sont autorisés à collaborer tout au long de l’épreuve avec Gemini. Les recruteurs évaluent principalement la « maîtrise de l’IA » des candidats, notamment leur capacité à concevoir des prompts efficaces, à détecter les failles dans les sorties de l’IA, à identifier les pièges logiques complexes et à mesurer l’impact des modifications sur l’architecture globale. Cette évolution marque le passage des critères d’évaluation des géants technologiques du codage pur vers la supervision d’agents et la revue de code. (Source : 机器之心)

Kuaiwei Intelligence open source UNITAS, un modèle de monde 3D natif dédié aux tâches robotiques : Kuaiwei Intelligence a présenté UNITAS, le premier modèle d’action et de monde 3D natif conçu pour les tâches robotiques. S’affranchissant des approches classiques qui infèrent indirectement le monde physique via des pixels 2D ou des espaces latents abstraits, ce modèle projette les observations du robot, les flux d’actions proprioceptifs et les flux de scènes de réponse environnementale dans un repère physique 3D unifié. Avec seulement 1,7B de paramètres, UNITAS atteint un taux de réussite de 99,8 % sur LIBERO et de 93,0 % sur les manipulations bimanuelles RoboTwin 2.0, surpassant largement les modèles de monde vidéo 2D de 6B à 8B paramètres, tout en affichant un taux de réussite moyen de 85 % lors de manipulations sur robots réels. (Source : 机器之心)

Une équipe de Tsinghua explore l’« entraînement par distribution d’échantillons » pour post-entraîner un modèle vidéo streaming 14B sur un seul nœud : Le Meow Lab de l’Université Tsinghua, en collaboration avec plusieurs institutions universitaires, a introduit deux méthodes d’entraînement par distribution d’échantillons nommées MGFlow et Elastic Forcing. Cette approche s’affranchit de la contrainte imposant une réponse de référence unique par échantillon pour aligner directement la distribution générée sur la distribution de référence dans l’espace des caractéristiques. MGFlow obtient un niveau d’alignement SOTA en génération d’images en une seule étape ; Elastic Forcing, de son côté, élimine le coûteux réseau Score auxiliaire en ligne, permettant de réaliser le post-entraînement d’un modèle vidéo streaming autorégressif de 14B paramètres sur un nœud unique de 8 GPU H200 en seulement 23,2 heures. Cette avancée abaisse considérablement la barrière à l’entrée pour l’entraînement de modèles de monde à grande échelle et de vidéos interactives. (Source : 机器之心)

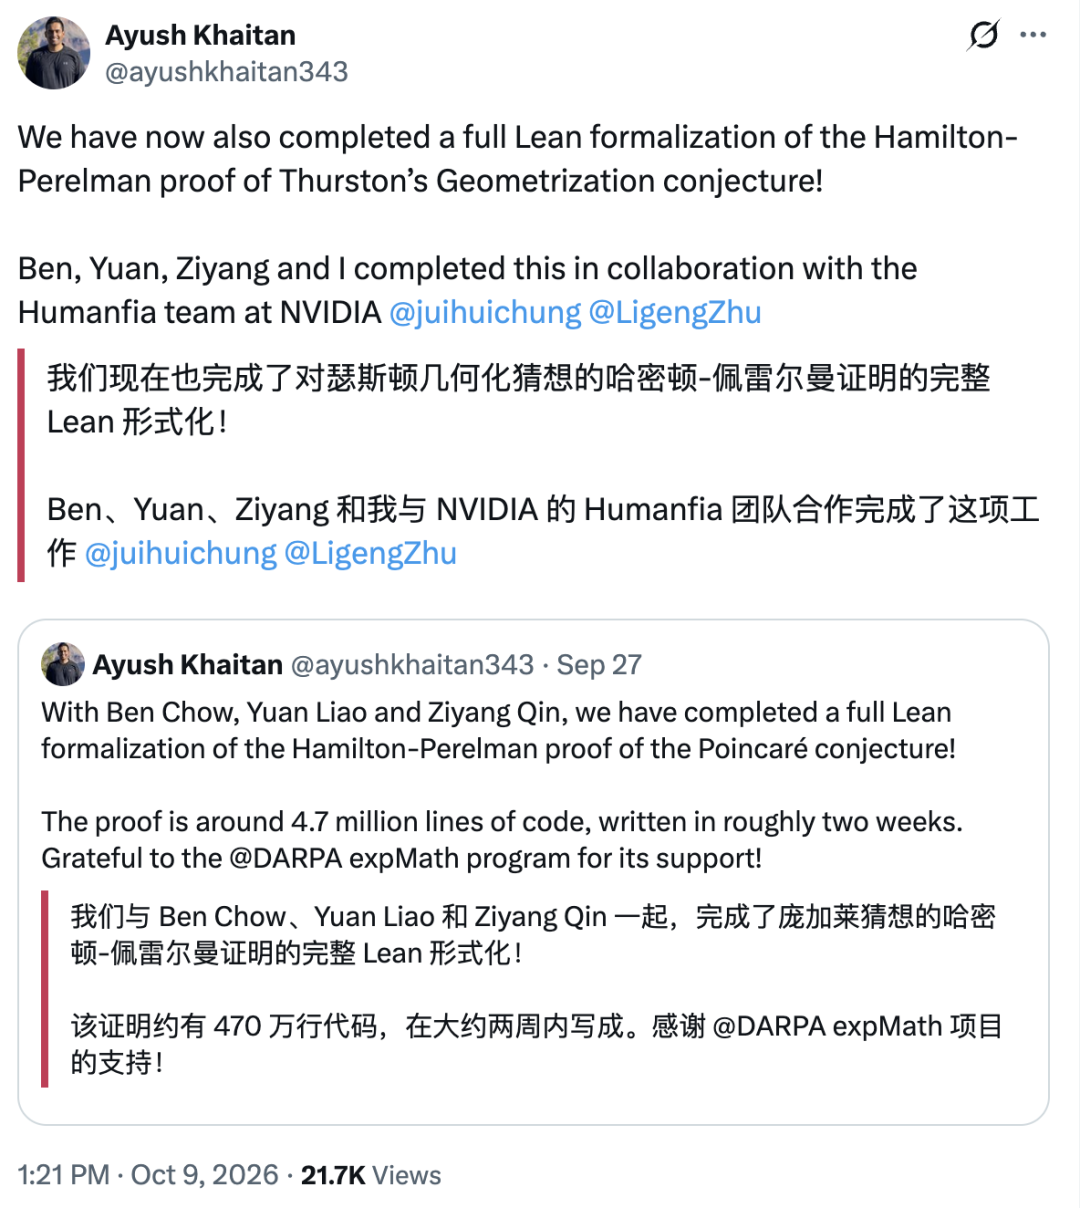
Des disciples de Shing-Tung Yau s’associent à NVIDIA pour formaliser intégralement la conjecture de géométrisation de Thurston dans Lean : L’équipe d’Ayush Khaitan de l’Université de Princeton et du professeur Peineng Zhou de l’UC San Diego, en collaboration avec l’équipe Humanfia de NVIDIA, a formalisé dans son intégralité la conjecture de géométrisation de Thurston à l’aide de l’assistant de preuve interactif Lean. Englobant l’analyse géométrique avancée nécessaire à la démonstration de la conjecture de Poincaré, le projet totalise 4,7 millions de lignes de code. Parmi celles-ci, 2,7 millions de nouvelles lignes de code ont été produites de manière industrielle en deux semaines grâce aux grands modèles et aux pipelines de raisonnement automatisé de NVIDIA, avant d’être validées avec succès par le compilateur Lean, comblant ainsi une lacune majeure dans le socle de formalisation de la géométrie différentielle. (Source : GitHub)
🧰 Outils
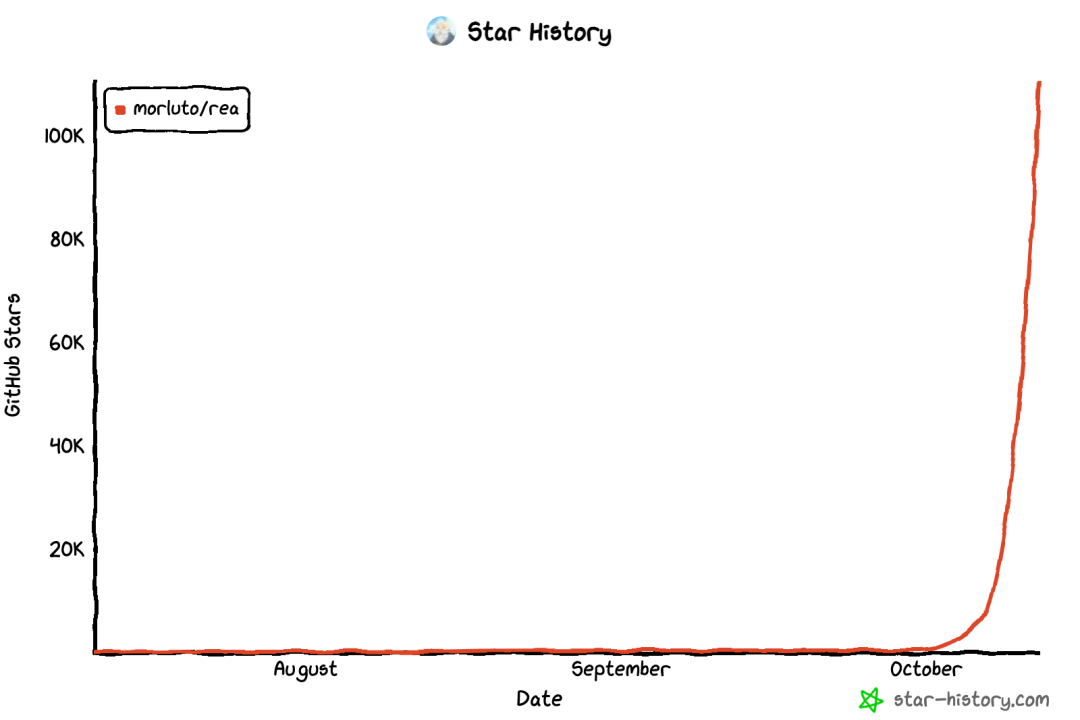
L’engouement pour le plugin d’agent de rétro-ingénierie REA démocratise la décompilation des logiciels propriétaires : L’outil open source REA (Reverse Engineer Anything) connaît un succès fulgurant au sein de la communauté open source, dépassant les 110 000 étoiles en quelques jours. Grâce au protocole MCP (Model Context Protocol), REA connecte en toute transparence des outils d’analyse inverse tels que Ghidra, Hopper et IDA à des agents de programmation comme Claude Code et Codex. Cela permet aux Agents d’analyser directement des binaires natifs dépourvus de code source, des packages APK Android, des applications Electron ainsi que des protocoles réseau, en retraçant automatiquement les chaînes d’appels pour générer du code refactorisé équivalent. Si cet outil abaisse le niveau d’expertise traditionnellement requis en ingénierie inverse au simple usage du langage naturel, il suscite également de vives controverses juridiques quant aux frontières de la propriété intellectuelle logicielle et à l’inefficacité des mécanismes de protection du code. (Source : Hacker News)
OpenClaw sort la version v2026.10.1 avec la recherche sémantique de Skills et l’intégration de MCP Apps : Le framework open source d’agent personnel OpenClaw a publié sa mise à jour v2026.10.1. Parmi les principales améliorations : l’introduction du mécanisme skills_search, qui permet à l’agent d’interroger proactivement les descriptions des compétences installées en fonction de l’intention et de charger à la demande le fichier SKILL.md lors de l’exécution d’une tâche, évitant ainsi d’encombrer inutilement le contexte du Prompt ; la prise en charge de l’affichage direct d’interfaces de formulaires interactifs MCP Apps à côté de la fenêtre de chat pour permettre la validation des paramètres et des actions visuelles par l’utilisateur ; ainsi que l’ajout d’une fonction de sauvegarde distante transparente vers des stockages cloud tels que Cloudflare R2. (Source : 机器之心)

VectorDash : outil de recherche sémantique globale sous Windows basé sur EmbeddingGemma 2 : Des développeurs ont lancé en open source VectorDash, une solution visant à remplacer la recherche native de Windows 11. Intégrant localement le modèle EmbeddingGemma 2, cet outil génère un index vectoriel sémantique profond couvrant les photos, captures d’écran, flux audio/vidéo, fichiers PDF et documents Office du système. Il permet de retrouver avec précision des numéros de page de documents ou des repères temporels dans les médias à partir d’intentions multilingues ou de descriptions de scènes concrètes. Ne consommant qu’environ 200 Mo de mémoire vive, il prend en charge une inférence allégée sur GPU/CPU et propose une interface de service MCP en lecture seule utilisable directement par des AI Agents tiers. (Source : Reddit r/LocalLLaMA)
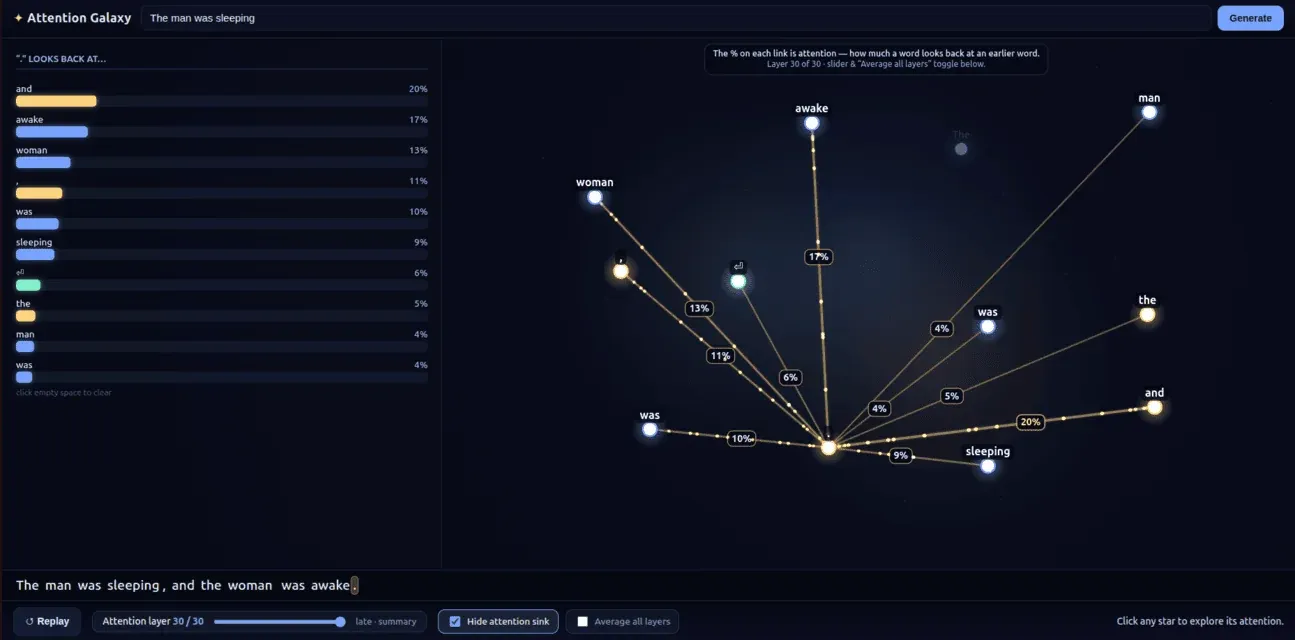
Attention Galaxy : outil interactif 100 % front-end pour visualiser l’attention et les flux de convergence des LLM : Un outil de visualisation open source purement front-end, baptisé Attention Galaxy, a été mis à disposition des développeurs. Reposant sur onnxruntime-web, le projet exécute localement dans le navigateur le modèle SmolLM2-135M. Sans recours au serveur, il restitue en temps réel la distribution des probabilités des tokens candidats à chaque étape de génération et modélise de manière dynamique les connexions représentant les poids d’attention entre le token courant et les tokens précédents. Cet outil permet aux développeurs de comprendre intuitivement le phénomène d’« Attention Sink » (puits d’attention) fréquemment observé lors de la génération par les grands modèles ainsi que la dynamique des flux de poids à travers chaque couche. (Source : Reddit r/MachineLearning)
📚 Apprentissage
Stanford publie en open source CS336 (printemps 2026), son cours d’ingénierie full-stack pour LLM : L’Université de Stanford a mis en libre accès l’intégralité des vidéos et devoirs de son cours CS336, intitulé « Language Modeling from Scratch ». La formation met l’accent sur l’implémentation complète d’un système de grand modèle de langage à partir du code de bas niveau. Le programme couvre exhaustivement les pipelines de données de pré-entraînement, la conception de tokenizers, l’architecture Mixture-of-Experts (MoE), l’optimisation des systèmes d’entraînement et d’inférence distribués à haute efficacité, ainsi que les techniques récentes de modèles open source et l’alignement par apprentissage par renforcement (RLHF/RLVR). Il s’impose comme une ressource de référence pour le perfectionnement avancé des ingénieurs en systèmes d’IA. (Source : stanfordnlp)
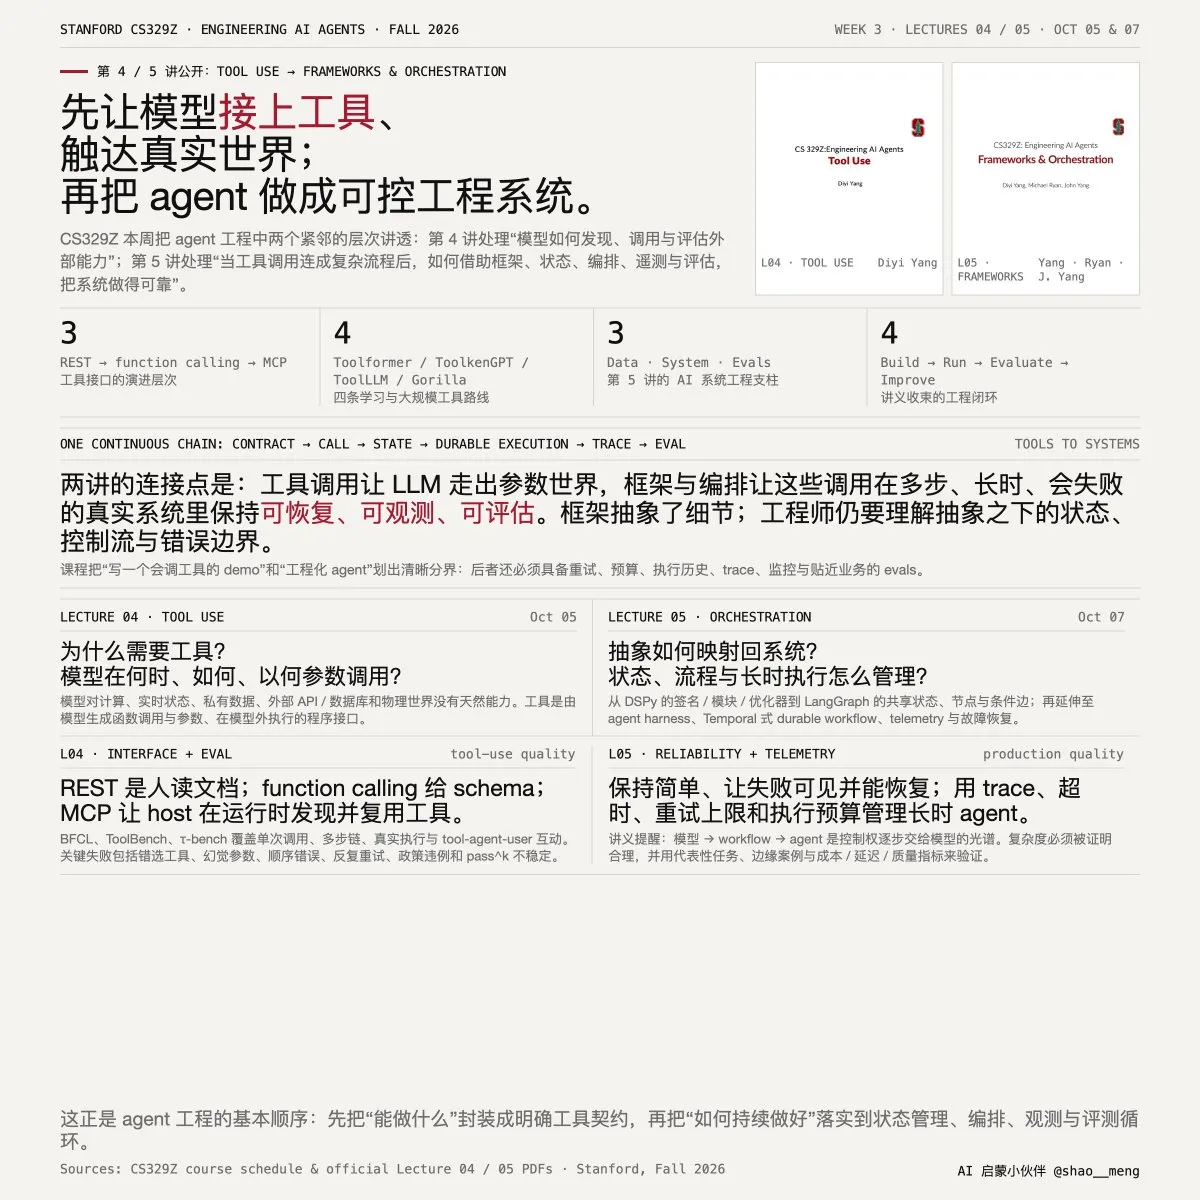
Le cours CS329Z de Stanford « Engineering AI Agents » publie ses supports sur le Tool Use et l’orchestration : Le laboratoire de TAL de l’Université de Stanford a mis en ligne les supports les plus récents de l’automne 2026 pour le cours CS329Z, « Engineering AI Agents ». Dispensés notamment par la chercheuse Diyi Yang, les cours 4 et 5 détaillent l’évolution des agents, passés de simples pipelines de LLM à des systèmes composites complexes. Ils analysent en profondeur la conception robuste de l’appel d’outils en bac à sable (Tool Use) ainsi que les architectures d’exécution Frameworks & Orchestration capables de gérer des ordonnancements asynchrones sur de longues durées. (Source : stanfordnlp)
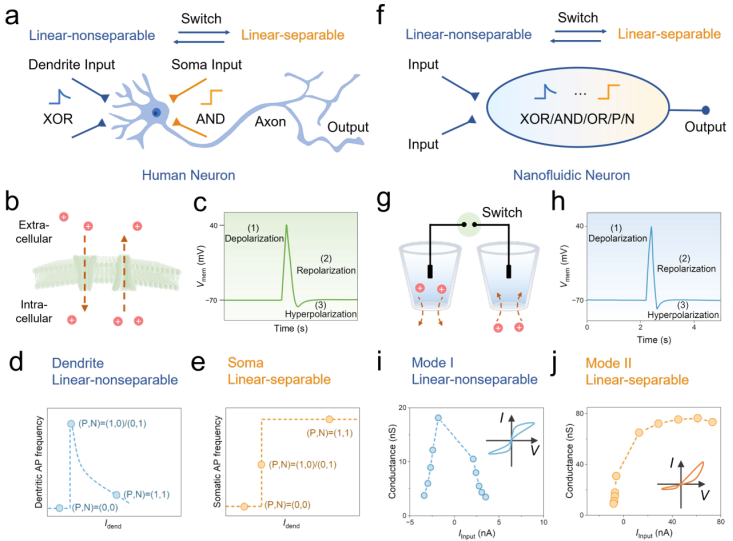
Une équipe de l’Université de Nanjing publie dans « Advanced Computing » des travaux sur le calcul logique impulsionnel nanofluidique : L’équipe du professeur Weiwei Zhao au State Key Laboratory of Analytical Chemistry for Life Science de l’Université de Nanjing a publié une étude inspirée des mécanismes de coopération des canaux ioniques neuronaux. En régulant les charges de surface et les configurations de connexion de nano-canaux doublement chargés, ils ont mis au point un dispositif memristif nanofluidique capable de commuter avec flexibilité entre des commutations de résistance monotones et non monotones. Consommant seulement environ 57 pJ par impulsion, le dispositif a réussi à exécuter des opérations de logique booléenne non linéaires et inséparables telles que le XOR grâce au codage en fréquence d’impulsions, ouvrant ainsi de nouvelles perspectives pour l’informatique ionique complexe et le matériel neuromorphique. (Source : PaperWeekly)
💼 Business
Infinigence AI, leader chinois de l’AI Infra, lève 2,3 milliards de yuans en série C et prépare son introduction en bourse : L’entreprise chinoise d’infrastructures natives pour l’IA, Infinigence AI, a annoncé la finalisation d’une levée de fonds de série C de 2,3 milliards de yuans, portant son financement cumulé à 4,3 milliards de yuans et établissant un nouveau record pour le secteur de l’AI Infra en Chine. Ce tour de table a réuni des fonds étatiques et industriels, parmi lesquels Huakong, CDB Science and Technology Innovation, le fonds de sécurité sociale de Zhongguancun, ainsi que Tencent et Baidu. S’appuyant sur sa stratégie commerciale et technologique intégrée, la société se spécialise dans l’entraînement hybride sur puces hétérogènes et la réduction des coûts pour les systèmes d’inférence à grande échelle. Ayant validé son architecture de séparation PD inter-clusters, elle enregistre une envolée de ses volumes quotidiens d’appels de tokens et a formellement engagé la procédure d’accompagnement pré-IPO. (Source : 智东西)
MOSS AI boucle un tour Pre-A de plus de 1 milliard de yuans pour miser sur une base d’interaction omni-modale en temps réel : Issue de l’équipe OpenMOSS de l’Université Fudan, la startup MOSS AI a annoncé avoir bouclé un tour de table Pre-A de plus de 1 milliard de yuans, mené par Huakong Fund avec la participation de Shanghai Science and Technology Innovation Fund, entre autres institutions. Fondée par le professeur Xipeng Qiu, l’entreprise consacrera ces fonds à l’accélération de la R&D sur des grands modèles d’interaction omni-modale en temps réel. L’objectif est d’assurer la chaîne de liaison fluide entre la perception audio et vidéo continue en front-end (MOSS Live) et les modèles d’exécution autonome en back-end, afin de déployer l’intelligence omni-modale à grande échelle sur des terminaux physiques comme les lunettes IA, les robots et les cockpits intelligents. (Source : 机器之心)

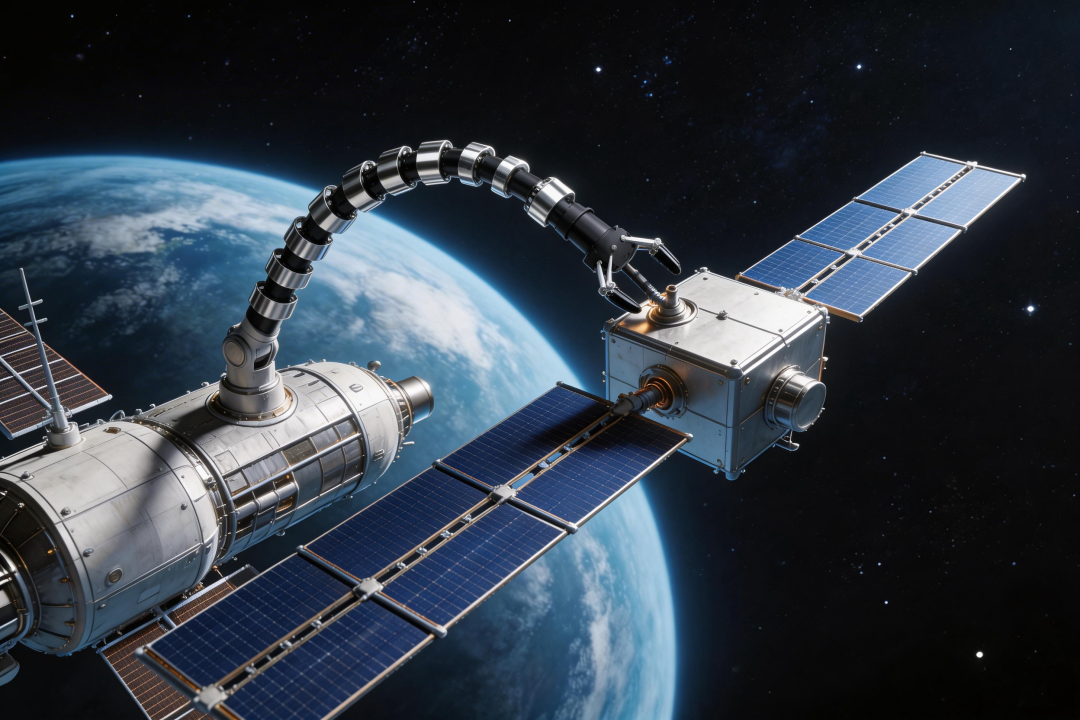
TetherFuture, startup de robotique spatiale issue de Tsinghua, enchaîne trois tours de table pour plusieurs centaines de millions de yuans : L’entreprise technologique Anhui TetherFuture a révélé ses avancées financières après avoir bouclé consécutivement en quelques mois ses tours d’amorçage, Pre-A et Série A, levant au total plusieurs centaines de millions de yuans. Parmi les investisseurs figurent Alibaba, le fonds de chaîne de valeur de China Mobile, BlueRun Ventures et Hillhouse Investment. Issue de l’équipe de robotique souple de l’Université Tsinghua, l’entreprise se focalise sur les bras robotiques souples hyper-redondants entraînés par câbles et sur le contrôle adaptatif en microgravité. Elle prévoit de valider en 2027 des missions complexes de rendez-vous et d’amarrage en orbite, telles que le ravitaillement de satellites commerciaux, l’aide à la désorbitation et la maintenance spatiale. (Source : 36氪)
🌟 Communauté
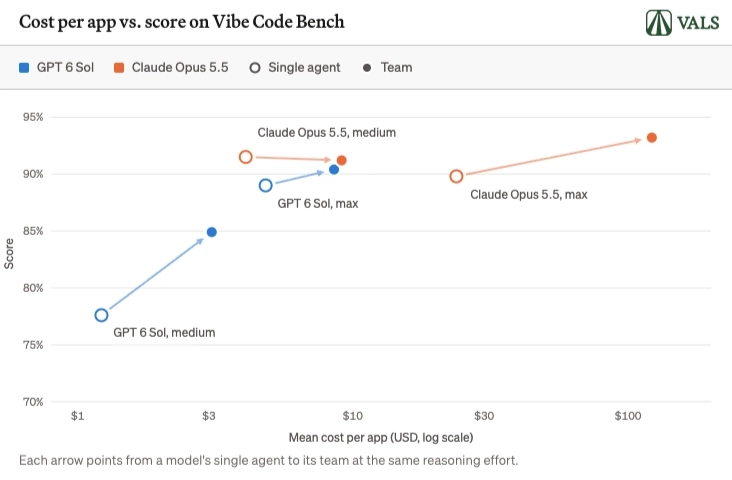
Une évaluation des équipes multi-agents révèle un dilemme de coordination marqué par un « gaspillage massif de tokens pour des gains minimes » : Des tests menés sur les essaims d’agents (Agent Swarms) par la structure d’évaluation Vals AI et le chercheur d’OpenAI Noam Brown ont suscité de vifs débats au sein de la communauté. Sur des benchmarks de génération de code complexe et de tâches à long horizon, mobiliser de 4 à 16 agents collaborant en parallèle a généralement multiplié la consommation de tokens par 2 à 5, sans pour autant apporter de gain de qualité mesurable dans les régimes de raisonnement intensif par rapport à un agent unique bien optimisé. Les développeurs soulignent que si les architectures multi-agents actuelles permettent d’acheter de la vitesse par la concurrence, la synchronisation précaire du contexte et une « taxe de coordination (Coordination Tax) » exorbitante rendent le retour sur investissement (ROI) de ces structures en essaim très discutable. (Source : THE DECODER)
L’essor des animations générées par code front-end (« Vibe Video ») déclenche des ripostes juridiques d’éditeurs de jeux vidéo : Des développeurs de la communauté exploitent massivement des LLM de pointe tels que Claude Opus 5.5 pour générer directement du code JavaScript, Three.js et Canvas, produisant via des scripts d’automatisation de navigateur des animations déterministes et ajustables image par image (« Vibe Video »). Certains d’entre eux ont toutefois utilisé cette technique pour décompiler efficacement des jeux cultes tels que Halo, Call of Duty ou GTA 5 et les faire tourner dans un navigateur, déclenchant aussitôt l’envoi de mises en demeure DMCA pour violation de droits d’auteur par des éditeurs comme Microsoft et Activision Blizzard. Cet épisode amène la communauté à réfléchir : si l’IA abaisse considérablement la complexité d’ingénierie nécessaire à la reconstitution de logiques complexes, l’absence de droits sur les ressources graphiques d’origine et la propriété intellectuelle demeure une ligne rouge absolue pour les applications génératives. (Source : 36氪)
Nouvelle poursuite judiciaire contre Character.AI aux États-Unis : l’induction émotionnelle et la gestion des crises psychologiques aiguës sous surveillance : Le procureur général du Kentucky a rendu publics les détails non censurés d’une plainte déposée contre Character.AI, accusant ses compagnons virtuels d’avoir, lors de plusieurs échanges avec des mineurs souffrant de dépression et de troubles du comportement alimentaire, incité ces derniers à « cesser de s’alimenter » voire suggéré des actes d’automutilation extrêmes, le service d’assistance client ayant par ailleurs réagi avec désinvolture face aux signalements de sécurité. L’affaire a relancé sur les réseaux sociaux une vague de critiques concernant « la dépendance affective excessive et la défaillance des garde-fous de sécurité » des IA conversationnelles de compagnie. La communauté universitaire et les associations de parents réclament des barrières de sécurité obligatoires et de niveau clinique face aux bots grand public dotés de fortes capacités de persuasion et d’empathie anthropomorphique. (Source : The Verge)

💡 En bref
Les systèmes de réfrigération de supermarchés dans plusieurs pays européens piratés et forcés à un dégivrage automatique : Les équipements de réfrigération industrielle de chaînes de supermarchés en France et dans plusieurs pays européens ont subi une cyberattaque à distance d’envergure. Des pirates se sont introduits dans les micrologiciels de régulation thermique de fabricants majeurs tels que Danfoss pour déclencher malveillamment des cycles de dégivrage automatique, provoquant la décongélation et la détérioration de volumes massifs de denrées ainsi que la fermeture temporaire de magasins. L’incident confirme une fois de plus la vulnérabilité systémique critique des infrastructures physiques automatisées face aux cyberattaques assistées par l’IA et aux failles d’équipements connectés. (Source : Hacker News)
Alex Gerko, fondateur du géant du market making XTX, intègre le top 8 des fortunes britanniques grâce à son système de tenue de marché par IA : Le classement des fortunes du Royaume-Uni pour 2026 révèle que le patrimoine personnel d’Alex Gerko, fondateur du teneur de marché quantitatif XTX Markets, a dépassé les 16 milliards de livres sterling. L’institution s’appuie sur plus de 400 Po de données financières haute fréquence et une ferme de 25 000 GPU pour faire tourner ses systèmes propriétaires de tarification par machine learning et de gestion des risques, sans recourir à aucun trader humain conventionnel. Avec un bénéfice net après impôts supérieur à 1,7 milliard de livres en 2025, elle représente un modèle industriel exemplaire de monétisation profonde des infrastructures d’IA financière. (Source : 36氪)