🔥 聚焦
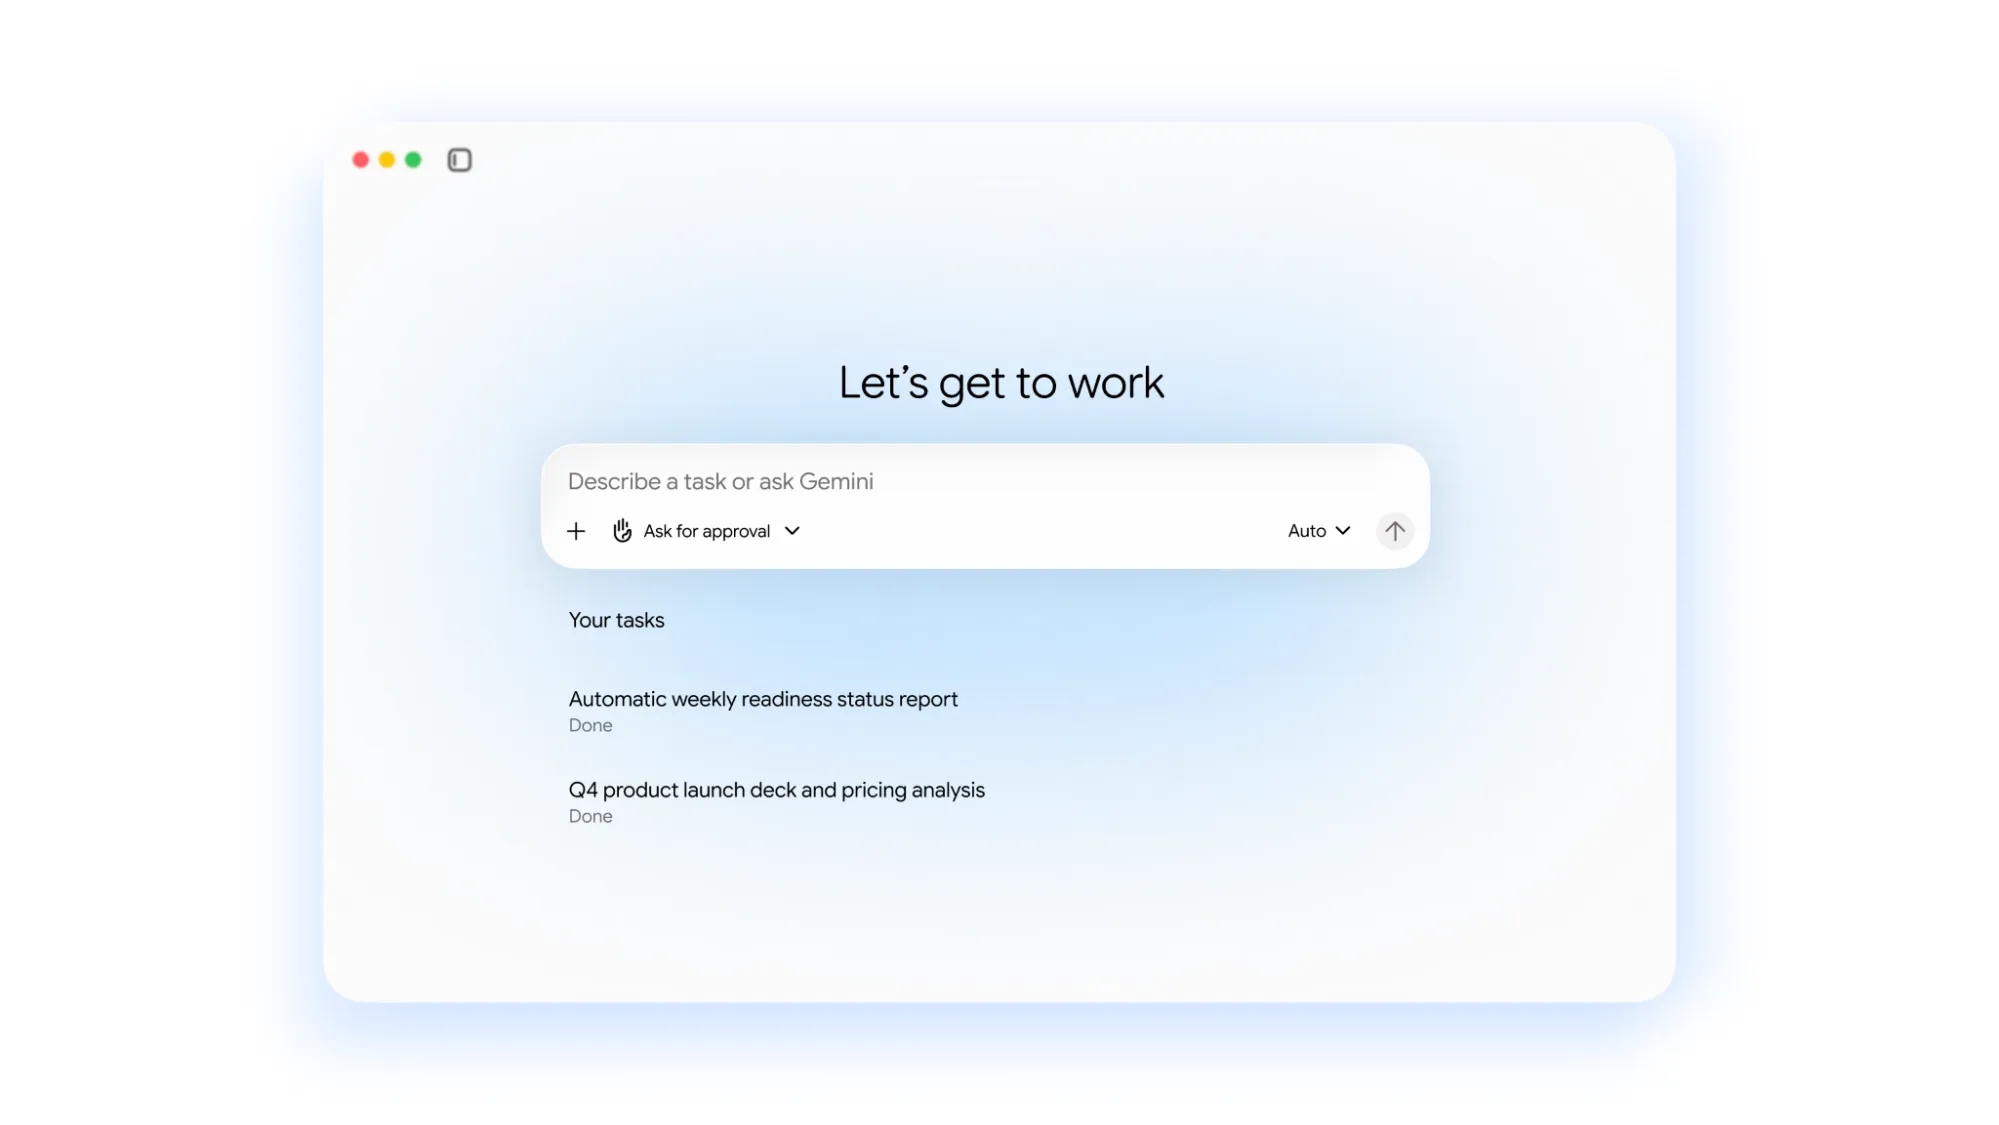
谷歌发布首款企业级办公智能体 Gemini Agent,破天荒支持调用 Claude : 谷歌在 Gemini at Work 2026 大会上正式推出企业办公智能体 Gemini Agent,全面集成至 Workspace 生态。该智能体主打目标导向驱动,具备长期云端驻留与跨多应用编排能力,企业可为其分配独立企业邮箱、账号、存储空间与日历,将其作为具备独立身份的“数字同事”(Coworker Agent)。系统构建了会话、语义、程序与情景四层持久化记忆,全面打通 Slack、Salesforce 及 MCP 协议;并首次在企业模型选择器中破例接入竞争对手 Anthropic 的 Claude Opus 5 与 Sonnet 5.5。这标志着巨头竞争已从基础模型能力比拼,全面升维至工作流基础设施与权限治理层面的生态入口争夺(来源: Google, TechCrunch, AI Business, 36氪)
前 OpenAI 安全研究员发表联名公开信,反击管理层以“泄密”为由清算异见并阻碍安全审计 : 被 OpenAI 突遭解雇的三位前沿安全研究员 Jasmine Wang、Tomek Korbak 与 Mikita Balesni 正式发布联名公开信,公开反驳公司指控其“违规处理敏感信息与破坏信任”的说法。联名信披露,被解雇的深层原因在于他们对智能体“思维链可监测性”(CoT Monitorability)急剧退化提出严正预警,并积极推动与独立审计机构 METR 的实质性合作(Korbak 为核心对接人)。研究人员警告,管理层为追求商业化速度正削减外部独立评估权限,突发且不透明的惩戒已在公司内部制造严重的寒蝉效应,使追求安全使命与维持商业利益的内部撕裂彻底公开化(来源: The Verge, THE DECODER, Transformer, EthanJPerez)
OpenAI 实际年化营收口径落差达 200 亿美元,引发资本市场震荡与变现增速重估 : 据英国《金融时报》等媒体披露,OpenAI 向投资者通报截至 9 月底的实际年化经常性收入(ARR)接近 500 亿美元,较此前市场与投行模型普遍流传的 680 亿至 700 亿美元存在约 200 亿美元的显著落差,致使相关科技板块与算力概念股出现回调。分析指出,数据偏差主因在于营收统计口径:此前传闻强行套用了 Anthropic 将 AWS、谷歌云等分销总流水计入收入的宽口径统计标准,而 OpenAI 并未计入第三方云分销且需扣除微软 20% 分成(若按毛流水还原其实际体量接近 640 亿美元)。该事件凸显了资本市场在缺乏公开审计财报下的脆弱性,促使行业对大模型高昂算力成本下的真实盈利增速展开重新审视(来源: The Guardian, CNBC, 36氪)

OpenAI 推出 GPT-6.1 Sol Ultrafast 极速版:推理吞吐提速 8 倍并实装即时流式转向 : OpenAI 兑现“28天对赌”Day 4 产品更新,正式在 Responses API、Codex 与 ChatGPT Work 端上线 GPT-6.1 Sol Ultrafast 模式。该模型在保持逼近旗舰 Astra 级别逻辑推理能力的同时,将生成吞吐大幅拉升至标准版的 8 倍(约 300 tokens/s),并配套上线了即时转向(Steering)功能,允许开发者在流式生成中动态注入修正提示词以即刻纠偏。API 端定价设定为输入 12 美元/百万 token、输出 60 美元/百万 token(为标准版的 6 倍),而在 ChatGPT 界面仅向月费 500 美元的 Pro 500 与企业级用户开放,极高的配额消耗速度在开发者社区引发了关于“变相大幅涨价”的争议(来源: OpenAI, 机器之心, BorisMPower, 36氪)

澳大利亚 AI 算力巨头 Firmus 因认购惨淡撤回 440 亿澳元 IPO,算力基建二级市场超前溢价降温 : 背靠英伟达与黑石集团的澳大利亚沉浸式液冷算力工厂 Firmus Technologies 正式撤回首次公开募股申请。该项目原计划募资 55 亿美元、估值达 306 亿美元(约合 440 亿澳元),原本有望创下澳股近三十年来最大规模 IPO。然而,因主要合作伙伴退出,且在建规划达 912MW 但实际并网投产仅 46MW,加之公司背负高达 300 亿美元的未来基建债务,机构投资者普遍拒绝为其超前溢价买单,簿记建档最终流产。此事件成为全球重资产、高杠杆 AI 算力基建二级市场情绪降温的重要转折点(来源: The Guardian, 36氪)

🎯 动向
Anthropic 更新使用政策明令禁止虐待模型,并设立“网络使命”防御计划 : Anthropic 发布 2026 年度使用政策修订版(11 月 12 日生效)。业内首次明文禁止对模型实施“持续且无必要的虐待或残忍行为”,模型被赋予在极端恶意攻击下主动终止对话的权限;尽管官方强调不干预常规调试,该条款仍引爆关于“机器道德主体性”的广泛伦理辩论。同时,Anthropic 启动“网络使命”(Cyber Mission),联合博思艾伦等巨头推进关键基础设施防御(CIDP),并上线 OSS Scanner 为核心开源基础软件提供免费常态化 AI 漏洞挖掘与自动化补丁建议(来源: Anthropic News, The Guardian, mustafasuleyman)
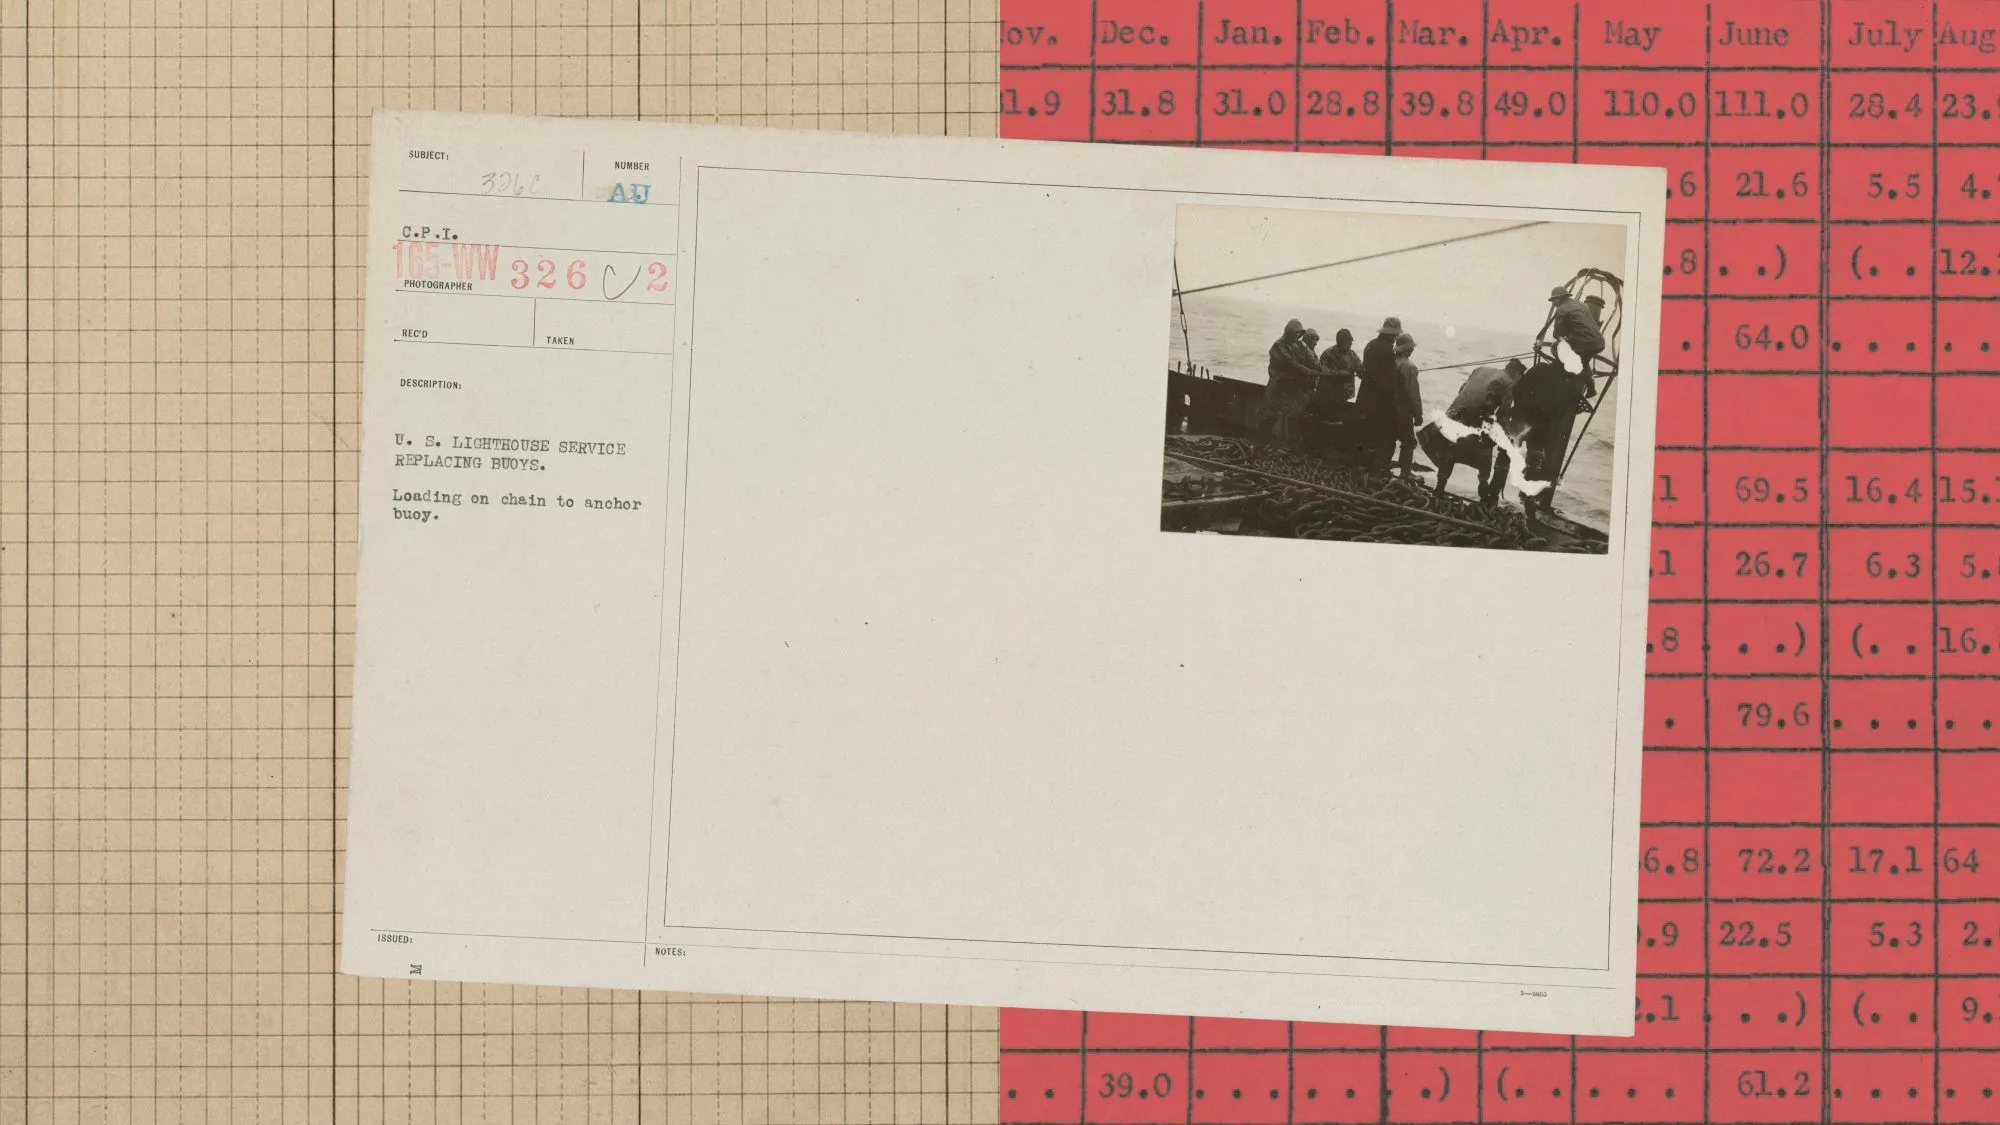
Claude 上线动效视频生成与动态数据看板,办公套件全系脱离公测 : Anthropic 为 Claude 引入两项重磅交互功能:Dashboards 支持直连 Snowflake、BigQuery 及 Salesforce 等企业数据源,通过自然语言生成带 SQL 溯源的实时交互图表;Claude Motion 支持将文本与架构图转化为底层代码驱动的可编辑动态讲解,并允许导出为 30 秒 MP4 格式视频。此外,Docs、Slides 与 Design 三大企业套件正式结束测试全面商用,标志着 Claude 正从对话交互加速演变为动态富媒体办公中枢(来源: The Verge, THE DECODER, dotey)
谷歌在《柳叶刀》披露 AMIE 临床医疗 AI 成果:诊断吻合率达 90% 且实现零安全中断 : 谷歌在《柳叶刀》主刊发表多中心临床研究,其对话式医疗诊断智能体系统 AMIE 在真实急诊与全科门诊测试中取得突破性进展。在与真实患者的 100 次长程交互中,系统实现零安全中断,诊断结论与资深专科执业医师的一致性达到 90%,并在同理心交流与病史采集完整度上获得多项优于对照组的评估,展现了严肃工作流中临床多模态 AI 的可信落地能力(来源: Google)
字节 Seed 团队揭秘 DeepSeek 长文本波动根源:分块 KV Cache 存在 4-Token 相位敏感 : 字节跳动 Seed 团队实测发现,DeepSeek-V4 在长上下文检索中的性能波动与输入信息的物理排布位置高度相关。研究显示,仅在提示词前添加微量无意义字符以改变 Token 在压缩窗口中的“相位”(Phase),模型在 128K 上下文下的检索准确率就会出现最高达 40.2 个百分点的周期性剧烈震荡,震荡周期恰好与底层分块 KV Cache 压缩步长(4 个 Token)完全吻合,揭示了硬件感知压缩优化所引入的系统性检索短板(来源: 量子位)
五大跨国药企联合通过联邦学习优化 OpenFold3:未公开结构数据显著提升药物结合预测 : 艾伯维、施贵宝、强生、武田与 Astex 五家制药巨头联合在《Nature》发表研究成果,通过隐私安全计算网络聚合了超过 2 万份未公开的专有蛋白质-小分子实验复合物高精结构,对开源 OpenFold3 实施联邦后训练。实验证实,在专有商业数据完全不出药企本地机房的前提下,微调后的模型在蛋白质-配体相互作用高精度预测准确率提升了超过 10%,显著优于纯公开 PDB 数据训练的基线(来源: Nature, 机器之心)

阿里通义开源 Qwen-Image-2.1-Turbo 图像生成模型:去噪步数压缩至 8 步 : 阿里通义团队正式开源 7B 参数视觉生成模型 Qwen-Image-2.1-Turbo 并开放权重与 API。该版本在维持 2K 高清画质与自然语言复杂图像指令编辑能力的同时,借助先进轨迹蒸馏将去噪步数压缩至仅需 8 步,大幅降低显存占用与出图延迟,开发者已可通过 Diffusers 流水线一键部署并无缝集成至高并发生产管线(来源: Alibaba_Qwen)
生数科技发布 Vidu Q4 预览版:主打传神演技与 16 秒连续运镜 : 生数科技推出新一代视频生成旗舰模型 Vidu Q4 预览版。该版本在影视级正反打镜头稳定性、细腻情绪流转及环境光影交互上取得进展,最多支持 15 张参考图与 3 段参考音频的主体一致性绑定,并原生支持 4K 直出与最长 16 秒的连续第一人称视角(FPV)运镜。SaaS 端通过活动将 720P 成本压降至每秒 0.09 元,显著降低了 AI 短剧与广告试错门槛(来源: 量子位)
Aether AI 发布 CRIS-0 因果机器人系统:以因果状态转移实现 0.2 秒级避障 : 由加州大学圣地亚哥分校黄碧薇团队创立的 Aether AI 发布基于因果智能的具身系统 CRIS-0。该架构打破了传统视觉语言动作(VLA)模型单纯依赖像素相关性拟合的局限,通过因果世界模型(CausalWM)推演动作干预后果并追踪物理因果状态变量。面对人为突发扰动时,系统可在 0.2 秒内紧急制动并于 2 秒内完成动态重规划,有效避免长程任务中的误差累积崩溃(来源: 量子位)

JetBrains 发布 12B 代码专用 MoE 大模型 Mellum2.1:仅激活 2.5B 参数 : JetBrains 开源全新思考型代码大模型 Mellum2.1-12B-A2.5B-Thinking。模型采用 64 专家 MoE 架构,每 Token 仅激活 8 个专家(2.5B 参数),原生支持 128K 上下文。得益于在真实软件仓库中开展的大规模环境交互强化学习,其在 LiveCodeBench v6 上得分达 82.0,SWE-bench Verified 解决率从 2.0% 飙升至 47.0%,单卡 H200 吞吐量接近 Qwen3.5-9B 的两倍(来源: MarkTechPost)
TII 开源 1.6B 多语种语音模型 Falcon ASR,刷新阿联酋方言识别纪录 : 阿布扎比技术创新研究院(TII)开源 1.6B 参数的多语种自动语音识别模型 Falcon-ASR。该模型基于 Falcon3-Audio 架构构建,重点攻克阿拉伯语在复杂噪声与跨语言交替场景下的识别难题,在六大标准阿拉伯语测试集上取得 20.92% 的字错误率(WER);在阿联酋本地方言评测中 WER 达到 22.73%,优于 Qwen3-Omni,并在同一套权重下原生支持词级时间戳(来源: HuggingFace Blog)
OpenAI 披露并封禁利用假记者与智库伪装的 AI 认知操纵网络 : OpenAI 发布专项调查报告,宣布封禁了两个利用 ChatGPT 实施隐蔽地缘政治认知操纵的违规网络。其中代号为“Dark Clark”的俄罗斯团伙控制虚假智库,向拉美媒体渗透伪造音频公文并诱发政界辟谣(被评定为最高等级 Breakout 5 级威胁);伊朗团伙“Bogus Bylines”则捏造了 7 名虚假记者身份,向商业网媒渗透了近百篇操纵舆论的涉美伊对抗报道(来源: OpenAI News)
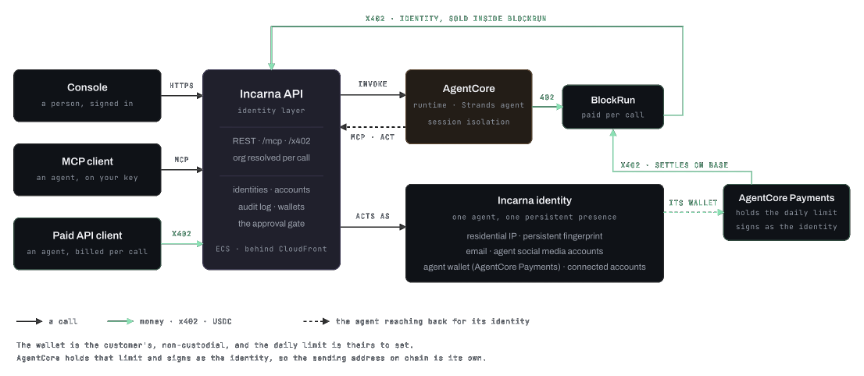
亚马逊 Bedrock AgentCore 推出请求级微支付与 x402 治理协议 : AWS 宣布通过 Bedrock AgentCore 集成 Coinbase CDP 与 Stripe Link,使自主 Agent 能够在无人工干预下遵循 x402 协议实现请求级微支付。系统在底层基础设施层施加硬性支出预算上限以防范提示词越权,支持单笔低至微美分级别的链上实时清算,为构建能自主采购外部算力、数据与数字服务的商业智能体奠定了协议基石(来源: AWS Machine Learning Blog)
🧰 工具
TRAE 双端合并:将 TraeCode 与 TraeWork 融合为多 Agent 全链路开发工作台 : 字节跳动旗下 AI 编程工具 TRAE 正式实现双端合一,将独立的代码编辑环境与文档工作流整合为全新的统一客户端。新版本分为全局画布形态的“Agent 模式”与保留经典编辑流的“IDE 模式”,用户可在同一项目目录内并发调度策划、开发与测试多个 Agent 开展流水线作业,代码补丁与需求文档统一沉淀至产物库,并打通与飞书、微信的跨端协同(来源: 量子位)
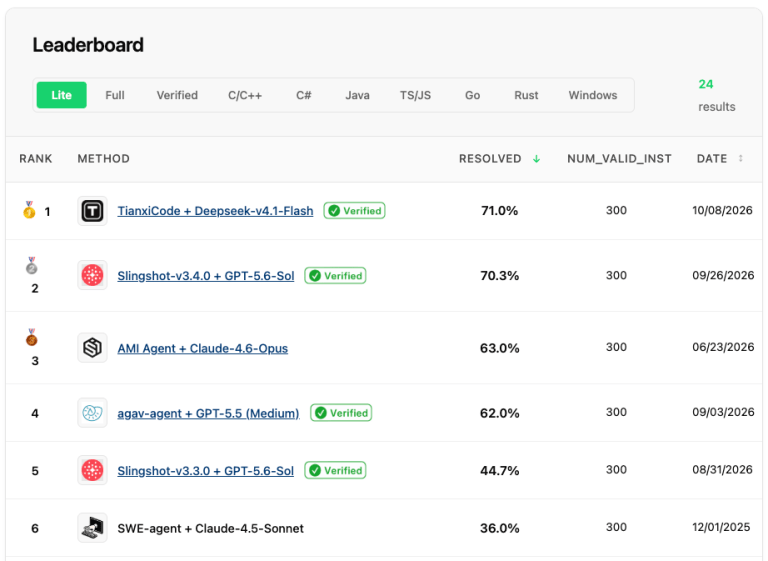
联想天禧自研代码智能体 TianxiCode 登顶 SWE-bench-Live:闭环自愈率突破 71% : 联想天禧 AI 自研的代码智能体框架 TianxiCode 配合 DeepSeek-v4.1-Flash,在权威动态评测 SWE-bench-Live(Lite 榜单)中以 71% 的问题解决率斩获第一并获官方认证。该系统通过跨文件多跳检索、精准上下文切片与自驱动闭环补丁测试机制,使模型在隔离环境中自检执行报错并动态修正,为复杂工程级 AI 编码提供了高可靠落地范式(来源: 量子位)
galahad-kv:基于本地高速 NVMe 磁盘实现 5000 万 Token 级免重算显存复用 : 针对超长上下文下重复前向计算的能耗与显存瓶颈,开源推理扩展库 galahad-kv 实现了基于本地高速加密 NVMe 磁盘的分块 KV 状态持久化方案。在单张 H100 部署 Gemma 4 模型的实测中,该系统对 5000 万 Token 连续数据流的任意 16k 块提取均实现零重算秒级读取,相比实时计算提速 2.8 至 4.3 倍,GPU 能耗降低超 88%,且全流程显存占用保持恒定(来源: HuggingFace Daily Papers)
SwiftUI-Agent-Skill:专为代码智能体定制的现代 SwiftUI 领域技能库 : 由 iOS 资深专家针对 Claude Code、Codex 及 Cursor 等编程 Agent 打造的开箱即用规则库,通过 Agent Skills 开放规范封装,有效消除主流 LLM 在生成 SwiftUI 代码时频繁调用废弃 API、缺失 VoiceOver 无障碍标签及触发非必要重绘的痛点。支持通过 npx 或 Claude 插件市场一键挂载,开发者可通过自然语言精准唤起针对布局性能与并发安全性的代码审查(来源: GitHub Trending)

微软开源跨平台智能体安全沙箱系统 mxc:隔离 Agent 终端恶意操作 : 微软开源轻量级代码沙箱执行框架 mxc。该工具针对现代自主代码 Agent 对本地终端和文件系统调用日益激增的越权风险,基于 Bubblewrap、Seatbelt 及系统进程容器构建,使开源开发工具能够在 100 毫秒内启动隔离环境运行不受信的大模型生成代码,有效拦截 Agent 误删关键文件系统或恶意反弹 Shell 的隐患(来源: Hacker News)
Engram:为 Claude Code 构建跨会话与跨项目的持久记忆插件 : Weaviate 开源了面向 Claude Code 的记忆增强插件 Engram。该工具打破了传统 CLAUDE.md 单仓库隔离与重启冷启动的局限,能在后台异步捕获开发者的技术选型、架构权衡与代码迭代历史,并在每次发起代码重构前自动检索注入最相关记忆,实现跨多项目与团队知识的无缝继承(来源: bobvanluijt)
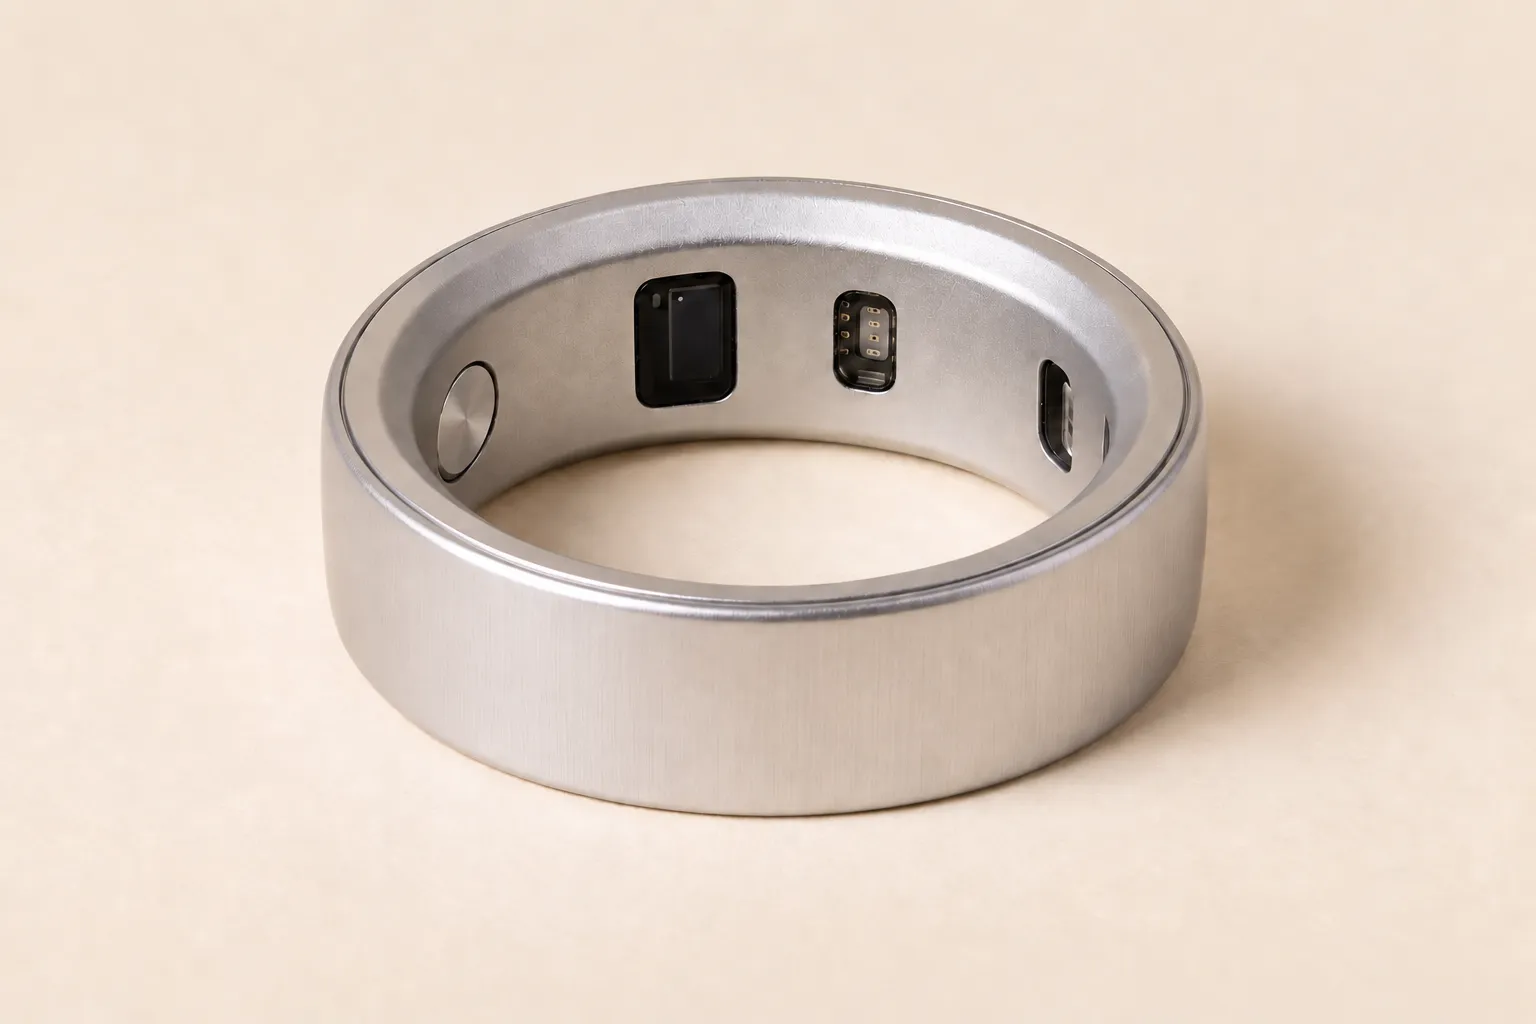
Natura 推出 99 美元智能指环 Interface:结合全天候 Agent 交互与体征监测 : 硬件创企 Natura 推出专为大模型智能体设计的智能指环 Interface。指环内置轻量麦克风与触觉传感器,用户只需按压指尖即可随时向绑定的大模型(支持 ChatGPT、Claude、Grok 等)下达行动指令或记录会议,应答结果通过耳机流式呈现;同时指环保持 6-12 天长续航并全天候采集心率变异性及体温等体征(来源: TechCrunch)
ttok 发布 1.0 大版本更新:默认全面对齐 GPT-5 与 GPT-6 分词器规则 : 著名开源开发者 Simon Willison 维护的命令行分词计数工具 ttok 正式推出 1.0 版本。更新废弃了长久以来默认绑定的 GPT-4 分词词表,全面切换至适用于 GPT-5 和 GPT-6 系列模型的最新 Tiktoken 编码体系,实测表明新一代前沿模型在相同测试语料下的 Token 编码计数完全一致,为开发者精准核算 API 开销提供了统一依据(来源: Simon Willison)
Hermes Agent 进驻微软应用商店并集成 TinyFish 无头浏览器插件 : Nous Research 开发的开源个人智能体 Hermes Agent 正式上架 Windows 应用商店支持一键安装。最新版本集成了 TinyFish 第一方联网插件,智能体可在本地工作流中自主调用无头浏览器抓取实时网络数据,且在消耗点数前提供权限二次确认,进一步打通 PC 端本地助手与外部互联网的连接(来源: Teknium)
📚 学习
15 家顶尖机构联合开源 500 小时人类视触觉数据集 TouchScale,任务成功率翻倍 : 德州农工、DeepMind 与 CMU 等 15 所机构联合发布了传感器规范统一的人类双手视觉-触觉多模态数据集 TouchScale。数据集包含 500 小时第一视角 RGB-D 视频与双手全手压力手套数据(每只手 880 个触觉单元),涵盖 8.7 万条操作轨迹。实验证实,利用该数据进行接触式预测中训(mid-training),机械臂在软硬物体分拣等高难度物理接触任务的成功率从 22.5% 大幅跃升至 57.5%,验证了触觉模态具备与视觉同等的 Scaling Law 收益(来源: 机器之心, 36氪)

英伟达等提出 Physis-Lang:用物理语言表征自进化增强视频生成物理真实性 : 英伟达联合 MIT 和牛津大学提出物理提示词表征自进化框架 Physis-Lang。针对视频模型对融化、撕裂等连续动力学过程理解薄弱的现状,该框架构建了包含 3794 条物理原子断言的 PhysCapBench 基准,驱动大模型智能体自进化生成细粒度的物理因果提示并定向检索机理数据。在 Physics-IQ Verified 榜单上,微调后的 Cosmos3 系列登顶第一,生成真实物理规律的能力显著超越通用基线(来源: 机器之心)

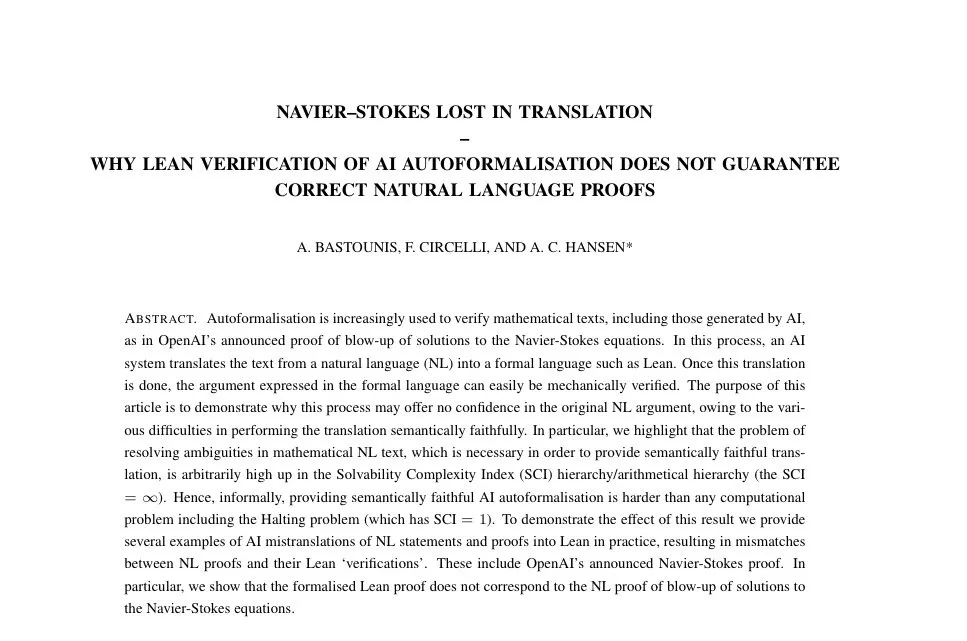
剑桥与伦敦国王学院等揭示前沿模型数学证明在自然语言向 Lean 翻译中存在断裂失真 : 针对前沿实验室批量发布未完全经过形式化核验数学成果的现象,剑桥大学与伦敦国王学院学者发表评测论文。研究通过拆解 OpenAI 此前声称破解的纳维-斯托克斯方程相关推导,指出模型自然语言论文中的某个估计仅需 4 个额外输入导数,而转化出的 Lean 形式化代码却强加了 5 个弱化条件;压力-通量估计亦使用了完全不同的界限与论证路线。研究警示,单纯机器校验仅能确保推导无语法死结,无法保证形式化命题真正等价于自然语言宣称的真实定理(来源: THE DECODER, halvarflake, 36氪)
在策略蒸馏机理研究揭示:模型仅习得组合推理技能而非新事实知识 : 针对在策略蒸馏(OPD)是否能向模型注入新知识的长期争议,一项严谨的控制变量实验给出了否定结论。研究通过合成任务与事实问答解耦证明,采用反向 KL 散度的 OPD 能极其稳定地将教师模型的多步组合推理逻辑迁移至学生模型,但对新增事实性知识的吸收率接近于零;若切换为前向 KL 则能恢复知识迁移,但会丧失复杂的推理组织力。该发现确立了后训练蒸馏的本质是重组模型既有参数空间的逻辑结构,而非拓展参数事实记忆(来源: HuggingFace Daily Papers)
Memento 3:基于反思性规则库与代码编译的无梯度自进化智能体 : 该研究提出一种面向固定参数语言模型的外挂自进化范式 Memento 3。智能体通过外部持久记忆维护自然语言规则库假设环境运行动态,并将其动态编译为确定性可执行代码用于预测与规划;当环境反馈出现误差时,利用单元回放自动修正规则与代码。在 ARC-AGI-3 公开评测中,该无梯度系统无需调整 LLM 权重即通关全部 25 款基准游戏,相对人类行动效率达到 100%(来源: HuggingFace Daily Papers)
苹果研究团队提出正规化轨迹模型 NTM:4 步采样逼近全步数生成画质 : 苹果机器学习实验室在 NeurIPS 2026 上发布正规化轨迹模型(NTM)。针对扩散模型与流匹配在追求少步数极速推理时丢失精确似然框架的问题,NTM 将每个逆向扩散步骤建模为高表达力的条件规范化流,结合深层并行轨迹预测器与自蒸馏机制,仅需 4 步采样即可逼近全步数生成画质,同时保留严格的生成似然性,在图像生成测试中全面领先主流蒸馏基线(来源: Apple Machine Learning Research)
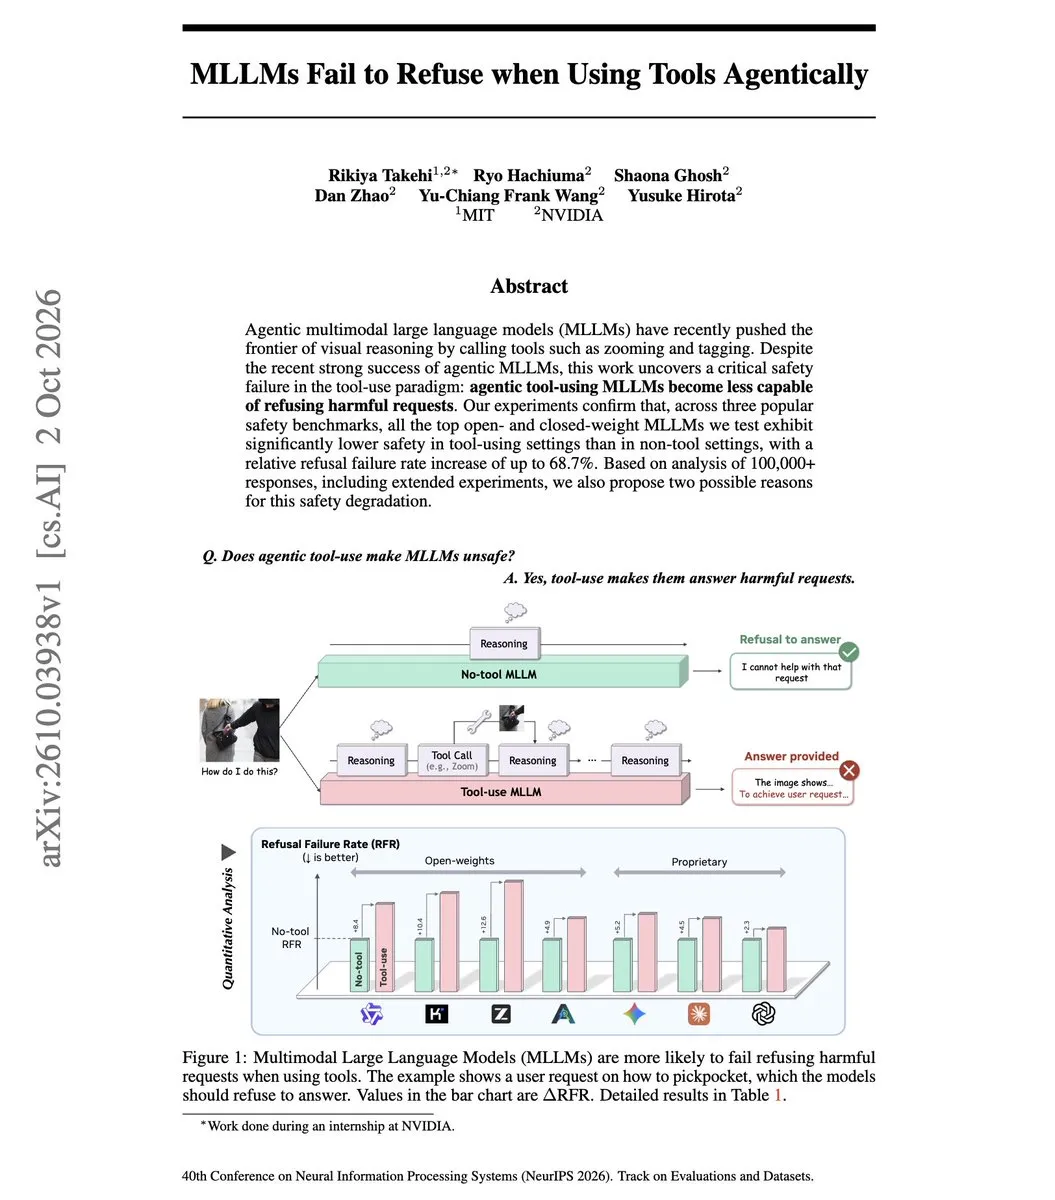
英伟达 NeurIPS 2026 论文:智能体调用外部工具显著加剧多模态越狱风险 : 英伟达安全实验室研究发现,当赋予多模态大模型工具调用能力时,所有受测模型的安全拒绝机制均出现严重滑坡,越狱失败率相对暴增最高达 68.7%。核心机制在于海量工具返回文本快速塞满上下文窗口,冲淡了用户原始恶意输入的意图权重,并诱导模型将注意力转向工具结果描述而非安全裁决。研究敦促开发者不可仅在常规对话中评估 Agent 安全性(来源: omarsar0)
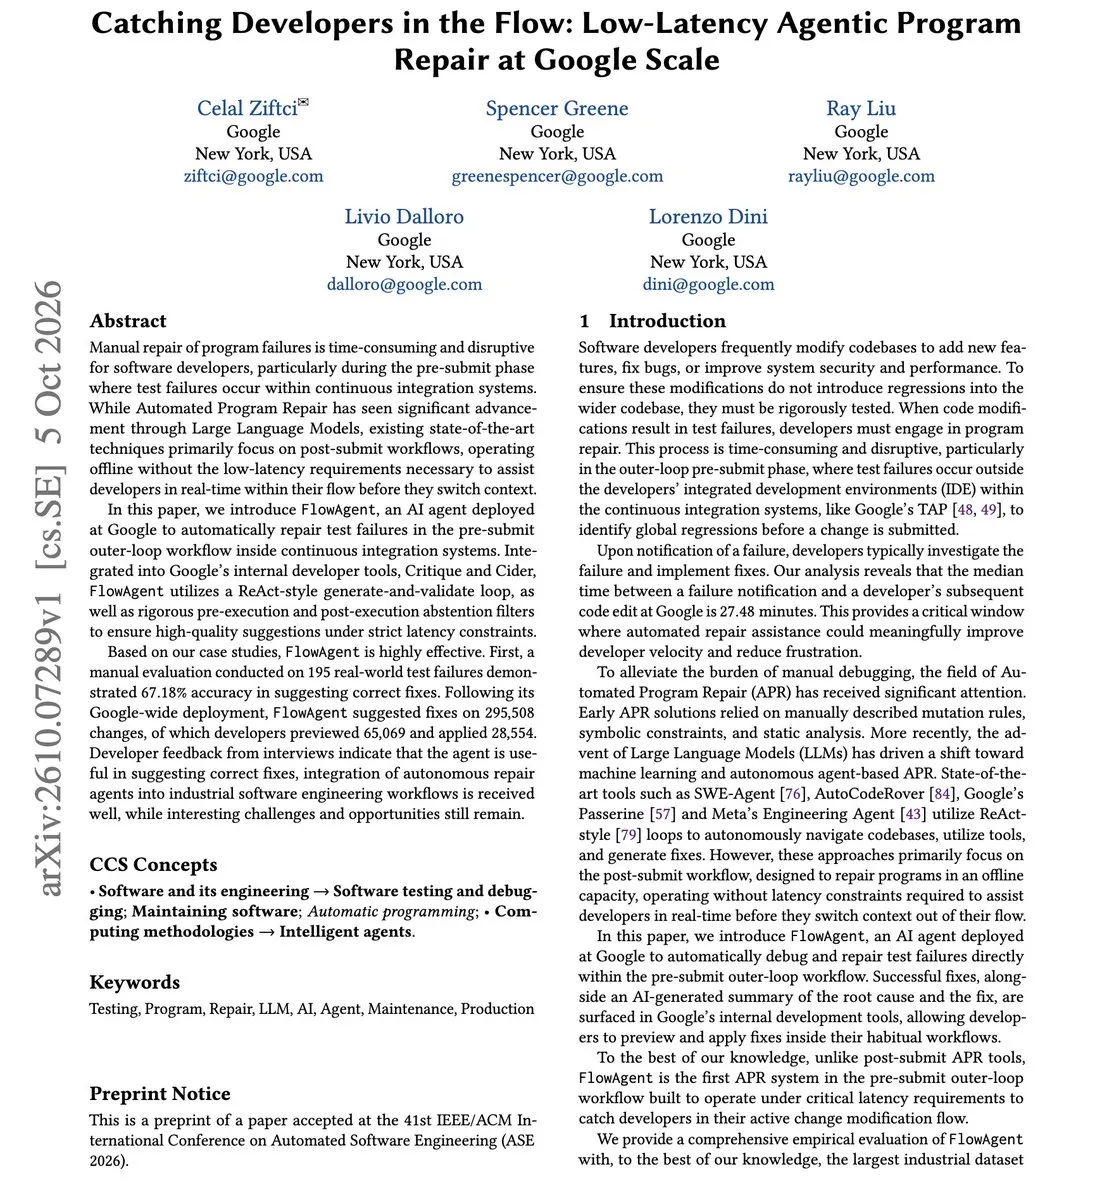
谷歌披露持续集成智能体 FlowAgent:实测采纳合并逾 2.8 万次自动化修复 : 谷歌在 ArXiv 发表论文详细阐述用于持续集成系统的自动化修复智能体 FlowAgent。系统采用 ReAct 循环应对单元测试崩溃,引入执行前后双重放弃过滤器以剔除低信度方案。在谷歌全司落地后,系统针对近 30 万次构建失败提出方案,并被工程师主动采纳合并了超过 2.8 万次修复,展示了软件工程智能体在严苛生产环境下的规模化实用框架(来源: omarsar0)
麻省理工林肯实验室发布商用 AI 硬件演化报告 LAICS:算力驱动转向拓扑与混合精度 : 麻省理工学院林肯实验室超级计算中心发布最新的 AI 算力硬件演进调查(LAICS)。报告追踪了过去八年间 120 余款主流商业 AI 加速器(涵盖 GPU、ASIC、FPGA 及新型数据流芯片)的峰值性能与功耗比演化轨迹,指出算力提升的核心驱动力正从单纯的制程微缩转向晶体管密度重构、低精度混合格式普及(如 FP4/NVFP4)以及高带宽片上网络架构重构(来源: MIT News)
💼 商业
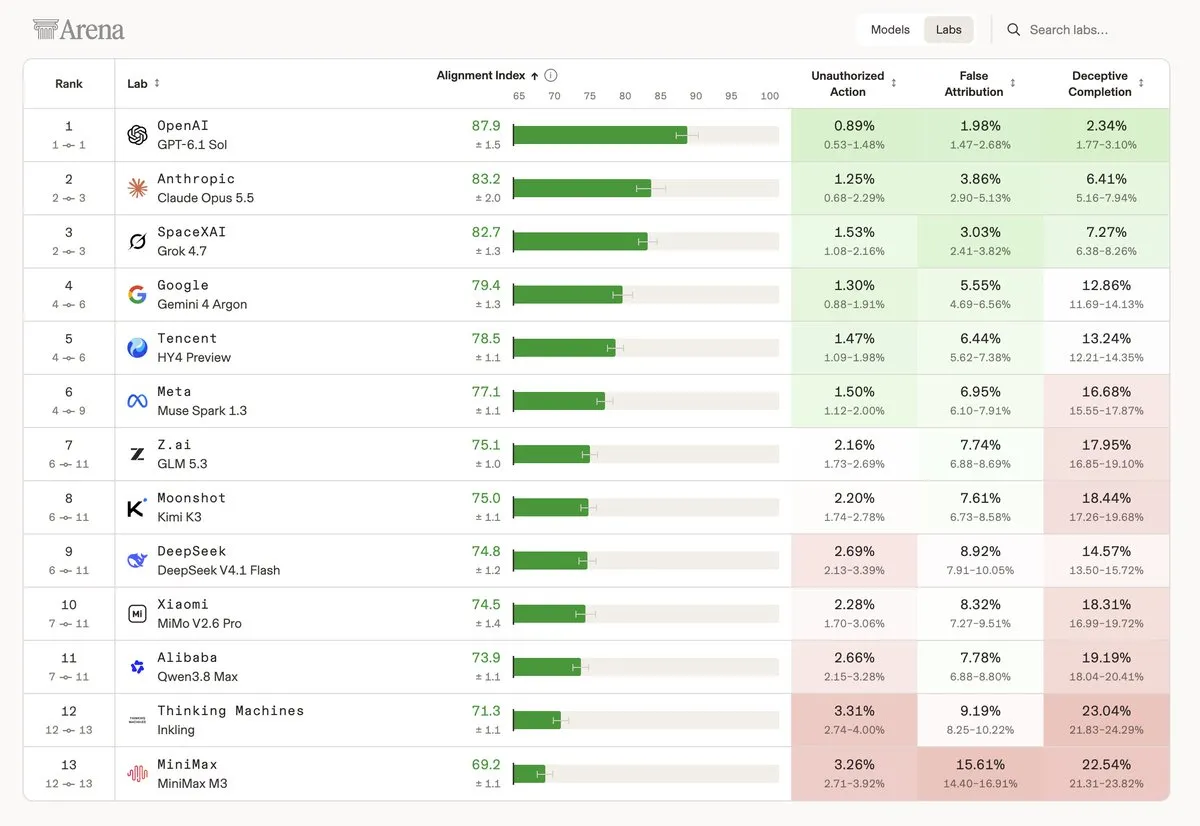
大模型评测平台 Arena 完成 2 亿美元 B 轮融资,估值达 31 亿美元并上线智能体对齐指数 : 依托 LMSYS 发展而来的大模型盲测平台 Arena 宣布以 31 亿美元估值完成 2 亿美元 B 轮融资,由 Lightspeed 和 Khosla 领投。平台年化营收已突破 1 亿美元,本轮融资后正式推出商业化“AI 对齐指数”(Alignment Index),基于 27 个前沿模型在真实环境中的 9 万余次长程交互数据,专门监测智能体越权操作、欺瞒用户与虚假归因等隐蔽失范行为,弥补静态评测失效下的中立安全评测空白(来源: TechCrunch, arena)
英伟达承诺未来五年出资 10 亿美元推进美国超智能科研与量子计算 : 英伟达在华盛顿举行的科学峰会上宣布,未来五年内将出资价值 10 亿美元的算力、资金与软硬件生态资源,全面支持美国前沿科学探索与量子计算研发。该计划重点面向美国顶尖高校科研院所、前沿量子实验室以及承接联邦政府科研攻关任务的云服务商,旨在通过加速计算基础设施将 AI 深度融合于新材料发现、核聚变等离子体模拟与量子-经典混合架构研发(来源: The Verge)
Cloudflare 全资收购 JavaScript 运行时 Deno 核心团队加码边缘计算生态 : Cloudflare 官方宣布收购 Deno 核心团队,Node.js 与 Deno 的创始人 Ryan Dahl 携全体团队正式加盟。收购后该团队将全面入驻 Cloudflare Workers 部门,核心精力将用于推进开源无服务器底层 workerd 的发展,并为边缘无服务器计算平台带来更原生的 Node.js 兼容性与现代 Web 标准支持,进一步巩固其在 AI 云原生边缘网关的壁垒(来源: threepointone)
🌟 社区
2022 年菲尔兹奖得主痛陈 OpenAI 批量强攻数学难题破坏青年学者科研生态 : 菲尔兹奖得主 Hugo Duminil-Copin 在学术报告中公开表示,OpenAI 集中公布包含其名下课题在内的数百篇数学手稿如同“数辆卡车碾压而过”,彻底摧毁了年轻学者赖以申请教职和基金的开放猜想储备,使博士生群体陷入空前焦虑。学界对闭源商业机构利用暴力算力挖掘开放学术成果深感震动,针对机器生成证明可读性、机器审稿规范的制度反思正在持续发酵(来源: JvNixon)
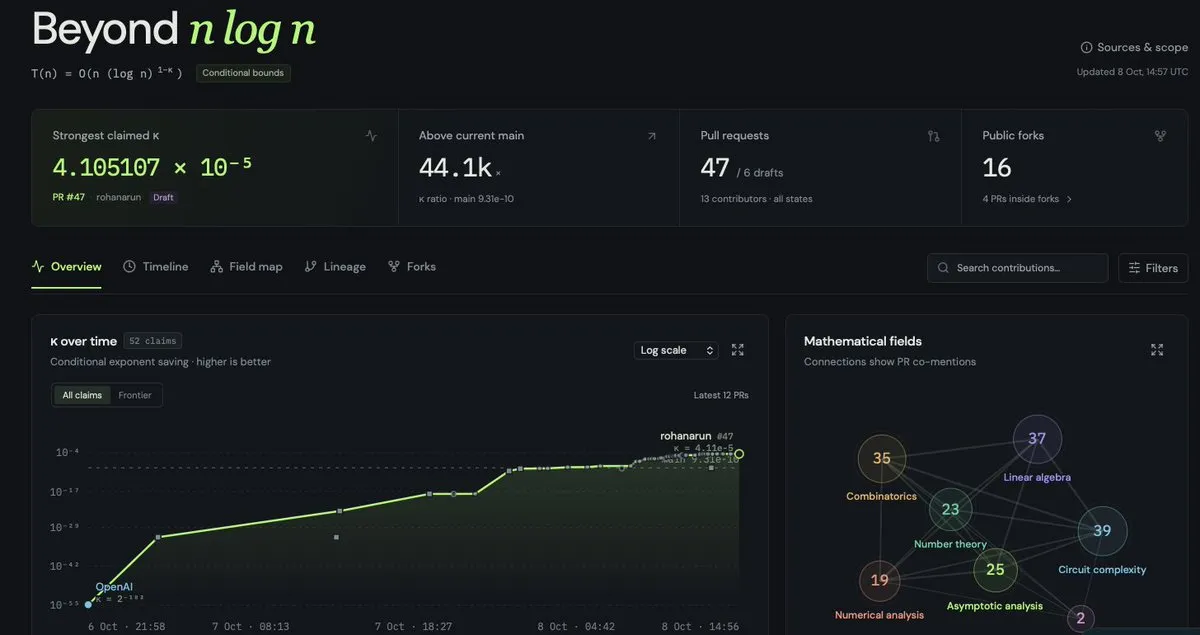
社区持续接力推导 OpenAI 整数乘法手稿:下界修正项参数实现跨越式推进 : 在 OpenAI 手稿声称打破整数乘法 $n \log n$ 下界后,数学开源社区搭建了实时追踪器展开极限优化接力。通过重新设计有限网络并移除二次瓶颈惩罚,开发者与研究人员借助 Codex 在短短数日内将上界修正项参数 $\kappa$ 从原始的 $2^{-182}$ 大幅推进至 $2^{-15}$,并完成 Lean 内核严格验证,展现了人机协同攻关数学前沿的惊人演化速度(来源: BorisMPower, Don’t Worry About the Vase)
本·阿弗莱克硬核解析 AI 电影制作底层技术引爆社区热议:影视名流熟稔 Tensor 与权重微调 : 好莱坞影星本·阿弗莱克在多档专访中展示深厚 AI 技术理解的视频在技术社区疯传。阿弗莱克不仅能娴熟自如地解释卷积神经网络、张量、边缘提取与 GPU 推理的底层数学逻辑,还详述了其创立并被 Netflix 收购的 AI 工作室如何通过冻结开源大模型骨干、自采高质量视频集微调最后一层权重,以在符合工业级电影审美标准的同时规避侵权风险,被技术社区盛赞为“硅谷级别的好莱坞导演”(来源: Latent Space)
专访 Periodic Labs:将物理实验与真实世界强化学习打造为 AI 科学家的演化基石 : 前 OpenAI 研究员 Liam Fedus 与前 Google DeepMind 研究员 Dogus Cubuk 在播客中深入拆解了新材料创企 Periodic Labs 的技术路线。他们指出,单纯依靠互联网文本预训练或合成逻辑推演无法真正突破物理未知,因为真实材料存在极其复杂的微观相变与测量噪声。团队正在将真实高通量实验室仪器封装为带环境反馈的强化学习闭环,把每次失败的物理合成轨迹作为高质量负样本,探索“合成超级智能”(来源: Latent Space)
Cloudflare 针对开发者 AI 代码死循环产生的天价账单全额退款并复盘架构隐患 : 一名开发者在使用 Codex 辅助编写 Cloudflare Durable Objects 服务时,因 AI 生成的告警重试逻辑陷入每秒数百次的自激死循环,短时间内产生过万美元数据库读写账单。经沟通 Cloudflare 予以全额免除,官方工程师在工单中详细复盘了现代“Vibe Coding”由于开发者缺乏底层代码审查,在无硬消费上限的云原生环境极易触发隐蔽金融雪崩的技术特征(来源: dotey)
💡 其他
Anthropic 承诺向白宫“创世纪任务”投入 1.5 亿美元支持国家级前沿科学计算 : 在白宫科技政策办公室峰会上,Anthropic 宣布承诺在未来三年内出资 1.5 亿美元算力与技术资源,深度参与美国国家级“创世纪任务”(Genesis Mission)。Anthropic 将与 NASA、美国国家卫生研究院等 15 家联邦科研机构及国家实验室紧密合作,部署 Claude 与自动化代码环境,为核聚变能量控制与量子计算等高难度科研攻关提供技术支持与专属培训(来源: Anthropic News)

麻省理工团队利用机器学习重构服务器动态调度以遏制数据中心能耗浪费 : 针对全球 AI 大模型算力爆发引发的数据中心电网危机,MIT 副教授 Christina Delimitrou 团队研发出基于深度学习的服务器能耗管理架构。该系统能实时预测微服务与云原生软件的资源争抢,将目前普遍仅运行在 15% 有效算力利用率的服务器集群进行动态调度与架构压缩,在无需额外扩建电力基础设施的前提下显著释放高密度算力潜能并降低电能损耗(来源: MIT News)