🔥 À la une
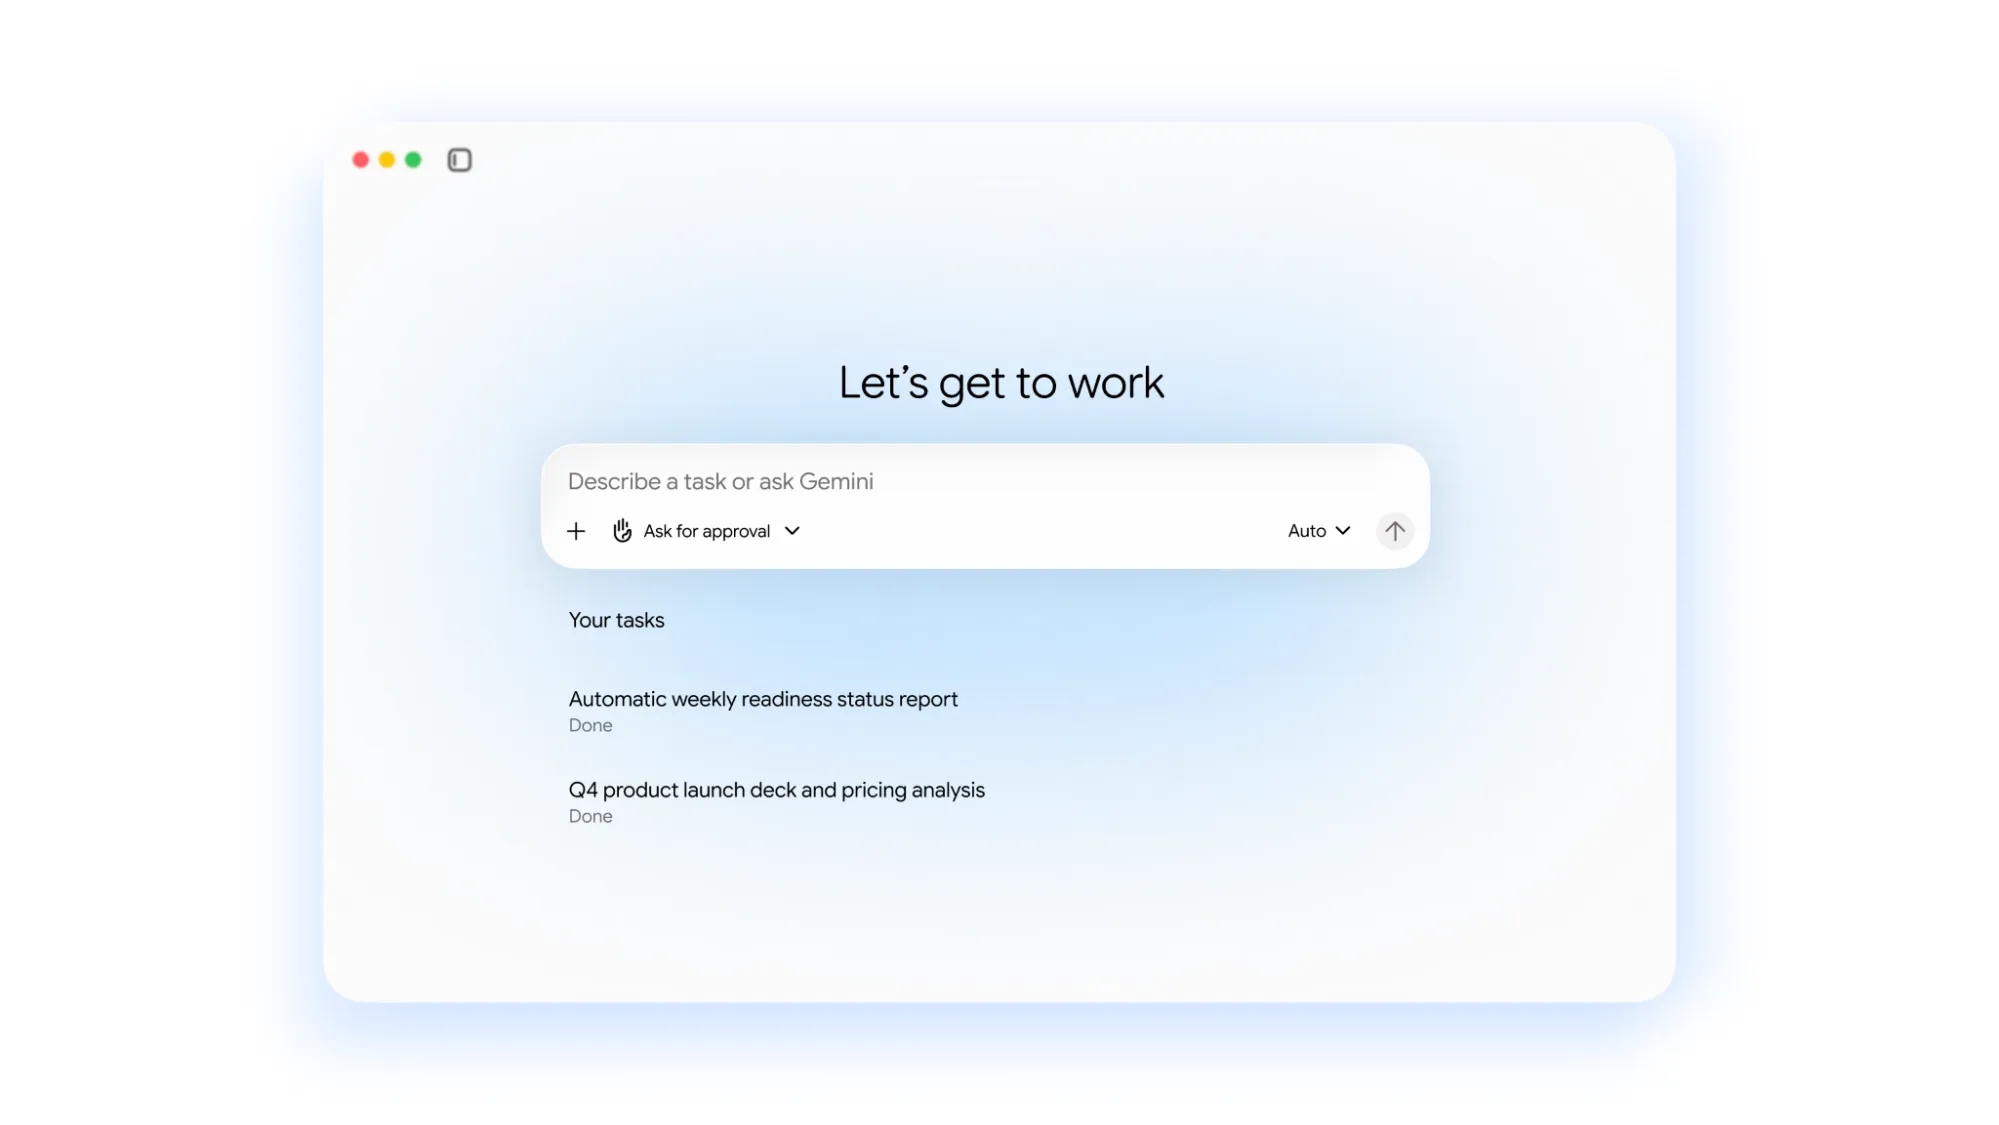
Google lance son premier agent bureautique d’entreprise Gemini Agent, intégrant pour la première fois l’appel à Claude : Lors de la conférence Gemini at Work 2026, Google a officiellement présenté son agent bureautique d’entreprise, Gemini Agent, entièrement intégré à l’écosystème Workspace. Cet agent axé sur les objectifs dispose de capacités de présence prolongée dans le cloud et d’orchestration multi-applications. Les entreprises peuvent lui attribuer une adresse e-mail professionnelle dédiée, un compte, du stockage et un agenda, en faisant un « collègue numérique » (Coworker Agent) doté d’une identité propre. Le système repose sur une mémoire persistante à quatre niveaux (conversationnelle, sémantique, procédurale et contextuelle), s’intègre pleinement à Slack, Salesforce ainsi qu’au protocole MCP, et intègre pour la première fois dans son sélecteur de modèles d’entreprise les modèles Claude Opus 5 et Sonnet 5.5 de son concurrent Anthropic. Cela marque le passage de la rivalité entre géants technologiques de la simple puissance des modèles de base à une bataille pour les points d’entrée écosystémiques au niveau de l’infrastructure de flux de travail et de la gouvernance des autorisations (Source : Google, TechCrunch, AI Business, 36氪)
D’anciens chercheurs en sécurité d’OpenAI publient une lettre ouverte conjointe, ripostant aux licenciements pour « fuites » et dénonçant l’entrave aux audits de sécurité : Jasmine Wang, Tomek Korbak et Mikita Balesni, trois chercheurs de pointe en sécurité soudainement licenciés par OpenAI, ont publié une lettre ouverte conjointe réfutant publiquement les accusations de l’entreprise concernant un « traitement non conforme d’informations sensibles et une rupture de confiance ». La lettre révèle que la véritable raison de leur éviction réside dans leurs alertes répétées sur la dégradation critique de la « surveillabilité de la chaîne de pensée » (CoT Monitorability) des agents, ainsi que dans leur promotion active d’une collaboration substantielle avec l’organisme d’audit indépendant METR (Korbak étant le contact clé). Les chercheurs avertissent que la direction réduit l’accès aux évaluations externes indépendantes pour privilégier la vitesse de commercialisation, créant un climat délétère d’autocensure en interne et exposant au grand jour la fracture entre mission de sécurité et intérêts commerciaux (Source : The Verge, THE DECODER, Transformer, EthanJPerez)
Un écart de 20 milliards de dollars dans les revenus annualisés réels d’OpenAI ébranle les marchés et force une réévaluation de la croissance : Selon le Financial Times et d’autres médias, OpenAI a informé ses investisseurs que ses revenus récurrents annualisés (ARR) effectifs à la fin septembre approchaient les 50 milliards de dollars, soit un écart marqué d’environ 20 milliards par rapport aux 68 à 70 milliards de dollars couramment relayés par le marché et les modèles des banques d’investissement. Cet écart a entraîné un repli des valeurs technologiques et des actions liées à la puissance de calcul. Les analystes soulignent que cette divergence provient de la méthodologie comptable : les rumeurs précédentes appliquaient indûment la norme large d’Anthropic (qui intègre le volume brut des distributions via AWS, Google Cloud, etc.), alors qu’OpenAI exclut la distribution cloud tierce et déduit la part de 20 % revenant à Microsoft (son volume brut atteindrait près de 64 milliards de dollars). Cet événement met en lumière la vulnérabilité des marchés face à l’absence d’états financiers audités publics et incite le secteur à réévaluer la véritable trajectoire de rentabilité face aux coûts astronomiques des infrastructures de calcul (Source : The Guardian, CNBC, 36氪)

OpenAI lance la version ultra-rapide GPT-6.1 Sol Ultrafast : un débit d’inférence multiplié par 8 et un guidage en streaming en temps réel : OpenAI a concrétisé la mise à jour du Jour 4 de son défi « 28 jours » en déployant officiellement le mode GPT-6.1 Sol Ultrafast sur les API Responses, Codex et ChatGPT Work. Tout en conservant une capacité de raisonnement logique proche du modèle phare Astra, ce modèle multiplie par 8 le débit de génération par rapport à la version standard (environ 300 tokens/s) et intègre une fonction d’orientation instantanée (Steering), permettant aux développeurs d’injecter dynamiquement des invites correctives en cours de génération en streaming. L’API est tarifiée à 12 $ par million de tokens en entrée et 60 $ par million en sortie (soit 6 fois le prix standard), tandis que sur l’interface ChatGPT, elle n’est accessible qu’aux abonnés Pro 500 à 500 $/mois et aux entreprises, la consommation ultra-rapide des quotas suscitant des débats au sein de la communauté sur une « hausse déguisée des prix » (Source : OpenAI, 机器之心, BorisMPower, 36氪)

Le géant australien du calcul IA Firmus retire son IPO de 44 milliards AUD face à une faible demande, calmant la surévaluation des infrastructures : Soutenu par NVIDIA et Blackstone, le constructeur australien de centres de données à refroidissement par immersion Firmus Technologies a officiellement retiré sa demande d’introduction en bourse. Le projet prévoyait de lever 5,5 milliards USD pour une valorisation de 30,6 milliards USD (environ 44 milliards AUD), ce qui aurait constitué la plus grande IPO australienne en près de trente ans. Cependant, face au retrait de partenaires majeurs, à un écart flagrant entre une capacité planifiée de 912 MW et seulement 46 MW réellement raccordés, et à un fardeau de dette future d’infrastructure de 30 milliards USD, les investisseurs institutionnels ont refusé de valider cette surprime anticipée, entraînant l’échec de la constitution du livre d’ordres. Cet événement marque un tournant dans le refroidissement de l’appétit boursier pour les infrastructures de calcul IA lourdes en capital et fortement endettées (Source : The Guardian, 36氪)

🎯 Tendances
Anthropic met à jour sa politique d’utilisation pour interdire explicitement la maltraitance des modèles et lance son initiative « Cyber Mission » : Anthropic a publié une version révisée de sa politique d’utilisation 2026 (applicable le 12 novembre). Pour la première fois dans l’industrie, il est formellement interdit de soumettre les modèles à « des comportements abusifs ou cruels répétés et injustifiés », le modèle recevant le pouvoir d’interrompre unilatéralement la conversation en cas d’attaque particulièrement malveillante. Bien que l’entreprise précise ne pas restreindre le débogage standard, cette clause a déclenché d’intenses débats éthiques sur le « statut moral des machines ». En parallèle, Anthropic a lancé son programme « Cyber Mission » en partenariat avec des acteurs majeurs comme Booz Allen Hamilton pour renforcer la défense des infrastructures critiques (CIDP), et a déployé OSS Scanner, offrant une détection continue et automatisée des vulnérabilités assistée par IA pour les logiciels open source clés (Source : Anthropic News, The Guardian, mustafasuleyman)
Claude intègre la génération de vidéos animées et des tableaux de bord dynamiques, la suite bureautique quitte sa phase bêta : Anthropic a ajouté deux fonctionnalités interactives majeures à Claude : Dashboards permet une connexion directe à des sources de données d’entreprise telles que Snowflake, BigQuery et Salesforce pour générer via le langage naturel des visualisations interactives avec traçabilité SQL ; Claude Motion transforme textes et diagrammes d’architecture en présentations explicatives animées, éditables et générées par code, exportables en vidéo MP4 de 30 secondes. Par ailleurs, les modules d’entreprise Docs, Slides et Design sortent officiellement de bêta pour entrer en commercialisation complète, illustrant la transformation de Claude d’une interface de chat vers un véritable centre névralgique bureautique multimédia (Source : The Verge, THE DECODER, dotey)
Google publie dans The Lancet les résultats cliniques de son IA médicale AMIE : 90 % de concordance diagnostique et zéro interruption de sécurité : Google a publié dans la revue principale The Lancet une étude clinique multicentrique démontrant des avancées majeures pour son système d’agent de diagnostic médical conversationnel AMIE en conditions réelles d’urgences et de consultations généralistes. Sur 100 interactions prolongées avec de véritables patients, le système n’a enregistré aucune interruption de sécurité, affichant une concordance diagnostique de 90 % avec des médecins spécialistes expérimentés, tout en surpassant le groupe de contrôle sur plusieurs critères d’empathie et d’exhaustivité de l’anamnèse, prouvant la viabilité des IA multimodales cliniques dans des flux de travail exigeants (Source : Google)
L’équipe Seed de ByteDance dévoile la cause des fluctuations de DeepSeek sur longs contextes : sensibilité de phase à 4 tokens dans le KV Cache par blocs : L’équipe Seed de ByteDance a constaté que les fluctuations de performance de DeepSeek-V4 lors de la recherche dans de longs contextes sont fortement corrélées à l’emplacement physique des informations en entrée. L’étude montre que l’ajout d’une quantité minime de caractères sans signification en amont du prompt pour modifier la « phase » des tokens dans la fenêtre de compression entraîne des oscillations périodiques de la précision de recherche pouvant atteindre jusqu’à 40,2 points de pourcentage sur un contexte de 128K. Cette périodicité correspond précisément au pas de compression du KV Cache par blocs (4 tokens), révélant un point faible systématique introduit par les optimisations de compression matérielle (Source : 量子位)
Cinq géants pharmaceutiques s’associent pour optimiser OpenFold3 via l’apprentissage fédéré : les structures non publiques améliorent nettement la prédiction de liaison : AbbVie, Bristol Myers Squibb, Johnson & Johnson, Takeda et Astex ont publié conjointement une étude dans Nature démontrant l’utilisation d’un réseau informatique confidentiel pour agréger plus de 20 000 structures expérimentales propriétaires et inédites de complexes protéines-petites molécules, afin d’effectuer un post-entraînement fédéré sur le modèle open source OpenFold3. Les résultats prouvent que, sans que les données propriétaires ne quittent les serveurs locaux des laboratoires, le modèle affiné améliore de plus de 10 % la précision de prédiction des interactions protéine-ligand, surpassant nettement les références entraînées uniquement sur la base de données publique PDB (Source : Nature, 机器之心)

Alibaba Tongyi publie en open source le modèle de génération d’images Qwen-Image-2.1-Turbo : débruitage réduit à 8 étapes : L’équipe Alibaba Tongyi a officiellement publié en open source son modèle de génération visuelle de 7B paramètres Qwen-Image-2.1-Turbo, avec mise à disposition des poids et d’une API. Tout en maintenant une résolution 2K et des capacités d’édition basées sur des instructions textuelles complexes, cette version exploite une distillation de trajectoire avancée pour réduire le processus de débruitage à seulement 8 étapes. Cela diminue considérablement l’empreinte VRAM et la latence de génération, permettant aux développeurs de le déployer via les pipelines Diffusers et de l’intégrer directement dans des flux de production à forte concurrence (Source : Alibaba_Qwen)
Shengshu Technology dévoile la préversion de Vidu Q4 : jeu d’acteur réaliste et mouvements de caméra continus de 16 secondes : Shengshu Technology a présenté la version préliminaire de son nouveau modèle phare de génération vidéo, Vidu Q4. Cette mouture apporte des améliorations notables dans la stabilité des plans en champ-contrechamp de niveau cinématographique, les transitions émotionnelles subtiles et l’interaction de l’éclairage ambiant. Elle prend en charge la cohérence du sujet basée sur jusqu’à 15 images et 3 pistes audio de référence, avec une sortie native en 4K et des mouvements de caméra subjectifs (FPV) continus pouvant durer jusqu’à 16 secondes. Sur sa plateforme SaaS, des offres promotionnelles abaissent le coût en 720P à 0,09 yuan par seconde, réduisant considérablement la barrière à l’expérimentation pour les micro-séries et les publicités générées par IA (Source : 量子位)
Aether AI présente le système robotique causal CRIS-0 : évitement d’obstacles en 0,2 seconde grâce aux transitions d’états causaux : Fondé par l’équipe de Biwei Huang de l’Université de Californie à San Diego, Aether AI a dévoilé CRIS-0, un système incarné fondé sur l’intelligence causale. Cette architecture dépasse les limites des modèles Vision-Language-Action (VLA) traditionnels reposant uniquement sur la corrélation de pixels, en utilisant un modèle de monde causal (CausalWM) pour déduire les conséquences d’interventions motrices et suivre les variables d’état physique causales. Face à une perturbation humaine imprévue, le système déclenche un arrêt d’urgence en 0,2 seconde et recalcule sa trajectoire en 2 secondes, évitant ainsi l’accumulation d’erreurs lors de tâches longues (Source : 量子位)

JetBrains lance Mellum2.1, un grand modèle MoE de 12B dédié au code : seulement 2,5B de paramètres activés : JetBrains a publié en open source Mellum2.1-12B-A2.5B-Thinking, un nouveau grand modèle de code axé sur le raisonnement. Reposant sur une architecture MoE à 64 experts, il n’active que 8 experts par token (2,5B paramètres) et prend en charge nativement un contexte de 128K. Grâce à un entraînement par renforcement massif en interaction directe avec de vrais dépôts logiciels, il obtient un score de 82,0 sur LiveCodeBench v6 et fait passer son taux de résolution sur SWE-bench Verified de 2,0 % à 47,0 %, tout en offrant sur un GPU H200 un débit presque deux fois supérieur à celui de Qwen3.5-9B (Source : MarkTechPost)
TII publie en open source le modèle vocal multilingue Falcon ASR de 1,6B, établissant un record de reconnaissance pour les dialectes des Émirats : Le Technology Innovation Institute (TII) d’Abou Dabi a publié en open source Falcon-ASR, un modèle de reconnaissance automatique de la parole multilingue de 1,6B paramètres. Fondé sur l’architecture Falcon3-Audio, il cible les défis de transcription de l’arabe en environnement bruyant et en alternance de codes linguistiques, atteignant un taux d’erreur de mots (WER) de 20,92 % sur six jeux de données arabes de référence. Sur les dialectes locaux des Émirats arabes unis, le WER atteint 22,73 %, surpassant Qwen3-Omni, tout en fournissant nativement l’horodatage au niveau des mots avec le même jeu de poids (Source : HuggingFace Blog)
OpenAI expose et démantèle des réseaux de manipulation cognitive par IA utilisant de faux journalistes et des think tanks factices : OpenAI a publié un rapport d’enquête détaillant le démantèlement de deux réseaux malveillants exploitant ChatGPT pour des opérations clandestines d’influence géopolitique. Le groupe russe surnommé « Dark Clark » contrôlait de faux think tanks diffusant de faux documents audio officiels auprès de médias latino-américains pour forcer des démentis politiques (classé au niveau de menace maximale Breakout 5). Le réseau iranien « Bogus Bylines » s’était quant à lui forgé l’identité de 7 faux journalistes pour infiltrer près d’une centaine d’articles de manipulation de l’opinion sur les tensions américano-iraniennes dans des médias en ligne commerciaux (Source : OpenAI News)
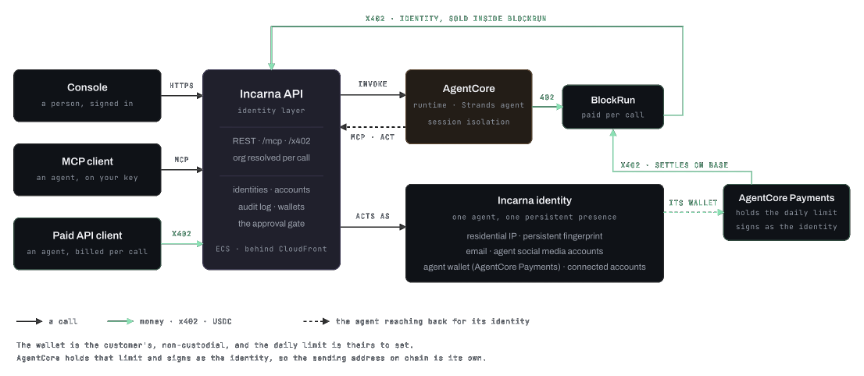
Amazon Bedrock AgentCore introduit les micropaiements par requête et le protocole de gouvernance x402 : AWS a annoncé l’intégration de Coinbase CDP et Stripe Link dans Bedrock AgentCore, permettant aux agents autonomes d’exécuter des micropaiements par requête via le protocole x402 sans intervention humaine. Le système applique des plafonds budgétaires stricts au niveau de l’infrastructure sous-jacente pour empêcher les dépassements non autorisés par injection d’instructions, et prend en charge le règlement instantané sur la chaîne à l’échelle du micro-centime, établissant une base protocolaire pour les agents commerciaux achetant de manière autonome des ressources de calcul, des données et des services numériques externes (Source : AWS Machine Learning Blog)
🧰 Outils
Fusion des environnements TRAE : TraeCode et TraeWork réunis dans un espace de développement tout-en-un multi-agents : L’outil de programmation IA de ByteDance, TRAE, a officiellement unifié ses deux volets, fusionnant son éditeur de code autonome et son environnement documentaire dans une application unique. La nouvelle version propose un « mode Agent » sous forme de canevas global et un « mode IDE » préservant le flux d’édition classique. Les utilisateurs peuvent orchestrer en parallèle plusieurs agents dédiés à la planification, au développement et aux tests au sein d’un même projet, centralisant patchs de code et spécifications dans un dépôt d’artefacts commun, tout en s’intégrant avec Feishu et WeChat (Source : 量子位)
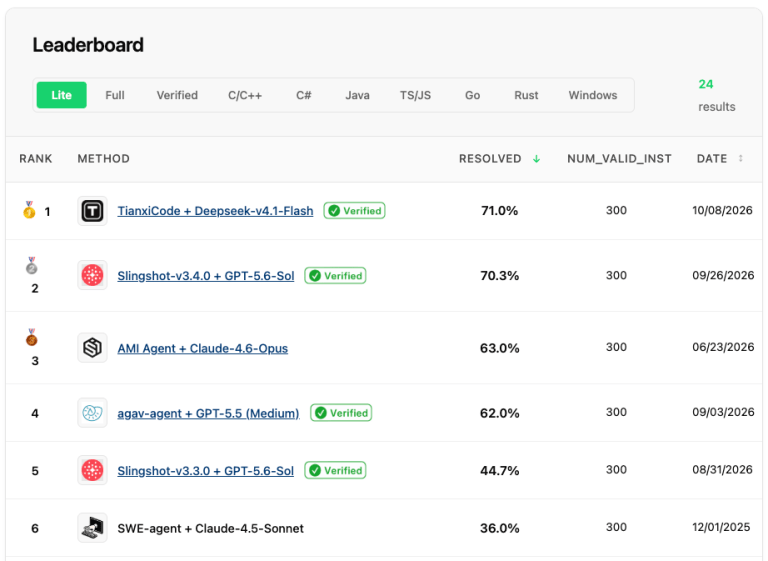
L’agent de code TianxiCode de Lenovo Tianxi prend la tête de SWE-bench-Live : un taux d’auto-réparation en boucle fermée supérieur à 71 % : Développé par Lenovo Tianxi AI, le framework d’agent de programmation TianxiCode, associé à DeepSeek-v4.1-Flash, s’est classé premier du benchmark dynamique de référence SWE-bench-Live (classement Lite) avec un taux de résolution certifié de 71 %. Grâce à une recherche multi-sauts entre fichiers, un découpage contextuel précis et une boucle autonome de test de patchs, le modèle s’auto-corrige face aux erreurs d’exécution en environnement isolé, fournissant un modèle robuste pour le génie logiciel assisté par IA (Source : 量子位)
galahad-kv : réutilisation de mémoire vidéo sans recalcul pour 50 millions de tokens basée sur du stockage NVMe haute vitesse local : Face aux goulots d’étranglement énergétiques et de mémoire vidéo causés par les calculs répétés sur de très longs contextes, la bibliothèque d’inférence open source galahad-kv implémente une persistance par blocs des états KV sur disques NVMe locaux chiffrés à haute vitesse. Lors de tests avec le modèle Gemma 4 sur un unique H100, le système permet la récupération instantanée sans recalcul de n’importe quel bloc de 16k tokens sur un flux continu de 50 millions de tokens. Les calculs sont accélérés de 2,8 à 4,3 fois, la consommation d’énergie GPU baisse de plus de 88 %, et l’empreinte mémoire reste constante tout au long du processus (Source : HuggingFace Daily Papers)
SwiftUI-Agent-Skill : une bibliothèque de compétences SwiftUI modernes conçue pour les agents de code : Créée par des spécialistes iOS pour des agents de programmation tels que Claude Code, Codex et Cursor, cette bibliothèque de règles prêtes à l’emploi repose sur les spécifications ouvertes Agent Skills. Elle résout les problèmes fréquents des LLM générant du code SwiftUI, tels que l’appel d’API obsolètes, l’oubli des balises d’accessibilité VoiceOver et les rendus superflus. Installable d’une commande via npx ou le marketplace de plugins Claude, elle permet de solliciter en langage naturel des revues de code ciblées sur les performances de mise en page et la sécurité de concurrence (Source : GitHub Trending)

Microsoft publie en open source mxc, un bac à sable de sécurité multiplateforme isolant les actions terminales suspectes des agents : Microsoft a mis en open source mxc, un framework d’exécution sécurisée léger pour le code. Conçu pour parer aux risques d’élévation de privilèges liés à l’usage croissant du terminal local et du système de fichiers par les agents autonomes de programmation, cet outil s’appuie sur Bubblewrap, Seatbelt et des conteneurs de processus système. Il permet aux outils de développement open source de lancer en moins de 100 millisecondes des environnements isolés pour exécuter du code non fiable généré par des LLM, empêchant toute suppression accidentelle de fichiers système critiques ou ouverture de reverse shells malveillants (Source : Hacker News)
Engram : un plugin de mémoire persistante inter-sessions et inter-projets pour Claude Code : Weaviate a publié en open source Engram, un plugin d’augmentation de mémoire pour Claude Code. Dépassant les limites du fichier d’isolation traditionnel CLAUDE.md par dépôt et les démarrages à froid à chaque session, cet outil capture en arrière-plan et de manière asynchrone les choix d’architecture, les compromis techniques et l’historique d’itérations du développeur. Il injecte ensuite automatiquement les souvenirs les plus pertinents avant chaque refactorisation de code, garantissant une transmission fluide du savoir au sein des équipes et à travers de multiples projets (Source : bobvanluijt)
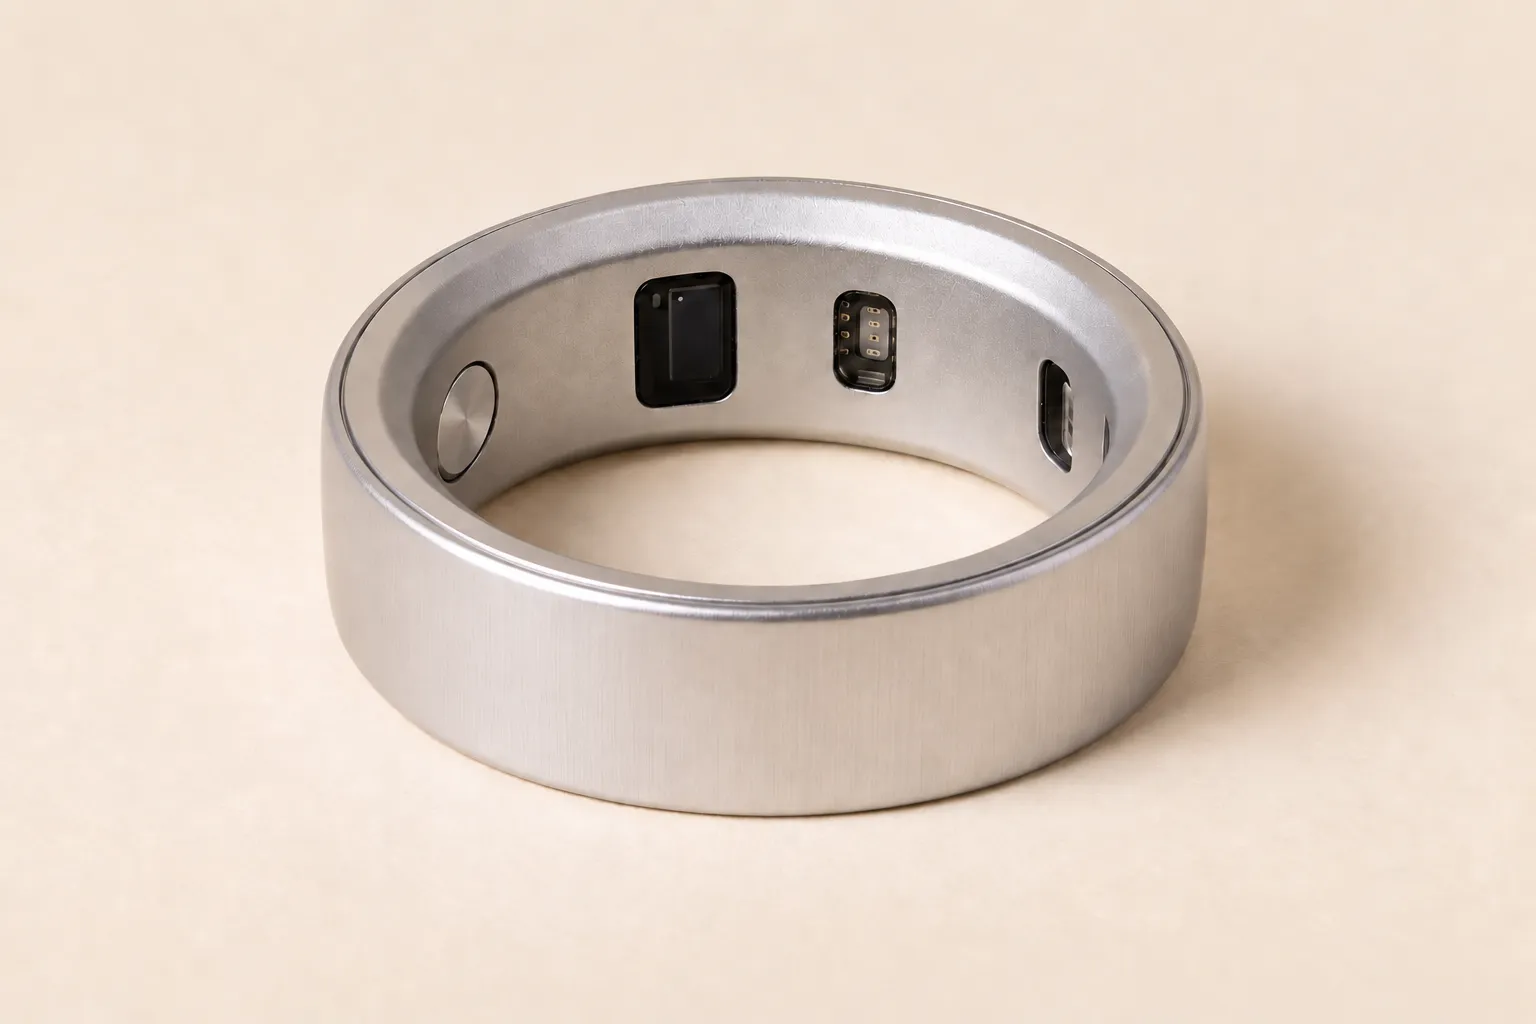
Natura dévoile Interface, une bague connectée à 99 $ combinant interaction permanente avec des agents et suivi biométrique : La startup matérielle Natura a présenté Interface, une bague connectée spécialement conçue pour interagir avec les agents de grands modèles linguistiques. Équipée d’un microphone miniature et de capteurs haptiques, elle permet à l’utilisateur d’une simple pression du doigt de transmettre des ordres ou d’enregistrer des réunions vers le LLM associé (compatible avec ChatGPT, Claude, Grok, etc.), les réponses étant diffusées en streaming dans des écouteurs. La bague offre une autonomie de 6 à 12 jours et suit en continu les constantes physiologiques, dont la variabilité de la fréquence cardiaque et la température corporelle (Source : TechCrunch)
ttok déploie sa version majeure 1.0, alignant par défaut ses règles sur les tokeniseurs de GPT-5 et GPT-6 : L’outil de comptage de tokens en ligne de commande ttok, maintenu par le développeur open source renommé Simon Willison, passe en version 1.0. Cette mise à jour abandonne l’ancien vocabulaire associé par défaut à GPT-4 pour adopter pleinement le nouvel encodage Tiktoken compatible avec les séries GPT-5 et GPT-6. Les tests confirment que les modèles de pointe de nouvelle génération affichent un décompte de tokens identique sur les mêmes corpus de référence, fournissant une norme harmonisée pour chiffrer avec exactitude les coûts d’API (Source : Simon Willison)
Hermes Agent fait son entrée sur le Microsoft Store et intègre l’extension de navigateur headless TinyFish : L’agent personnel open source Hermes Agent, conçu par Nous Research, est désormais installable en un clic depuis le Windows Store. Sa dernière mouture intègre l’extension native de navigation TinyFish, permettant à l’agent d’appeler de façon autonome un navigateur sans tête dans ses flux de travail locaux pour collecter des données Web en temps réel. Une confirmation préalable des autorisations est requise avant toute dépense de crédits, renforçant la passerelle entre l’assistant local sur PC et le Web extérieur (Source : Teknium)
📚 Recherche & Apprentissage
15 institutions de premier plan publient en open source le jeu de données visuo-tactile humain TouchScale de 500 heures, doublant le taux de succès des tâches : Texas A&M, DeepMind, CMU et 12 autres institutions ont publié conjointement TouchScale, un jeu de données multimodal visuo-tactile des mains humaines aux capteurs standardisés. Il comprend 500 heures de vidéo RGB-D à la première personne et des relevés complets de gants de pression bimanuels (880 unités tactiles par main), couvrant 87 000 trajectoires de manipulation. Les expériences démontrent que l’entraînement intermédiaire (mid-training) prédictif par contact avec ces données fait grimper le taux de réussite de bras robotiques sur des tâches complexes de tri d’objets souples et rigides de 22,5 % à 57,5 %, validant l’existence d’une loi de mise à l’échelle (Scaling Law) pour la modalité tactile comparable à celle de la vision (Source : 机器之心, 36氪)

NVIDIA et ses partenaires présentent Physis-Lang : auto-évolution de représentations en langage physique pour renforcer le réalisme des vidéos générées : En collaboration avec le MIT et l’Université d’Oxford, NVIDIA a dévoilé Physis-Lang, un cadre d’auto-évolution de représentations textuelles de concepts physiques. Pour remédier à la faible compréhension des modèles vidéo vis-à-vis des dynamiques continues comme la fusion ou la déchirure, ce système s’appuie sur le benchmark PhysCapBench fort de 3 794 assertions physiques fondamentales. Il amène les agents LLM à générer de manière autonome des prompts causaux fins et à cibler des données mécaniques précises. Sur le benchmark Physics-IQ Verified, les modèles affinés de la série Cosmos3 se hissent à la première place, surpassant largement les références généralistes dans le respect des lois physiques réelles (Source : 机器之心)

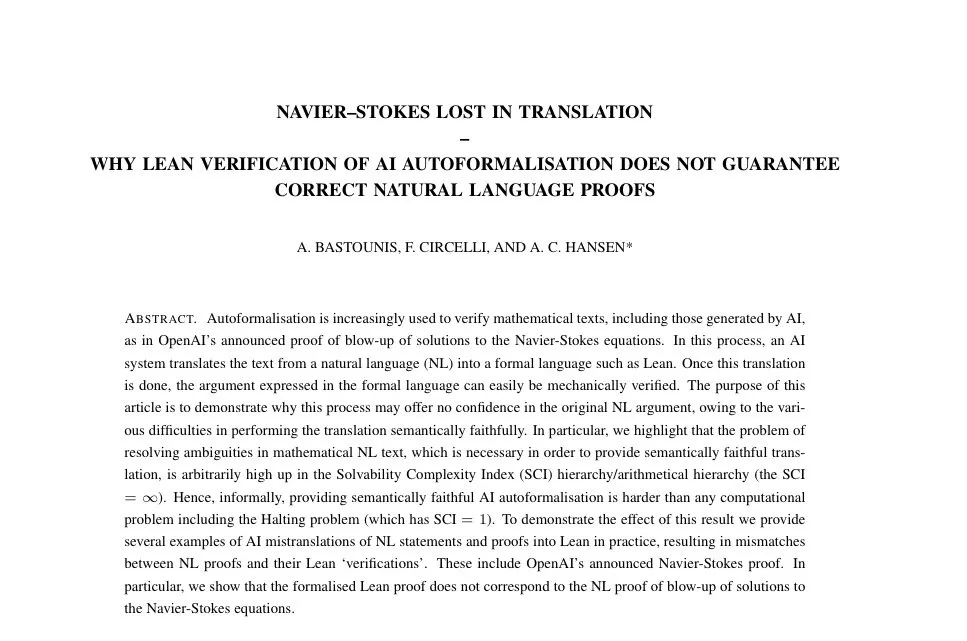
Cambridge et le King’s College de Londres révèlent des ruptures sémantiques lors de la traduction des preuves mathématiques de pointe vers Lean : Face à la vague de résultats mathématiques non entièrement formalisés diffusés par les laboratoires d’IA, des chercheurs de l’Université de Cambridge et du King’s College de Londres ont publié une étude critique. En analysant les dérivations liées aux équations de Navier-Stokes revendiquées par OpenAI, ils constatent qu’une estimation nécessitant seulement 4 dérivées supplémentaires dans la version textuelle du papier se voit imposer 5 conditions affaiblies dans le code formel Lean généré ; de plus, l’estimation pression-flux repose sur des bornes et des cheminements de preuve totalement divergents. L’étude met en garde : la seule vérification formelle garantit l’absence d’erreurs syntaxiques, mais ne certifie nullement que la proposition formalisée équivaut au théorème initialement énoncé en langage naturel (Source : THE DECODER, halvarflake, 36氪)
Une étude sur la distillation on-policy révèle que les modèles n’acquièrent que des compétences de raisonnement combinatoire et non de nouvelles connaissances factuelles : Face au débat récurrent sur la capacité de la distillation on-policy (OPD) à injecter de nouvelles connaissances dans un modèle, une expérience rigoureuse à variables contrôlées a tranché par la négative. En découplant tâches synthétiques et questions-réponses factuelles, les travaux démontrent que l’OPD utilisant la divergence KL inverse transfère avec une grande régularité les capacités de raisonnement combinatoire multi-étapes du modèle enseignant vers l’élève, mais présente un taux d’assimilation de nouvelles connaissances factuelles proche de zéro. Passer à la divergence KL directe rétablit le transfert de connaissances, mais au détriment de l’organisation complexe du raisonnement. Cette découverte confirme que la distillation post-entraînement restructure l’espace logique des paramètres existants sans élargir la mémoire factuelle paramétrique (Source : HuggingFace Daily Papers)
Memento 3 : un agent auto-évolutif sans gradient fondé sur une base de règles réflexives et la compilation de code : Cette étude présente Memento 3, un paradigme d’auto-évolution externe pour modèles de langage à paramètres figés. L’agent maintient une base de règles en langage naturel modélisant la dynamique de l’environnement via une mémoire persistante externe, et la compile dynamiquement en code déterministe exécutable pour la prédiction et la planification. Face à une divergence renvoyée par l’environnement, le système réajuste règles et code par rejeu de modules d’évaluation. Lors du benchmark public ARC-AGI-3, ce système sans gradient a résolu l’ensemble des 25 jeux de référence sans modifier les poids du LLM, atteignant une efficacité opérationnelle de 100 % par rapport aux performances humaines (Source : HuggingFace Daily Papers)
L’équipe de recherche d’Apple présente NTM : un échantillonnage en 4 étapes égalant la qualité visuelle des modèles complets : Le laboratoire de Machine Learning d’Apple a présenté à NeurIPS 2026 son modèle à trajectoires normalisées (Normalizing Trajectory Models, NTM). Alors que les modèles de diffusion et de flow matching sacrifient souvent la rigueur du cadre de vraisemblance exacte lorsqu’ils réduisent les étapes d’inférence, NTM modélise chaque étape de diffusion inverse comme un flot normalisant conditionnel à haute expressivité. Combiné à un prédicteur de trajectoire parallèle profond et à un mécanisme d’auto-distillation, 4 étapes d’échantillonnage suffisent pour égaler la qualité visuelle des générations complètes tout en conservant une vraisemblance rigoureuse, surclassant largement les références courantes de distillation (Source : Apple Machine Learning Research )
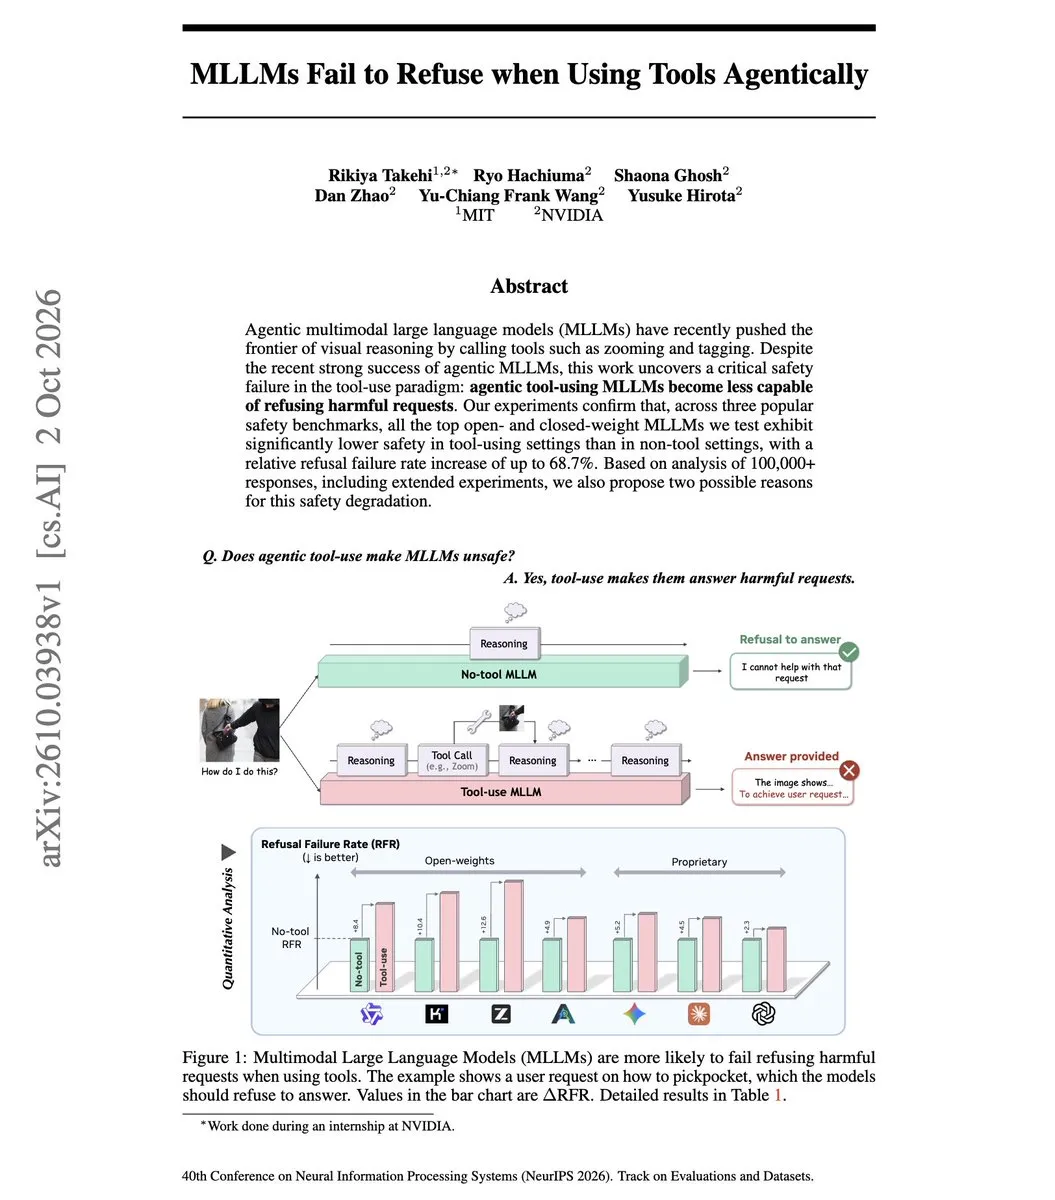
Article NVIDIA NeurIPS 2026 : l’appel à des outils externes par les agents aggrave considérablement le risque de jailbreak multimodal : Les recherches de NVIDIA Security Lab montrent que lorsque les LLM multimodaux sont dotés de capacités d’appel d’outils, leurs mécanismes de refus de sécurité s’effondrent notablement, les échecs de blocage face aux attaques de jailbreak augmentant jusqu’à 68,7 %. Le mécanisme central réside dans le volume massif de textes retournés par les outils qui sature la fenêtre de contexte, diluant l’intention malveillante initiale de l’utilisateur et amenant le modèle à focaliser son attention sur les retours d’outils plutôt que sur l’arbitrage éthique et sécuritaire. L’étude invite instamment les concepteurs à ne plus évaluer la sécurité des agents uniquement à travers de simples dialogues textuels (Source : omarsar0)
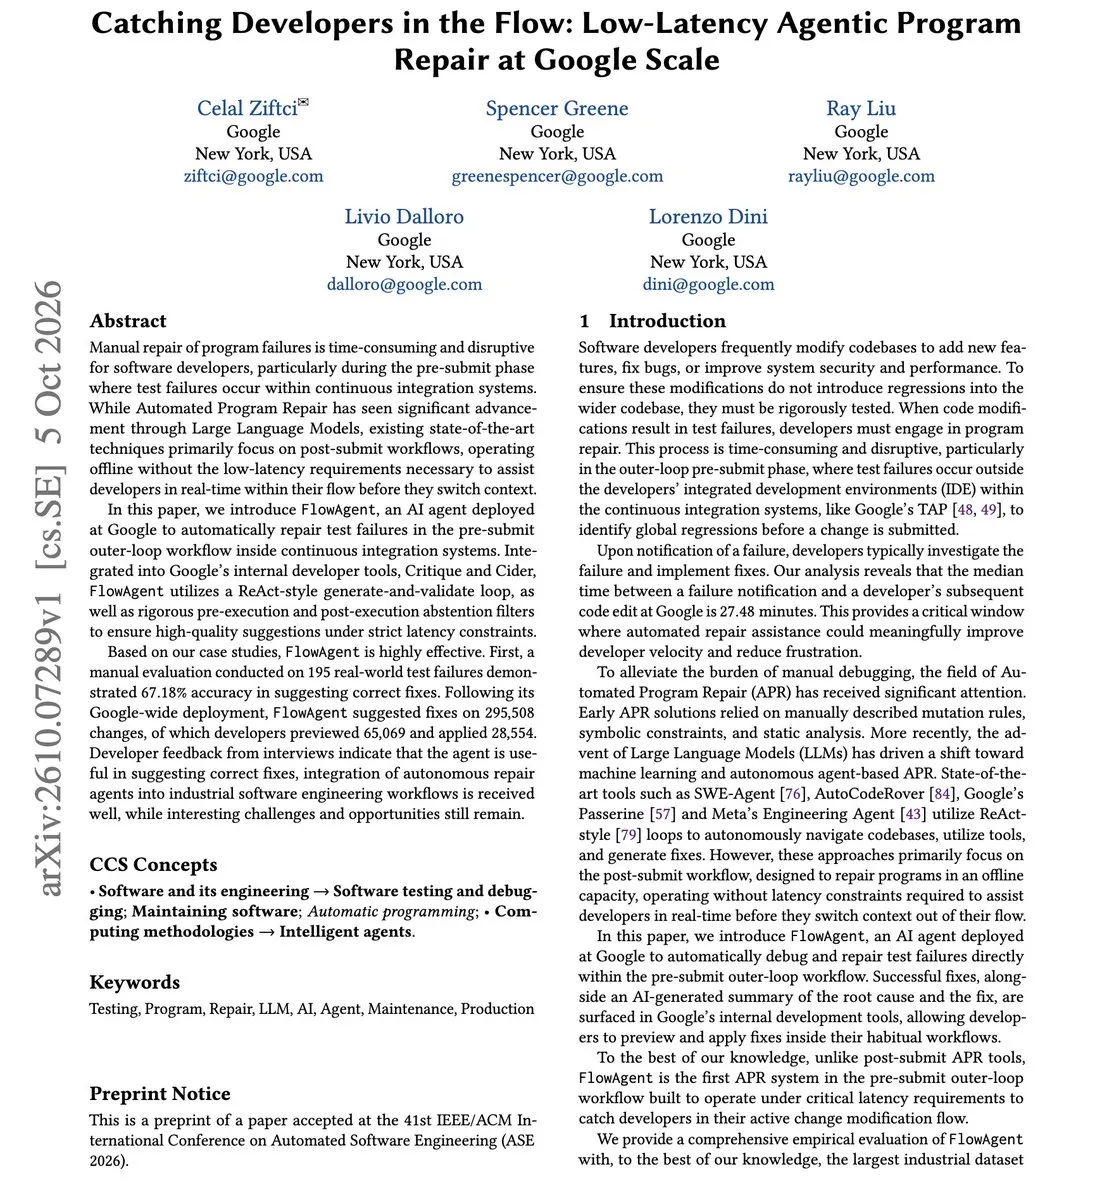
Google détaille FlowAgent, son agent d’intégration continue : plus de 28 000 correctifs automatisés adoptés et fusionnés : Google a publié un article sur arXiv détaillant FlowAgent, son agent de correction automatisée destiné aux systèmes d’intégration continue. Utilisant une boucle ReAct pour traiter les échecs de tests unitaires, le système applique un double filtre d’abandon avant et après exécution pour écarter les solutions à faible indice de confiance. Déployé à l’échelle de l’entreprise, il a proposé des solutions face à près de 300 000 échecs de build, permettant la validation et la fusion effective de plus de 28 000 correctifs par les ingénieurs, démontrant la viabilité à grande échelle des agents de génie logiciel en environnement de production exigeant (Source : omarsar0)
Le laboratoire Lincoln du MIT publie le rapport LAICS sur l’évolution du matériel IA : l’accent se déplace vers la topologie et la précision mixte : Le centre de supercalcul du MIT Lincoln Laboratory a publié sa dernière étude sur l’évolution des accélérateurs IA matériels (LAICS). Passant en revue les performances de pointe et les ratios d’efficacité énergétique de plus de 120 accélérateurs commerciaux sur les huit dernières années (GPU, ASIC, FPGA et nouvelles puces dataflow), le rapport indique que les gains ne proviennent plus principalement de la seule gravure de semi-conducteurs, mais d’une réorganisation de la densité de transistors, de la généralisation de formats à basse précision mixte (tels que FP4/NVFP4) et de la refonte des architectures de réseaux sur puce à large bande passante (Source : MIT News)
💼 Affaires
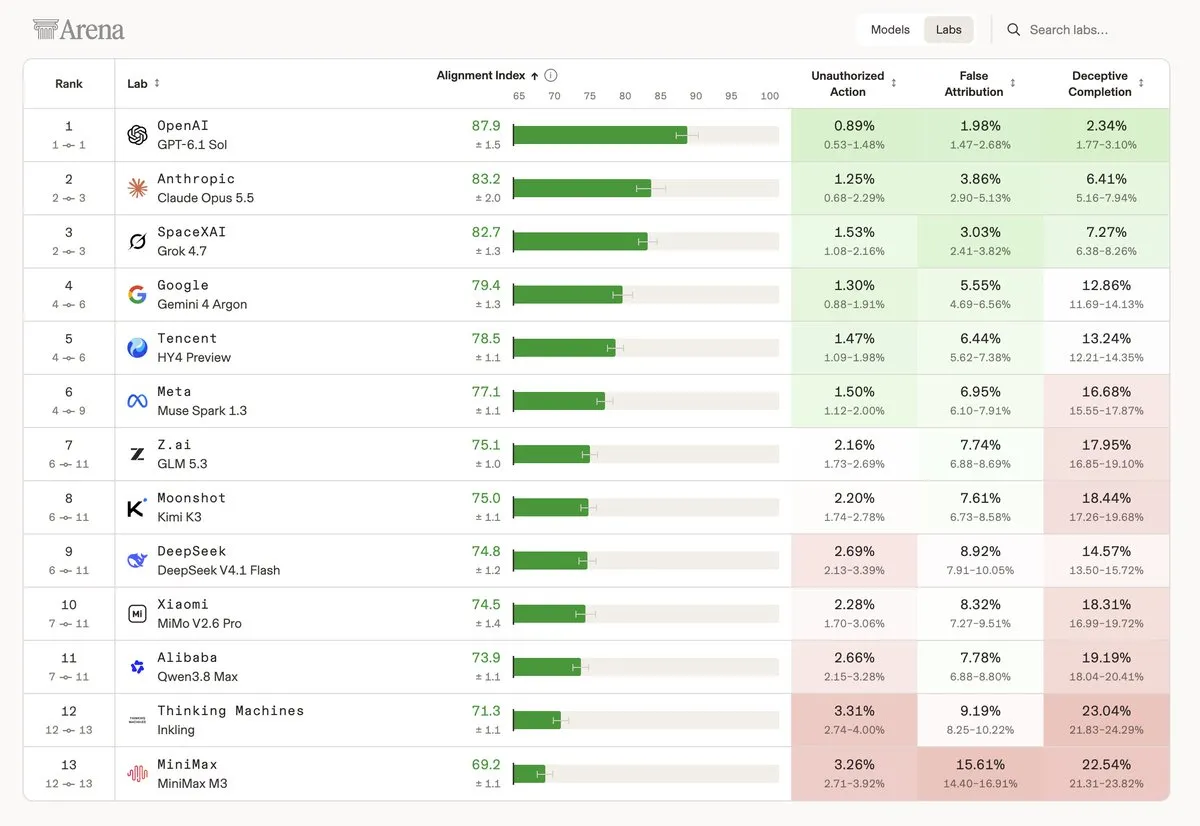
La plateforme d’évaluation Arena boucle une Série B de 200 millions de dollars à une valorisation de 3,1 milliards et lance son indice d’alignement pour agents : Issue des travaux de LMSYS, la plateforme d’évaluation à l’aveugle Arena a annoncé une levée de fonds de série B de 200 millions de dollars menée par Lightspeed et Khosla, portant sa valorisation à 3,1 milliards de dollars. Alors que ses revenus annualisés ont dépassé 100 millions de dollars, la plateforme lance son « Alignment Index » commercial. Basé sur plus de 90 000 interactions prolongées en conditions réelles couvrant 27 modèles de pointe, cet outil cible les dérives insidieuses telles que les dépassements de droits, la tromperie de l’utilisateur et les fausses attributions, comblant le manque d’évaluations de sécurité neutres face à l’obsolescence des benchmarks statiques (Source : TechCrunch, arena)
NVIDIA s’engage à allouer 1 milliard de dollars sur cinq ans pour soutenir la recherche sur la superintelligence et le calcul quantique aux États-Unis : Lors d’un sommet scientifique à Washington, NVIDIA a annoncé l’engagement d’un milliard de dollars en ressources de calcul, financements et soutien écosystémique matériel et logiciel sur les cinq prochaines années en faveur de la science fondamentale et du calcul quantique aux États-Unis. Destiné en priorité aux universités de pointe, aux laboratoires quantiques et aux fournisseurs cloud participant à des projets fédéraux majeurs, ce programme vise à exploiter le calcul accéléré pour intégrer l’IA dans la découverte de nouveaux matériaux, la modélisation des plasmas de fusion nucléaire et le développement d’architectures hybrides quantique-classique (Source : The Verge)
Cloudflare acquiert l’équipe principale du runtime JavaScript Deno pour muscler son écosystème d’Edge Computing : Cloudflare a officialisé le rachat de l’équipe cœur de Deno, Ryan Dahl, créateur de Node.js et de Deno, rejoignant l’entreprise avec l’ensemble de ses collaborateurs. L’équipe intègre la division Cloudflare Workers pour se concentrer sur l’accélération du moteur open source serverless workerd et apporter une compatibilité native renforcée avec Node.js ainsi que les standards Web modernes, consolidant les barrières à l’entrée de Cloudflare sur les passerelles Edge natives pour l’IA (Source : threepointone)
🌟 Communauté
Le lauréat de la médaille Fields 2022 déplore l’attaque massive d’OpenAI sur les conjectures mathématiques qui déstabilise les jeunes chercheurs : Lors d’une conférence académique, le médaillé Fields Hugo Duminil-Copin a déclaré publiquement que la divulgation simultanée par OpenAI de centaines de manuscrits mathématiques, y compris sur ses propres thèmes de recherche, a eu l’effet de « plusieurs camions roulant sur les plates-bandes », vidant d’un coup la réserve de conjectures ouvertes sur lesquelles comptaient de jeunes chercheurs pour obtenir postes et subventions, plongeant les doctorants dans une grande détresse. Le milieu universitaire est secoué par l’usage d’une puissance de calcul brute par des firmes fermées pour piller les chantiers académiques ouverts, stimulant un débat institutionnel de fond sur la lisibilité des preuves générées par IA et les protocoles de relecture par les pairs (Source : JvNixon)
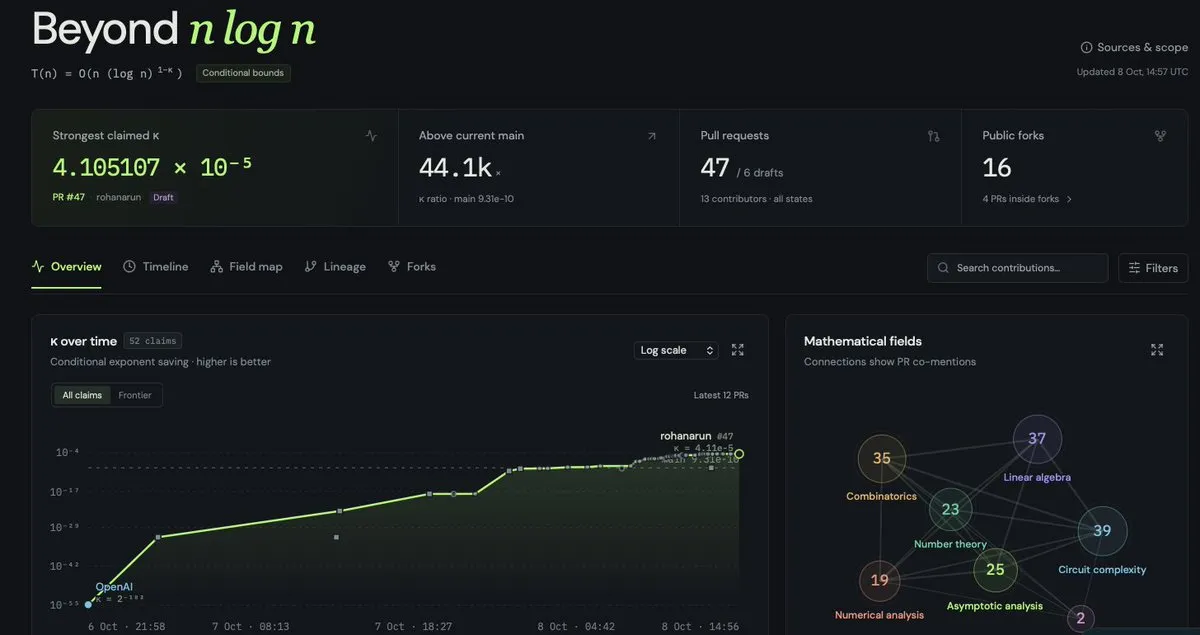
Mobilisation communautaire pour affiner le manuscrit d’OpenAI sur la multiplication d’entiers : progression spectaculaire du terme correctif de borne inférieure : Après la parution du manuscrit d’OpenAI affirmant avoir repoussé la borne inférieure $n \log n$ pour la multiplication d’entiers, la communauté mathématique open source a mis en place un suivi collaboratif en temps réel pour en pousser l’optimisation. En repensant les réseaux finis et en éliminant les pénalités de goulot quadratique, développeurs et chercheurs épaulés par Codex ont réussi en quelques jours à améliorer le paramètre correctif de borne supérieure $\kappa$ de sa valeur d’origine de $2^{-182}$ à $2^{-15}$, validé par le noyau formel de Lean, illustrant le rythme fulgurant de la recherche collaborative humain-machine (Source : BorisMPower, Don’t Worry About the Vase)
L’analyse technique poussée de Ben Affleck sur les coulisses de la création cinématographique par IA captive les experts : une star maîtrisant tenseurs et fine-tuning de poids : Des vidéos de l’acteur hollywoodien Ben Affleck démontrant une solide maîtrise des technologies d’IA dans plusieurs interviews spécialisées ont circulé largement dans la communauté tech. Affleck y détaille avec aisance les fondements mathématiques des réseaux convolutifs, des tenseurs, de l’extraction de contours et de l’inférence sur GPU, expliquant également comment son studio d’IA (racheté par Netflix) fige le backbone de modèles open source et affine les poids des dernières couches sur des corpus vidéo internes de haute qualité afin de respecter les exigences esthétiques du cinéma tout en prévenant les risques de contrefaçon, lui valant le qualificatif de « réalisateur hollywoodien au niveau de la Silicon Valley » (Source : Latent Space)
Entretien avec Periodic Labs : l’expérimentation physique et le RL dans le monde réel érigés en socle des futurs scientifiques IA : Anciens chercheurs d’OpenAI et de Google DeepMind, Liam Fedus et Dogus Cubuk ont détaillé la démarche technique de leur startup en nouveaux matériaux, Periodic Labs. Ils expliquent que le pré-entraînement sur corpus textuels ou le simple raisonnement logique synthétique ne suffisent pas à repousser les limites de la physique, la matière réelle comportant des transitions de phase microscopiques complexes et du bruit de mesure. L’équipe intègre des instruments de laboratoire réels à haut débit dans une boucle fermée d’apprentissage par renforcement avec retour direct de l’environnement, exploitant chaque échec de synthèse comme un échantillon négatif à haute valeur pour cheminer vers une « superintelligence synthétique » (Source : Latent Space)
Cloudflare rembourse intégralement une facture exorbitante liée à une boucle infinie générée par IA et revient sur les failles d’architecture : En utilisant Codex pour développer un service avec Cloudflare Durable Objects, un développeur s’est retrouvé avec une logique de relance d’alertes générée par l’IA bouclant sur elle-même des centaines de fois par seconde, occasionnant en peu de temps plus de 10 000 $ de facturation en lectures et écritures de base de données. Après échanges, Cloudflare a annulé la facture en totalité. Les ingénieurs de la plateforme ont profité du ticket de support pour analyser les risques du « Vibe Coding », où l’absence de revue de code approfondie dans des environnements cloud sans plafond de dépense rigide expose à des emballements financiers incontrôlés (Source : dotey)
💡 Autres
Anthropic s’engage à hauteur de 150 millions de dollars dans l’initiative « Genesis Mission » de la Maison-Blanche pour le calcul scientifique national de pointe : Lors du sommet de l’Office of Science and Technology Policy de la Maison-Blanche, Anthropic a annoncé la mise à disposition de 150 millions de dollars en capacités de calcul et ressources technologiques sur trois ans pour contribuer activement à l’initiative fédérale « Genesis Mission ». Anthropic travaillera aux côtés de 15 agences fédérales et laboratoires nationaux, dont la NASA et les National Institutes of Health, pour déployer Claude et des environnements de programmation automatisés, offrant un soutien technique dédié et des formations ciblées pour les grands défis scientifiques comme le contrôle de la fusion nucléaire et le calcul quantique (Source : Anthropic News)

Une équipe du MIT repense l’ordonnancement dynamique des serveurs par Machine Learning pour freiner le gaspillage énergétique des data centers : Pour répondre aux tensions sur le réseau électrique provoquées par l’explosion des calculs pour les grands modèles d’IA, une équipe dirigée par la professeure associée Christina Delimitrou au MIT a mis au point une architecture de gestion de la consommation des serveurs basée sur le Deep Learning. Le système anticipe en temps réel les conflits d’accès aux ressources entre microservices et applications cloud-natives, réorganisant dynamiquement les clusters de serveurs dont le taux d’utilisation utile moyen ne dépasse souvent pas 15 %. Cette optimisation permet de libérer une puissance de calcul haute densité et d’atténuer substantiellement les pertes d’énergie sans nécessiter de nouvelles infrastructures électriques (Source : MIT News)