🔥 À la une
Trump nomme le directeur du renseignement national Jay Clayton au poste de tsar de l’IA à la Maison-Blanche : Donald Trump a officiellement annoncé la nomination du directeur du renseignement national américain, Jay Clayton, au poste cumulé de tsar de l’IA à la Maison-Blanche, chargé de diriger la nouvelle « Super Intelligence Force » (SIF). Clayton, qui a précédemment présidé la SEC et dirigé l’ensemble des 18 agences de renseignement américaines, a déclaré publiquement que l’IA représente à la fois une opportunité historique et une menace pour la sécurité nationale. La SIF coordonnera les relations du gouvernement fédéral avec les consommateurs, les groupes d’intérêt public, les organisations religieuses, les infrastructures critiques et les institutions de R&D de pointe sur la superintelligence. Cette nomination marque l’entrée de la régulation et de la gouvernance de sécurité de l’IA de pointe aux États-Unis dans une phase de coordination interministérielle de niveau d’alerte stratégique. (Source : The Guardian)

L’européen Aleph Alpha publie en open source Kolibri, un modèle MoE bilingue de 78B : La startup allemande d’IA Aleph Alpha a officiellement publié en open source son grand modèle souverain Kolibri-1. Doté d’un total de 78,1B de paramètres, le modèle repose sur une architecture combinant sliding window et attention globale, n’activant que 3,46B de paramètres par token (soit 4,4 %), tout en prenant en charge un contexte de 1 million de tokens. Entièrement entraîné sur des infrastructures européennes locales et conforme aux exigences de l’EU AI Act ainsi que du GDPR, Kolibri a obtenu des scores élevés de 96,9 % au test de mathématiques AIME 2025 et de 84,3 % à GPQA Diamond. Ses poids en FP8 ont été publiés sous licence Apache 2.0 et sont optimisés pour un déploiement sur un seul GPU B200 ou deux H100. (Source : MarkTechPost)
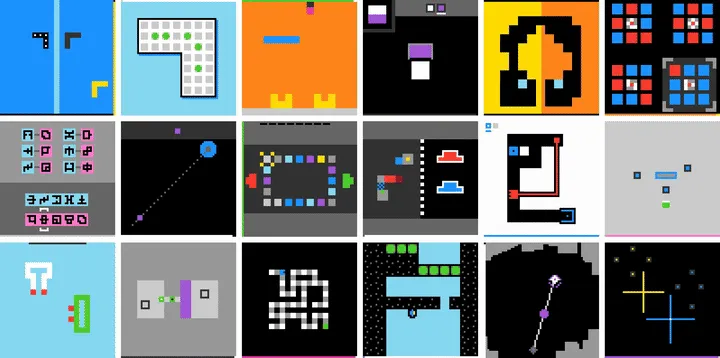
L’architecture de renforcement visuel VISTA de l’équipe de Kaiming He pulvérise le benchmark ARC-AGI-3 : L’équipe de Kaiming He a publié une nouvelle recherche intitulée VISTA, bouleversant l’approche traditionnelle consistant à convertir les jeux interactifs en symboles numériques abstraits pour adopter des entrées d’images purement natives couplées à un mécanisme externe d’« album visuel sans perte » (attention explicite). Pendant l’exploration, le modèle peut consulter et comparer à la demande des captures d’écran historiques côte à côte, permettant à Claude Opus 5, sans aucun entraînement supplémentaire, d’obtenir un score parfait de 100 points sur l’ensemble des 25 jeux, en réalisant seulement 0,43 fois le nombre d’étapes requis par un humain lors d’une première réussite ; GPT-5.6 Sol a également atteint 99 points. Ce résultat brise la croyance selon laquelle le raisonnement abstrait doit obligatoirement reposer sur de longues chaînes de pensée ou des simulateurs de code, démontrant que la perception visuelle et la mémoire de travail constituent les clés pour franchir le cap de la généralisation abstraite vers l’AGI. (Source : 36Kr)
La NASA et IBM publient conjointement un modèle de fondation open source pour la science lunaire : La NASA et IBM Research ont dévoilé conjointement un modèle de fondation lunaire basé sur l’architecture multimodale TerraMind, intégrant près de 2 millions de tuiles de télédétection à haute et basse résolution accumulées sur 17 ans, notamment par le Lunar Reconnaissance Orbiter (LRO). En intégrant l’angle d’illumination et la géométrie spatiale solaire comme a priori explicites en entrée, le modèle réduit l’erreur de prédiction de probabilité des dépôts de glace d’eau dans les cratères polaires situés dans l’ombre permanente jusqu’à 22 %, tout en démontrant d’excellentes performances dans la détection des cratères d’impact. Les poids du modèle, le code source et les jeux de données d’évaluation ont été entièrement publiés en open source sur Hugging Face et GitHub. (Source : The Decoder)
🎯 Tendances
Google ajuste la grille d’abonnements individuels de Gemini : la version gratuite rétrogradée à Flash-Lite avec un palier payant mis en place : Google a annoncé un durcissement des accès à Gemini pour les comptes personnels. Les utilisateurs gratuits seront limités au plus petit modèle, Flash-Lite, perdant l’accès à Flash et Pro ; les abonnés à l’offre AI Plus à 5 $/mois sont également privés de l’accès à Pro, ne conservant que Flash-Lite et Flash. Pour accéder à la gamme complète des modèles, il faudra désormais souscrire aux formules Pro ou Ultra, facturées entre 20 $ et 100 $ par mois. Selon les observateurs de l’industrie, cette décision vise d’une part à réduire le déficit lié à l’inférence à haute fréquence des grands modèles, et d’autre part à préparer le terrain pour le lancement commercial de son nouveau fleuron plus coûteux, Gemini 4 Argon. (Source : The Decoder)
DeepSeek Harness publie la v0.2.1 et introduit une couche de compatibilité expérimentale pour Claude Code Mods : DeepSeek a mis à jour son framework d’agents open source en version v0.2.1-alpha.1. Au-delà de l’intégration de l’application de bureau officielle, la principale nouveauté réside dans l’ajout d’une couche de compatibilité expérimentale pour l’API Claude Code Mods, permettant via un pont d’exécuter des modules tels que Token Weather ou Blast Radius au sein du système de plugins de DSH. Le responsable de l’équipe, Cui Tianyi, a indiqué que DSH applique la philosophie « tout est plugin », et que cette initiative vise à démontrer que les mécanismes de Mods concurrents peuvent être réutilisés entre écosystèmes en tant que sous-ensemble de l’architecture de plugins de DSH. (Source : JiQizhixin)

OpenAI annonce qu’Astra 6.1 renforcera ses capacités d’élagage et de refactorisation de code : Tibo Sottiaux, responsable produit chez OpenAI, et Rajan Agarwal, chercheur en post-entraînement, ont révélé que la prochaine génération de modèles concentre ses efforts sur les capacités de « suppression et simplification de code », afin de remédier à la dette technique causée par la génération de code verbeux et désordonné par les agents. L’équipe de R&D affine ses stratégies de post-entraînement pour répondre aux difficultés des développeurs, dotant le modèle d’un niveau élevé d’exigence pour la refactorisation et l’auto-simplification du code, tout en laissant entendre qu’Astra 6.1, temporairement retardé pour des motifs de sécurité, sera bientôt mis à disposition des utilisateurs. (Source : JiQizhixin)

Google Research développe un apprentissage fédéré avec confidentialité différentielle vérifiable basé sur les TEE : Google Research a présenté une architecture d’apprentissage fédéré (FL) de nouvelle génération reposant sur des environnements d’exécution de confiance (TEE), déjà déployée pour le modèle de prédiction bilingue anglais-japonais de Gboard. Cette architecture déporte le calcul des gradients côté appareil vers des TEE matériels dans le cloud vérifiés par attestation à distance ; en consignant des politiques d’accès au code immuables et publiques via Sigstore, elle permet à des auditeurs externes de vérifier le processus d’injection de bruit de la confidentialité différentielle centrale sans avoir à faire confiance à Google, résolvant ainsi la rupture de confiance liée à la confidentialité dans l’entraînement collaboratif à grande échelle. (Source : MarkTechPost)
Bilibili publie en open source la famille de modèles de traduction multilingue Index-Translate : Bilibili a publié en open source la série de modèles Index-Translate, affinés à partir de Qwen3.5, prenant en charge la traduction croisée de haute précision entre 150 langues avec un accent particulier sur le respect des contraintes terminologiques et la préservation de la mise en page. La gamme se décline également en Index-Echo (interprétation simultanée avec clonage vocal), Index-Homura (traduction alignée sur le nombre de syllabes cibles) et Index-NativeLong (traduction de documents longs avec cohérence contextuelle inter-paragraphes). Lors d’essais réalisés par la communauté, les performances de traduction chinois-anglais ont surpassé plusieurs références commerciales. (Source : Reddit r/LocalLLaMA)
🧰 Outils
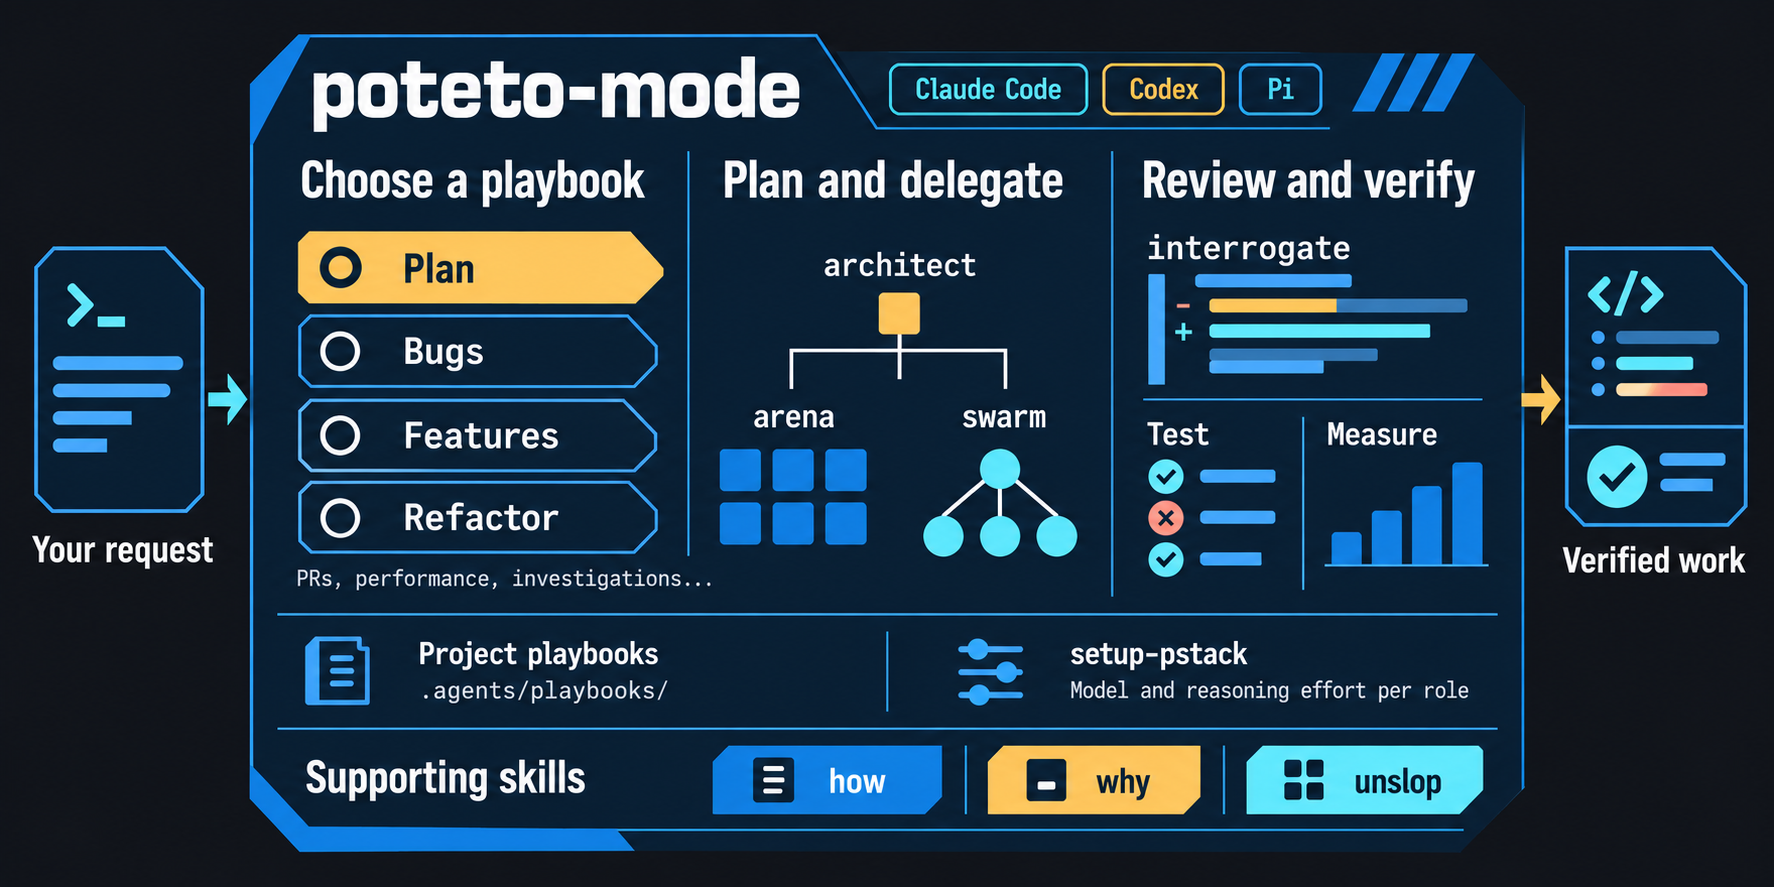
pstack-claude : une bibliothèque rigoureuse de compétences d’ingénierie d’agents portée sur plusieurs Harness : Des développeurs de la communauté, s’appuyant sur les pratiques de l’équipe de Cursor, ont développé un portage multi-environnements de pstack adapté à des plateformes telles que Claude Code, Codex et Pi. Ce plugin intègre le flux d’exécution automatisé poteto-mode, appliquant strictement une procédure de validation « reproduction – double questionnement – correction ciblée – re-test » lors du traitement des bugs de code, et déclenchant obligatoirement un audit d’architecture lors du franchissement des frontières de fonctions, aidant ainsi les développeurs à bâtir des pipelines de commit automatisés de haute qualité. (Source : GitHub Trending)
e2e : un framework de test IA de bout en bout pour applications piloté par le langage naturel : Le framework de test open source e2e permet de piloter directement les tests web et mobiles à l’aide de descriptions en langage naturel. Son mécanisme central consiste à laisser l’agent explorer et atteindre l’objectif de test initialement à partir d’un prompt, puis à figer automatiquement la séquence d’opérations d’interface en un script d’exécution sans modèle. Les tests de régression ultérieurs sont ensuite rejoués avec précision sans consommer de tokens, garantissant des assertions agiles tout en évitant totalement le gaspillage de tokens sur les tests de longue durée. (Source : GitHub Trending)
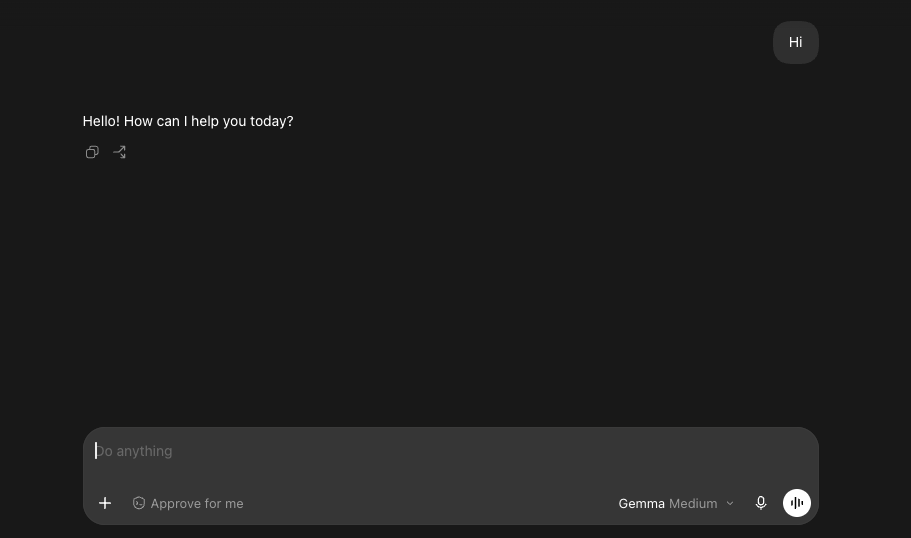
local-codex-proxy : connexion open source sans clé d’API de grands modèles locaux aux interfaces de Codex et ChatGPT : Un développeur a mis en open source un middleware proxy léger pour Codex, permettant aux utilisateurs d’interfacer directement des modèles open source déployés localement via vLLM ou Ollama (tels que Gemma ou Qwen) avec le client de bureau de ChatGPT et l’environnement d’exécution de Codex. En simulant localement les endpoints d’OpenAI et la synchronisation d’état, les développeurs peuvent profiter d’une expérience d’interface graphique de bureau mature sans exposer leur code interne au cloud. (Source : TheZachMueller)
Texting Bubbles : un plugin de bulles segmentées humanisées pour Open WebUI : La communauté a lancé la suite de fonctionnalités Texting Bubbles pour Open WebUI, qui restructure les réponses traditionnelles sous forme de longs blocs Markdown en continu en une série de bulles de messages successives imitant une conversation humaine. Le filtre associé guide le modèle par prompt pour produire des phrases courtes et concises, combiné à une planification de délais intégrant un effet de pause de frappe dynamique, offrant une immersion plus naturelle pour les interactions conversationnelles et le jeu de rôle. (Source : Reddit r/OpenWebUI)
NInfer-4080 : un moteur d’inférence à débit extrême dédié aux GPU de 16 Go : Un développeur a publié NInfer-4080, un moteur d’inférence profondément optimisé pour la RTX 4080 (16 Go de VRAM). En associant la quantification à haute compression GSQ d’ISTA-DASLab au décodage spéculatif DFlash2, il atteint des vitesses de pré-remplissage allant jusqu’à 2720 tok/s et une vitesse de génération de 262 tok/s sous un long contexte de 100K, démontrant la supériorité écrasante des moteurs d’inférence verticaux hautement optimisés pour un matériel spécifique par rapport aux frameworks généralistes. (Source : Reddit r/LocalLLaMA)
📚 Apprentissage
L’équipe de Bo An à l’Université de technologie de Nanyang révèle les mécanismes d’interaction entre modèles et Harness : L’équipe de la NTU a publié un rapport d’évaluation sur l’écosystème des agents, comparant les performances de 66 combinaisons impliquant OpenHands, DSH, PI, openJiuwen et des Harness natifs officiels. L’étude démontre que la règle selon laquelle « l’association native est optimale » ne se vérifie pas : par exemple, GPT-6 Astra sur PI surpasse nettement ses performances sur Codex. De plus, les mécanismes précis du Harness (tels que le retour de signaux de timeout, la séparation de l’écriture et de l’édition de fichiers, et le taux de succès du cache KV de contexte) jouent un rôle déterminant dans l’auto-réparation du modèle et le coût final des tâches. (Source : JiQizhixin)

Un auteur clé d’AlphaGo analyse dans un article les origines du manque de véritable raisonnement Système 2 chez les LLM : Thore Graepel, ancien chercheur senior chez DeepMind, a publié un article dans la MIT Technology Review soulignant que les chaînes de pensée actuelles des LLM ne constituent qu’une génération associative prolongée de Système 1, dépourvue du mécanisme de recherche vérifiable et de l’arbre d’état cognitif explicitement variable propres à AlphaGo. Selon lui, le véritable raisonnement machine exige de dissocier totalement la « représentation des connaissances » de la « déduction appliquée », en s’appuyant sur une architecture d’arbitrage indépendante capable d’évaluer les preuves et de tester des hypothèses, plutôt que d’augmenter aveuglément la taille des paramètres. (Source : JiQizhixin)

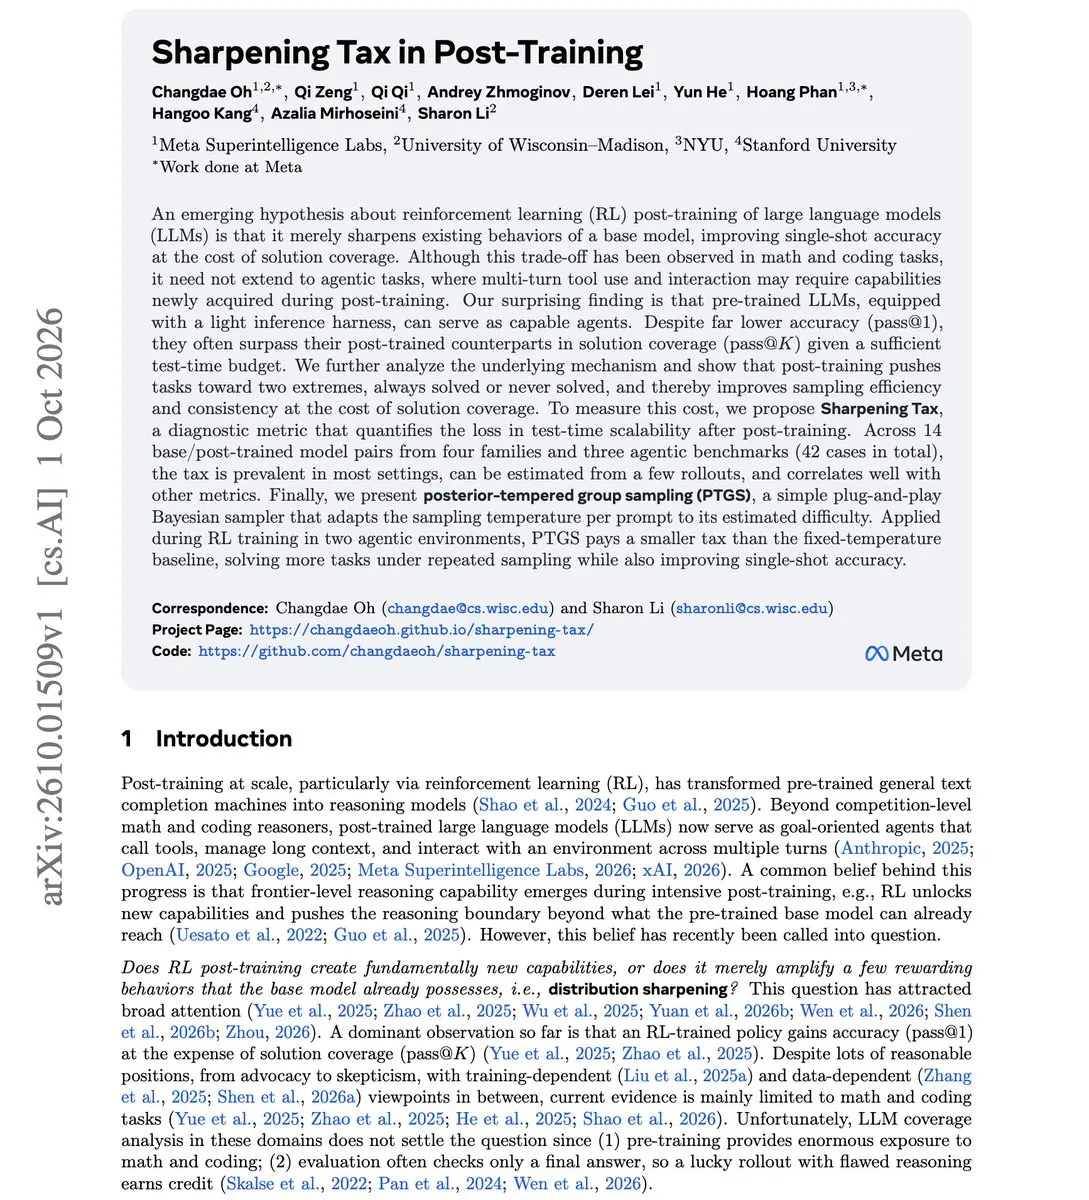
Le laboratoire de super-intelligence de Meta met en lumière le phénomène de « taxe d’affûtage » dans le post-entraînement par RL : En analysant 42 paires de modèles de base et de modèles post-entraînés par RL, l’équipe de recherche de Meta a découvert que si l’apprentissage par renforcement améliore sensiblement le taux de réussite pass@1, cela se fait au détriment de la diversité de l’espace de sortie, rendant les réponses extrêmement binaires (soit systématiquement correctes, soit systématiquement fausses). Lorsqu’un budget d’échantillonnage de test suffisant (Large K) est alloué, les modèles de base sans post-entraînement excessif, associés à un Harness léger, parviennent en réalité à résoudre des problèmes complexes de longue traîne hors de portée des modèles affinés par RL. (Source : dair_ai)
Stanford publie CS336, un cours public sur l’ingénierie système pour l’entraînement de grands modèles : Le laboratoire de NLP de l’Université de Stanford a mis en ligne les supports de son cours pratique CS336 dédié à l’ingénierie des systèmes de modèles de langage. Le cursus se concentre sur les pratiques d’ingénierie pointues pour concevoir de grands modèles à partir de zéro, couvrant l’implémentation de tokenizers, l’optimisation de l’entraînement distribué de Transformers, le franchissement du mur de mémoire GPU, la validation des scaling laws, les pipelines de nettoyage de données ainsi que le RL appliqué au raisonnement, avec des devoirs alliant rigueur théorique et exigences d’ingénierie prêtes pour la production. (Source : stanfordnlp)
Meta propose RankEvolve, un pipeline multi-agents de correction d’erreurs pour la recherche scientifique : Face aux défauts insidieux qui surviennent lorsque l’IA mène de façon autonome des expériences de machine learning (fuites de données, rupture silencieuse de gradients, etc.), l’équipe de Meta propose le Harness de recherche scientifique multi-agents RankEvolve. Le système configure Claude Code et Codex comme des nœuds d’audit mutuellement redondants, qui s’auditent mutuellement et corrigent les modifications de code via un protocole de compilation, faisant progresser le taux d’exactitude des expériences scientifiques entièrement automatisées de 45,8 % à 62,5 %. (Source : dair_ai)
💼 Entreprises
La licorne de génération 3D Meshy dépasse les 100 millions de dollars d’ARR, illustrant les barrières des modalités spécialisées : Une analyse économique a révélé que la startup de génération 3D Meshy a vu son revenu récurrent annuel (ARR) bondir de 1 million à 100 millions de dollars en moins de deux ans. Bien que les grands modèles généralistes soient désormais capables d’écrire des scripts géométriques élémentaires, la génération 3D verticale a su verrouiller une boucle de rentabilisation solide grâce aux appels d’API de grands studios de jeux vidéo et à l’écosystème matériel d’impression 3D, en s’appuyant sur des topologies très détaillées, l’alignement des textures et l’intégration aux pipelines industriels. (Source : Liangziwei)
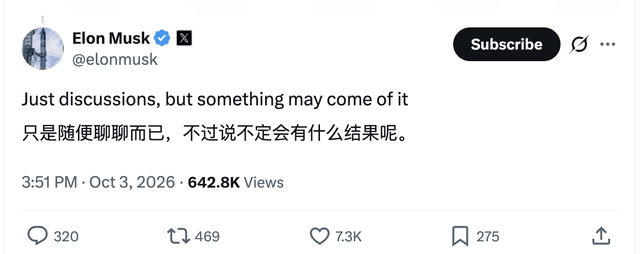
Musk confirme des discussions avec TSMC concernant la fonderie des puces pour la Terafab : Elon Musk a publiquement confirmé la tenue de discussions approfondies avec TSMC au sujet du projet de fonderie de puces à intégration verticale ultra-large Terafab. La Terafab prévoit une production annuelle de 1 TW de puissance de calcul pour répondre aux besoins de Tesla, SpaceX et xAI. Face à la pression sur le calendrier de production industrielle du procédé 14A d’Intel, Musk cherche à couvrir les risques de la chaîne d’approvisionnement en s’appuyant sur l’expérience opérationnelle et les rendements éprouvés des usines de TSMC, visant une maîtrise absolue sur l’approvisionnement de ses puces sur mesure. (Source : Liangziwei)
Le Queensland en Australie fait face à une contestation locale contre un centre de calcul Anthropic de 31 milliards de dollars australiens : Le projet de datacenter Western Downs, estimé à 31 milliards de dollars australiens pour fournir de la puissance de calcul aux modèles d’Anthropic, suscite une vive opposition parmi les résidents locaux. L’installation devrait atteindre une consommation de pointe de 2,16 GW (soit un quart de la consommation électrique totale de l’État du Queensland), et plus de 20 000 personnes ont déjà signé une pétition pour s’y opposer. Afin de préserver la transition énergétique et les retombées économiques, le gouvernement de l’État a annoncé retirer les pouvoirs d’approbation aux conseils municipaux pour centraliser la décision, mettant en relief l’arbitrage difficile entre expansion de la puissance de calcul et opinion publique locale. (Source : The Guardian)

🌟 Communauté
Altman adopte une position ferme contre la déification de l’IA, les divisions idéologiques s’accentuent dans la Silicon Valley : En réponse à des révélations médiatiques concernant des rencontres intensives entre de hauts dirigeants d’Anthropic et des chefs religieux pour discuter de la conscience de l’IA et du statut moral des machines, le PDG d’OpenAI, Sam Altman, a publié un message soulignant qu’accorder une autorité religieuse aux modèles d’IA ou encourager les humains à renoncer à leur propre jugement représente un risque majeur pour la sécurité. Le lauréat du prix Turing Yann LeCun ainsi que plusieurs universitaires ont soutenu cette vision, rappelant que dépeindre les grands modèles comme des entités conscientes dotées de sensibilité relève non seulement de la pseudo-science philosophique, mais risque aussi d’être utilisé par les géants de la tech comme argument juridique pour échapper à la responsabilité stricte du fait des produits en cas de violation de la loi ou de préjudice causé par les modèles. (Source : sama)
Réflexion sur la transformation du secteur derrière l’explosion du rôle de Forward Deployed Engineer (FDE) : Face à l’engouement généralisé pour les postes de Forward Deployed Engineer (FDE), les praticiens soulignent que le cœur de ce métier est passé de la livraison traditionnelle de code « clé en main » à la « structuration de l’ontologie métier et à la reconfiguration des relations organisationnelles ». Alors que l’IA réduit drastiquement le coût marginal d’écriture de logiciels, les silos de données inter-services, les barrières d’autorisations et les réticences des employés deviennent les principaux goulets d’étranglement pour le déploiement de l’IA. La nature du rôle de FDE évolue ainsi vers du conseil métier approfondi doté d’une forte maîtrise technique. (Source : Liangziwei)
Le passage de relais de l’IA d’Alibaba aux années 90 et l’intégration terrain au cœur de la conférence Apsara : La conférence Apsara 2026 a envoyé un signal générationnel et stratégique clair : les grands modèles Tongyi Qianwen sont désormais entièrement pilotés par deux trentenaires nés dans les années 90 — Liu Dayiheng, responsable du pré-entraînement, et Chen Yusen, en charge du déploiement commercial de Qianwen Office —, bouclant la boucle entre recherche fondamentale et commercialisation des produits. Le salon a vu affluer de nombreux repreneurs d’entreprises manufacturières venus chercher des solutions de transformation par l’IA pour leurs usines, l’attention se portant résolument sur les retours financiers concrets : « en combien d’heures le processus est-il bouclé et en combien de temps l’investissement est-il rentabilisé ? ». (Source : 36Kr)
Débat entre CLI de terminal et GUI de bureau : les développeurs s’interrogent sur la nouvelle interface d’interaction des agents : Les discussions s’animent au sein de la communauté autour de la forme que doivent prendre les outils de codage assistés par l’IA. Plusieurs développeurs indiquent que les CLI multi-onglets en terminal deviennent obsolètes, la charge cognitive liée au contexte poussant les outils vers des UI dédiées aux agents, à l’image du client de bureau de Codex ou d’espaces de travail sous forme de canvas indépendants ; les utilisateurs n’interagissent plus directement avec les fichiers au niveau microscopique, mais supervisent et auditent de manière asynchrone plusieurs agents via des espaces de travail persistants. (Source : Yuchenj_UW)
Les développeurs appellent les fournisseurs de cloud et passerelles de modèles à imposer par défaut des plafonds budgétaires stricts : Face aux factures exorbitantes soudaines générées par des boucles d’exécution autonomes d’agents multiples, Simon Willison et d’autres ingénieurs de la communauté demandent instamment aux passerelles d’API et aux plateformes cloud de configurer par défaut un coupe-circuit strict générant une erreur dès que le montant défini est dépassé. Les alertes passives par e-mail s’avèrent totalement inefficaces lorsqu’un agent autonome s’emballe en pleine nuit ; un contrôle granulaire des coûts et des limites strictes infranchissables deviennent les prérequis élémentaires pour la mise en production de l’ingénierie d’agents. (Source : Simon Willison)
💡 Divers
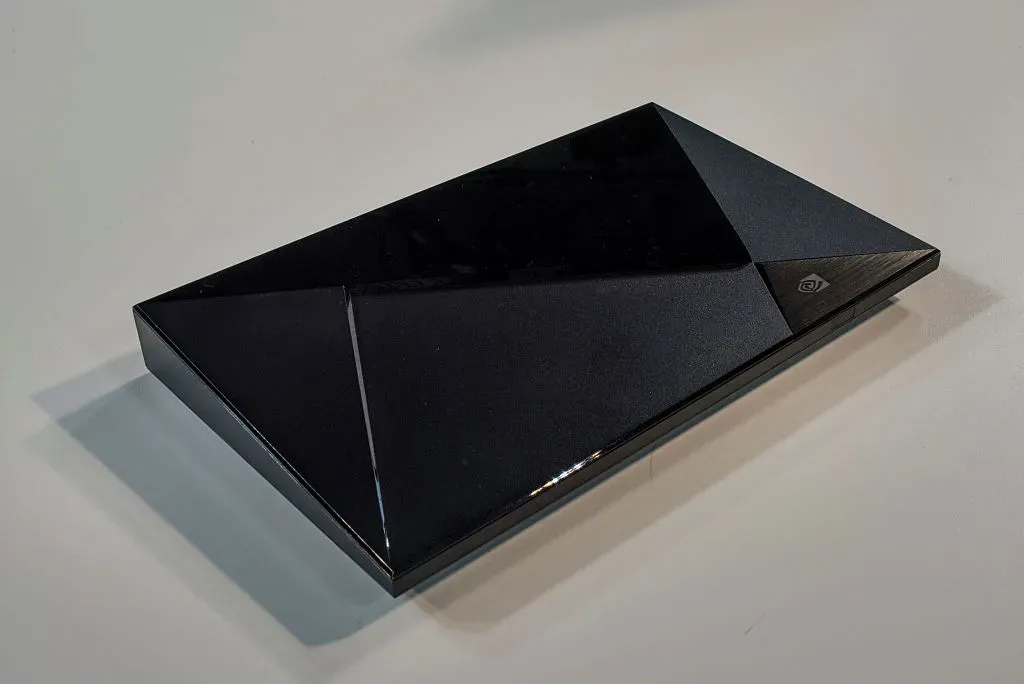
NVIDIA Shield TV augmente son prix de 100 $ à contre-courant en raison de la hausse des coûts de mémoire provoquée par l’IA : Présente sur le marché depuis sept ans, la box TV NVIDIA Shield TV Pro a vu son prix augmenter brutalement de 100 $ pour atteindre 299,99 $. NVIDIA a confirmé officiellement que l’expansion des infrastructures de calcul IA à l’échelle de l’industrie a entraîné une flambée des coûts d’approvisionnement en mémoire et en composants, obligeant l’entreprise à relever le tarif d’un matériel grand public plus ancien reposant sur une architecture éprouvée pour maintenir les lignes de production en activité. (Source : WIRED)
Une enquête révèle un recul de la proportion de femmes et de leur présence dans le leadership malgré le boom de l’IA : Selon les dernières données d’un institut d’études, bien que le volume de recrutement et les primes salariales dans le secteur de l’IA aient atteint des sommets historiques mondiaux, les femmes ne représentent qu’un quart des nouveaux postes créés dans l’IA et seulement 13 % des postes de direction, étant majoritairement cantonnées à des fonctions faiblement rémunérées d’annotation de données. La culture agressive des heures supplémentaires et les pratiques de recrutement favorisant les réseaux interpersonnels établis tendent à reléguer les femmes dans une périphérie particulièrement exposée au risque de remplacement par l’IA. (Source : The Guardian)

Les allègements fiscaux pour les datacenters ruraux aux États-Unis suscitent la prise de distance des géants de la tech et les doutes du public : Des milliards de dollars d’allègements fiscaux prévus par la loi fédérale américaine pour les datacenters situés dans les « zones d’opportunité » rurales doivent entrer en vigueur l’année prochaine. Pourtant, des géants de la technologie tels que Microsoft, Meta et Amazon ont successivement pris leurs distances vis-à-vis de cette politique. Les critiques soulignent que ces exonérations, qui ne reposent que sur des critères de volume de capital, ne créent aucun emploi pérenne substantiel pour les zones rurales, tout en accentuant la concurrence sur les ressources en eau et en électricité ainsi que les tensions avec les populations locales. (Source : WIRED)