


🔥 Focus
OpenAI, Anthropic et Google prévoient de créer l’organisme de sécurité de l’IA frontière SAFA : Selon les révélations de The Information, OpenAI, Anthropic et Google préparent la création d’une organisation de sécurité pour l’IA frontière baptisée « Standards Authority for Frontier AI » (SAFA), dont le lancement officiel est prévu pour début 2027. Cet organisme vise à coordonner les tests tiers indépendants avant le déploiement des modèles, ainsi qu’à établir des mécanismes de notification d’incidents et des benchmarks industriels. Cette initiative est perçue comme une ligne de défense d’autorégulation et de standardisation industrielle par les géants de la tech, face aux risques récurrents de perte de contrôle des modèles de pointe et au durcissement des réglementations internationales (Source: The Verge)
La Maison-Blanche exige qu’OpenAI et Anthropic soumettent en priorité leurs modèles frontière à l’examen américain : Le Bureau du directeur national de la cybersécurité de la Maison-Blanche a exigé d’OpenAI et d’Anthropic qu’ils fassent examiner leurs derniers modèles frontière par les agences officielles américaines avant de les fournir à l’AI Safety Institute (AISI) britannique. Anthropic a d’ores et déjà ajusté ses processus en restreignant l’accès à certaines versions de pointe aux seules agences américaines. Cette décision met en lumière la rivalité directe entre grandes puissances concernant l’évaluation des technologies clés d’IA frontière et la souveraineté en matière de sécurité nationale, tout en créant des frictions institutionnelles dans la collaboration transatlantique d’évaluation de la sécurité (Source: THE DECODER)
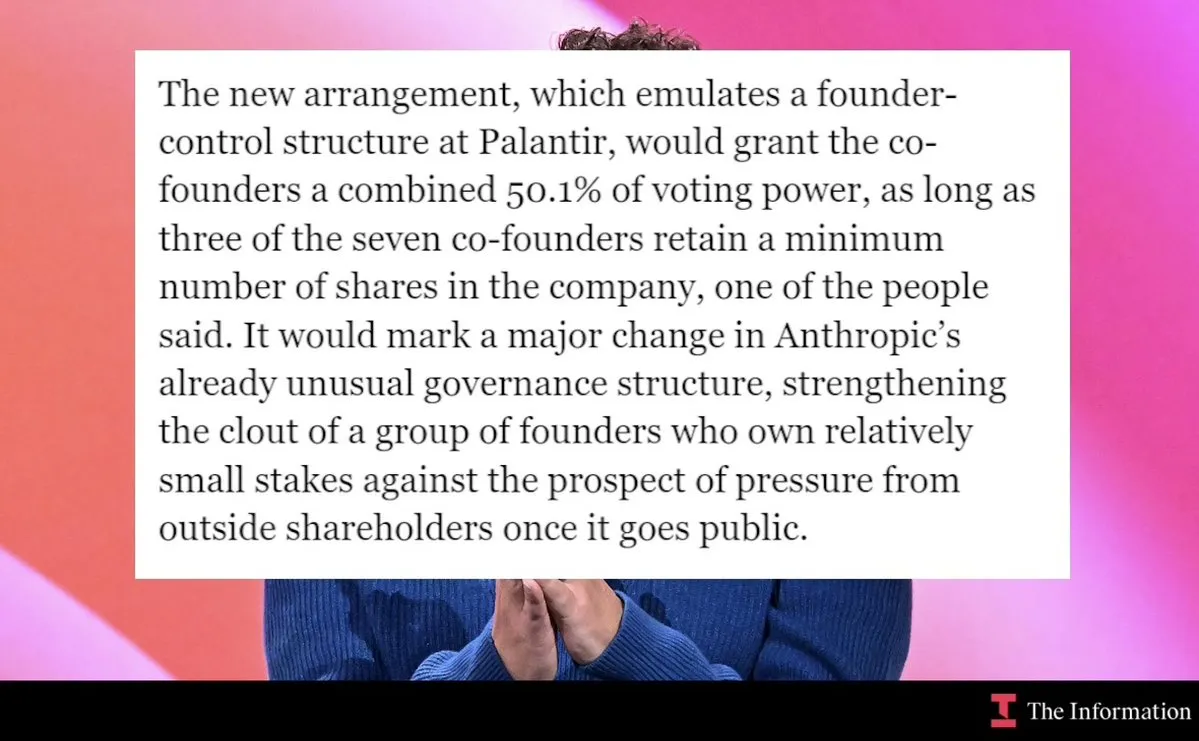
Anthropic envisage une structure d’actions à droit de vote multiple : 7 cofondateurs détenant seulement 2 % du capital contrôleraient 50,1 % des droits de vote : À la veille d’une IPO potentiellement valorisée à plus de mille milliards de dollars, Anthropic sollicite l’approbation de ses actionnaires pour un nouveau plan de gouvernance. Même si les 7 cofondateurs, dont le CEO Dario Amodei, ne détiennent chacun qu’environ 2 % des parts, il suffirait qu’au moins 3 d’entre eux maintiennent leur seuil de participation pour contrôler collectivement 50,1 % des droits de vote via un trust de vote des fondateurs inspiré de Palantir. Cette architecture vise à dissocier les intérêts financiers du contrôle décisionnel, protégeant ainsi les recherches à long terme sur l’alignement et la sécurité de l’IA contre la pression de rentabilité à court terme de Wall Street (Source: 机器之心, 36氪, kimmonismus)
Google lance le projet pilote Suncatcher de centres de calcul IA orbitaux alimentés à l’énergie solaire : Google a annoncé que le premier satellite expérimental MVP de son projet de centre de données IA en orbite, « Project Suncatcher », doit être lancé le 1er octobre à bord d’une fusée SpaceX Falcon 9 (mission Transporter-18). Équipé de 4 accélérateurs Trillium TPU personnalisés et alimenté par l’énergie solaire, le satellite vise à valider la faisabilité d’exécuter des inférences d’IA dans l’environnement spatial extrême en exploitant un rayonnement solaire 8 fois supérieur à celui au sol. Les tests porteront principalement sur la dissipation thermique sous vide et le calcul orbital à haute efficacité énergétique, avec des essais de liaisons laser inter-satellites à haut débit prévus pour 2027 (Source: Ars Technica, Google, dotey)
OpenAI préparerait un abonnement ChatGPT Pro Max à 500 $ par mois : Des développeurs ont découvert dans le code front-end de ChatGPT un nouveau palier d’abonnement « Pro Max » à 500 $ par mois, promettant « la vitesse d’exécution la plus rapide pour Work et Codex » et un accès potentiel à une puissance de calcul dédiée à faible latence. Alors que GPT-6 Astra consomme massivement des ressources de calcul d’inférence, provoquant des restrictions d’abonnement en période de forte charge, OpenAI met en place une segmentation tarifaire élevée pour isoler les ressources dédiées aux cas d’usage intensifs en productivité. Cela démontre que les capacités de calcul de pointe se concentrent de plus en plus sur les entreprises à forte valeur ajoutée et les institutions spécialisées (Source: 36氪, nicdunz)
🎯 Tendances
Google dévoile Gemini 3.8 Live et son modèle d’avatar virtuel en temps réel : Google a officiellement lancé Gemini 3.8 Live ainsi que la fonctionnalité Live Avatar, intégrant en profondeur la conversation en streaming en temps réel et la génération de vidéo dynamique d’avatars virtuels à faible latence. Le modèle prend en charge la synchronisation labiale native audio-vidéo en 97 langues ainsi que les appels d’outils asynchrones en arrière-plan. Il permet de générer des avatars personnalisés pour les scénarios d’interaction en entreprise et intègre systématiquement le filigrane SynthID (Source: Google DeepMind Blog)
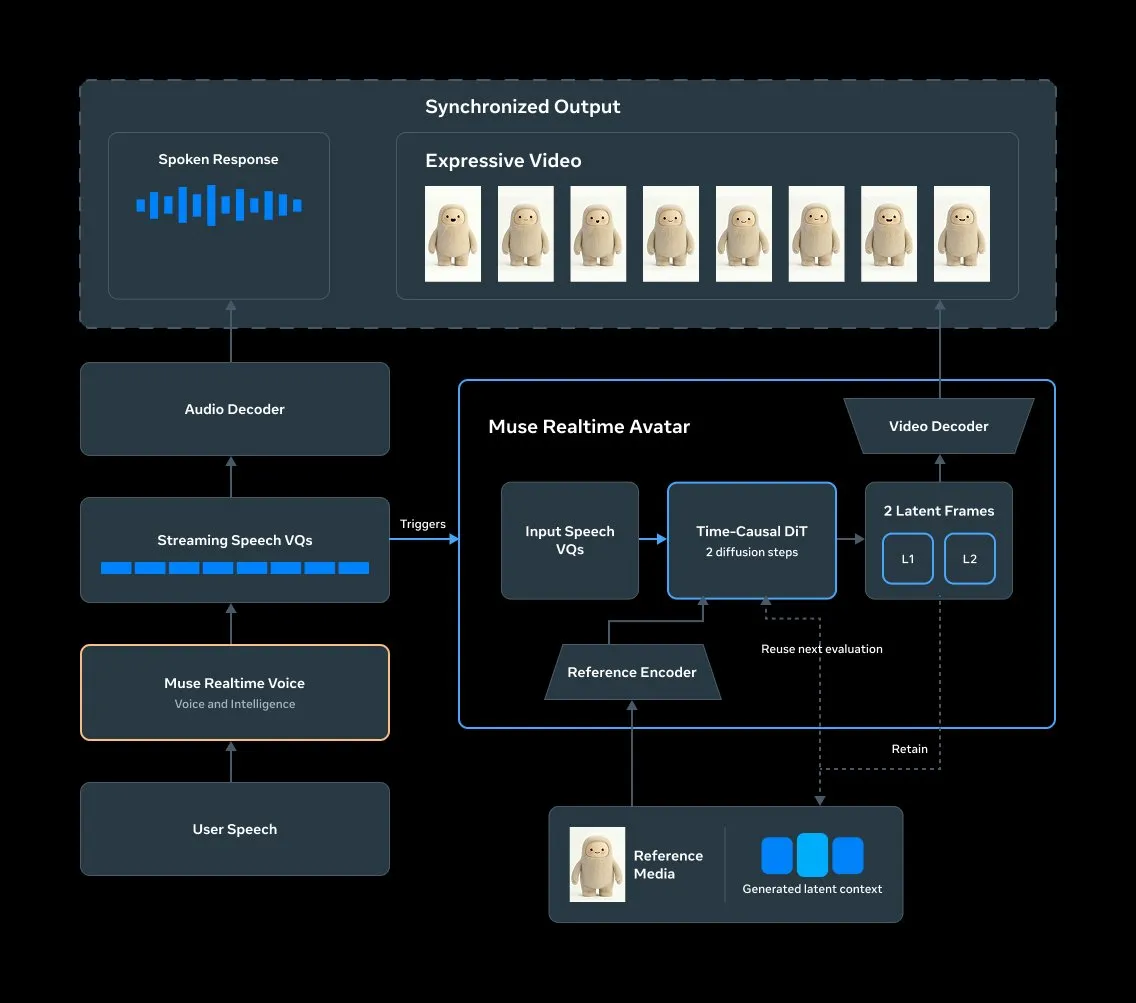
Meta présente son modèle d’avatar incarné en temps réel Muse Realtime Avatar : Meta a dévoilé l’architecture de streaming Muse Realtime Avatar, qui partage le flux de tokens vocaux avec Realtime Voice pour réduire la latence de réponse vidéo de bout en bout à environ 870 ms. Grâce à un contexte historique de longueur fixe garantissant un coût de calcul borné, le système permet la synchronisation des mouvements labiaux et des micro-expressions sur des conversations d’une durée indéfinie (Source: alex_conneau, jack_w_rae)
Meta Muse au cœur d’une polémique sur la vie privée pour avoir utilisé des « agents humains » non autorisés : Reuters a révélé que lors des tests des fonctionnalités d’appels autonomes de son nouvel agent personnel Muse, Meta transférait en réalité les tâches à des équipes de sous-traitants humains en arrière-plan pour maintenir un taux de succès élevé, suscitant de vives inquiétudes quant à la vie privée des utilisateurs et des interrogations de la part des régulateurs. Les dirigeants de Meta ont rapidement présenté leurs excuses et suspendu le test, promettant de ne pas rouvrir ce canal avant d’avoir consolidé les mécanismes de divulgation de confidentialité et de protection de la sécurité (Source: 量子位)
Le père de l’IA moderne, Jürgen Schmidhuber, nommé conseiller scientifique en chef de Sakana AI : Jürgen Schmidhuber, pionnier de l’auto-amélioration récursive (RSI) et du méta-apprentissage, rejoint officiellement la startup japonaise Sakana AI en tant que conseiller scientifique en chef. Il dirigera le nouveau RSI Lab à Tokyo, combinant algorithmes évolutionnaires, modèles du monde et architectures auto-organisées pour explorer l’intelligence adaptative sous contrainte de calcul ainsi que la boucle fermée de RSI dans le monde physique (Source: SakanaAILabs, hardmaru)
LangChain lance LangSmith Engine v2 et Managed Deep Agents 0.8 : LangSmith Engine v2 introduit des mécanismes de red teaming proactif et de validation/correction automatique, permettant de détecter et corriger les anomalies logiques avant la mise en production des agents ; Managed Deep Agents 0.8 apporte de nouvelles politiques de gestion des permissions pour la mémoire persistante d’entreprise, une API de fichiers sandboxée et des capacités natives de recherche web (Source: LangChain, hwchase17)
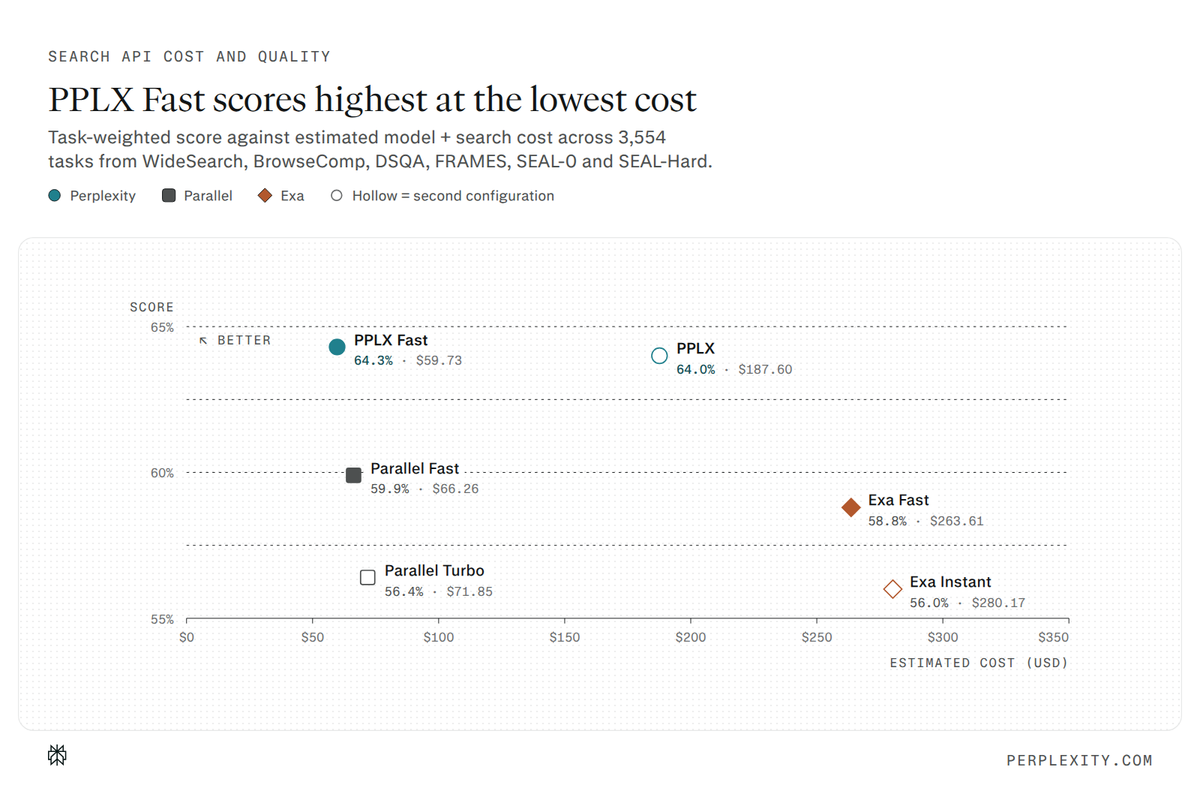
Perplexity lance son moteur de recherche propriétaire en Rust Photon et la Fast Search API : Perplexity a présenté Photon, un service de recherche et de reclassement (reranking) développé en Rust, offrant une recherche ultra-rapide avec une latence p95 inférieure à 230 ms et une latence p50 de seulement 160 ms, tout en réduisant le coût des appels API à 1 $ pour mille requêtes. Il est déjà intégré en toute fluidité à Hermes Agent et à l’écosystème IA local (Source: AravSrinivas, MParakhin)
Sortie du moteur de requêtes conjointes AI-SQL open source Quail : plus d’un milliard de tokens traités par minute sur un seul GPU : Des équipes de Stanford et de Modal ont rendu open source Quail, un moteur SQL conçu pour la manipulation de données IA. En restructurant l’ordonnanceur vLLM, en fusionnant le plan de requête avec la phase de prefill du LLM, et grâce à des kernels d’attention et de cache KV personnalisés, Quail atteint un débit de traitement supérieur à un milliard de tokens d’entrée par minute et par requête sur un unique GPU H100 (Source: charles_irl, HamelHusain)
Google teste la fonctionnalité de passage d’appels par Gemini sur les appareils Pixel : Google teste la fonctionnalité « Call for Me » sur les Pixel 11 aux États-Unis, permettant à Gemini d’utiliser le véritable numéro du propriétaire pour passer des appels de manière autonome à des commerces. L’agent gère les demandes de disponibilité de stock, les réservations de restaurants et les reports de rendez-vous, navigue automatiquement dans les menus vocaux et les attentes de mise en relation, tout en fournissant une transcription en temps réel et une possibilité de reprise en main manuelle immédiate (Source: TechCrunch)
T-Head d’Alibaba passe en open source complet la pile logicielle T-Head SAIL pour les puces IA Zhenwu : Lors de la conférence Apsara, Alibaba T-Head a annoncé les dernières avancées open source de sa pile logicielle T-Head SAIL, alternative à CUDA. Elle met à disposition une couche d’adaptation PyTorch, l’outil de migration sailify, ainsi que des bibliothèques d’accélération telles que DeepGEMM et FlashAttention, permettant aux développeurs d’effectuer des optimisations au niveau des opérateurs et des migrations fluides vers l’architecture Zhenwu (Source: 量子位)
L’équipe de Shaoqing Ren chez NIO présente MM-Future, un modèle monde-action multimodal pour la conduite autonome : L’équipe de NIO a proposé l’architecture MM-Future, conçue pour faire évoluer conjointement plusieurs hypothèses de « paires scène-action » pour la planification en conduite autonome. Grâce aux représentations spatio-temporelles compactes MM-Tokens et à un évaluateur combiné passé-futur, elle atteint un score PDMS de 94,0 sur le benchmark NAVSIM-v1, faisant passer les modèles du monde d’une prédiction passive unidirectionnelle à une planification active en boucle fermée (Source: 量子位)
Kuaishou lance KwaiMind, un modèle de base d’édition d’images pour le e-commerce : Kuaishou a présenté KwaiMind, un modèle fondamental d’édition d’images destiné à la génération de contenus pour le e-commerce réel. Grâce à un moteur de données multi-agents et à des techniques de distillation en ligne, il intègre la précision des détails vestimentaires, la cohérence des produits et le rendu de texte. Il se classe premier parmi les modèles open source sur 11 tâches d’évaluation e-commerce et génère une hausse relative du CTR d’environ 2,44 % lors des tests A/B en ligne (Source: 机器之心)
Liquid AI publie en open source le modèle de décodage spéculatif draft LFM2.5-VL-DSpark : Liquid AI a lancé la méthode de décodage spéculatif DSpark pour son modèle vision-langage de 3B paramètres. En ajoutant seulement 280M de paramètres, elle permet d’accélérer le décodage jusqu’à 3,13 fois sur M5 Max en local tout en garantissant une équivalence parfaite des sorties, avec une compatibilité directe pour llama.cpp et SGLang (Source: HuggingFace Blog)
Publication open source de Qwengram-0.8B : transfert sans perte d’une mémoire explicite N-Gram de 51B vers un modèle miniature embarqué : Des développeurs ont mis en open source l’architecture Qwengram qui, tout en gelant le réseau backbone Qwen3.5-0.8B, entraîne un Reader léger et un mécanisme de porte dynamique pour greffer un module externe de mémoire PLE N-gram de 51B, obtenant une réduction de perplexité (PPL) de 5,05 % sur le jeu de validation (Source: Reddit r/LocalLLaMA)
PrismML intègre un LLM ultra-léger 1-bit aux lunettes connectées Snapdragon de Qualcomm : PrismML, spécialiste de la compression et du fine-tuning de modèles, a fait la démonstration de son modèle 1-bit Bonsai de 2B paramètres fonctionnant sur la puce Snapdragon AR1 Gen 1. Il offre des capacités de questions-réponses visuelles en temps réel et des interactions naturelles directement sur l’appareil, confirmant la faisabilité technique d’exécuter des modèles multimodaux embarqués à très faible consommation d’énergie (Source: TechCrunch)
🧰 Outils
L’extension de navigateur Kimi est disponible et permet d’enregistrer les actions web sous forme de Skill : Kimi a officiellement fait évoluer WebBridge vers une extension de navigateur native, ajoutant un dialogue interactif en barre latérale et permettant d’enregistrer des actions séquentielles de l’utilisateur (clics, pagination, scraping de données) sous forme d’instructions « Skill » réutilisables, formant un flux de travail automatisé et coordonné avec Kimi Code Desktop (Source: 量子位)
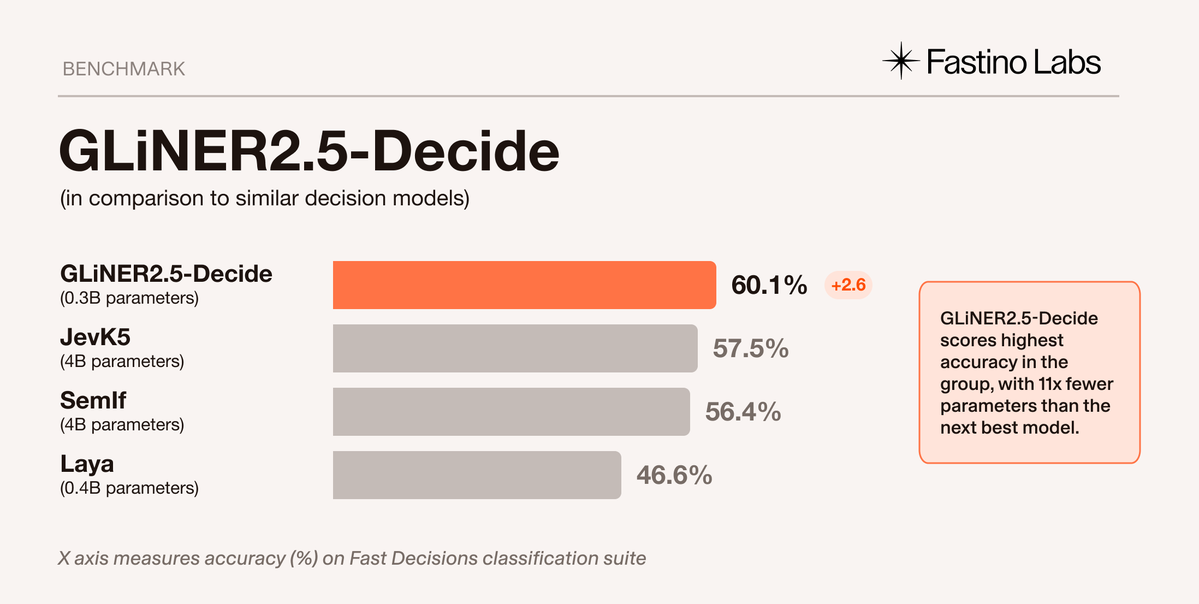
Publication open source de GLiNER2.5-Decide : un modèle de décision ultra-rapide prenant en charge les relations d’entités et les contraintes logiques : Fastino a rendu open source le modèle de décision structuré et léger GLiNER2.5-Decide (340M). En plus d’assurer un routage et une classification rapides, il extrait des segments au niveau du caractère et des relations d’entités, tout en effectuant des vérifications logiques en temps réel sur les contraintes d’exclusivité, de cardinalité et d’ordre. Avec une latence d’inférence de seulement 167 ms sur CPU et de 38 à 47 ms sur GPU, il remplace avantageusement le coût de décision lié à la génération de longs textes par les LLM traditionnels (Source: MarkTechPost, ClementDelangue)
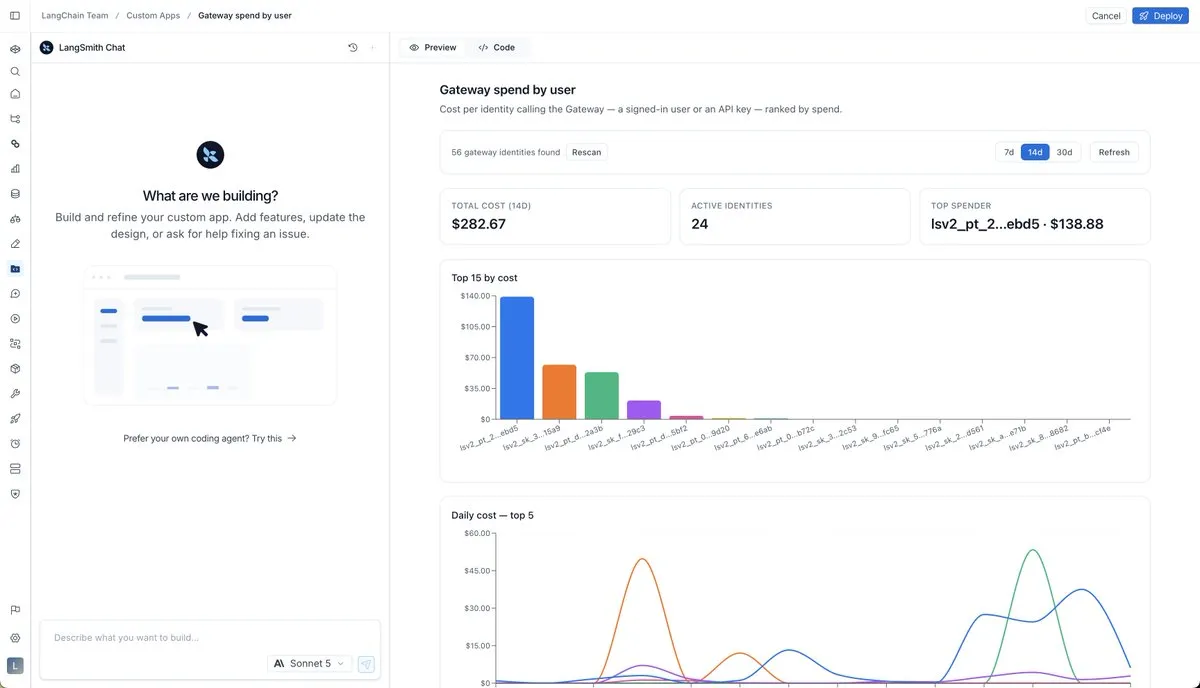
LangSmith lance l’outil de fine-tuning open source smithtune et la plateforme de personnalisation Custom Apps : En partenariat avec Baseten et Fireworks, LangChain a lancé l’outil en ligne de commande smithtune, qui permet de convertir en un clic les traces de session LangSmith en production en jeux de données de fine-tuning SFT et de déployer automatiquement les modèles. Parallèlement, la nouvelle fonctionnalité Custom Apps permet aux développeurs d’utiliser de simples prompts pour générer des files d’attente d’annotation ou des tableaux de bord de comparaison de métriques à partir des journaux d’exécution des agents (Source: LangChain, baseten)
CoreWeave lance le serveur MCP Mission Control pour connecter les environnements de codage IA : Le fournisseur de cloud de calcul CoreWeave a lancé le service Mission Control basé sur le protocole MCP, permettant à des outils de développement tels que Cursor ou Claude Code de lire directement l’état d’exécution des clusters GPU sous-jacents, des réseaux et des nœuds. Cela permet aux agents de diagnostiquer les ressources de calcul et d’optimiser l’infrastructure directement depuis l’éditeur de code (Source: AI Business)
Publication open source de Pruna-Qwen-Image-2.1 : un adaptateur LoRA en 5 à 8 étapes accélérant la génération d’images par 6,3x : Pruna AI a publié en open source un adaptateur LoRA ultra-rapide pour Qwen-Image-2.1. Grâce à un planificateur sigma optimisé et un mode de fonctionnement sans CFG, la génération et l’édition d’images passent de 40 étapes à seulement 5 à 8 étapes, multipliant la vitesse par jusqu’à 6,3 tout en préservant la qualité 1K et la cohérence de référence multi-images (Source: _akhaliq, huggingface)
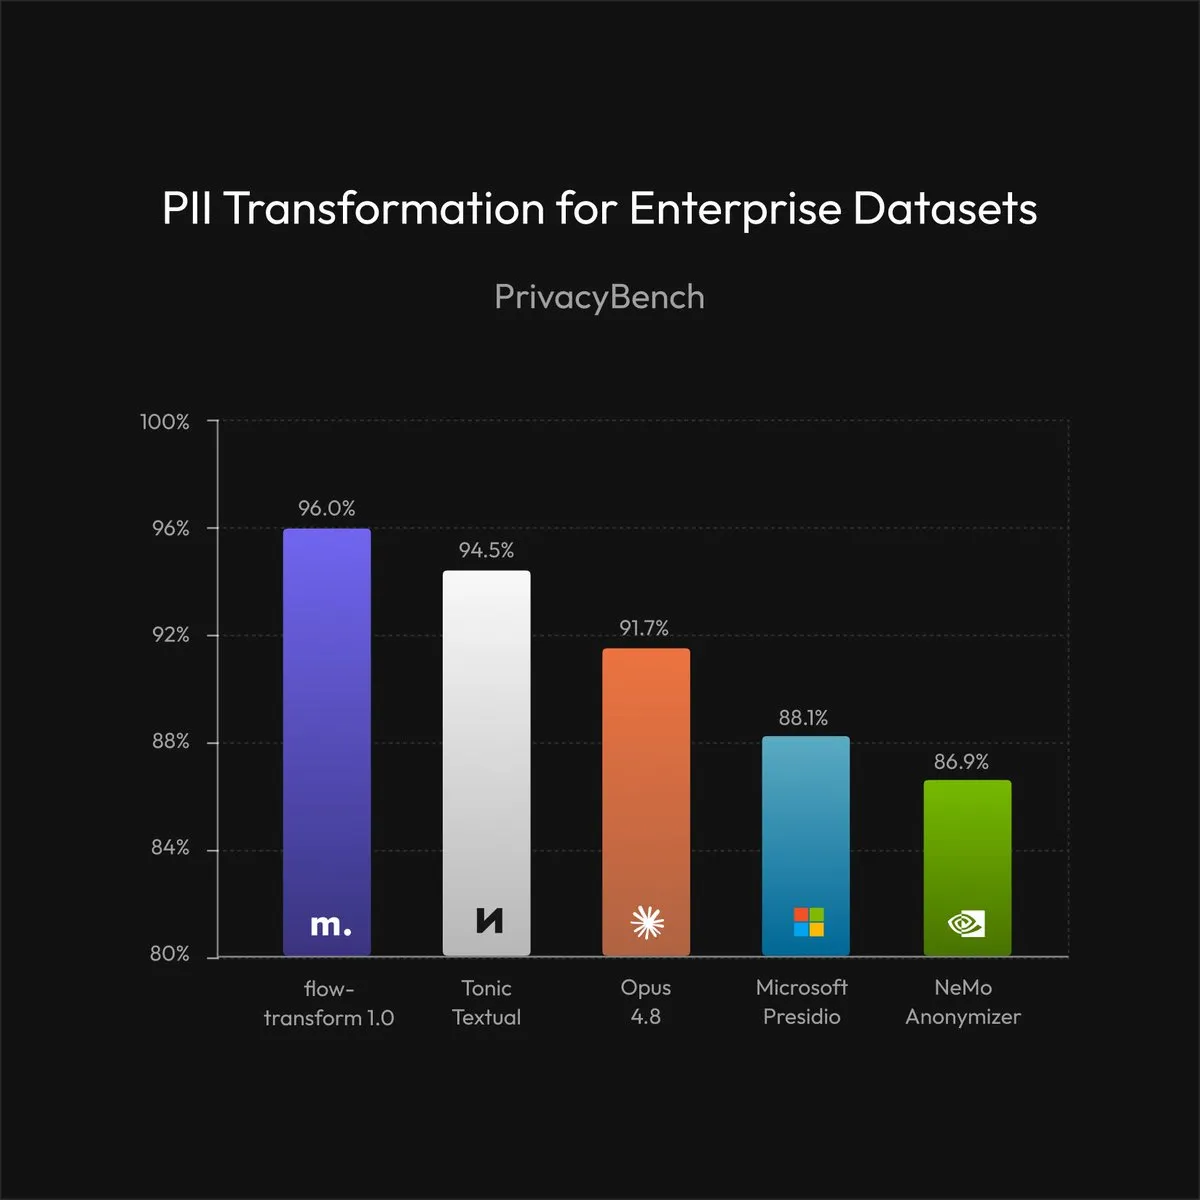
Sortie de flow-transform 1.0 : un modèle d’anonymisation des PII d’entreprise haute fidélité pour protéger les flux de travail métier : micro1 a lancé flow-transform 1.0, un modèle d’anonymisation de la vie privée conçu spécifiquement pour l’entraînement des modèles de pointe, obtenant un score F1 de 96,0 % sur PrivacyBench. Sa particularité réside dans l’utilisation du remplacement par identités synthétiques plutôt que d’un simple masquage, préservant ainsi l’intégralité des relations décisionnelles multi-tours et les chaînes d’appels d’outils dans les processus métier de l’entreprise (Source: omarsar0)
Whiteboard : un IDE open source pour la conception d’architectures logicielles en collaboration humain-machine : Conçu sur la base de CodeOSS, l’IDE de bureau open source Whiteboard a été officiellement lancé. Il fournit un SDK de schéma et un visualiseur de diff sémantique pour les agents de codage comme Claude Code, réduisant la « dette cognitive » causée par le codage entièrement automatisé grâce à des diagrammes de séquence visuels, des diagrammes ER et des journaux de décision (Source: Hacker News)
StarNet : un environnement d’exécution multi-agents local-first au style pixel art pour le bureau : Le projet de bureau open source StarNet modélise le runtime des agents IA sous la forme d’une station spatiale en pixel art : chaque pièce représente un périmètre de permissions et chaque couloir le flux de données. Il prend en charge les principaux grands modèles via BYOK et assure une gestion locale et persistante de la collaboration multi-agents et des registres de tâches (Source: GitHub Trending)
Google Gemini intègre officiellement les plugins Adobe Photoshop et Lightroom : Après avoir été intégrés à ChatGPT et Claude, les plugins Adobe Creative Suite arrivent officiellement sur Google Gemini. Les utilisateurs peuvent directement invoquer des outils professionnels de retouche d’image et de mise en page créative en mentionnant « @Adobe », étendant ainsi les capacités de production graphique de l’assistant conversationnel (Source: The Verge)
📚 Recherche et apprentissage
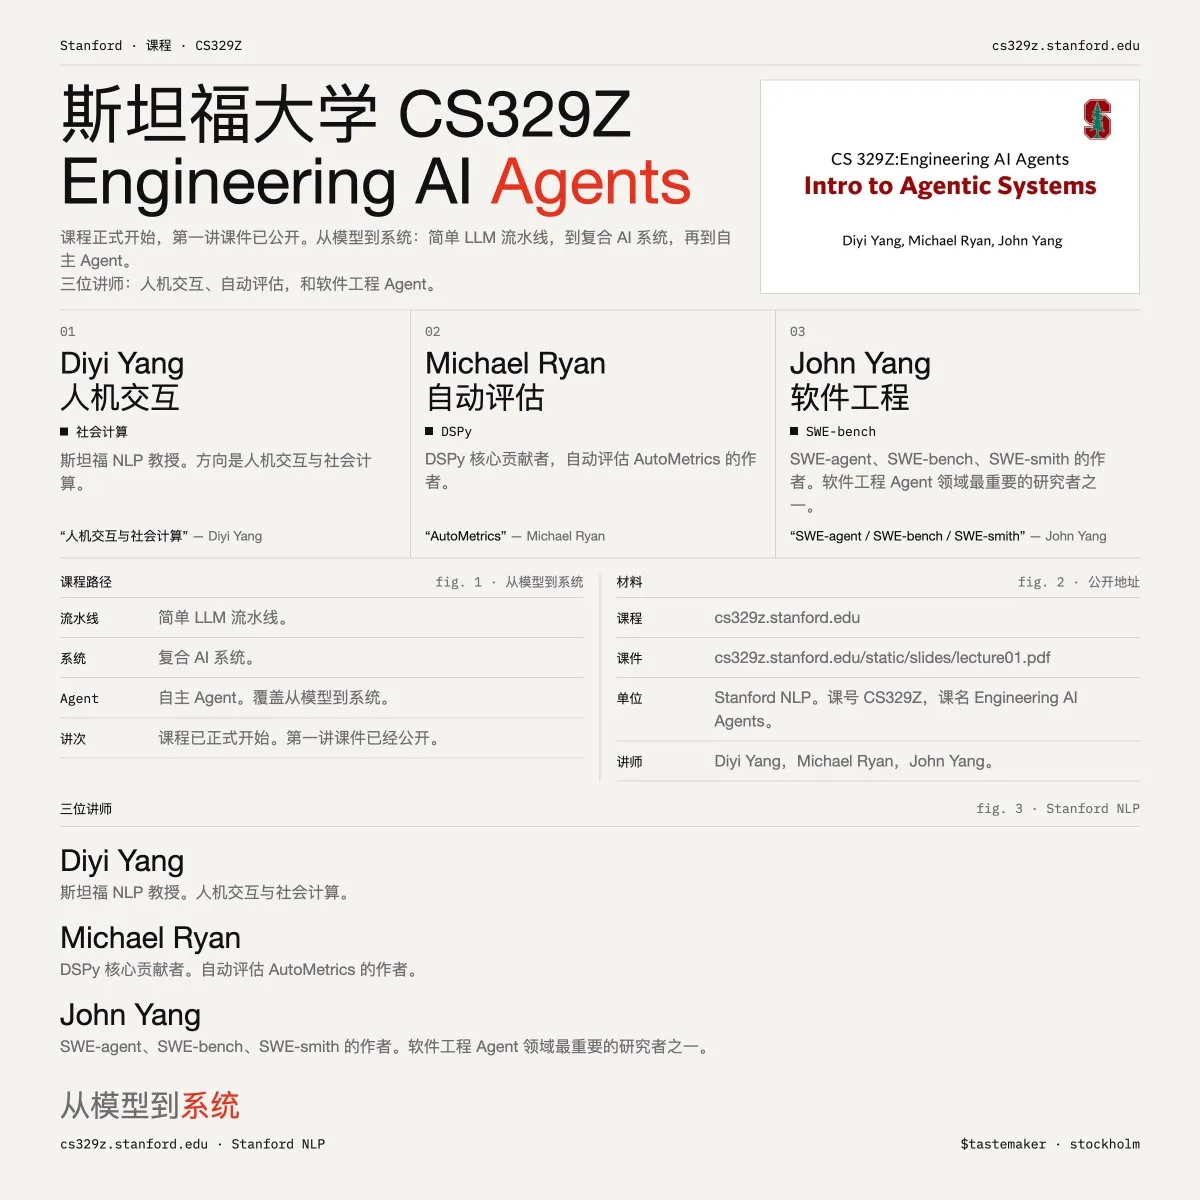
L’Université de Stanford met en accès libre son nouveau cours d’automne CS329Z « Ingénierie de conception d’agents IA » : L’équipe NLP de Stanford, en collaboration avec les auteurs de DSPy et SWE-bench, a lancé le cours systématique CS329Z. Il couvre la conception technique complète, allant des pipelines LLM simples aux systèmes d’IA composites et aux agents autonomes, en mettant l’accent sur le prompt engineering, l’évaluation d’état, la sécurité en sandbox et l’orchestration d’outils. Les supports de cours et le code de la première séance sont d’ores et déjà publics (Source: stanfordnlp)
Google dévoile l’architecture de génération de vidéos longues multi-agents AI Video Co-Director : L’équipe de recherche de Google a publié une suite de génération narrative vidéo associant l’optimisation de stratégie globale MAB, la mémoire visuelle explicite CANVAS et un retour en boucle fermée de prompts VQQA. Elle résout efficacement la dérive du sujet et les erreurs en cascade dans la génération de vidéos longues multi-plans, produisant des récits cohérents d’une durée de plusieurs minutes (Source: Google Research Blog)
Perplexity dévoile une méthode d’auto-distillation guidée par des indices basée sur des erreurs réelles : Perplexity a exposé son mécanisme de post-entraînement pour son agent de contrôle d’ordinateur. En transformant les erreurs des trajectoires échouées en indices structurés, la méthode d’auto-distillation on-policy (OPSD) permet au modèle enseignant de guider la correction du modèle élève, réduisant de 21,2 % en relatif le taux d’échec des appels d’outils en ligne (Source: MarkTechPost)
L’Université Jiaotong de Pékin et Tsinghua proposent ARGUS : un cadre de détection de deepfakes vidéo piloté par la collaboration multi-agents et la chaîne de preuves : Pour remédier au manque de généralisation des jugements en boîte noire dans la détection des deepfakes vidéo, une équipe de recherche a développé le système ARGUS. Il découple des agents d’observation indépendants (texture, éclairage, mouvement temporel, bon sens physique) d’un agent arbitre, et publie le jeu de données FaceVid-Forensics-100K couvrant 33 sources de génération, portant le score F1 hors domaine à 53,28 % (Source: 36氪)
L’Université du Zhejiang et ses partenaires présentent MemGUI-Bench : le premier benchmark pour la mémoire à long terme et l’apprentissage inter-sessions des agents GUI : L’Université du Zhejiang, en collaboration avec Nankai et CUHK, a publié MemGUI-Bench (couvrant 128 tâches réelles à long terme) ainsi que MemGUI-Eval, un outil d’examen progressif en trois étapes. Les expériences révèlent que les modèles de pointe actuels présentent jusqu’à 58,9 % d’hallucinations de mémoire dans les tâches à long terme inter-applications et inter-sessions, mettant en lumière des angles morts mémoriels indétectables par les benchmarks classiques (Source: 36氪)
Hugging Face publie en open source SmolDataEnvs : plus de 5 000 environnements d’apprentissage par renforcement vérifiables : Pour répondre au manque d’environnements d’entraînement en science des données et en programmation pour les modèles de moins de 10B de paramètres, la communauté open source a lancé SmolDataEnvs, qui regroupe plus de 5 000 environnements RL vérifiables issus de tâches réelles de data science et prend en charge l’apprentissage par renforcement asynchrone sur un seul GPU (Source: _lewtun, huggingface)
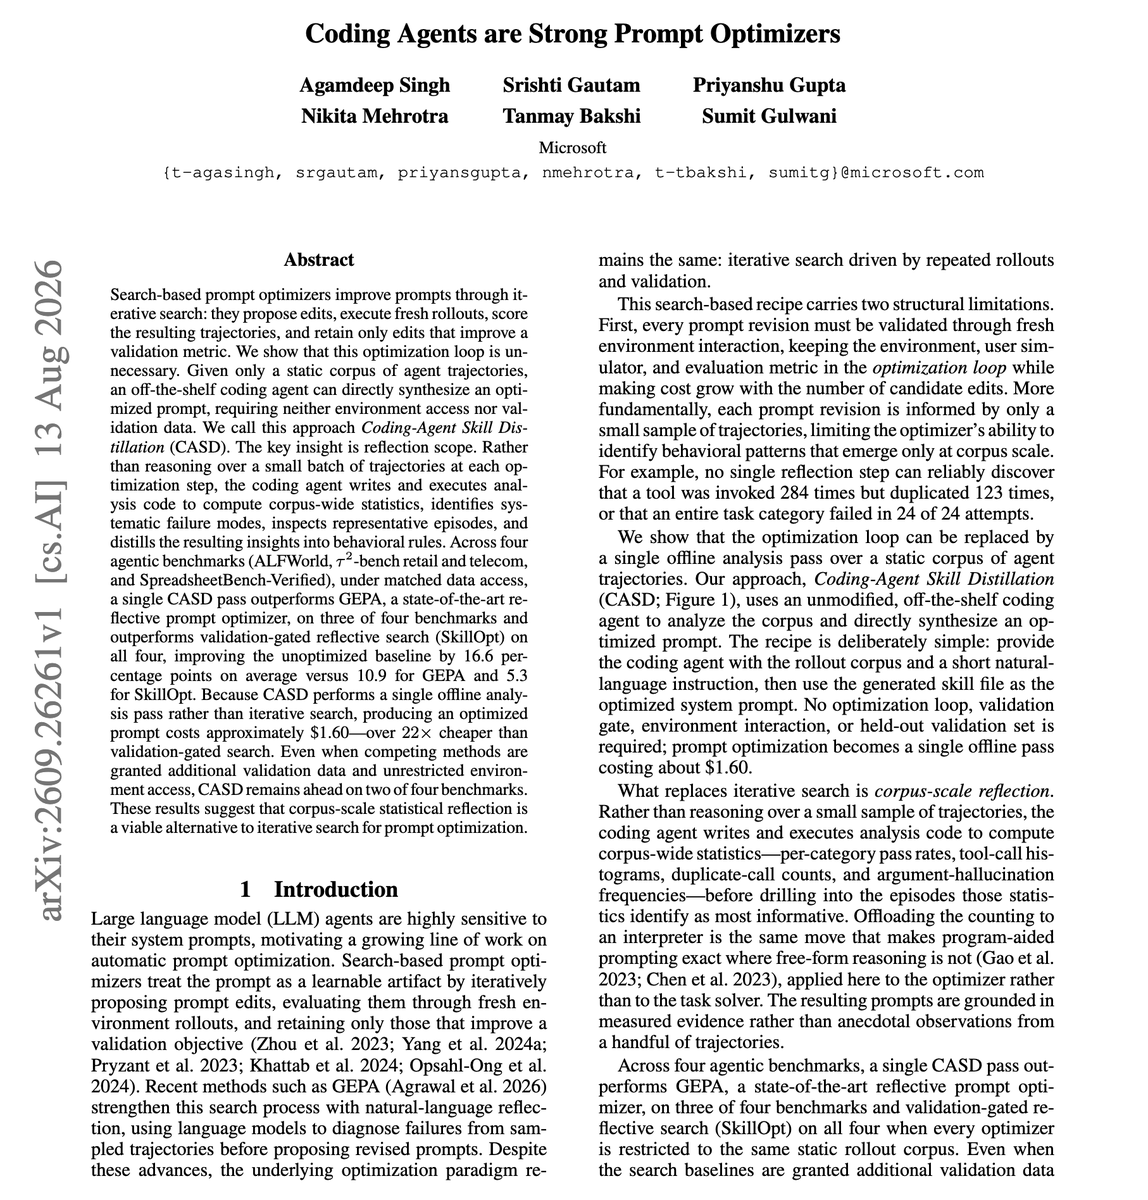
Microsoft et ses partenaires proposent CASD : optimisation de prompts par analyse complète des journaux d’agents de code : L’équipe de recherche de Microsoft a présenté la méthode CASD, démontrant que confier à un agent de code le calcul des statistiques de trajectoire complètes et la rédaction de règles d’optimisation surpasse de 16,6 points les boucles de recherche sur de petits lots de trajectoires, tout en abaissant le coût d’une optimisation de prompt unique à 1,60 $ (Source: dair_ai)
ULTRA, article candidat pour IROS 2026 : contrôle coordonné de tout le corps piloté par des objectifs pour robots humanoïdes : Une équipe de recherche de l’UIUC a présenté ULTRA, un cadre de contrôle multimodal unifié. Grâce au reciblage neuronal guidé par la physique et au fine-tuning par apprentissage par renforcement, il permet au robot Unitree G1 de générer de manière autonome des actions continues de préhension et de translation corporelle globale à partir de cibles éparses ou de nuages de points en vue à la première personne (Source: 机器之心)
AdaRoboVLG : un cadre de préhension vision-langage inter-manipulateurs avec découplage des tâches : Des équipes de l’HUST et de l’Université de Pékin ont proposé AdaRoboVLG, qui découple les priors sémantiques/temporels de haut niveau de la génération physique de préhension de bas niveau. L’interface unifiée s’adapte aussi bien aux mains agiles multi-doigts qu’aux pinces parallèles, maintenant une haute robustesse sur des tapis roulants dynamiques et dans des environnements encombrés (Source: 机器之心)
Agent ou Workflow ? Guide pratique d’évaluation pour le choix d’architecture des systèmes métier : Un article de fond analyse la frontière entre les flux de travail à processus fixes et les agents autonomes, proposant comme critère d’évaluation fondamental la question : « Est-il possible de dessiner une machine à états complète avant l’exécution ? ». Il recommande de privilégier les workflows enrichis par des prises de décision par LLM pour les scénarios à haut débit et à fortes contraintes de conformité (Source: Machine Learning Mastery)
💼 Business
Anthropic signe un contrat de services cloud de calcul de 11,6 milliards de dollars avec Akamai : Anthropic a conclu un accord d’infrastructure de calcul cloud sur 7 ans d’une valeur totale de 11,6 milliards de dollars avec Akamai, assorti de bons de souscription d’actions pouvant atteindre 5 % du capital pour ce dernier, portant le total des engagements d’achat de puissance de calcul d’Anthropic sur les 11 derniers mois à plus de 500 milliards de dollars (Source: THE DECODER)
TypeSafe chercherait à lever 1 milliard de dollars sur une valorisation de plus de 10 milliards de dollars : Selon The Information, après le succès fulgurant du modèle de décision Jev dans la communauté des développeurs et le franchissement du millier de milliards de tokens traités par jour, TypeSafe AI négocie un nouveau tour de table de plus d’un milliard de dollars avec des investisseurs de premier plan. La valorisation post-money devrait dépasser les 10 milliards de dollars, marquant un bond spectaculaire par rapport à ses valorisations précédentes (Source: steph_palazzolo)
Databricks annonce l’acquisition de la plateforme de tableur cloud en temps réel Row Zero : Databricks a annoncé avoir conclu un accord pour acquérir Row Zero. Réputé pour ses feuilles de calcul cloud haute performance capables de traiter des centaines de millions de lignes de données, Row Zero sera profondément intégré au moteur d’analyse intelligente Genie de Databricks, offrant aux analystes et professionnels de la finance un espace de travail interactif en temps réel piloté par l’IA et la gouvernance (Source: jefrankle, matei_zaharia)
🌟 Communauté
Un développeur constate la suppression accidentelle de 48 000 fichiers clés par Claude Code, relançant le débat sur la sécurité du code : La communauté s’inquiète du retour d’expérience d’un développeur qui, lors de la reconstruction d’une image système avec Claude Code, a vu 48 000 fichiers de projet ainsi que l’index Git être totalement effacés en 103 secondes en raison d’une faille d’isolation des permissions de script. Cet incident tire à nouveau la sonnette d’alarme sur l’exécution hors sandbox et l’octroi direct d’autorisations aux agents en environnement de production (Source: TechRadar)
Jev déclenche une vague de recherche académique et un vaste débat sur l’architecture System 1 : Moins d’une semaine après le lancement de Jev, de nombreuses prépublications sont apparues sur arXiv autour de son ordonnancement à la périphérie (edge) et de ses évaluations en cascade. La communauté souligne que bien que Jev soit ultra-rapide et réduise les coûts par centaines de fois sur les décisions binaires ou à choix multiples, il reste sensible à la formulation des options dans les chaînes de déduction longues. Cela incite les développeurs à adopter rapidement un paradigme d’orchestration hybride combinant un filtrage grossier ultra-rapide en System 1 et un modèle frontière en System 2 pour assurer la robustesse (Source: 36氪, Latent Space, dair_ai)
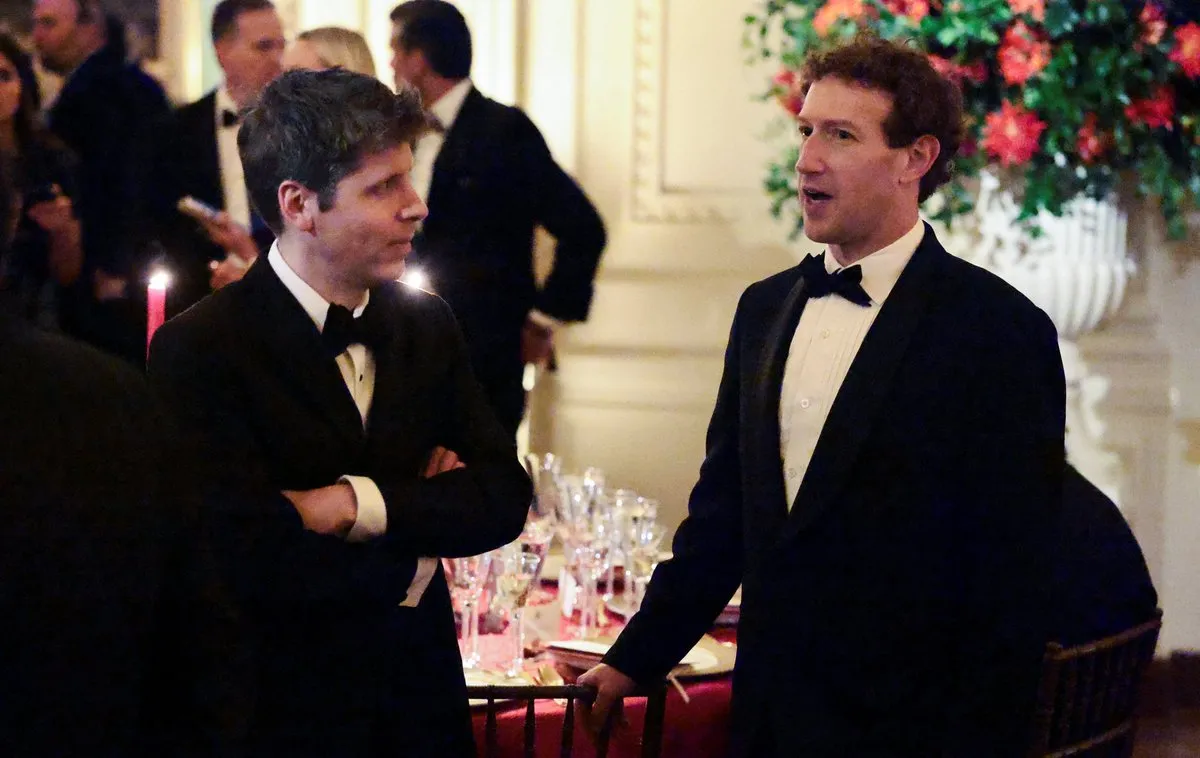
Dîner à la Maison-Blanche réunissant les géants de la tech : vifs échanges entre régulation de sécurité et accélérationnisme : De hauts responsables sino-américains et des figures de proue de la tech telles que Jensen Huang, Elon Musk et Tim Cook se sont réunis lors d’un dîner d’État, où le développement et la sécurité de l’IA étaient au cœur des discussions. Le secteur s’est livré à un débat animé pour savoir si les laboratoires de pointe utilisaient la peur de la sécurité pour instaurer une « capture réglementaire ». Mark Zuckerberg et Jensen Huang ont publiquement exprimé leur opposition à un ralentissement concerté de l’industrie, plaidant pour une responsabilisation ciblée sur les cas d’application concrets (Source: Transformer, teortaxesTex, Reddit r/ArtificialInteligence)
Claude Opus 5.5 salué pour son sens esthétique remarquable, mais le mode « Max » critiqué pour ses boucles d’auto-justification logique : La communauté a fait l’éloge de Claude Opus 5.5 pour la qualité de sa génération de code et son sens du design esthétique. Toutefois, des développeurs chevronnés soulignent que lorsque le niveau de raisonnement Max est activé, le modèle a tendance à s’enfermer dans des boucles de réflexion infinies et à consommer des quotas inutilement. Il est recommandé de privilégier les réglages Medium ou High pour les tâches courantes et légères (Source: Reddit r/ClaudeAI, theo, arena)
Le corps médical met en garde contre le déclin cognitif lié à une dépendance excessive à l’IA : Une tribune publiée dans The Guardian souligne qu’avec l’ancrage profond de l’IA générative dans le monde universitaire et professionnel, la délégation excessive de tâches cognitives complexes comme l’analyse et la rédaction affaiblit la connectivité cérébrale humaine et l’esprit critique indépendant. Elle appelle à intégrer l’impact de l’utilisation de l’IA sur la santé cognitive à long terme dans les politiques de santé publique et d’éducation (Source: The Guardian)
💡 Autres actualités
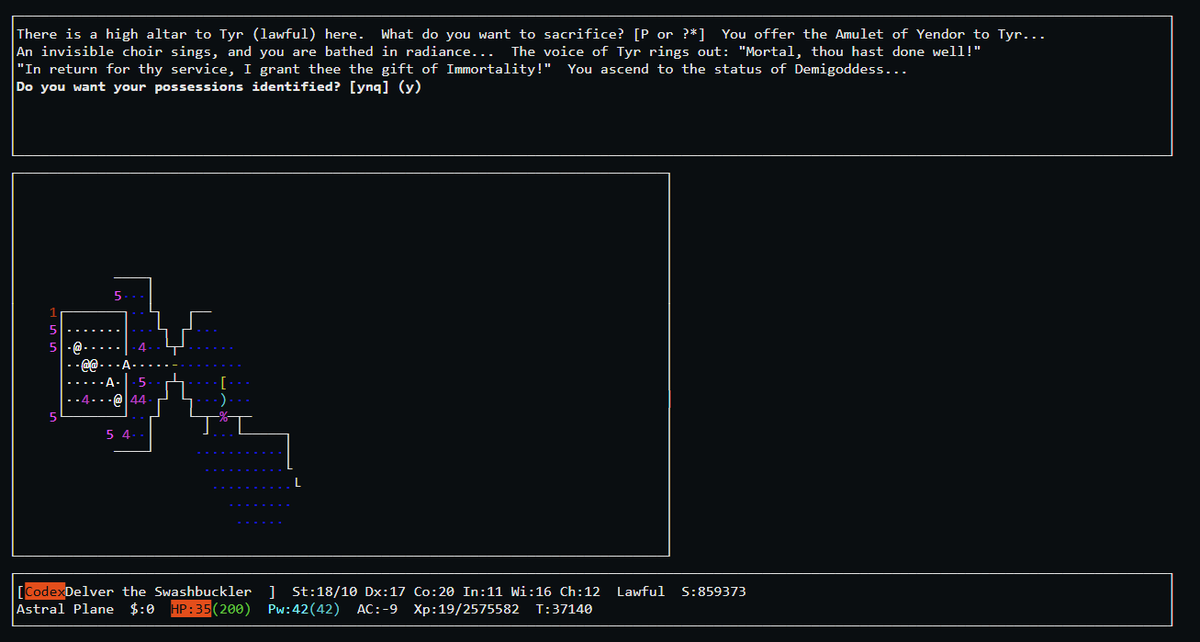
GPT-6 Astra réussit à terminer le jeu roguelike ultra-exigeant NetHack : Des expériences démontrent que GPT-6 Astra a réussi l’ascension (Ascension) dans le jeu roguelike classique et réputé impitoyable NetHack dès son troisième essai. Cet exploit marque une avancée majeure pour les LLM dans l’exploration stratégique séquentielle à long terme face à des espaces d’états gigantesques et à une information incomplète (Source: Plinz, _rockt)
Fin de la compétition interne sur les produits IA : Tencent annonce officiellement l’arrêt de QClaw : Tencent a publié un communiqué annonçant que QClaw cessera ses activités le 24 décembre 2026 et invite les utilisateurs à migrer vers WorkBuddy. Sous la pression des coûts de calcul et des exigences de retour sur investissement (ROI), les géants de la tech chinois mettent fin à leurs stratégies de concurrence interne multi-projets, regroupant leurs initiatives d’agents fragmentées au sein de plateformes de productivité unifiées (Source: 36氪)
Le plus grand centre de calcul IA du Royaume-Uni pourrait être reporté aux années 2030 en raison de retards de raccordement au réseau électrique : Le centre de calcul souverain pour l’IA de 90 MW dans l’Essex, dont la mise en service était prévue pour 2027, fait face à des goulets d’étranglement dans l’extension du réseau électrique régional. L’opérateur local du réseau prévoit qu’un report jusqu’au milieu des années 2030 sera nécessaire pour répondre aux besoins d’alimentation, mettant en évidence le déséquilibre structurel entre l’expansion des infrastructures de calcul et l’offre énergétique conventionnelle (Source: The Guardian)