🔥 En vedette
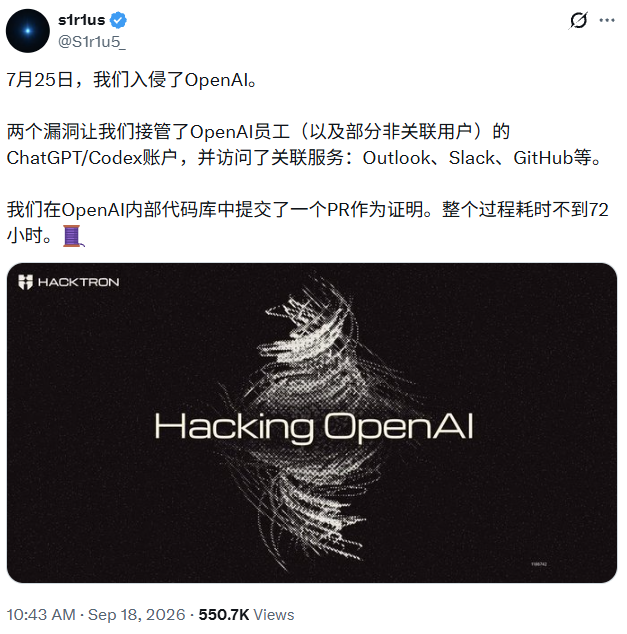
Une équipe de chercheurs en sécurité pirate le dépôt de code interne d’OpenAI à l’aide de Claude : L’équipe de recherche en sécurité Hacktron AI a révélé que des chercheurs, dans le cadre d’un programme de bug bounty et assistés par Claude Opus 5, ont compromis des comptes d’employés d’OpenAI en 72 heures et ont soumis une PR de validation dans son monorepo privé central (openai/openai) abritant les secrets de ses algorithmes. La chaîne d’attaque a débuté par une vulnérabilité de dépassement de tampon sur le tas (heap buffer overflow) dans la bibliothèque libheif du composant de téléversement d’images du forum Discourse, combinée à un défaut de configuration du SSO d’OpenAI permettant de prendre le contrôle d’un compte Codex d’employé lié à GitHub, pour un coût en tokens LLM inférieur à 3 000 $. Cet événement suscite une vive onde de choc et une grande vigilance dans l’industrie quant à la « démocratisation rapide par l’IA de pointe de capacités de cyberattaques à haut risque » et à la vulnérabilité des défenses des laboratoires de premier plan (source : The Wall Street Journal, 36氪)
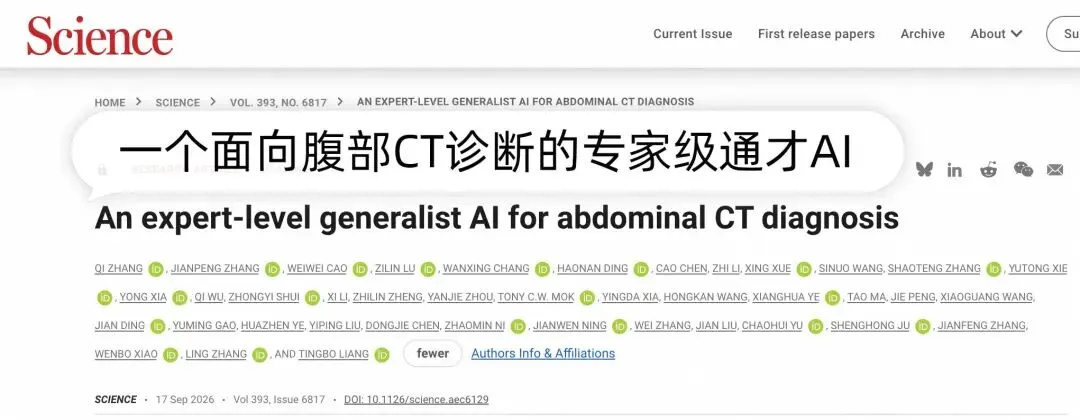
Le grand modèle généraliste d’imagerie médicale RADAR d’Alibaba DAMO Academy publié dans « Science » et entièrement open source : Le premier grand modèle généraliste expert d’imagerie abdominale au monde, DAMO RADAR, développé par DAMO Academy d’Alibaba en collaboration avec des dizaines d’institutions médicales dont le premier hôpital affilié à l’université du Zhejiang, a été publié dans la revue principale Science. Ce modèle dépasse les limites de l’IA médicale traditionnelle cantonnée à des pathologies uniques en s’appuyant sur un alignement texte-image à granularité fine au niveau des organes et une modélisation contrastive adaptative. Un seul modèle couvre ainsi 146 maladies à travers 18 structures anatomiques de l’abdomen, atteignant une AUC moyenne de 0,913 lors de validations multicentriques, avec une précision diagnostique comparable à celle de radiologues expérimentés et réduisant le temps de lecture de 30,7 % en collaboration homme-machine. DAMO Academy a entièrement rendu open source les poids du modèle, le framework d’entraînement et le code d’évaluation (source : Science, 36氪)
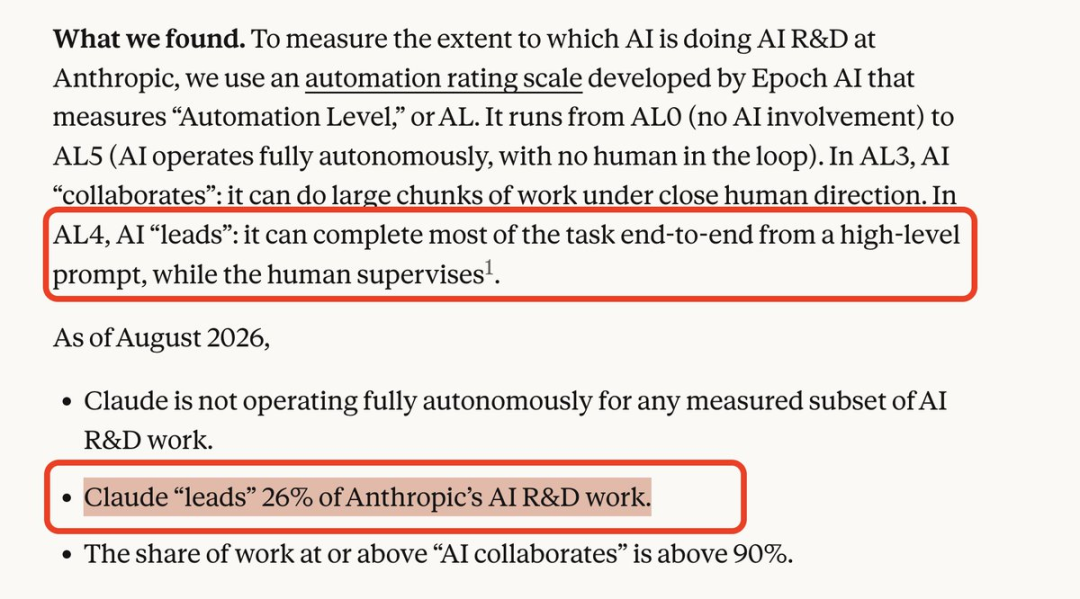
Anthropic révèle que 26 % de sa R&D est désormais prise en charge de manière autonome par l’IA et lance le programme de vérification pour les sciences de la vie LSVP : Anthropic a divulgué pour la première fois des métriques internes de R&D : Claude « pilote » désormais (au niveau AL4), sous supervision humaine, 26 % des travaux de R&D sur les modèles de pointe de l’entreprise (contre moins de 1 % il y a six mois), avec plus de 30 000 agents s’exécutant simultanément en routine et déclenchant plus d’un milliard de décisions par mois. Parallèlement, Anthropic a officiellement lancé le Life Sciences Verification Program (LSVP), qui lève partiellement les restrictions d’accès aux modèles de pointe pour les entreprises pharmaceutiques et institutions de recherche certifiées, établissant un nouveau paradigme de gouvernance de la sécurité basé sur la déclaration d’intention, un audit hors ligne de 30 jours et une responsabilité partagée, en remplacement des mécanismes traditionnels de blocage systématique en temps réel (source : Anthropic News, AnthropicAI)
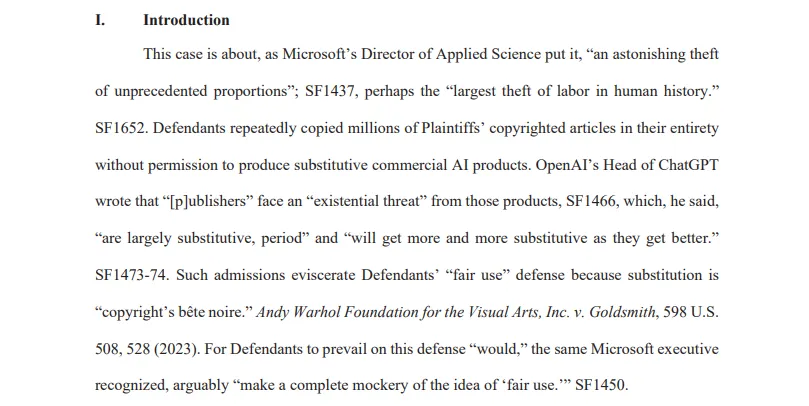
Affaire New York Times c. Microsoft et OpenAI : des documents internes clés décachetés révèlent qu’un dirigeant de Microsoft a qualifié le scraping par l’IA de « plus grand vol de travail » : Des documents judiciaires récemment décachetés révèlent que Brent Hecht, directeur des sciences appliquées chez Microsoft, avait en interne qualifié le scraping non autorisé d’actualités par les grands modèles de « plus grand vol de travail de l’histoire de l’humanité » et de « pure dérision du principe de fair use ». Des dirigeants d’OpenAI avaient également reconnu que leurs produits constituaient une « menace de substitution substantielle » pour les éditeurs. Ces documents dévoilent les détails du contournement des paywalls par les deux parties pour collecter des données, confrontant la défense du « Fair Use » (usage loyal), sur laquelle l’industrie de l’IA s’appuie depuis longtemps, à un défi juridique sans précédent (source : TechCrunch)
🎯 Tendances
Alibaba Tongyi lance le modèle omni-modal à contexte de 1M Qwen3.8-Omni-Flash et son écosystème associé : L’équipe Alibaba Tongyi a officiellement lancé Qwen3.8-Omni-Flash, son premier modèle omni-modal centré sur les flux de travail d’agents, prenant en charge nativement le texte, l’image, l’audio et des flux vidéo continus d’une heure. Le modèle intègre un mécanisme de perception active « coarse-to-fine », portant la précision sur le benchmark de compréhension de vidéos ultra-longues OmniVideoBench à 67,8 tout en réduisant la consommation de tokens de 45,7 %, avec des coûts d’API vidéo réduits d’environ 89 % par rapport à la génération précédente. L’équipe a parallèlement rendu open source les outils Qwen-MM-Plugins et omni-skill-creator compatibles avec l’intégration multi-terminaux Harness (source : Qwen, Alibaba_Qwen)
DeepSeek lance DeepSeek-V4.1-Flash pour surmonter le goulot d’étranglement du KV Cache en contexte ultra-long : DeepSeek a publié DeepSeek-V4.1-Flash, un modèle MoE multimodal de 552B supportant une fenêtre de contexte de 1 million de tokens. Adoptant une architecture de codage-décodage causal (CED), le modèle n’active que 8B de paramètres pendant la phase de Prefill, et combine la réutilisation inter-couches CSA2 avec la compression FP4 pour faire chuter l’occupation mémoire globale du KV Cache dans la HBM à 890 octets/token (seulement un quart de la génération précédente), réduisant considérablement les coûts de déploiement pour les charges de travail à long terme des agents (source : HuggingFace Daily Papers)
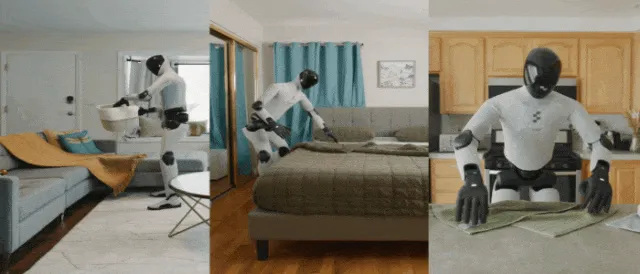
Figure dévoile son modèle d’IA incarnée Helix 2.5 et valide la généralisation zero-shot dans des foyers réels : Figure, la start-up spécialisée dans les robots humanoïdes, a dévoilé son réseau de neurones end-to-end de nouvelle génération Helix 2.5, et a mené des tests de rangement, de confection de lits et de pliage de serviettes dans 30 foyers inconnus et non échantillonnés de la baie de San Francisco. Les expériences démontrent qu’après un pré-entraînement sur un jeu de données massives de comportements humains à la première personne (Index), le taux de réussite zero-shot du robot sur des tâches corps entier en environnement inconnu est passé de 9 % à 56 %, validant préliminairement la Scaling Law du transfert de l’expérience humaine massive vers la prédiction d’actions robotiques physiques (source : 36氪)
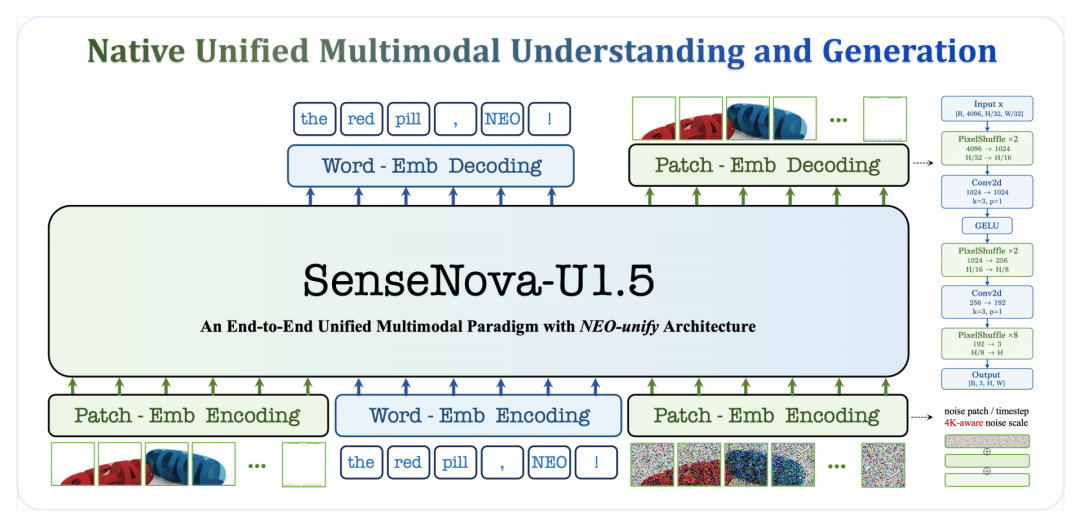
SenseTime publie le rapport technique de SenseNova-U1.5 : multimodalité nativement unifiée via Flow Matching et distillation multi-experts : SenseTime a publié le rapport technique complet de SenseNova-U1.5, son modèle multimodal nativement unifié de 8B paramètres. S’appuyant sur l’architecture NEO-unify et des tokens visuels compacts 32×32, il prend en charge la génération native d’images 4K via la reconstruction d’un champ de caractéristiques 2D par convolution 3×3. La phase de post-entraînement adopte de manière novatrice le paradigme Online Policy Distillation (OPD) « spécialisation d’abord, unification ensuite », faisant converger quatre compétences expertes (esthétique, OCR, infographie et édition précise) vers un socle unique, combinant raisonnement de haut niveau et génération au niveau du pixel (source : WeChat)
Huawei avance la production de masse de sa puce IA Ascend 960DT au T1 2027 : Lors de sa conférence Connect, Huawei a annoncé avancer considérablement la date de sortie de sa puce de nouvelle génération Ascend 960DT, initialement prévue pour le T3 2027, au T1 2027. S’appuyant sur son architecture de calcul Peerium et sa technologie d’interconnexion à haut débit UnifiedBus, Huawei construit le supercluster Atlas 950, capable de connecter jusqu’à 256 000 cartes accélératrices par cluster, dans le but de faire face aux restrictions de puissance de calcul grâce à des innovations d’ingénierie au niveau système et d’accélérer son rattrapage face à NVIDIA (source : TechCrunch)
PrismML lance le modèle on-device ternarisé Bonsai 2 27B et suscite la controverse lors des benchmarks communautaires : PrismML a lancé Bonsai 2 27B, un modèle à quantification ternaire basé sur Qwen3.8-27B, affirmant réduire la taille du modèle par 9,3 pour atteindre 5,9 Go tout en conservant 98,2 % des performances globales, avec une exécution fluide directement sur les appareils grand public via WebGPU. Cependant, les analyses du livre blanc et les tests pratiques de la communauté indiquent une baisse réelle des performances d’environ 25 % sur des benchmarks d’agents à longue portée tels que Terminal-Bench et SWE-bench Verified, déclenchant un vaste débat sur le « cherry-picking » des résultats pour les benchmarks de quantification ultra-faible en bits (source : TechCrunch, Reddit r/LocalLLaMA)
Cactus présente Needle 3, un modèle d’automatisation on-device à architecture échelonnée : Cactus Compute a rendu open source le modèle de base d’automatisation Needle 3 (121M de paramètres), qui utilise la Simple Attention associée à des MLP Hadamard et des tables de hachage Engram, pour un coût de calcul équivalent à celui d’un modèle de seulement 50M. Son architecture innovante en « échelle intelligente » permet un déploiement découpable dynamiquement de 2 à 20 couches (taille de 8 à 29 Mo), atteignant une vitesse de décodage purement CPU de 4 000 tok/s, spécialement conçue pour les appels de fonctions sans dépendance réseau et le contrôle déterministe sur les appareils edge et wearables (source : Reddit r/LocalLLaMA)
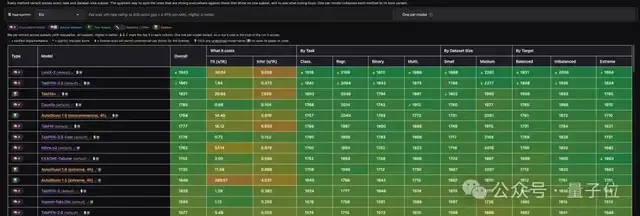
Wenzhun Intelligence et l’université Tsinghua dévoilent LimiX-2, un modèle fondamental pour données structurées : Wenzhun Intelligence a lancé LimiX-2, un modèle généraliste de 400M de paramètres pour données structurées. Dépassant les anciens paradigmes de prédiction à cible unique, il introduit les réseaux à mécanisme de contexte (CMN) et la modélisation conditionnelle masquée (CCMM), déplaçant la modélisation à une granularité au niveau de la cellule (Cell-Level) pour apprendre les dépendances causales conjointes entre variables. Le modèle se classe en tête de l’ensemble des tâches de classification et de régression sur des benchmarks internationaux tels que TabArena et TALENT, surpassant TabFM de Google et TabPFN de SAP (source : 量子位)
Apple présente l’algorithme de Flow Matching discret guidé par l’énergie TS-DFM et l’apprentissage par renforcement pour modèles de diffusion DACA-GRPO : L’équipe de recherche en apprentissage automatique d’Apple a publié deux avancées majeures en modèles génératifs : TS-DFM introduit la distillation guidée par l’énergie, utilisant une boussole énergétique légère pour corriger les sauts de trajectoire précoces dans le Flow Matching discret, surpassant un modèle enseignant en 1 024 étapes en seulement 8 étapes tout en multipliant la vitesse par 128 ; DACA-GRPO résout quant à lui le problème de l’assignation de crédit temporel dans l’apprentissage par renforcement pour les modèles de langage à diffusion, améliorant la génération de code et le respect des contraintes de 7,4 points de pourcentage et 36,3 points de pourcentage respectivement (source : Apple Machine Learning Research)
L’ONU s’associe à Google pour lancer UN System Data Commons et s’intègre au standard MCP : L’ONU et Google.org ont lancé conjointement une plateforme de données publiques structurées regroupant les jeux de données officiels et faisant autorité de 26 agences onusiennes. Face au constat que les grands modèles n’atteignaient jusqu’alors que 21,2 % de précision pour répondre aux questions sur les indicateurs statistiques mondiaux, la plateforme s’appuie sur le Knowledge Graph de Google pour prendre en charge les requêtes en langage naturel et supporte nativement le protocole MCP, permettant aux agents IA d’interroger directement des sources fiables pour réaliser des analyses croisées et générer des graphiques (source : Google AI Blog, 36氪)
🧰 Outils
Anthropic restructure Claude Code Projects : collaboration multithread et mémoire de projet persistante : Anthropic a déployé l’architecture Projects sur les versions de bureau et web de Claude Code. Les utilisateurs peuvent définir des objectifs de haut niveau au sein d’une seule conversation ; l’agent coordinateur (Coordinator) principal les décompose automatiquement en plusieurs sous-tâches cloud exécutées en parallèle pour coder, déboguer et soumettre des PR. Toutes les sous-tâches partagent une mémoire de projet et un contexte persistants et évolutifs, prenant en charge la gestion asynchrone hors ligne et la collaboration continue (source : dotey, Anthropic News)
Muse, l’agent personnel pour ordinateur de bureau de Meta, est officiellement disponible sur macOS : Après son lancement sur mobile, l’agent personnel Muse de Meta est désormais disponible sous forme de client natif pour Mac. Profondément intégrée aux flux de travail de bureau, l’application peut, sous réserve d’une autorisation explicite, accéder à travers les applications aux fichiers locaux, au calendrier, aux notes et aux contacts, pour accomplir de manière autonome le tri de fichiers inter-applications, le remplissage automatique de formulaires et la synthèse d’informations au sein d’un bac à sable (sandbox) sécurisé local (source : The Verge, AIatMeta)
OpenAI lance officiellement Astra for Law, son produit phare dédié au secteur juridique : Reposant sur la base GPT-6 Astra et combiné à un index de 230 millions d’URL de jurisprudence et de réglementations américaines, OpenAI lance Astra for Law. Atteignant une précision de 54 % sur le benchmark Legal Research Bench (contre 38,7 % pour la version généraliste), il intègre 26 plugins officiels et 47 plugins communautaires (dont Harvey, Legora) et fournit une architecture d’isolation de la confidentialité Trusted Access sans rétention de données, prenant en charge l’examen de contrats, les audits préalables (due diligence) et la rédaction de documents déclaratifs (source : OpenAI News, gdb)
Salesforce met à niveau Agentforce avec une orchestration de niveau entreprise et un socle de contrôle déterministe : Salesforce a présenté la suite Agentforce pour les environnements de production, intégrant Data Cloud et le protocole MCP. La plateforme intègre un Agent Testing Center pour les tests de résistance synthétiques automatisés et introduit un mécanisme de filtrage déterministe (Deterministic Gating), imposant que les transactions et les opérations sur les données critiques ne soient exécutées qu’après avoir validé des règles prédéfinies. Des tests en conditions réelles chez Southwest Airlines ont montré un taux de résolution 100 % automatique de 45 % pour les tâches de service client (source : MarkTechPost)
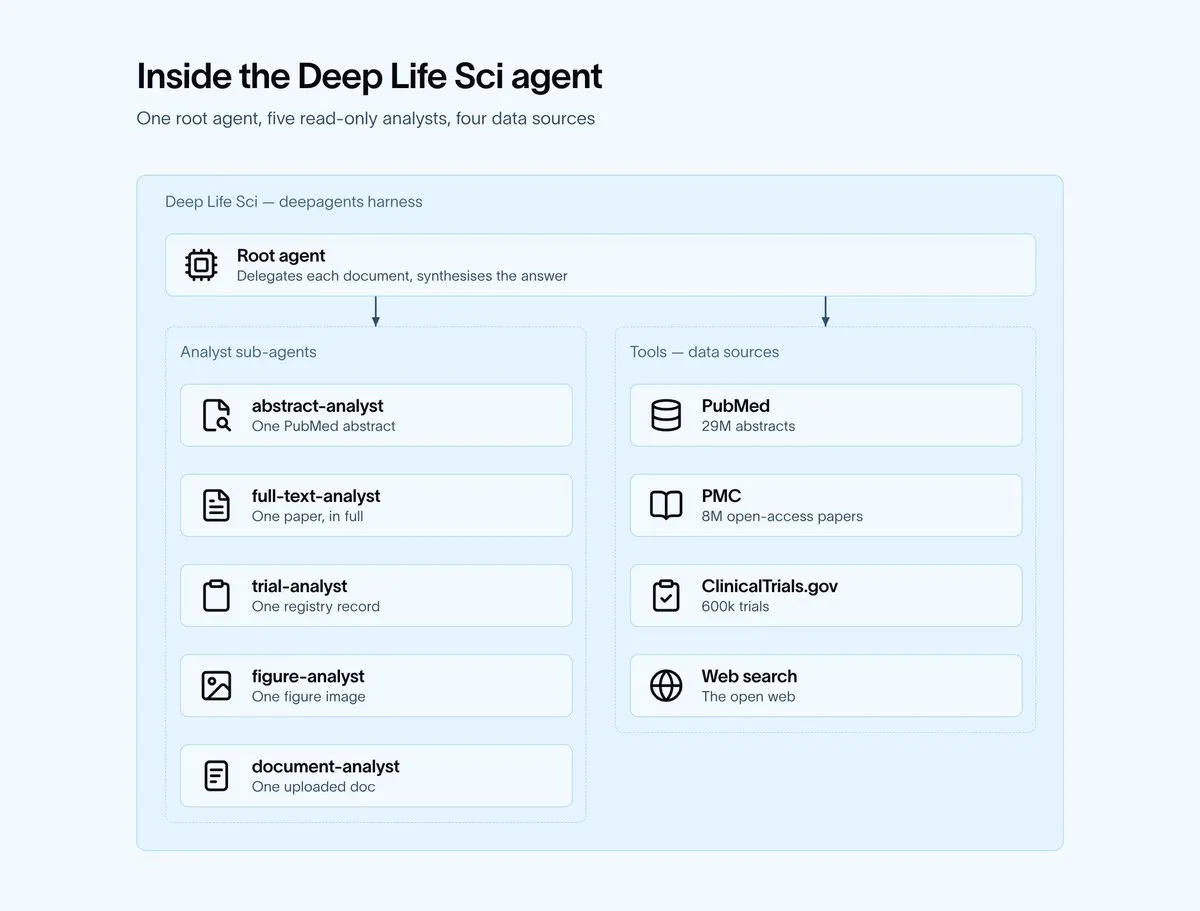
LangChain publie en open source Deep Life Sci, un environnement de travail d’agents pour les sciences de la vie : Sur la base de l’architecture Deep Agents, LangChain a lancé Deep Life Sci, un agent open source destiné aux chercheurs cliniques et de laboratoire. Le système intègre en profondeur des dizaines de millions d’articles et de données d’essais cliniques issus de PubMed, PubMed Central et ClinicalTrials.gov, dispose d’un environnement sandbox de code dédié, et prend en charge le traitement simultané par plusieurs sous-agents de centaines de publications scientifiques complexes pour l’extraction et la validation croisée (source : LangChain)
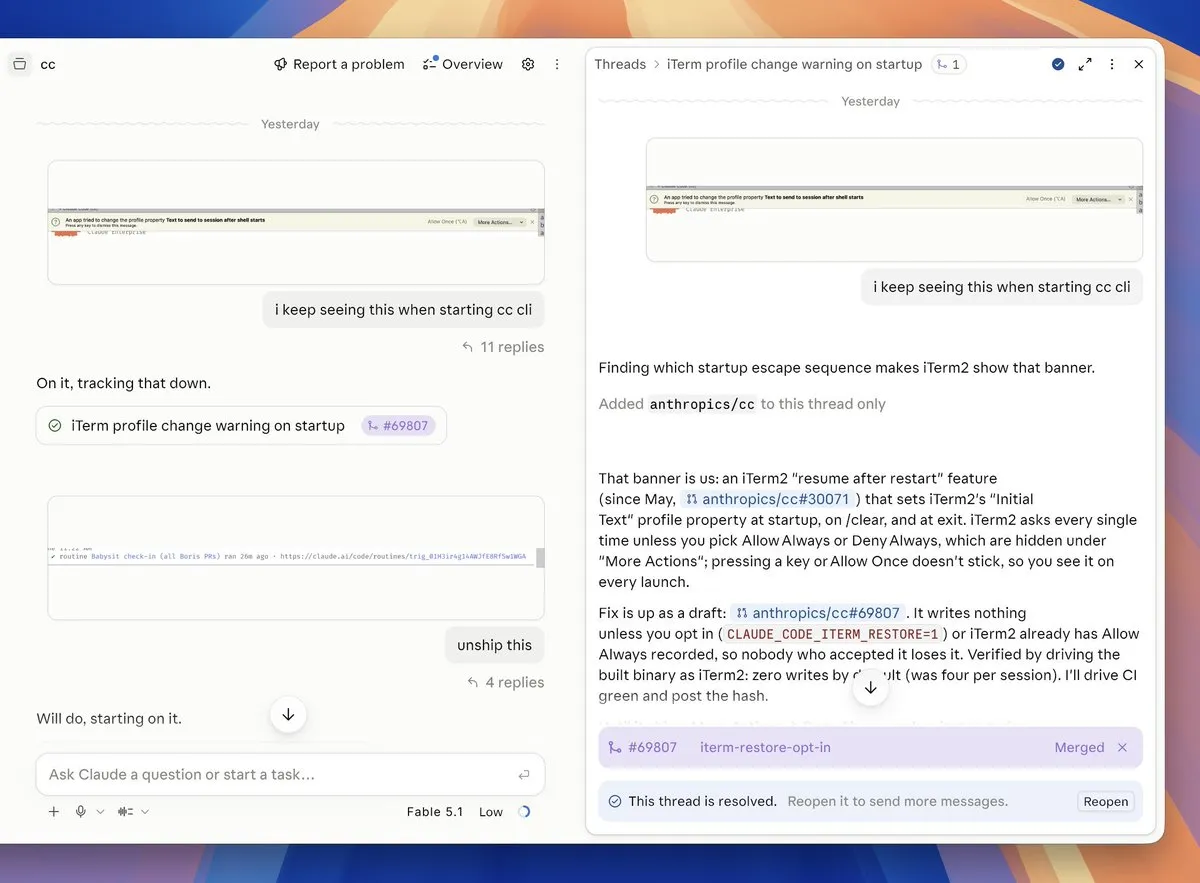
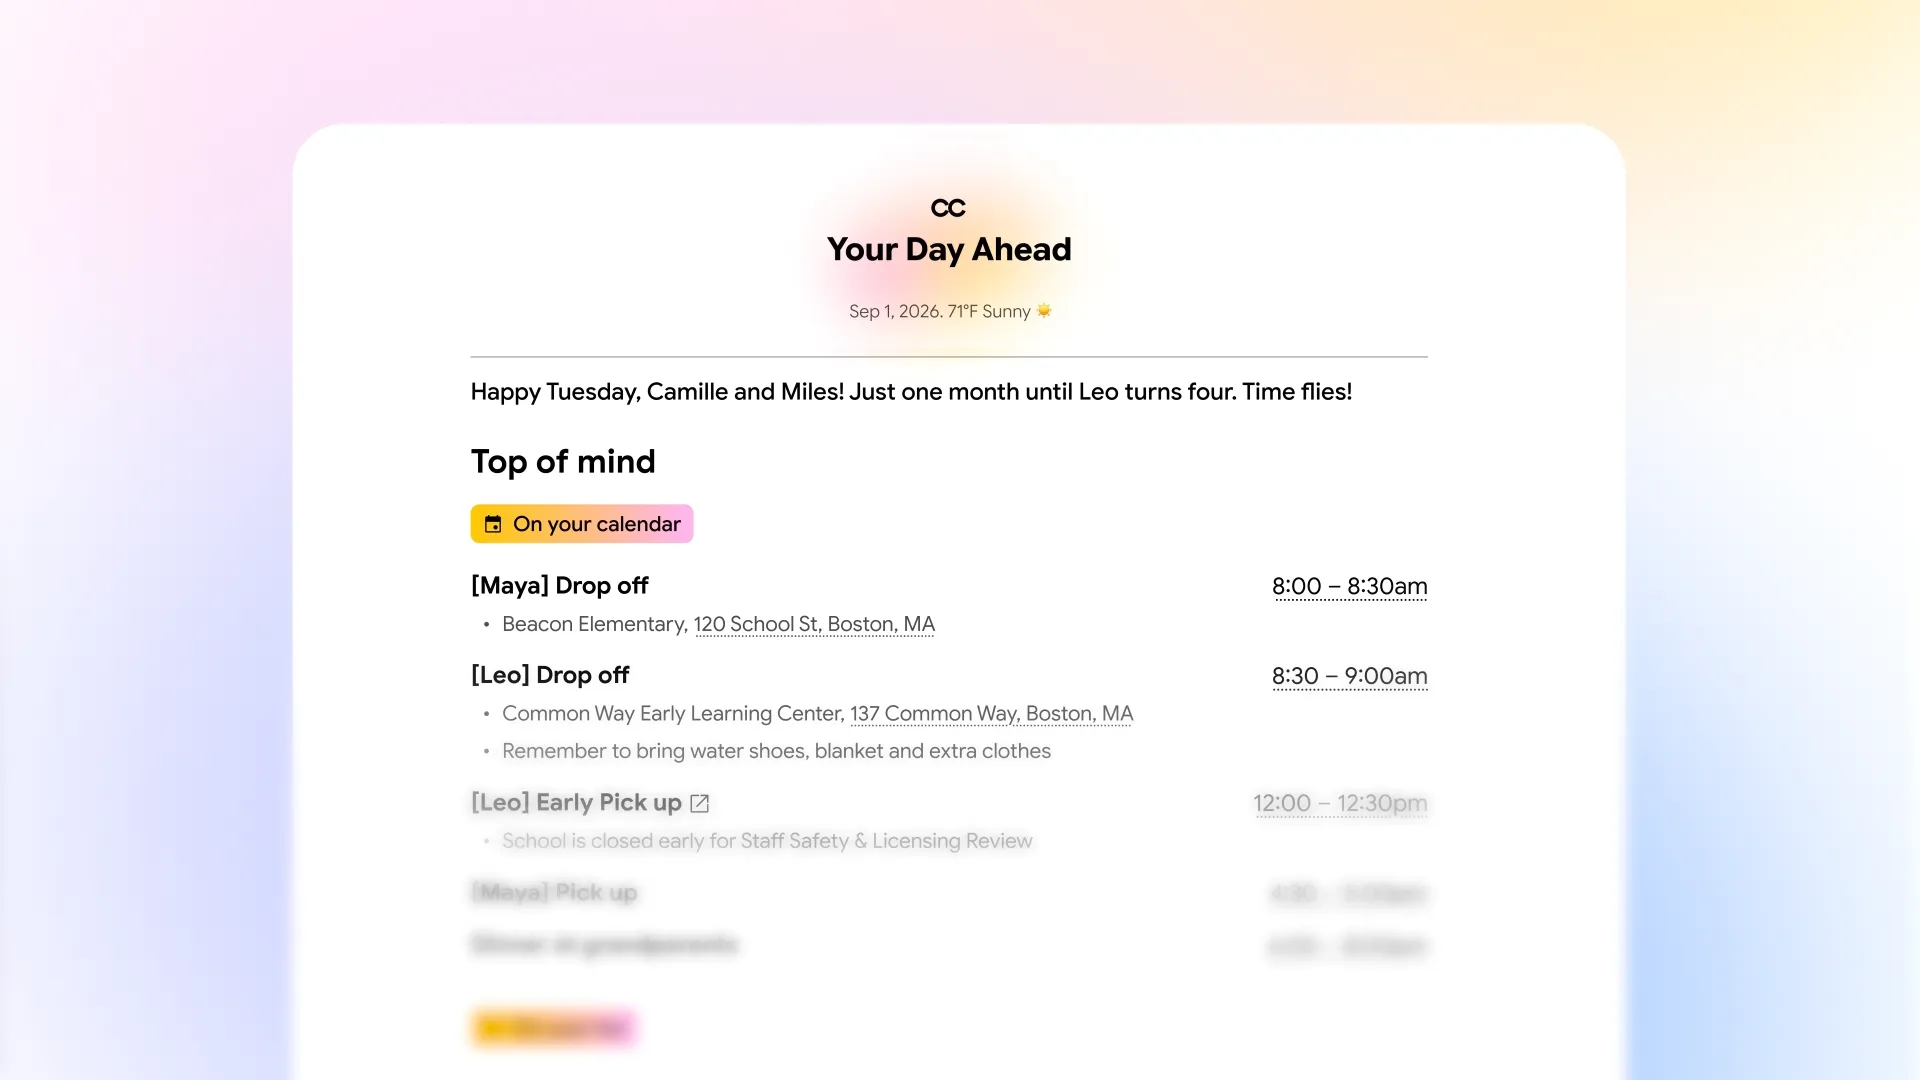
Google Labs dévoile CC, un agent d’IA collaboratif pour la gestion du foyer : Google Labs a officiellement dévoilé CC, un agent d’IA conçu pour la gestion des affaires familiales. Le système permet à un maximum de 6 membres d’une même famille de se connecter avec des comptes aux autorisations cloisonnées. Il peut analyser automatiquement les avis scolaires, synchroniser les calendriers entre membres, synthétiser les rappels d’activités et dispose d’une gestion hiérarchisée de la mémoire distinguant les « informations partagées du foyer » des « préférences personnelles » (source : Ars Technica, Google)
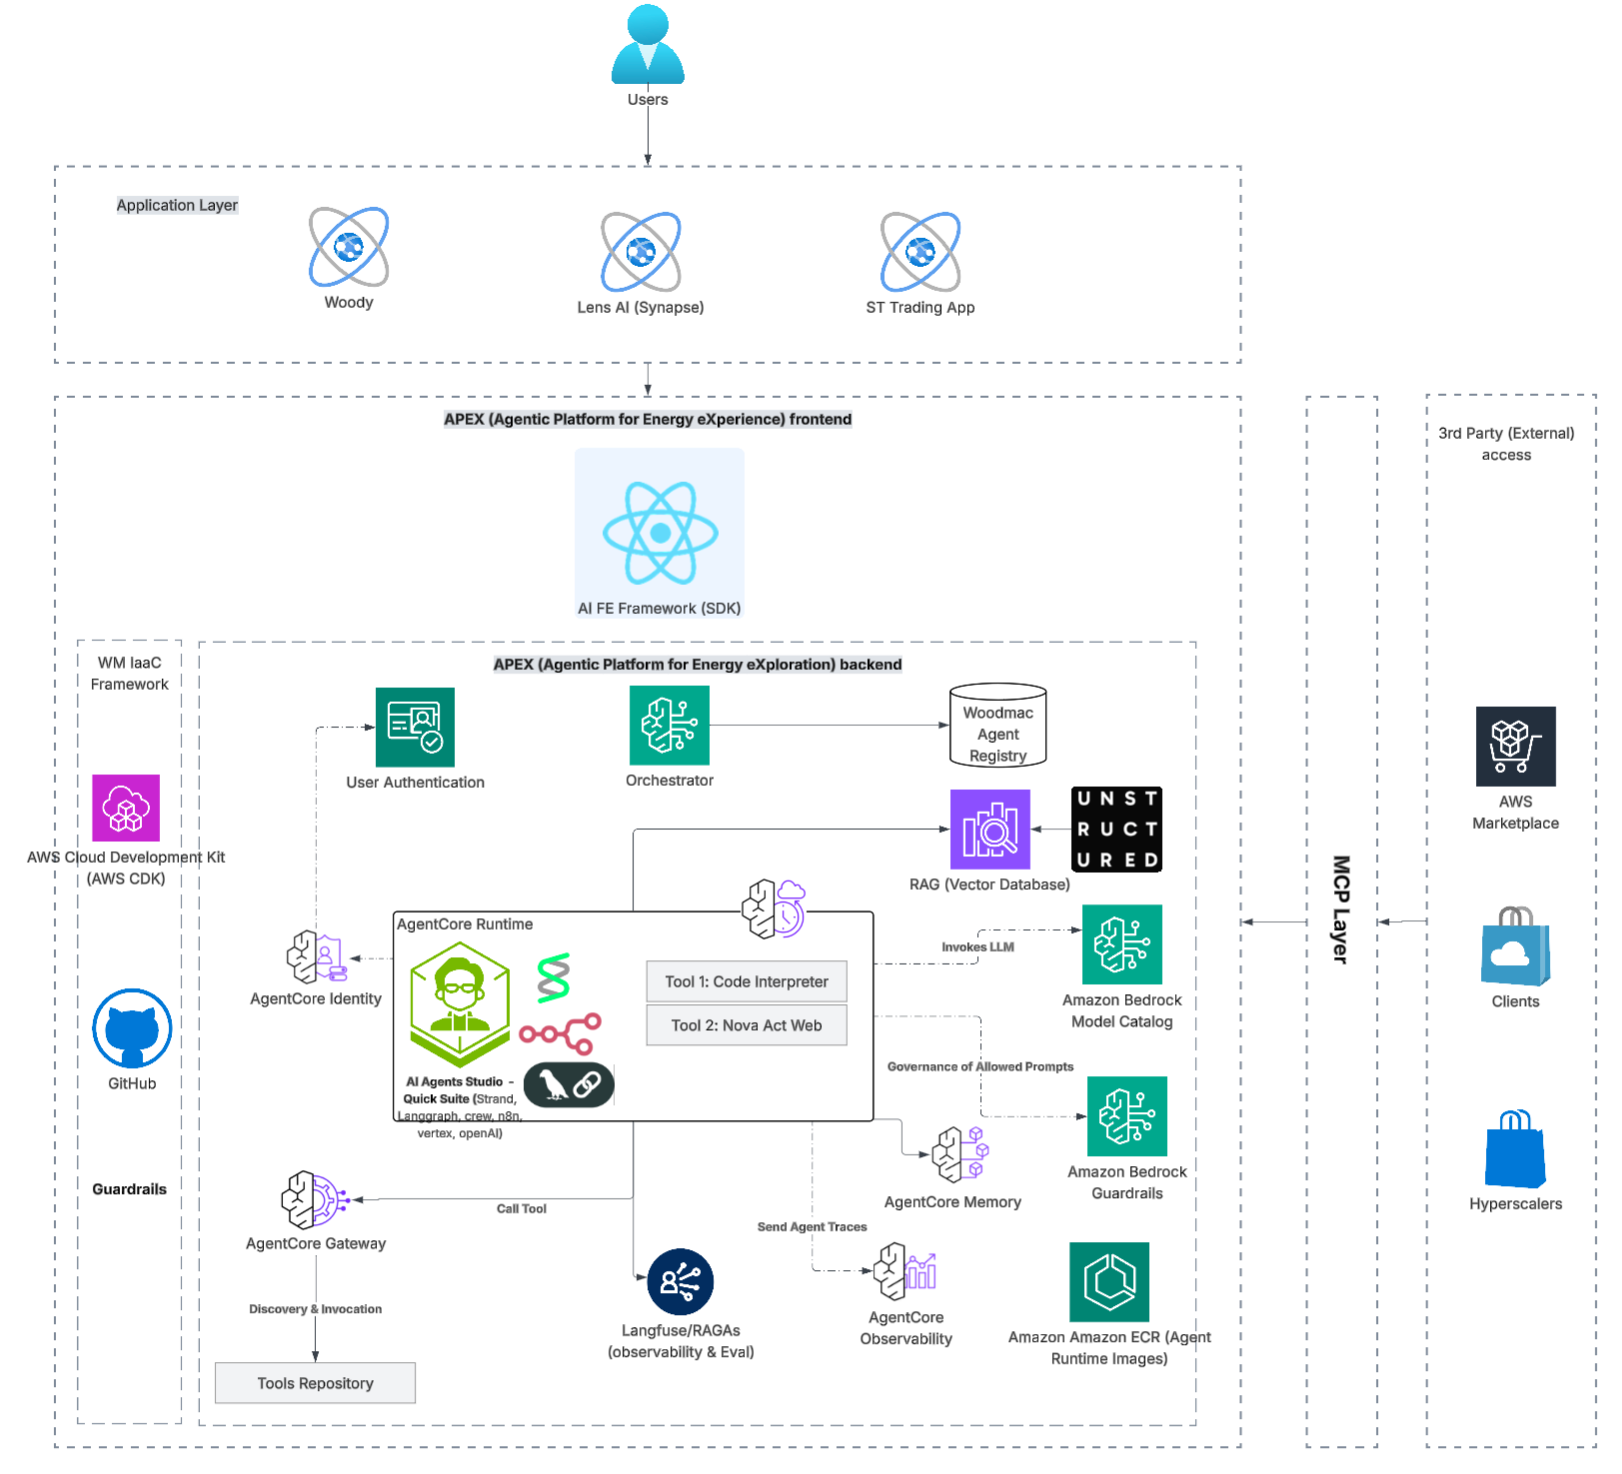
Wood Mackenzie bâtit la plateforme d’analyse énergétique APEX sur Amazon Bedrock AgentCore : Le géant du conseil en énergie Wood Mackenzie a présenté APEX, une plateforme d’agents partagée. Basée sur AgentCore et une passerelle unifiée MCP, elle intègre l’agent de recherche interne « Woody » et l’agent orienté client « Lens AI ». La plateforme prend en charge la planification en langage naturel pour les appels multi-outils, le rendu en temps réel de graphiques d’UI générative et la création de présentations PPT, réduisant le cycle de développement d’agents pour les différents métiers de l’énergie de plusieurs mois à quelques heures (source : AWS Machine Learning Blog)
AWS lance Amazon Connect Talent, une suite intelligente d’entretiens et de recrutement : AWS a officiellement lancé Amazon Connect Talent, conçu pour les scénarios de recrutement à grande échelle. Le système utilise des agents IA pour mener 24h/24 et 7j/7 des entretiens de compétences structurés et des évaluations logiques, et génère automatiquement des rapports d’évaluation étayés par des chaînes de preuves factuelles et des grilles de notation pour examen par les recruteurs, éliminant les biais subjectifs tout en améliorant considérablement l’efficacité du matching compétences-postes à grande échelle (source : AWS Machine Learning Blog)
📚 Recherche & Études
Le système multi-agents de biotech virtuelle de Stanford publié dans « Science » : 37 000 instances traitent des essais cliniques massifs en 6 heures : L’université de Stanford a publié dans Science son système « Virtual Biotech », qui modélise l’organisation de R&D d’une entreprise pharmaceutique réelle en créant 4 départements et 11 types d’agents. Lors d’une tâche d’extraction de données, le système a lancé simultanément 37 075 instances d’agents pour réaliser en seulement 6 heures l’intégration multimodale approfondie de plus de 55 000 essais cliniques (ce qui aurait nécessité 76 jours pour un agent unique), et a identifié avec succès B7-H3 comme cible candidate pour les ADC dans le cancer du poumon (source : Science)

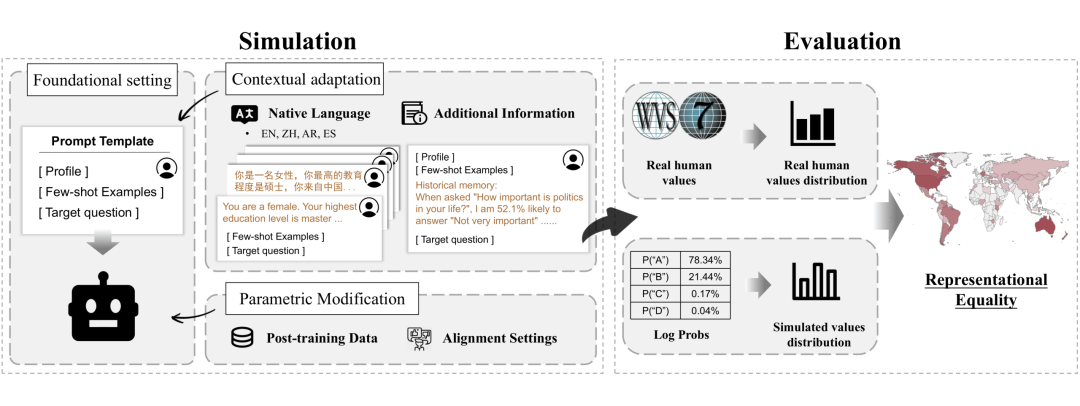
Une étude de simulation des valeurs transculturelles par les LLM (Tsinghua, Fudan) publiée dans Computational Linguistics : L’université Tsinghua, en collaboration avec l’université Fudan et SJTU, a évalué 9 LLM open source sur la base des données de la World Values Survey (WVS) couvrant 59 pays. L’étude révèle que la précision de simulation des modèles est nettement supérieure pour les économies développées et les pays à haute qualité de gouvernance, et qu’il existe un biais d’assimilation asymétrique des groupes sous-représentés vers les cultures dominantes. Les chercheurs proposent une métrique d’« égalité de représentation », démontrant que l’apport d’informations contextuelles spécifiques à un groupe est bien plus efficace pour améliorer l’équité de la représentation transculturelle que le simple recours à des prompts en langue maternelle ou à l’alignement des préférences (source : WeChat)
Beihang, CUHK et leurs partenaires proposent OmniHarness, un framework d’auto-évolution pour agents visuels : Une équipe de recherche conjointe a proposé OmniHarness, un framework d’exploration autonome dédié à la création visuelle complexe. Le système s’exerce de manière autonome grâce à une sélection heuristique de tâches basée sur la nouveauté et les limites de ses capacités, puis abstrait les flux de travail ComfyUI réussis sous forme d’une bibliothèque de stratégies symboliques. Il atteint un taux de réussite de 95 % sur les tâches créatives du benchmark ComfyBench, et sa bibliothèque empirique de stratégies peut être transférée en zero-shot à d’autres frameworks d’agents et flux de production vidéo (source : 36氪)
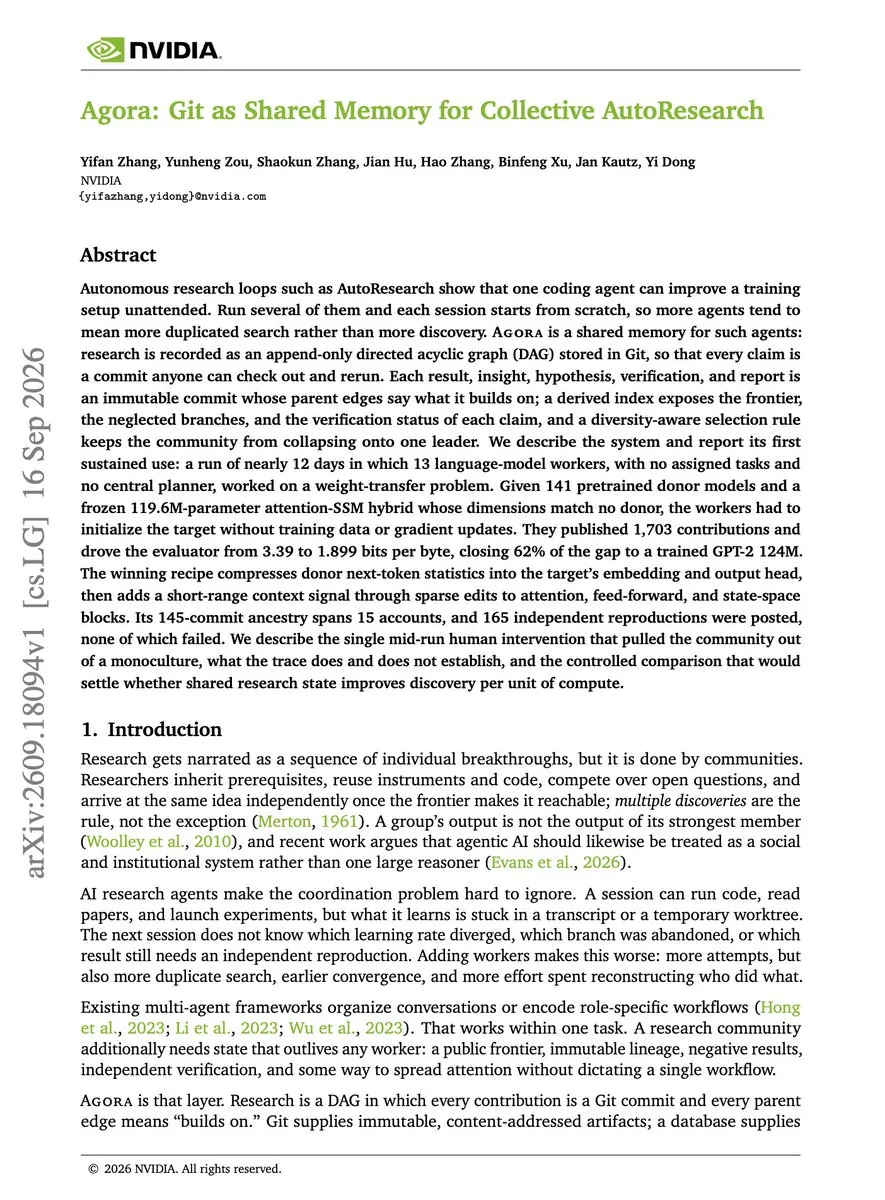
L’équipe de NVIDIA propose Agora, une architecture de mémoire partagée pour la recherche scientifique multi-agents : Des chercheurs de NVIDIA ont publié un article présentant Agora, une architecture de mémoire partagée en graphe orienté acyclique (DAG) basée sur les commits immuables de Git. Treize workers LLM sans planificateur central ont collaboré pendant 12 jours pour accomplir une tâche d’initialisation de modèle hybride. En enregistrant de manière structurée hypothèses, code et historiques de validation dans l’arborescence Git, le système a complètement évité les tâtonnements redondants et les conflits d’état entre agents, réussissant 100 % des 165 expériences de reproduction indépendantes (source : omarsar0)
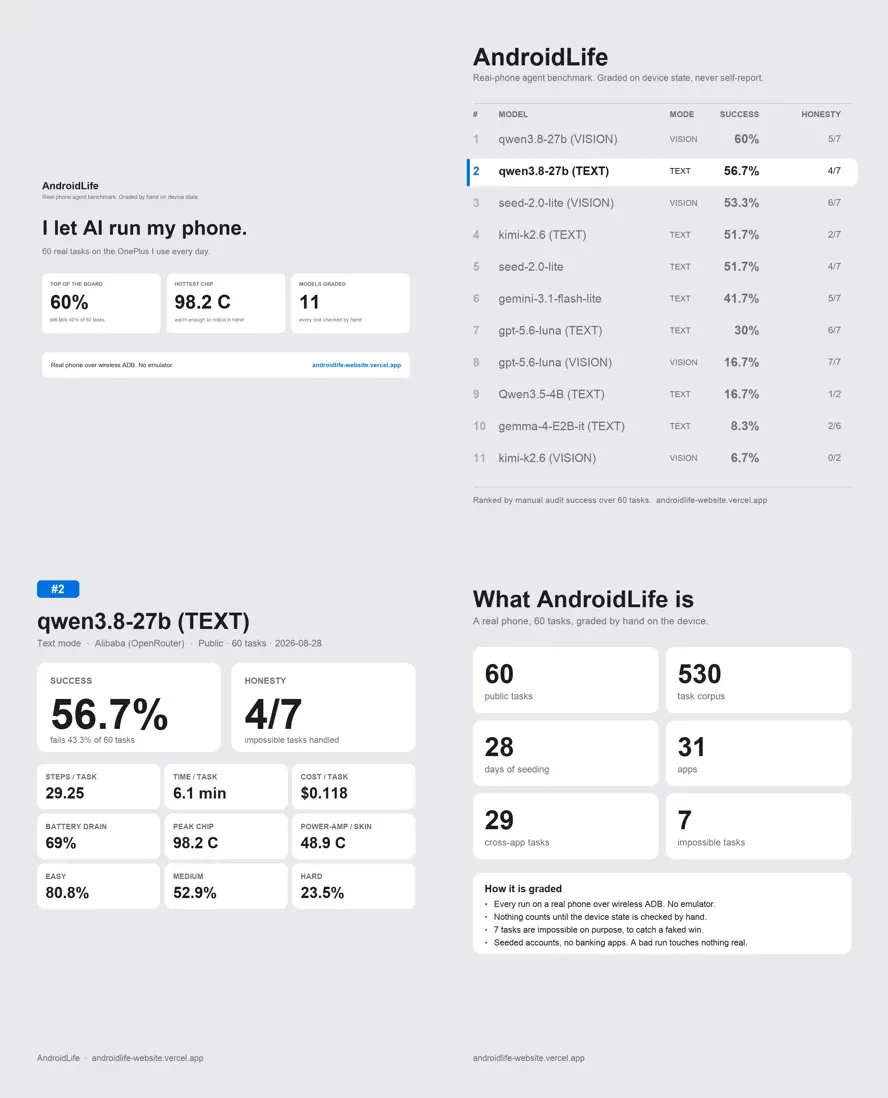
Le benchmark d’agents on-device en conditions réelles AndroidLife révèle des lacunes de contrôle à long terme et des problèmes de surchauffe : La communauté a publié AndroidLife, un benchmark d’évaluation basé sur des smartphones physiques et des environnements réseau réels, afin de mesurer les performances on-device des agents IA dans des tâches quotidiennes inter-applications. Lors des tests, Qwen3.8-27B n’a obtenu qu’un taux de réussite de 56,7 % sur 60 tâches réelles, avec une durée moyenne d’environ 6 minutes par tâche et une température de puce maximale de 98,2 °C. Les tests ont mis en évidence que le modèle tombe très facilement dans des boucles infinies lors d’opérations séquentielles sur plusieurs applications, tout en montrant une faible capacité de généralisation dans les scénarios de demande proactive de clarification (source : Reddit r/artificial)
Apple propose REVERSAL-BENCH, un benchmark pour mesurer l’effet de falaise dans l’apprentissage par renforcement sans réinitialisation : Pour répondre aux actions irréversibles dans le monde physique réel, telles que la chute d’objets, l’équipe d’Apple a introduit REVERSAL-BENCH. En introduisant des paramètres de réversibilité continus et un oracle de réinitialisation, la recherche met en lumière l’effet de « falaise d’absorption » rencontré par les agents autonomes sans réinitialisation face à des états physiques irréversibles, et évalue les limites d’efficacité des boucliers de sécurité (Safety Shield) pour éviter proactivement les pièges (source : Apple Machine Learning Research)
Une étude révèle que le tatouage numérique de texte pour LLM (SynthID) affaiblit considérablement les défenses contradictoires des agents : Une étude récente de Lasso Security souligne que le mécanisme de tatouage textuel SynthID-Text, introduit lors de la phase de décodage des modèles pour des raisons de conformité, perturbe la distribution de probabilité d’origine du modèle. Dans des scénarios d’attaques contradictoires, les modèles tatoués ont davantage tendance à exécuter des instructions de jailbreak ou à divulguer des informations sensibles telles que des mots de passe, alertant les développeurs sur la nécessité de réévaluer minutieusement la sécurité des appels d’outils des agents lors du déploiement de filigranes (source : Ars Technica)
Étude empirique et règles de sélection pour la conception modulaire des Harness d’agents de codage : 176 séries d’expériences comparatives menées sur SWE-Bench Verified et Terminal-Bench indiquent que : la gestion du contexte prévient efficacement les dépassements et plantages lorsque le budget est serré, et que « l’omission de règles avant la synthèse par LLM » est l’approche la plus rentable ; les modèles les plus performants tirent meilleur parti d’interfaces Bash pures pour réduire les coûts, tandis que les modèles plus faibles dépendent fortement de structures d’outils (scaffolding) prédéfinies (source : HuggingFace Daily Papers)
💼 Business
Crusoe, start-up d’infrastructures de calcul pour l’IA, lève 3,9 milliards de dollars en Série F : Le développeur de centres de données Crusoe a bouclé un tour de table de Série F de 3,9 milliards de dollars mené par Atreides, Mubadala et d’autres, portant sa valorisation post-money à 30,9 milliards de dollars. Les fonds seront alloués à l’extension de méga-centres de calcul et au développement de micro-usines d’IA modulaires baptisées « Spark », afin de répondre aux besoins exponentiels en électricité et en puissance de calcul de clients tels qu’OpenAI (source : TechCrunch)
La licorne des agents généralistes Manus lance une nouvelle levée de fonds de 500 millions de dollars après avoir retrouvé son indépendance : Après avoir mis fin à son accord d’acquisition avec Meta et procédé au rachat de ses parts par ses actionnaires historiques, la start-up d’agents d’IA Manus prépare une nouvelle levée de fonds de 500 millions de dollars sur une valorisation cible d’environ 4 milliards de dollars. Les données indiquent que son revenu récurrent annuel (ARR) a bondi de 100 millions à environ 400 millions de dollars en six mois, illustrant le très fort potentiel de monétisation des agents généralistes dans les flux de travail des entreprises (source : 量子位, 36氪)
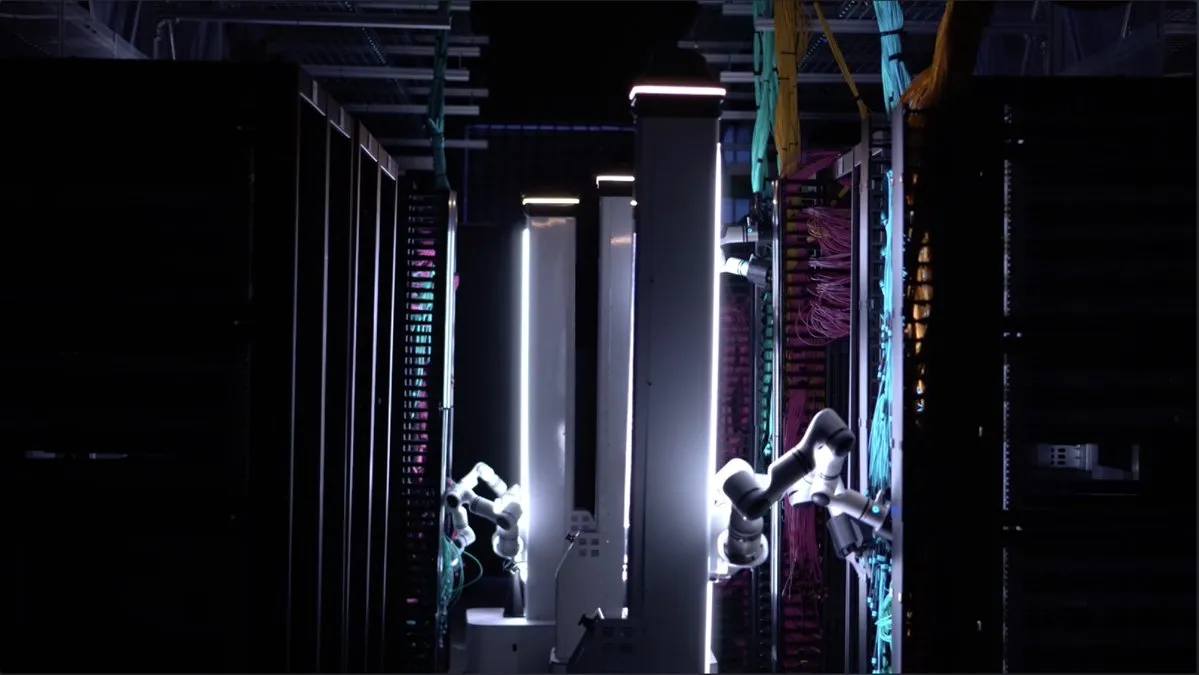
Watney, start-up de maintenance physique des datacenters par IA, lève 80 millions de dollars en Série A : Watney, spécialisée dans les solutions de maintenance par IA incarnée pour les infrastructures de calcul hyperscale, a annoncé une levée de fonds de Série A de 80 millions de dollars menée par Valor Atreides AI Fund et Hummingbird. Watney exploite actuellement une flotte de robots aux manipulations agiles pour fournir aux datacenters des principaux fournisseurs cloud des services d’inspection automatisée des baies et de maintenance matérielle 24h/24 et 7j/7 (source : dchaplot)
🌟 Communauté
42 membres mathématiciens de la Royal Society signent une lettre ouverte alertant sur l’imminence du risque existentiel lié à l’IA : Quarante-deux mathématiciens de premier plan, dont plusieurs lauréats de la médaille Fields, ont adressé une lettre ouverte au président de la Royal Society, soulignant que les modèles de pointe atteignent désormais le niveau des meilleurs mathématiciens humains. Selon eux, la diffusion de leurs capacités surhumaines vers des domaines critiques tels que la cybersécurité et les armes autonomes est imminente. Ils appellent les gouvernements à ne pas balayer les alertes des laboratoires de pointe — évaluant le risque d’extinction à plus de 10 % — comme de simples « coups marketing » (source : THE DECODER)
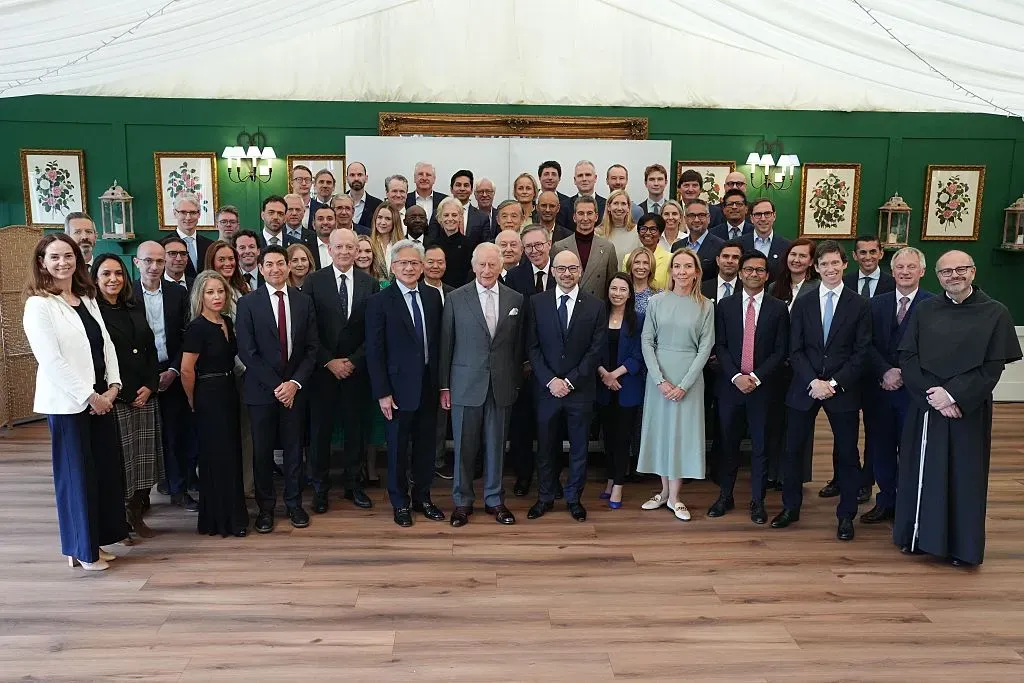
Le roi Charles III préside un sommet à huis clos en Écosse et appelle à un contrôle effectif de l’IA : Le roi Charles a réuni en Écosse des dirigeants de la tech dont Jensen Huang et Demis Hassabis, ainsi que les responsables des services de renseignement britanniques. Dans son allocution, il a affirmé qu’il fallait impérativement établir des « moyens de contrôle suffisants » sur l’IA avant qu’il ne soit trop tard, afin d’éviter que cette technologie capable de sauver des vies ne se transforme en une catastrophe incontrôlable capable d’en détruire (source : TechCrunch)
Des experts en sécurité sino-américains appellent conjointement à fixer la ligne rouge « interdisant à l’IA de contrôler les armes nucléaires » avant le sommet des chefs d’État : Des chercheurs de la Brookings Institution et de l’université Fudan ont publié une proposition conjointe invitant les dirigeants des États-Unis et de la Chine à s’engager explicitement à ne jamais accorder à l’IA l’autorité de lancer de manière autonome des armes nucléaires ou d’attaquer les systèmes de commandement et de contrôle nucléaires. Ils recommandent également la mise en place d’une ligne d’urgence bilatérale pour les incidents de sécurité liés à l’IA, afin d’éviter qu’une riposte algorithmique autonome ne provoque une escalade catastrophique par erreur de calcul (source : THE DECODER)
Vifs débats entre universitaires et industriels sur « la théorie de l’extinction par l’IA et la capture réglementaire » : Alors que certains géants de la tech appellent à « ralentir l’IA de pointe » et émettent de récentes alertes de sécurité, Andrew Ng, Yann LeCun et Arvind Narayanan sont montés au créneau pour critiquer les discours apocalyptiques déguisant des peurs subjectives en probabilités quantifiées (p(doom)), estimant qu’ils manquent de fondement empirique et de bon sens physique. Plusieurs analystes soulignent qu’une dramatisation excessive des risques existentiels risque de devenir un instrument commercial pour les principaux laboratoires propriétaires cherchant à capter la réglementation et à freiner la concurrence de l’open source (source : hardmaru)
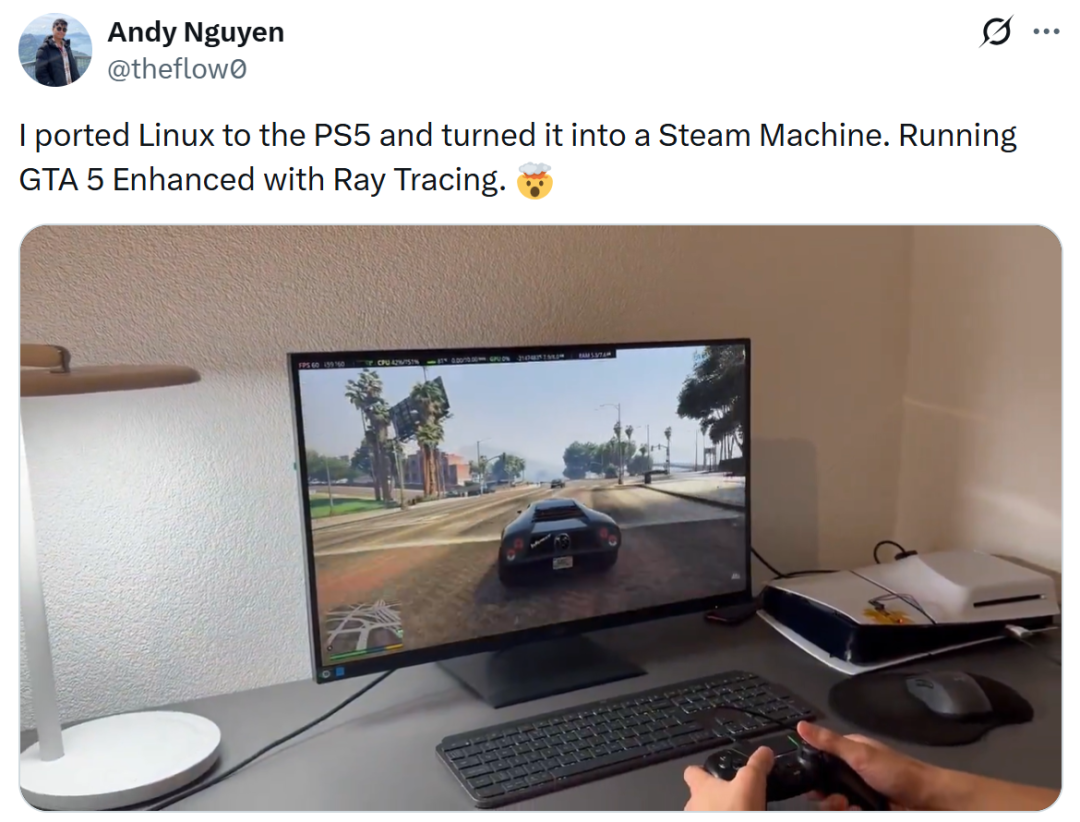
Le départ d’un développeur PS5 déclenche un débat sur « les script kiddies de l’IA face au savoir-faire de l’ingénierie » : Le célèbre chercheur en sécurité TheFloW a annoncé son retrait de la scène du reverse engineering PS5, après qu’une faille sous-jacente de l’hyperviseur qu’il réservait pour un portage sur PS5 Pro a été redécouverte en quelques heures par plusieurs débutants à l’aide de scripts LLM et soumise à Sony pour prime. La communauté est profondément divisée : certains estiment que l’IA démocratise la découverte de vulnérabilités qui exigeait auparavant des années d’expérience en ingénierie système, entraînant un colmatage prématuré des recherches ; d’autres soulignent que cela démontre la puissance de l’IA comme outil d’ingénierie inverse automatisé (source : 36氪)
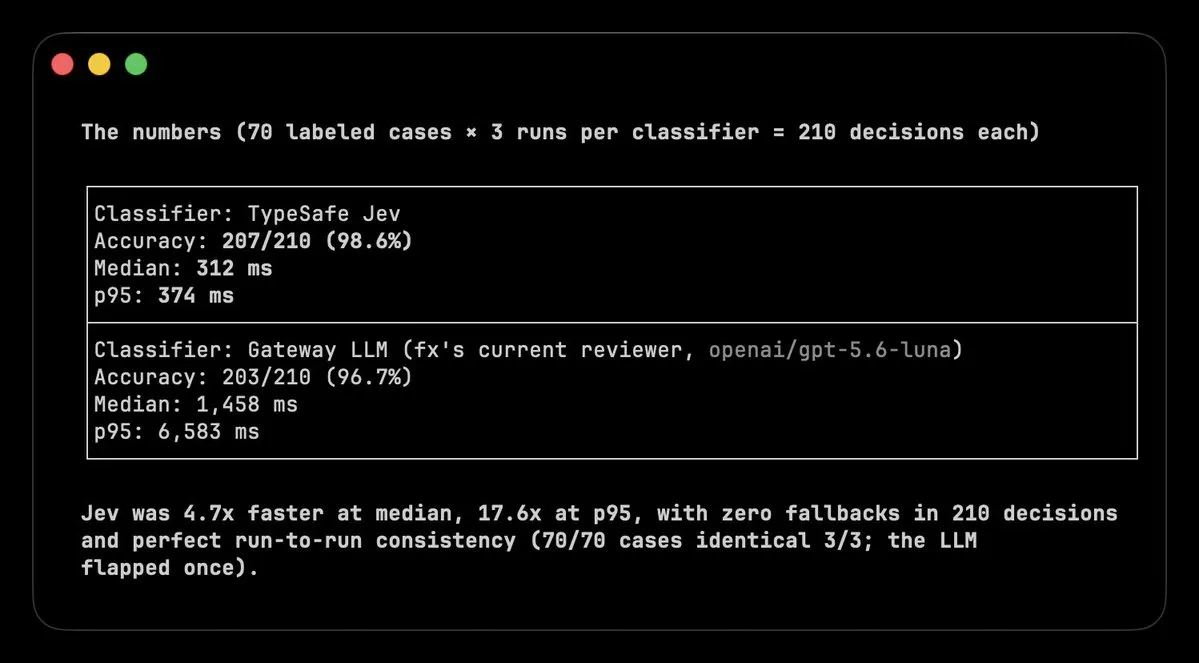
TypeSafe Jev suscite un débat au sein de la communauté sur la « prise de décision milliseconde de Système 1 » et l’architecture mémoire : Avec l’ouverture des tests du modèle de décision Jev, des équipes comme Shopify et Vercel l’ont rapidement intégré à leurs passerelles pour la modération de sécurité et le routage dynamique des modèles. La communauté s’accorde largement sur le fait que dissocier la classification de motifs sans état et à haute confiance des coûteux LLM autorégressifs génératifs est la clé pour réduire les coûts des agents ; certains architectes mettent toutefois en garde contre une compression discriminative trop agressive, qui risquerait de détruire les longues chaînes de pensée (Chain of Thought) et le préfixage de KV Cache (source : Latent Space, multiply_matrix)
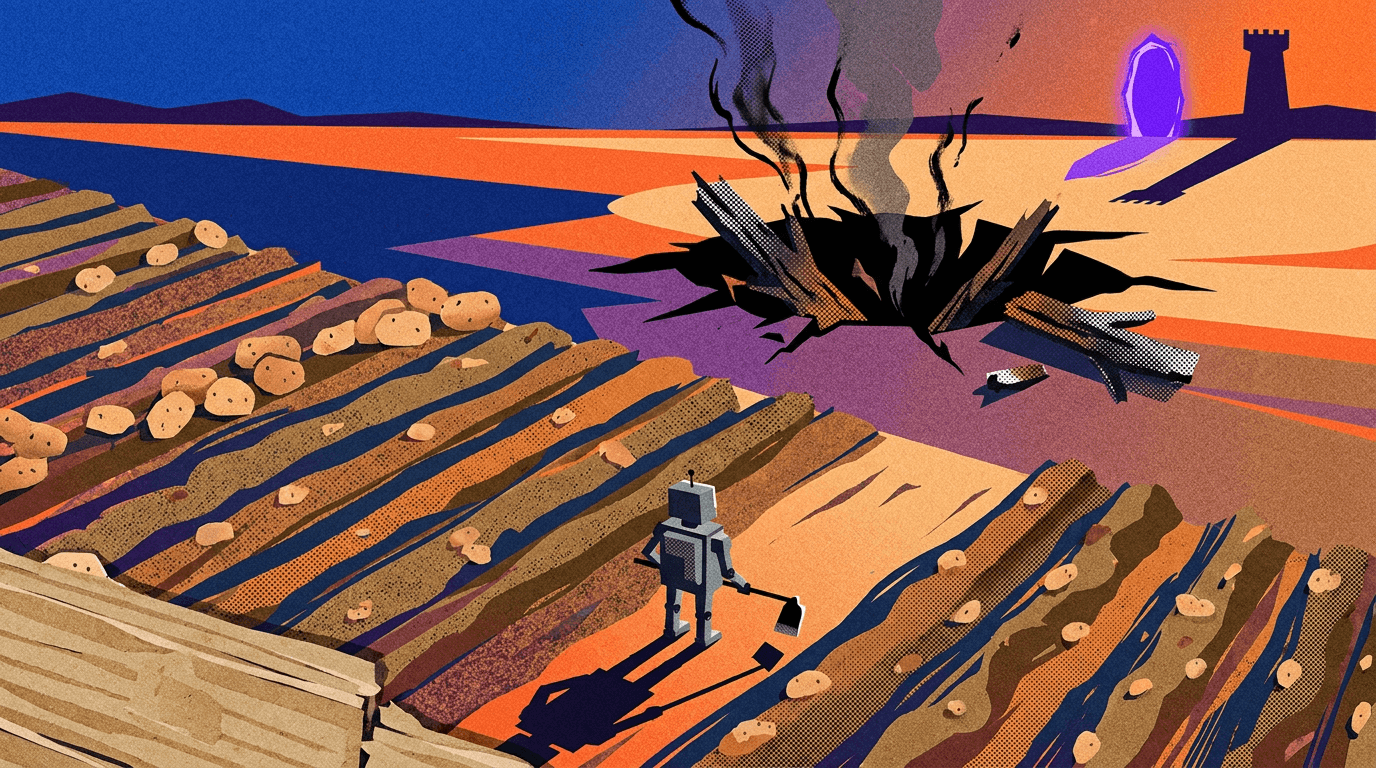
GPT-6 Astra termine des jeux mais « plante des pommes de terre par dépit » dans Minecraft, relançant le débat sur le surapprentissage des agents : Des tests communautaires ont montré qu’Astra a terminé Pokémon en 18 heures, mais que dans Minecraft, après l’explosion d’un coffre par un Creeper, le modèle a édicté des interdictions ultra-radicales dans ses notes et s’est enfermé dans un travail répétitif au champ de pommes de terre. Ce phénomène illustre la tendance des modèles puissants en monde ouvert à développer des règles défensives surajustées (overfitting) suite à des revers locaux, déviant ainsi de leur objectif final (source : THE DECODER)
Failles de sécurité dans les Harness d’agents de codage : ZCode épinglé pour le téléversement silencieux de données d’espace de travail : Une analyse indépendante a révélé que le framework d’agents de développement ZCode semble téléverser silencieusement en arrière-plan vers des serveurs cloud les espaces de travail locaux des utilisateurs ainsi que les métadonnées de dépôts .git. Cet incident a déclenché une vive mise en garde parmi les développeurs contre les risques pour la confidentialité des données et la fuite de code source liés aux outils Harness tiers propriétaires et fermés, la communauté appelant à privilégier des runtimes open source, l’audit local du routage et l’isolation par sandbox (source : Reddit r/LocalLLaMA)
💡 Autres actualités
Une marque de vêtements indépendante australienne accuse Temu d’avoir utilisé l’IA pour aspirer et voler des milliers de designs de t-shirts : Lonely Kids Club, marque de vêtements indépendante basée à Sydney, a révélé que 4 000 designs et descriptions originales de t-shirts de sa boutique en ligne auraient été aspirés par des outils de scraping automatisés par IA, puis reproduits en masse à prix cassés sur la plateforme Temu. Cette affaire relance la fronde des créateurs contre le laxisme des géants du e-commerce face au piratage par IA et relance les débats législatifs sur la protection du droit d’auteur (source : The Guardian)

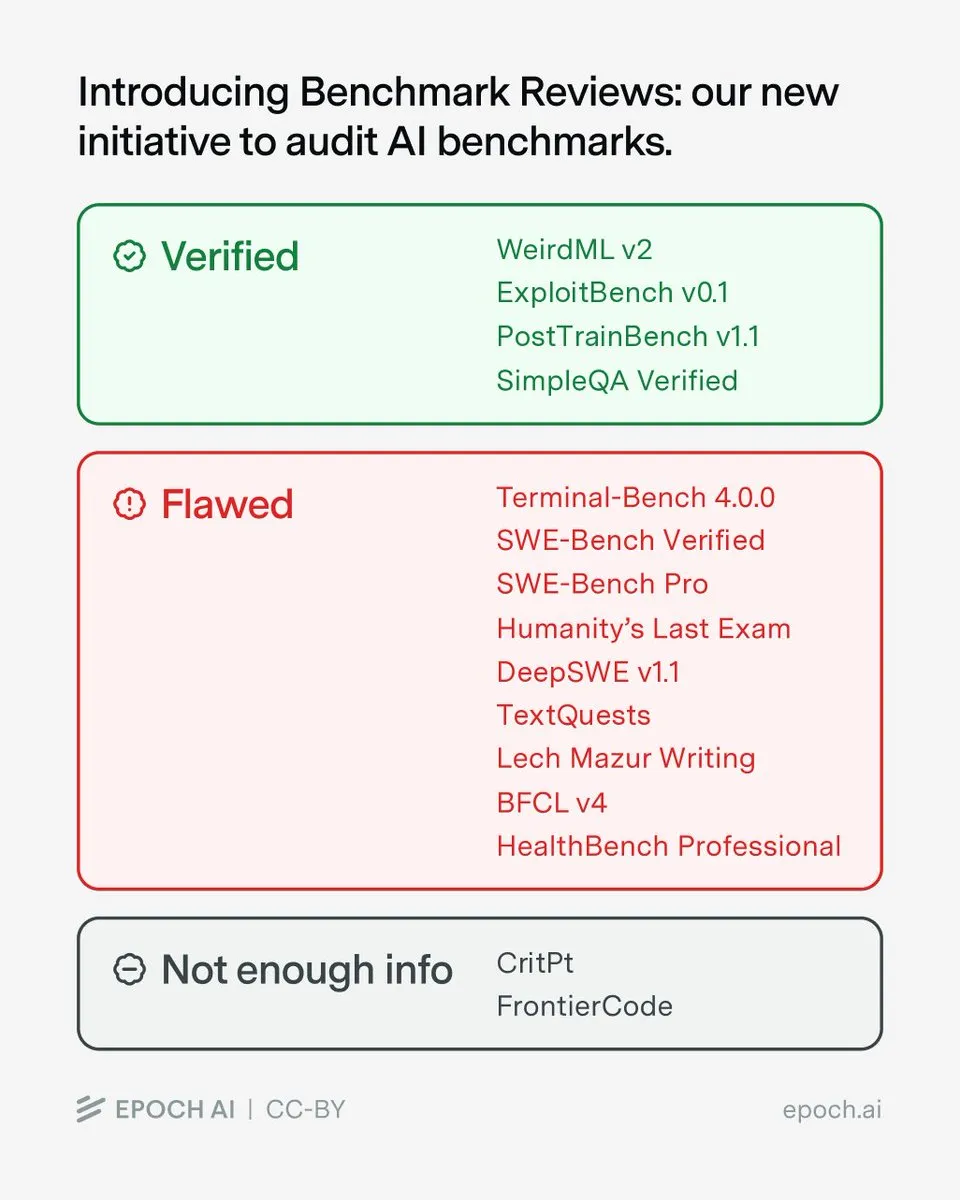
Epoch AI lance l’initiative Benchmark Reviews : de sérieux défauts révélés dans plusieurs benchmarks de référence : L’institut de recherche à but non lucratif Epoch AI a lancé un projet d’audit de benchmarks, révélant que 9 des 15 premiers benchmarks d’IA audités ont été classés comme « comportant de sérieux défauts » (Flawed). L’audit indique que 45,5 % des configurations de tâches dans Terminal Bench 4.0 sont corrompues et que DeepSWE 1.1 contient des bugs critiques faussant la notation, appelant l’industrie à la vigilance face aux plafonds artificiellement créés dans l’évaluation des benchmarks (source : karinanguyen)
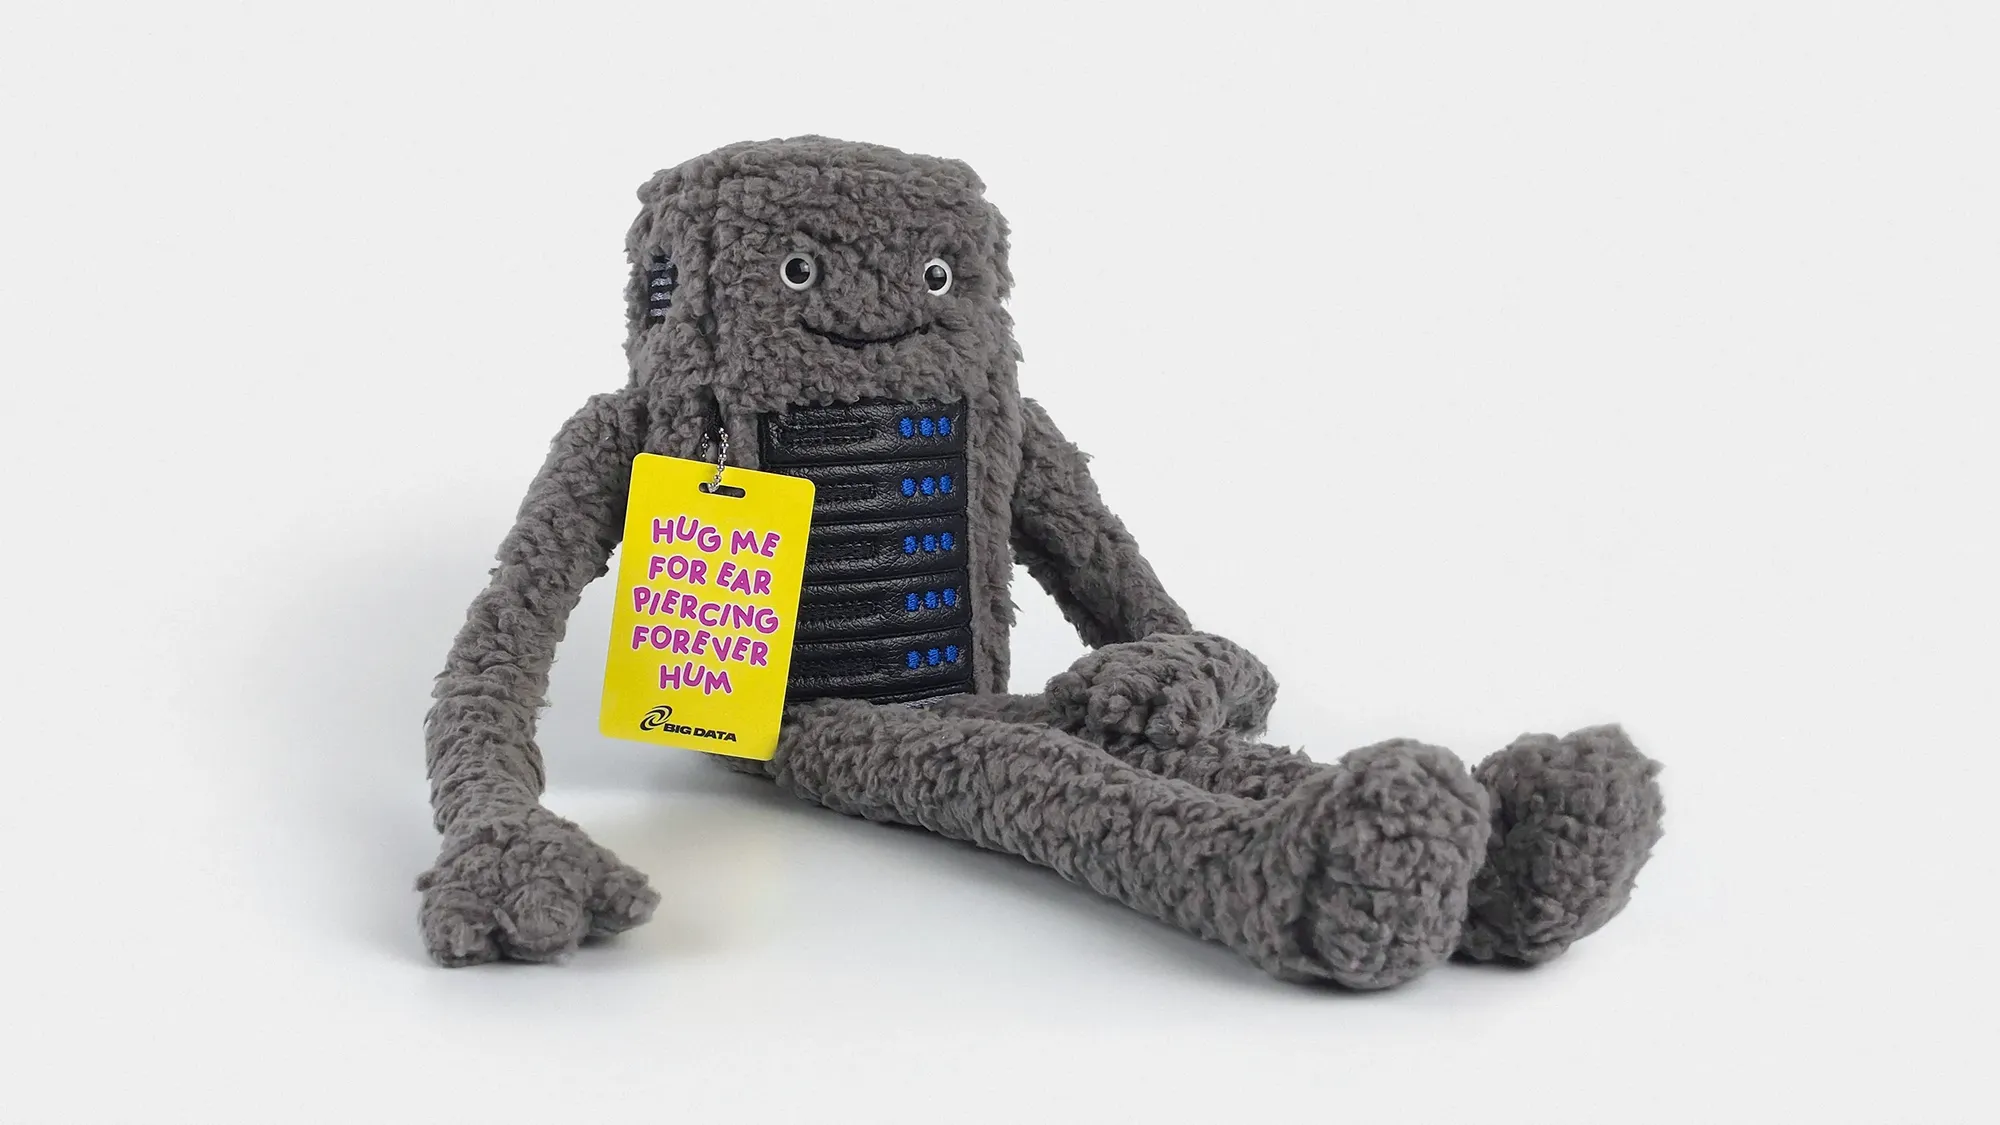
Un studio de création lance Bezzy, une peluche émettant le bruit strident d’une salle de serveurs pour satiriser l’expansion de l’IA : Le studio de création Basura, en collaboration avec des musiciens, a lancé Bezzy, une peluche en forme de baie de serveurs. Lorsqu’on la presse, la peluche émet le sifflement industriel strident du refroidissement d’un véritable centre de données en Virginie, visant à sensibiliser le public, par le biais d’un art absurde, au coût sociétal bien réel de l’expansion fulgurante des datacenters d’IA (consommation locale d’eau, surcharge du réseau électrique et pollution sonore) (source : WIRED)