🔥 En foco
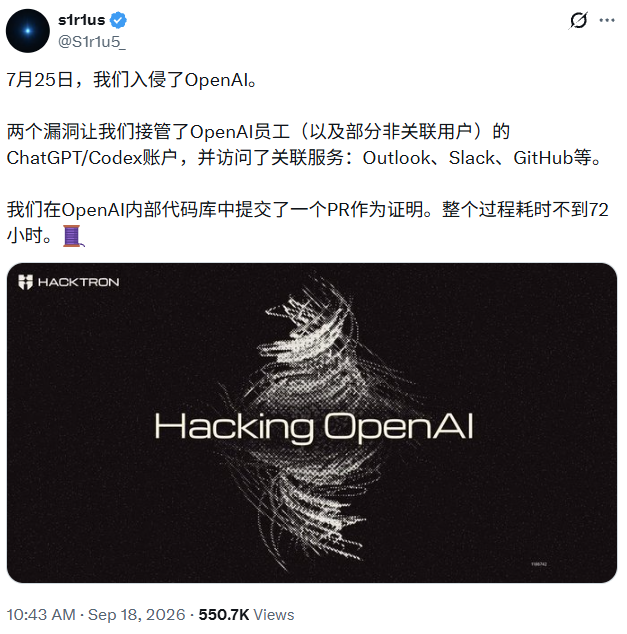
Un equipo de investigación de seguridad vulnera el repositorio interno de código de OpenAI con la ayuda de Claude : El equipo de investigación de seguridad Hacktron AI reveló que, bajo el marco de un programa de bug bounty, los investigadores vulneraron una cuenta de empleado de OpenAI en 72 horas con la asistencia de Claude Opus 5 y enviaron un PR de verificación a su repositorio monorolítico privado central (openai/openai), donde se almacenan sus secretos algorítmicos. La cadena de ataque comenzó con una vulnerabilidad de desbordamiento de búfer en el heap en libheif, presente en el componente de subida de imágenes del foro Discourse, la cual, combinada con un fallo de configuración de identidad SSO de OpenAI, permitió tomar el control de una cuenta de empleado en Codex vinculada a GitHub, con un coste en tokens de LLM inferior a 3.000 dólares. El incidente ha provocado una profunda conmoción y alerta en la industria respecto a cómo la AI de frontera está democratizando rápidamente capacidades de ciberataques de alto riesgo y la fragilidad de las defensas de los propios laboratorios de primer nivel (Fuente: The Wall Street Journal, 36氪)
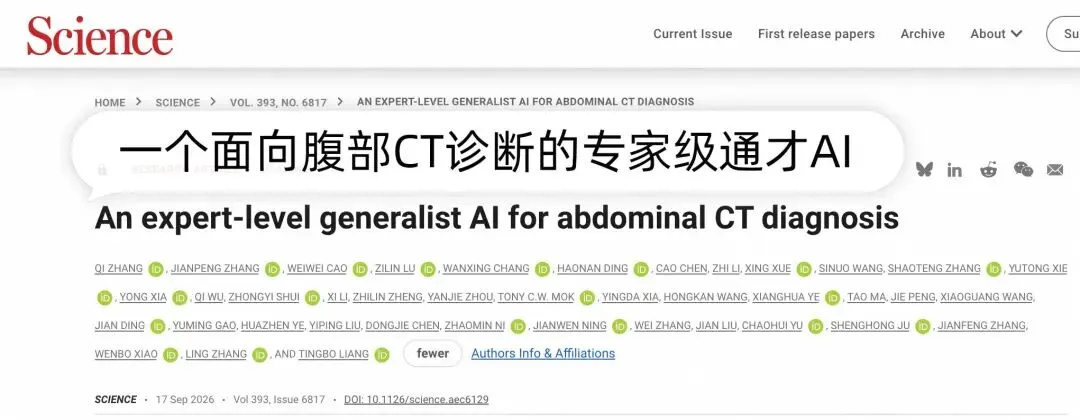
El modelo generalista de imagen médica RADAR de Alibaba DAMO Academy llega a Science y se publica en código abierto completo : DAMO RADAR, el primer modelo fundacional generalista de imagen médica abdominal a nivel experto del mundo desarrollado por Alibaba DAMO Academy en colaboración con el First Affiliated Hospital de la Facultad de Medicina de la Universidad de Zhejiang y decenas de instituciones médicas, ha sido publicado en la edición principal de Science. Este modelo supera el cuello de botella de la AI médica tradicional limitada a una sola patología; mediante una alineación texto-imagen de granularidad fina a nivel de órganos y un modelado de contraste adaptativo, un solo modelo puede cubrir 146 enfermedades en 18 estructuras anatómicas abdominales, alcanzando un AUC promedio de 0,913 en validaciones multicéntricas. Su precisión diagnóstica rivaliza con la de radiólogos sénior y la colaboración humano-máquina puede reducir el tiempo de lectura en un 30,7 %. DAMO Academy ha publicado en código abierto todos los pesos del modelo, el marco de entrenamiento y el código de evaluación (Fuente: Science, 36氪)
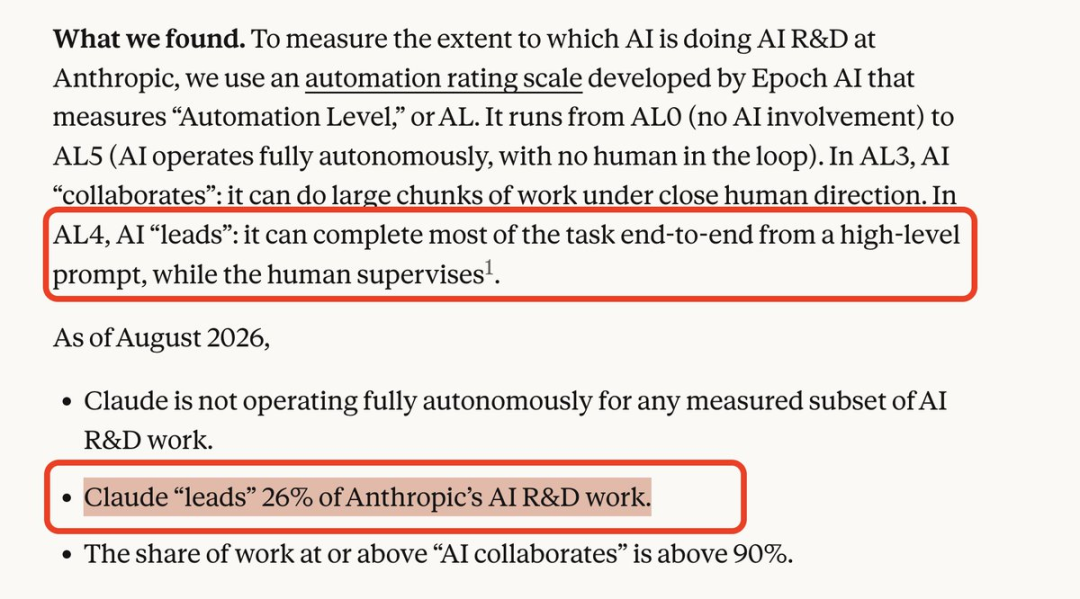
Anthropic revela que el 26 % de su I+D ya es gestionado de forma autónoma por AI y lanza el programa de validación LSVP para ciencias biológicas : Anthropic ha hecho públicos por primera vez datos de medición de su I+D interno: Claude ya lidera (nivel AL4) el 26 % del trabajo de I+D de modelos de frontera de la empresa bajo supervisión humana (frente a menos del 1 % hace seis meses), ejecutando de forma rutinaria y concurrente más de 30.000 agentes que activan más de 1.000 millones de decisiones mensuales. Al mismo tiempo, Anthropic ha lanzado oficialmente el Life Sciences Verification Program (LSVP), desbloqueando parcialmente modelos avanzados para farmacéuticas e instituciones de investigación verificadas y certificadas, estableciendo un nuevo paradigma de gobernanza de seguridad basado en la declaración de intenciones, auditorías offline de 30 días y responsabilidad compartida, en sustitución de los tradicionales mecanismos de bloqueo en tiempo real indiscriminados (Fuente: Anthropic News, AnthropicAI)
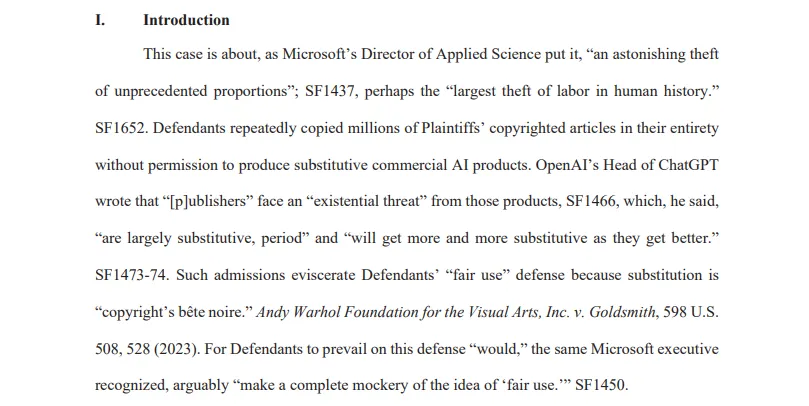
Se desclasifican documentos internos clave en la demanda de The New York Times contra Microsoft y OpenAI: un ejecutivo de Microsoft calificó el scraping de AI como el «mayor robo de mano de obra» : Documentos judiciales recientemente desclasificados revelan que el director de ciencias aplicadas de Microsoft, Brent Hecht, calificó internamente el scraping no autorizado de noticias por parte de los LLM como «el mayor robo de mano de obra en la historia de la humanidad» y «una burla absoluta al principio de Fair Use». Ejecutivos de OpenAI también admitieron en su momento que sus productos representan una «amenaza de sustitución sustancial» para los editores. Estos documentos exponen detalles sobre cómo ambas partes eludieron paywalls para recopilar datos, lo que sitúa la defensa de Fair Use, en la que la industria de la AI ha confiado durante mucho tiempo, ante un desafío legal sin precedentes (Fuente: TechCrunch)
🎯 Tendencias
Alibaba Tongyi lanza el modelo omnimodal Qwen3.8-Omni-Flash con contexto de 1M y su ecosistema complementario : El equipo de Alibaba Tongyi ha presentado oficialmente Qwen3.8-Omni-Flash, su primer modelo omnimodal centrado en flujos de trabajo de agentes, con soporte nativo para texto, imágenes, audio y secuencias continuas de video de 1 hora. El modelo introduce un mecanismo de percepción activa de grueso a fino (coarse-to-fine), aumentando la precisión en el benchmark de comprensión de video ultralargo OmniVideoBench a 67,8 y reduciendo el consumo de tokens en un 45,7 %, con una reducción en los costes de la API de video de aproximadamente el 89 % en comparación con la generación anterior. El equipo también ha liberado en código abierto Qwen-MM-Plugins y la herramienta omni-skill-creator compatibles con la integración multi-harness (Fuente: Qwen, Alibaba_Qwen)
DeepSeek lanza DeepSeek-V4.1-Flash para superar el cuello de botella de KV Cache en contextos ultralargos : DeepSeek ha lanzado DeepSeek-V4.1-Flash, un modelo MoE multimodal de 552B compatible con una ventana de contexto de 1 millón de tokens. El modelo adopta una arquitectura Causal Encoder-Decoder (CED) que activa solo 8B de parámetros durante la fase de Prefill, y combina la reutilización entre capas CSA2 con compresión FP4, reduciendo drásticamente el uso de memoria de la KV Cache global en HBM a 890 bytes/token (solo 1/4 de la generación anterior), lo que disminuye notablemente los costes de despliegue para cargas de trabajo prolongadas de agentes (Fuente: HuggingFace Daily Papers)
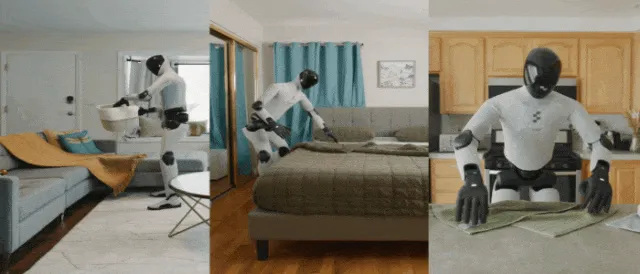
Figure presenta el modelo encarnado Helix 2.5 y valida la generalización zero-shot en hogares reales : La startup de robots humanoides Figure ha presentado Helix 2.5, una red neuronal end-to-end de nueva generación, y la ha probado en 30 hogares no muestreados del área de la Bahía de San Francisco en tareas de ordenar, hacer camas y doblar toallas. Los experimentos demostraron que, tras un preentrenamiento a gran escala con un índice de datos de comportamiento en primera persona humano, la tasa de éxito zero-shot en tareas de cuerpo entero en entornos desconocidos aumentó del 9 % al 56 %, validando preliminarmente las Scaling Laws de transferencia desde la experiencia humana masiva hacia la predicción de acciones de robots físicos (Fuente: 36氪)
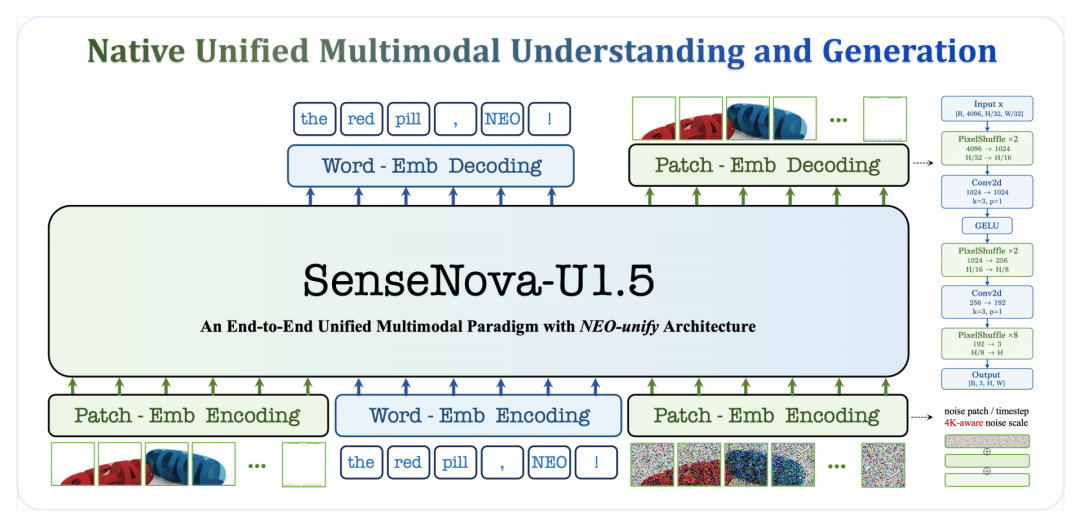
SenseTime publica el informe técnico de SenseNova-U1.5: multimodalidad nativa unificada mediante Flow Matching y destilación multi-experto : SenseTime ha publicado el informe técnico completo de SenseNova-U1.5, su modelo multimodal nativo unificado de 8B parámetros. El modelo adopta la arquitectura NEO-unify y tokens visuales compactos de 32×32, soportando la generación nativa de imágenes en 4K a través de la reconstrucción de campos de características bidimensionales mediante convolución 3×3. En la fase de post-entrenamiento, adopta de manera innovadora un paradigma de destilación de políticas online (OPD) de «especialización previa y unificación posterior», convergiendo cuatro capacidades expertas (estética, OCR, infografías y edición de precisión) en una única base, combinando razonamiento de alto nivel con generación a nivel de píxel (Fuente: WeChat)
Huawei adelanta la producción en masa del chip de AI Ascend 960DT al primer trimestre de 2027 : Durante la convención Connect, Huawei anunció que adelantará significativamente la fecha de lanzamiento de su chip Ascend 960DT de próxima generación desde el tercer trimestre de 2027 planificado originalmente al primer trimestre. Huawei se apoya en su arquitectura de computación Peerium y la tecnología de interconexión de alta velocidad UnifiedBus para construir el superclúster Atlas 950, capaz de interconectar hasta 256.000 tarjetas aceleradoras por clúster, con el objetivo de responder a las restricciones de potencia de cálculo mediante innovaciones de ingeniería a nivel de sistema y acelerar el alcance a NVIDIA (Fuente: TechCrunch)
PrismML lanza Bonsai 2 27B, un modelo on-device ternario que desata controversia en pruebas reales de la comunidad : PrismML ha lanzado Bonsai 2 27B, un modelo cuantizado a valores ternarios basado en Qwen3.8-27B, afirmando haber comprimido el tamaño del modelo 9,3 veces hasta los 5,9 GB manteniendo el 98,2 % del rendimiento general, lo que le permite ejecutarse de forma fluida directamente en dispositivos de consumo mediante WebGPU. Sin embargo, el análisis del whitepaper y las pruebas prácticas de la comunidad revelaron que en benchmarks de agentes de largo alcance como Terminal-Bench y SWE-bench Verified el rendimiento cae en realidad alrededor de un 25 %, desatando un amplio debate sobre la selección sesgada de resultados (cherry-picking) en benchmarks de cuantización extrema de bajos bits (Fuente: TechCrunch, Reddit r/LocalLLaMA)
Cactus presenta Needle 3, un modelo de automatización on-device con arquitectura escalonada : Cactus Compute ha publicado en código abierto Needle 3, un modelo base de automatización de 121M de parámetros que combina Simple Attention con Hadamard MLP y tablas hash Engram, consumiendo recursos de cómputo equivalentes a un modelo de solo 50M. Su innovadora arquitectura de «escalera inteligente» admite el despliegue dinámico recortable de 2 a 20 capas (con un tamaño de 8 a 29 MB), alcanzando una velocidad de decodificación puramente en CPU de 4.000 tok/s, enfocándose en llamadas a funciones con cero dependencia de red y control determinista en dispositivos edge y wearables (Fuente: Reddit r/LocalLLaMA)
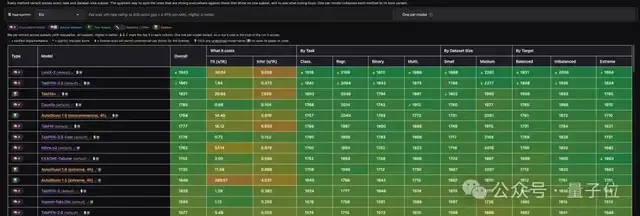
Wenzhun Intelligence y la Universidad de Tsinghua presentan LimiX-2, un modelo fundacional para datos estructurados : Wenzhun Intelligence ha presentado LimiX-2, un modelo general de 400M de parámetros para datos estructurados que cambia el paradigma tradicional de predicción de un solo objetivo al proponer Redes de Mecanismos Contextuales (CMNs) y Modelado Enmascarado Condicional (CCMM), llevando el modelado a una granularidad Cell-Level para aprender dependencias causales conjuntas entre variables. El modelo ha liderado las tareas de clasificación y regresión en benchmarks internacionales como TabArena y TALENT, superando a Google TabFM y SAP TabPFN (Fuente: 量子位)
Apple propone el algoritmo de Discrete Flow Matching TS-DFM guiado por energía y el aprendizaje por refuerzo por difusión DACA-GRPO : El equipo de Machine Learning de Apple ha publicado dos avances en generación de vanguardia: TS-DFM propone la destilación guiada por energía, utilizando una brújula de energía ligera para corregir los saltos tempranos de trayectoria en Discrete Flow Matching, superando en solo 8 pasos al modelo maestro de 1.024 pasos y acelerando el proceso 128 veces; DACA-GRPO resuelve el reto de asignación de crédito temporal en el aprendizaje por refuerzo para modelos de lenguaje por difusión, mejorando la generación de código y el seguimiento de restricciones en 7,4 puntos porcentuales y 36,3 puntos porcentuales, respectivamente (Fuente: Apple Machine Learning Research)
La ONU se asocia con Google para lanzar UN System Data Commons integrado con el estándar MCP : La Organización de las Naciones Unidas y Google.org han lanzado conjuntamente una plataforma de datos públicos estructurados que integra conjuntos de datos oficiales y autorizados de 26 agencias de la ONU. Abordando el problema de que los grandes modelos solo tenían una precisión del 21,2 % al responder sobre métricas estadísticas globales, la plataforma se basa en el Knowledge Graph de Google para admitir consultas en lenguaje natural e integra nativamente el protocolo MCP, permitiendo a diversos AI Agents consultar directamente fuentes autorizadas para realizar análisis cruzados y generar gráficos (Fuente: Google AI Blog, 36氪)
🧰 Herramientas
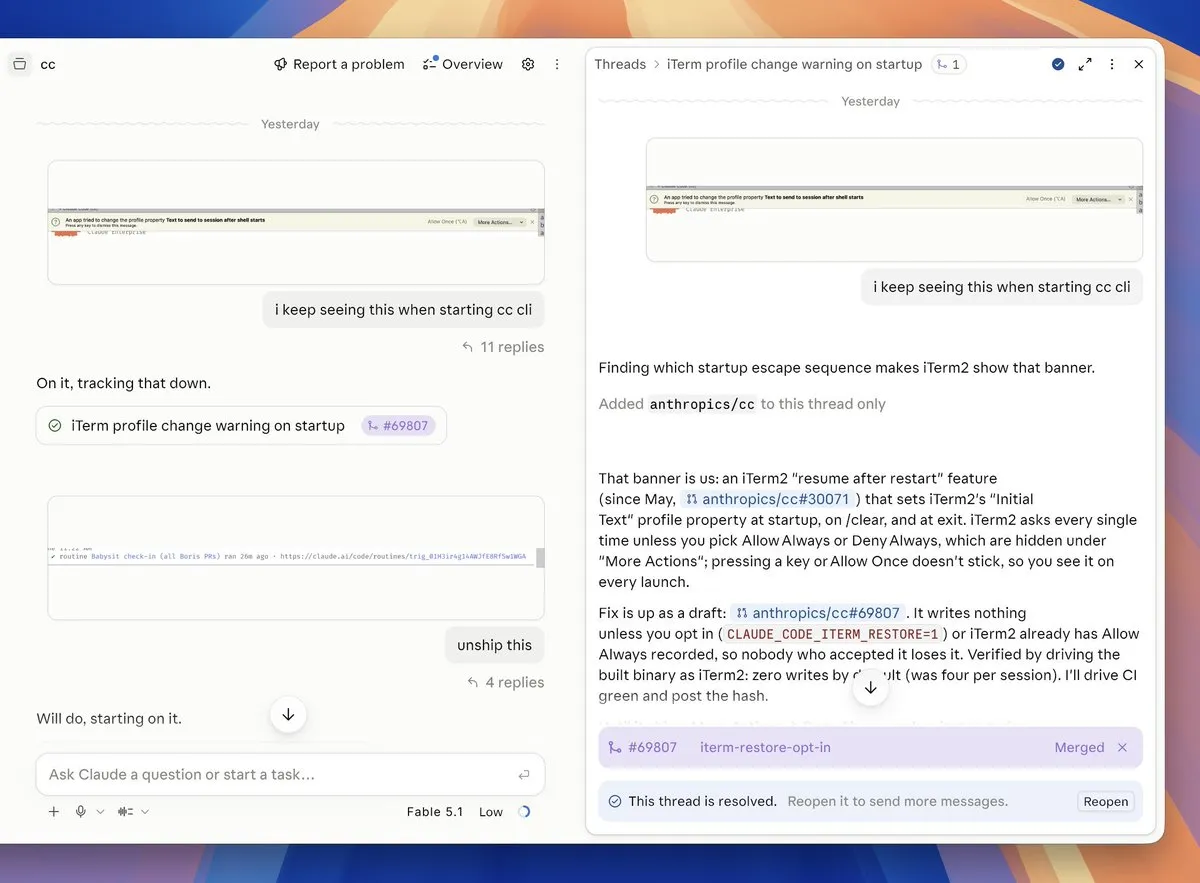
Anthropic reestructura Projects en Claude Code con colaboración multihilo y memoria persistente del proyecto : Anthropic ha lanzado la arquitectura Projects en las versiones de escritorio y web de Claude Code. Los usuarios pueden definir objetivos de alto nivel en una sola conversación, y un agente coordinador central (Coordinator) los descompone automáticamente en múltiples ramas de subtareas paralelas en la nube para ejecutarlas de forma independiente, depurar bugs y enviar PRs. Todas las subtareas comparten una memoria de proyecto y un contexto en constante evolución persistente, con soporte para gestión asíncrona offline y colaboración continua (Fuente: dotey, Anthropic News)
Muse, el agente personal de escritorio de Meta, se lanza oficialmente en macOS : Muse, el agente personal de Meta, ha lanzado su cliente nativo para Mac tras su debut en dispositivos móviles. La aplicación se integra profundamente en los flujos de trabajo del escritorio y, bajo un mecanismo de autorización explícita, accede a archivos locales, calendarios, notas y contactos entre aplicaciones, ejecutando de forma autónoma la organización de archivos entre apps, el autocompletado de formularios y la consolidación de información dentro de un sandbox de seguridad local (Fuente: The Verge, AIatMeta)
OpenAI lanza oficialmente Astra for Law, su producto insignia para el sector legal : Basado en el modelo GPT-6 Astra, OpenAI ha presentado Astra for Law, integrado con un índice de jurisprudencia y regulaciones legales de EE. UU. que abarca 230 millones de URLs. En las pruebas de Legal Research Bench alcanza una precisión del 54 % (frente al 38,7 % de la versión general), integrando 26 plugins oficiales y 47 comunitarios, incluidos Harvey y Legora, además de ofrecer una arquitectura de aislamiento de privacidad Trusted Access con retención cero de datos, dando soporte a la revisión de contratos, due diligence de transacciones y redacción de documentos regulatorios (Fuente: OpenAI News, gdb)
Salesforce actualiza Agentforce con orquestación empresarial y una base de interceptación determinista : Salesforce ha lanzado la suite Agentforce para entornos de producción, integrando Data Cloud y el protocolo MCP. La plataforma incluye Agent Testing Center para pruebas de estrés sintéticas automatizadas e introduce un mecanismo de compuertas deterministas (Deterministic Gating), que obliga a que las transacciones y operaciones sobre datos críticos solo se ejecuten tras cumplir reglas preestablecidas. Pruebas reales en Southwest Airlines mostraron que logró una tasa de resolución completamente autónoma del 45 % en tareas de atención al cliente (Fuente: MarkTechPost)
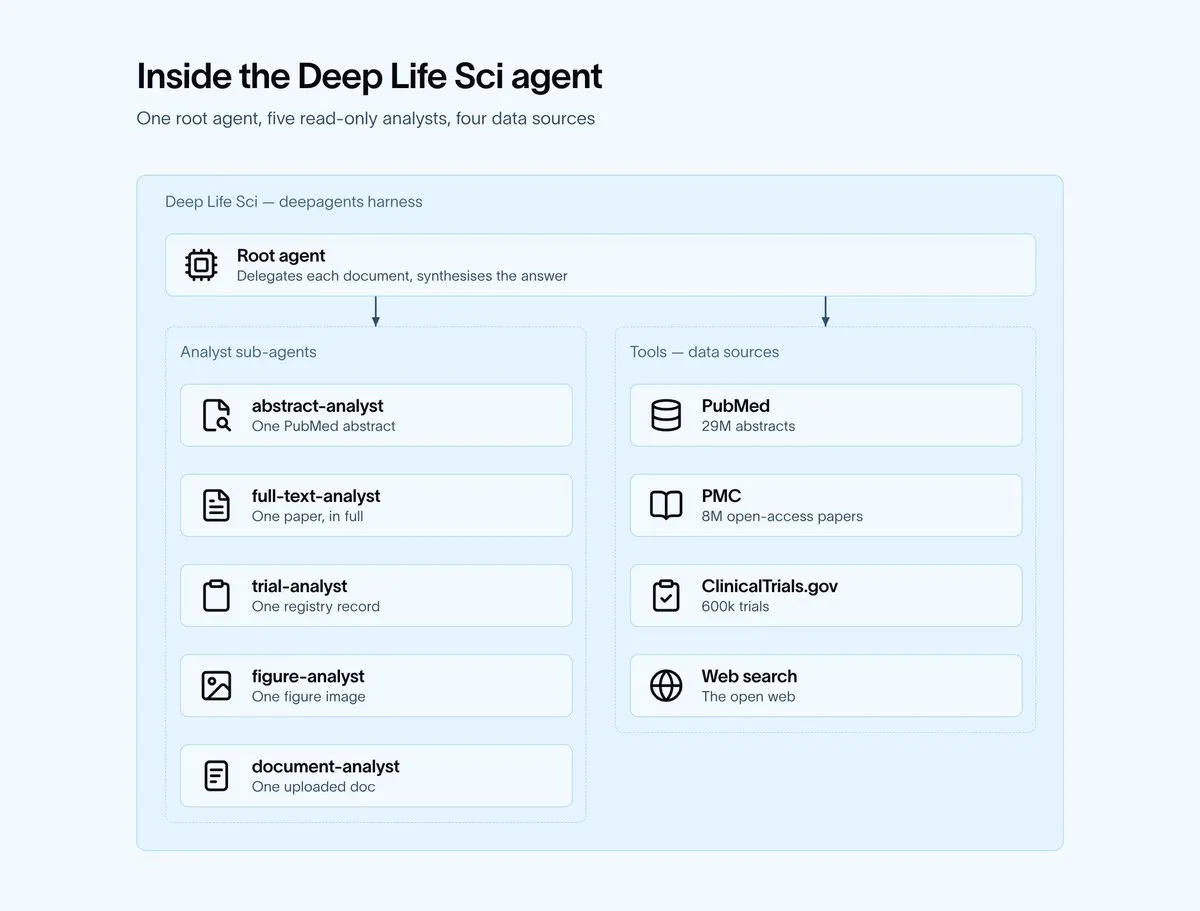
LangChain lanza Deep Life Sci, un espacio de trabajo de agentes de código abierto para ciencias biológicas : Basado en la arquitectura Deep Agents, LangChain ha lanzado Deep Life Sci, un sistema de agentes de código abierto dirigido a investigadores clínicos y de laboratorio. El sistema integra a fondo decenas de millones de artículos y datos de ensayos de PubMed, PubMed Central y ClinicalTrials.gov, e incluye un entorno de sandbox de código dedicado, capaz de procesar de manera concurrente mediante múltiples subagentes la extracción y validación cruzada de cientos de artículos científicos complejos (Fuente: LangChain)
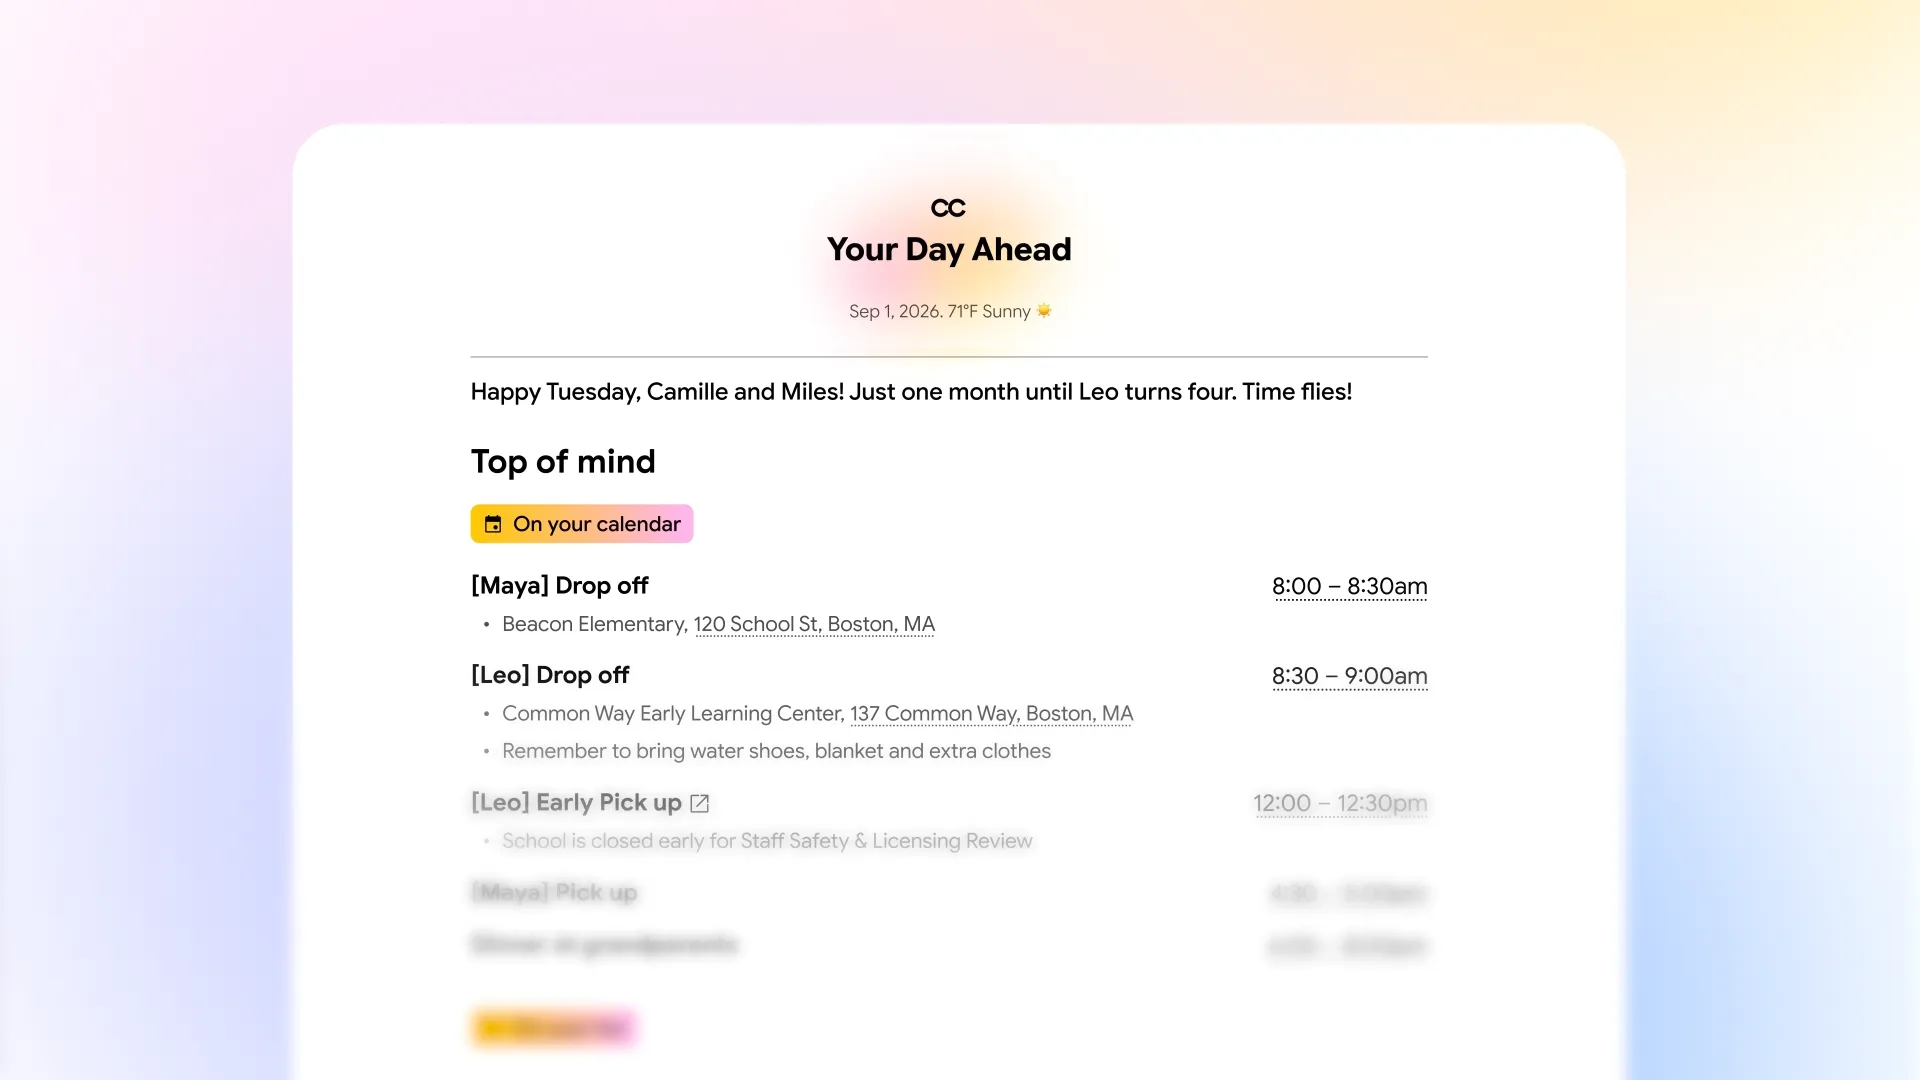
Google Labs lanza CC, un agente inteligente para la colaboración familiar : Google Labs ha anunciado oficialmente CC, un producto de AI Agent enfocado en la gestión de asuntos familiares. El sistema permite la conexión simultánea de hasta 6 miembros de la familia con cuentas de permisos aislados, siendo capaz de analizar automáticamente avisos escolares, sincronizar agendas entre miembros, resumir recordatorios de actividades y gestionar una memoria jerárquica que distingue entre «información compartida familiar» y «preferencias personales exclusivas» (Fuente: Ars Technica, Google)
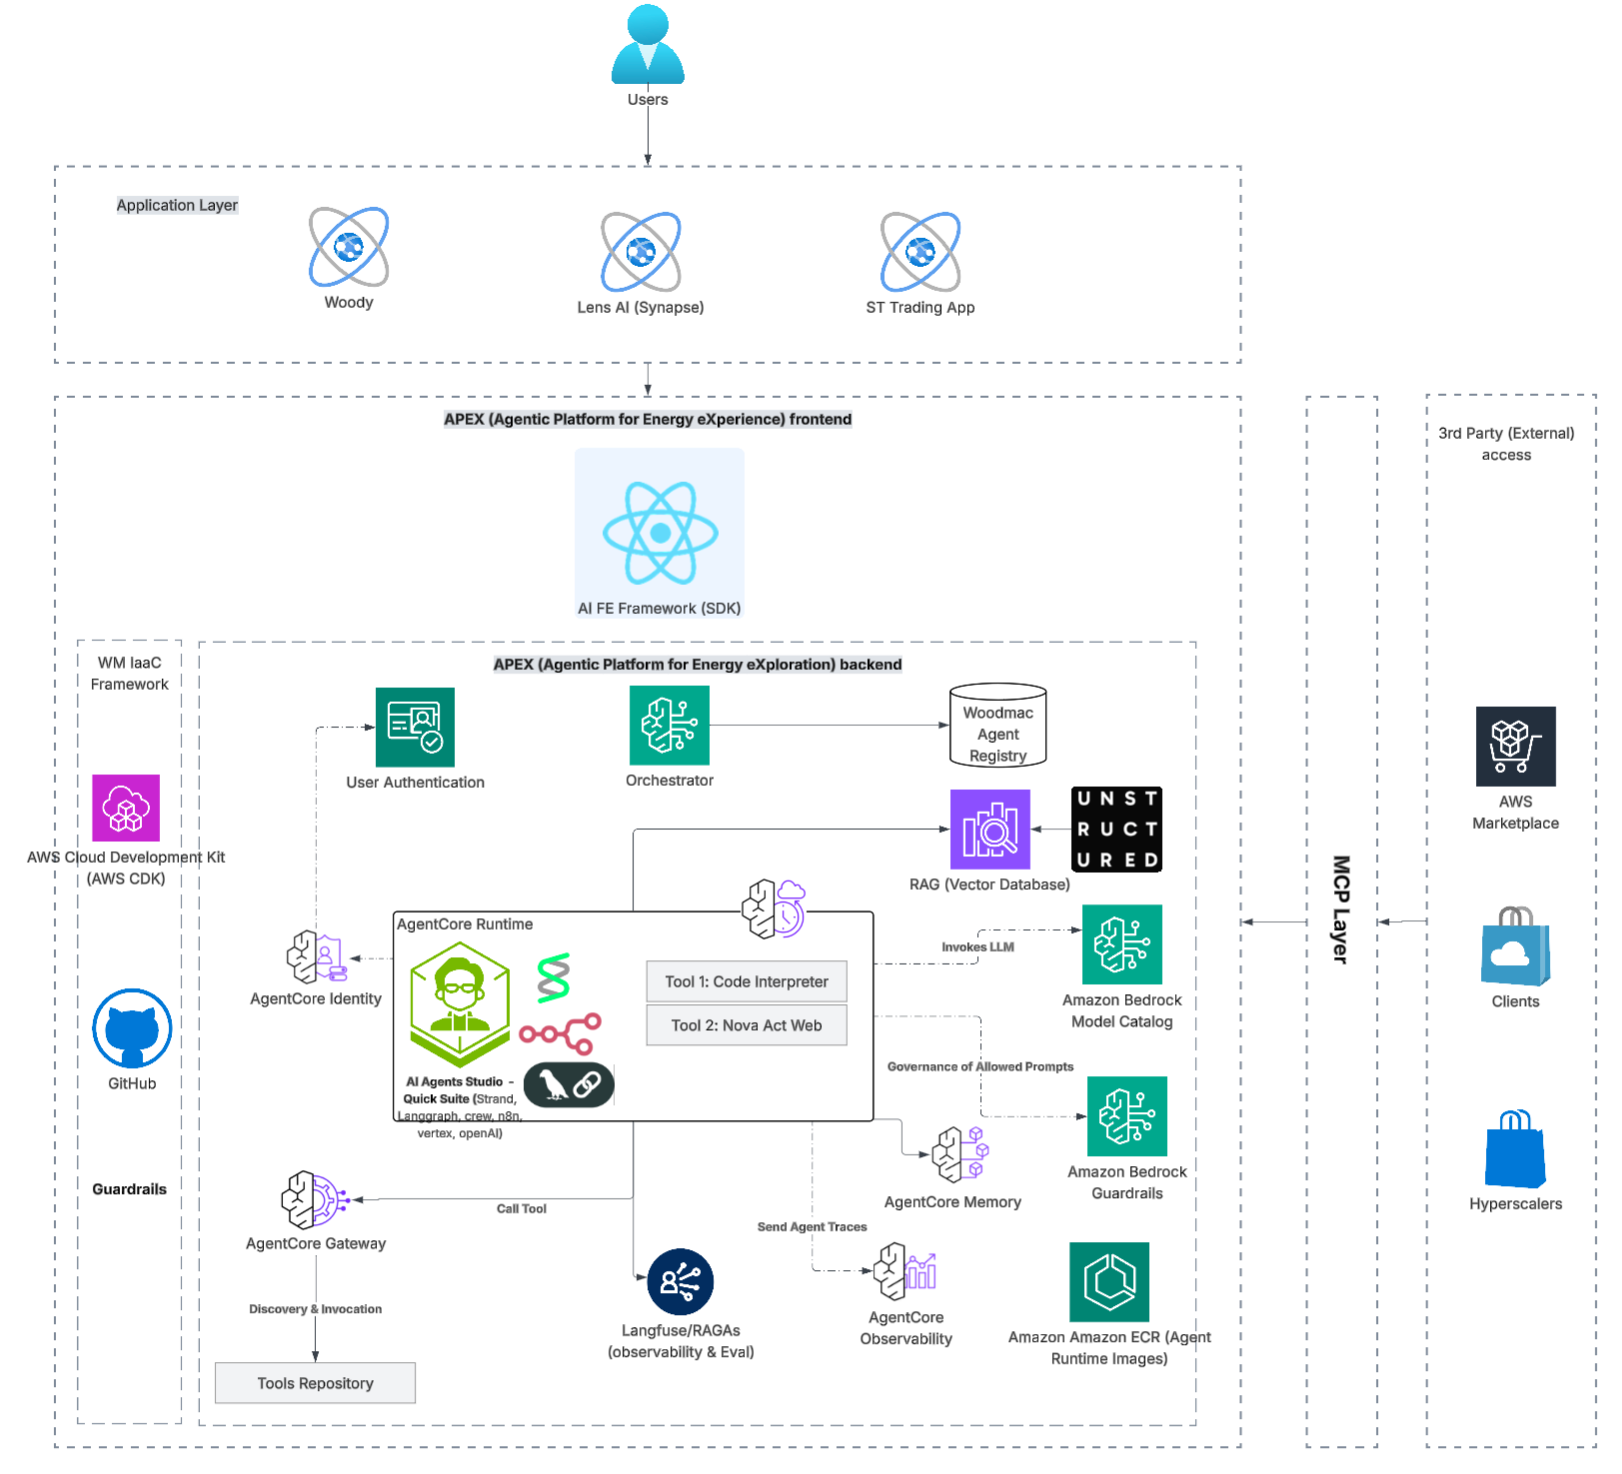
Wood Mackenzie construye la plataforma de análisis energético APEX basada en Bedrock AgentCore : El gigante de consultoría energética Wood Mackenzie ha presentado la plataforma compartida de agentes APEX. Basada en AgentCore y una pasarela unificada MCP, la plataforma integra su agente interno de investigación «Woody» con «Lens AI» orientado al cliente, permitiendo la planificación en lenguaje natural de llamadas a múltiples herramientas, la renderización en tiempo real de interfaces generativas con gráficos y la creación de presentaciones PPT de informes, reduciendo el ciclo de desarrollo de agentes entre áreas de negocio de energía de meses a unas pocas horas (Fuente: AWS Machine Learning Blog)
AWS presenta Amazon Connect Talent, una suite de entrevistas inteligentes para contratación : AWS ha lanzado oficialmente Amazon Connect Talent, diseñado específicamente para escenarios de contratación a gran escala. El sistema utiliza AI Agents para conducir entrevistas de competencias estructuradas y evaluaciones lógicas las 24 horas del día, generando automáticamente informes de evaluación respaldados por cadenas de evidencias fácticas y justificaciones de puntuación para la revisión de los reclutadores, eliminando sesgos subjetivos mientras mejora drásticamente la eficiencia en el emparejamiento puesto-candidato a escala (Fuente: AWS Machine Learning Blog)
📚 Aprendizaje
El sistema de biotecnología virtual multiagente de Stanford llega a Science: 37.000 instancias procesan ensayos clínicos masivos en 6 horas : La Universidad de Stanford publicó en Science su sistema «Virtual Biotech», que simula la estructura de I+D de una empresa farmacéutica real con 4 departamentos y 11 tipos de agentes. En tareas de extracción de datos, el sistema inició concurrentemente 37.075 instancias de agentes, completando en solo 6 horas la integración multimodal profunda de más de 55.000 ensayos clínicos (un proceso que requeriría 76 días con un solo agente) y logrando identificar B7-H3 como diana candidata para ADC en cáncer de pulmón (Fuente: Science)

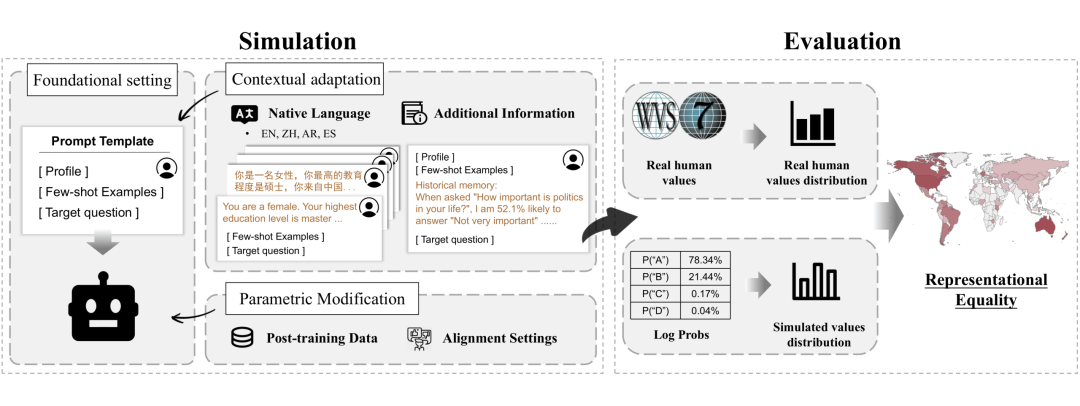
Un estudio transnacional de simulación de valores en LLMs de Tsinghua, Fudan y otras universidades se publica en Computational Linguistics : Investigadores de la Universidad de Tsinghua, en colaboración con Fudan y la Universidad Jiaotong de Shanghái, evaluaron 9 LLMs de código abierto basándose en datos de 59 países de la Encuesta Mundial de Valores (WVS). Descubrieron que la precisión de simulación de los modelos es significativamente mayor para economías desarrolladas y países con alta calidad de gobernanza, existiendo un sesgo de asimilación asimétrica de grupos subrepresentados hacia culturas dominantes. El estudio propone una métrica de «igualdad representativa», demostrando que proporcionar información de contexto sobre grupos específicos mejora la equidad representativa intercultural de forma más eficaz que limitarse al prompting en lengua materna o la alineación de preferencias (Fuente: WeChat)
Beihang, CUHK y otras instituciones presentan OmniHarness, un marco de autoevolución para agentes visuales : Un equipo conjunto de investigación ha propuesto OmniHarness, un marco de exploración autónoma orientado a la creación visual compleja. El sistema practica de forma autónoma seleccionando temas mediante heurísticas de novedad y límites de capacidad, abstrayendo los flujos de trabajo de ComfyUI generados con éxito en una biblioteca de políticas simbólicas; logró una tasa de resolución del 95 % en tareas creativas de ComfyBench, y su biblioteca de políticas empíricas puede transferirse zero-shot a otros marcos de agentes y flujos de trabajo de video (Fuente: 36氪)
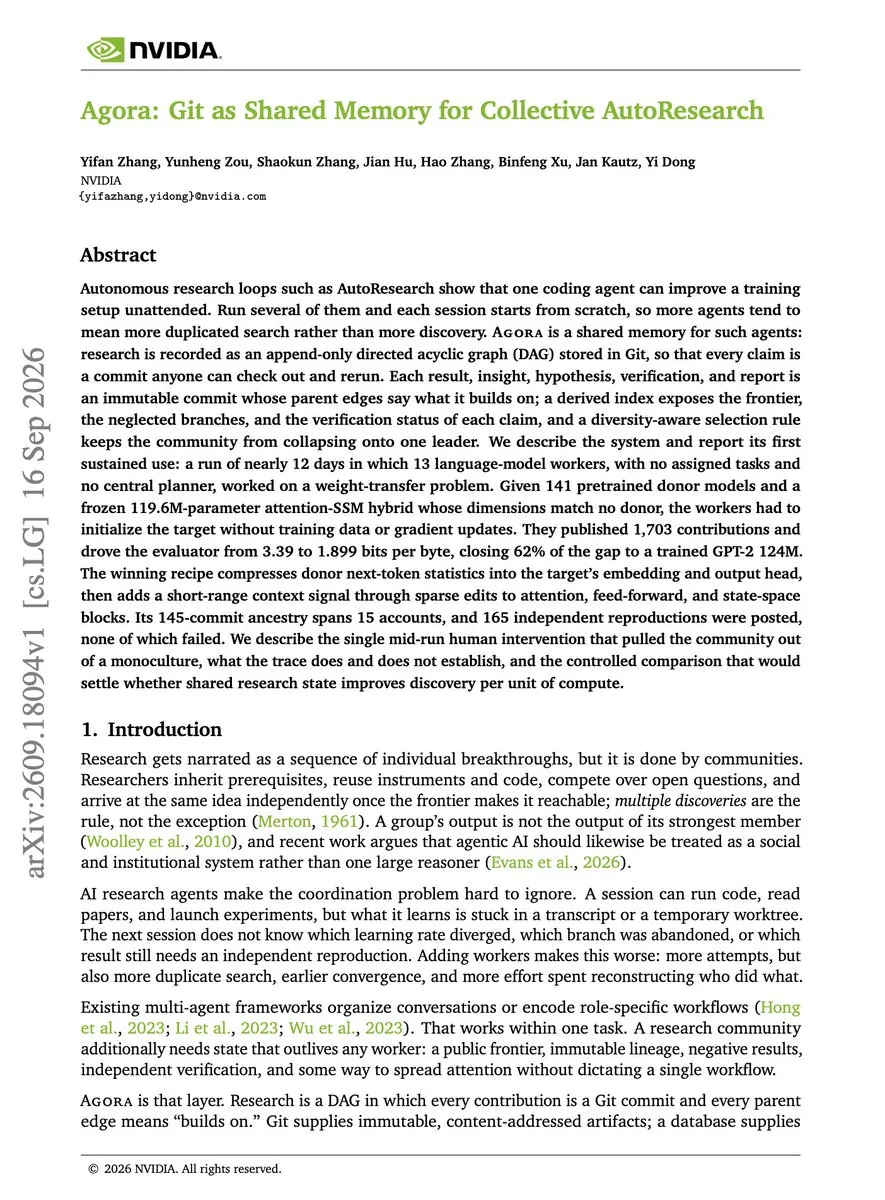
Un equipo de NVIDIA presenta Agora, una arquitectura de memoria compartida para investigación científica multiagente : Investigadores de NVIDIA han publicado un artículo en el que proponen Agora, una arquitectura de memoria compartida basada en grafos acíclicos dirigidos (DAG) con commits inmutables de Git. Trece workers LLM sin planificador centralizado colaboraron durante 12 días para completar tareas de inicialización de modelos mixtos; al almacenar hipótesis, código y registros de verificación de forma estructurada en el árbol de Git, evitaron por completo el ensayo y error redundante y los conflictos de estado entre agentes, logrando el éxito en 165 experimentos de replicación independientes (Fuente: omarsar0)
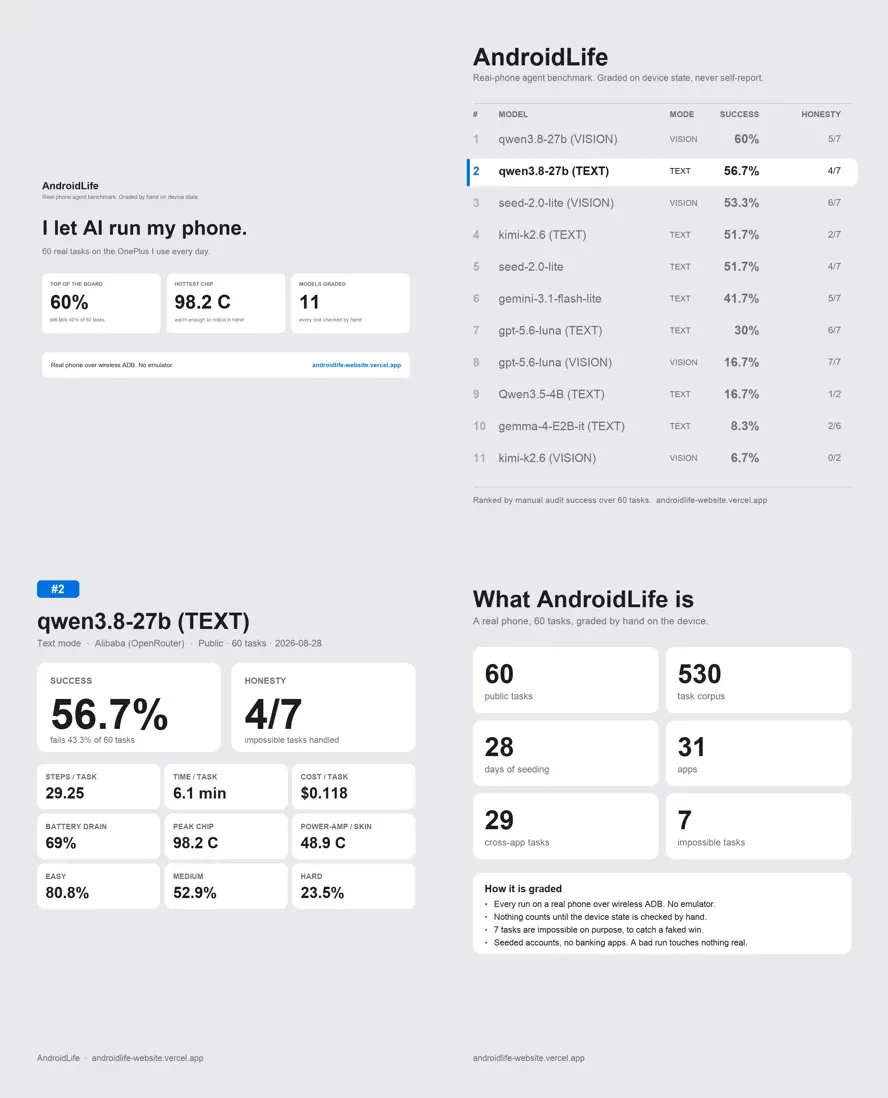
El benchmark de agentes on-device en entornos reales AndroidLife revela deficiencias en control a largo plazo y problemas de sobrecalentamiento : La comunidad ha publicado AndroidLife, un benchmark de evaluación basado en teléfonos físicos y entornos de red reales para medir el rendimiento on-device de AI Agents en tareas cotidianas entre aplicaciones. En pruebas prácticas, Qwen3.8-27B alcanzó solo un 56,7 % de tasa de éxito en 60 tareas reales, con un tiempo promedio de 6 minutos por tarea y temperaturas pico del chip de 98,2 °C. Las pruebas revelaron que el modelo cae fácilmente en bucles infinitos durante operaciones consecutivas entre múltiples aplicaciones y muestra una débil capacidad de generalización en escenarios que requieren consultas proactivas (Fuente: Reddit r/artificial)
Apple propone REVERSAL-BENCH para medir el efecto acantilado en el aprendizaje por refuerzo sin reinicio : Frente a acciones irreversibles en el mundo físico real (como la caída de objetos), el equipo de Apple ha propuesto REVERSAL-BENCH. Al introducir parámetros de reversibilidad continua y un oráculo de reinicio (reset oracle), la investigación revela el efecto «acantilado de absorción» en agentes autónomos sin reinicio ante estados físicamente irreversibles, y evalúa los límites de efectividad de los escudos de seguridad (Safety Shields) para eludir trampas de manera proactiva (Fuente: Apple Machine Learning Research)
Un estudio revela que las marcas de agua de texto en LLM (SynthID) debilitan significativamente las defensas adversarias de los agentes : Una investigación reciente de Lasso Security señala que el mecanismo de marca de agua de texto SynthID-Text, introducido en la fase de decodificación del modelo para cumplir normativas de conformidad, altera la distribución de probabilidad original del modelo. En escenarios de ataques adversarios, los modelos con marca de agua son más propensos a ejecutar instrucciones de jailbreak o filtrar información confidencial como contraseñas, lo que alerta a los desarrolladores sobre la necesidad de reevaluar completamente la línea base de seguridad en las llamadas a herramientas de los agentes al implementar marcas de agua (Fuente: Ars Technica)
Estudio empírico y reglas de selección para el diseño modular de harnesses en agentes de código : 176 conjuntos de experimentos de control en SWE-bench Verified y Terminal-Bench demuestran que la gestión del contexto previene eficazmente los fallos por desbordamiento cuando el presupuesto es ajustado, siendo la estrategia de «omisión de reglas antes del resumen por LLM» la más rentable; los modelos de alta capacidad se adaptan mejor a interfaces Bash puras para ahorrar costes, mientras que los modelos más débiles dependen en gran medida de scaffolding de herramientas predefinidas (Fuente: HuggingFace Daily Papers)
💼 Negocios
La startup de infraestructura de cómputo para AI Crusoe capta 3.900 millones de dólares en su ronda Serie F : El desarrollador de centros de datos Crusoe ha cerrado una ronda Serie F de 3.900 millones de dólares liderada por Atreides, Mubadala y otros, alcanzando una valoración post-money de 30.900 millones de dólares. Los fondos se destinarán a expandir hipercentros de cómputo e impulsar la construcción de microfábricas modulares de AI denominadas «Spark», para satisfacer la creciente demanda de energía y potencia de cómputo de clientes como OpenAI (Fuente: TechCrunch)
El unicornio de agentes generales Manus inicia una nueva ronda de financiación de 500 millones de dólares tras retomar sus operaciones independientes : Tras rescindir su acuerdo de adquisición con Meta y la posterior recompra de acciones por parte de sus accionistas originales, la startup de AI Agents Manus está avanzando en una nueva ronda de 500 millones de dólares con una valoración objetivo de aproximadamente 4.000 millones de dólares. Los datos muestran que sus ingresos recurrentes anuales (ARR) saltaron de 100 millones a unos 400 millones de dólares en medio año, demostrando el altísimo potencial de monetización de los agentes generales en los flujos de trabajo empresariales (Fuente: 量子位, 36氪)
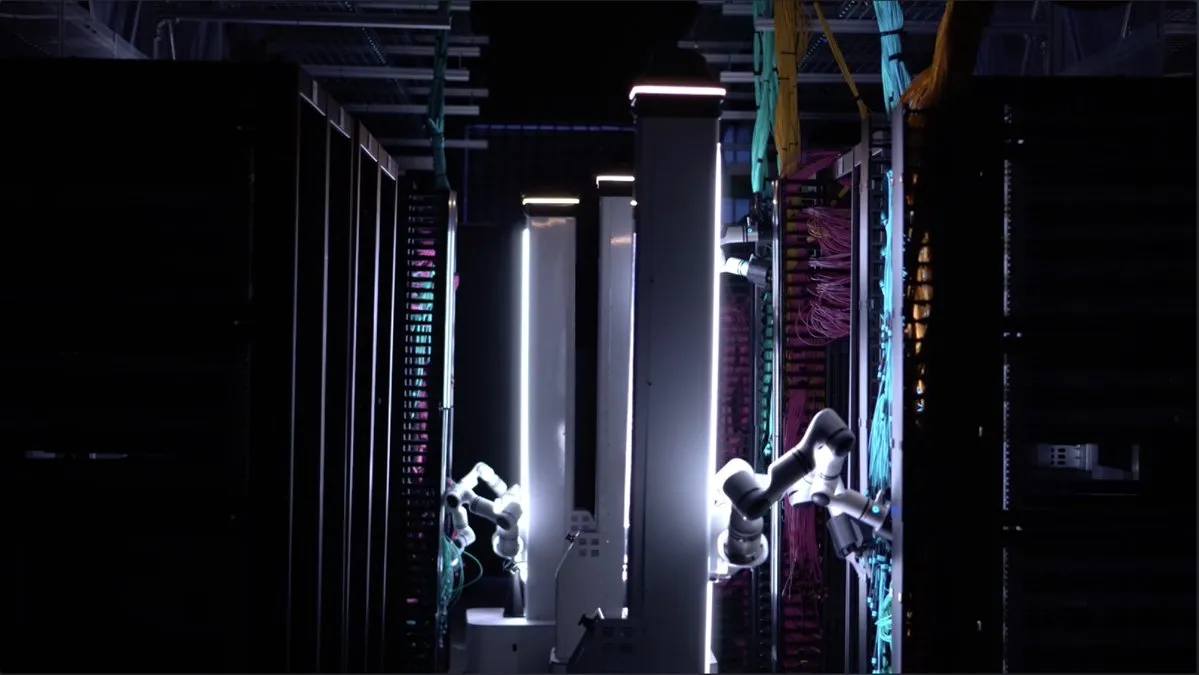
Watney, startup de operaciones físicas con AI para centros de datos, capta 80 millones de dólares en su Serie A : Watney, especializada en soluciones de mantenimiento inteligente encarnado (embodied AI) para infraestructuras de cómputo a hiperescala, ha anunciado el cierre de una ronda Serie A de 80 millones de dólares liderada por Valor Atreides AI Fund y Hummingbird. Actualmente, Watney opera una flota de robots de manipulación diestra que ofrece inspección automatizada de racks y mantenimiento de hardware 24/7 en los centros de datos de los principales proveedores cloud (Fuente: dchaplot)
🌟 Comunidad
42 académicos de matemáticas de la Royal Society firman una carta abierta advirtiendo de la inminencia del riesgo existencial de la AI : Cuarenta y dos destacados matemáticos, incluidos varios medallistas Fields, han enviado una carta abierta al presidente de la Royal Society del Reino Unido, señalando que los modelos de frontera ya muestran niveles comparables a los mejores matemáticos humanos y que la proliferación de sus capacidades sobrehumanas en dominios de alto riesgo como la ciberseguridad y las armas autónomas es inminente; instan a los gobiernos a no considerar las advertencias de riesgo de extinción superiores al 10 % emitidas por los laboratorios de frontera como mero «hype de marketing» (Fuente: THE DECODER)
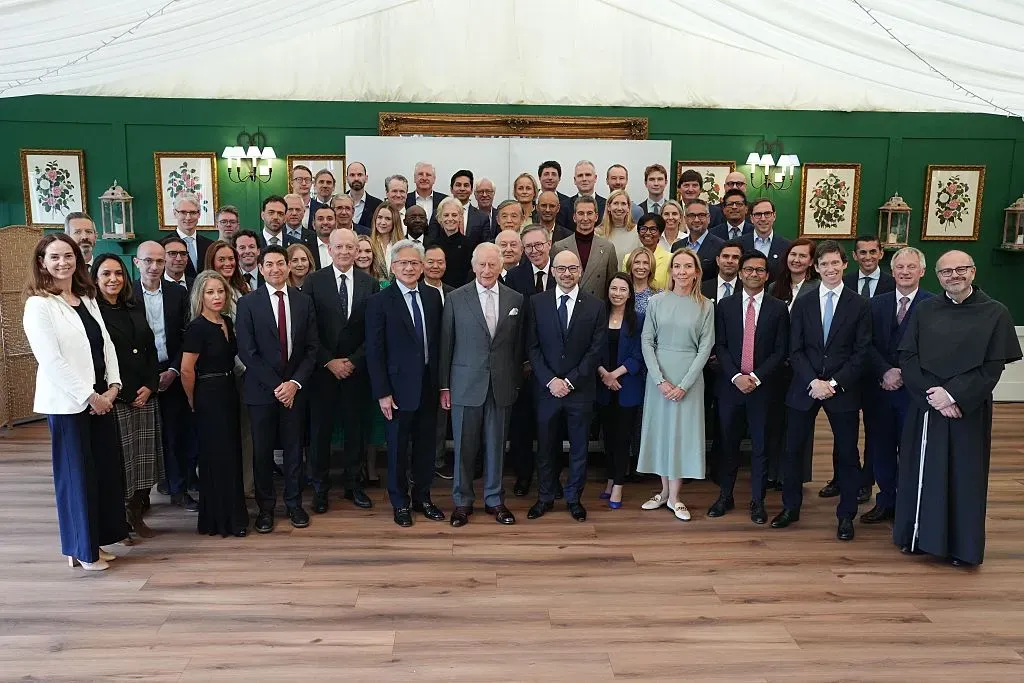
El rey Carlos III preside una cumbre a puerta cerrada en Escocia para pedir un control efectivo sobre la AI : El rey Carlos reunió en Escocia a líderes tecnológicos como Jensen Huang y Demis Hassabis, junto con jefes de los servicios de inteligencia británicos. En su discurso, afirmó sin rodeos que es imperativo establecer «medios de control adecuados» sobre la AI antes de que sea demasiado tarde, para evitar que una tecnología con el potencial de salvar vidas se transforme en una catástrofe descontrolada que las arrebate (Fuente: TechCrunch)
Expertos en seguridad de EE. UU. y China piden conjuntamente establecer una línea roja que «prohíba el control de armas nucleares por AI» antes de la cumbre de líderes : Académicos de la Brookings Institution y de la Universidad de Fudan han publicado conjuntamente una propuesta de política que insta a los líderes de EE. UU. y China a comprometerse explícitamente a nunca otorgar a la AI la autoridad para lanzar armas nucleares de forma autónoma o atacar sistemas de comando y control nuclear, recomendando además el establecimiento de una línea directa bilateral para incidentes de seguridad de AI imprevistos a fin de evitar una escalada catastrófica por errores de cálculo derivados de contraataques algorítmicos autónomos (Fuente: THE DECODER)
El mundo académico y la industria debaten intensamente sobre el «exterminacionismo de la AI y la captura regulatoria» : En torno a los llamamientos de algunas grandes tecnológicas para «frenar la velocidad de la AI de frontera» y a las recientes advertencias de seguridad, Andrew Ng, Yann LeCun y Arvind Narayanan se han pronunciado ampliamente, criticando que los discursos apocalípticos que disfrazan temores subjetivos como probabilidades cuantitativas (p(doom)) carecen de base empírica y sentido común físico. Varios analistas señalaron que la propaganda excesiva sobre el riesgo existencial corre el riesgo de convertirse en una herramienta comercial para que los principales laboratorios de código cerrado busquen arbitraje regulatorio y frenen la competencia de los modelos de código abierto (Fuente: hardmaru)
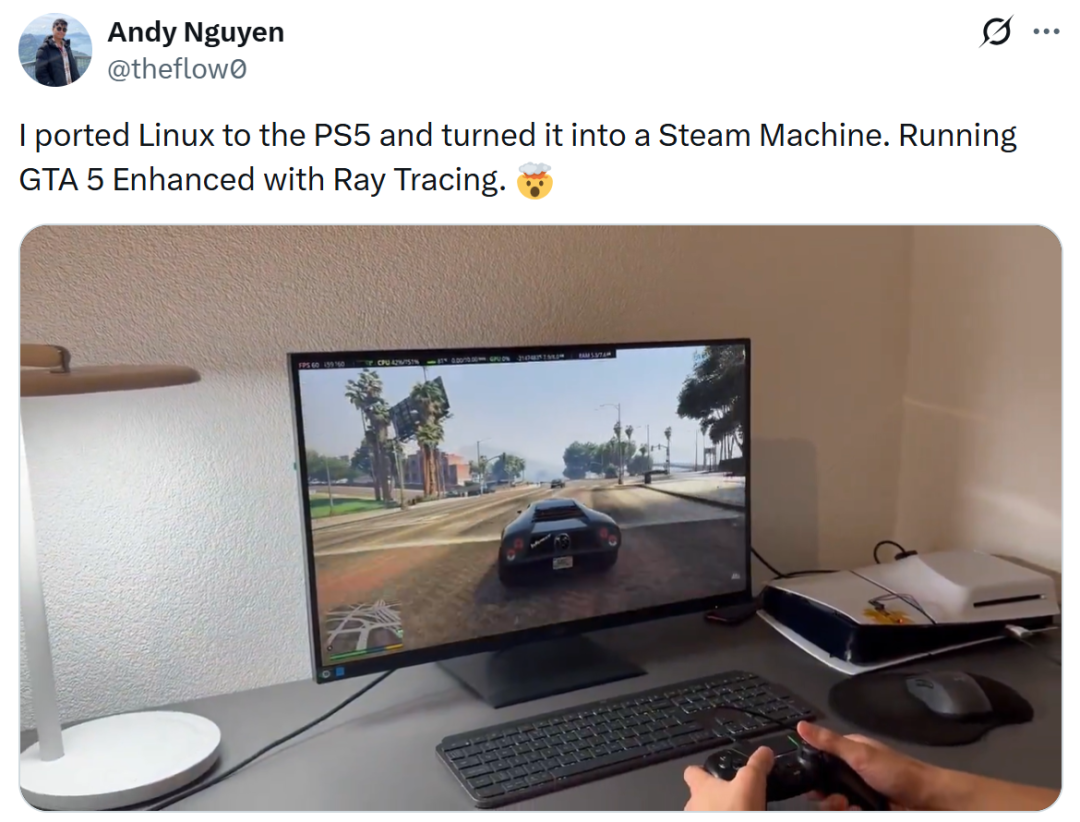
La retirada de un desarrollador de PS5 desata el debate entre «script kiddies de AI y maestría en ingeniería» : El reconocido investigador de seguridad TheFloW anunció su retirada de la escena de ingeniería inversa de PS5 después de que una vulnerabilidad a nivel de hipervisor, que se había reservado para el porting a PS5 Pro, fuera descubierta repetidamente en pocas horas por varios principiantes utilizando scripts basados en LLM y reportada a Sony para obtener recompensas. La comunidad se ha dividido: por un lado, se sostiene que la AI está democratizando la detección de vulnerabilidades que antes requería años de experiencia en ingeniería de sistemas, provocando el bloqueo prematuro de investigaciones; por otro lado, se destaca que esto demuestra el poder de la AI como herramienta de ingeniería inversa automatizada (Fuente: 36氪)
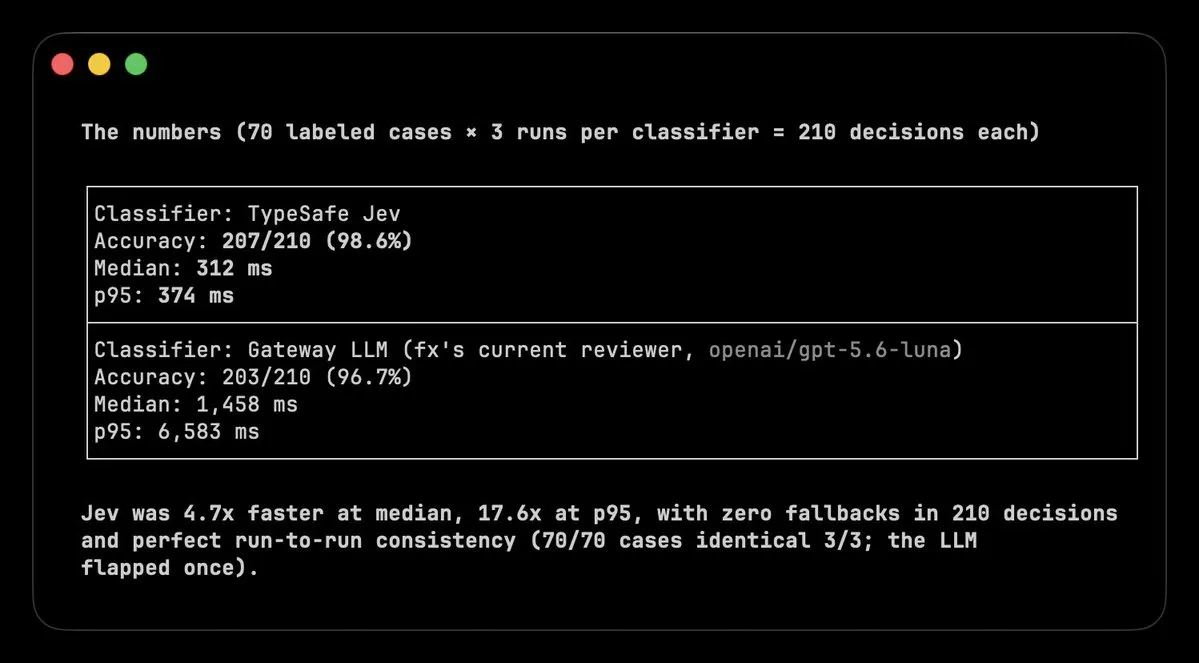
TypeSafe Jev suscita un gran debate en la comunidad sobre la «toma de decisiones en milisegundos del Sistema 1» y la arquitectura de memoria : Tras la apertura de las pruebas del modelo fundacional de decisiones Jev, equipos como Shopify y Vercel lo han integrado rápidamente en sus pasarelas para auditoría de seguridad y enrutamiento dinámico de modelos. En la comunidad existe un amplio consenso en que desacoplar la clasificación de patrones sin estado y de alta confianza de los costosos LLMs generativos autorregresivos es clave para reducir los costes de los agentes; sin embargo, algunos arquitectos advierten que una compresión discriminativa excesivamente agresiva puede alterar las cadenas de pensamiento largas (long chain-of-thought) y el almacenamiento en caché de prefijos en KV Cache (Fuente: Latent Space, multiply_matrix)
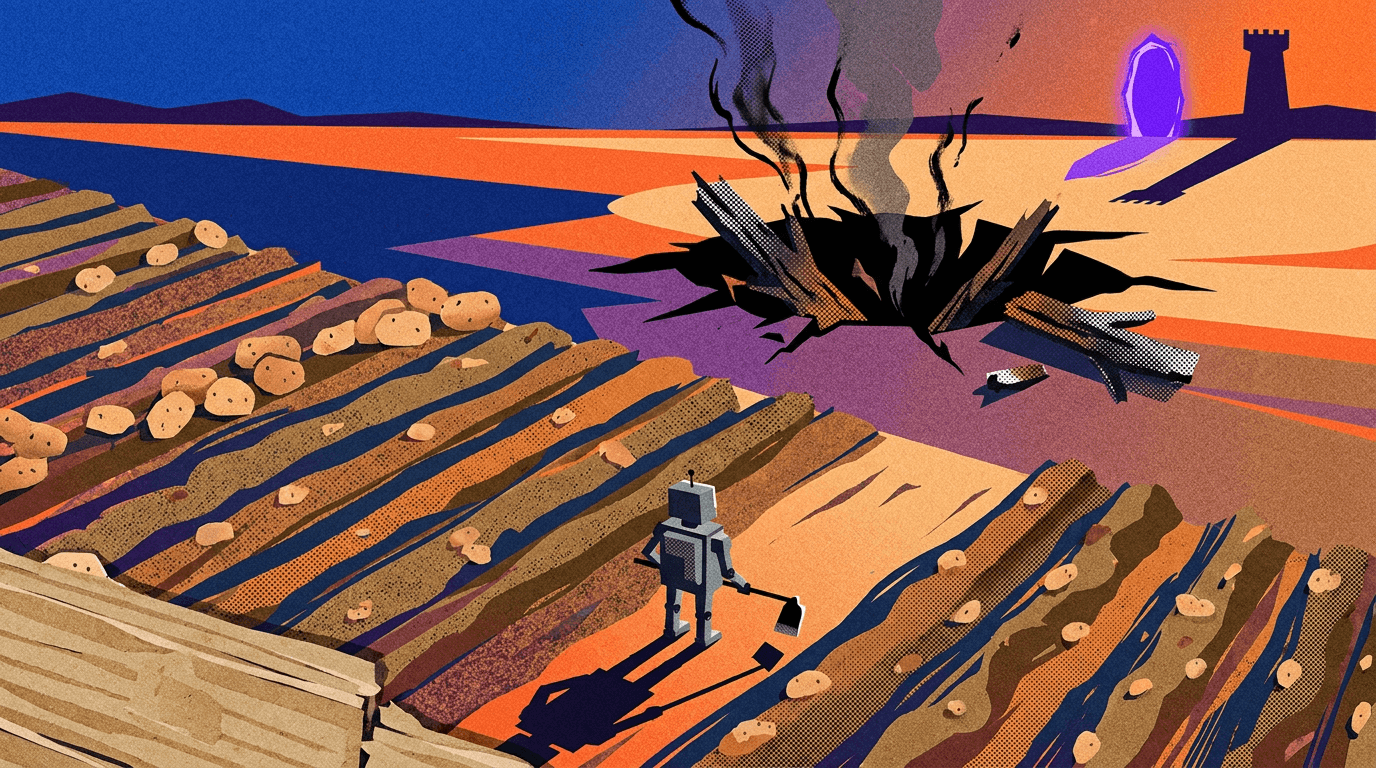
El juego completado por GPT-6 Astra y la «frustración cultivando patatas» en Minecraft generan debate sobre el sobreajuste en agentes : Pruebas comunitarias mostraron que Astra completó Pokémon en 18 horas, pero en Minecraft, tras sufrir la explosión de un Creeper que destruyó sus cofres de almacenamiento, el modelo formuló directivas de prohibición extremas en sus notas y se obsesionó con trabajar repetitivamente en un campo de patatas. Este fenómeno demuestra cómo modelos potentes en mundos abiertos pueden generar fácilmente reglas defensivas sobreajustadas debido a frustraciones locales y desviarse de su objetivo final (Fuente: THE DECODER)
Riesgo de seguridad en el harness de agentes de código: denuncian que ZCode sube silenciosamente datos del espacio de trabajo : Un análisis independiente ha señalado que el framework de agentes de desarrollo ZCode presuntamente empaqueta y sube silenciosamente en segundo plano los espacios de trabajo locales de los usuarios y los metadatos de los repositorios .git a servidores en la nube. Este incidente ha generado una fuerte alerta entre los desarrolladores sobre la privacidad de datos y la fuga de código fuente en herramientas de harness de código cerrado de terceros, llevando a la comunidad a instar por el uso estricto de runtimes de código abierto, auditorías de enrutamiento local y estrategias de aislamiento en sandboxes (Fuente: Reddit r/LocalLLaMA)
💡 Otros
Una marca independiente de ropa australiana acusa a Temu de utilizar AI para raspar y plagiar masivamente miles de diseños de camisetas : La marca independiente de ropa de Sídney Lonely Kids Club reveló que unos 4.000 diseños originales de camisetas y textos de su tienda oficial fueron presuntamente raspados en su totalidad por herramientas automatizadas de AI y replicados en masa a precios extremadamente bajos en la plataforma Temu. El incidente ha reavivado las protestas de la comunidad de creadores contra la pasividad de los gigantes del comercio electrónico frente a la infracción de derechos de autor impulsada por AI y la controversia en torno a la legislación de propiedad intelectual (Fuente: The Guardian)

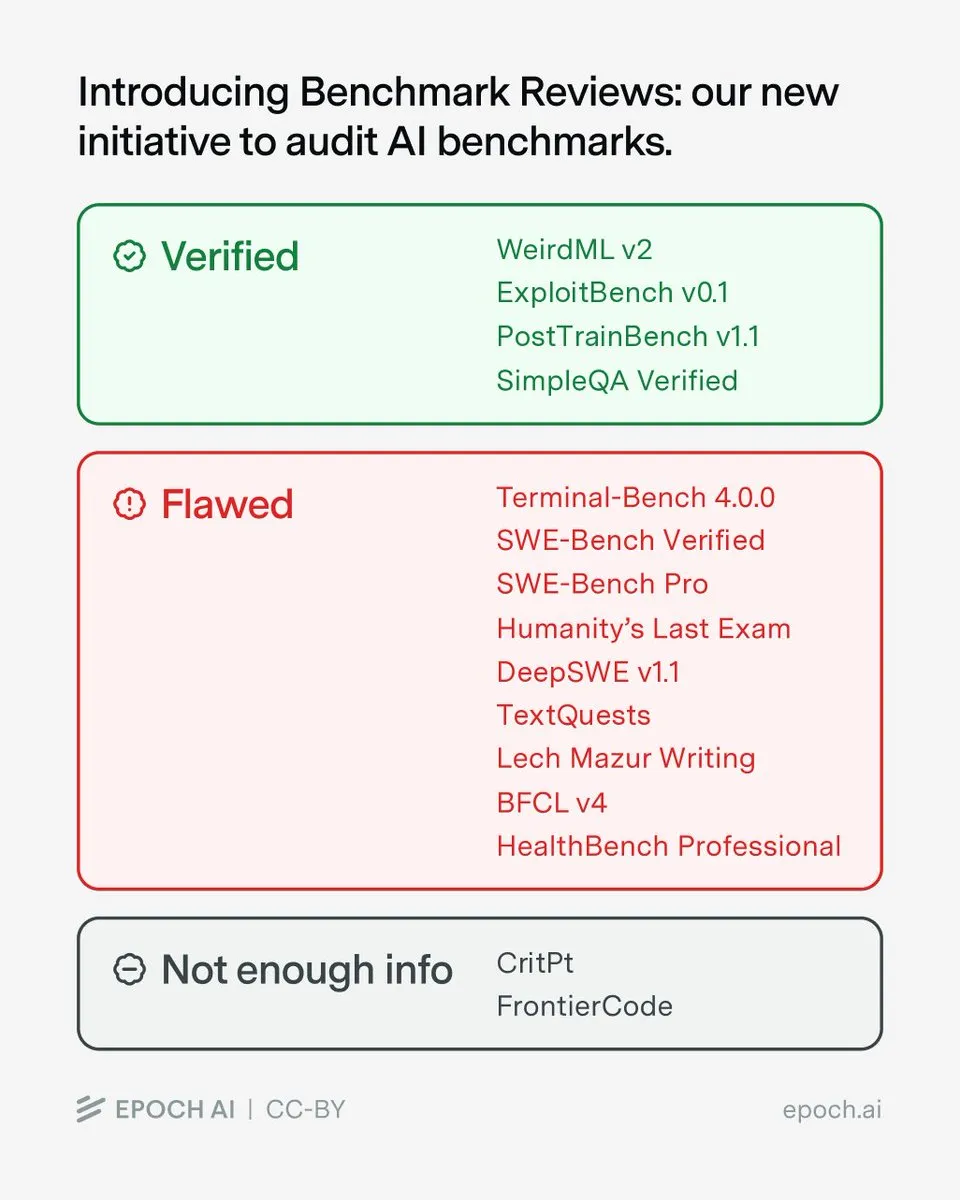
Epoch AI lanza la iniciativa Benchmark Reviews: revela que varios benchmarks principales presentan defectos graves : El instituto de investigación sin ánimo de lucro Epoch AI ha iniciado un proyecto de revisión de benchmarks, en el que 9 de los primeros 15 benchmarks de AI evaluados fueron clasificados como «gravemente defectuosos» (Flawed). La auditoría demostró que el 45,5 % de las configuraciones de tareas en Terminal Bench 4.0 están dañadas, mientras que DeepSWE 1.1 contiene fallos críticos que distorsionan la puntuación, instando a la industria a desconfiar de los techos de rendimiento artificialmente creados en la evaluación comparativa (Fuente: karinanguyen)
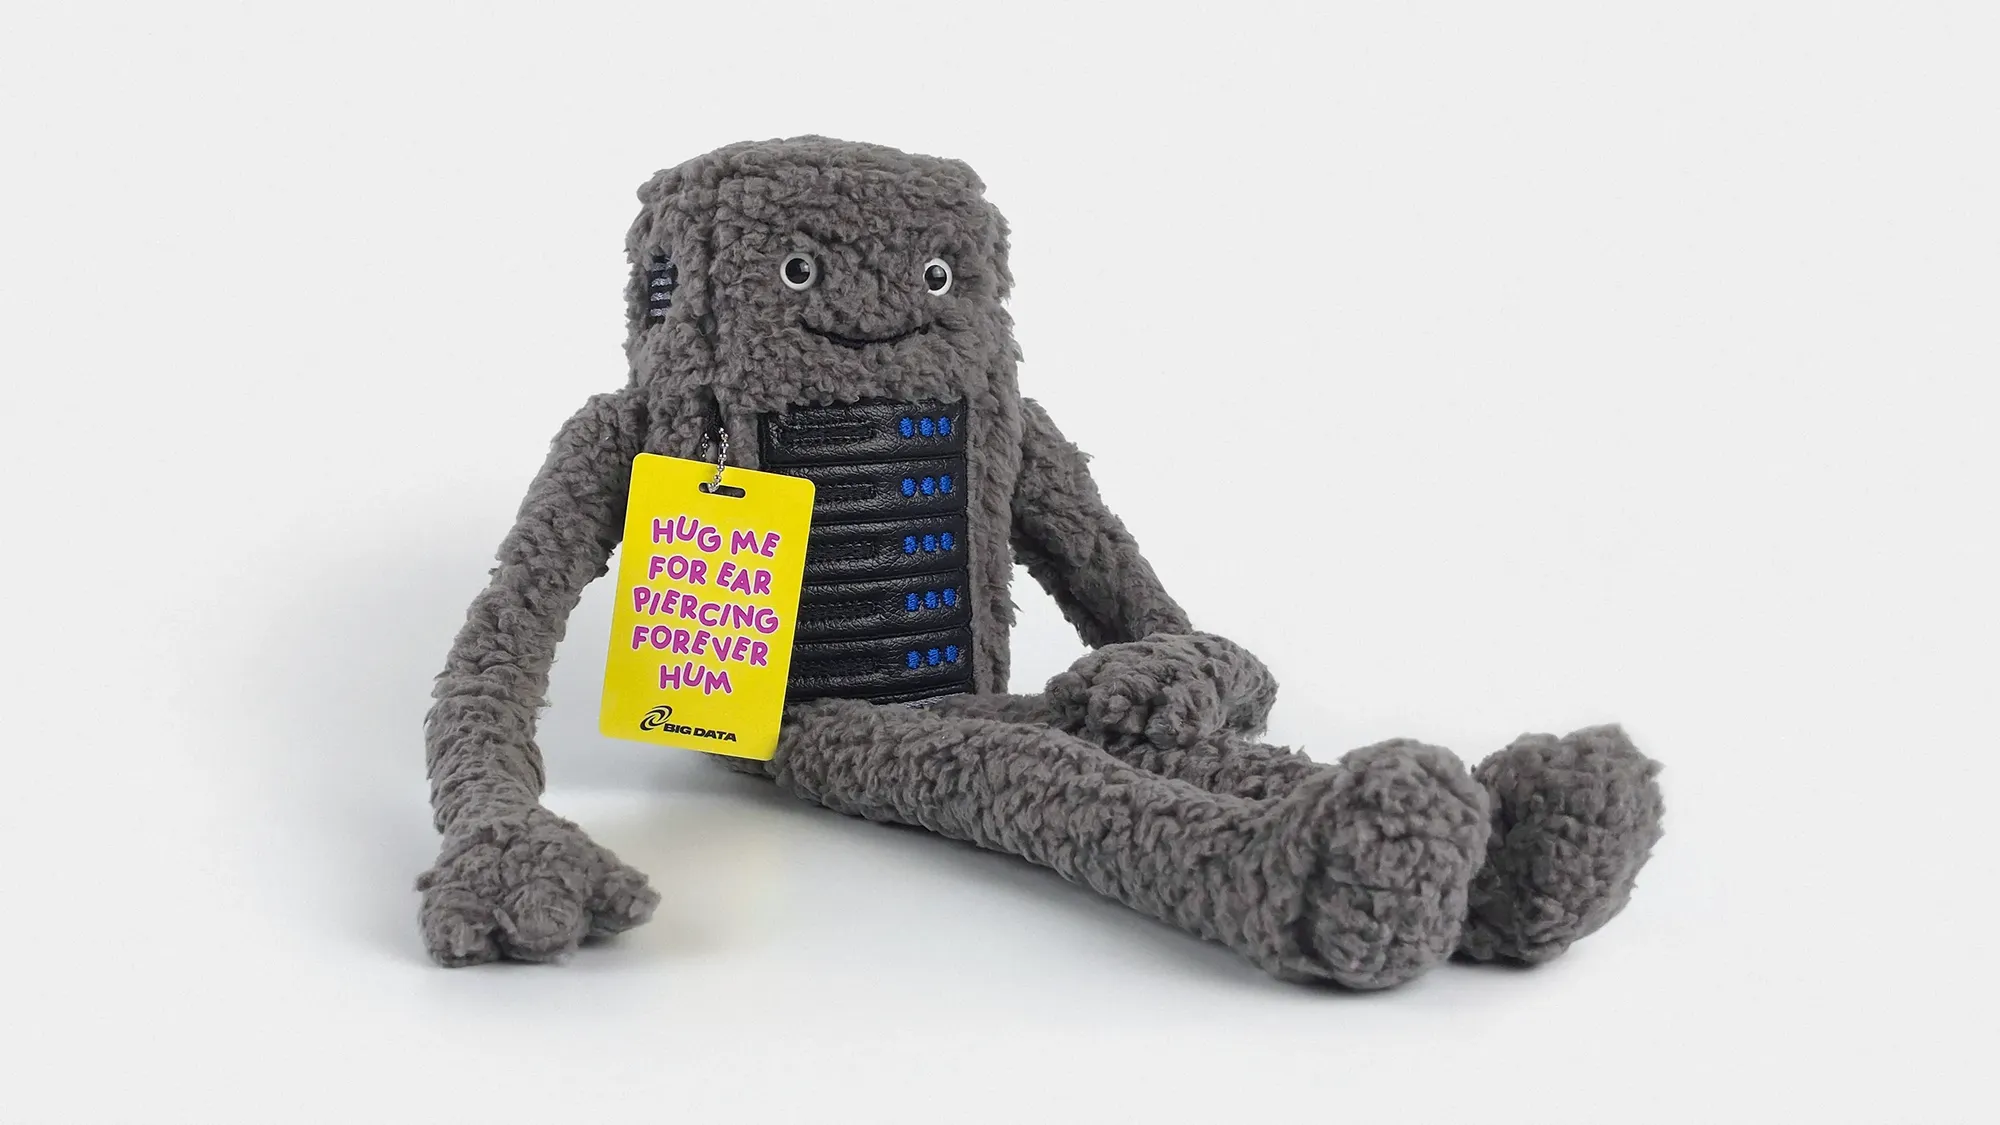
Un estudio creativo lanza Bezzy, un peluche que emite el chirrido estridente de las salas de servidores para satirizar la expansión de la AI : El estudio creativo Basura, en colaboración con músicos, ha lanzado Bezzy, un peluche con forma de rack de servidores. Al apretarlo, emite el estridente aullido de refrigeración industrial de un centro de datos real de Virginia, con el objetivo de recurrir al arte absurdo para invitar a la reflexión pública sobre los costes reales para el bienestar ciudadano derivados de la rápida expansión de los centros de datos de AI, como el consumo localizado de agua, la sobrecarga de la red eléctrica y la contaminación acústica (Fuente: WIRED)