


🔥 À la une
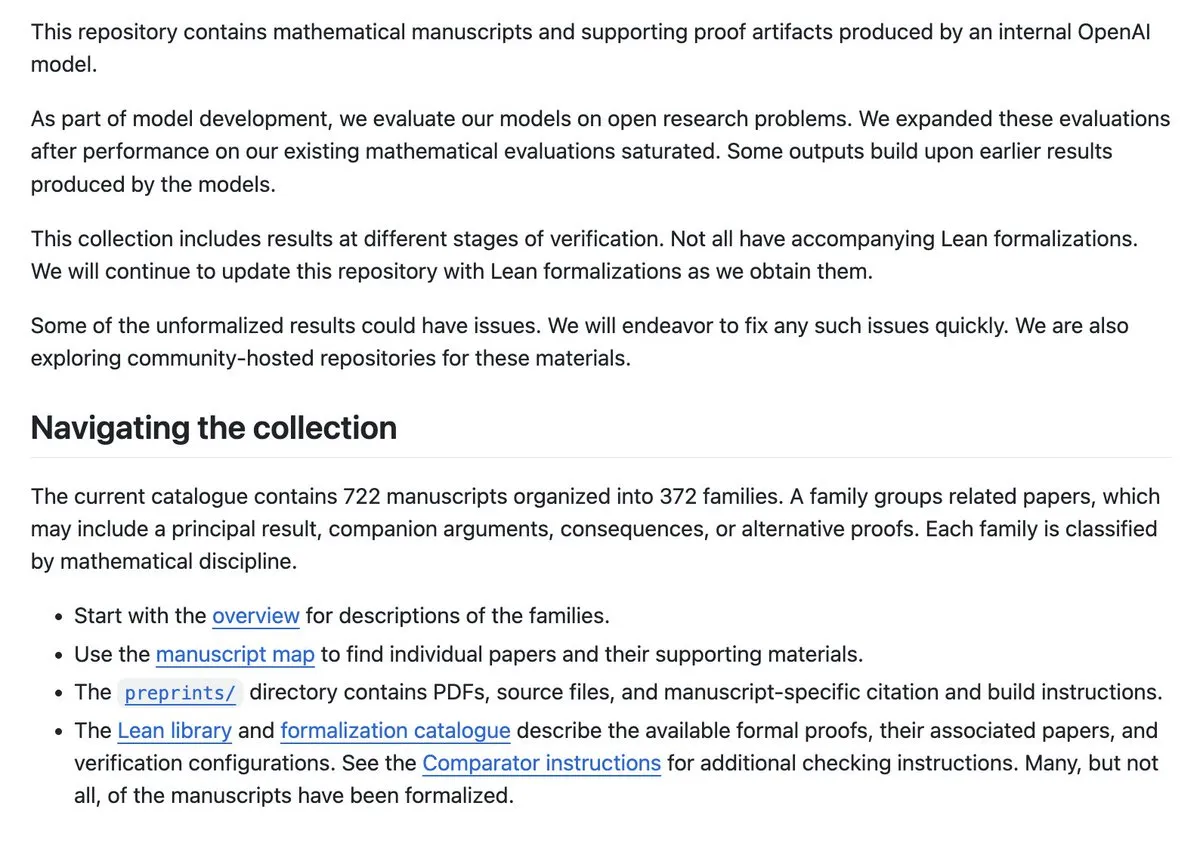
OpenAI publie 722 manuscrits mathématiques issus d’un modèle non publié, repoussant les frontières de problèmes séculaires tels que la quasi-hypothèse de Riemann : OpenAI a officiellement mis en ligne sur son dépôt open source GitHub openai/math 372 ensembles de résultats totalisant 722 manuscrits d’articles mathématiques générés par un modèle frontière interne non publié. Les résultats phares couvrent la quasi-hypothèse de Riemann (affirmant prouver que toutes les fonctions L de Dirichlet ne possèdent aucun zéro dans la région où la partie réelle est supérieure à 7/8 et éliminant les zéros de Siegel), une démonstration de la conjecture de Hodge pour les variétés abéliennes, la conjecture de Kakeya en dimension 4, le dixième problème de Hilbert sur le corps des rationnels ainsi que l’établissement du seuil ordinaire de NP-difficulté de Basic-SDP indépendamment de la conjecture des jeux uniques ; environ 160 articles s’accompagnent de preuves formalisées sous Lean. OpenAI a révélé que chaque résultat a nécessité en moyenne 3 heures de calcul d’inférence sous ChatGPT Pro. Bien que saluée comme une étape majeure dans la découverte scientifique autonome par les machines, une commission consultative de l’Institute for Advanced Study de Princeton, comprenant trois médaillés Fields, a publié une déclaration soulignant que la publication ne vaut pas validation académique, alertant sur le fait que la production massive de démonstrations par des machines perturbe gravement les mécanismes d’assimilation et de vérification des chercheurs humains (Source : 机器之心、The Verge、Latent Space、Abhishek Saha、openai)
Le département américain de l’Énergie et les NIH s’associent à DeepMind et à d’autres géants pour lancer la « Virtual Biology Initiative » : Le département américain de l’Énergie (DOE) et les National Institutes of Health (NIH) ont annoncé la signature d’un partenariat stratégique national avec Google DeepMind, Meta, Isomorphic Labs et NVIDIA pour créer la « Virtual Biology Initiative ». Ce programme vise à cartographier systématiquement la biologie cellulaire à toutes les échelles et à générer des données de référence standardisées, en mobilisant l’IA multimodale pour concevoir le premier modèle numérique universel capable de prédire de bout en bout les activités cellulaires du vivant, refondant ainsi la recherche thérapeutique et l’exploration des mécanismes pathologiques à partir des premiers principes (Source : Alex Rives)
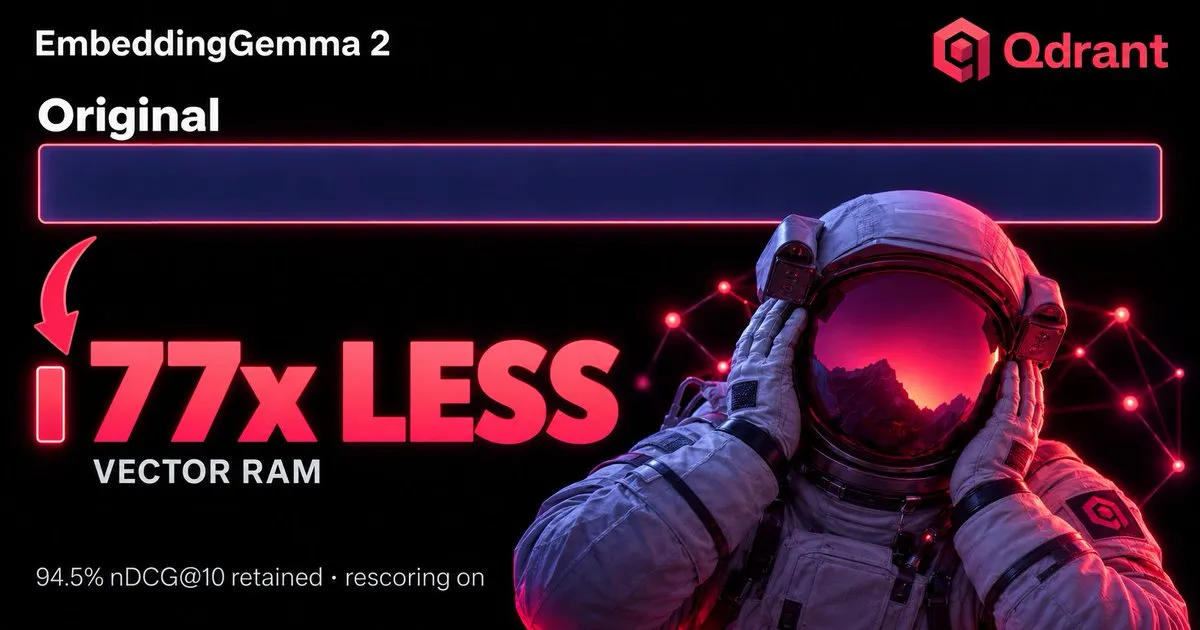
Google DeepMind publie en open source EmbeddingGemma 2, un modèle d’embedding on-device omnimodal : Google DeepMind a officiellement publié sous licence Apache 2.0 son premier modèle d’embedding multimodal reposant sur l’architecture Gemma 4, nommé EmbeddingGemma 2. Doté de 740M de paramètres, il unifie nativement les espaces de représentation vectorielle pour le texte, le code, l’image, l’audio et la vidéo, tout en prenant en charge un contexte de 8K. Sa conception modulaire permet au composant textuel unimodal de s’exécuter avec 270M de paramètres, n’occupant qu’environ 191 Mo de mémoire sur les appareils mobiles après quantification. Grâce au Matryoshka representation learning, il permet une troncature dynamique des dimensions jusqu’à 768. Les bancs d’essai de Qdrant montrent qu’associé à une quantification 1-bit, l’empreinte VRAM est réduite d’un facteur 77 tout en conservant 94,5 % de précision de recherche, comblant ainsi un vide d’infrastructure pour le RAG multimodal léger on-device et la recherche sémantique hors ligne (Source : Google DeepMind Blog、THE DECODER、GoogleDeepMind)
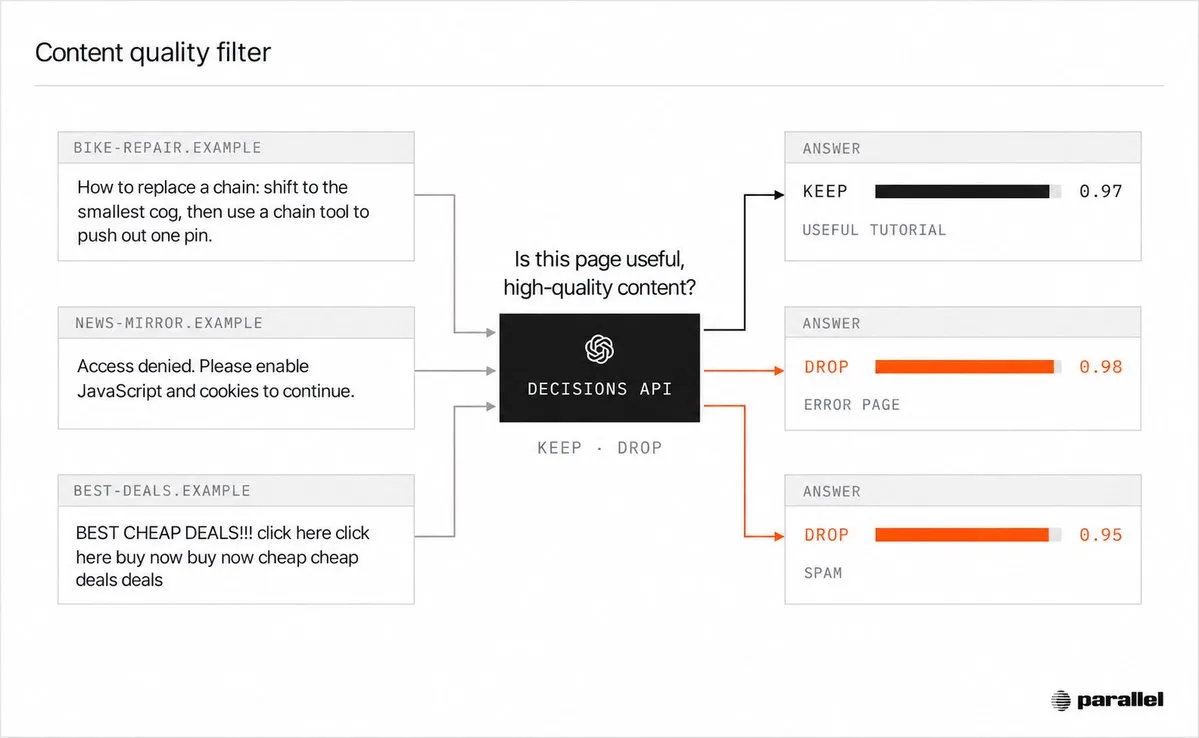
OpenAI honore le Jour 2 de son « défi de 28 jours » : Auto-review devient gratuit et lancement de la bêta publique de Decisions API : Au deuxième jour de son défi consistant à « livrer chaque jour une amélioration concrète pendant 28 jours », OpenAI a dévoilé plusieurs mises à jour majeures ciblant les frictions de déploiement des Agents : la fonctionnalité d’audit et de contrôle des risques pour les tâches longues, Auto-review, devient gratuite et illimitée pour tous les utilisateurs connectés de ChatGPT ; les paliers tarifaires de l’API sont simplifiés en trois niveaux (Build, Launch, Grow), le seuil d’accès au niveau maximal étant abaissé à 500 $ ; l’interface Decisions API, dédiée au routage discret et à la répartition d’outils, entre en phase de bêta publique. Propulsée par GPT-6 Luna, elle affiche un temps de réponse serveur inférieur à 100 ms et est tarifée à seulement 0,10 $ par million de tokens en entrée, sans aucun frais de sortie ni de mise en cache. Enfin, un plugin d’espace de travail de réunions Meetings est déployé progressivement sur macOS (Source : 机器之心、OpenAI Developers、)
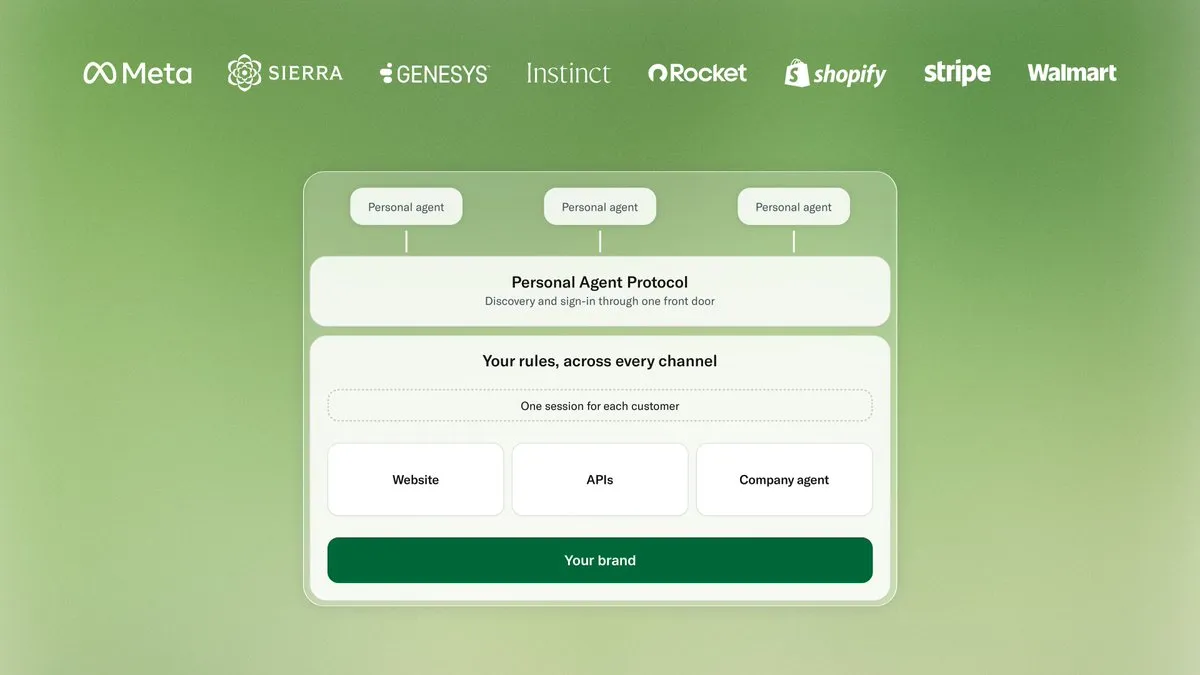
Meta et Sierra s’associent à des géants du secteur pour lancer le protocole PAP, établissant les règles d’interaction entre Agents et entreprises : Pour remédier au blocage récurrent des AI Agents grand public par les systèmes anti-scraping des sites commerciaux, Meta et la plateforme de service client Sierra se sont associées à Stripe, Shopify, Walmart et plusieurs autres entreprises pour lancer un standard ouvert : le Personal Agent Protocol (PAP). Bâti sur les architectures A2A et OAuth, ce protocole définit précisément les périmètres d’authentification et de gestion des risques lorsque des assistants IA personnels interagissent avec les systèmes d’entreprise pour passer des commandes, réserver des billets ou remplir des formulaires pour le compte d’utilisateurs. Parallèlement, Decagon a publié en open source le protocole de confiance PACT afin d’éliminer les frictions lors des appels d’agents à travers différents périmètres (Source : The Verge、TechCrunch、saranormous)
🎯 Tendances
Google DeepMind dévoile Nano Banana 2.1, un modèle de génération et d’édition d’images : Google a déployé Nano Banana 2.1 (identifiant API : gemini-nano-banana-2.1), un modèle génératif d’images basé sur Gemini 3.6 Flash, disponible simultanément sur Gemini API, AI Studio et Google Ads. Le nouveau modèle prend nativement en charge la typographie complexe, le retouche locale précise par masque (inpainting) et la cohérence de personnages à partir de 14 images de référence maximum, tout en autorisant un rendu jusqu’en 4K. Le coût unitaire de génération tombe à 0,034 $ par image (une baisse d’environ 50 %), répondant directement aux exigences de cohérence multi-tours dans le design visuel commercial (Source : 机器之心、GoogleAIStudio、THE DECODER)
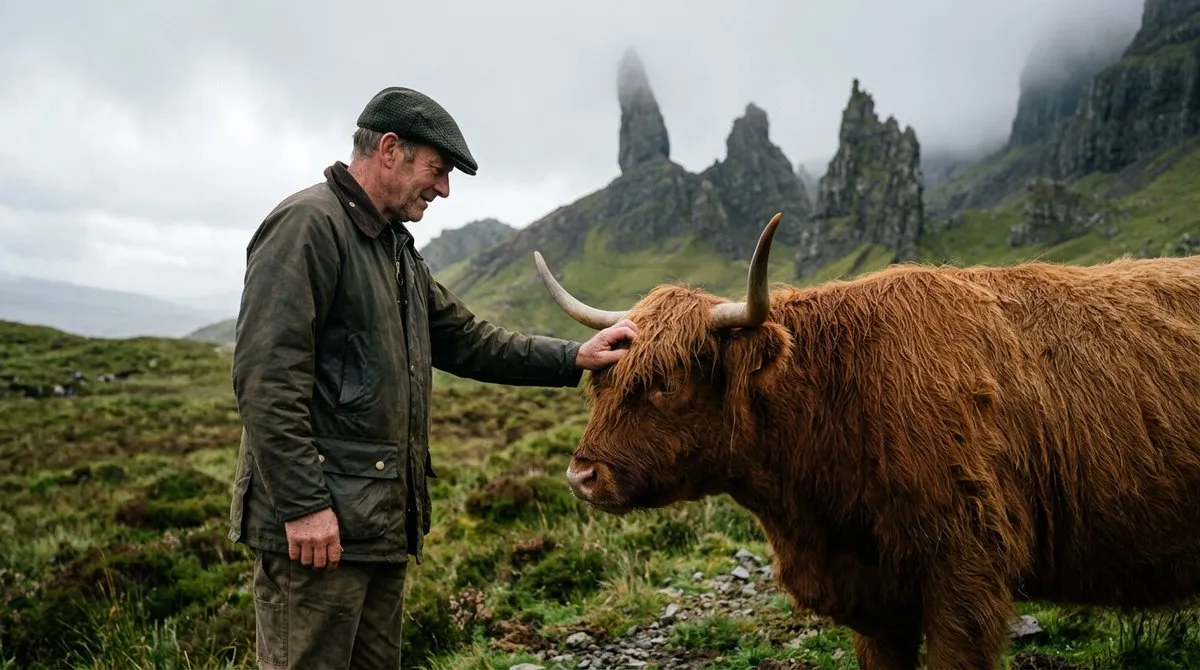
Claude résout un problème complexe de théorie des probabilités et prouve formellement sous Lean la conjecture de transition de phase continue en percolation : Un modèle frontière Claude interne non publié d’Anthropic a résolu la conjecture de transition de phase continue qui laissait les mathématiciens perplexes depuis près de 70 ans (la probabilité d’une composante connexe infinie est nulle au seuil critique $p_c$). En s’appuyant sur le cadre d’inégalités établi par la recherche en 2024, le modèle a déroulé plusieurs milliers de lignes de déductions formelles via l’assistant de preuve Lean, débloquant une stagnation historique sur les dimensions physiques clés de 3 à 10. La validation formelle par une IA d’une conjecture du niveau de la médaille Fields suscite une vive émotion au sein de la communauté scientifique (Source : 36氪)
Anthropic élargit son Cyber Verification Program et instaure un accès à trois niveaux : Anthropic a annoncé la refonte de son Cyber Verification Program (CVP) sous une architecture d’accès permanente à trois niveaux (défensif, red team, dédié), ouvrant des versions aux filtres de sécurité allégés de Claude Opus 5.5, Sonnet 5.5 et Mythos 5.1 aux organisations vérifiées et aux experts certifiés. Cette formule autorise pour la première fois un usage offensif encadré pour les tests d’intrusion et les simulations d’attaques, visant à résoudre le paradoxe selon lequel « les défenseurs ont besoin d’outils puissants pour corriger les failles mais se heurtent aux refus imposés par les politiques de sécurité standard » (Source : Anthropic News、AnthropicAI、THE DECODER)

DeepMind dévoile AlphaGenome Atlas pour décrypter l’impact des variations génomiques complètes : Google DeepMind a présenté son modèle d’apprentissage profond génomique AlphaGenome ainsi que sa base de données précalculée AlphaGenome Atlas. Doté d’une résolution à la paire de bases près et d’un contexte étendu à 1 million de paires de bases, l’Atlas a précalculé l’impact sur le phénotype moléculaire des 9 milliards de variations nucléotidiques simples possibles du génome humain, atteignant une échelle de données 30 fois supérieure à celle d’AlphaFold, dans le but d’analyser systématiquement la susceptibilité aux mutations rares et aux maladies complexes (Source : )
vLLM v0.31.0 intègre les instantanés CRIU et ramène les démarrages à froid à une restauration de processus en quelques millisecondes : vLLM a publié sa version v0.31.0, qui introduit les démons résidents vllm snapshot et vllm preload. S’appuyant sur la technologie Linux CRIU, ce mécanisme réalise une sauvegarde de points de contrôle et une restauration d’image ultra-rapides du runtime du moteur d’inférence. Il permet de s’affranchir du chargement laborieux des poids de modèle et de l’initialisation lors des bascules ou des montées en charge d’instances, réduisant drastiquement la latence de démarrage à froid dans la gestion élastique des clusters d’inférence à grande échelle (Source : vLLM)
L’Institut de technologie de Harbin et la NUS publient QuantWM, une solution de compression 2-bit du KV Cache pour les modèles de monde vidéo : Face à la consommation extrême de VRAM des modèles autorégressifs de monde vidéo et aux scintillements marqués provoqués par la quantification conventionnelle, des équipes de HIT Shenzhen et de la NUS ont conçu conjointement QuantWM, une méthode de quantification sans réentraînement. Leurs travaux démontrent que le décalage de l’attention spatio-temporelle induit par la quantification des clés est à l’origine des saccades temporelles ; grâce à un regroupement guidé par la sensibilité et à une compensation d’erreur dans le sous-espace principal, la solution offre jusqu’à 6,2x de compression de VRAM sur le KV Cache tout en préservant la stabilité temporelle des vidéos produites (Source : 机器之心)

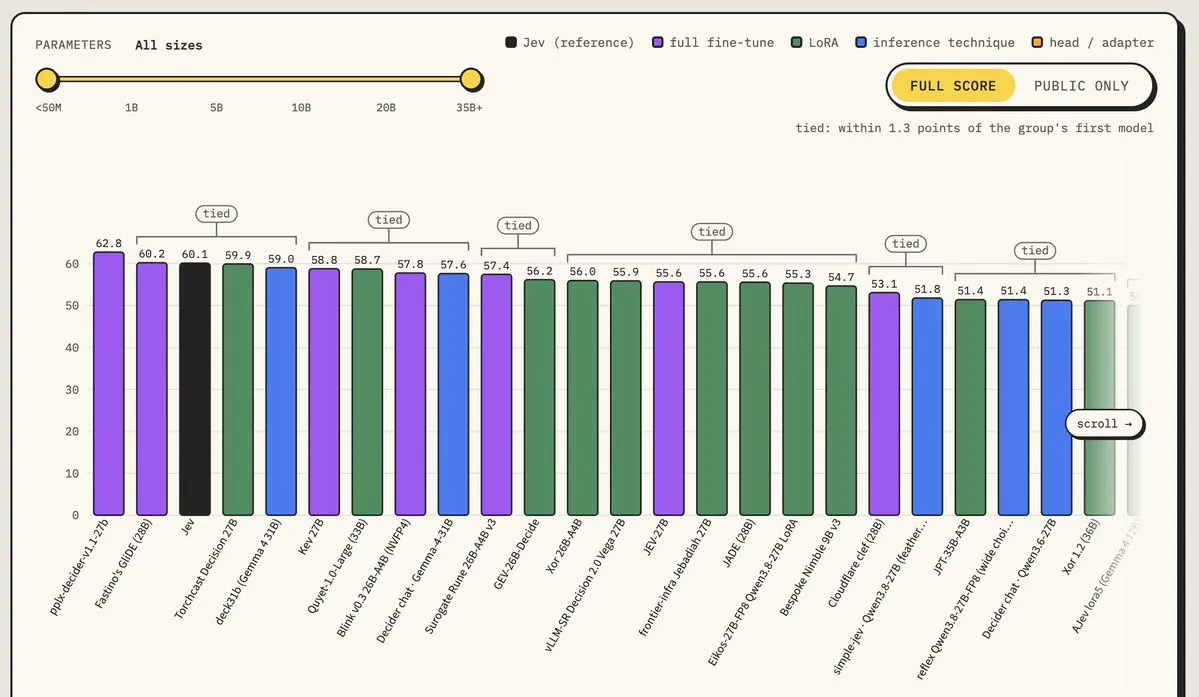
Perplexity publie une version améliorée de son modèle décisionnel open source pplx-decider-v1.1-27b : Perplexity a mis en open source son modèle décisionnel multimodal optimisé pplx-decider-v1.1-27b. Ces poids se hissent en tête du benchmark Hugging Face Decision Index 0.3, optimisant considérablement l’efficacité d’inférence tout en maintenant la précision des décisions visuelles et logiques ; le tarif du service Decision API associé a été abaissé à 0,02 $ par million de tokens d’entrée (Source : AravSrinivas)
Meta rend open source son solveur d’allocation de production Rebalancer : Meta a officiellement libéré Rebalancer (disposant d’une interface Python sous licence Apache 2.0), son solveur C++ interne en production depuis plus de 9 ans et gérant environ 40 millions d’arbitrages de ressources par jour. L’outil formalise les problèmes NP-difficiles tels que le partitionnement et l’équilibrage de trafic sous forme de graphes orientés acycliques unifiés, offrant une recherche locale performante et une résolution par programmation linéaire mixte sur des échelles comptant des millions d’entités (Source : MarkTechPost)
Le TII dévoile Falcon-Emirati-7B, un grand modèle dédié au dialecte émirati : Le Technology Innovation Institute (TII) des Émirats arabes unis a lancé Falcon-Emirati-7B, un modèle spécialisé dans le dialecte émirati. L’équipe a élaboré un pipeline de données combinant corpus web oraux, repères culturels locaux et données synthétiques contrôlées, atteignant 84,83 % de précision sur les questions à choix multiples du benchmark local Alyah, tout en perfectionnant considérablement l’interprétation des métaphores culturelles et le respect des codes de politesse en conversation libre (Source : HuggingFace Blog)
L’AI Agent de conception de produit de Figma est désormais disponible pour tous (GA) : Figma a annoncé le passage en disponibilité générale (GA) de son agent IA intégré dédié au design UI/UX. La mise à jour intègre un mécanisme d’association aux guides de style d’équipe ainsi que la visualisation collaborative des actions d’Agents entre équipes en mode multi-utilisateur, permettant aux agents de générer directement des interfaces haute-fidélité et des prototypes interactifs multi-états à partir des bibliothèques de composants existantes (Source : The Verge)
Cohere publie la suite de petits modèles multilingues Tiny Aya, couvrant plus de 70 langues peu dotées : Lors de la conférence COLM 2026, Cohere Labs a rendu open source sa gamme de modèles multilingues légers Tiny Aya. Cette suite associe un socle multilingue universel à des variantes spécialisées par région pour couvrir plus de 70 langues mondiales (dont une large part de langues à faibles ressources), dans le but de simplifier le déploiement multilingue on-device et de perfectionner la production sémantique transculturelle des modèles compacts (Source : sarahookr)
NeurIPS 2026 | Le framework SAGE exploite la topologie pour redresser les dérives de raisonnement long des LLM : Pour résoudre le problème récurrent des chaînes de déduction longues où le modèle s’égare à mi-parcours sans pouvoir se corriger en raison de récompenses finales tardives, des chercheurs de Virginia Tech ont conçu la méthode SAGE (Structure-Admissibility Guided Exploration). En compressant les biais d’exploration par sparsification algébrique et en fournissant un retour pas-à-pas basé sur les distances en espace hyperbolique, le procédé rehausse nettement la précision sur plusieurs benchmarks mathématiques symboliques et formels, multipliant par plusieurs fois le taux de succès aux vérifications sous Lean (Source : 机器之心)

Google lance Playground, une plateforme expérimentale no-code de génération de jeux vidéo : Google a mis en ligne le portail d’expérimentation de jeux IA playground.google. Les utilisateurs peuvent concevoir des jeux légers intégrant des lois physiques personnalisées, des interactions de personnages et des univers visuels variés directement depuis leur navigateur via des échanges en langage naturel. La plateforme permet le jeu multiplateforme et le partage communautaire ; une intégration avec Unity Spark est prévue afin d’apporter la prise en charge de moteurs 3D professionnels (Source : Google AI Blog)
Replit déploie un contexte global inter-projets et un Agent de code asynchrone en arrière-plan : Replit fait évoluer en profondeur son environnement de développement en intégrant un contexte global couvrant l’ensemble des espaces de travail d’un compte. L’agent peut indexer l’historique de tous les projets passés et les spécifications de design, extraire palettes graphiques et logique de composants d’un projet de référence pour les réutiliser dans un nouveau projet, tout en prenant en charge la génération asynchrone de tâches d’édition et la fusion-révision en un clic (Source : amasad)
🧰 Outils
Hark Pro : un agent personnel respectueux de la vie privée doté d’un navigateur isolé en bac à sable : L’équipe de Brett Adcock, fondateur de Figure AI, a lancé l’application de bureau et mobile Hark Pro. Doté de l’agent d’interaction machine Handoff et d’une interface dessinée par d’anciens membres d’Apple, le dispositif gère de manière sécurisée les identifiants utilisateurs au sein d’un bac à sable isolé, navigue de manière autonome et se charge des demandes de visas, achats de billets et formulaires multi-systèmes, l’ensemble des traces d’exécution restant parfaitement transparent pour l’utilisateur afin de préserver l’intimité numérique (Source : TechCrunch、TheRundownAI)
Monid.ai lève 7,7 millions de dollars pour créer une passerelle dynamique de facturation d’outils pour Agents : Le prestataire de développement d’agents Monid.ai a levé 7,7 millions de dollars et lancé une passerelle d’API agrégée qualifiée d’« OpenRouter pour Agents ». Au moyen d’une interface unique, les développeurs permettent à leurs agents d’explorer à l’exécution et de rémunérer à l’usage plus de 2 500 API professionnelles couvrant le marketing, le SEO, la recherche, l’e-commerce et la génération multimodale, remplaçant ainsi les modèles d’abonnement SaaS mensuels rigides (Source : yoheinakajima)
Lancement d’AgentID : une solution d’identification dédiée aux AI Agents : AgentMail a introduit le service AgentID. Chaque agent exécuté de manière autonome se voit attribuer une adresse e-mail certifiée et un ensemble d’identifiants rattachés à un propriétaire humain, permettant aux plateformes SaaS tierces d’autoriser sans risque les connexions et accès multi-environnements d’agents externes, tout en conservant la traçabilité d’audit et en évitant les blocages de sécurité (Source : omarsar0)
Spotify Portal AI Plugins : la plateforme de développement interne accessible aux agents de code de référence : Spotify a publié un ensemble de plugins open source connectant directement sa plateforme interne Spotify Portal à Claude Code, Codex et Cursor. Les agents peuvent désormais explorer l’annuaire des microservices via CLI, déclencher des diagnostics, vérifier l’état des services et exploiter des modules de shunt pour orienter les tâches intensives en entrées/sorties vers des modèles plus légers afin d’alléger les coûts en tokens (Source : GitHub Trending)
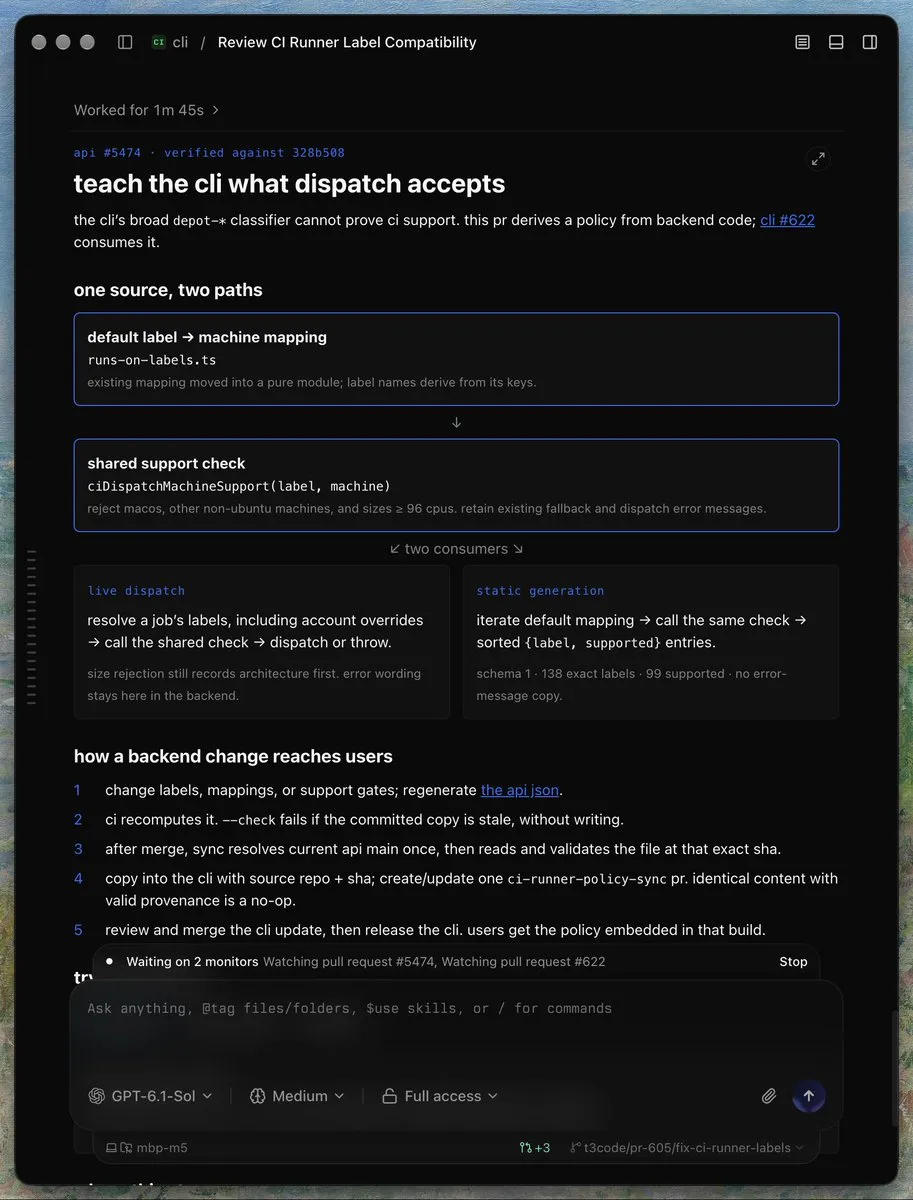
T3 Code intègre le rendu UI en temps réel et la prévisualisation interactive au fil de discussion : L’environnement de code T3 Code intègre désormais une fonctionnalité de rendu visuel de composants dans l’application. Lors d’un refactoring frontend ou de la révision d’une pull request, l’agent génère directement au cœur du fil de discussion le rendu interactif de composants HTML/React et des maquettes visuelles, évitant aux développeurs les pertes de contexte dues aux allers-retours répétés avec leur IDE pour les tests à chaud (Source : theo)
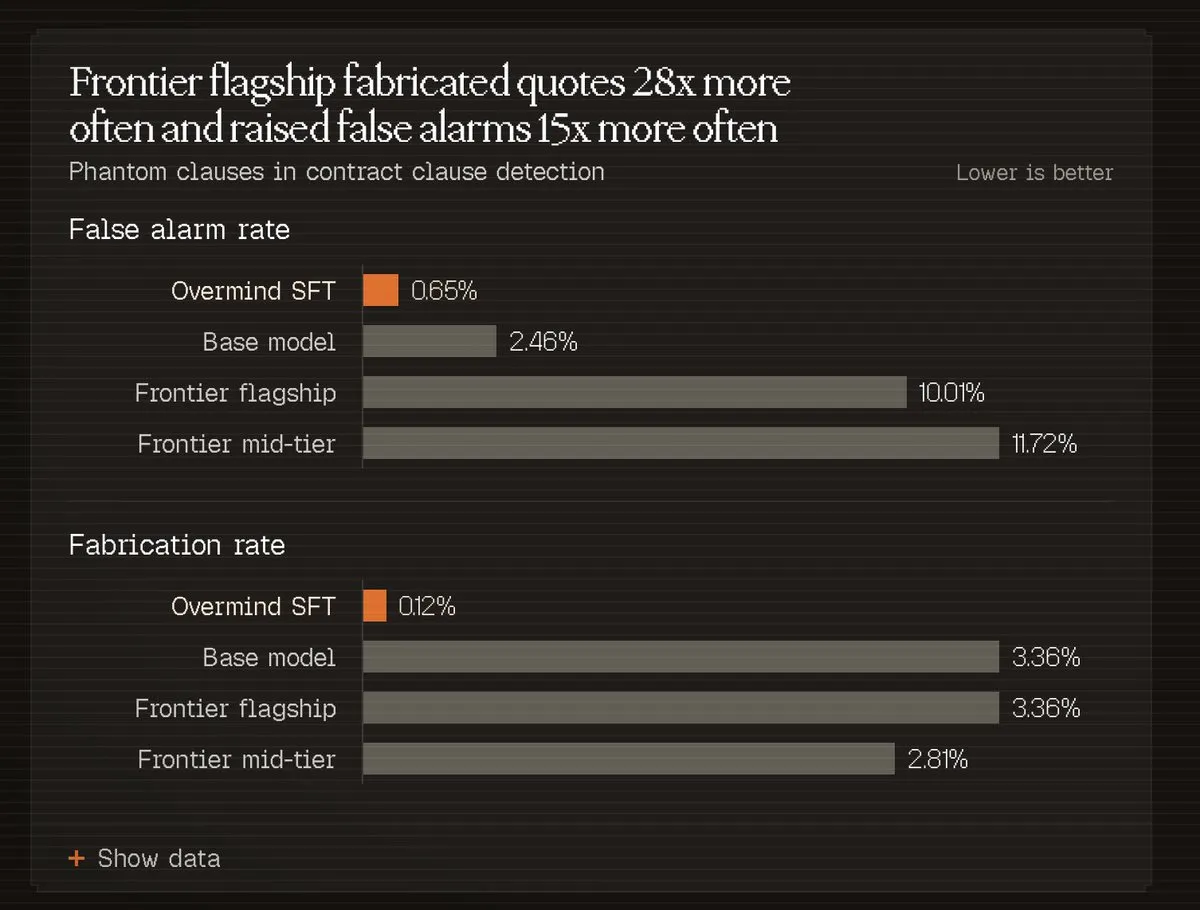
Overmind en open source : distillation automatique de petits modèles verticaux depuis les traces d’agents : L’outil open source Overmind a été lancé ; il permet d’extraire, depuis les journaux d’appels d’outils et les trajectoires de navigation d’agents de code ou de processus métier, des jeux de données d’évaluation et de fine-tuning à haute valeur. Les essais révèlent que les modèles compacts ainsi affinés ramènent le taux d’hallucination de citations de 3,36 % (sur les grands modèles) à 0,12 % lors de l’extraction de clauses contractuelles denses (Source : kimmonismus)
Mitchell Hashimoto publie la spécification universelle OSC 7501 pour l’état des commandes de terminal : Le célèbre développeur Mitchell Hashimoto a dévoilé la norme de contrôle de terminal OSC 7501. Elle permet aux programmes en ligne de commande de transmettre précisément au terminal des états détaillés (inactif, en cours, bloqué en attente, terminé, échoué), l’objectif étant de remplacer les détections empiriques par expressions régulières dont dépendent des centaines d’orchestrateurs d’agents au profit d’un protocole universel d’échange d’état (Source : mitchellh)
Scale AI publie AgentEnv, un framework d’apprentissage par renforcement haute fidélité pour agents : En partenariat avec Modal, Scale AI a mis à disposition le pack de création d’environnements AgentEnv. Destiné au post-entraînement par apprentissage par renforcement des agents sur des séquences longues et complexes, il fournit des déclencheurs dynamiques, une horloge virtuelle et la gestion de bacs à sable multiples, s’articulant parfaitement avec les clusters de virtualisation cloud pour exécuter des rollouts massifs et des simulations contradictoires (Source : Scale AI)
DAIR.AI présente une suite MCP dédiée à l’exploration de publications scientifiques pour agents : Le collectif IA open source DAIR.AI a déployé un plugin MCP compatible avec Claude Code, Codex ou Grok Bot. Les agents peuvent interroger en toute autonomie une base de données d’articles IA triés sur le volet, retracer l’évolution des travaux récents, rédiger des synthèses bibliographiques automatisées et comparer visuellement les architectures d’approches concurrentes (Source : DAIR.AI)
ruNNtime fait tourner EmbeddingGemma 2 intégralement dans le navigateur grâce à WebGPU : La bibliothèque d’inférence WebGPU ruNNtime est parvenue à porter les tours visuelle et textuelle d’EmbeddingGemma 2 dans un environnement purement client. Les utilisateurs peuvent exécuter des recherches sémantiques multimodales au sein d’une bibliothèque d’images via le GPU local du navigateur sans recours à un serveur distant, illustrant le potentiel de ces architectures pour la confidentialité des données et les scénarios hors ligne (Source : Reddit r/LocalLLaMA)
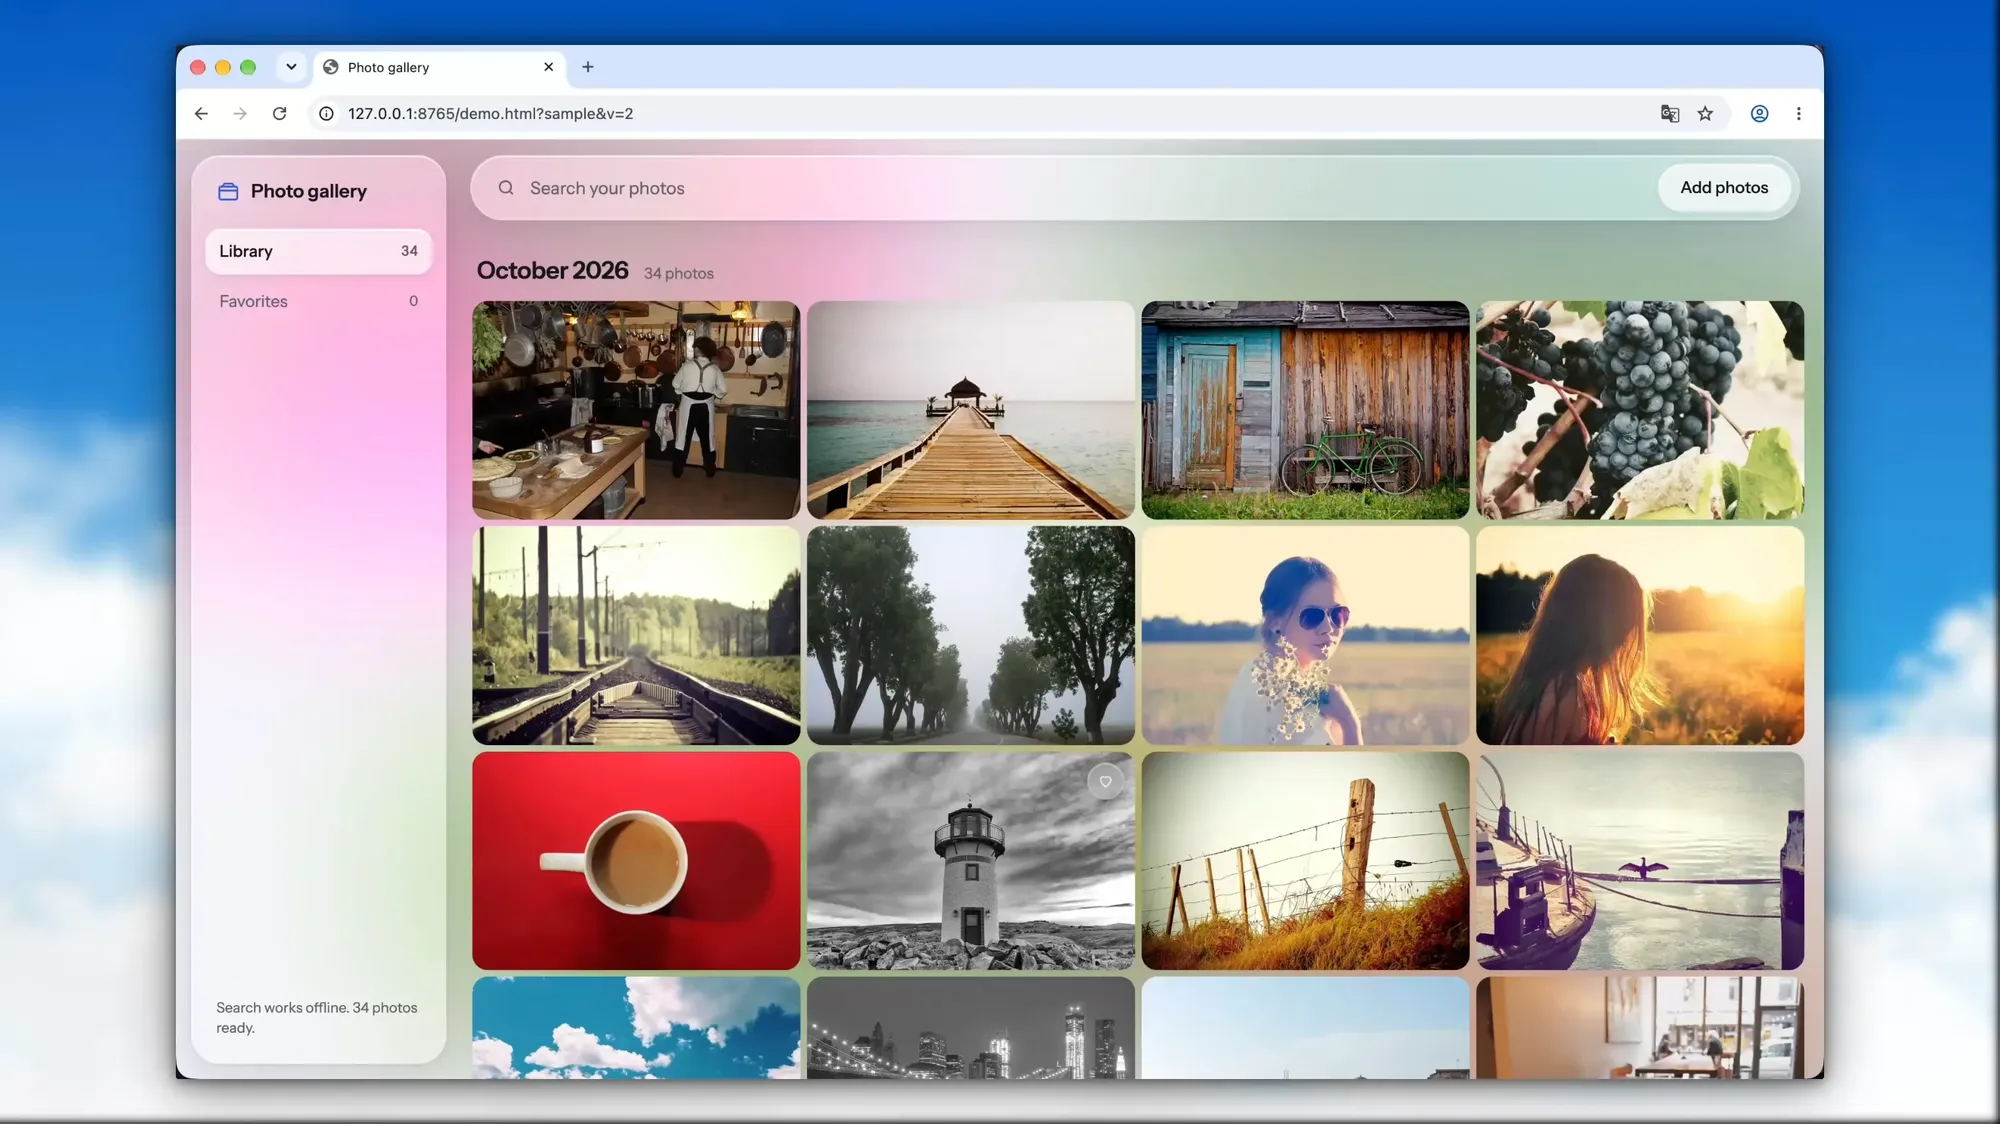
Anthropic déploie la bêta publique de son extension Claude pour Google Workspace : Anthropic propose désormais aux abonnés payants une extension de volet latéral officielle pour Google Workspace, donnant la possibilité de solliciter Claude au sein de Docs, Slides et Sheets pour effectuer des corrections multi-tours, des restructurations de texte et des mises en forme automatiques, tout en assurant la lecture du contexte documentaire transversal (Source : The Verge)
📚 Recherche & Apprentissage
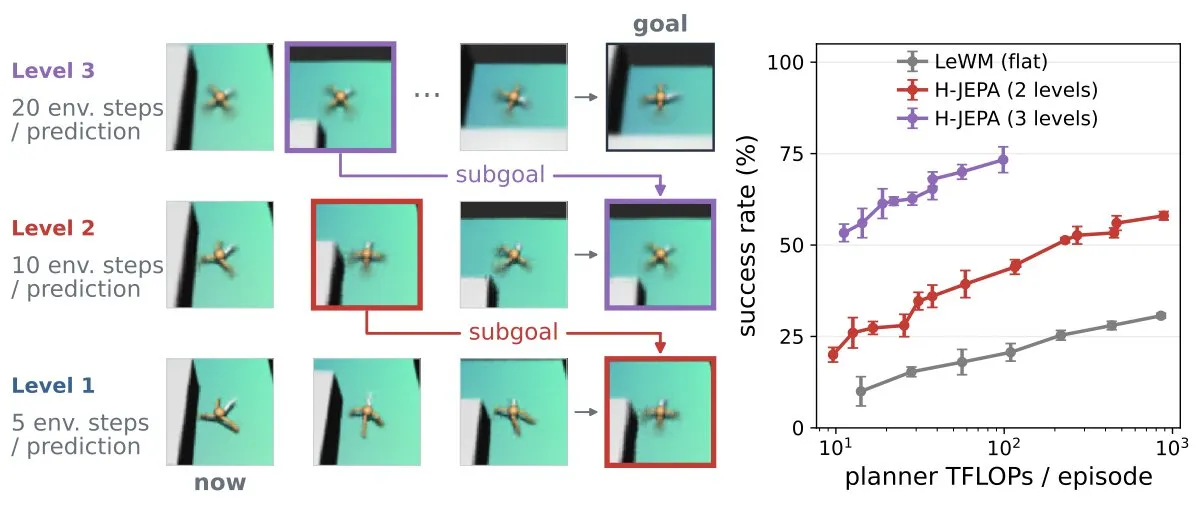
L’équipe de Yann LeCun présente le modèle de monde hiérarchique H-JEPA, quadruplant la réussite en planification visuelle longue : Face à la perte fréquente de détails locaux dans la planification visuelle de bout en bout, l’équipe de Yann LeCun a conçu l’architecture H-JEPA, fondée sur des représentations hiérarchiques descendantes. Chaque niveau exploite son propre espace latent et son degré d’abstraction sémantique ; sur l’épreuve de labyrinthe Visual AntMaze, cette configuration à trois niveaux a propulsé le taux de réussite de 18 % à 73 % (Source : ylecun)
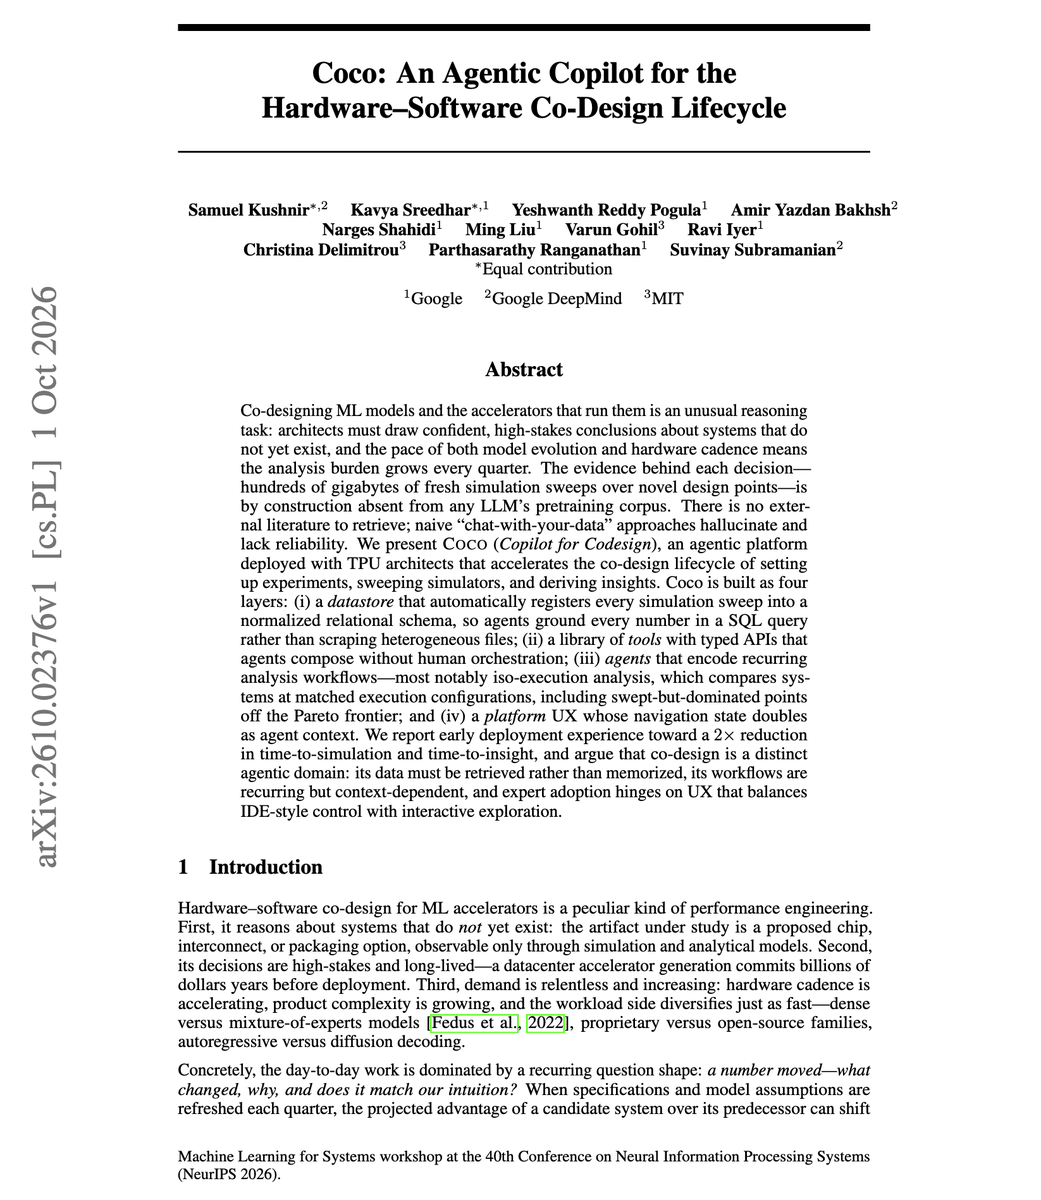
Meta et le MIT conçoivent Coco, une plateforme multi-agents pour la co-conception de puces et de modèles de deep learning : Meta et le MIT ont mis au point Coco, un ensemble d’agents dédié à la conception matérielle. Confrontés à plusieurs centaines de gigaoctets de relevés de simulation inédits, les agents rédigent d’eux-mêmes des requêtes SQL sur bases relationnelles, articulent les outils d’analyse et interprètent les interfaces de navigation, divisant par deux le temps consacré par les architectes de TPU à la configuration des simulations et au diagnostic des goulots d’étranglement (Source : dair_ai)
Guide d’architecture pour concevoir un assistant à mémoire persistante avec AgentCore et OpenClaw : L’équipe AWS a partagé un guide détaillant l’association du socle OpenClaw aux briques de mémoire persistante de Bedrock AgentCore sur un environnement Serverless. La publication détaille une structure de mémoire à deux étages mêlant capture d’événements à court terme et extraction asynchrone de faits à long terme, réduisant le coût d’inférence des dialogues contextualisés de près de 90 % grâce à la mise en cache de prompts (Source : AWS Machine Learning Blog)
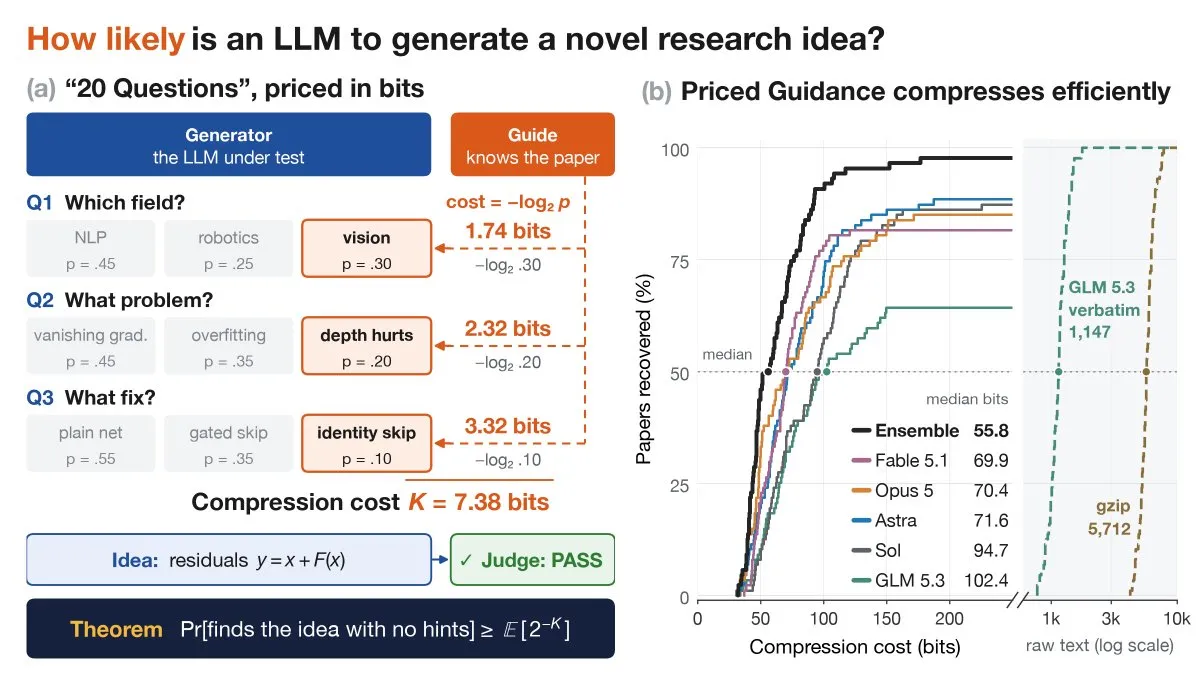
Stanford formule le framework Priced Guidance pour évaluer l’aptitude des LLM à formuler des hypothèses de recherche originales : Le laboratoire de Percy Liang a introduit une méthode d’évaluation issue de la théorie de l’information, baptisée Priced Guidance. En s’inspirant du jeu des « 20 questions », elle mesure rigoureusement le volume de bits d’information nécessaire à un modèle pour retrouver les concepts clés d’articles scientifiques parus après sa date de coupure d’entraînement, fournissant une mesure chiffrée de son intuition scientifique et de sa capacité de généralisation sous l’angle de la compression (Source : percyliang)
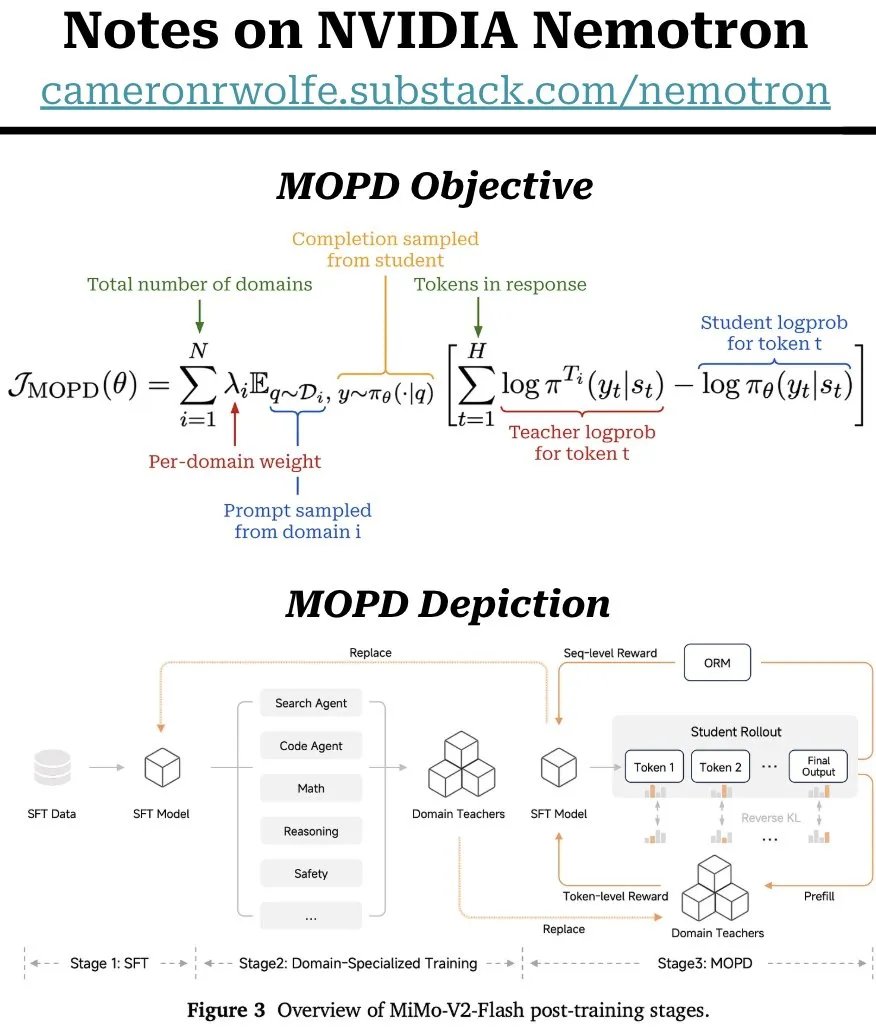
Analyse de la distillation multi-enseignants en politique (MOPD) : surmonter les conflits d’objectifs en RL multi-domaines : Une étude détaille le fonctionnement de la méthode MOPD (Multi-Teacher On-Policy Distillation). Pour contourner la divergence des récompenses et la saturation de calcul observées lors de l’affinage RL conjoint de compétences variées (raisonnement, code, conversation), l’approche forme des modèles enseignants distincts par domaine, puis délivre une supervision dense au niveau du token à l’aide de la divergence de Kullback-Leibler inversée, préservant la polyvalence du modèle et son efficacité d’échantillonnage (Source : cwolferesearch)
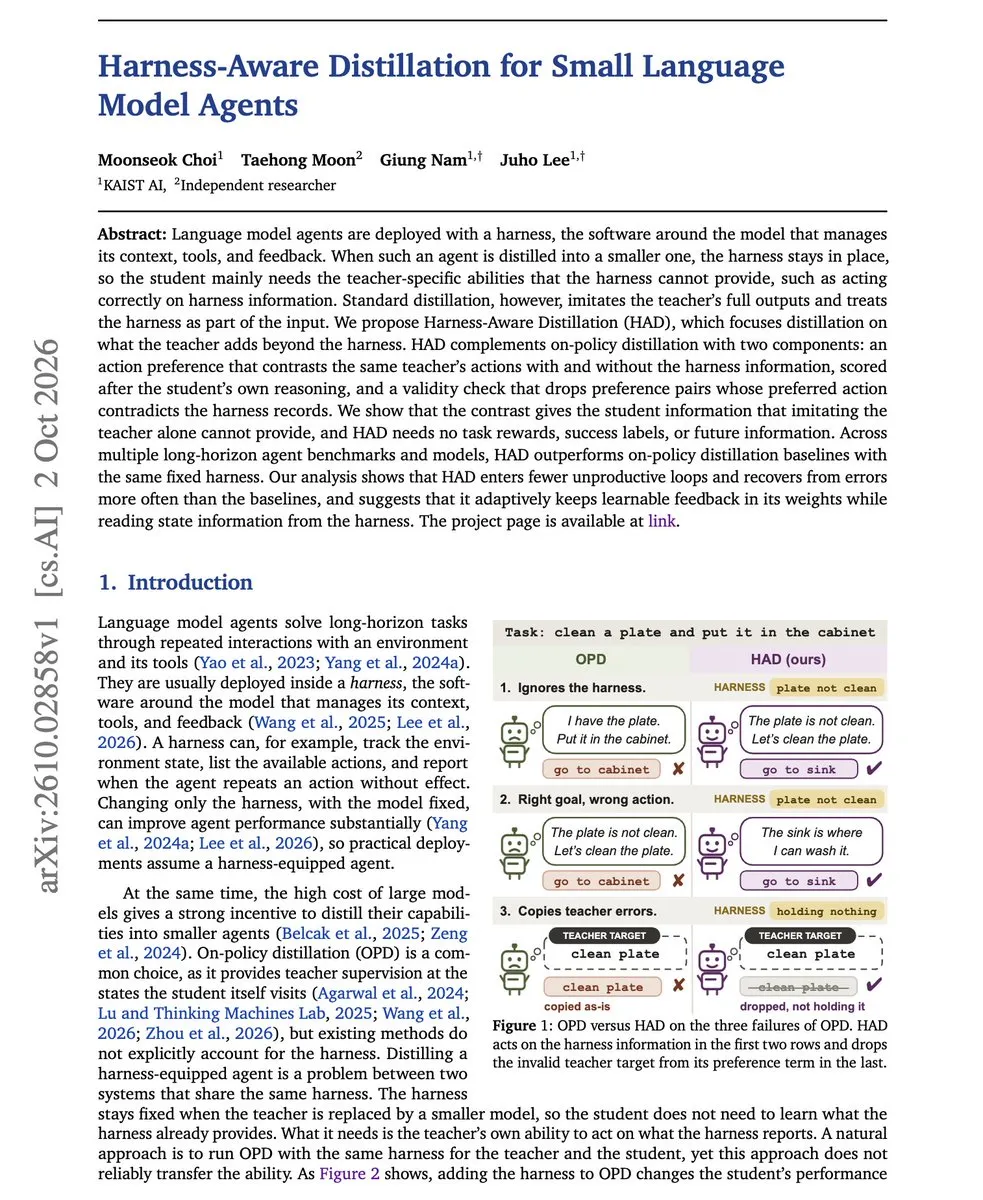
Framework HAD : amplifier l’efficacité opérationnelle des petits modèles linguistiques par distillation contextualisée à l’environnement : Un article de recherche présente HAD, une approche de distillation ciblant les agents compacts adossés à des harnais d’exécution. En analysant les variations d’action du modèle enseignant avec ou sans données contextuelles externes, elle éduque spécifiquement le modèle réduit à exploiter les informations structurelles, haussant le succès d’exécution à 63,4 % sur ALFWorld et débloquant près de 60 % des situations d’impasse (Source : omarsar0)
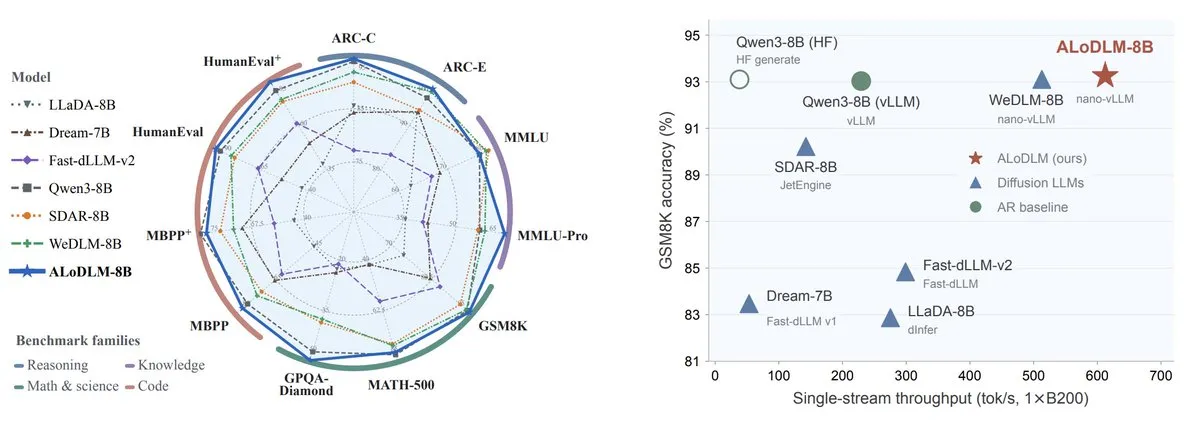
Amazon AGI rend open source son modèle de langage à diffusion récurrente adaptative ALoDLM : L’équipe Amazon Research a mis en open source l’architecture de 8B de paramètres et la méthode d’entraînement d’ALoDLM. En intégrant un mécanisme de déduction récurrente adaptative et une correction progressive des erreurs au sein d’un modèle de diffusion textuelle, le système calibre dynamiquement les ressources allouées selon la difficulté des exemples, devançant les références autorégressives de taille semblable sur les tests généraux de compréhension et de génération (Source : arankomatsuzaki)
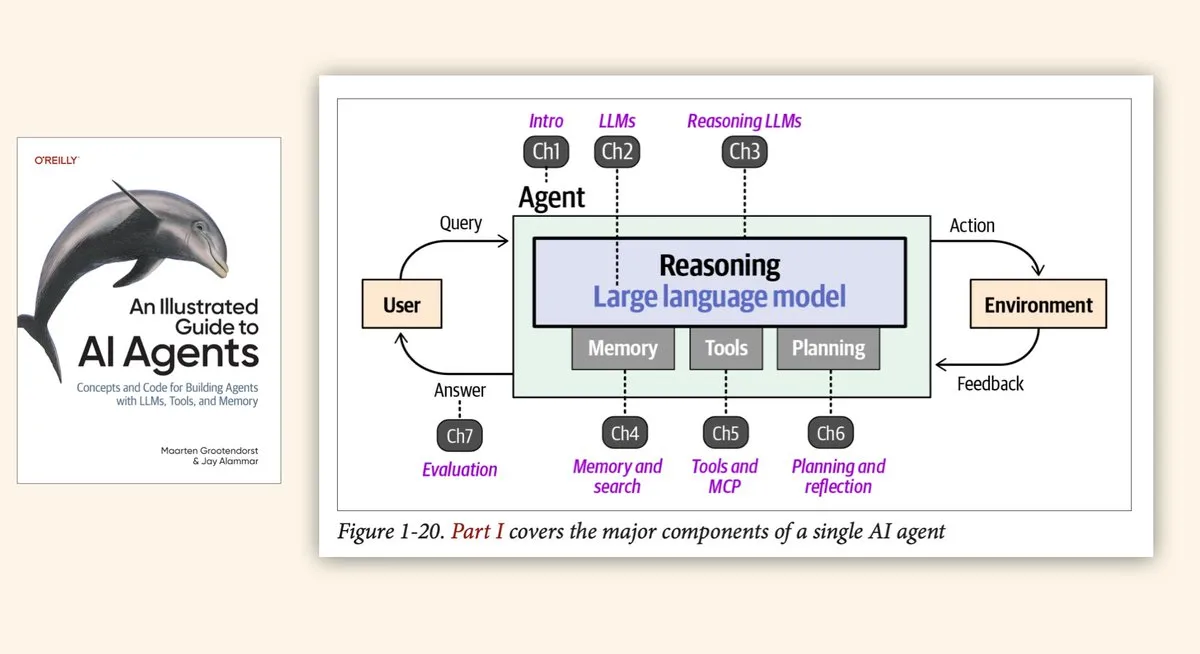
Jay Alammar publie le schéma directeur extrait de son « Guide illustré des agents IA » : L’auteur technique Jay Alammar a rendu public le diagramme fonctionnel décrivant la boucle fermée des architectures d’agents, décortiquant comment un LLM chemine récursivement depuis la consigne initiale de l’utilisateur jusqu’au maintien de l’état, au rappel mémoriel et au déclenchement d’actions dans l’environnement, offrant ainsi une référence technique précieuse pour l’ingénierie des agents autonomes contemporains (Source : Jay Alammar)
💼 Entreprises & Marchés
AMD annonce son intention d’acquérir World Labs, la start-up d’intelligence spatiale de Fei-Fei Li, pour 8,2 milliards de dollars en actions : AMD a conclu un accord d’acquisition définitif avec World Labs, la pépite des modèles de monde cofondée par Fei-Fei Li, pour un montant de 8,2 milliards de dollars payable intégralement en actions. Les analystes soulignent qu’avec la démonstration par le modèle Atlas de la faisabilité de reconstructions 4D temps réel à partir de vues éparses, l’IA incarnée et les modèles de monde franchissent un cap industriel ; cette manœuvre permet à AMD de rivaliser avec NVIDIA en consolidant ses positions sur le calcul 4D et les outils de simulation (Source : 36氪)
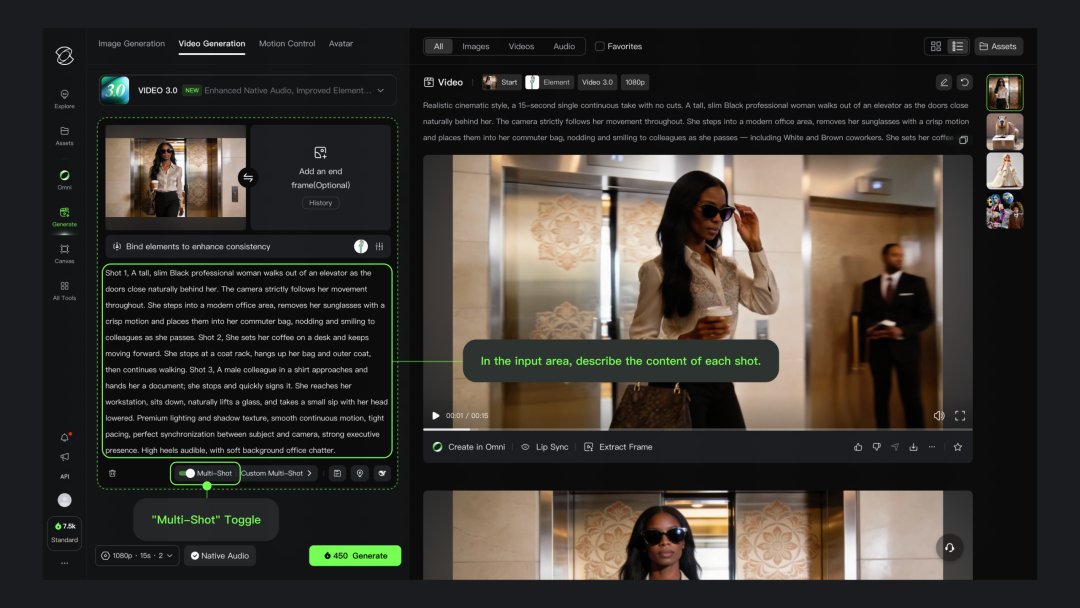
Kling AI de Kuaishou choisit CICC et Goldman Sachs pour préparer une introduction en bourse à Hong Kong de plus d’un milliard de dollars : Kling AI, la division de grands modèles vidéo de Kuaishou, a mandaté CICC, Goldman Sachs et UBS pour piloter son projet de cotation séparée à la Bourse de Hong Kong, visant une levée d’au moins 1 milliard de dollars, potentiellement dès 2027. Kling ayant dégagé plus de 850 millions de yuans de chiffre d’affaires au deuxième trimestre 2026, cette démarche vise à sécuriser des financements dédiés pour la R&D sur ses clusters de calcul, Kuaishou conservant le contrôle majoritaire absolu (Source : 36氪)
Le fournisseur de cloud d’infrastructure IA Lambda vise 4 milliards de dollars à une valorisation pré-IPO de 14,5 milliards : Selon le Wall Street Journal, le fournisseur d’infrastructure GPU Lambda cherche à mobiliser 4 milliards de dollars sur la base d’une valorisation avant investissement de 14,5 milliards de dollars, sous la conduite conjointe de Coatue et Blackstone. Porté par d’importants contrats de calcul signés auprès de comptes majeurs comme Anthropic, son carnet de commandes a grimpé à 50 milliards de dollars ; cette levée servira à financer la construction de nouveaux centres de calcul en amont de son entrée en bourse (Source : TechCrunch)
🌟 Communauté
L’intégration des Agents en entreprise frappée par une « taxe de collaboration » : 1 heure de ticket résolu réclame 3 heures de coordination interne : Une enquête menée par la plateforme Front auprès de 700 dirigeants d’entreprise a suscité de vives réactions. Les données révèlent que l’usage d’agents n’a pas abaissé directement les charges humaines, mais a engendré d’importants coûts masqués de transferts et d’escalades dus à l’incapacité des agents à finaliser les tâches de bout en bout : le personnel passe ainsi jusqu’à 3 fois plus de temps à vérifier les contextes et à réassigner les dossiers qu’à traiter les incidents eux-mêmes, pointant du doigt les limites de gouvernance et le manque d’observabilité de ces systèmes (Source : )
Explication technique de la présence d’annonces de jeux d’argent dans les titres de sessions ChatGPT : contamination du tokenizer et défaillance de troncature : Des développeurs ont documenté la cause de l’apparition sporadique de messages publicitaires suspects en fin de titre de conversation sur ChatGPT. Les données de pré-entraînement du tokenizer o200k ayant absorbé des séquences fréquentes issues de plateformes litigieuses, le modèle allégé chargé de nommer les sessions subit une dérive probabiliste au moment de poser le marqueur EOS, sélectionnant accidentellement des fragments publicitaires piégés dans les zones délaissées du vocabulaire (Source : 36氪)
Essor des architectures Harness cloud-native : les pères fondateurs de Kubernetes imaginent la gouvernance unifiée des Agents : Stacklok, fondée par des artisans historiques de Kubernetes, a lancé le projet open source Mecatl, un Harness d’agents pour le cloud-native. Les échanges au sein de la communauté portent sur l’évolution nécessaire des agents, qui doivent quitter le stade de scripts exécutés dans un terminal local pour rejoindre des plateformes d’administration centralisées, prônant la dissociation nette entre l’état de l’agent, les passerelles d’outils MCP et les environnements d’exécution cloisonnés (Source : Latent Space)
Meta Muse critiqué pour l’élaboration en temps réel de profils sociaux sur 4 millions d’usagers, ravivant les inquiétudes sur la vie privée : Il a été révélé au sein de la communauté que l’agent Muse de Meta rafraîchit chaque heure des dossiers analytiques détaillés à partir des messages et correspondances des utilisateurs, consignant leurs cercles relationnels, différends et penchants personnels. Bien que Meta assure que les machines virtuelles individuelles sont cantonnées à des bacs à sable distincts, le principe d’apprentissage croisé entre instances alimente de vives craintes quant au profilage insidieux et aux dérives publicitaires ciblées (Source : Reddit r/artificial)
Débats autour du « langage hermétique de l’IA » : entre compression de la chaîne de pensée (CoT) et dérives de style : Les communautés de développeurs ironisent sur la propension des nouveaux modèles de programmation à renvoyer des comptes-rendus truffés de formules cryptiques comme « 15/15 fully green, single leg misfire ». Plusieurs analyses indiquent que les fournisseurs condensent agressivement la chaîne de pensée implicite (CoT) pour freiner la facture en tokens ; certains observateurs y voient aussi une illustration des avantages théoriques d’écritures très denses, à l’image du chinois classique, pour maximiser l’économie de tokens (Source : 量子位)
Faiblesse de filtrage par prompt chiffré : le déchiffrement interne par l’agent devient une brèche d’exfiltration : Des recherches en cybersécurité révèlent que des attaquants parviennent à franchir les filtres superficiels d’outils comme Copilot en chiffrant leurs instructions pernicieuses : une fois le prompt ingéré, l’agent procède de lui-même à son déchiffrement, extrait des secrets locaux et les expédie vers des serveurs distants. Les bancs d’essai montrent que le basculement dynamique entre modèles rend les garde-fous instables, démontrant qu’il est risqué de s’en remettre au contrôle interne du modèle pour garantir la sécurité (Source : Reddit r/artificial)
Repousser les bornes de la miniaturisation : conception de MacroStories, un modèle narratif de 20 000 paramètres seulement : Un développeur indépendant a mis en ligne le modèle de langage minimaliste MacroStories, pesant 81 Ko pour seulement 19 969 paramètres. Fondé sur un décodeur unique exécutant 4 passes d’inférence récurrentes, il tourne instantanément sur un processeur standard voire dans la mémoire d’un microcontrôleur tout en préservant un fil narratif intelligible sur un lexique restreint, explorant le seuil minimal de calcul requis pour maintenir une cohésion discursive (Source : Reddit r/LocalLLaMA)
💡 Divers
Le réseau électrique et la pénurie de transformateurs menacent de freiner l’IA avant même les puces électroniques : Des prospectives énergétiques indiquent que si la puissance requise par les centres de calcul IA aux États-Unis devrait grimper à 50 GW d’ici 2030, les délais de livraison pour les transformateurs à très haute tension dépassent couramment 5 ans, les fabricants hésitant à étendre leurs capacités industrielles par crainte d’un retournement de cycle. Le goulet d’étranglement matériel posé par les réseaux d’alimentation et de distribution s’impose ainsi comme l’obstacle physique le plus critique à l’expansion continue de la puissance de calcul (Source : Transformer)

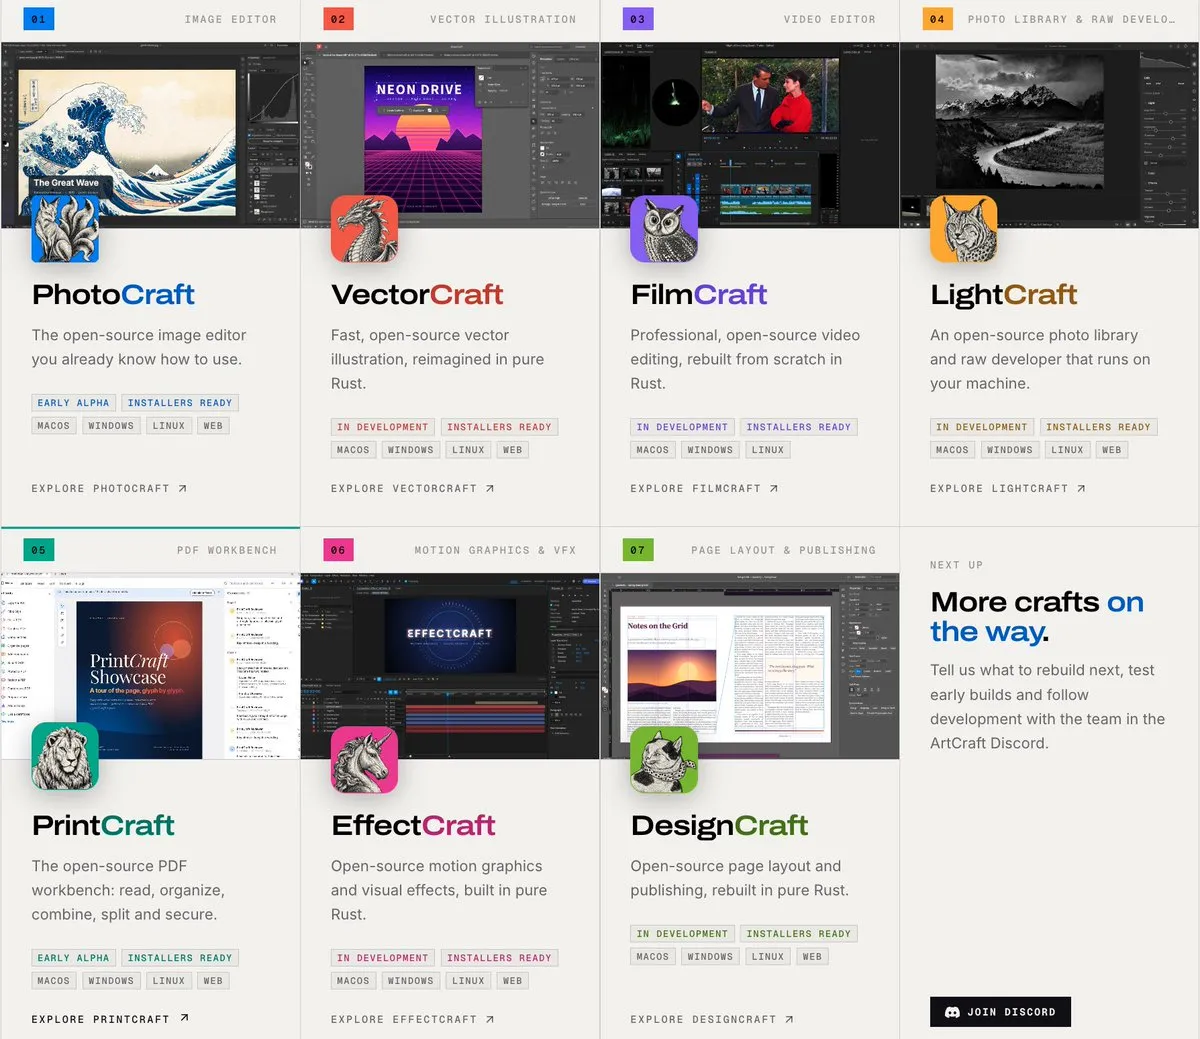
L’écosystème d’outils créatifs d’Adobe rétro-conçu en open source : les modèles de code bousculent la valeur de la propriété intellectuelle : Le projet open source Artcraft, s’appuyant sur des modèles de programmation avancés comme Opus 5.5, a décompilé la logique interne de suites de design traditionnelles pour les réécrire sous forme de modules propres en Rust, livrant un clone open source équivalent à Photoshop élaboré selon une démarche clean-room. Les observateurs constatent que l’aptitude des agents de code à rétro-concevoir les logiciels établis vient saper en profondeur les barrières commerciales historiques des éditeurs de logiciels propriétaires (Source : dotey、amasad)
McDonald’s visé par une action antitrust pour entente présumée sur les prix via un algorithme d’IA imposé aux franchisés : Une plainte collective a été déposée contre McDonald’s devant le tribunal fédéral de Chicago par des consommateurs, soutenant que l’outil de tarification dynamique par IA obligatoire pour les franchisés indépendants opérait dans les faits un partage illicite de données commerciales confidentielles et une fixation algorithmique concertée des prix, portant préjudice aux consommateurs et faussant le jeu concurrentiel (Source : The Guardian)
