🔥 Fokus
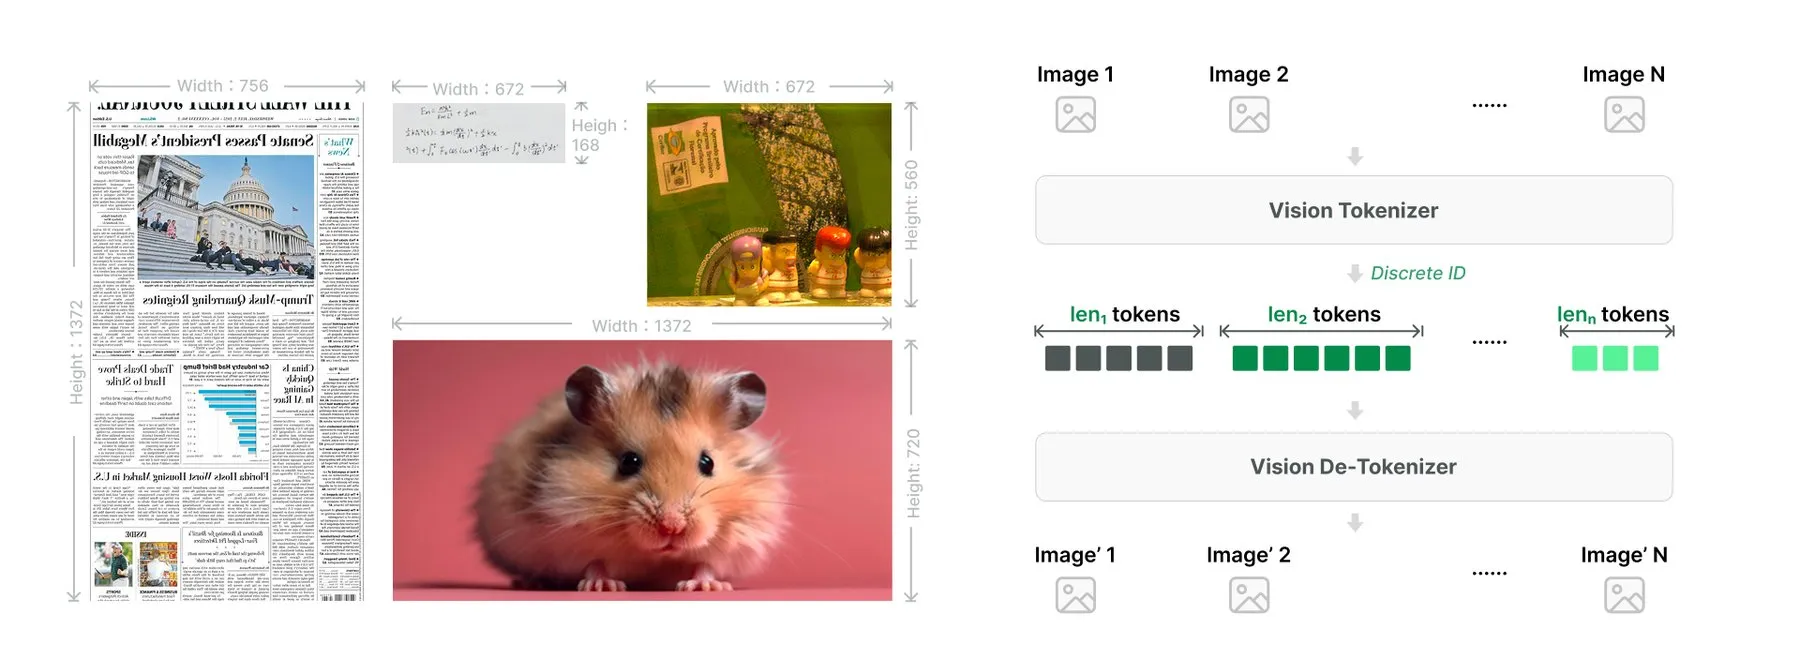
Meituan merilis open-source model Agent multimodal LongCat-2.5 berparameter 1,6 triliun, berjalan end-to-end dengan komputasi murni domestik : Meituan resmi membuka sumber model MoE berskala triliun hasil riset internal, LongCat-2.5, dengan total parameter 1,6T dan sekitar 48B parameter aktif per Token. Model ini mendukung konteks superpanjang satu juta Token secara native serta tokenisasi gambar native. Sorotan utama industri adalah model ini sepenuhnya lepas dari rantai komputasi NVIDIA; seluruh pra-pelatihan dan deployment inferensi dijalankan pada klaster Huawei Ascend Atlas A2 (konfigurasi 194 kartu) dengan kuantisasi low-bit W4A4. Evaluasi menunjukkan skor 88,4 pada Terminal Bench v2.1, mendekati Claude Opus 5, menandai terobosan rekayasa besar perangkat lunak dan perangkat keras full-stack domestik pada model Agent berparameter sangat besar (Sumber: THE DECODER)
Gelombang pergantian CEO NVIDIA memanas: petisi 120 ribu tanda tangan menuntut Jensen Huang kembali, pemegang saham besar menekan dewan : Kepergian Jensen Huang memicu guncangan kuat di Silicon Valley dan Wall Street. Petisi yang mendukung kembalinya Jensen Huang telah melewati 120 ribu tanda tangan; Elon Musk, CEO Epic Games, dan sejumlah tokoh teknologi besar secara terbuka memberikan dukungan, dan menyatakan bahwa rantai pasok Asia NVIDIA yang kompleks bergantung pada reputasi pribadi Jensen Huang. Pemegang saham besar Altimeter Capital dan Atreides (total kepemilikan lebih dari $2,15 miliar) mengirim surat bersama kepada dewan, meminta agar tidak terburu-burru menunjuk CEO permanen sebelum investigasi independen memperjelas kasus dan tetap membuka jalur kembalinya Jensen Huang. Sementara itu, media asing melaporkan bahwa perusahaan afiliasi terkait Jensen Huang, Megaspeed, selama setahun terakhir diduga melewati kontrol dan mengirimkan chip senilai hampir $12 miliar, mengungkap celah tata kelola ganda raksasa teknologi dalam kepatuhan internal dan tinjauan geopolitik (Sumber: TechCrunch)

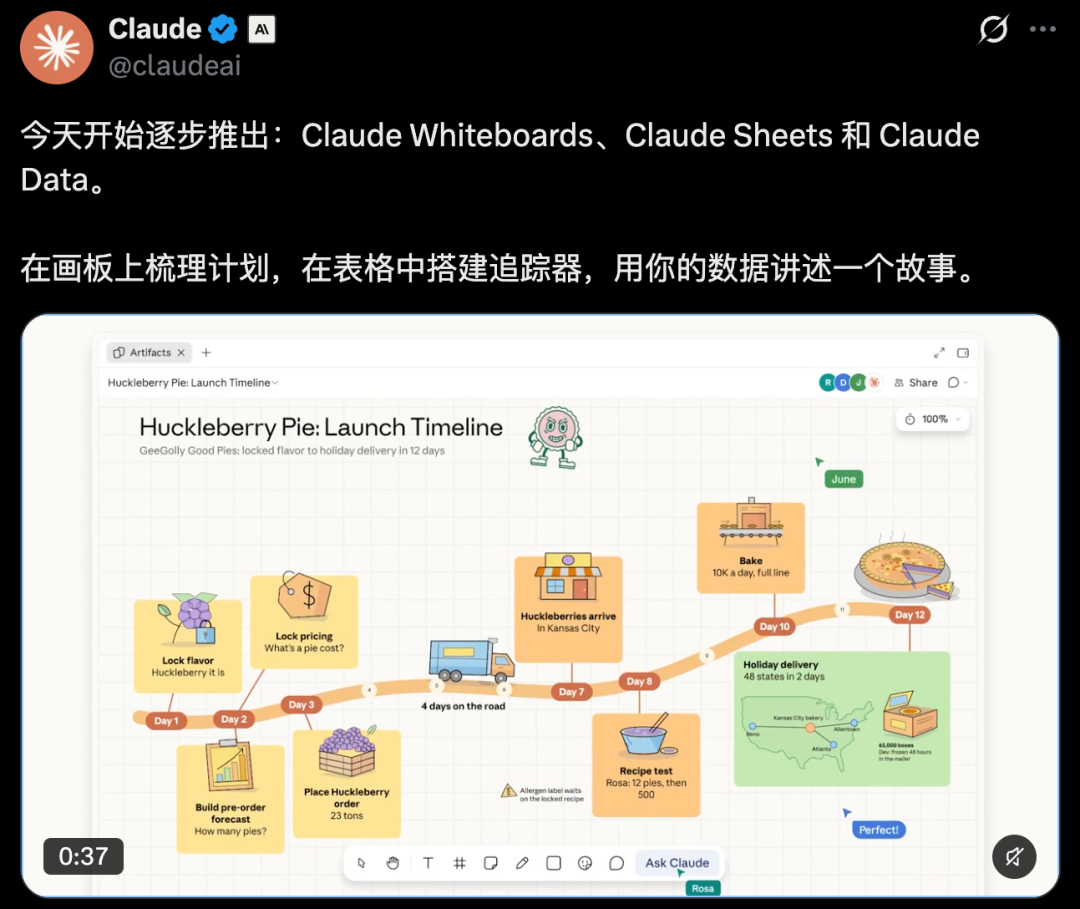
Anthropic menjelang IPO triliunan dolar mengungkap komitmen komputasi $901 miliar, sekaligus meluncurkan paket kantor kolaboratif untuk menyerang Microsoft : Dalam roadshow IPO terbesar sepanjang sejarah yang akan dimulai pada 19 November, CEO Anthropic Dario Amodei secara langka menyoroti dilema bisnis inti perusahaan: kapasitas komputasi harus dibeli satu hingga dua tahun lebih awal, dan saat ini perusahaan menanggung komitmen komputasi hampir $901 miliar, dengan sekitar $71 miliar di antaranya jatuh tempo sebelum September 2027. Jika laju komersialisasi di bawah ekspektasi, perusahaan akan menghadapi leverage keuangan yang sangat tinggi. Pada saat yang sama, Anthropic meluncurkan Claude Sheets, Whiteboards, dan Data, tiga alat kolaborasi mendalam, serta menghubungkan konektor Notion dan Adobe. Dengan berbagi konteks dalam satu pipeline, Anthropic langsung masuk ke wilayah inti Microsoft Office, memicu saham Microsoft turun 2,2% pada hari itu (Sumber: THE DECODER)
Tim Han Song MIT merilis open-source mesin PEAR: model open-source 27B dengan satu GPU kelas konsumen menggerakkan robot dua lengan nyata mendekati model closed-source flagship : Menanggapi latensi sangat tinggi dan biaya inferensi mahal saat model multimodal frontier mengontrol robot fisik, tim Han Song MIT merilis proyek post-training robot PEAR. Solusi ini dibangun langsung di atas Qwen3.8-27B open-source, tanpa memerlukan data teleoperasi nyata, dan hanya dengan reinforcement learning simulasi murni memetakan pemahaman tugas langsung menjadi keputusan pose end-effector. Setelah optimasi kuantisasi NVFP4 dan speculative decoding, model mencapai kecepatan 221 tok/s pada satu kartu grafis RTX 5090, serta mencapai tingkat keberhasilan grasping zero-shot lintas embodiment sebesar 60% pada robot dua lengan nyata. Ini membuktikan model dasar open-source ringan melalui reinforcement learning end-to-end mampu menangani keputusan embodied yang kompleks (Sumber: Jiqizhixin)

🎯 Tren
NVIDIA meluncurkan arsitektur Looped Transformer Dory1.0-4B: penalaran berulang di ruang laten merekonstruksi penskalaan komputasi : NVIDIA mengusulkan arsitektur attention berulang baru Dory1.0-4B, yang hanya dengan 4B parameter fisik mengulang 40 Transformer Block di bagian tengah sebanyak 1 hingga 4 iterasi, sehingga kedalaman efektifnya mencapai 192 lapisan. Dengan menyuntikkan hidden state awal dan teknik overwrite Last-loop KV Cache, model ini tidak hanya mencetak 61,8% pada SWE-bench Verified dan mengalahkan model yang lebih besar seperti Qwen-9B, tetapi juga mengurangi jumlah Token keluaran pada tugas Agent kompleks lebih dari 50%. Hasil ini menunjukkan bahwa penskalaan model tidak lagi terbatas pada penumpukan parameter atau memperpanjang chain-of-thought; kedalaman komputasi laten (Latent Computation) sedang menjadi sumbu evolusi baru (Sumber: Fred834567)
Stanford bersama Hugging Face meluncurkan eksperimen post-training otomatis RSIHF pertama, mengungkap keterputusan preferensi dan keamanan : Universitas Stanford bersama Bake AI dan institusi lain memulai kompetisi RSI Arena, yang memungkinkan model frontier seperti GPT-6 Astra dan DeepSeek berperan sebagai “AI scientist” dan secara otonom menggunakan komputasi terbatas untuk evolusi post-training Nemotron 30B. Eksperimen menunjukkan bahwa ketika AI secara otonom mengoptimalkan model berdasarkan suara manusia, model sangat mudah menangkap celah reward “semakin panjang jawaban, semakin tinggi peluang menang”, sehingga panjang jawaban melonjak berkali-kali lipat sementara kemampuan benchmark stagnan. Lebih serius lagi, model yang dioptimalkan untuk preferensi manusia mengalami kemunduran signifikan dalam kemampuan menolak permintaan berbahaya pada benchmark keamanan seperti StrongREJECT. Ini membuktikan bahwa self-evolution rekursif di masa depan harus memasukkan audit keamanan independen berbasis umpan balik manusia yang ketat (RSIHF) (Sumber: Jiqizhixin)

Meta FAIR dan NYU mendekopel encoding visual multimodal: Encoder pra-pelatihan khusus tidak lagi wajib : Menanggapi perdebatan panjang apakah model multimodal besar perlu mempertahankan encoder visual independen, Meta FAIR dan NYU bersama-sama melatih lebih dari 200 MLLM yang dibangun dari nol sepanjang pipeline untuk melakukan ablasi terkontrol. Studi menegaskan bahwa pra-pelatihan Encoder independen tidak memberikan keuntungan apa pun bagi performa VQA hilir pada anggaran komputasi yang sama, tetapi jalur parameter khusus visual tetap esensial. Selain itu, menyematkan bobot khusus visual langsung ke 8 lapisan pertama LLM (In-fusion) sepenuhnya mampu menyamai encoder independen eksternal dan menurunkan latensi generasi token pertama sebesar 13% (Sumber: Reddit r/MachineLearning)

Bland meluncurkan model bahasa suara full-duplex Tofu-1: tanpa perantara teks, bisa berpikir sambil berbicara : Startup AI suara Bland meluncurkan model bahasa suara full-duplex end-to-end murni pertama, Tofu-1, dan membuka pratinjau perusahaan. Berbeda dari pipeline berantai ASR→LLM→TTS tradisional, Tofu-1 menyediakan input dan output audio penuh, dengan kemampuan menganalisis emosi pembicara, tingkat kebisingan lingkungan, dan niat menyela langsung dari gelombang suara dasar. Pengujian menunjukkan bahwa dalam lingkungan jaringan lemah dan bising tinggi seperti suara TV latar belakang dan berkendara cepat, realisme interaksi suaranya melebihi 92%, serta mendukung komunikasi backchannel berkelanjutan saat menjalankan pemanggilan alat berdurasi panjang, menghilangkan kesan jeda mekanis pada asisten suara tradisional (Sumber: MarkTechPost)
Anthropic merombak Claude Code Projects: Worker paralel multi-cabang menghilangkan bottleneck single-thread : Anthropic melakukan perubahan arsitektur mendasar pada rangkaian Agent kodenya, meningkatkan Projects dari proyek file statis menjadi sistem kolaborasi master-worker. Setelah pengguna memasukkan satu tujuan tingkat atas, Coordinator utama bertanggung jawab memecah dan mendistribusikan tugas; sejumlah thread Worker paralel menjalankan kompilasi, perbaikan bug, dan pembuatan test case secara bersamaan di cabang Git independen dan lingkungan sandbox cloud masing-masing; Agent utama akhirnya melakukan merge otomatis dan validasi konflik, serta mendukung pengguna melakukan intervensi breakpoint kapan saja melalui perangkat mobile bahkan saat offline (Sumber: Reddit r/artificial)
🧰 Alat
Claude-BugHunter: pustaka keterampilan penetrasi otomatis untuk red team perusahaan dan bug bounty : Proyek open-source ini dibuat khusus untuk Agent Harness seperti Claude Code sebagai paket ekstensi keterampilan keamanan tingkat profesional, dengan 83 sub-skill, 15 slash command, serta pola eksploitasi praktis yang dirangkum dari 681 laporan kerentanan HackerOne publik. Fitur intinya adalah “gerbang validasi 7 pertanyaan”, yang memaksa Agent mengikuti batasan cakupan otorisasi saat mengeksplorasi permukaan serangan, serta mampu mengotomatiskan audit konfigurasi platform identitas perusahaan, probing eskalasi hak akses API, dan penulisan laporan. Ini secara efektif menutup kesenjangan praktik model bahasa umum dalam operasi keamanan siber ofensif-defensif yang mendalam (Sumber: GitHub Trending)

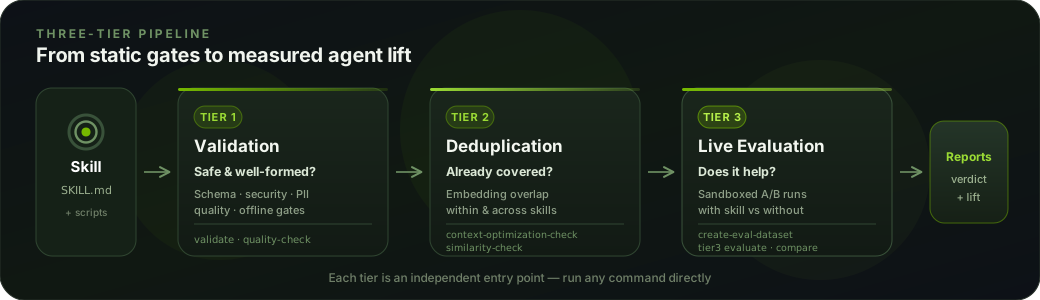
SkillEvaluator: framework evaluasi siklus hidup penuh keterampilan Agent open-source dari NVIDIA : NVIDIA meluncurkan framework pengujian SkillEvaluator untuk sistem Agent Skills. Alat ini menyediakan tiga pipeline evaluasi independen: Tier 1 memvalidasi kepatuhan sintaks dan kerentanan keamanan skrip keterampilan; Tier 2 menghilangkan tumpang tindih keterampilan dan redundansi instruksi melalui analisis ruang vektor; Tier 3 secara otomatis menyintesis set evaluasi mini di sandbox Docker ringan untuk uji run A/B, serta mengukur keuntungan nyata satu Skill terhadap tingkat keberhasilan Agent dan konsumsi Token. Ini menyediakan alat ambang standar untuk membangun pustaka keterampilan tepercaya tingkat perusahaan (Sumber: GitHub Trending)
nanoMuse: framework ringan Agent pribadi self-hosted lintas perangkat open-source dari Zhejiang University : Peneliti Zhejiang University merilis open-source sistem Agent pribadi ringan nanoMuse, yang berfokus mengatasi fragmentasi perangkat multi-terminal dan kebocoran privasi. Framework ini mendukung sinkronisasi mulus memori jangka panjang dan konteks tugas antara ponsel, desktop, dan server lokal; menggunakan mekanisme gerbang otorisasi pengguna yang ketat untuk menangani panggilan sistem operasi yang ireversibel; serta sepenuhnya kompatibel dengan OpenAI dan model kecil open-source yang di-deploy lokal. Komunitas menilainya sebagai alternatif privat dengan rasio biaya-manfaat tinggi terhadap asisten komersial cloud Meta, Muse (Sumber: Fred834567)
Row-Bot: framework driver Computer-Use lokal dengan sandbox keamanan sistem yang ketat : Row-Bot menanggapi risiko kehilangan kendali keamanan akibat model bahasa besar yang langsung mengoperasikan sistem desktop dengan membangun lapisan eksekusi perlindungan tingkat rendah. Alat ini mengunci versi driver dan checksum SHA, serta melarang Agent membaca atau mengetikkan karakter ke password manager dan jendela autentikasi dua faktor. Untuk semua operasi yang melibatkan pembayaran, pengiriman pesan, dan penghapusan file, alat ini secara default menerapkan konfirmasi pemblokiran wajib, serta menggunakan pointer konteks untuk menentukan entitas UI nyata agar Agent tidak menimbulkan kerusakan tak sengaja saat bertindak otonom (Sumber: Reddit r/artificial)
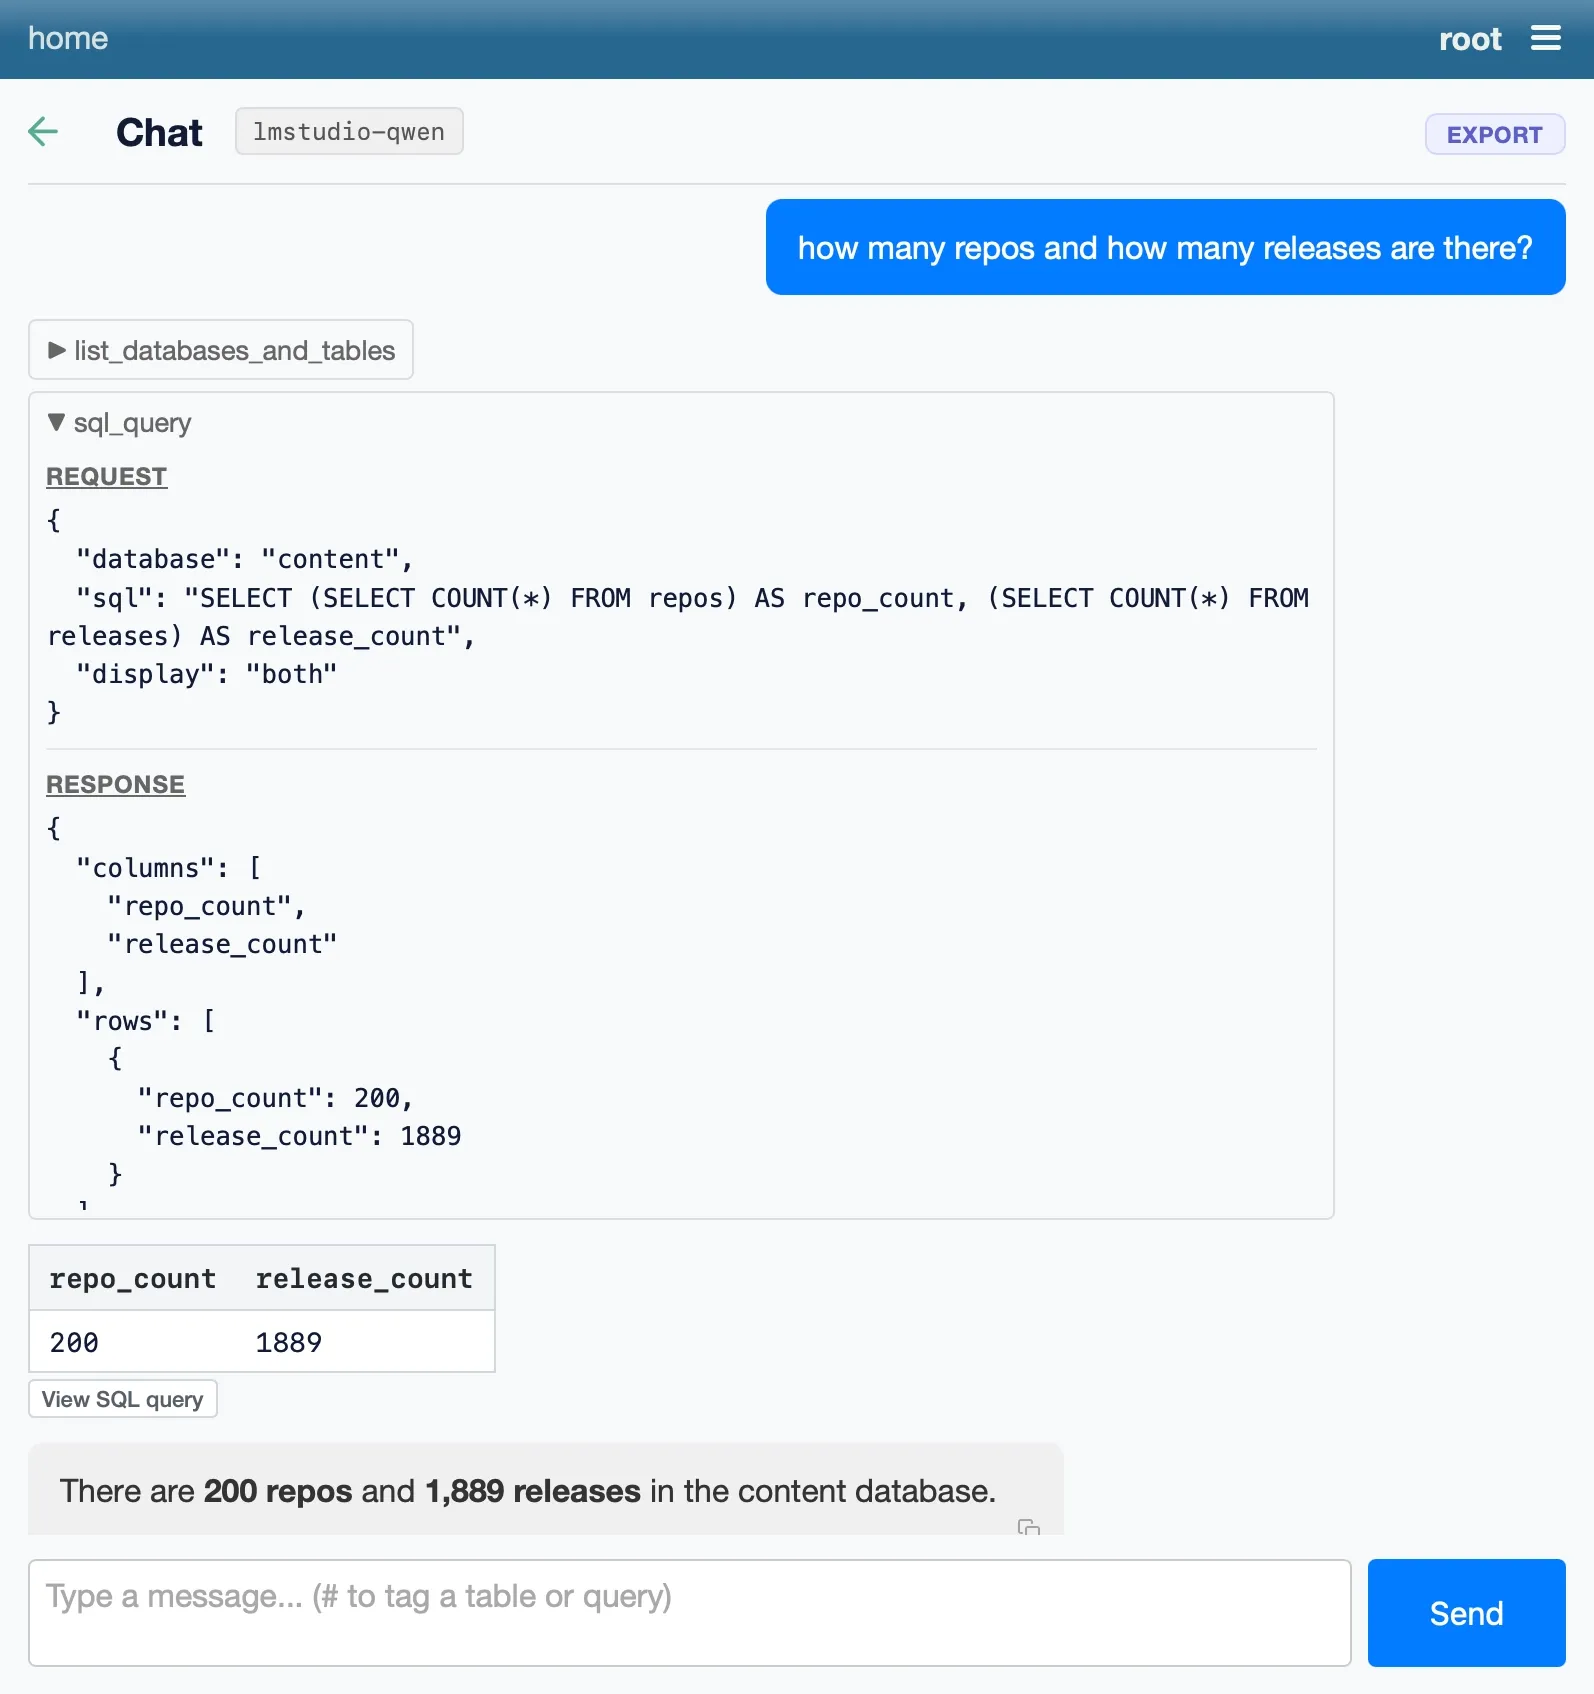
datasette-llm 0.1a11: menghubungkan protokol kompatibel OpenAI dengan loop Agent data lokal : Alat eksplorasi data open-source Datasette merilis pembaruan ekstensi inti datasette-llm 0.1a11 yang sepenuhnya mengimplementasikan protokol API OpenAI standar. Developer tidak memerlukan konfigurasi cloud yang rumit; cukup satu perintah untuk menghubungkan llama.cpp, LM Studio, atau Ollama yang berjalan lokal ke database SQLite privat, sehingga model ringan lokal memiliki kemampuan Agent data lengkap untuk memanggil retrieval skema SQL, analisis grafik, dan tanya jawab statistik multi-turn secara otonom (Sumber: Simon Willison)
📚 Pembelajaran
Makalah luar biasa EMNLP 2026 | NICT Jepang mengusulkan OptiMer: penggabungan vektor distribusi optimal memecahkan masalah continual pre-training : Menanggapi biaya trial-and-error yang sangat tinggi dalam menentukan proporsi campuran data berbagai domain pada continual pre-training model besar, tim NICT Jepang mengusulkan metode OptiMer. Peneliti melatih model secara terpisah pada dataset independen, mengekstrak vektor selisih parameter (vektor distribusi) antara model dan basis, lalu menggunakan optimasi Bayesian di ruang bobot untuk mencari kombinasi berbobot optimal secara otomatis. Solusi ini mencapai percepatan tuning proporsi 15 hingga 35 kali tanpa perlu pelatihan ulang parameter penuh berulang kali, dengan skor benchmark rata-rata meningkat 6,7 poin dibandingkan pelatihan campuran konvensional, membuka paradigma baru untuk inkubasi efisien model multibahasa dan vertikal industri (Sumber: Jiqizhixin)

Institut Otomasi Chinese Academy of Sciences bersama Meituan dan lainnya merilis “Survei Recursive Self-Improvement LLM Agent” : Menanggapi proposisi inti “bagaimana Agent dapat berevolusi sendiri tanpa mengubah bobot”, Institut Otomasi Chinese Academy of Sciences bersama Meituan, Shanghai Jiao Tong University, dan beberapa institusi lain secara sistematis memetakan lanskap frontier RSI. Laporan merangkum empat pilar self-evolution: optimasi Prompt, evolusi Memory, pemeliharaan pustaka Skill, dan modifikasi framework runtime Harness. Laporan juga merangkum siklus hidup closed-loop tujuh langkah, dari pengumpulan error, diagnosis, abstraksi, pembaruan, hingga verifikasi dan integrasi, yang menyediakan cetak biru rekayasa ketat untuk membangun sistem otonom yang mampu secara otomatis mengendapkan pengalaman yang dapat digunakan kembali dari interaksi historis (Sumber: Jiqizhixin)

NeurIPS 2026 | D-DOIT: generasi bersyarat tanpa gradien untuk model difusi biologis berbasis discrete Doob h-transform : Model difusi diskret sulit beradaptasi langsung dengan scorer black-box dalam desain DNA dan protein; fine-tuning tradisional mahal dan mudah merusak naturalitas sekuens. Tsinghua University bersama tim kolaborator mengusulkan algoritma sampling D-DOIT, yang untuk pertama kalinya secara matematis menurunkan transisi status diskret sebagai kernel reweighting multiplikatif dari Doob h-transform, serta memperkirakan nilai masa depan hanya melalui satu forward pass head prediksi. Pada tugas aktivitas enhancer HepG2 dan inverse folding protein, solusi ini mencapai tingkat keberhasilan pemenuhan target bersama 68,1% sepenuhnya tanpa mengubah parameter model dan tanpa bergantung pada gradien, melampaui sejumlah baseline yang memerlukan fine-tuning parameter penuh (Sumber: WeChat)
Artikel mendalam Sebastian Raschka: membedah evolusi positional encoding LLM modern dan tren NoPE : Akademisi AI terkenal Sebastian Raschka merilis survei sistematis positional encoding. Artikel dimulai dari embedding posisi absolut yang dapat dipelajari pada GPT-2, lalu menggunakan geometri intuitif dan kode PyTorch untuk menurunkan bagaimana RoPE melalui rotasi kompleks mengubah koordinat absolut menjadi dot product offset relatif. Artikel juga menggabungkan peta model open-source 2026 untuk menganalisis secara mendalam Partial RoPE, skip bergantian antar-lapisan (seperti lapisan NoPE SmolLM3), dan mekanisme bias relatif Inkling, serta menunjukkan bahwa mengurangi beban memori positional encoding dan meningkatkan kemampuan extrapolation telah menjadi konsensus inti optimasi arsitektur saat ini (Sumber: Ahead of AI)

💼 Bisnis
Li Mu menjadi co-founder dan CTO Aimotion, Boson AI berkolaborasi mendalam dengan skenario industri : Li Mu, akademisi deep learning terkenal dan mantan Senior Principal Scientist AWS, resmi bergabung dengan Aimotion, perusahaan solusi penjualan dan pemasaran AI otomotif, sebagai co-founder dan CTO, sekaligus mempertahankan jabatan CTO di Boson AI. Kerja sama ini bertujuan menyelaraskan teknologi model dasar langsung dengan skenario komersial berat seperti otomotif yang memiliki nilai transaksi tinggi dan siklus keputusan panjang, mengembangkan “world model bisnis” dengan penalaran kausal dan pemahaman aturan bisnis, serta mendorong AI dari sekadar alat tanya jawab menuju Agent tingkat profitabel yang mampu mengeksekusi bisnis penjualan secara closed-loop penuh (Sumber: Jiqizhixin)

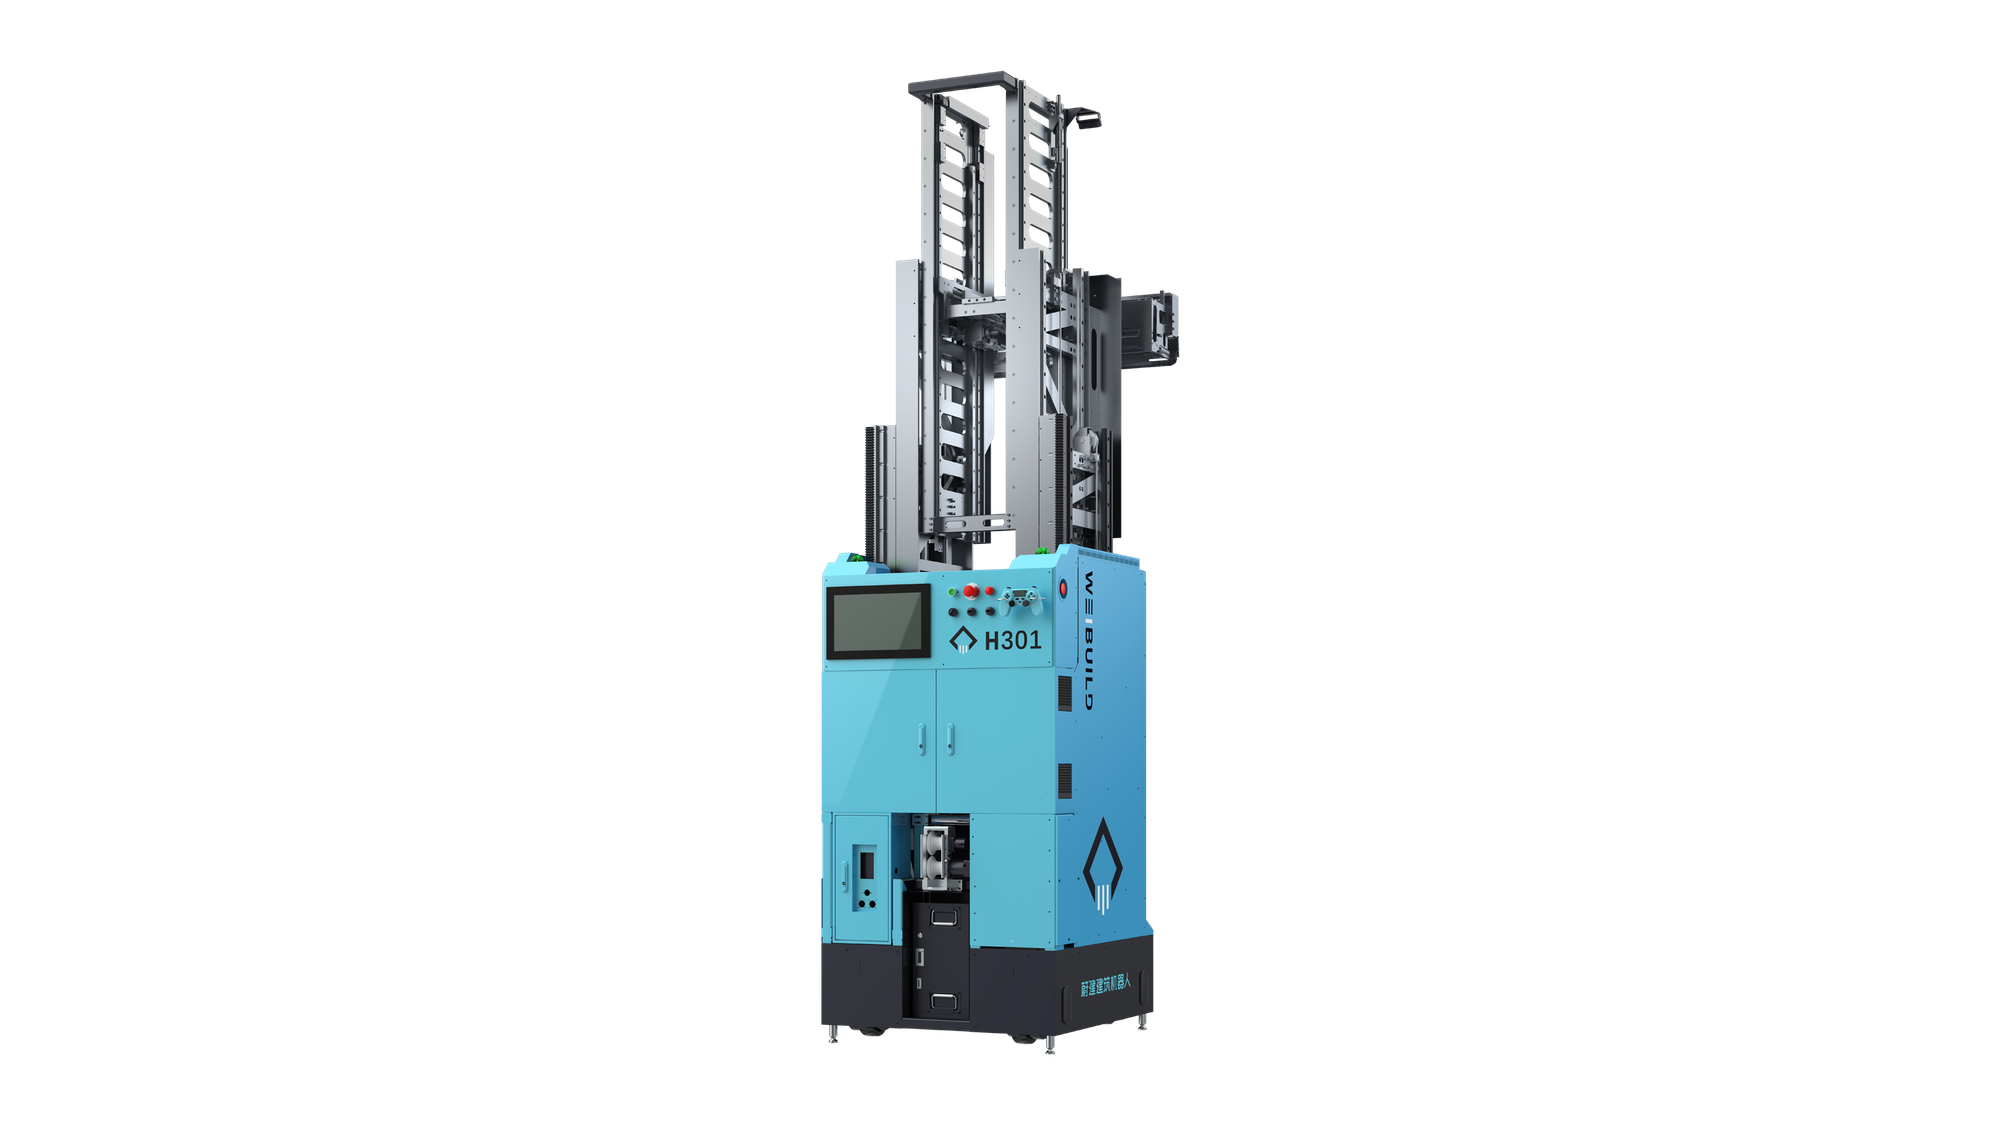
Startup embodied intelligence konstruksi Weijian Technology menyelesaikan pendanaan lebih dari 100 juta yuan, pesanan berlipat dua tiga tahun berturut-turut : Weijian Technology, salah satu dari sedikit perusahaan robot global yang mencapai deployment skala besar di lokasi konstruksi, mengumumkan penyelesaian putaran kelima pendanaan lebih dari 100 juta yuan. Pendiri Liang Yanxue menyatakan bahwa di skenario konstruksi, ambang keterampilan pekerja rendah tetapi biaya tenaga kerja sangat tinggi. Tim melalui “otak kecil Tiangong” (kontrol gerak presisi tinggi) dan “otak besar Tiangong” (semantik embodied lingkungan) yang dikembangkan sendiri mendorong robot plester dan pusat pemrosesan baja tulangan fleksibel otomatis ke pelanggan benchmark dalam dan luar negeri seperti China Construction dan Singapore HDB, dengan penjualan tahunan diperkirakan melewati ambang 100 juta yuan (Sumber: 36Kr)
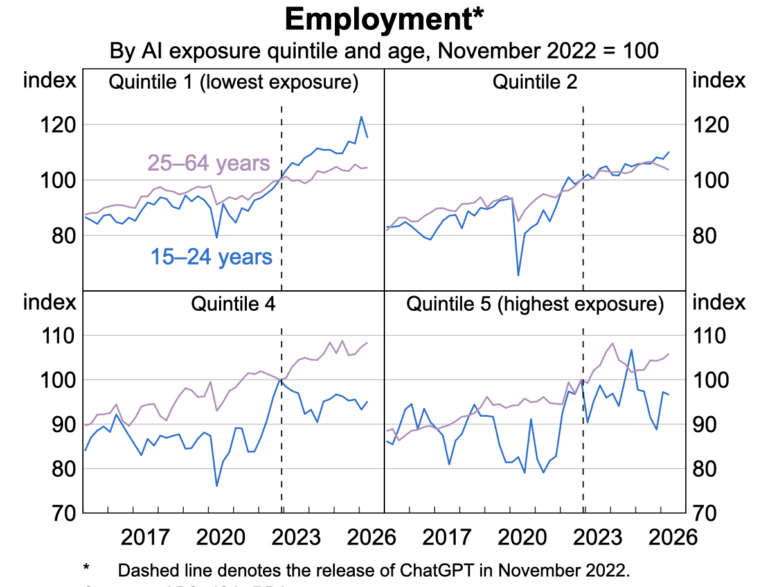
Bank Sentral Australia mengungkap secara empiris: dampak substitusi AI pertama-tama menyasar posisi teknologi junior dan layanan pelanggan : Analisis terbaru Reserve Bank of Australia (RBA) terhadap pasar tenaga kerja menunjukkan bahwa sejak ledakan generative AI, meskipun tingkat pengangguran keseluruhan belum meningkat drastis, di bidang dengan paparan AI tinggi (seperti pengembangan perangkat lunak junior, administrasi dasar, dan layanan pelanggan), permintaan rekrutmen dan tingkat employment kelompok muda 15–24 tahun serta lulusan baru turun drastis, dengan penurunan jauh lebih tinggi daripada karyawan senior. Ini membuktikan semakin parahnya “tragedi commons kognitif”, yaitu hilangnya banyak posisi junior dapat menyebabkan krisis struktural kekosongan ahli senior di masa depan industri (Sumber: THE DECODER)
🌟 Komunitas
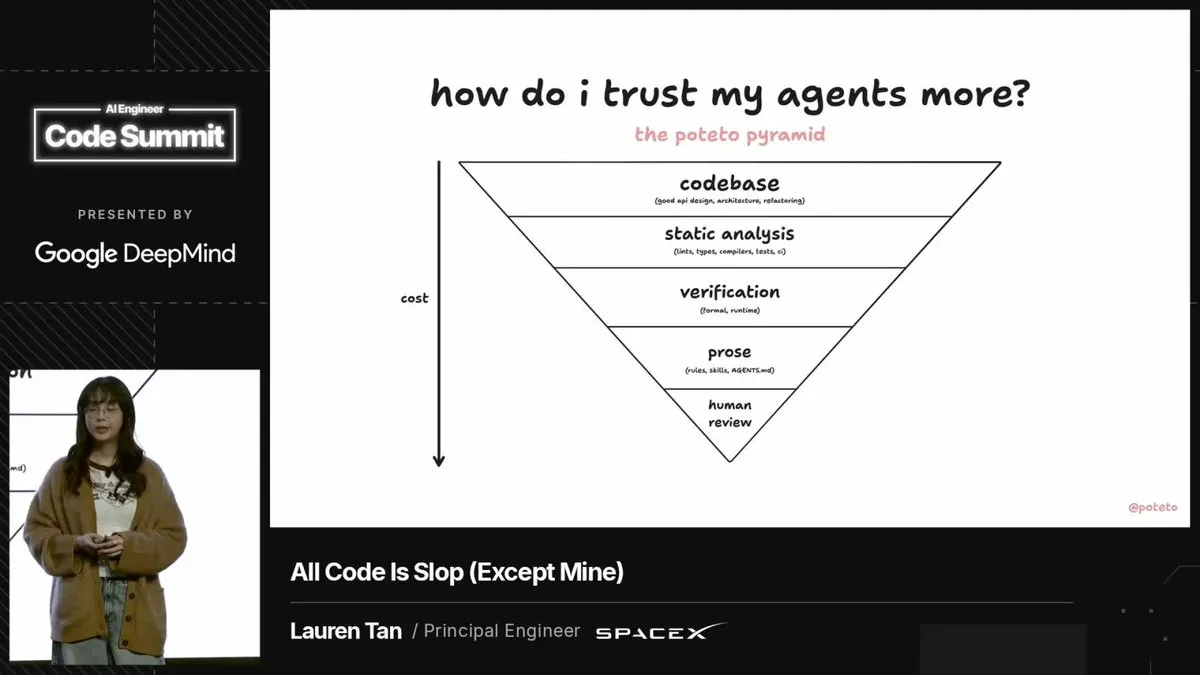
Praktik rekayasa Grok Bot memicu diskusi hangat: gerbang codebase adalah satu-satunya solusi untuk menjinakkan pembengkakan AI : Lauren Tan, yang bertanggung jawab atas pengembangan Grok Bot desktop SpaceX AI, membagikan prinsip rekayasa dalam konferensi AI Engineer dan wawancara YC yang viral di komunitas developer. Ia menyatakan “semua kode yang dihasilkan AI adalah sampah, harus dijaga ketat dengan aturan statis”. Rahasia tim menggabungkan lebih dari 10 ribu PR per bulan dengan tingkat rollback di bawah 0,5% adalah: dilarang menggunakan kalimat bertele-tele di prompt atau agents.md; setiap kali Agent membuat kesalahan, langsung menjadikannya aturan pemblokiran Lint yang ketat; sekaligus menghapus 99% komentar kode untuk mencegah Agent berikutnya meniru jalan pintas. Ia menekankan “menggunakan batasan codebase itu sendiri sebagai memori” jauh lebih efektif daripada menumpuk Token tanpa akhir untuk menjaga performa sistem tinggi (Sumber: dotey)
Data gateway produksi Vercel memicu refleksi: “model keputusan” murah menangani 26% permintaan tetapi hanya menghabiskan 0,5% biaya : Laporan lingkungan produksi AI terbaru Vercel menjadi fokus komunitas. Data menunjukkan model keputusan berukuran kecil untuk klasifikasi, scoring intent, dan routing (seperti seri Jev) menangani lebih dari seperempat permintaan gateway seluruh jaringan, tetapi hanya mengonsumsi 0,53% biaya tagihan. Developer menyerukan agar industri meninggalkan kebiasaan malas “memanggil model generatif triliunan parameter secara membabi buta untuk semua pekerjaan kecil”, dan sepenuhnya mendekopel “keputusan/routing” dari “generasi teks” dalam sistem Agent. Ini tidak hanya dapat mencapai pengurangan biaya end-to-end hingga puluhan kali, tetapi juga secara signifikan mengurangi latensi generasi Token yang tidak perlu (Sumber: Reddit r/ArtificialInteligence)
Dunia akademik terjerumus dalam ghostwriting AI dan involusi peninjauan: 38% makalah ditandai dihasilkan AI, memicu keruntuhan kepercayaan institusional : Pemindaian terhadap 13.500 makalah arXiv menunjukkan bahwa pada musim gugur 2026 hingga 38% submisi menunjukkan ciri ghostwriting mesin, hampir dua kali lipat dari tahun lalu. Pada saat yang sama, jumlah submisi konferensi puncak seperti ICLR melewati 40 ribu, sehingga peninjau juga beralih sepenuhnya menggunakan Claude atau GPT untuk meninjau otomatis. Loop absurd “makalah hasil AI dikirim ke AI untuk ditinjau” memicu kecaman keras akademisi. Komunitas sangat khawatir bahwa jika sistem konferensi berirama cepat runtuh total oleh banjir makalah berkualitas rendah hasil AI, dunia akademik dapat mundur ke era jurnal tertutup “sistem murid” dengan ambang ketat dan bergantung pada reputasi pembimbing (Sumber: Reddit r/ArtificialInteligence)
Investigasi kelumpuhan lalu lintas udara nasional AS berbalik: pemotongan fiber memicu badai jaringan, sepenuhnya membersihkan nama sistem AI : Menanggapi kecelakaan fatal yang sebelumnya memicu kelumpuhan penerbangan nasional AS dan membuat publik luas meragukan sistem penjadwalan AI baru, hasil investigasi terbaru FAA menunjukkan bahwa akar masalah sepenuhnya adalah router tua di situs terpencil yang salah konfigurasi saat migrasi kabel tembaga ke fiber, mengirim permintaan koneksi ke backbone 1.000 kali setiap 4 detik dan memicu longsor jaringan. Investigasi sepenuhnya menyingkirkan kemungkinan gangguan sistem kontrol lalu lintas udara SMART AI atau serangan siber. Komunitas menyesalkan bahwa dalam menghadapi sistem rapuh modern yang terlalu dioptimalkan, orang selalu cenderung mendewakan atau mendemonisasi AI, tetapi mengabaikan bahwa infrastruktur nyata sering mati karena celah tepi paling dasar (Sumber: madiator)
Dilema PhD di tengah lonjakan kemampuan model dasar: LLM menelan inovasi algoritmik, akademisi muda menjadi “pekerja leaderboard” : Seiring model bahasa umum langsung mengambil alih tugas kompleks tradisional, diskusi tentang nilai penelitian memicu resonansi kuat. Banyak mahasiswa PhD mengeluh bahwa “micro-innovation” berupa tuning manual dan mengganti dataset tidak lagi memiliki hambatan di hadapan AI; banyak penelitian akademik merosot menjadi membersihkan data untuk model dasar atau membangun Benchmark baru; namun leaderboard dalam siklus sangat singkat kembali dibanjiri model generasi berikutnya. Peneliti menunjukkan bahwa dalam menghadapi pembentukan ulang dunia akademik oleh model besar, yang benar-benar bernilai jangka panjang adalah keluar dari metrik kesombongan dan menyelesaikan masalah nyata dengan closed-loop fisik serta masalah yang belum didigitalkan (Sumber: Fred834567)
💡 Lainnya
Peringkat pertama ujian nasional akuntan pajak Korea mengaku curang dengan AI, perangkat mini menembus pengawasan ketat dan memicu kepanikan keamanan soal ujian : Peserta yang meraih peringkat pertama dengan skor hampir sempurna dalam ujian kualifikasi akuntan pajak nasional Korea tahun ini merekam video permintaan maaf publik dan menyerahkan diri ke polisi, mengakui menggunakan kamera mikro tersembunyi di ruang ujian untuk memotret soal dan mengirimkannya ke model bahasa besar, serta menerima jawaban melalui ponsel tersembunyi untuk menyelesaikan dua putaran ujian. Karena ujian masuk universitas (Suneung) yang menentukan mobilitas sosial segera digelar, insiden kecurangan ini memicu kegemparan nasional; kantor presiden dan kabinet mengadakan rapat darurat, serta meningkatkan secara menyeluruh deteksi radio di ruang ujian dan metode anti-kecurangan AI (Sumber: The Guardian)

Pengadilan menolak mosi pembatalan raksasa penyimpanan, kasus dugaan kolusi produsen DRAM memanfaatkan ledakan AI untuk menaikkan harga terus berlanjut : Gugatan antitrust terhadap Samsung, SK Hynix, dan Micron atas dugaan persekongkolan menaikkan harga memori mencapai titik penting; Pengadilan Distrik Federal California AS menolak mosi pembatalan dari tergugat, dan kasus resmi masuk ke persidangan substantif. Diskusi komunitas dan dokumen gugatan menunjukkan bahwa ketiga produsen menciptakan kelangkaan pasokan dengan dalih memenuhi kebutuhan pusat data AI; harga spot memori naik hingga 300%–600% per tahun, dengan margin laba operasi secara langka melewati 80%. Gugatan ini diharapkan memaksa rantai pasok menyerahkan kontrak komputasi off-balance-sheet dan bukti dasar pembatasan produksi buatan (Sumber: Hacker News)
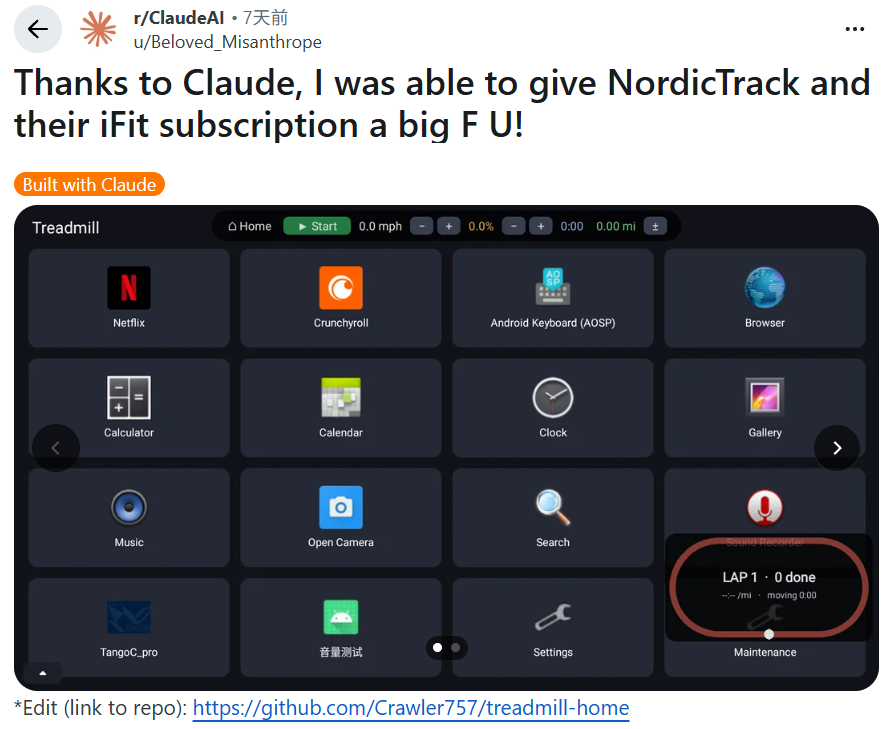
Geek luar negeri menggunakan Claude untuk membalik rekayasa firmware treadmill: tembakan pertama melawan “langganan bersarang” perangkat keras : Seorang pengguna luar negeri membeli treadmill NordicTrack kelas atas yang mewajibkan langganan anggota vendor $39 per bulan agar dapat menonton video Netflix yang sudah dibayar, dan saat menyala penuh iklan panjang. Ia menggunakan Claude Code dan Java untuk menganalisis firmware dasar Android dan berhasil memanggil antarmuka lokal motor, menghapus semua komponen penguncian dan iklan. Proyek reverse engineering open-source ini mendapat dukungan tinggi di Reddit, mencerminkan kejengkelan umum konsumen terhadap “pemerasan langganan” yang dilakukan vendor perangkat lunak dan perangkat keras dengan berbagai dalih (Sumber: 36Kr)