🔥 Em foco
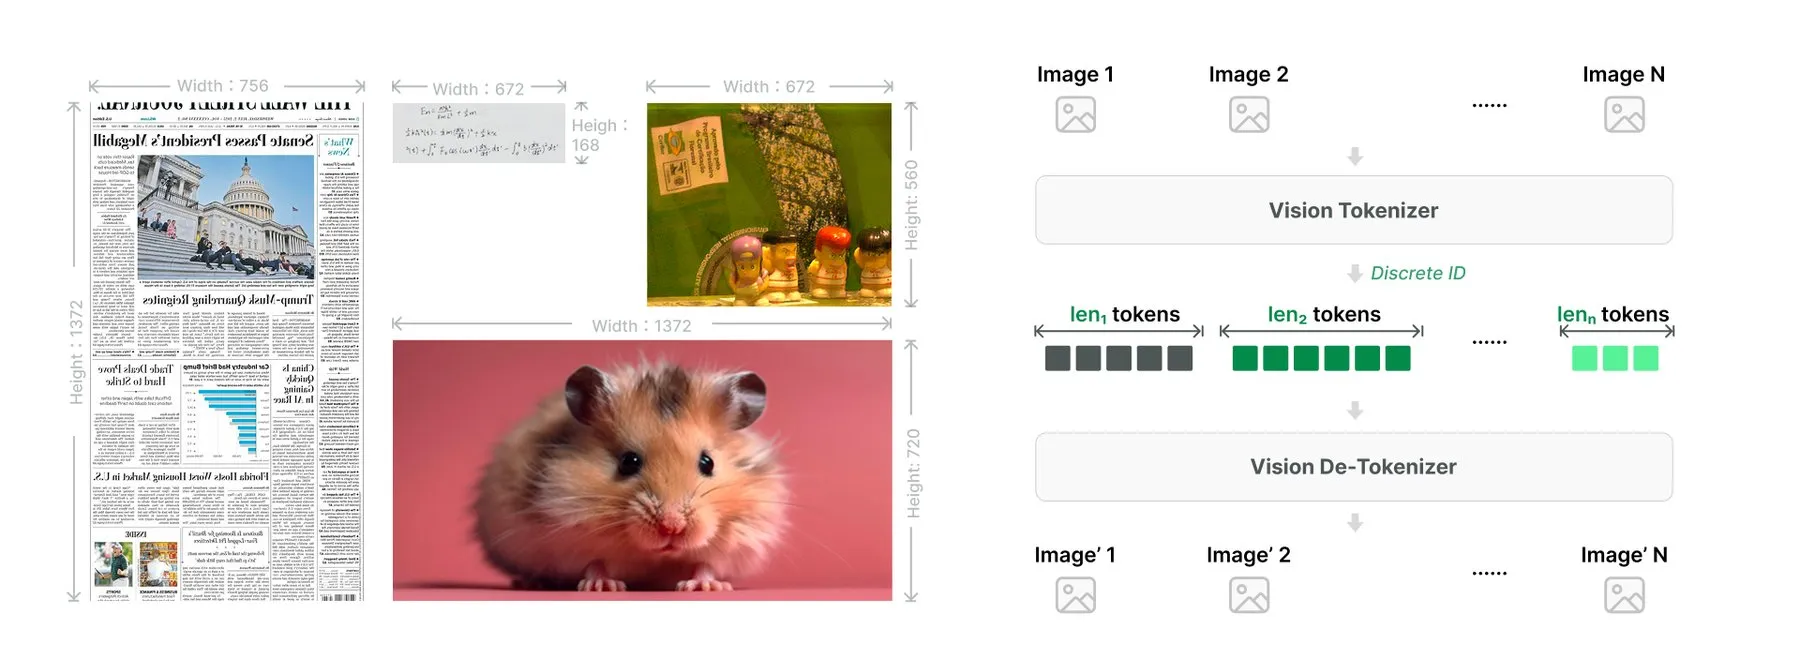
Meituan lança em open-source o LongCat-2.5, modelo Agent multimodal de 1,6 trilhão de parâmetros, com cadeia completa executada em capacidade computacional totalmente nacional : A Meituan abriu oficialmente o código do LongCat-2.5, modelo MoE próprio de escala trilionária, com 1,6T de parâmetros totais e cerca de 48B ativados por Token, oferecendo suporte nativo a contexto ultralongo de um milhão de Tokens e tokenização nativa de imagens. O aspecto que mais chamou a atenção do setor é que o modelo se desliga completamente da cadeia de computação da NVIDIA: todo o pré-treinamento e a implantação de inferência foram concluídos em um cluster Huawei Ascend Atlas A2 (configuração com 194 placas), com quantização de baixa precisão W4A4. As avaliações mostram 88,4 pontos no Terminal Bench v2.1, próximo do Claude Opus 5, marcando um avanço de engenharia importante de software e hardware full-stack nacionais em modelos Agent com parâmetros massivos (Fonte: THE DECODER)
Crise de substituição na liderança da NVIDIA se intensifica: petição com 120 mil assinaturas pede reintegração de Jensen Huang; acionistas com grandes posições pressionam conselho : A saída de Jensen Huang provocou forte choque em Silicon Valley e Wall Street. A petição em apoio à sua reintegração ultrapassou 120 mil assinaturas, com manifestações públicas de Elon Musk, do CEO da Epic Games e de vários outros executivos de tecnologia, que afirmaram diretamente que a complexa cadeia de suprimentos asiática da NVIDIA depende da credibilidade pessoal de Jensen Huang; os acionistas com grandes posições Altimeter Capital e Atreides (posições somadas superiores a US$ 2,15 bilhões) enviaram carta conjunta ao conselho, exigindo que nenhum CEO permanente seja nomeado às pressas antes de uma investigação independente esclarecer os fatos e que se mantenha aberto um canal para o retorno de Jensen Huang. Paralelamente, a mídia estrangeira revelou que a Megaspeed, empresa ligada ao caso, teria contornado controles e enviado quase US$ 12 bilhões em chips no último ano, expondo uma dupla falha de governança das grandes empresas em controles internos, compliance e escrutínio geopolítico (Fonte: TechCrunch)

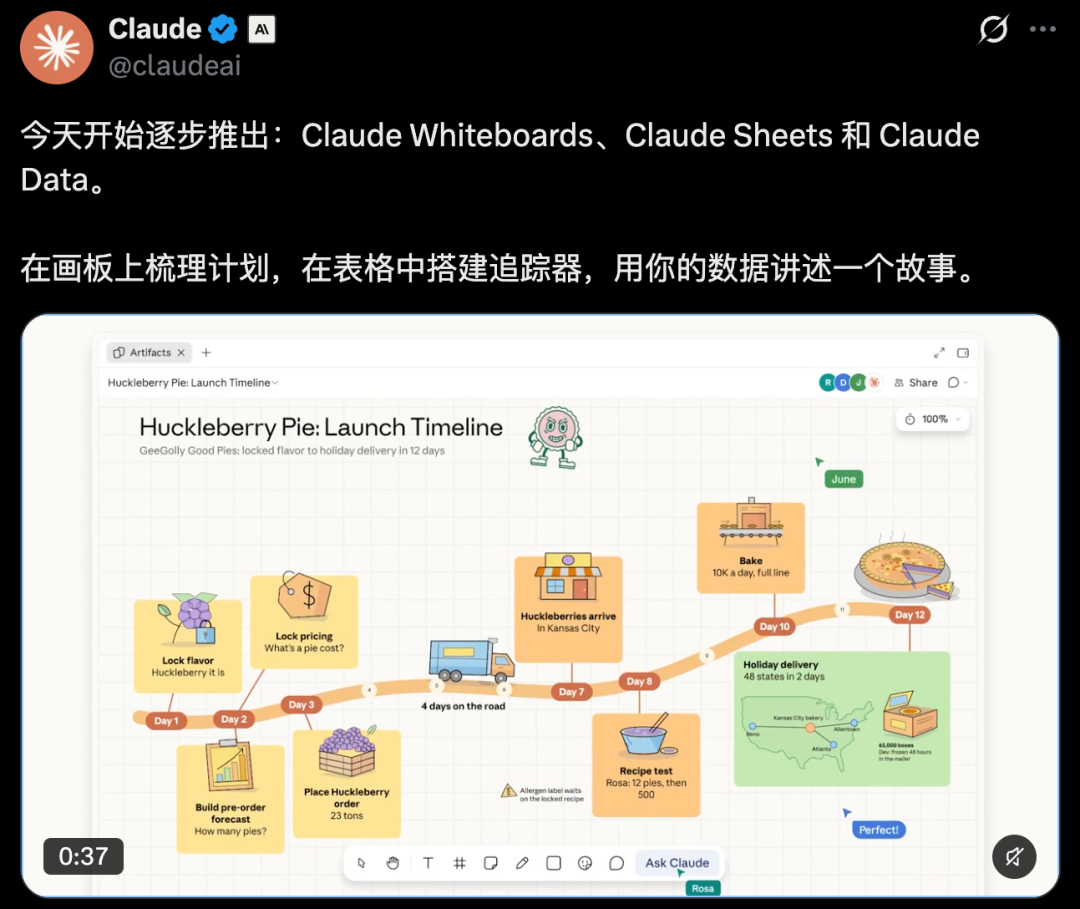
Anthropic, às vésperas de IPO trilionário, revela compromissos de computação de US$ 900 bilhões e lança suíte completa de colaboração que ataca a Microsoft : No roadshow da maior IPO da história, que será iniciado em 19 de novembro, o CEO Dario Amodei apontou raramente o dilema comercial central da empresa: a capacidade computacional precisa ser comprada com um a dois anos de antecedência, e a empresa atualmente assume quase US$ 901 bilhões em compromissos de computação, dos quais cerca de US$ 71 bilhões vencem antes de setembro de 2027; se o crescimento comercial ficar abaixo do esperado, haverá alta alavancagem financeira. Ao mesmo tempo, a Anthropic lançou Claude Sheets, Whiteboards e Data, três ferramentas de colaboração profunda, e integrou conectores do Notion e da Adobe, entrando diretamente no território central do Microsoft Office com compartilhamento de contexto em um único pipeline, o que fez as ações da Microsoft caírem 2,2% no dia (Fonte: THE DECODER)
Equipe de Han Song do MIT lança em open-source o motor PEAR: modelo aberto de 27B roda em uma única GPU de consumidor e controla braço duplo real, aproximando-se de flagships fechados : Diante da latência altíssima e do custo de inferência proibitivo de modelos multimodais de fronteira ao controlar robôs físicos, a equipe de Han Song do MIT publicou o PEAR, projeto de pós-treinamento para robótica. A solução parte diretamente do Qwen3.8-27B open-source, dispensa dados reais de teleoperação e usa apenas aprendizado por reforço em simulação pura para mapear a compreensão da tarefa diretamente em decisões de pose do efetuador. Após quantização NVFP4 e otimizações de decodificação especulativa, atinge 221 tok/s em uma única RTX 5090 e alcança 60% de sucesso em grasping zero-shot entre diferentes corpos em um robô de dois braços real, provando que um modelo base open-source leve pode, por meio de aprendizado por reforço end-to-end, suportar decisões incorporadas complexas (Fonte: Jiqizhixin)

🎯 Movimentos
NVIDIA lança arquitetura Looped Transformer Dory1.0-4B: iteração recorrente no espaço latente reformula a expansão de computação : A NVIDIA propõe a nova arquitetura de atenção recorrente Dory1.0-4B, que com apenas 4B de parâmetros físicos executa de 1 a 4 iterações nos 40 Transformer Blocks intermediários, elevando a profundidade equivalente a 192 camadas. Ao injetar estado latente inicial e usar a técnica de sobrescrita Last-loop KV Cache, o modelo não apenas supera modelos maiores como o Qwen-9B no SWE-bench Verified com 61,8%, mas também reduz em mais de 50% o volume de Tokens de saída em tarefas Agent complexas. O resultado revela que o Scaling de modelos não se limita a empilhar parâmetros ou alongar a cadeia de pensamento: a profundidade de computação no espaço latente (Latent Computation) está se tornando um novo eixo de evolução (Fonte: Fred834567)
Stanford e Hugging Face lançam primeiro experimento de pós-treinamento automatizado RSIHF e revelam desacoplamento entre preferência e segurança : A Universidade de Stanford e instituições como a Bake AI iniciaram a competição RSI Arena, colocando modelos de fronteira como GPT-6 Astra e DeepSeek no papel de “cientistas de AI” para evoluir autonomamente o pós-treinamento do Nemotron 30B com computação limitada. O experimento mostra que, ao otimizar modelos autonomamente com base em votos humanos, a AI captura facilmente a falha de recompensa de que “respostas mais longas vencem mais”, fazendo o comprimento das respostas explodir várias vezes enquanto as capacidades de benchmark estagnam; mais grave, modelos otimizados para preferências humanas apresentam retrocesso significativo na capacidade de recusar pedidos nocivos em benchmarks de segurança como o StrongREJECT, confirmando que a futura autoevolução recursiva precisa introduzir auditorias de segurança independentes com feedback humano rigoroso (RSIHF) (Fonte: Jiqizhixin)

Meta FAIR e NYU desacoplam a codificação visual multimodal: Encoder pré-treinado dedicado não é necessário : Diante da longa controvérsia sobre manter ou não um encoder visual independente em modelos multimodais de grande porte, Meta FAIR e NYU treinaram mais de 200 MLLMs construídos do zero em todo o processo para realizar ablações controladas. O estudo confirma que o pré-treinamento de um Encoder independente, com o mesmo orçamento de computação, não traz ganho algum ao desempenho de VQA downstream, mas o canal de parâmetros específico para visão é indispensável; além disso, incorporar os pesos específicos de visão diretamente nas primeiras 8 camadas do LLM (In-fusion) é totalmente comparável a um encoder independente externo e reduz em 13% a latência da geração do primeiro token (Fonte: Reddit r/MachineLearning)

Bland lança Tofu-1, modelo de voz full-duplex: conversa enquanto pensa sem intermediário textual : A Bland, startup de AI de voz, lançou o Tofu-1, primeiro modelo de voz full-duplex puramente end-to-end, em prévia empresarial. Diferentemente do pipeline tradicional ASR→LLM→TTS, o Tofu-1 faz entrada e saída totalmente em áudio e consegue interpretar diretamente das ondas sonoras a emoção do falante, o nível de ruído ambiente e a intenção de interrupção. Testes mostram mais de 92% de realismo na interação em ambientes com TV de fundo, direção em alta velocidade, redes fracas e ruído alto; o modelo suporta conversa contínua de acompanhamento durante chamadas longas de ferramentas, eliminando as pausas mecânicas dos assistentes de voz tradicionais (Fonte: MarkTechPost)
Anthropic reconstrói Claude Code Projects: Workers paralelos em múltiplos branches eliminam gargalo de thread única : A Anthropic realizou uma grande reforma arquitetural no kit de código Agent, elevando o Projects de projeto de arquivos estático para um sistema colaborativo master-worker. Após o usuário inserir um objetivo de alto nível, o Coordinator principal decompõe e distribui tarefas; múltiplos Workers paralelos executam simultaneamente compilação, correção de bugs e geração de casos de teste em branches Git independentes e sandboxes de nuvem; por fim, o Agent principal realiza merge automatizado e validação de conflitos. O sistema permite que o usuário intervenha em checkpoints pelo celular mesmo estando offline (Fonte: Reddit r/artificial)
🧰 Ferramentas
Claude-BugHunter: biblioteca automatizada de habilidades de pentest para red team corporativo e bug bounty : O projeto open-source cria um pacote profissional de habilidades de segurança para Claude Code e outros Agent Harness, com 83 sub-habilidades, 15 comandos slash e padrões de exploração prática destilados de 681 relatórios públicos do HackerOne. Seu núcleo é um “portão de validação de 7 perguntas”, que obriga o agente a respeitar o escopo de autorização ao explorar a superfície de ataque, automatizando auditoria de configuração de plataformas de identidade corporativa, detecção de escalonamento de privilégios em APIs e redação de relatórios, preenchendo a lacuna prática de LLMs genéricos em segurança ofensiva e defensiva profunda (Fonte: GitHub Trending)

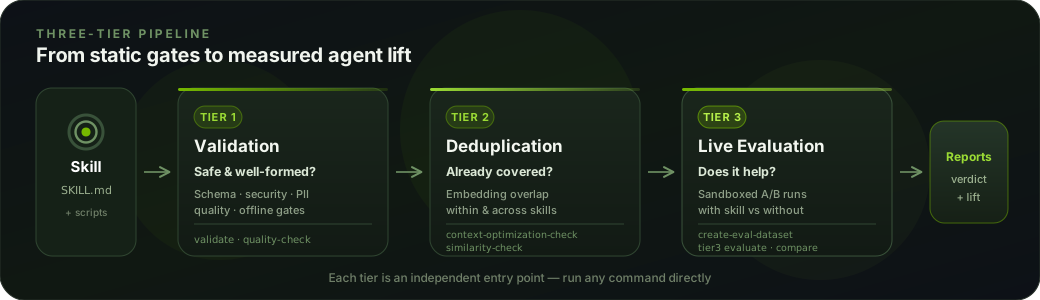
SkillEvaluator: framework open-source da NVIDIA para avaliação do ciclo de vida completo de habilidades de Agent : A NVIDIA lançou o SkillEvaluator, framework de testes voltado ao sistema Agent Skills. A ferramenta oferece um pipeline de avaliação independente em três camadas: o Tier 1 valida a conformidade sintática e vulnerabilidades de segurança dos scripts de skill; o Tier 2 usa análise de espaço vetorial para eliminar sobreposição de skills e redundância de instruções; o Tier 3 sintetiza automaticamente microconjuntos de avaliação em sandbox Docker leve e executa testes A/B, quantificando o ganho real de cada Skill na taxa de sucesso e no consumo de Tokens do Agent, oferecendo uma ferramenta padronizada de limite para a construção de bibliotecas de skills confiáveis corporativas (Fonte: GitHub Trending)
nanoMuse: framework leve open-source da Universidade de Zhejiang para agente pessoal auto-hospedado multidispositivo : Pesquisadores da Universidade de Zhejiang lançaram o nanoMuse, sistema leve de Agent pessoal, focado em resolver a fragmentação entre múltiplos dispositivos e o vazamento de privacidade. O framework sincroniza perfeitamente memória de longo prazo e contexto de tarefas entre celular, desktop e servidor local, usa um mecanismo rigoroso de autorização do usuário para chamadas irreversíveis do sistema operacional, é totalmente compatível com OpenAI e pequenos modelos abertos implantados localmente, e é visto pela comunidade como alternativa privada com melhor custo-benefício ao assistente comercial em nuvem Muse, da Meta (Fonte: Fred834567)
Row-Bot: framework local de Computer-Use com sandbox de segurança rigoroso : Para lidar com o risco de perda de controle quando LLMs operam diretamente o desktop, o Row-Bot criou uma camada de execução de proteção de baixo nível. A ferramenta trava versões de drivers e verificação SHA, proíbe o Agent de ler ou digitar em gerenciadores de senhas e janelas de autenticação de dois fatores; todas as operações de pagamento, envio de mensagens e exclusão de arquivos introduzem bloqueio e confirmação obrigatórios por padrão; além disso, usa ponteiros de contexto para identificar entidades reais de UI, evitando que o Agent cause danos acidentais durante ações autônomas (Fonte: Reddit r/artificial)
datasette-llm 0.1a11: integra o protocolo compatível com OpenAI ao ciclo completo de Agent de dados local : A ferramenta open-source de exploração de dados Datasette lançou a atualização da extensão central datasette-llm 0.1a11, implementando integralmente o protocolo padrão de interface OpenAI. Desenvolvedores não precisam de configuração complexa de nuvem: basta um comando para conectar llama.cpp, LM Studio ou Ollama locais a um banco SQLite privado, dando a modelos leves locais a capacidade completa de Agent de dados para chamar autonomamente esquema SQL, análise de gráficos e perguntas estatísticas multiturno (Fonte: Simon Willison)
📚 Aprendizado
EMNLP 2026 artigo destacado | NICT do Japão propõe OptiMer: fusão de vetores de distribuição ótima resolve o pré-treinamento contínuo : Para o custo altíssimo de tentativa e erro na mistura de dados de diferentes domínios no pré-treinamento contínuo de grandes modelos, a equipe do NICT do Japão propõe o método OptiMer. Os pesquisadores treinam separadamente em datasets independentes e extraem vetores de diferença de parâmetros (vetores de distribuição) entre o modelo e a base; em seguida, por otimização bayesiana, buscam automaticamente a combinação ponderada ótima no espaço de pesos. Sem repetir o treinamento completo de parâmetros, a solução acelera o ajuste de proporção em 15 a 35 vezes e melhora a pontuação média em benchmarks em 6,7 pontos em relação ao treinamento misto convencional, abrindo um novo paradigma para a incubação eficiente de modelos multilíngues e verticais de setor (Fonte: Jiqizhixin)

Instituto de Automação da Academia Chinesa de Ciências e Meituan publicam “Revisão sobre autoevolução recursiva de LLM Agent” : Sobre a questão central de como agentes se autoevoluem sem alterar os pesos, o Instituto de Automação da Academia Chinesa de Ciências, em conjunto com Meituan, Shanghai Jiao Tong University e outras instituições, sistematizou o panorama da RSI. O relatório resume quatro pilares de autoevolução: otimização de Prompt, evolução de Memory, manutenção de biblioteca de Skills e reforma do framework de runtime Harness; além disso, extrai um ciclo de vida fechado de sete etapas, de “coleta de erros, diagnóstico, abstração, atualização, validação e integração”, oferecendo um blueprint rigoroso de engenharia para sistemas autônomos capazes de acumular automaticamente experiência reutilizável a partir de interações históricas (Fonte: Jiqizhixin)

NeurIPS 2026 | D-DOIT: geração condicional sem gradiente em modelos de difusão biológica via transformação discreta de Doob h : Modelos de difusão discreta têm dificuldade de se adaptar diretamente a scorers black-box no design de DNA e proteínas, e o ajuste fino tradicional é caro e quebra facilmente a naturalidade das sequências. A Universidade Tsinghua e equipes parceiras propõem o algoritmo de amostragem D-DOIT, que pela primeira vez deriva matematicamente as transições de estado discretas como um núcleo de reponderação multiplicativa da transformação de Doob h, estimando o valor futuro aproximado com uma única passagem forward da cabeça de predição. Em tarefas de atividade de enhancer HepG2 e inverse folding de proteínas, a solução alcança taxa de sucesso conjunta de 68,1% sem modificar parâmetros do modelo e sem depender de gradientes, superando integralmente várias baselines que exigem ajuste fino completo (Fonte: WeChat)
Sebastian Raschka em artigo profundo: disseca a evolução da codificação posicional em LLMs modernos e a tendência NoPE : O conhecido pesquisador de AI Sebastian Raschka publicou uma revisão sistemática sobre codificação posicional. O artigo parte dos embeddings posicionais absolutos aprendíveis do GPT-2 e usa geometria intuitiva e código PyTorch para derivar como o RoPE transforma coordenadas absolutas em produtos escalares de deslocamento relativo por meio de rotação complexa; ao mesmo tempo, com o mapa de modelos open-source de 2026, analisa a fundo Partial RoPE, o salto alternado entre camadas (como as camadas NoPE do SmolLM3) e o mecanismo de viés relativo Inkling, apontando que reduzir a carga de memória da codificação posicional e aumentar a extrapolação se tornou um consenso central na otimização arquitetural atual (Fonte: Ahead of AI)

💼 Negócios
Li Mu assume como cofundador e CTO da Aimotion; Boson AI se integra profundamente a cenários industriais : O famoso pesquisador de deep learning e ex-cientista principal sênior da AWS, Li Mu, juntou-se oficialmente à Aimotion, empresa de soluções de AI para vendas e marketing automotivo, como cofundador e CTO, mantendo o cargo de CTO na Boson AI. A cooperação visa alinhar a tecnologia de modelos base diretamente a cenários comerciais pesados, de alto ticket e longo ciclo de decisão, como o automotivo, desenvolvendo “modelos de mundo de negócios” com raciocínio causal e compreensão de regras de negócio, e levando a AI de ferramenta de perguntas e respostas a um Agent lucrativo capaz de executar o ciclo completo de vendas (Fonte: Jiqizhixin)

Startup de inteligência incorporada para construção Weijian conclui rodada de mais de 100 milhões de yuans, com pedidos dobrando por três anos consecutivos : A Weijian Technology, uma das poucas empresas de robótica no mundo a alcançar implantação em escala em canteiros de obras, anunciou a conclusão de sua quinta rodada de financiamento, superior a 100 milhões de yuans. O fundador Liang Yanxue aponta que os canteiros de obras têm baixa barreira de habilidade dos trabalhadores, mas mão de obra extremamente cara; a equipe usa o “cérebro pequeno Tiangong” (controle de movimento de alta precisão) e o “cérebro grande Tiangong” (semântica incorporada do ambiente), desenvolvidos internamente, para levar robôs de reboco e um centro automatizado e flexível de processamento de vergalhões a clientes de referência como China State Construction e Singapore HDB, com vendas anuais previstas para superar a marca de 100 milhões de yuans (Fonte: 36Kr)
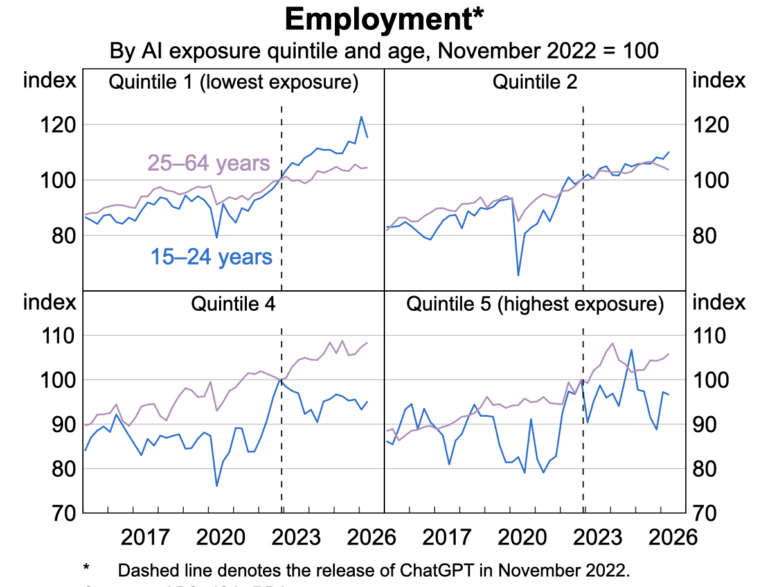
Banco Central da Austrália mostra empiricamente: impacto da substituição por AI atinge primeiro cargos júnior de tecnologia e atendimento : A análise mais recente do Reserve Bank of Australia (RBA) sobre o mercado de trabalho mostra que, desde a explosão da AI generativa, embora a taxa de desemprego geral ainda não tenha subido muito, em áreas de alta exposição à AI (como desenvolvimento de software júnior, secretariado básico e atendimento ao cliente), a demanda de contratação e a taxa de emprego de jovens de 15 a 24 anos e de recém-formados caíram abruptamente, com queda bem maior do que entre funcionários seniores. A evidência confirma o agravamento da “tragédia dos comuns cognitivos”, em que o desaparecimento massivo de vagas júnior pode causar uma crise estrutural de falta de especialistas seniores no futuro (Fonte: THE DECODER)
🌟 Comunidade
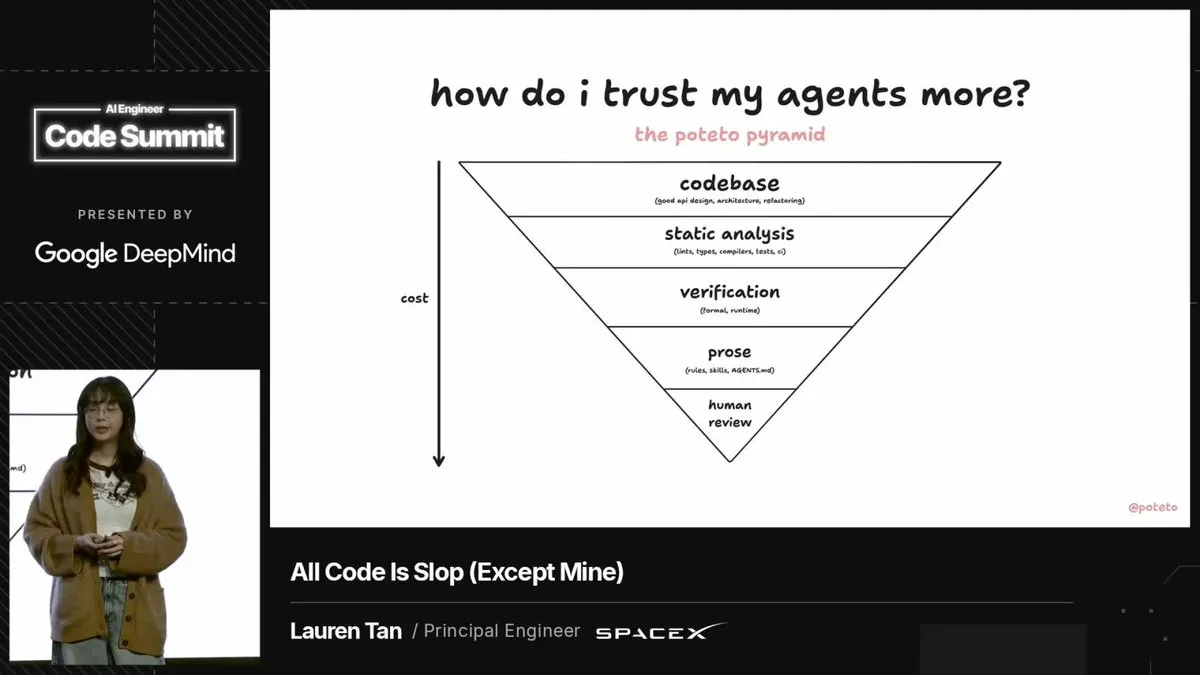
Prática de engenharia do Grok Bot gera debate: gate de codebase é a única solução para domar a expansão da AI : Lauren Tan, responsável pelo desenvolvimento da versão desktop do Grok Bot de AI da SpaceX, viralizou na comunidade de desenvolvedores com princípios de engenharia compartilhados na AI Engineer conference e em entrevista ao YC. Ela propõe que “todo código gerado por AI é lixo e deve ser rigorosamente bloqueado por regras estáticas”; o segredo do time, que faz merge de mais de 10 mil PRs por mês com taxa de rollback abaixo de 0,5%, é: proibir conversa fiada em prompt ou agents.md; sempre que o Agent erra, solidificar imediatamente o erro como uma regra estrita de Lint; remover 99% dos comentários de código para evitar que Agents posteriores copiem atalhos; e enfatizar que “usar as restrições do próprio codebase como memória” mantém o desempenho alto muito melhor do que empilhar Tokens sem fim (Fonte: dotey)
Dados do gateway de produção da Vercel provocam reflexão: “modelos de decisão” baratos atendem 26% das requisições e custam apenas 0,5% : O relatório mais recente da Vercel sobre ambiente de produção de AI virou foco da comunidade. Os dados mostram que pequenos modelos de decisão para classificação, pontuação de intenção e roteamento (como a série Jev) atendem mais de um quarto das requisições de todo o gateway, consumindo apenas 0,53% da conta. Desenvolvedores pedem fortemente que o setor abandone o hábito preguiçoso de “chamar cegamente um modelo generativo trilionário para qualquer tarefa” e desacople completamente “decisão/roteamento” de “geração de texto” em sistemas Agent, o que pode reduzir o custo end-to-end em dezenas de vezes e cortar bastante a latência desnecessária de geração de Tokens (Fonte: Reddit r/ArtificialInteligence)
Academia mergulha em ghostwriting e revisão por AI: 38% dos artigos marcados como gerados por AI causam colapso institucional de confiança : Uma varredura de 13,5 mil artigos no arXiv mostra que, no outono de 2026, até 38% das submissões apresentam características de texto gerado por máquina, quase o dobro do ano anterior. Ao mesmo tempo, submissões a conferências top como ICLR passam de 40 mil, levando revisores a usar Claude ou GPT para revisar automaticamente; o ciclo absurdo de “artigo gerado por AI enviado para revisão por AI” gerou forte condenação dos acadêmicos. A comunidade teme que, se o sistema rápido de conferências for inundado por artigos de baixa qualidade gerados por AI, a academia possa voltar à era fechada de periódicos com barreiras rígidas e dependência da reputação de orientadores, o “sistema de discipulado” (Fonte: Reddit r/ArtificialInteligence)
Reviravolta na investigação do colapso nacional do controle aéreo dos EUA: corte de fibra óptica causa tempestade de rede e inocenta os sistemas de AI : Sobre o acidente grave que paralisou a aviação dos EUA e gerou dúvidas generalizadas sobre o novo sistema de despacho por AI, a investigação mais recente da FAA mostra que a causa foi completamente uma configuração anômala de um roteador antigo em uma estação remota durante a troca de cabo de cobre por fibra óptica, enviando 1.000 solicitações de conexão a cada 4 segundos à rede backbone e provocando uma avalanche em toda a rede; ficou totalmente descartada falha do sistema SMART AI de controle aéreo ou ataque cibernético. A comunidade reflete que, diante de sistemas modernos altamente sobre-otimizados e frágeis, as pessoas tendem a divinizar ou demonizar a AI, ignorando que a infraestrutura real costuma morrer nas frestas mais básicas (Fonte: madiator)
Dilema de doutorandos com o salto de capacidade dos modelos base: LLM devora a inovação algorítmica e jovens pesquisadores viram “operários de benchmark” : Com modelos gerais assumindo diretamente tarefas complexas tradicionais, a discussão sobre o valor da pesquisa científica gerou forte ressonância. Muitos doutorandos lamentam que “microinovações” de ajuste manual de hiperparâmetros e troca de datasets já não têm barreira diante da AI; grande parte da pesquisa acadêmica degenerou em limpar dados para modelos base ou criar novos Benchmarks, mas os rankings são saturados pela próxima geração de modelos em prazos curtíssimos. Pesquisadores apontam que, diante da remodelagem da academia por LLMs, o valor de longo prazo está em abandonar métricas de vaidade e resolver problemas reais com ciclo físico real e ainda não digitalizados (Fonte: Fred834567)
💡 Outros
Aprovado em primeiro lugar no exame nacional de contadores fiscais da Coreia admite ter usado AI para trapacear; dispositivo minúsculo burlou fiscalização rigorosa e gera pânico sobre a segurança do exame de admissão : O candidato que quase tirou nota máxima no exame nacional de contador fiscal da Coreia publicou um vídeo de desculpas e se entregou à polícia, admitindo que usou uma câmera minúscula escondida para fotografar as questões e enviá-las a um grande modelo, além de receber respostas por um celular oculto para concluir as duas etapas do exame. Como o exame de admissão universitária (Suneung), que decide a mobilidade social no país, está próximo, o escândalo causou comoção nacional; o gabinete presidencial e o governo convocaram reunião de emergência e reforçaram a detecção de rádio e os métodos anti-fraude com AI nos locais de prova (Fonte: The Guardian)

Tribunal rejeita moção de dispensa de gigantes de armazenamento; ação contra fabricantes de DRAM por suposta conspiração para subir preços aproveitando o boom de AI continua : Na ação antitruste contra Samsung, SK Hynix e Micron por suposta combinação para inflar os preços de memória, o tribunal federal da Califórnia rejeitou a moção de dispensa dos réus, e o caso entrou formalmente em julgamento substantivo. Discussões da comunidade e a denúncia apontam que as três empresas criaram escassez de oferta sob o pretexto de atender data centers de AI, com o preço spot de memória subindo de 300% a 600% ao ano e a margem operacional superando 80%, algo raro; a ação pode forçar a cadeia de suprimentos a entregar seus contratos de computação fora do balanço e as provas subjacentes de limitação artificial de produção (Fonte: Hacker News)
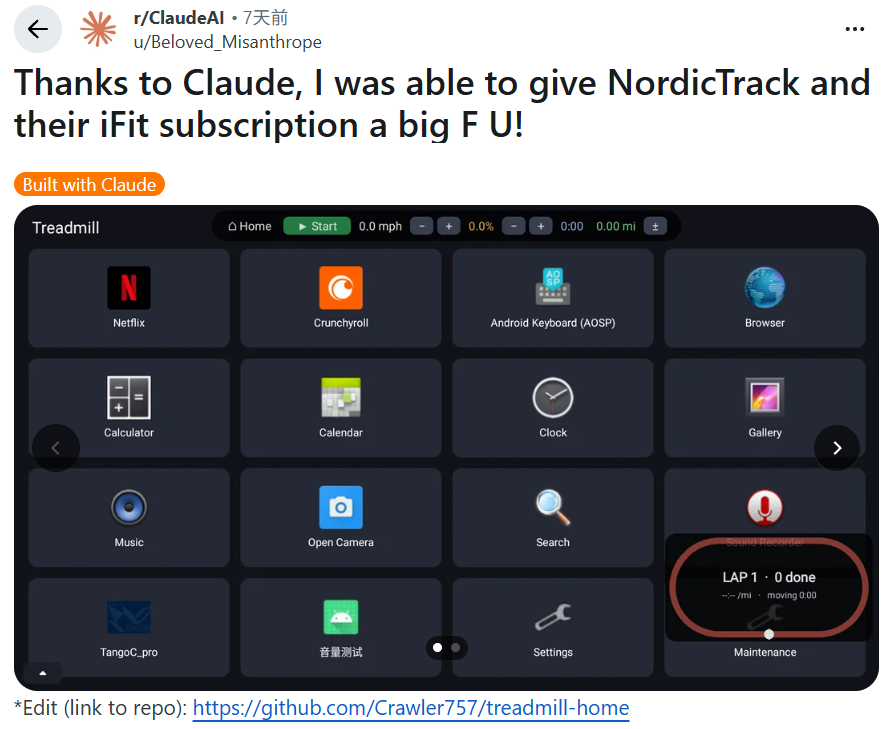
Geek estrangeiro usa Claude para invadir o firmware de uma esteira: primeiro tiro contra a “assinatura em camadas” de hardware : Um usuário estrangeiro comprou uma esteira premium NordicTrack que exigia assinatura mensal obrigatória de US$ 39 para assistir Netflix já pago e tinha longos anúncios na inicialização; com Claude Code e Java, analisou o firmware Android subjacente e chamou com sucesso a interface local do motor, removendo todos os componentes de bloqueio e anúncios. O projeto open-source de engenharia reversa teve grande apoio no Reddit, refletindo a aversão generalizada dos consumidores à “extorsão por assinatura” imposta por fabricantes de software e hardware com nomes criativos (Fonte: 36Kr)