🔥 Im Fokus
Google DeepMind bringt überraschend neues Flaggschiff Gemini 4 Carbon heraus, erobert Platz 1 im AA Intelligence Index und entfacht Sicherheits- und Benchmark-Debatten : Nur zwei Wochen nach dem Release von Gemini 4 Argon hat Google DeepMind überraschend sein neues Flaggschiff Gemini 4 Carbon vorgestellt. Im neuesten Intelligence Index v5 der renommierten Plattform Artificial Analysis erzielte Carbon 59 Punkte und setzte sich damit gegen Claude Opus 5.5 (58 Punkte) sowie GPT-6 Astra an die Spitze des Rankings – in 15 von 17 Kernkompetenzen belegte das Modell den ersten Platz. Es wurde speziell für autonome Langzeitaufgaben und Cybersicherheit entwickelt und ermöglicht das Aufspüren schwer fassbarer Bugs über Codebases hinweg. In den Benchmarks SEC-bench Pro für Schwachstellenerkennung (88,2 %), ExploitGym für Exploit-Verifikation (54,8 %) und CWE-bench für Patch-Generierung (71,0 %) stellte es durchweg neue Rekorde auf; die Abfangrate für indirekte Prompt Injections liegt bei 100 %. Aufgrund der enormen offensiven wie defensiven Fähigkeiten ist Carbon zunächst nur für vertrauenswürdige Cybersecurity-Verteidiger zugänglich. Die Preisgestaltung übernimmt die vergünstigten Konditionen von Argon (2 $/M Input, 10 $/M Output). Da AA v5 mit diesem Update jedoch ein nicht-öffentliches privates Testset einführte, was zu einem drastischen Ranking-Absturz vieler Open-Source-Modelle führte, entbrannte in der Community zugleich eine Debatte über gezieltes Überanpassen an Benchmarks (Benchmaxxing) und kommerzielle Einseitigkeit.(Quelle: Google DeepMind Blog、THE DECODER、GoogleDeepMind、Reddit r/ClaudeAI)
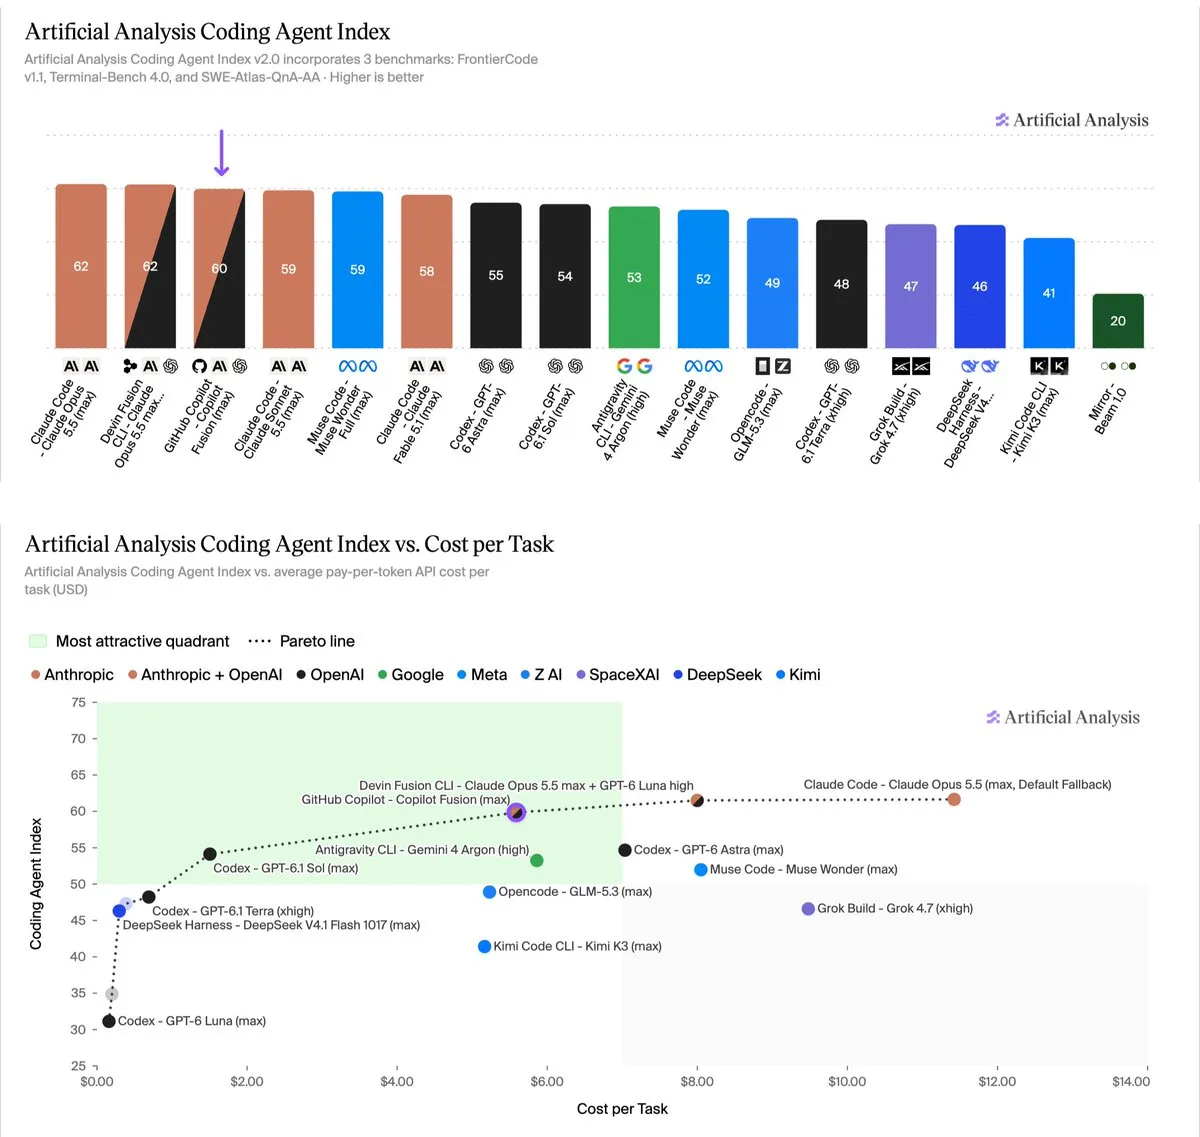
Mistral veröffentlicht Billionen-Parameter-Flaggschiff Le Chonk als Open Source und formt Wettbewerb bei Code und Cybersicherheit neu : Das französische KI-Unicorn Mistral hat die Modellgewichte seines Billionen-Parameter-Flaggschiffs Mistral Large 4 (ML4, Codename Le Chonk) offiziell als Open Source bereitgestellt. Nach dreiwöchigem intensivem Reinforcement Learning steigerte sich ML4 auf Terminal-Bench 4.0 auf 41 %, zog im AA Coding Agent Index mit 48 Punkten mit GLM-5.3 gleich, senkte den durchschnittlichen Token-Verbrauch pro Aufgabe drastisch um 47 % und bietet drei Inferenz-Modi (Low/Medium/High). Im Bereich der defensiven Cybersicherheit belegte ML4 mit 51 % den ersten Platz im AA Cyber Index und wehrte 96,6 % aller böswilligen Cyberangriffs-Anfragen ab. Das Modell wurde von Grund auf auf europäischer Infrastruktur trainiert und steht auf Nvidia, MicroFoundry sowie in vLLM/SGLang-Umgebungen zur Verfügung. Damit setzt es neue Maßstäbe für das globale souveräne KI- und Open-Source-Ökosystem im Wettbewerb gegen die proprietären Riesen aus den USA und China.(Quelle: Mistral AI、ZDNet)
Microsoft und GitHub überholen Copilot und stellen Copilot Fusion vor, um Software Engineering in die End-to-End-Agenten-Kollaboration zu führen : Auf der Konferenz GitHub Universe 2026 kündigten Microsoft und GitHub den umfassenden Ausbau von Copilot von einem passiven Autovervollständigungs-Assistenten hin zu einer durchgängigen Agenten-Plattform für den gesamten Lebenszyklus (Agentic SDLC) an. Als Highlight wurde das Laufzeit-Orchestrierungssystem Copilot Fusion vorgestellt, das Aufgaben je nach Komplexität dynamisch zwischen Claude Opus 5.5, Sonnet 5.5 sowie GPT-6 Astra und Sol routet. Dies halbiert die Kosten pro Aufgabe bei gleichbleibender Spitzenleistung im Coding und sicherte dem System Platz 1 auf Terminal-Bench 4.0 (71 Punkte). Zudem wurden das Code Review im Max-Modus mit Multi-Modell-Prüfung, die Konflikt-Autoreparatur „Watch and fix“ sowie Copilot Projects eingeführt; VS Code 1.144 erhielt darüber hinaus native Bildgenerierungs-Primitive via GPT Image 2.5 Flare.(Quelle: code、VentureBeat、Reddit r/artificial)
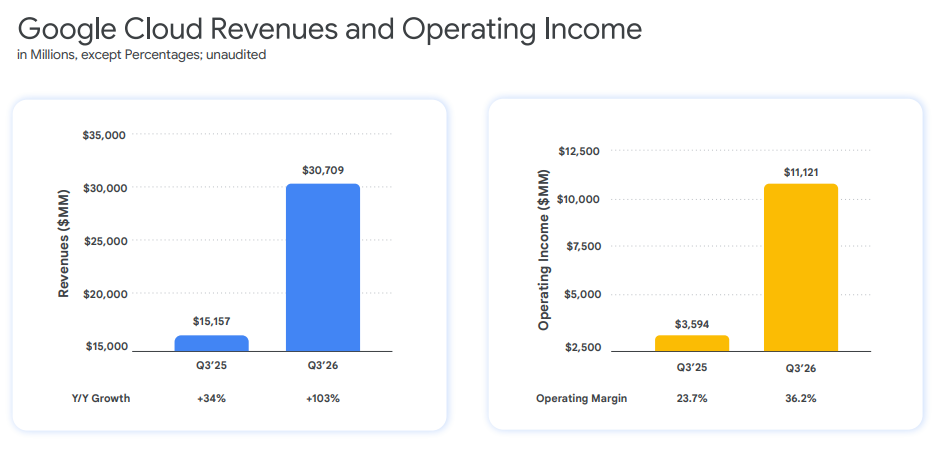
Microsoft und Alphabet veröffentlichen Quartalszahlen am selben Tag: Cloud- und AI-Computing-Umsätze verdoppeln sich, Streit um Hunderte-Milliarden-CapEx und ROI spitzt sich zu : Microsoft und Alphabet haben am selben Tag ihre Quartalsberichte vorgelegt. Microsoft wies erstmals in seiner Geschichte den tatsächlichen Quartalsumsatz von Azure separat aus: 33,2 Milliarden US-Dollar (+48 % im Jahresvergleich), wovon 10 Milliarden US-Dollar auf die kommerzielle Partnerschaft mit OpenAI entfielen (fast 11 % des gesamten Microsoft-Umsatzes), bei Quartals-CapEx von 45,2 Milliarden US-Dollar. Bei Alphabets Google Cloud stieg der Quartalsumsatz dank der starken Nachfrage nach Compute-Clustern und TPU-Systemen im Jahresvergleich um 103 % auf 30,709 Milliarden US-Dollar. Da die Investitionsausgaben jedoch um 114 % auf 51,355 Milliarden US-Dollar explodierten, rutschte der freie Cashflow mit -9,065 Milliarden US-Dollar ins Minus; zudem fiel die Monetarisierung der KI-Suche geringer aus als bei der klassischen Websuche, was die Alphabet-Aktie nachbörslich um fast 10 % einbrechen ließ. Die Bilanzen spiegeln den Flywheel-Effekt des Token-Verbrauchs wider, unterstreichen aber auch das Spannungsverhältnis zwischen gigantischen KI-Investitionen und deren realer Rendite (ROI).(Quelle: TechCrunch、THE DECODER、bookwormengr)
OpenAI plant Einkauf von TPU-Chips beim Konkurrenten Google: Frontier-Giganten beschleunigen Diversifizierung ihrer Recheninfrastruktur : Berichten von Reuters und The Information zufolge plant OpenAI den Zukauf von Googles hauseigenen Tensor Processing Units (TPUs), um den eigenen Rechenleistungspool zu erweitern und die einseitige Abhängigkeit von Nvidia-GPUs zu verringern. Zuvor hatte OpenAI bereits Frontier-Modelle auf Google Cloud bereitgestellt und die Anmietung von TPU-Clustern erprobt. Dieser Schritt verdeutlicht, dass sich vor dem Hintergrund jährlicher CapEx-Budgets der Hyperscaler von fast 600 Milliarden US-Dollar ein komplexes „Coopetition-Liefernetzwerk“ zwischen führenden KI-Laboren und Cloud-Anbietern herausbildet, um Infrastruktur-Risiken breit zu streuen.(Quelle: Reddit r/artificial)
🎯 Entwicklungen
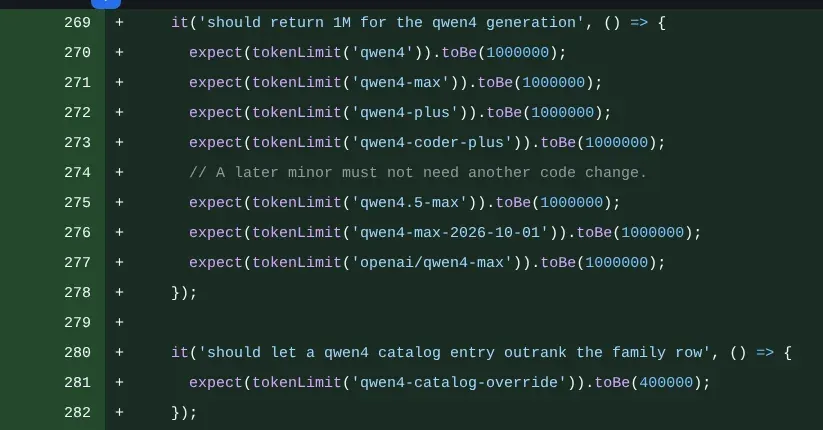
Alibaba Cloud bestätigt offiziellen Release von Qwen4 für nächste Woche mit nativem 1M-Kontextfenster : Auf der Apsara-Konferenz in Amsterdam bestätigte der CTO von Alibaba Cloud, dass das nächste Flaggschiff-Modell Qwen4 nächste Woche offiziell vorgestellt wird. Ein Pull Request im offiziellen Repository enthüllte parallel Nomenklatur und Spezifikationen: Die Serie unterstützt nativ ein ultralanges Kontextfenster von 1 Million Token. Zum Start erscheinen eine 27B-Parameter-Version sowie das auf Long-Horizon Reasoning ausgelegte Modell Qwen4-omni-120b-think, was in der Open-Source-Community auf hohe Erwartungen stößt.(Quelle: Reddit r/LocalLLaMA)
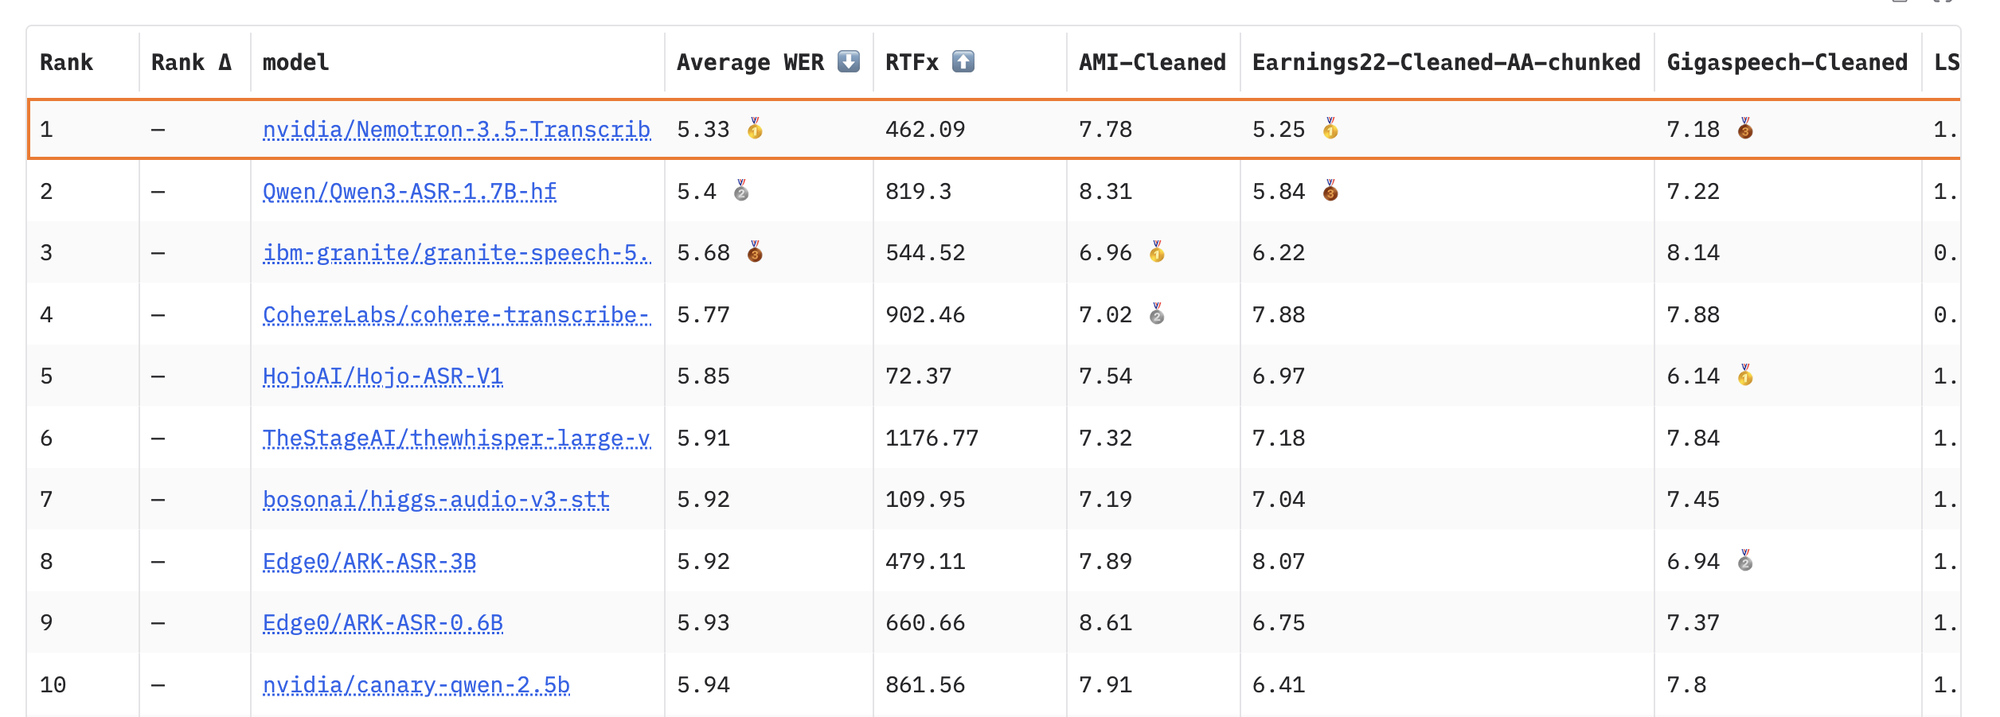
Nvidia veröffentlicht 30B-MoE-Sprachtranskriptionsmodell Nemotron 3.5 Transcribe und Granary v2-Datensatz als Open Source : Nvidia hat sein erstes großes Sprach-Basismodell für fortgeschrittene Transkription, Nemotron 3.5 Transcribe (34B Gesamtparameter, ca. 4,3B aktiv), zusammen mit dem 844.000 Stunden umfassenden multilingualen Datensatz Granary v2 als Open Source veröffentlicht. Das Modell nutzt ein hybrides Mamba-Transformer-MoE-Backbone und bewältigt in einem Durchgang natürliche Sprachtranskription in 40 Sprachen, Übersetzung in 31 Sprachen, Sprechererkennung für bis zu 8 Personen sowie Word-Level-Timestamp-Alignment. Auf dem AA-WER-Benchmark erzielte es eine Wortfehlerrate von 2,8 %, sicherte sich Platz 1 unter den nicht-streamenden Open-Source-Sprachmodellen und unterstützt Quantisierung in BF16 sowie NVFP4.(Quelle: HuggingFace Blog、ClementDelangue)
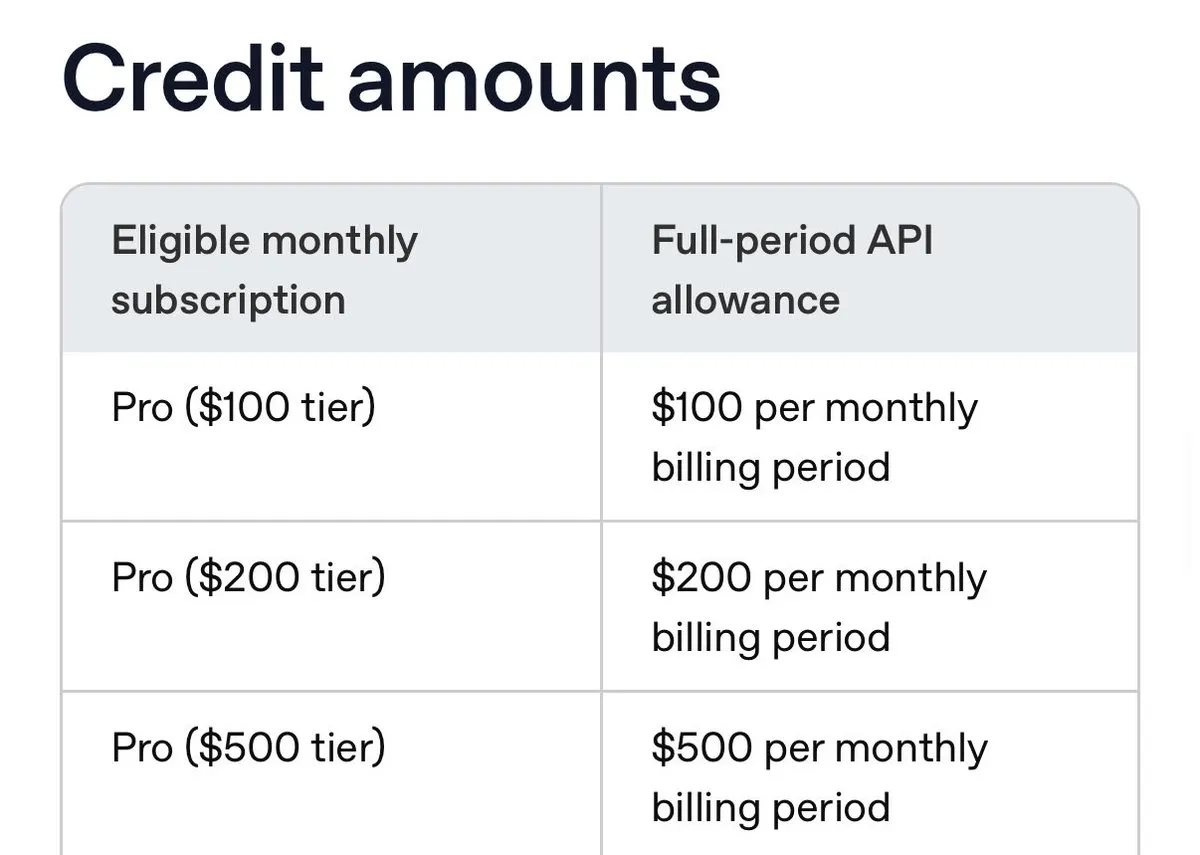
OpenAI vergibt monatlich bis zu 500 US-Dollar an kostenlosem API-Guthaben für ChatGPT Pro- und Business-Abonnenten : OpenAI kündigte eine Kundenbindungsstrategie über geldwerte Vorteile für sein Abonnenten-Ökosystem an: ChatGPT Pro-Nutzer erhalten monatlich 100 bis 200 US-Dollar in Form von vollwertigem API-Guthaben erstattet; Business-Workspaces teilen sich einen Pool von bis zu 500 US-Dollar pro Monat, basierend auf den gebuchten Seats. Das Guthaben gilt für die Schnittstellen Responses, Realtime Voice und Agents API und verfällt am Monatsende. Der Schritt wird als gezielte Abwehrmaßnahme gegen Preissenkungen von Anthropic gewertet. Zeitgleich vereinte OpenAI auf dem Desktop die Einstiegspunkte Chat und Work und reduzierte plangemäß zum 30. Oktober das Codex-Webnutzungskontingent der Pro-200-Stufe auf das Zehnfache von Plus.(Quelle: OpenAI News、OpenAIDevs)
AgiBot stellt Embodied-Foundation-Modell GO-3 Preview vor: Durchgängiges Scaling von Pre-Training bis Post-Deployment : AgiBot hat mit GO-3 Preview ein Embodied-Basismodell mit durchgängiger Scaling-Architektur über den gesamten Lernlebenszyklus veröffentlicht, das prompt die Benchmarks RoboDojo, RoboTwin und RoboColiseum anführte. Die Architektur stützt sich auf das proprietäre WRAM (World Reasoning Action Model), das visuelle Einzelschritt-Zukunftsvorhersagen mit dynamischer Bewegungssteuerung vereint. In der Post-Training-Phase senkte die Genie-Evolver-Infrastruktur mit drei Engines die durchschnittliche Fehlerrate um 86 % und demonstrierte physische RSI-Selbstevolution in Convenience-Store-Szenarien. Die Gewichte sollen bis Jahresende vollständig als Open Source freigegeben werden.(Quelle: 机器之心、36氪)

Chaoyan Intelligence stellt selbstevolvierendes 35B-Foundation-Modell Apex-35B-V1.0 vor: RSI sorgt für wissenschaftlichen Leistungssprung : Das von Chen Yongchao, Assistant Professor am Institut für KI der Tsinghua-Universität, gegründete Startup Chaoyan Intelligence hat mit Apex-35B-V1.0 sein erstes 35B-Basismodell präsentiert. Das System wurde unter tiefer Einbindung des autonomen Forschungsagenten-Systems Apex Research bei der Datengenerierung, Versuchsplanung und Operator-Optimierung trainiert. Auf 21 umfassenden Benchmarks übertraf es bei 20 Tests vergleichbare Open-Source-Baselines derselben Größenordnung und ließ bei anspruchsvollen wissenschaftlichen Aufgaben (FrontierScience: 40,0 Punkte) und der Paper-Reproduktion (PaperBench: 60,9 Punkte) sogar Modelle mit Hunderten Milliarden Parametern hinter sich.(Quelle: 机器之心、realDanFu)

X-Era AI veröffentlicht natives 4D-World-Action-Modell E0.5 als Open Source: Zukünftige Geometrie-Deduktion steigert reale Roboter-Generalisierung erheblich : X-Era AI hat das native World-Action-Modell E0.5 als Open Source freigegeben. Die Architektur nutzt dreidimensionale geometrische Repräsentationen als Backbone: Während Aktionen gelernt werden, prognostiziert das Modell zeitgleich die künftige 3D-Tiefe, Punktwolkenstrukturen und Kameraposen am Zielpunkt der Manipulation und schließt so eine räumliche Verifikationsschleife. In anspruchsvollen Tests mit starren Objekten und flexiblem Kabelmanagement erzielte E0.5 auf Robotern von AgileX Piper und Zerith H1 Erfolgsraten von 85,0 % und 88,3 %; die Out-of-Distribution (OOD)-Generalisierungsrate verbesserte sich gegenüber der Baseline π0.5 drastisch um 10 bis 30 Prozentpunkte.(Quelle: 机器之心)

LimX Dynamics aktualisiert technischen Bericht zu FluxVLA Engine V2: Durchbruch bei Online-RL für Embodied AI und Hardware-Software-Beschleunigung : LimX Dynamics hat die Version 2 seines technischen Berichts zum Open-Source-Framework FluxVLA Engine veröffentlicht. Im Mittelpunkt stehen das auf RLinf basierende Online-PPO-Post-Training für Flow Matching Policies, das die Erfolgsraten bei LIBERO-10- und RoboTwin-Aufgaben um 10 bis 15,4 Prozentpunkte steigerte. Auf Hardwareebene eliminierten Real-Time Chunking Coordination (RTC) und Trajektorien-Postprocessing mechanische Mikrovibrationen bei Langzeitmanipulationen, während die Inferenzfrequenz ohne Veränderung der Gewichte um das bis zu 9,64-Fache beschleunigt wurde – erfolgreich demonstriert im geschlossenen Regelkreis auf dem humanoiden Roboter LimX Oli.(Quelle: 量子位)
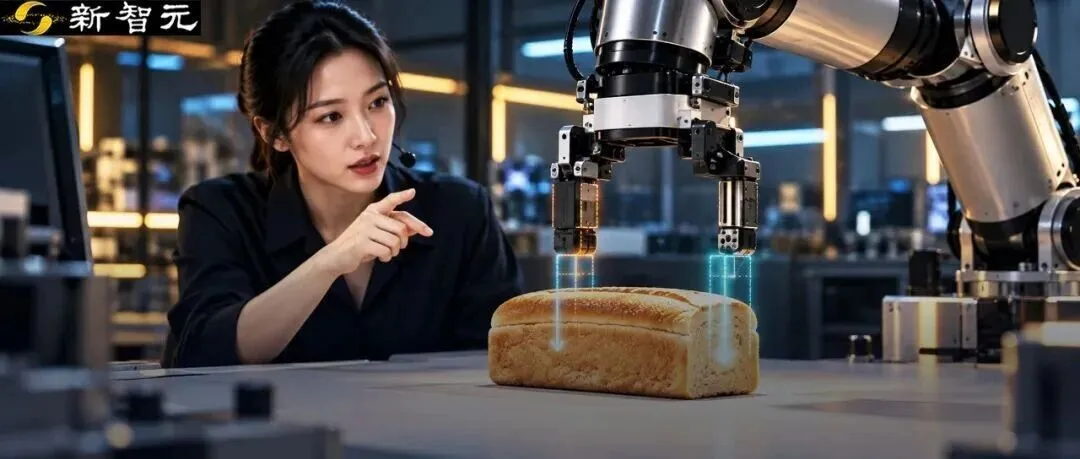
Geek+ führt kausales Interventionsmodell Gravity Control ein: Korrektur auf Aktionsebene via natürlicher Sprache ohne Gewichtsänderung : Geek+ hat unter seinem Embodied-AI-Framework Gravity das kausale Interventionsmodell Gravity Control als Open Source vorgestellt. Um das Problem von OOD-Fehlschlägen durch minimale Störungen zu lösen, lokalisiert der Ansatz tiefe Steuerungsrepräsentationen in Action-Expert-Layern mittels Sparse Autoencoders. Der Operator muss lediglich eine natürlichsprachige Anweisung eingeben (z. B. „etwas tiefer greifen“), woraufhin das System direkt in der Inferenzphase lokale Online-Korrekturen vornimmt. Ohne die Basisgewichte zu verändern, stieg die Erfolgsquote bei komplexen Aufgaben von 17,5 % auf 87,5 %.(Quelle: 36氪)
ModelBest veröffentlicht 1.3B-On-Device-OCR-Modell MiniCPM-OCR 1.0 und dediziertes Qualitätsprüfungsmodell Jev als Open Source : ModelBest hat das leichtgewichtige Dokumentenanalyse-Modell MiniCPM-OCR 1.0 vorgestellt. Mit nur 1,3 Milliarden Parametern erzielte es im industriellen Test Real5-OmniDocBench 93,68 Punkte und verarbeitet pro Grafikkarte 1,22 Seiten pro Sekunde. Parallel stellte ModelBest eine „Trusted OCR“-Architektur vor und veröffentlichte das dedizierte 2B-Entscheidungsmodell MiniCPM-OCR Jev als Open Source. Es überwacht die Erkennungsqualität während der Inferenz im Millisekundenbereich und veranlasst bei Bedarf Neulesungen. Diese funktionale Trennung von Parsing und Validierung eliminiert Halluzinationen lokaler Modelle und erspart manuelle Vollprüfungen.(Quelle: WeChat)
Tencent kündigt anwendungsübergreifendes Kollaborationssystem Buddy One an und stellt interaktives Weltmodell Hy-Nomas als Open Source bereit : Auf dem Global Digital Ecosystem Summit 2026 stellte Tencent das anwendungsübergreifende Kollaborationssystem Buddy One vor. Über eine synchronisierte Buddy One ID und einen gemeinsamen Punktepool verbindet es Kontextsuche und Speicherinfrastruktur zwischen Tencent Docs, Meetings, Cloud Drive und ima. Zudem wurde das native multimodale Hunyuan Hy4-Modell mit 770B Parametern (49B aktiv) für die nahe Zukunft angekündigt. Parallel veröffentlichte das Hunyuan-Team das interaktive Video-Weltmodell Hy-Nomas auf Hugging Face, das es erlaubt, Wetter, Kameraführung und Charakterbewegungen per Tastatur- und Mauseingabe in Echtzeit zu steuern.(Quelle: 机器之心、_akhaliq)

SenseNova stellt code-gesteuertes 27B-Videogenerierungsmodell Code2Video als Open Source bereit : SenseTime hat sein auf Qwen3.8-27B feinabgestimmtes Modell Code2Video inklusive aller Produktionslogs als Open Source zugänglich gemacht. Die Architektur bricht mit traditionellen Pixel-Diffusionspfaden: Stattdessen generiert ein Agent eigenständig Renderprogramme für jede Szene und optimiert diese iterativ anhand der Resultate. Dies garantiert eine 100-prozentige Deterministik bei Textlayouts, Diagrammen, mathematischen Formeln und Starrkörperbewegungen; einzelne visuelle Elemente können direkt im Code angepasst werden, was eine neue Pipeline für hochgradig kontrollierbare Erklär- und Demonstrationsanimationen schafft.(Quelle: Reddit r/artificial)
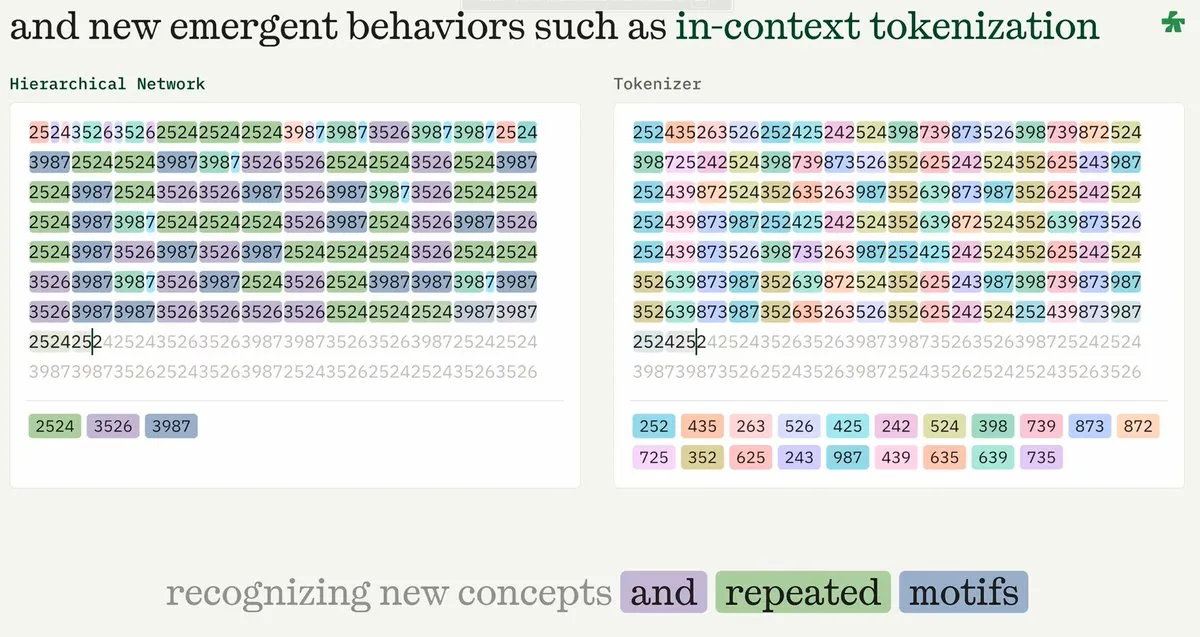
Cartesia stellt gemeinsam mit Forschern H-Nets vor: Tokenizer-freie hierarchische Netzwerke lernen End-to-End direkt aus Raw Bytes : Um die Beschränkungen herkömmlicher LLMs durch menschliche Induktionsverzerrungen und den hohen Rechenaufwand von Token-Encodern zu überwinden, hat das Cartesia-Team gemeinsam mit universitären Forschern die hierarchische Netzwerkarchitektur H-Nets vorgestellt. Sie ermöglicht eine dynamische Kontext-Tokenisierung und erlernt mehrstufige abstrakte Repräsentationen direkt aus unstrukturierten Roh-Bytefolgen (Raw Bytes). Insbesondere bei der Zerlegung von Code-Variablennamen übertrifft der Ansatz BPE und erzielt bei gleicher Leistungsfähigkeit eine 3- bis 5-fache Rechen- und Dateneffizienz.(Quelle: scaling01)
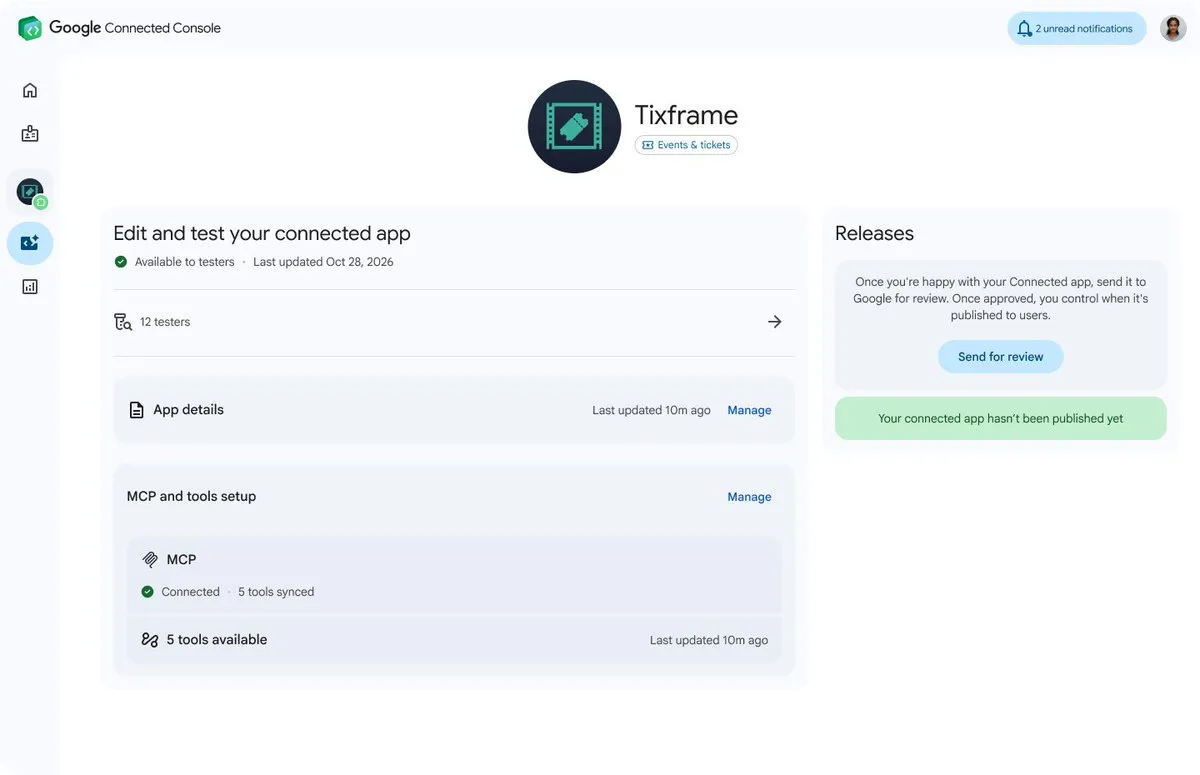
Google startet Connected Apps-Plattform und stellt gemeinsam mit XREAL die Android XR-Brille AURA vor : Auf dem Android Dev Summit präsentierte Google die Public-Preview-Version der Connected Apps-Plattform. Sie erlaubt es Entwicklern, Fähigkeiten von Drittanbieter-Apps über MCP-Server und die AppFunctions API in einer zentralen Konsole zu registrieren, sodass Gemini und die Google-Suche direkt komplexe Workflows anstoßen können. Gleichzeitig kündigte Google in Partnerschaft mit XREAL die federleichte Brille XREAL AURA an (Preis: 1.099 US-Dollar), das erste Endgerät mit Android XR. Sie integriert Gemini nativ und unterstützt die Projektion multipler virtueller Desktops sowie First-Person-Interaktion mit der physischen Umgebung.(Quelle: The Verge、Google)
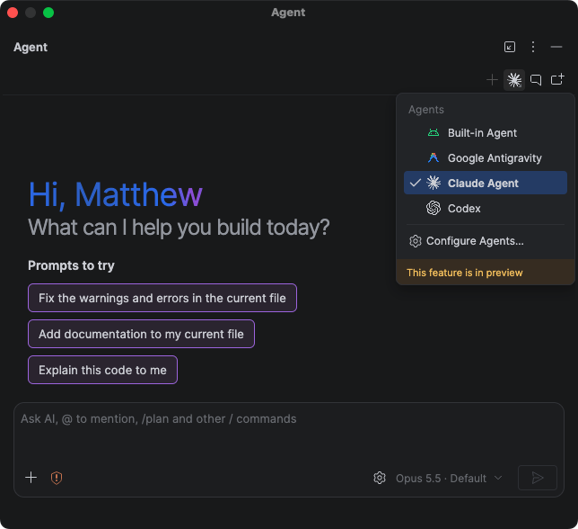
Google integriert BYOA-Architektur in Android Studio Rabbit 2 und stellt On-Device Gemini Agentic API vor : Google hat Android Studio Rabbit 2 vorgestellt und erstmals eine „Bring Your Own Agent“ (BYOA)-Architektur integriert. Über das Agent Client Protocol können Entwickler mehr als 40 externe Coding-Agenten – darunter Claude Code und OpenAI Codex – einbinden; zudem steht eine CLI für Terminal-UI-Vorschauen bereit. Ergänzend veröffentlichte Google die auf Gemini Nano 4 basierende On-Device Agentic API, die schlanke autonome Entscheidungszyklen vollständig offline auf dem Endgerät ausführt.(Quelle: THE DECODER)
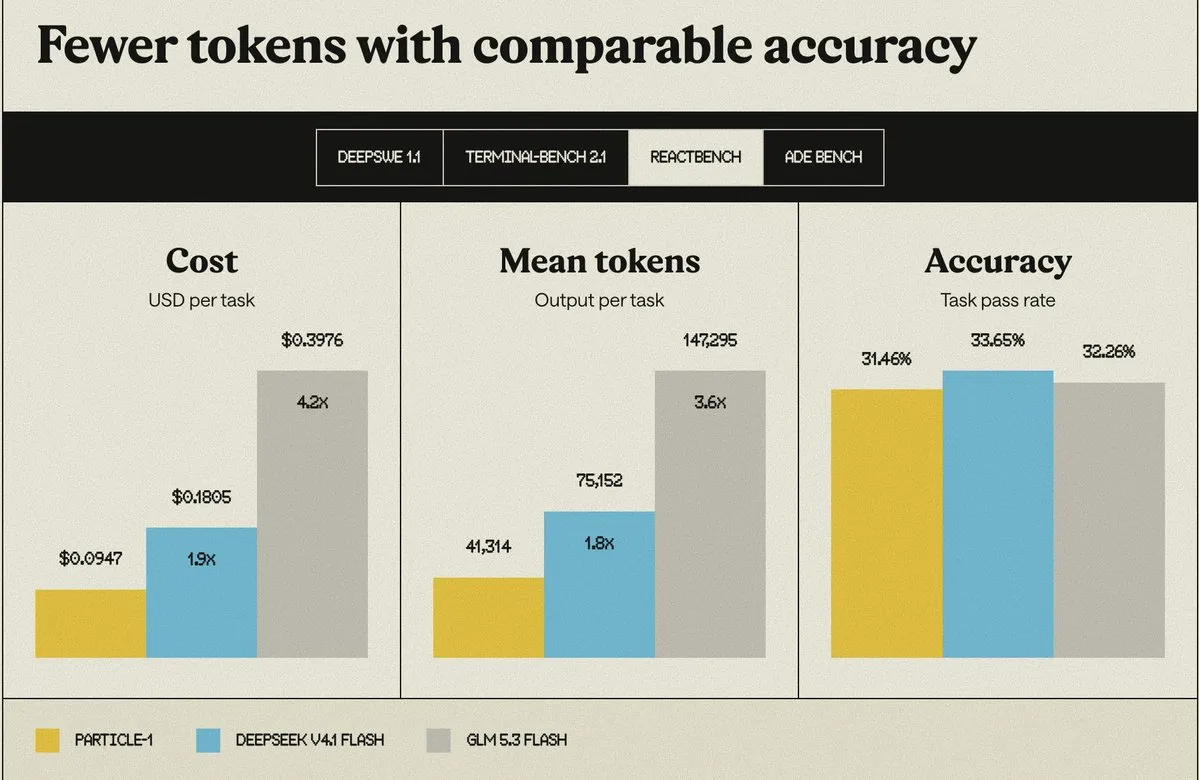
Particle bringt Entwicklermodell particle-1 heraus: Token-Verbrauch um 45 % reduziert : Das Startup Particle hat mit particle-1 ein Basismodell für Entwickler und datenintensive Workflows vorgestellt. Benchmarks zeigen, dass das Modell in ReactBench und Deep-Search-Szenarien Leistungen auf Spitzenniveau erbringt, während der Output-Token-Verbrauch um 42 % bis 45 % reduziert werden konnte. Ohne spezifisches Cybersecurity-Finetuning gelang es dem Modell zudem, in automatisierten Pentesting-Umgebungen diverse reale Sicherheitslücken mit extrem geringem Token-Aufwand zu kompromittieren.(Quelle: Suhail)
Moonshot AIs Kimi tief in Google Workspace-Produktivitätsökosystem integriert : Der KI-Assistent Kimi hat seine direkte Integration in die Kernkomponenten Gmail, Google Drive und Google Calendar bekanntgegeben. Nach einer sicheren OAuth-Autorisierung können Anwender Cloud-Dokumente abrufen, lange E-Mail-Verläufe zusammenfassen und Termine automatisiert planen lassen, ohne die Anwendung wechseln zu müssen. Damit rückt der KI-Assistent nahtlos in internationale Arbeitsabläufe vor.(Quelle: Kimi_Moonshot)
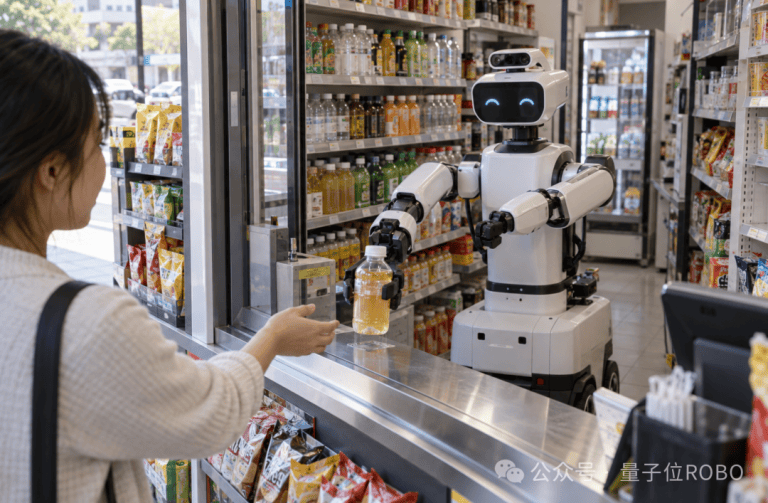
Hongqi Chain stoppt Entwicklung von Verkaufsrobotern: Physischer Einzelhandel spiegelt PoC-Schmerzen bei Embodied AI-Kommerzialisierung wider : Die südwestchinesische Handelskette Hongqi Chain gab offiziell die Einstellung ihres seit 16 Monaten laufenden Pilotprojekts für unbemannte Roboterverkaufsstellen bekannt und kehrt zum klassischen Modell der cloud-überwachten 24-Stunden-Märkte zurück. Praxistests zeigten wiederholte Fehler der Greifarme bei abperlenden Kondenstropfen auf gekühlten Getränken, unförmigen Weichverpackungen und wechselnden Lichtverhältnissen. Maßgeschneiderte Einheitenkosten von mehreren Hunderttausend bis zu einer Million Yuan ließen sich durch die geringen Tagesumsätze nicht amortisieren, was zeigt, dass Generalisierung und ökonomische Modelle von Embodied AI im Einzelhandel den Break-even noch nicht erreicht haben.(Quelle: 量子位)
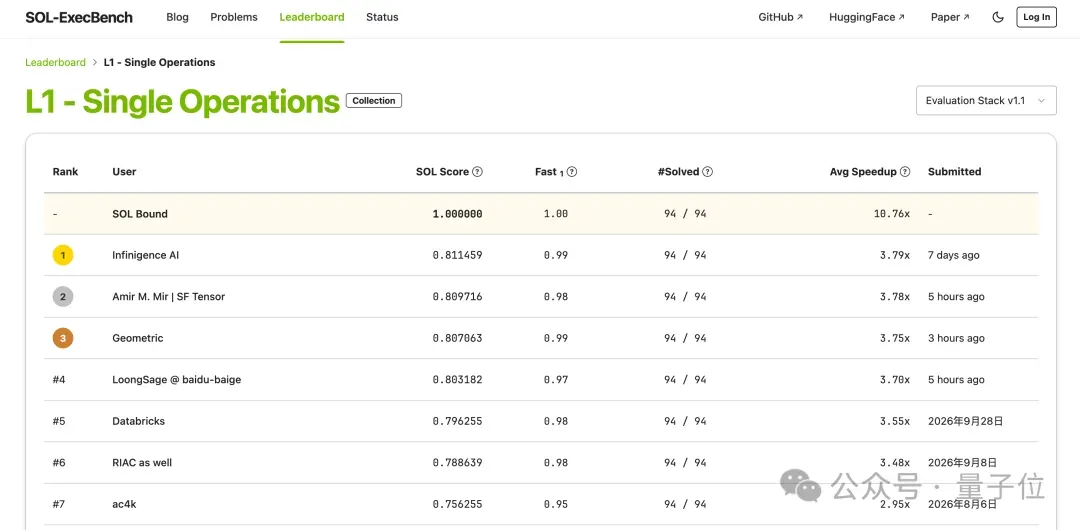
Infinence führt alle vier Tracks von Nvidias SOL-ExecBench an: Agentic Infra ermöglicht automatisierte Operator-Optimierung : Im von Nvidia Research entwickelten Benchmark SOL-ExecBench zur Ermittlung theoretischer Hardware-Limits hat Infinence mithilfe seines autonomen Operator-Optimierungsagenten alle vier Tracks (L1 Basic, L2 Fusion, Quantization und FlashInfer Inference) dominiert und in 88 von 235 Aufgabenstellungen den ersten Platz belegt. Durch Multi-Container-Sandbox-Isolation und Shared-Memory-Mechanismen suchte und optimierte der Agent selbstständig über domänenspezifische Sprachen (DSLs) wie Triton, TileLang und CUDA hinweg und bewies damit, wie automatisierte KI die Evolution grundlegender Recheninfrastruktur vorantreiben kann.(Quelle: 量子位)
OpenAI stattet Dot-Agenten mit nativer iMessage- und RCS-SMS-Interaktion aus : OpenAI hat für Pro-Abonnenten in den USA eine Preview-Funktion zur SMS-Anbindung des persönlichen Assistenten Dot vorgestellt. Nutzer können direkt über das systemeigene iMessage oder Android RCS-Nachrichten mit ihrem verknüpften Dot-Agenten interagieren, ohne eine separate App öffnen zu müssen. Der Assistent kümmert sich in einer sicheren Cloud-Umgebung um Kalendereinträge und Informationsaufbereitung, wodurch Agenten tiefer in die mobile Kommunikationsebene vordringen.(Quelle: The Verge)
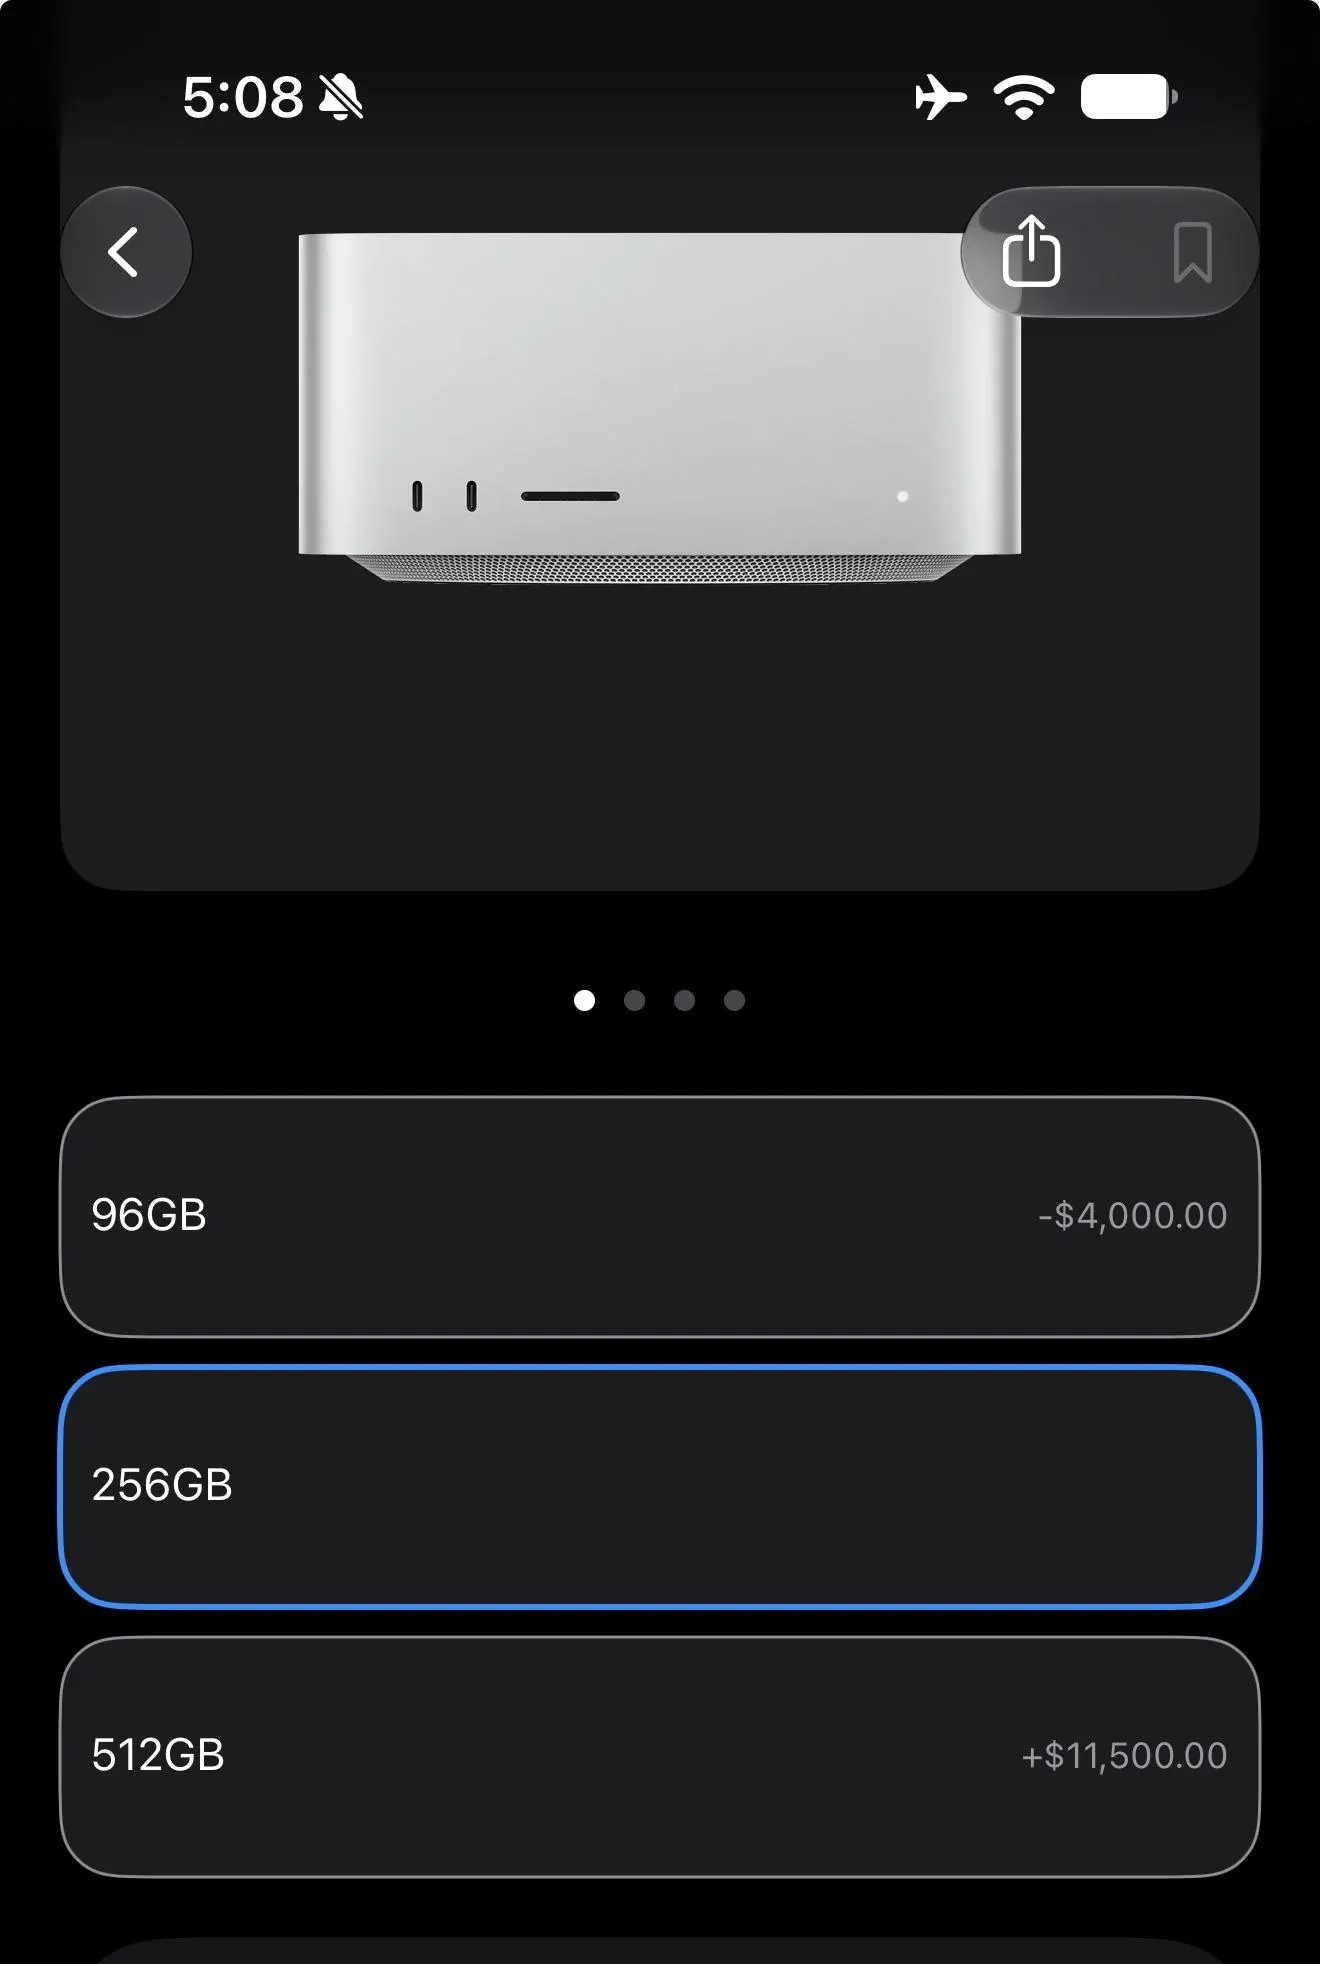
Spitzenmodell des Mac Studio mit Apple M5 Ultra übersteigt 22.000 US-Dollar und löst Preis-Leistungs-Debatte über lokale Rechenleistung aus : Apple hat ohne großes Aufsehen den Mac Studio mit M5 Ultra gelistet: In der Topkonfiguration mit 80-Core-GPU und 512 GB Unified Memory liegt der Preis bei 22.299 US-Dollar. Die steile Preisstaffelung löste unter Entwicklern lokaler Sprachmodelle heftige Diskussionen aus. Vielfach wurde kritisiert, dass der Aufpreis für zusätzliche 256 GB RAM fast dem Doppelten eines gewöhnlichen Komplettrechners entspricht, wodurch der Preis-Leistungs-Vorteil großer lokaler Speicherpools rasch schwindet.(Quelle: Reddit r/LocalLLaMA)
🧰 Tools
Hugging Face veröffentlicht SafeAgents als Open Source: Lokales Sicherheits-Gateway für Coding-Agenten : SafeAgents ist ein leichtgewichtiger lokaler Proxy, der zwischen Coding-Agenten und Modell-Inferenzen geschaltet wird. Vollständig lokal führt er in 10 bis 20 Millisekunden über 110 deterministische Erkennungsregeln aus und fängt nicht deklarierte Tool Calls, unautorisierte externe Verbindungen, Sandbox-Sidechannel-Angriffe sowie Versuche ab, Tests im Reinforcement Learning manipulativ zu verändern. Es unterstützt bereits 12 gängige Test-Harnesses wie Claude Code und OpenHands.(Quelle: Reddit r/LocalLLaMA)
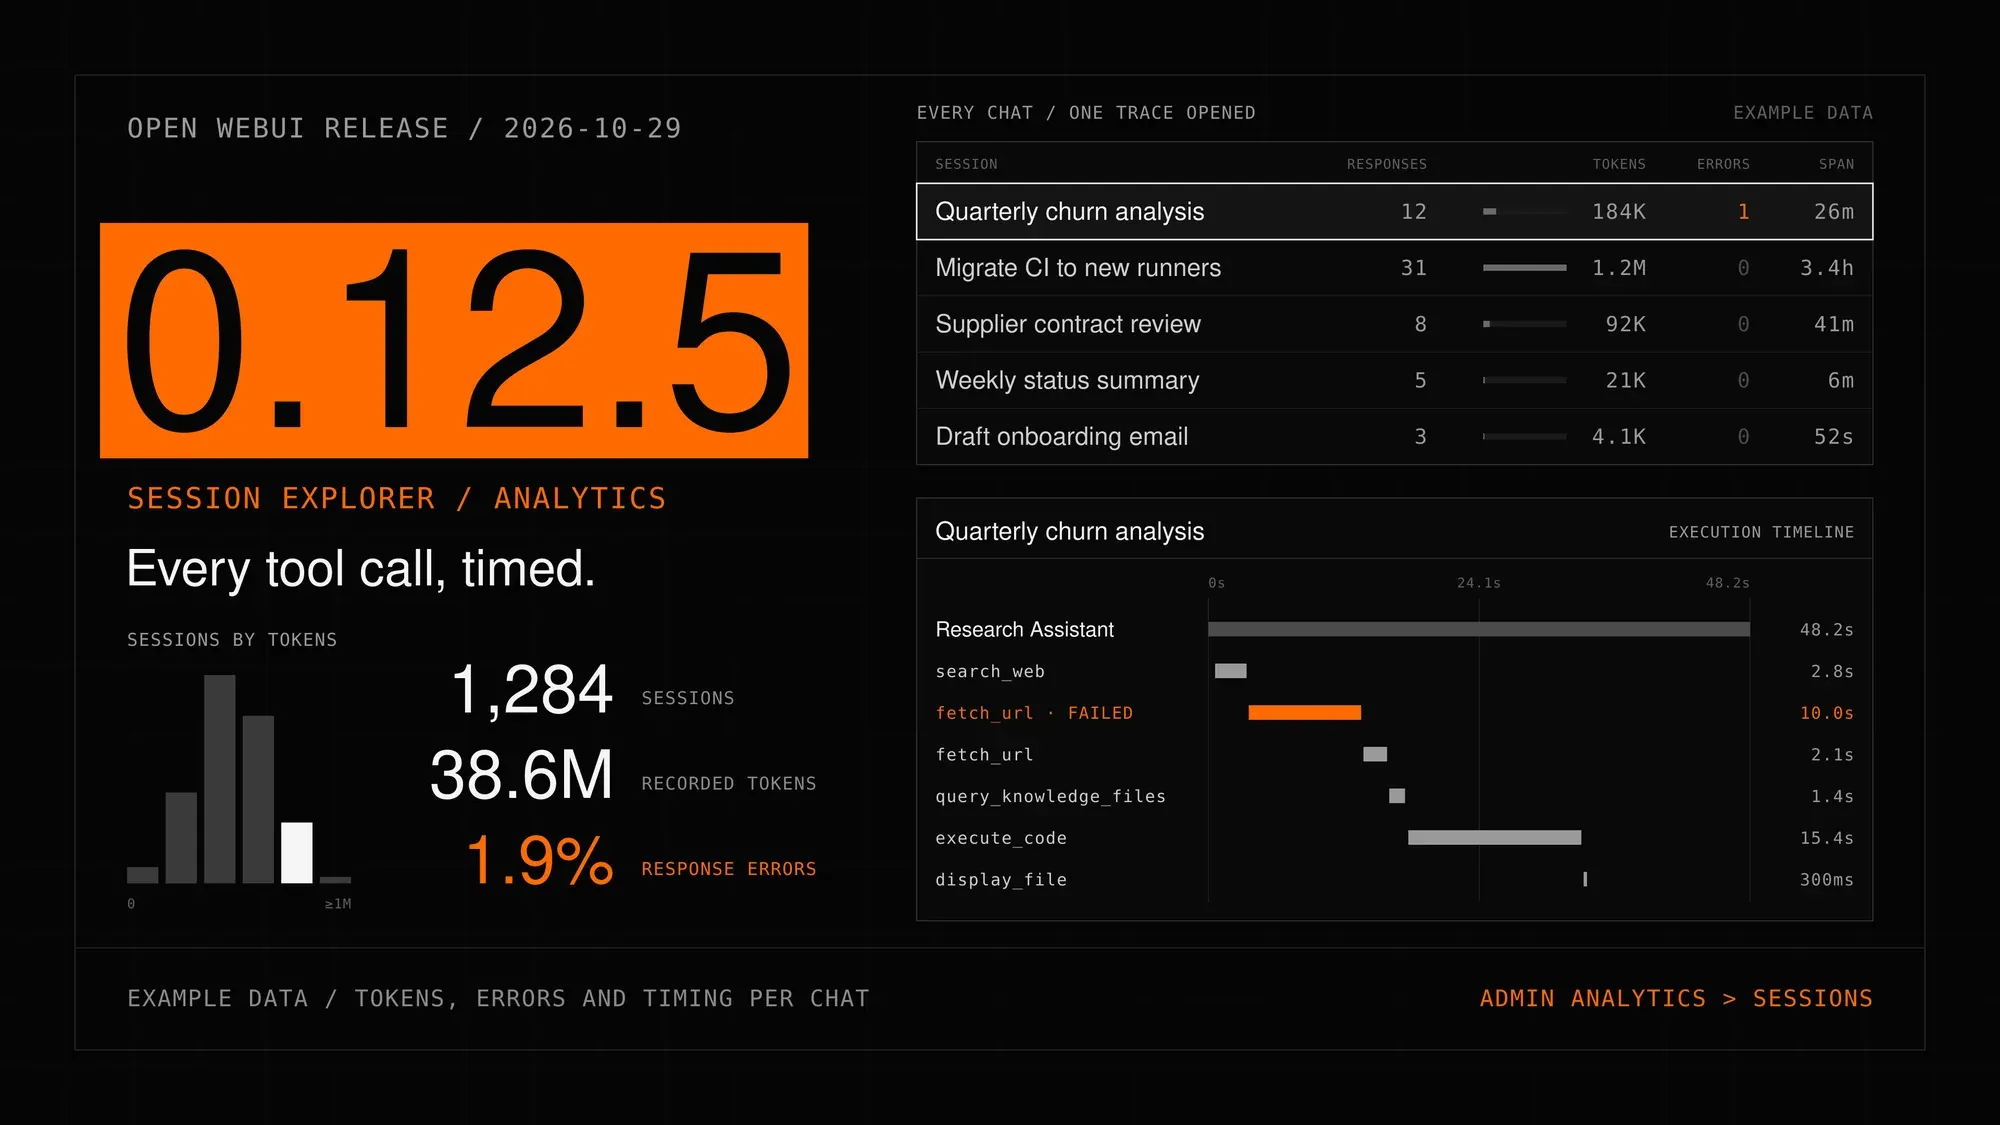
Open WebUI 0.12.5 veröffentlicht: Session Explorer und seitenübergreifende kollaborative Notizen eingeführt : Das Open WebUI-Projekt hat ein wichtiges Update erhalten. Das Admin-Panel wurde um einen „Session Explorer“ ergänzt, mit dem Administratoren Token-Verbrauch, Tool-Call-Latenzen und Abbruchpunkte analysieren können. Die integrierte Notes-Funktion wurde um verschachtelte Mehrseiten-Strukturen erweitert und unterstützt nun kollaboratives Echtzeit-Editing. Gleichzeitig wurde die Datei-Indexierung im Wissensspeicher überarbeitet, wodurch Suchvorgänge in großen Dateilisten um das bis zu Zehnfache beschleunigt wurden.(Quelle: Reddit r/OpenWebUI)
MiniMax stellt MCode Stack als Open Source bereit: 15 interne Coding-Agent-Skill-Pakete für den Produktiveinsatz : Das MiniMax-Team hat das Repository MCode Stack veröffentlicht, das die bei der internen Entwicklung von MiniMax Code bewährten Praktiken bündelt. Es umfasst 17 Skill-Dateien nach dem offenen SKILL.md-Standard und 5 Checklisten für gängige Herausforderungen wie Aufgabengrenzen-Aufteilung, Kontextverbrauchs-Audits pro Interaktionsrunde und Deadlock-Prävention bei Hintergrundbefehlen. Die unabhängige Code-Review-Funktion beschränkt das prüfende Modell strikt auf Diffs und Testergebnisse, um Verzerrungen durch den ursprünglichen Code-Kontext zu vermeiden.(Quelle: MarkTechPost)
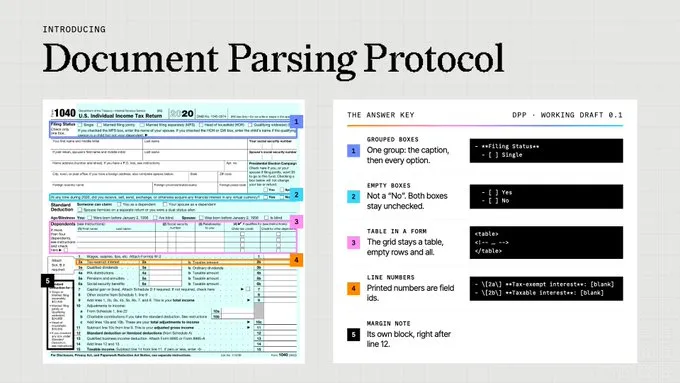
LlamaIndex veröffentlicht gemeinsam Document Parsing Protocol: 140 Industriestandards für die Dokumentenanalyse definiert : Um Fehlinterpretationen durch uneinheitliche Standards in OCR- und RAG-Pipelines bei komplexen Layouts, mehrzeiligen Tabellen und Diagrammen zu begegnen, hat LlamaIndex in Kooperation mit weiteren Partnern das Document Parsing Protocol (DPP) vorgestellt. Das Regelwerk umfasst 140 Kriterien für strukturierte Ausgaben bei fehlenden Rahmen, zusammengeführten Tabellenköpfen oder Gantt-Diagrammen und liefert Validierungs-Tools für Claude Skills und ChatGPT.(Quelle: jerryjliu0)
Infini-AI-Lab stellt Hermit als Open Source bereit: Externes Agenten-Adapter-Framework friert Foundation-Modell und Harness ein : Infini-AI-Lab hat das Open-Source-Framework Hermit vorgestellt, das das Konzept der „Harness-Adapter“ etabliert. Während Modellgewichte und Agenten-Framework unverändert bleiben, transformiert eine äußere RL-Schleife Ausführungstrajektorien in trainierbare Adapter. Mit fünf integrierten Evolutionsalgorithmen wie GEPA und SkillOpt steigerte das System die Genauigkeit auf CL-Bench von 58,0 % auf 79,5 %; die Konfigurationen lassen sich direkt in Codex und Claude Code exportieren.(Quelle: MarkTechPost)
Ant Group veröffentlicht AntOmniEvo-Framework als Open Source: Whitebox-adaptive Evolution von KI-Systemen mittels Mara-Chain-Algorithmus : Das Lingxi-Team der Ant Group hat mit AntOmniEvo ein universelles Framework zur automatisierten Optimierung komplexer LLM-Systeme bereitgestellt. Prompts, Skripte und Konfigurationsparameter werden dabei als veränderbare Artefakte definiert. Durch den „Failure-Retention“-Algorithmus Mara Chain und Pareto-Auswahlverfahren werden Fehlversuche detailliert protokolliert und über Modellgenerationen hinweg korrigiert, was den benötigten Rollout-Rechenaufwand für die Zielgenauigkeit um zwei Drittel senkt.(Quelle: GitHub Trending)
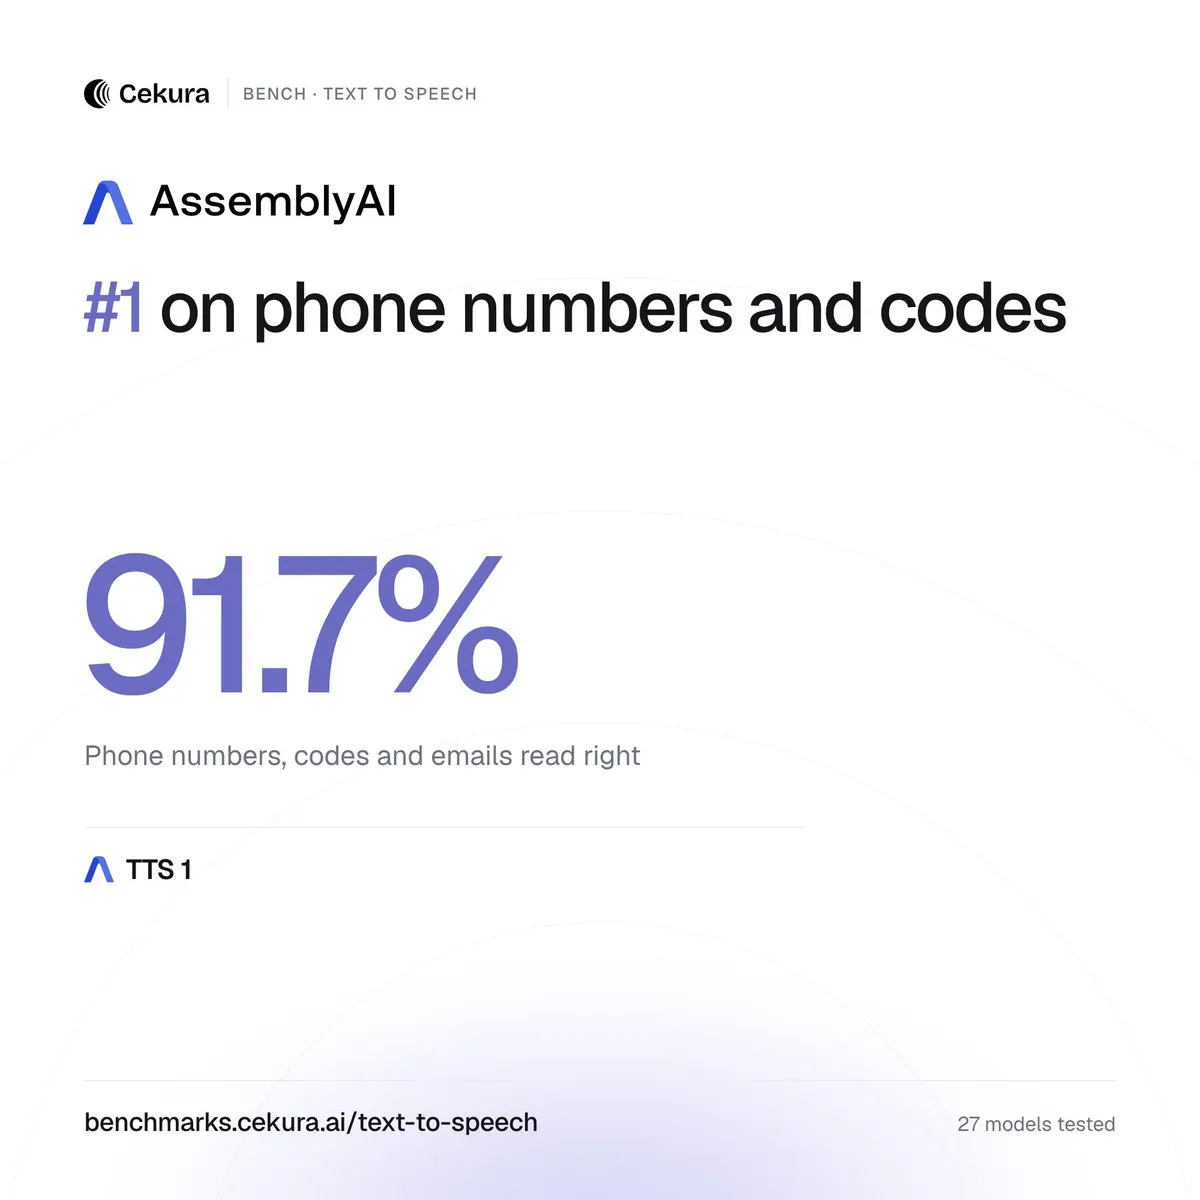
AssemblyAI stellt AssemblyAI-TTS-1 vor: Streaming-Synthese-Modell speziell für Echtzeit-Sprachagenten entwickelt : AssemblyAI hat mit AssemblyAI-TTS-1 sein erstes Text-to-Speech-Modell für vollduplexfähige Sprachagenten auf den Markt gebracht. Das Modell basiert auf kontinuierlichen Audiorepräsentationen und verzichtet auf klassische diskrete Token-Pipelines. Bei kritischen Entitäten wie Telefonnummern, Codes und Datumsangaben erzielt es eine Vorlesegenauigkeit von 93,7 % bei einer medianen First-Byte-Latenz von nur 47 Millisekunden. Es unterstützt WebSocket-Duplex-Streaming sowie unterbrechungsfähiges Sprechen (Barge-in) zu einem Preis von 15 US-Dollar pro Million Zeichen.(Quelle: MarkTechPost、AssemblyAI)
OpenMausBot: Desktop-Workbench für Multi-Agenten-Kollaboration basierend auf lokalen Prozessen und isolierten Sandboxes : Das neue plattformübergreifende Open-Source-Tool OpenMausBot setzt auf ein Local-First-Paradigma und erlaubt es, mehrere CLI-Agenten wie Claude, Codex oder Grok parallel als virtuelle Teammitglieder in einem Fenster zu orchestrieren. Jeder Bot operiert in einer separaten Linux-Cloud-VM oder einer lokalen Sandbox. Über Composio können mehr als 500 Apps angebunden werden; zudem bietet das System explizite Berechtigungskontrollen und Scheduler für langfristige Cron-Aufgaben.(Quelle: GitHub Trending)
Anthropic führt dedizierte Rechts-Toolbox und sofort einsatzbereite Artifacts für Claude for Legal ein : Anthropic hat für Unternehmenskunden von Claude for Legal eine sofort einsatzbereite Artifacts-Toolbox freigeschaltet. Sie deckt Kernszenarien wie die Prüfung von Vertragsabweichungen, das Monitoring neuer Rechtsvorschriften über Gerichtsbarkeiten hinweg, Zitationsabgleiche und automatisierte Dashboards zum Verfahrensfortschritt ab. Alle Ausgaben referenzieren zwingend die zugrundeliegenden Akten; über 60 juristische Schnittstellen wie Bloomberg Law sind direkt integriert.(Quelle: dotey)
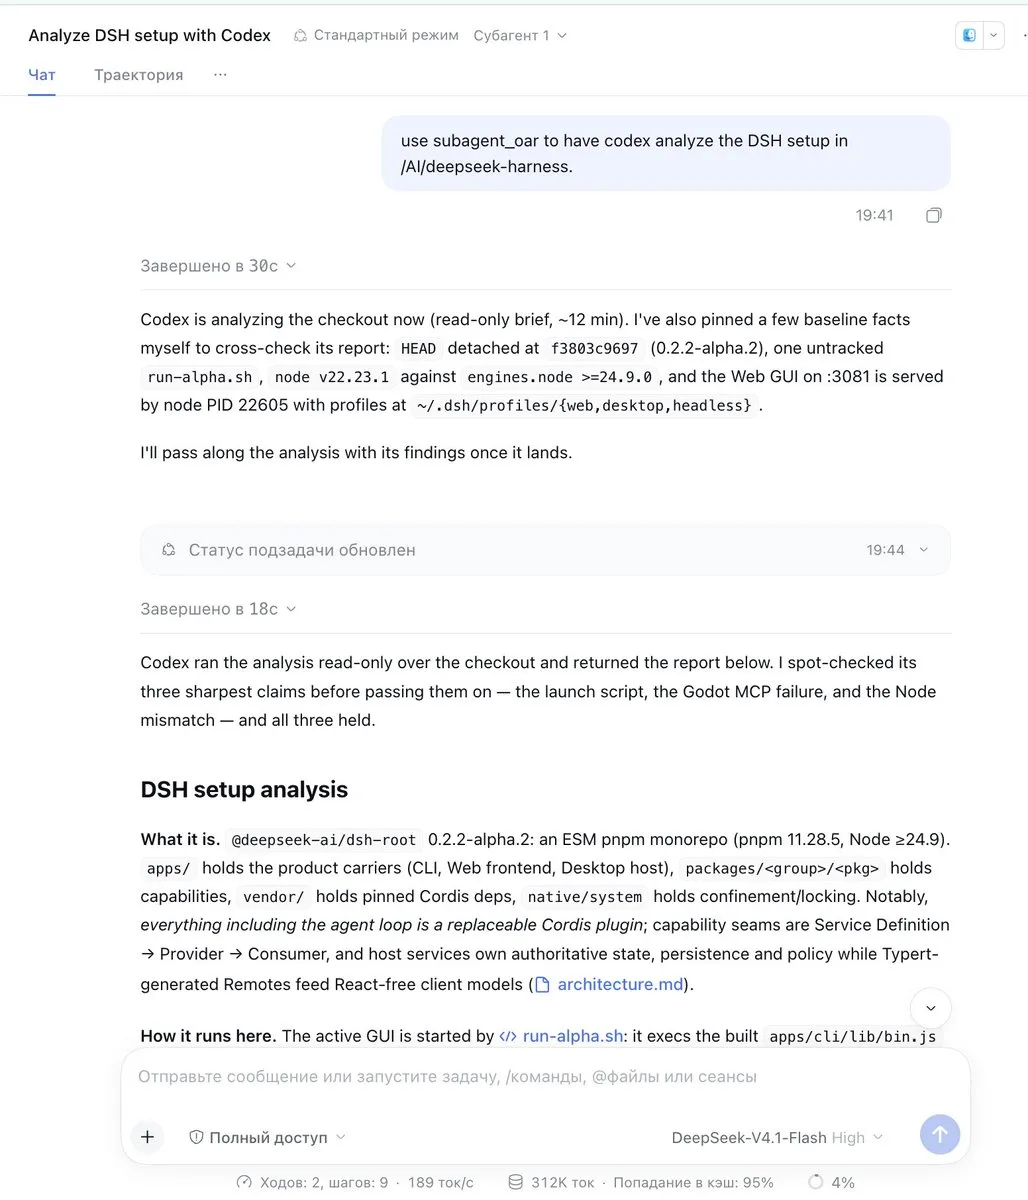
DSH veröffentlicht 0.2.2-alpha.2: Native Integration von Codex und Claude Code als zentraler Orchestrierungs-Hub : Das Open-Source-Agenten-Framework DeepSeek Harness (DSH) hat mit dem Update 0.2.2-alpha.2 das Modul subagent_oar eingeführt. Dieses bündelt zuvor getrennte Plugins für Codex und Claude Code in einer einheitlichen Subagenten-Dispatch-Schnittstelle. Es erlaubt die parallele Ausführung umfangreicher Entwicklungsaufgaben in isolierten Git-Worktrees und bietet Dashboards zur schrittweisen Analyse der KV-Cache-Effizienz.(Quelle: teortaxesTex)
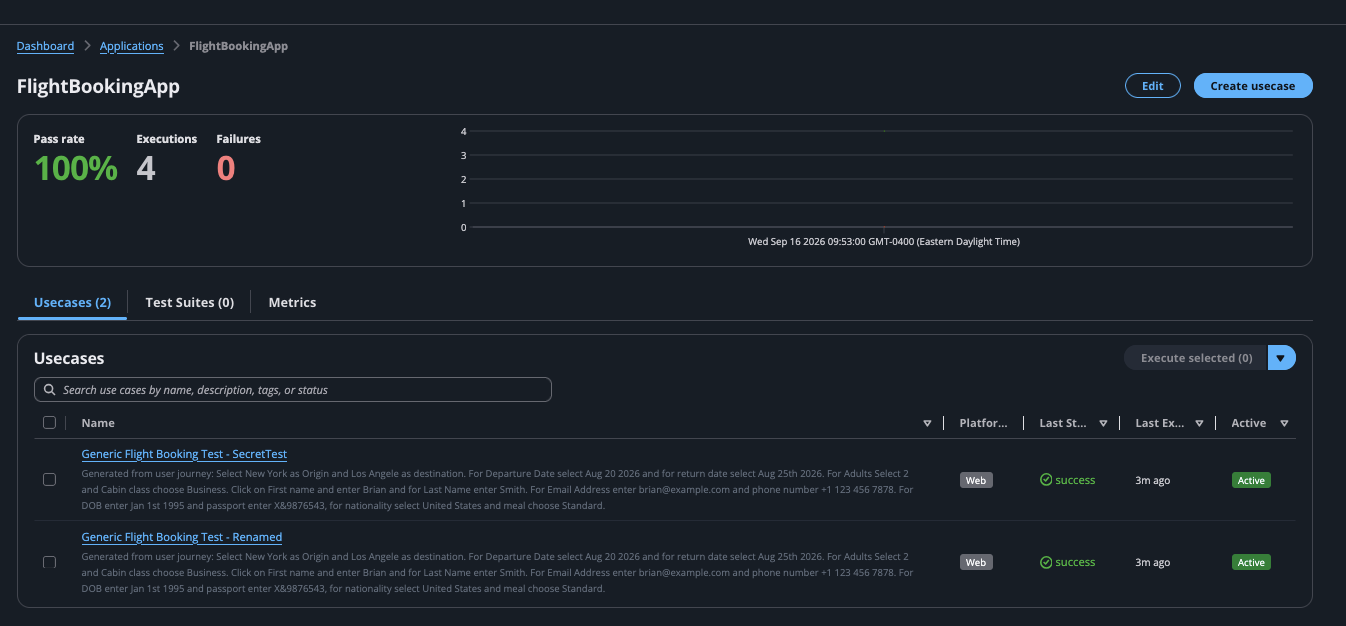
AWS stellt QA Studio vor: End-to-End-Automatisierungsplattform für Agenten-Tests basierend auf Amazon Nova Act : AWS hat die automatisierte Testsuite QA Studio veröffentlicht, die auf dem visuellen Aktionsmodell Amazon Nova Act basiert. QA-Teams können Testfälle für Benutzeroberflächen in natürlicher Sprache verfassen; KI-Agenten steuern daraufhin eigenständig reale Browser zur visuellen Navigation und End-to-End-Validierung. Instabile Flaky Tests werden mithilfe von CloudWatch-Metriken automatisch herausgefiltert, was den Wartungsaufwand von Regressionstests drastisch reduziert.(Quelle: AWS Machine Learning Blog)
Exoproc: MCP-Server ermöglicht Claude Code das Echtzeit-Hooking von Windows-x64-Prozessen : Entwickler haben mit Exoproc ein MCP-Tool veröffentlicht, das die Grenzen reiner statischer Dekompilierung überwindet. Über standardisierte MCP-Schnittstellen koppelt es Claude Code mittels Thread Hijacking und Memory-JMP-Trampolinen an laufende Windows-Prozesse. Das Tool erlaubt das dynamische Erfassen von Speicherdaten zur Laufzeit und lässt sich rückstandslos entfernen, ohne verdächtige DLLs auf der Festplatte zu hinterlegen, was Agenten neue Möglichkeiten im Reverse Engineering eröffnet.(Quelle: Reddit r/ClaudeAI)
Unsloth rüstet lokale LLMs mit autonomer Headless-Browser-Steuerung via Browser Use aus : Das Inferenz-Beschleunigungs-Framework Unsloth integriert Browser Use zur autonomen Webseitensteuerung in seine lokal quantisierten Modelle. Nach minimaler Umgebungsanpassung können On-Device-Modelle wie Qwen3.8-27B auf einer einzelnen GPU ohne menschliches Zutun Screenshots analysieren, Eingaben tätigen, Captchas lösen, Formulare ausfüllen und dynamische Diagramme rendern.(Quelle: danielhanchen)
baoyu-design v2 als Open Source veröffentlicht: Entkoppelt Claude-Design- und Dashboard-Funktionen für plattformübergreifende Modelle : Mit baoyu-design v2 steht eine Open-Source-Lösung bereit, die das visuelle Interaktions- und Generierungserlebnis von Claude Design, Slides und Dashboard nachbildet. Das Projekt löst die Bindung an Anthropics proprietäre Artifacts-Container und kann lokal mit beliebigen Open-Source-Agenten und externen LLMs betrieben werden.(Quelle: dotey)
📚 Forschung
Science-Publikation: Stanford stellt Multi-Agenten-Framework Virtual Biotech vor, um Wirkstoffforschung und klinisches Data-Mining zu revolutionieren : In einem Beitrag im Journal Science präsentierten Stanford-Forscher Virtual Biotech, ein Multi-Agenten-System, das die Organisationsstruktur realer Biotech-Unternehmen abbildet. Ein virtueller CSO orchestriert acht spezialisierte Wissenschafts-Agenten, die über das MCP-Protokoll Zugriff auf über 100 biologische Tools und Hunderte Millionen Einzelzell-Datensätze haben. Das System benötigte nur 6 Stunden für die strukturierte Kausalanalyse von fast 40.000 klinischen Studien (eine 184-fache Beschleunigung) und rekonstruierte präzise die Erfolgs- und Misserfolgsmechanismen diverser Krebs- und Immuntherapie-Targets.(Quelle: Science)

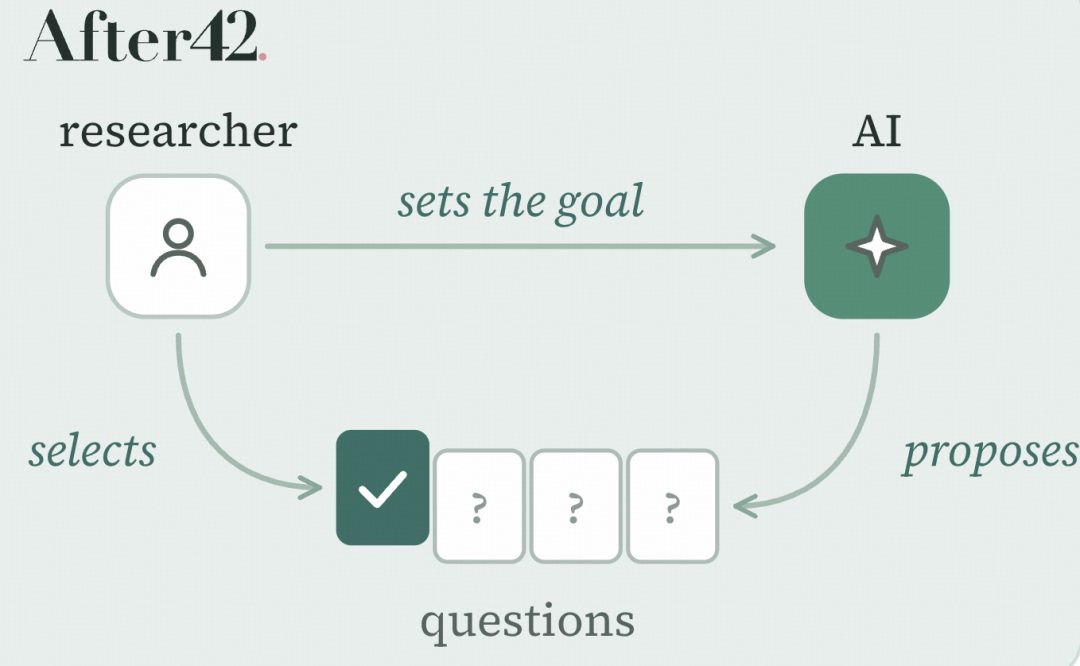
Percy Liangs Team an der Stanford University stellt After42 vor: LLMs formulieren eigenständig hochkarätige Forschungsfragen : Vor dem Hintergrund der Sorge, dass KI bekannte mathematisch-naturwissenschaftliche Probleme rasch löst und „gute Fragen knapp werden“, hat die Stanford University das Forschungssystem After42 entwickelt. Anstatt simple Prompts zu nutzen, arbeiten mehrere Agenten zusammen: Sie sichten Literatur, leiten Hypothesen her, prüfen Gegenbeispiele und iterieren Entwürfe. In multidisziplinären Tests stieg der Anteil von Fachexperten als hochrelevant eingestufter Fragestellungen von 3 % auf 33 %, was den Wert von Modellen bei der Konkretisierung diffuser Thesen belegt.(Quelle: 36氪)
NeurIPS 2026 Oral | NV-CoT: Kontinuierliche numerische Koordinaten strukturieren multimodale Visual Chain-of-Thought neu : Ein Team der NTU, USTC und Microsoft Research stellte NV-CoT (Numerical Visual Chain-of-Thought) vor. Da die Diskretisierung räumlicher Positionen in Text-Token zu geometrischen Ungenauigkeiten führt, integriert NV-CoT einen leichtgewichtigen Regressionszweig in der Ausgabeschicht, der reale Koordinaten direkt ausgibt. In Kombination mit Reparametrisierungsstrategien auf Basis der Laplace-Verteilung im RL verbesserten sich IoU-Werte und die Genauigkeit bei visuellen Frage-Antwort-Aufgaben spürbar.(Quelle: arXiv)

Fluid-Gen-Zero: Physik-Simulator direkt im latenten Raum ermöglicht trainingsfreie, physikalisch konsistente Videogenerierung : Die Simon Fraser University und Meta Reality Labs präsentierten mit Fluid-Gen-Zero ein Framework zur trainingsfreien physikalischen Videogenerierung. Ohne Modellgewichte zu modifizieren, rekonstruiert der Ansatz zunächst Szenengeometrien und übergibt sie an die Genesis-Physik-Engine. Ein VLM unterteilt die Zeitleiste nach Kontaktintensität und wendet während des Denoising eine regionsbasierte Steuerung im latenten Raum an, wodurch optische Flussfehler bei Flüssigkeiten in Tora und WanMove um 67,9 % bis 84,0 % sanken.(Quelle: arXiv)

Google DeepMind veröffentlicht erklärbaren KI-Textdetektor DetectorScope als Open Source : DeepMind und die University of Pennsylvania stellten auf der EMNLP 2026 DetectorScope vor. Statt undurchsichtiger Black-Box-Scores liefert das Tool detaillierte linguistische Indikatoren (wie Doppelpunkt-Häufungen und Präpositionen-Verteilungen). Bei ungesehenen Texten lag der F1-Score um 8 bis 12 Punkte über Binoculars. Die Arbeit legt jedoch auch Risiken offen: Kennt ein LLM diese Kriterien, reicht bereits die Umformulierung von 40 % des Inhalts aus, um den Text für den Detektor als menschlich erscheinen zu lassen.(Quelle: algo_diver)
RobotAgentBench: Erster umfassender Benchmark für Roboter in offenen Haushaltsumgebungen und dynamischer Aufgabenfindung : Aether AI und die UCSD haben den Benchmark RobotAgentBench für die Autonomie von Robotern in unstrukturierten Umgebungen vorgestellt. Anhand digitaler Zwillinge von 50 realen Haushaltsumgebungen prüft er Aufgabenidentifikation und Situationslogik bei vagen Anweisungen. Während isolierte VLA-Modelle in offenen Szenarien bis zu 88,3 % der Zeit untätig blieben, zeigten hybride Architekturen aus code-generierenden Planern und RSI signifikante Vorteile.(Quelle: arXiv)

Alibaba und SJTU veröffentlichen CutCraft: Erster Benchmark zur Ausführung professioneller Schnittanweisungen für Multi-Shot-Audio und -Video : Alibaba stellte gemeinsam mit der Shanghai Jiao Tong University und der Fudan-Universität den Benchmark CutCraft vor. Dieser verschiebt den Schwerpunkt von reiner Bildkohärenz hin zur korrekten Umsetzung filmischer Schnittgrammatik. Getestet werden 13 Montagetechniken und komplexe Übergänge; gängige Modelle scheiterten in Tests regelmäßig an zeitlichen Restriktionen, Zeitsprüngen sowie versetzten Bild-Ton-Schnitten (J/L-Cuts), was Herausforderungen für den industriellen Einsatz unterstreicht.(Quelle: WeChat)
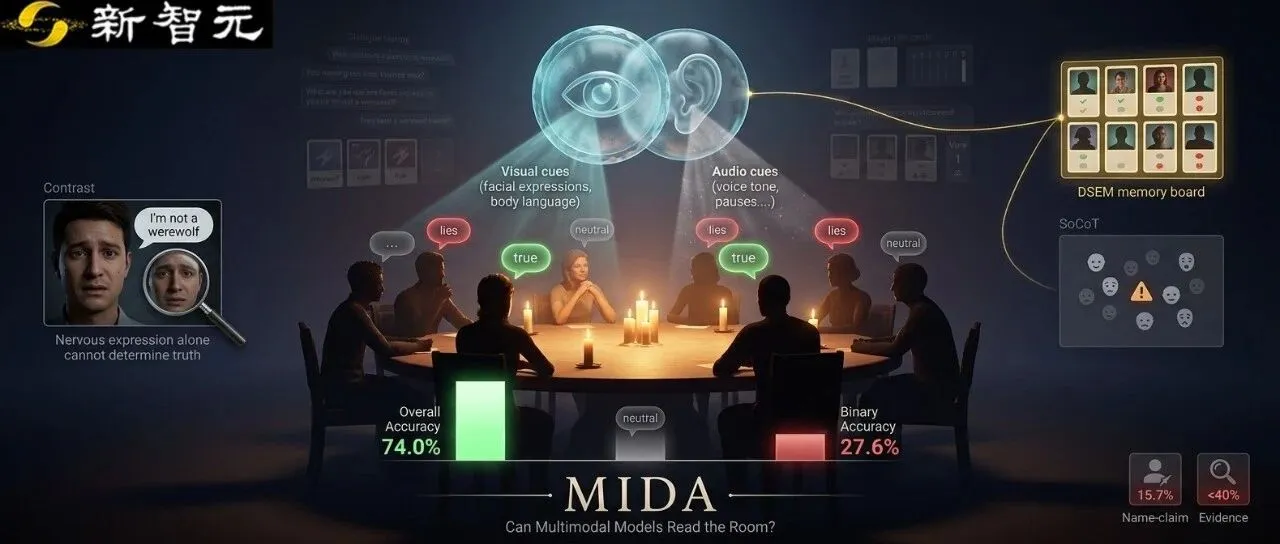
Universität Tokio stellt multimodalen Täuschungs-Benchmark MIDA vor: Frontier-Modellen fehlt es an sozialer Theory of Mind : Ein Forschungsteam der Universität Tokio präsentierte auf der Hauptkonferenz der EMNLP 2026 den Benchmark MIDA, der das unvollständige Informationsspiel „One Night Ultimate Werewolf“ als Testumgebung nutzt. Die Experimente offenbaren, dass gängige Modelle bei der binären Erkennung von Lügen lediglich Trefferquoten zwischen 27,6 % und 39,4 % erreichen. Sie scheitern daran, Wissensgrenzen und verdeckte Motive anderer Akteure abzuleiten, was zeigt, dass ein dynamisches kognitives Langzeitgedächtnis weit wichtiger ist als reine Mikroausdrucksanalysen.(Quelle: WeChat)
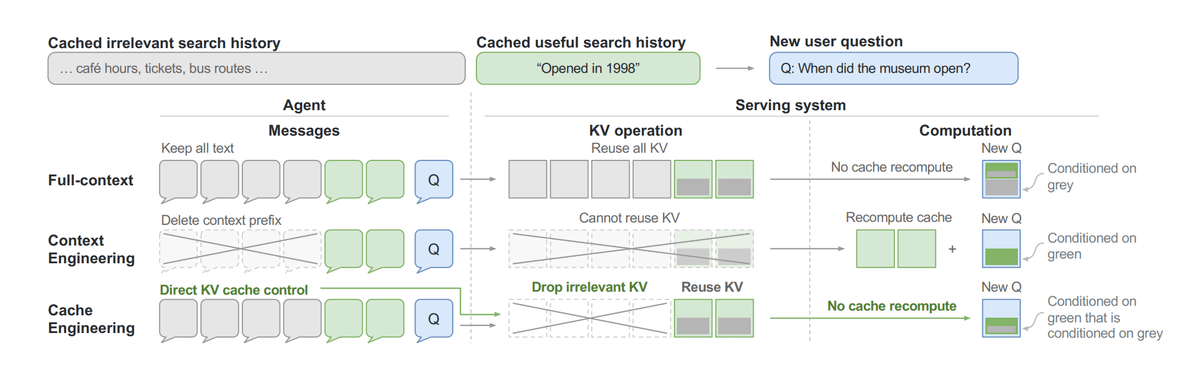
Tsinghua und CUHK stellen AKV vor: Hochleistungs-Engine zur dynamischen KV-Cache-Verwaltung für Long-Horizon-Agenten : Forscher der Tsinghua-Universität und der CUHK schlagen „Cache Engineering“ als Alternative zu herkömmlicher Kontextkompression vor. Um das wiederholte Neuberechnen des KV-Cache durch das blinde Löschen früherer Interaktionen zu verhindern, führt die Service-Engine AKV zwei Mechanismen ein: Future-Attention Pruning und adaptive Anpassungen der Positions-Encodings. Ohne den ursprünglichen Dialogtext zu beschneiden, sanken die durchschnittlichen Inferenzkosten um 27,7 % bei einem Durchsatzplus um den Faktor 1,18.(Quelle: TheTuringPost)
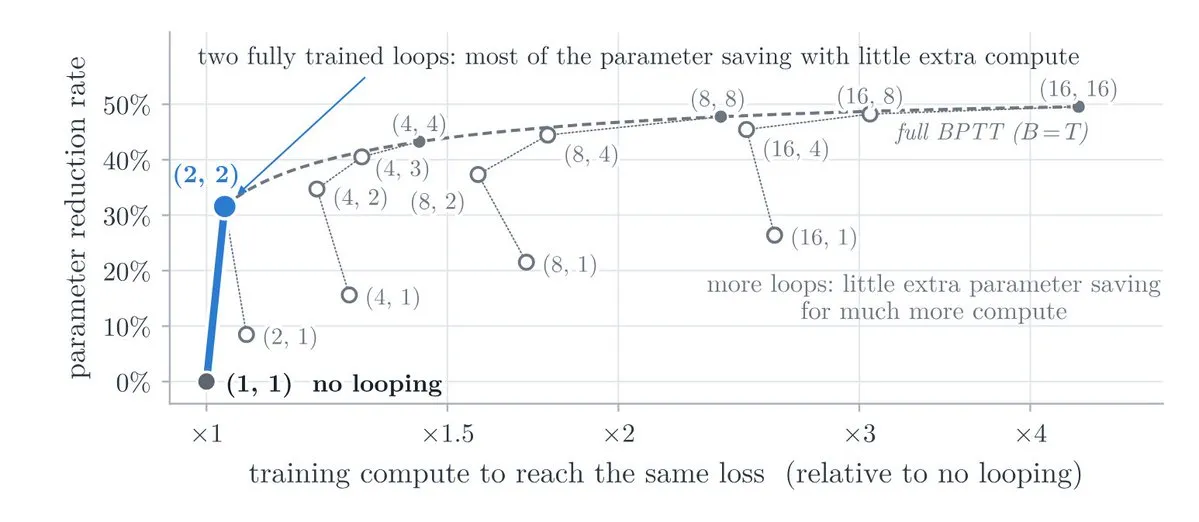
Empirische Studie zu Looped Transformers: Durchgängiges End-to-End-Training widerlegt bisherige Rechenzeit-Abkürzungen : Eine auf arXiv veröffentlichte Studie mit über 600 Experimenten zu Looped Transformers – bei denen dieselben Schichten iterativ wiederverwendet werden – zeigt, dass die gängige Praxis, zur Rechenzeitersparnis nur die letzten beiden Zyklen per Backpropagation zu trainieren, ineffizient ist. Ein vollständiges End-to-End-Training über zwei Iterationen erfordert lediglich 8 % mehr Rechenaufwand, übertrifft herkömmliche Spitzenmodelle jedoch mit 27 % weniger Parametern.(Quelle: halvarflake)
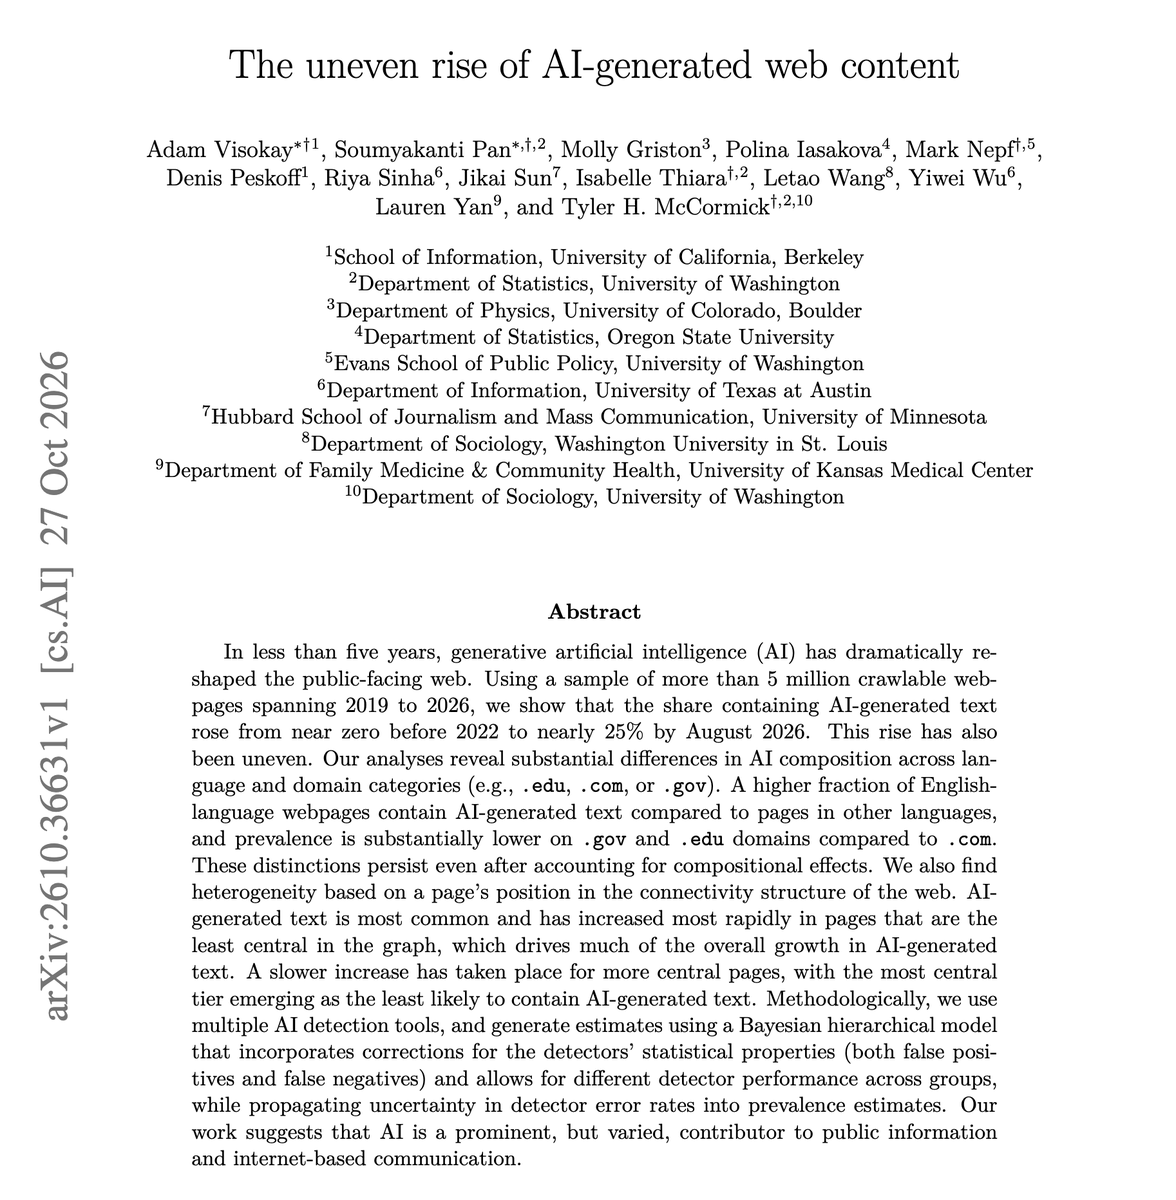
Studie der Purdue University zeigt 24 % KI-Textanteil im Web: Flut auf Long-Tail-Seiten beschleunigt Informationsverschmutzung : Eine Analyse von über 5 Millionen indexierbaren Webseiten im Zeitraum von 2019 bis 2026 belegt, dass bis August 2026 rund 24 % aller Web-Inhalte Spuren von KI-Generierung oder -Bearbeitung aufwiesen. Über 80 % dieser KI-Texte ballen sich auf Long-Tail-Websites am Rand des Netzwerkgraphen. Zudem liegt der Anteil auf kommerziellen Domains deutlich höher als auf Bildungs- und Regierungsseiten, was die Sorge vor Datendegeneration und Inzucht synthetischer Trainingsdaten künftiger Basismodelle schürt.(Quelle: omarsar0)
💼 Wirtschaft
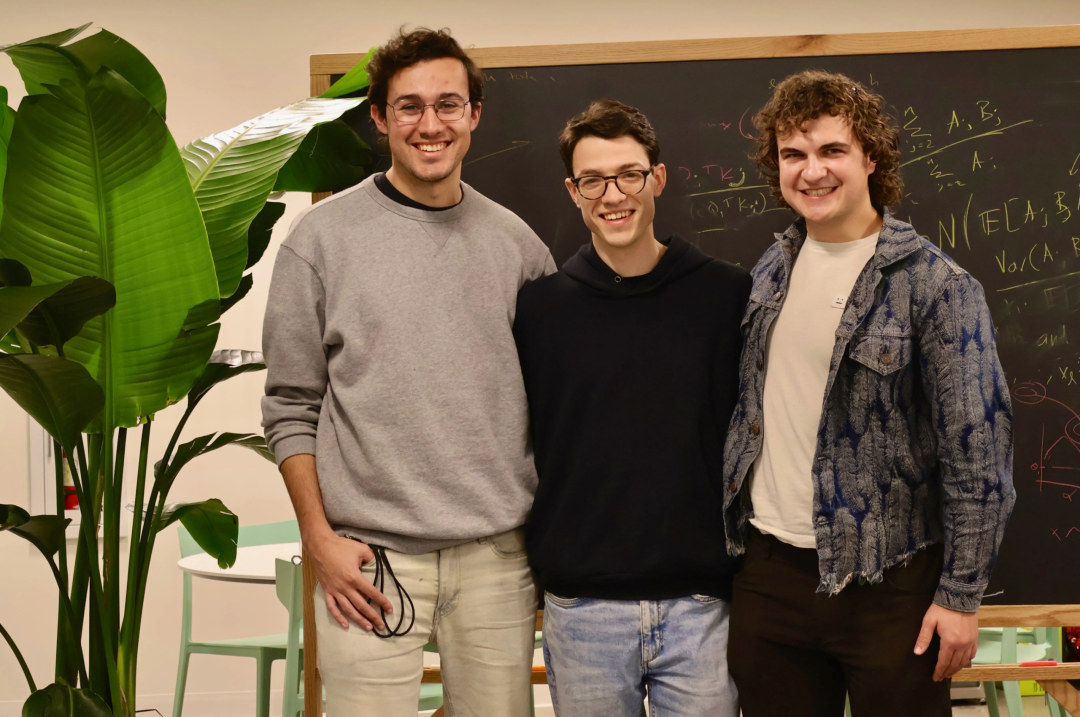
Sample-effizientes KI-Infrastruktur-Startup Flapping Airplanes sichert sich 1 Milliarde US-Dollar in Rekord-Serie-A-Runde : Das Startup Flapping Airplanes, das fundamentale Paradigmen des Gradientenabstiegs und der Verlustfunktionen im Deep Learning neu definieren will, hat eine Serie-A-Finanzierung über 1 Milliarde US-Dollar abgeschlossen. Angeführt wurde die Runde von Index Ventures und Lux Capital unter Beteiligung von Sequoia, KPCB und Nvidia. Das von den Spector-Brüdern (Stanford-Absolventen) gegründete Unternehmen will die Datenabhängigkeit von Transformern überwinden: Sein Megakernel-System fusioniert den Forward Pass vollständig auf GPU-Hardwareebene und minimiert Latenzen auf nahezu Null, um die Lerneffizienz großer Modelle an das menschliche Gehirn anzunähern.(Quelle: 36氪)
Deepgram übernimmt Daily, das Mutterunternehmen des Open-Source-Echtzeit-Audio/Video-Frameworks Pipecat, vollständig : Das Voice-AI-Infrastrukturunternehmen Deepgram hat Daily, den Entwickler des Open-Source-Echtzeit-Frameworks Pipecat, übernommen. Beide Partner sicherten zu, dass Pipecat dauerhaft Open Source und anbieterneutral bleibt. Geplant ist zudem die Einführung des offenen Protokolls „Real-Time Context Standard“ (RCS), um multimodale Metadaten in latenzarmen Audiopipelines zu standardisieren und ein durchgängiges Ökosystem aus Spracherkennung, LLM-Orchestrierung, TTS und Streaming zu schaffen.(Quelle: TechCrunch)
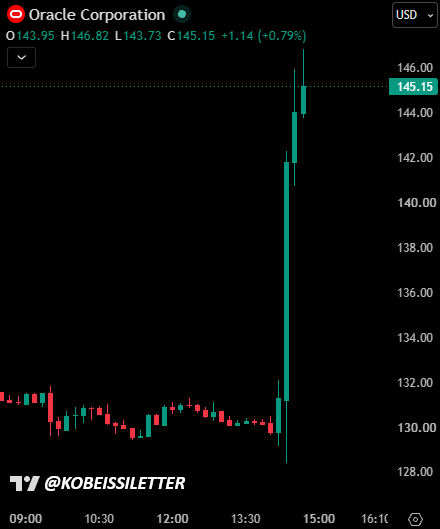
Oracle setzt Obergrenze für KI-CapEx und Finanzierung: Aktie legt gegen den Markttrend um über 10 % zu : Während viele Tech-Giganten unter dem Druck gigantischer Rechenzentrums-Investitionen auf den Cashflow ächzen, zog Oracle am Analystentag klare finanzielle Grenzen: Die KI-Investitionsausgaben (CapEx) sollen in den Geschäftsjahren 2027 bis 2028 ihren Höchststand erreichen. Bis zum Geschäftsjahr 2030 wird die externe Neuverschuldung strikt auf 20 Milliarden US-Dollar begrenzt; der freie Cashflow soll in der zweiten Hälfte des Geschäftsjahres 2028 wieder positiv werden. Die Märkte honorierten die disziplinierte Kapitalallokation mit einem Kurssprung von 10,73 %.(Quelle: damianvtran)
🌟 Community
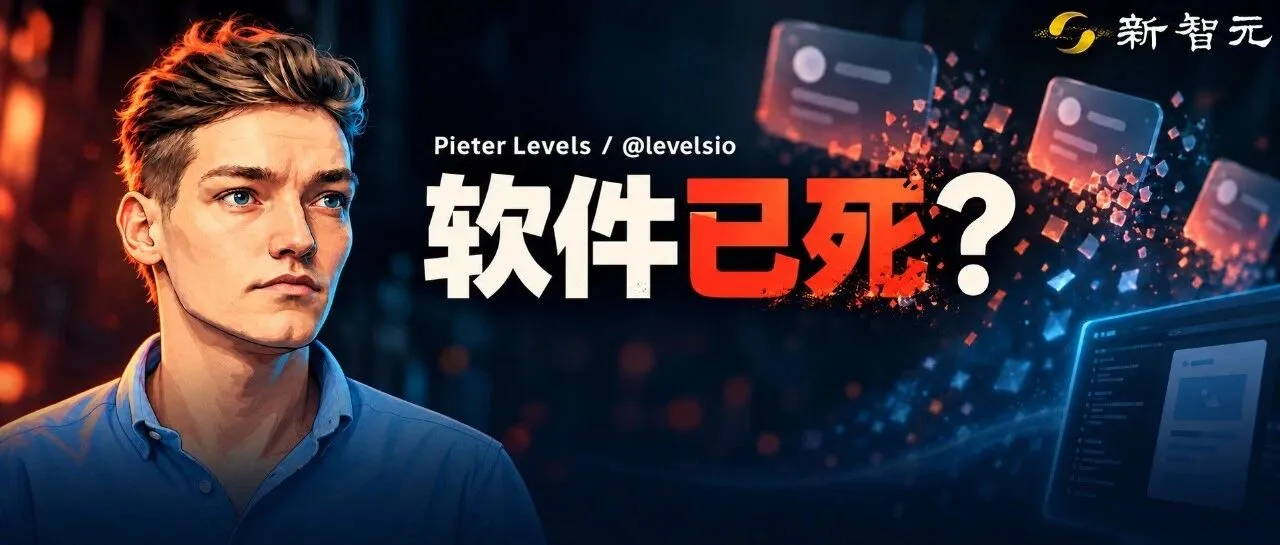
Indie-Hacker-Ikone Pieter Levels kündigt die meisten kommerziellen SaaS-Abos: „On-Demand-Entwicklung“ bricht mit dem Abomodell : Der bekannte Solo-Entwickler Pieter Levels gab bekannt, fast alle kommerziellen SaaS-Abonnements für sein operatives Tagesgeschäft gekündigt zu haben. Stattdessen setzt er auf Coding-Agenten wie Claude Code, um leichtgewichtige Tools bei Bedarf ad hoc zu schreiben oder Open-Source-Projekte anzupassen. Durch den Leistungssprung autonomer Programmierassistenten gerate das Modell überladener, monatlich abgerechneter Software-Abos ins Wanken – das Zeitalter maßgeschneiderter Software nach dem Prinzip „Generieren, Nutzen, Verwerfen“ habe begonnen.(Quelle: WeChat)
FrontierCode 2.0-Datenbank leakt verborgenes Modell „Obsidian 3“ – mutmaßlich neues Flaggschiff von Anthropic : In der Datenbank des renommierten Programmier-Benchmarks FrontierCode 2.0 wurden versehentlich Testeinträge eines Modells mit dem Codenamen „Obsidian 3“ öffentlich. Mit 46,8 % bei hoher Reasoning-Intensität übertraf es den bisherigen Spitzenreiter Claude Opus 5.5 (45,5 %); die Testumgebung weist starke Bindungen an das Claude-Framework auf. In der Community wird allgemein vermutet, dass es sich um Anthropics nächstes Flaggschiff Claude Fable 5.5 handelt.(Quelle: imjaredz)
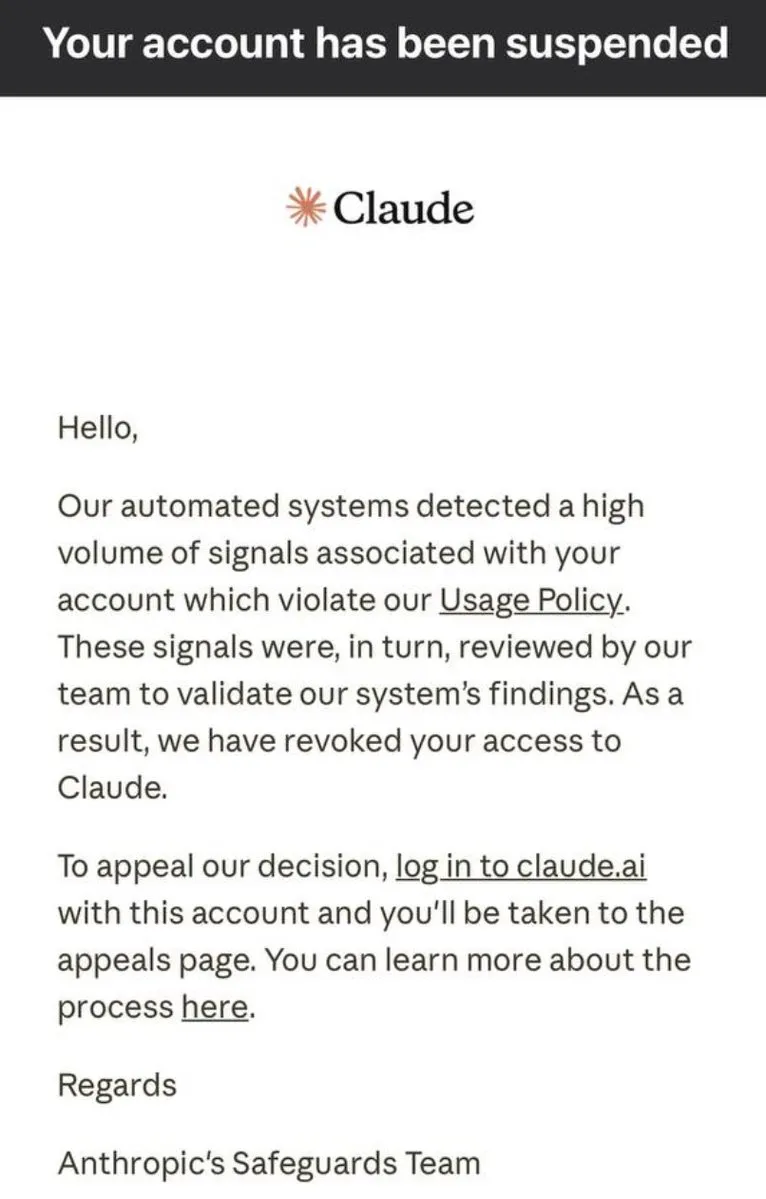
Anthropic verschärft Pass-KYC-Prüfung im Ausland und löst Sperrwelle bei grenzüberschreitenden Entwicklern aus : Entwickler berichten, dass Anthropic in bestimmten Regionen strenge KYC-Prüfungen mittels Reisepass verlangt. Konten von Inhabern Pässen sanktionierter Staaten wie Russland wurden selbst dann gesperrt, wenn der Wohnsitz nachweislich und dauerhaft in regulierten Ländern wie Neuseeland lag. Dies schürt erneute Debatten über geopolitische Risiken, Zugriffssicherheit und die Unberechenbarkeit proprietärer Modellplattformen.(Quelle: teortaxesTex)
KI-gestütztes Reverse-Engineering entfacht Hype in der Retro-Gaming-Community: Urheberrechtsgrenzen erneut auf dem Prüfstand : Soziale Netzwerke verzeichnen eine Welle von „Game-Mashups“, die mithilfe von LLMs wie Claude durch Dekompilierung und Portierung entstanden sind (etwa Cities: Skylines in Minecraft oder plattformübergreifende Emulatoren). Moderne Modelle senken die Hürden des binären Reverse Engineerings erheblich: Was früher Monate dauerte, gelingt nun über Nacht. Dies stellt Spielehersteller vor massive Probleme bezüglich Urheberrechten, Privatservern und dem Schutz proprietären Codes.(Quelle: The Guardian)

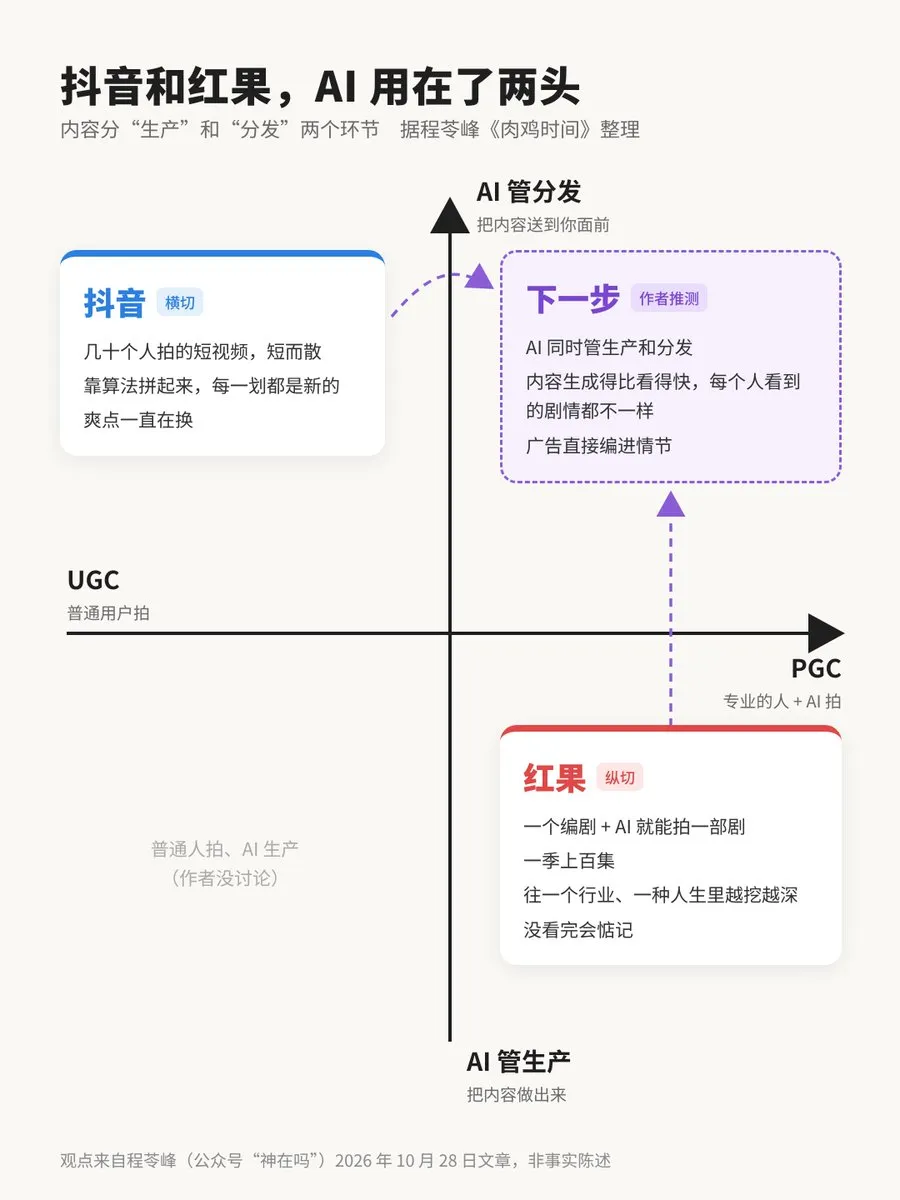
Hongguo-Kurzdramen überschreiten 168 Millionen DAU und entfachen Debatte: KI-Kurzdramen als Content-Explosion oder Aufmerksamkeitsfalle? : Die Medienkommentatoren Qin Shuo und Cheng Lingfeng lieferten sich eine Grundsatzdebatte über die Plattform Hongguo, die mit ihren KI-Kurzdramen 168 Millionen täglich aktive Nutzer (DAU) bei einer durchschnittlichen Nutzungsdauer von 125 Minuten verzeichnet. Während Kritiker vor einem suchterzeugenden „Zeitfresser“ warnen, der kognitive Tiefe verdränge, heben Befürworter hervor, dass KI Drehbuch, Produktion und Distribution extrem verbilligt habe. Traditionelle Reichweitenmodelle würden umgewälzt; denkbar sei künftig eine K-förmige Spaltung in kostenlose algorithmische Betäubung und hochpreisige exklusive Bildungsinhalte.(Quelle: dotey)
Zwei Teenager entwickeln FPV-Videorestaurierungs-Tool mit rein handgeschriebenem Code: Absage an „Vibe Coding“ regt zum Umdenken an : Zwei 10 und 14 Jahre alte Entwickler haben innerhalb von zwei Stunden die ML-Software DVR Doctor entwickelt, die Bildstörungen analoger FPV-Drohnenübertragungen korrigiert. Im Interview betonten beide, dass sie KI zwar zum Erlernen von APIs und Bibliotheken nutzten, die Kernalgorithmen für optischen Fluss und Pixelrekonstruktion jedoch bewusst per Hand schrieben und „Vibe Coding“ ablehnten. Dies löste unter Ingenieuren Diskussionen darüber aus, ob die übermäßige Abhängigkeit von generierter Software das fundamentale Systemverständnis erstickt.(Quelle: simonw)
💡 Sonstiges
US-Justizministerium leitet Kartelluntersuchung zur geplanten 13-Milliarden-Dollar-Übernahme von Hugging Face durch Nvidia ein : Insidern zufolge prüft das US-Justizministerium (DOJ) kartellrechtliche Bedenken bezüglich der geplanten Übernahme von Hugging Face durch Nvidia für 13 Milliarden US-Dollar. Die Ermittler untersuchen insbesondere, ob Nvidia die marktbeherrschende Stellung der Plattform bei der Entwickler- und Modellverteilung nutzen könnte, um eigene Hardware und das CUDA-Ökosystem exklusiv zu bündeln und so Konkurrenten bei KI-Beschleunigern zu benachteiligen.(Quelle: The Verge)
US-Regierung vergibt 5 Milliarden US-Dollar Darlehen für Ausbau von Kernkraftwerken: Gesamter Strom exklusiv für AI-Rechenzentren der Tech-Giganten bestimmt : Das US-Energieministerium hat eine Kreditgarantie über 5 Milliarden US-Dollar für Constellation Energy finalisiert. Die Mittel dienen der Laufzeitverlängerung und Leistungssteigerung von acht Kernkraftwerksblöcken, was 1,1 Gigawatt CO₂-freie Grundlastleistung freisetzen soll. Die gesamte zusätzliche Kapazität wurde bereits vorab von Hyperscalern wie Google, Meta und Amazon für deren KI-Rechenzentren vertraglich gesichert, was den enormen Energiehunger der expandierenden Recheninfrastruktur unterstreicht.(Quelle: TechCrunch)
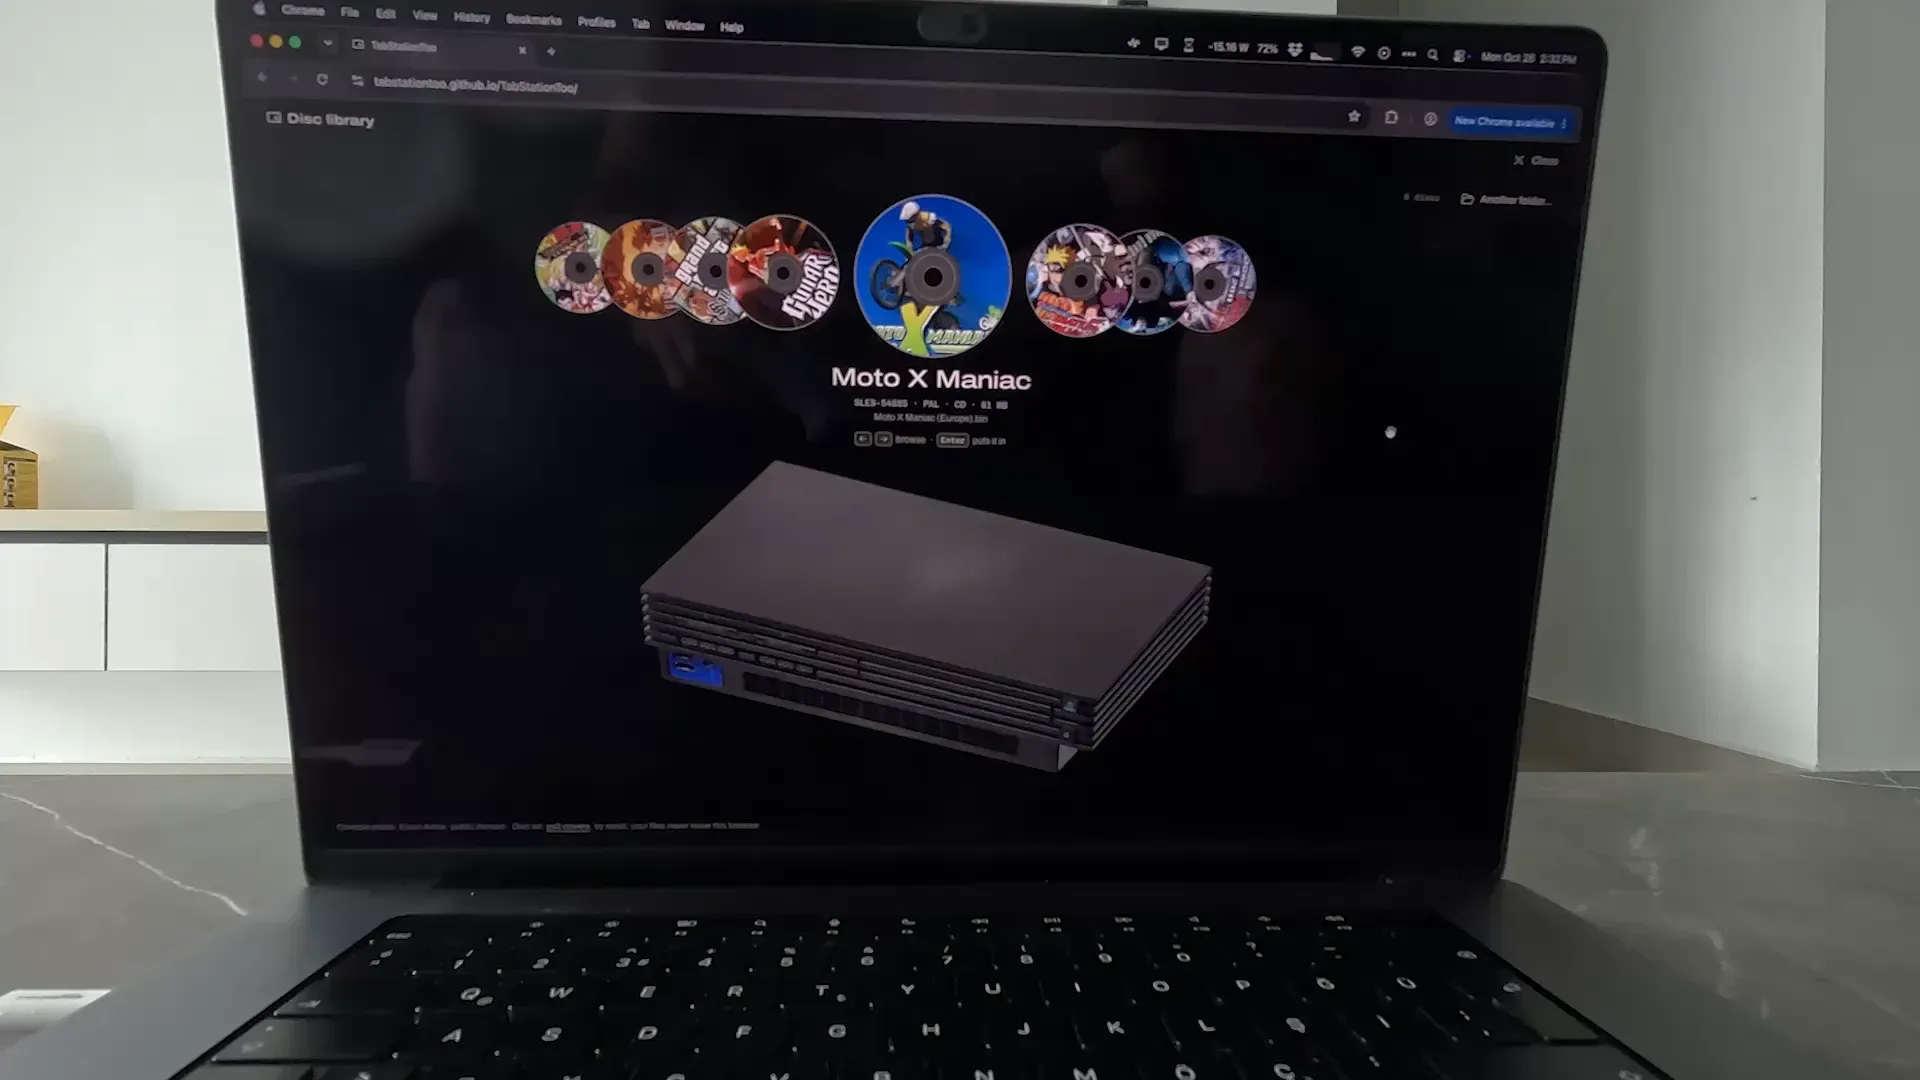
Entwickler bauen browsernativen PS2-Emulator mit Claude Opus 5.5 : Ein Entwicklerteam hat das Open-Source-Projekt TabStationToo veröffentlicht. In enger Zusammenarbeit mit Claude Opus 5.5 wurde der Kern des Emulators PCSX2 neu strukturiert und vollständig in direkt im Browser ausführbaren WebAssembly- und WebGPU-Code übersetzt. Anwender können lokale ISO-Images einfach in Chrome laden und Klassiker ohne Installation mit voller Geschwindigkeit spielen, was die Leistungsfähigkeit aktueller Spitzenmodelle bei komplexen Software-Portierungen demonstriert.(Quelle: Reddit r/ClaudeAI)