🔥 À la une
Google DeepMind dévoile par surprise son nouveau modèle phare Gemini 4 Carbon, se hisse en tête de l’Intelligence Index d’AA et suscite de vifs débats sur la sécurité et les benchmarks : À peine deux semaines après le lancement de Gemini 4 Argon, Google DeepMind a surpris tout le monde avec son nouveau modèle phare, Gemini 4 Carbon. Lors de la dernière évaluation Intelligence Index v5 publiée par l’organisme de référence Artificial Analysis, Carbon a obtenu 59 points, devançant Claude Opus 5.5 (58 points) et GPT-6 Astra pour s’emparer de la première place, tout en décrochant le premier rang dans 15 des 17 catégories d’aptitudes clés évaluées. Spécifiquement conçu pour l’exécution de tâches autonomes de longue durée et la cybersécurité, le modèle prend en charge la détection de bugs furtifs à travers de multiples bases de code. Il a pulvérisé tous les records sur SEC-bench Pro (détection de vulnérabilités à 88,2 %), ExploitGym (vérification d’exploits à 54,8 %) et CWE-bench (génération de correctifs à 71,0 %), avec un taux de neutralisation des injections indirectes de prompts atteignant 100 %. En raison de ses capacités offensives et défensives extrêmes, Carbon n’est accessible dans un premier temps qu’à des acteurs de confiance en cybersécurité défensive, tout en conservant la tarification avantageuse d’Argon (2 $/M de tokens en entrée, 10 $/M en sortie). Dans le même temps, l’introduction dans AA v5 de jeux de tests privés non publics ayant provoqué une chute du classement des modèles open source, de vifs débats ont éclaté au sein de la communauté quant à un éventuel surapprentissage ciblé (Benchmaxxing) et à un biais commercial.(Source : Google DeepMind Blog, THE DECODER, GoogleDeepMind, Reddit r/ClaudeAI)
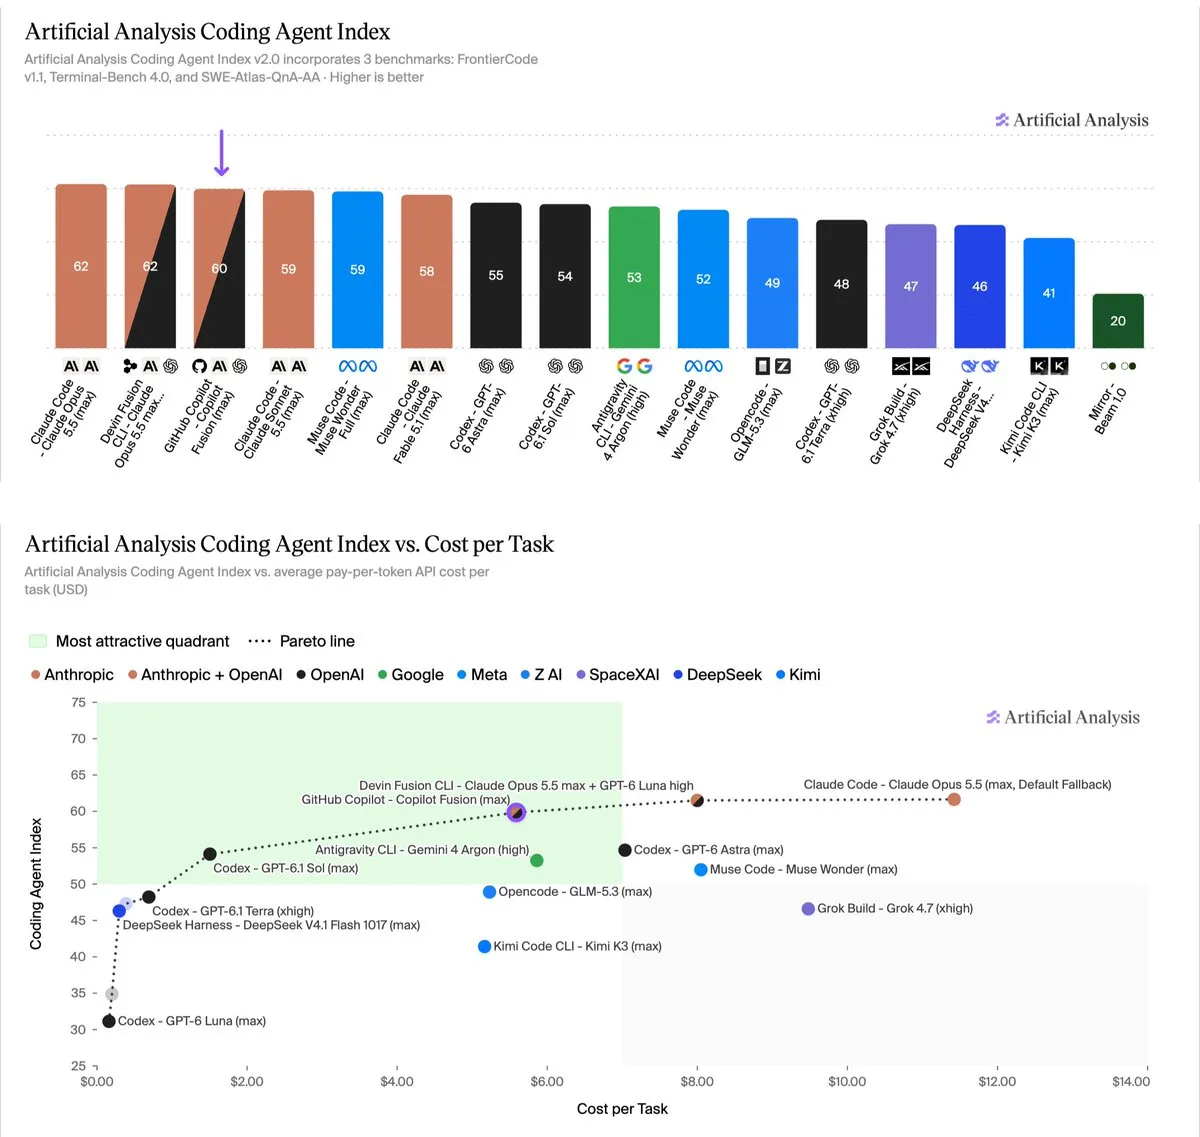
Mistral passe officiellement en open source son fleuron à mille milliards de paramètres « Le Chonk », redéfinissant le paysage concurrentiel du code open source et de la cybersécurité : La licorne française d’IA Mistral a officiellement publié en open source les poids de son modèle phare à mille milliards de paramètres, Mistral Large 4 (ML4, nom de code Le Chonk). Après trois semaines d’apprentissage par renforcement intensif, ML4 a bondi à 41 % sur Terminal-Bench 4.0 et a égalé GLM-5.3 sur l’AA Coding Agent Index avec un score de 48 points, tout en réduisant la consommation moyenne de tokens par tâche de 47 % et en proposant trois modes de raisonnement (Low/Medium/High). Dans le domaine de la cybersécurité défensive, ML4 a pris la tête de l’AA Cyber Index avec un score de 51 % et un taux d’interception des requêtes d’attaques réseau malveillantes de 96,6 %. Entraîné de zéro sur des infrastructures européennes souveraines, le modèle est d’ores et déjà déployé sur Nvidia, Microsoft Foundry, vLLM et SGLang, établissant un nouveau standard pour l’IA souveraine et l’écosystème open source mondial face aux géants propriétaires américains et chinois.(Source : Mistral AI, ZDNet)
Microsoft et GitHub refondent Copilot et dévoilent Copilot Fusion, propulsant le génie logiciel vers une collaboration d’agents de bout en bout : Lors de la conférence GitHub Universe 2026, Microsoft et GitHub ont annoncé l’évolution majeure de Copilot, passant d’un assistant passif d’autocomplétion à une plateforme d’agents de bout en bout couvrant l’ensemble du cycle de développement logiciel (Agentic SDLC : build, revue et déploiement). L’événement a mis en lumière le système d’orchestration d’exécution Copilot Fusion, capable de router dynamiquement les requêtes de manière hybride entre Claude Opus 5.5, Sonnet 5.5, GPT-6 Astra et Sol en fonction de la complexité des tâches, réduisant les coûts de 50 % par tâche tout en maintenant des performances de codage d’élite, culminant en tête de Terminal-Bench 4.0 avec un score de 71 points. La conférence a également introduit la fonctionnalité Code Review niveau Max avec revue multi-modèle conjointe, la correction automatique de conflits « Watch and fix », Copilot Projects, ainsi que l’intégration native dans VS Code 1.144 de primitives de génération d’images avec GPT Image 2.5 Flare.(Source : code, VentureBeat, Reddit r/artificial)
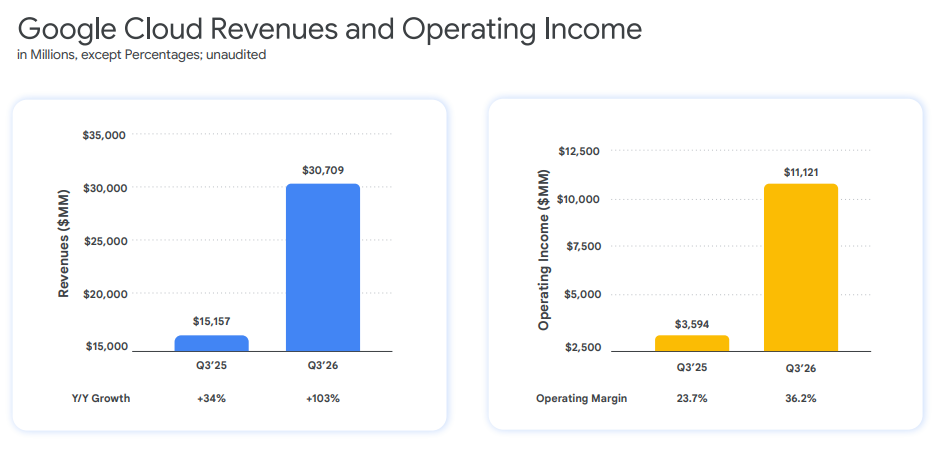
Microsoft et Alphabet publient leurs résultats financiers le même jour : les revenus du cloud et du calcul IA doublent, les tensions s’accentuent entre des dépenses d’investissement de centaines de milliards et le ROI : Microsoft et Alphabet ont publié simultanément leurs résultats financiers trimestriels. Pour la première fois de son histoire, Microsoft a divulgué séparément les revenus réels d’Azure, qui ont atteint 33,2 milliards de dollars (+48 % sur un an), les partenariats commerciaux avec OpenAI rapportant 10 milliards de dollars (près de 11 % du chiffre d’affaires total de Microsoft), pour des dépenses d’investissement (CapEx) de 45,2 milliards de dollars sur le trimestre. De son côté, Google Cloud (Alphabet), porté par une forte demande en clusters de calcul et systèmes TPU, a vu son chiffre d’affaires trimestriel bondir de 103 % à 30,709 milliards de dollars ; toutefois, la flambée de 114 % de ses dépenses d’investissement à 51,355 milliards de dollars a fait plonger son flux de trésorerie disponible (free cash flow) à un déficit de -9,065 milliards de dollars, tandis que la monétisation de la recherche assistée par IA reste inférieure à celle de la recherche web classique, provoquant une chute de près de 10 % de l’action Alphabet après la clôture. Les résultats de ces deux géants illustrent concrètement l’effet d’entraînement de la consommation de tokens, mais soulignent aussi l’arbitrage difficile entre des dépenses d’infrastructure de plusieurs centaines de milliards de dollars et le retour sur investissement réel.(Source : TechCrunch, THE DECODER, bookwormengr)
OpenAI prévoit d’acheter des puces TPU à son rival Google, les géants de pointe accélèrent la diversification de leurs infrastructures de calcul : Selon Reuters et The Information, OpenAI envisage d’acquérir des puces TPU (Tensor Processing Unit) développées en interne par Google pour étendre ses capacités de calcul et réduire sa dépendance exclusive aux GPU Nvidia. Précédemment, OpenAI avait déjà déployé des modèles avancés sur Google Cloud et testé la location de clusters TPU. Cette démarche illustre l’émergence d’un réseau complexe de « coopétition » d’approvisionnement entre laboratoires de pointe et fournisseurs de cloud, à l’heure où les dépenses d’investissement annuelles des grands hyperscalers frôlent les 600 milliards de dollars, poussant les leaders de l’IA à accélérer la diversification stratégique de leurs infrastructures.(Source : Reddit r/artificial)
🎯 Tendances
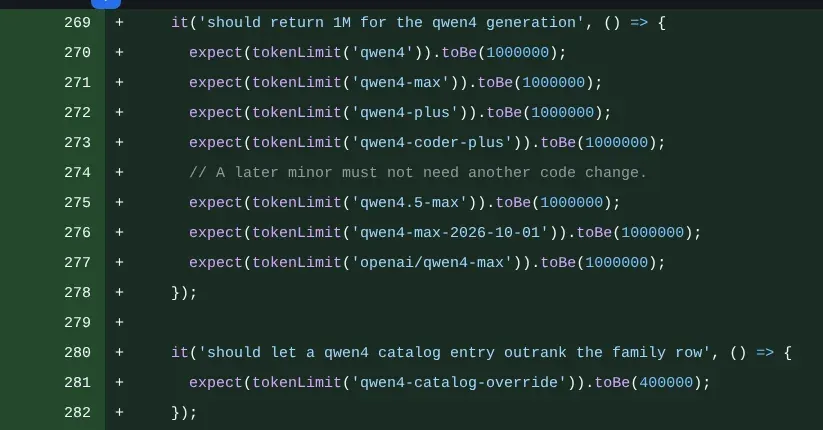
Alibaba Cloud confirme la sortie officielle de Qwen4 pour la semaine prochaine, avec un support natif d’une fenêtre de contexte de 1M : Lors de la conférence Apsara organisée à Amsterdam, le CTO d’Alibaba Cloud a confirmé aux participants le lancement officiel la semaine prochaine de son modèle phare de nouvelle génération, Qwen4. Une pull request sur le dépôt de code officiel a simultanément révélé les conventions de nommage et les caractéristiques techniques : la gamme prendra en charge nativement une fenêtre de contexte ultra-longue d’un million de tokens et débutera avec une version à 27B de paramètres ainsi qu’une variante capable de raisonnement long cours, Qwen4-omni-120b-think, suscitant de grandes attentes dans la communauté open source.(Source : Reddit r/LocalLLaMA)
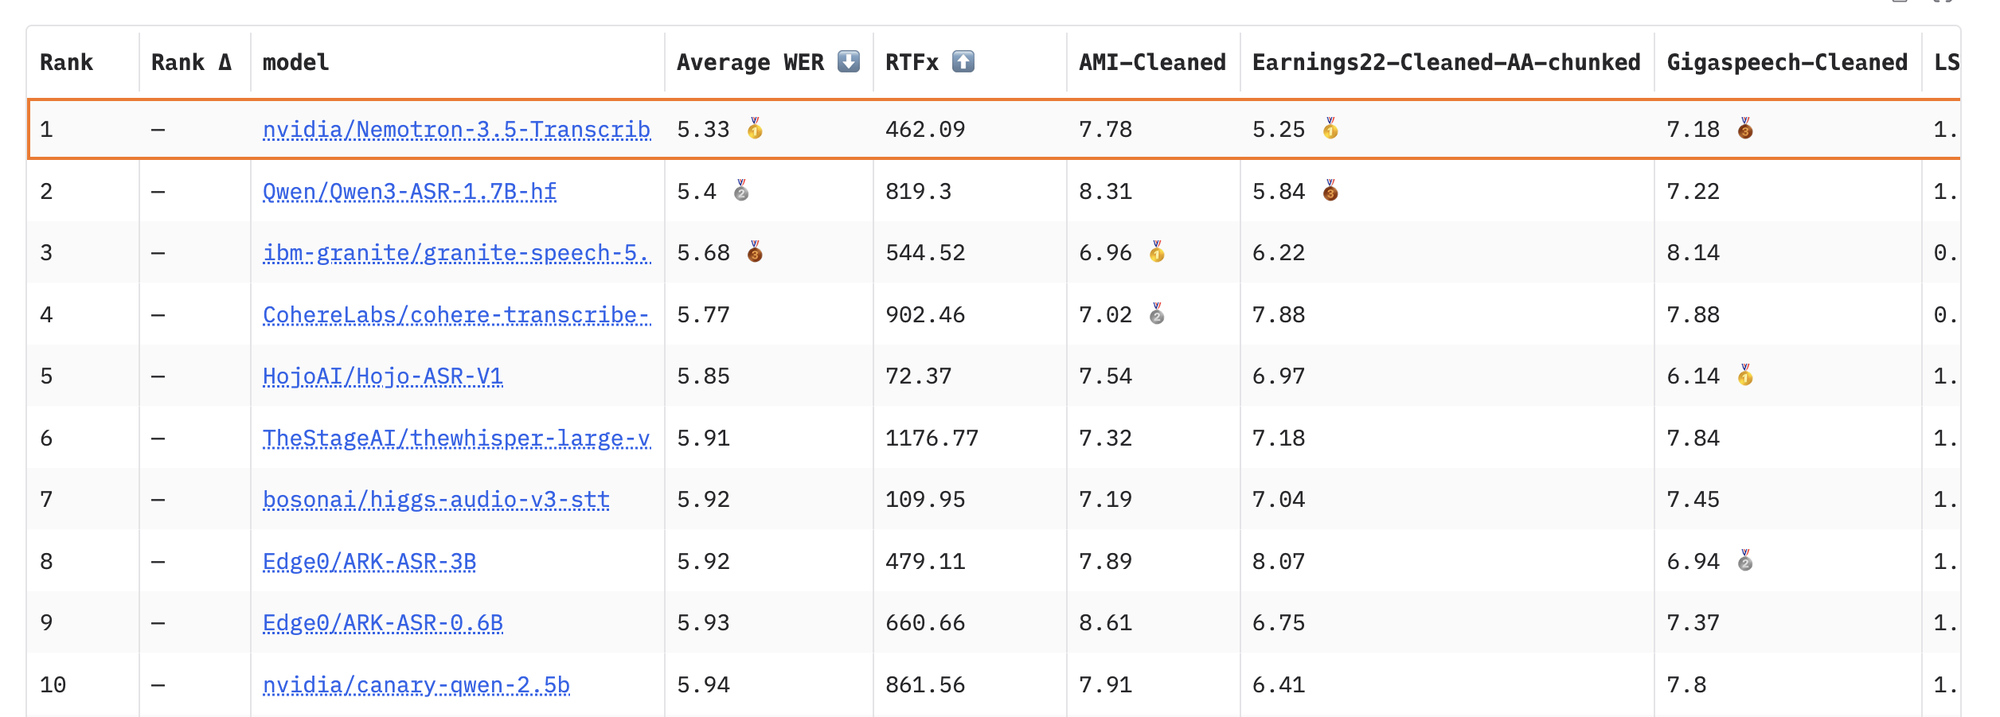
Nvidia publie en open source son modèle MoE de transcription vocale 30B Nemotron 3.5 Transcribe ainsi que le jeu de données Granary v2 : Nvidia a rendu public son premier grand modèle de fondation audio dédié à la transcription avancée, Nemotron 3.5 Transcribe (34B de paramètres totaux, ~4,3B activés), accompagné du jeu de données multilingue de 844 000 heures Granary v2. Utilisant une architecture MoE hybride Mamba-Transformer, le modèle réalise en une seule passe la transcription de 40 langues, la traduction vers 31 langues, la diarisation jusqu’à 8 locuteurs et l’alignement temporel au niveau du mot. Il affiche un taux d’erreur sur les mots (WER) de 2,8 % sur le benchmark AA-WER, s’emparant de la 1ère place des modèles vocaux open source non-streaming, avec support de la quantification BF16 et NVFP4.(Source : HuggingFace Blog, ClementDelangue)
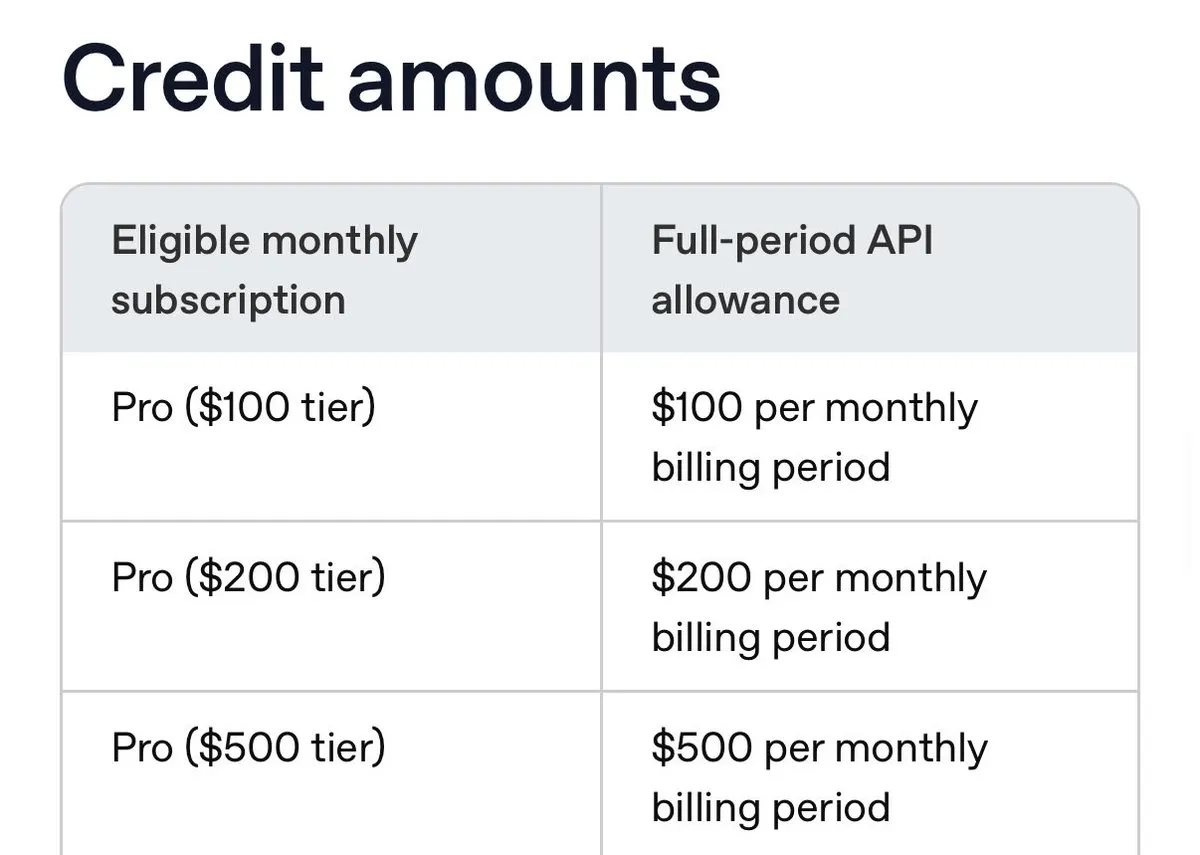
OpenAI accorde jusqu’à 500 $ de crédits API mensuels gratuits aux abonnés ChatGPT Pro et Business : OpenAI a mis en place une stratégie de fidélisation de ses abonnés payants : les utilisateurs de ChatGPT Pro reçoivent un remboursement mensuel équivalent de 100 à 200 $ en crédits API, tandis que les espaces de travail d’entreprise Business bénéficient d’un pool mutualisé par siège allant jusqu’à 500 $/mois. Ces crédits sont valables sur Responses, Realtime audio et les interfaces de l’Agents API, réinitialisés chaque fin de mois. Cette décision est interprétée comme une manœuvre offensive pour contrer les baisses de tarifs d’Anthropic. Parallèlement, OpenAI a fusionné les entrées Chat et Work sur son application desktop et a réduit, à compter du 30 octobre, les quotas d’utilisation web de Codex pour le palier Pro 200 à 10 fois ceux de Plus.(Source : OpenAI News, OpenAIDevs)
Agibot dévoile son modèle d’IA incarnée GO-3 Preview, couvrant toute la chaîne de scaling du pré-entraînement au post-déploiement : Agibot a officiellement présenté GO-3 Preview, un modèle de fondation incarné doté d’une capacité d’apprentissage à grande échelle sur l’ensemble de son cycle de vie, s’adjugeant la tête des benchmarks RoboDojo, RoboTwin et RoboColiseum. Son architecture intègre le modèle maison WRAM (World Reasoning Action Model), combinant prédiction visuelle future en une étape et contrôle dynamique. La phase de post-entraînement s’appuie sur l’infrastructure à triple moteur Genie Evolver, réduisant le taux de défaillance moyen de 86 %, et a validé l’auto-évolution Physical RSI en conditions réelles de magasin de proximité. Les poids seront intégralement publiés en open source d’ici la fin de l’année.(Source : JiQizhixin, 36Kr)

Hyper-Scale AI lance le modèle de fondation auto-évolutif Apex-35B-V1.0 de 35B, surpassant des modèles géants en recherche scientifique grâce au RSI : Fondée par Chen Yongchao, professeur adjoint à l’Institut d’intelligence artificielle de l’Université Tsinghua, la startup Hyper-Scale AI a dévoilé Apex-35B-V1.0, son premier modèle de fondation à l’échelle de 35B de paramètres. Son système propriétaire d’agents de recherche Apex Research a participé activement à la structuration des données, aux itérations de protocoles expérimentaux et aux optimisations au niveau des opérateurs. Sur 21 benchmarks complets, il surpasse les modèles de référence open source de taille équivalente sur 20 d’entre eux, et devance nettement certains modèles comptant des centaines de milliards de paramètres dans la résolution de problèmes scientifiques de pointe (40,0 sur FrontierScience) et la reproduction d’articles de recherche (60,9 sur PaperBench).(Source : JiQizhixin, realDanFu)

X-Era AI publie en open source le modèle d’action mondial 4D natif E0.5, améliorant fortement la généralisation sur robots réels par projection géométrique : X-Era AI (Tuoyuan Zhihui) a mis en open source son modèle d’action mondial natif E0.5. L’architecture utilise des représentations géométriques 3D comme ossature : tout en apprenant les actions, elle prédit directement la profondeur 3D future, la structure en nuage de points et la pose de caméra correspondant à la fin de la manipulation, formant ainsi une boucle de validation spatiale. Lors de tests complexes impliquant des corps rigides et le rangement de câbles flexibles, E0.5 a atteint des taux de succès globaux de 85,0 % et 88,3 % sur les robots AgileX Piper et Zerith H1, augmentant la réussite en généralisation hors-distribution (OOD) de 10 à 30 points de pourcentage par rapport à la base π0.5.(Source : JiQizhixin)

LimX Dynamics met à jour le rapport technique de FluxVLA Engine V2, unissant RL en ligne pour IA incarnée et accélération matérielle-logicielle : LimX Dynamics a publié le rapport technique de sa plateforme open source d’IA incarnée FluxVLA Engine V2. Cette nouvelle version intègre principalement un post-entraînement PPO en ligne avec politique de flow matching basé sur RLinf, augmentant le taux de succès du modèle de 10 à 15,4 points de pourcentage sur les tâches LIBERO-10 et RoboTwin. En sous-couche, l’introduction de la coordination par blocs d’action en temps réel (RTC) et d’un post-traitement des trajectoires élimine les secousses mécaniques matérielles sur les manipulations longues, accélérant la fréquence d’inférence jusqu’à 9,64 fois sans modifier les poids, et validant une boucle fermée sur le robot humanoïde grandeur nature LimX Oli.(Source : QbitAI)
Geek+ dévoile Gravity Control : un modèle d’intervention causale pour corriger les mouvements par le langage sans modifier les poids : Au sein de son framework d’IA incarnée Gravity, Geek+ a publié le modèle d’intervention causale Gravity Control. Pour résoudre le problème des échecs hors-distribution causés par de légères perturbations, la solution s’appuie sur des autoencodeurs creux pour isoler les représentations de contrôle profondes dans les couches d’experts de mouvement. Une simple consigne en langage naturel de l’opérateur (ex. « saisir un peu plus profondément ») permet au système d’effectuer une intervention locale directe en ligne durant l’inférence, faisant bondir le taux de réussite sur tâches complexes de 17,5 % à 87,5 % sans altérer les poids du modèle de base.(Source : 36Kr)
ModelBest publie le modèle OCR 1.3B pour appareils edge MiniCPM-OCR 1.0 et son modèle de contrôle qualité dédié Jev : ModelBest a publié en open source MiniCPM-OCR 1.0, un modèle de fondation léger d’analyse de documents. Avec seulement 1,3B de paramètres, il a obtenu un score de 93,68 points sur le test industriel Real5-OmniDocBench, traitant 1,22 page par seconde sur un seul GPU. Parallèlement, ModelBest a proposé une architecture d’« OCR de confiance » et rendu open source MiniCPM-OCR Jev (2B), un modèle d’arbitrage dédié qui valide la qualité de reconnaissance en quelques millisecondes pendant l’inférence et ordonne des relectures ciblées, dissociant exécution de l’analyse et contrôle qualité, et éliminant ainsi les hallucinations sur terminal ainsi que la charge d’une relecture humaine exhaustive.(Source : WeChat)
Tencent dévoile l’écosystème de collaboration cross-applications Buddy One et publie en open source le modèle mondial interactif Hy-Nomas : Lors du Global Digital Ecosystem Summit 2026, Tencent a présenté son écosystème collaboratif personnel cross-applications Buddy One. Grâce à un Buddy One ID synchronisé et un pool de points unifié, il relie la recherche contextuelle et le stockage entre Tencent Docs, Meetings, Cloud Drive et ima. Tencent a également annoncé l’arrivée prochaine de son modèle de vision natif Hunyuan Hy4 de 770B (49B activés). De plus, l’équipe Hunyuan a officiellement publié sur Hugging Face le modèle mondial vidéo interactif Hy-Nomas, permettant d’intervenir en temps réel via clavier/souris sur la météo, les mouvements de caméra et les animations des personnages.(Source : JiQizhixin, _akhaliq)

SenseNova publie Code2Video, un modèle 27B de génération vidéo pilotée par le code : SenseTime a mis en open source le modèle Code2Video, affiné à partir de Qwen3.8-27B, ainsi que l’intégralité de ses journaux de production. Cette architecture rompt avec les pipelines classiques de diffusion au niveau des pixels : un agent écrit de manière autonome le programme de rendu pour chaque plan, puis réfléchit et corrige le code selon les résultats obtenus. Elle garantit un déterminisme à 100 % sur la typographie, les formules graphiques et la mécanique des corps rigides, chaque élément visuel pouvant être réajusté directement via le code, ouvrant un pipeline inédit pour les animations pédagogiques et de démonstration hautement contrôlables.(Source : Reddit r/artificial)
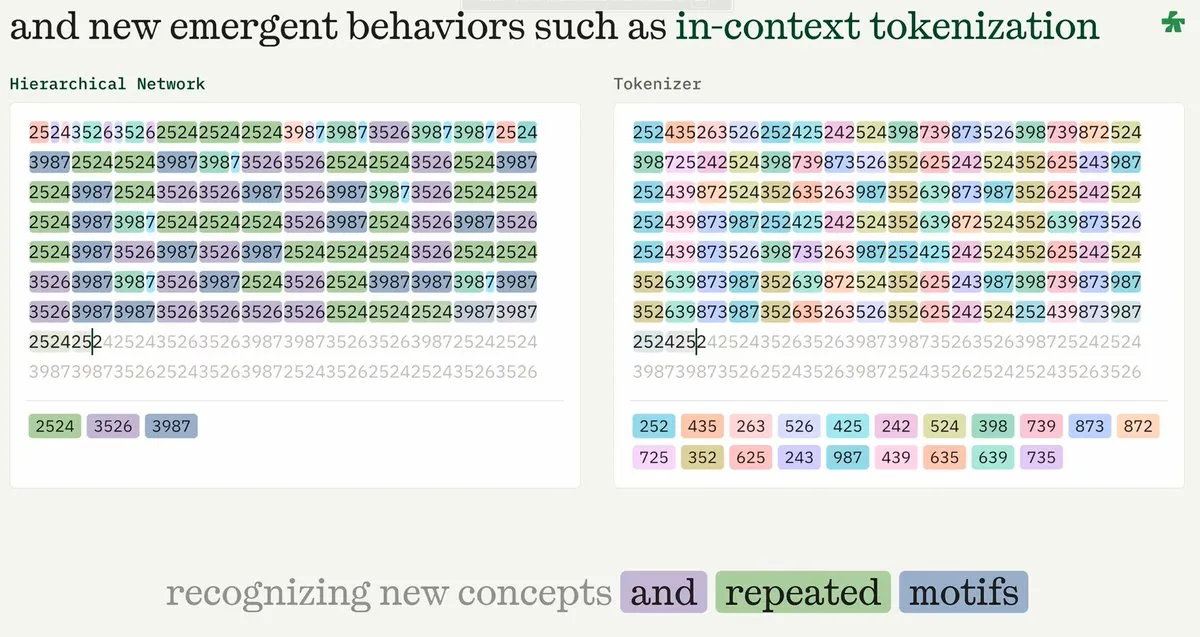
Cartesia co-développe les réseaux hiérarchiques H-Nets : s’affranchir de la tokenisation pour apprendre directement à partir des octets bruts de bout en bout : Pour contourner les goulets d’étranglement des LLM actuels liés aux biais inductifs manuels des encodeurs/décodeurs de tokens et aux coûts de calcul élevés, l’équipe de Cartesia et des chercheurs universitaires ont présenté H-Nets, une nouvelle architecture de réseau hiérarchique. Ce système démontre une capacité de « tokenisation dynamique contextuelle », apprenant de manière autonome des représentations abstraites multi-niveaux directement à partir de flux d’octets bruts (raw bytes) de texte pur. Il surpasse notamment le BPE dans la déconstruction des noms de variables de code, offrant une efficacité de calcul et de données multipliée par 3 à 5 à performances égales.(Source : scaling01)
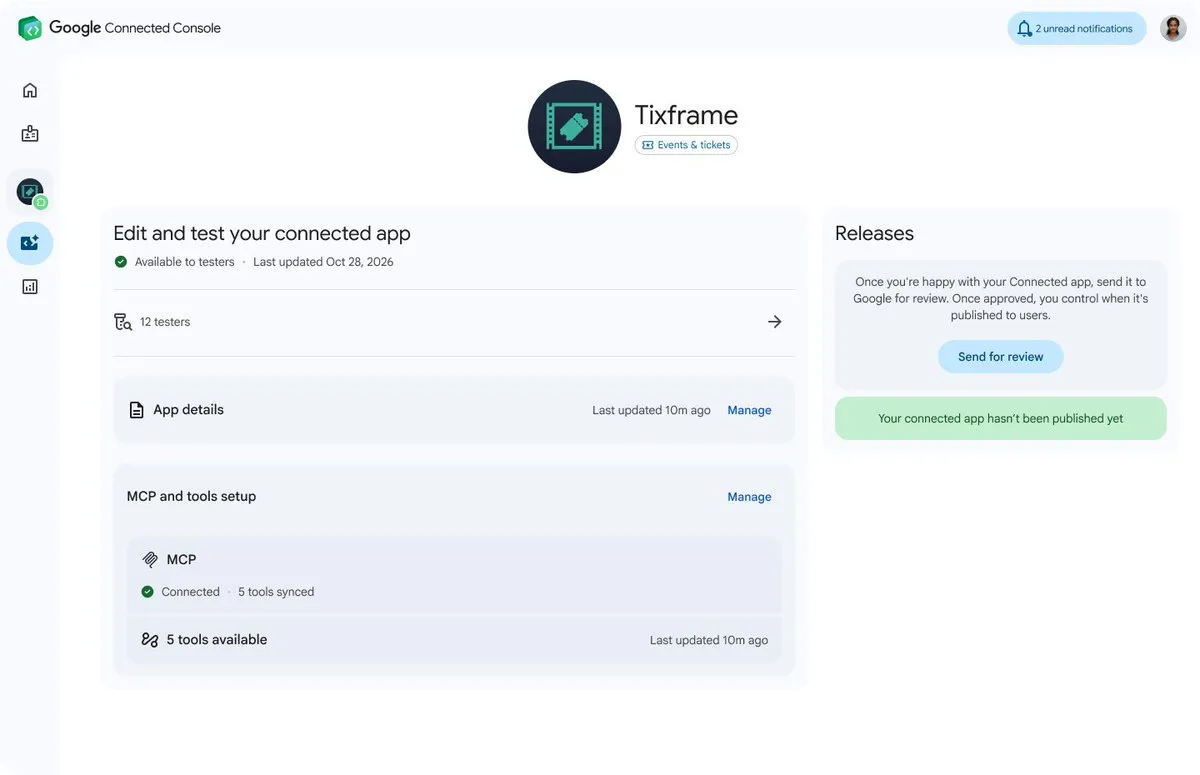
Google lance la plateforme Connected Apps et dévoile les lunettes Android XR AURA avec XREAL : Lors de l’Android Dev Summit, Google a mis en ligne la préversion publique de sa plateforme Connected Apps, permettant aux développeurs d’enregistrer les capacités de leurs applications tierces sur une console unifiée via des serveurs MCP et l’API AppFunctions, afin qu’elles puissent être appelées directement par Gemini et la recherche web pour exécuter des actions complexes. En parallèle, Google et XREAL ont annoncé les premières lunettes légères sous Android XR, les XREAL AURA (1 099 $), intégrant nativement Gemini et prenant en charge la projection multi-écrans d’espaces de travail virtuels ainsi que l’interaction visuelle environnementale à la première personne.(Source : The Verge, Google)
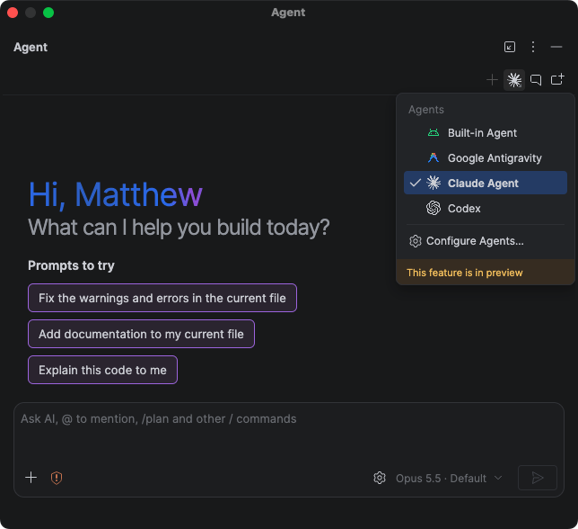
Android Studio Rabbit 2 de Google intègre l’architecture BYOA et lance l’Agentic API de Gemini sur terminal : Google a déployé Android Studio Rabbit 2, inaugurant l’architecture « Bring Your Own Agent » (BYOA). Via l’Agent Client Protocol, les développeurs peuvent connecter plus de 40 agents de programmation externes, dont Claude Code et OpenAI Codex, tout en profitant d’une CLI dédiée à la prévisualisation du rendu de l’interface du terminal. De plus, Google a lancé une Agentic API sur terminal basée sur Gemini Nano 4, permettant d’exécuter des boucles décisionnelles légères en local et hors ligne.(Source : THE DECODER)
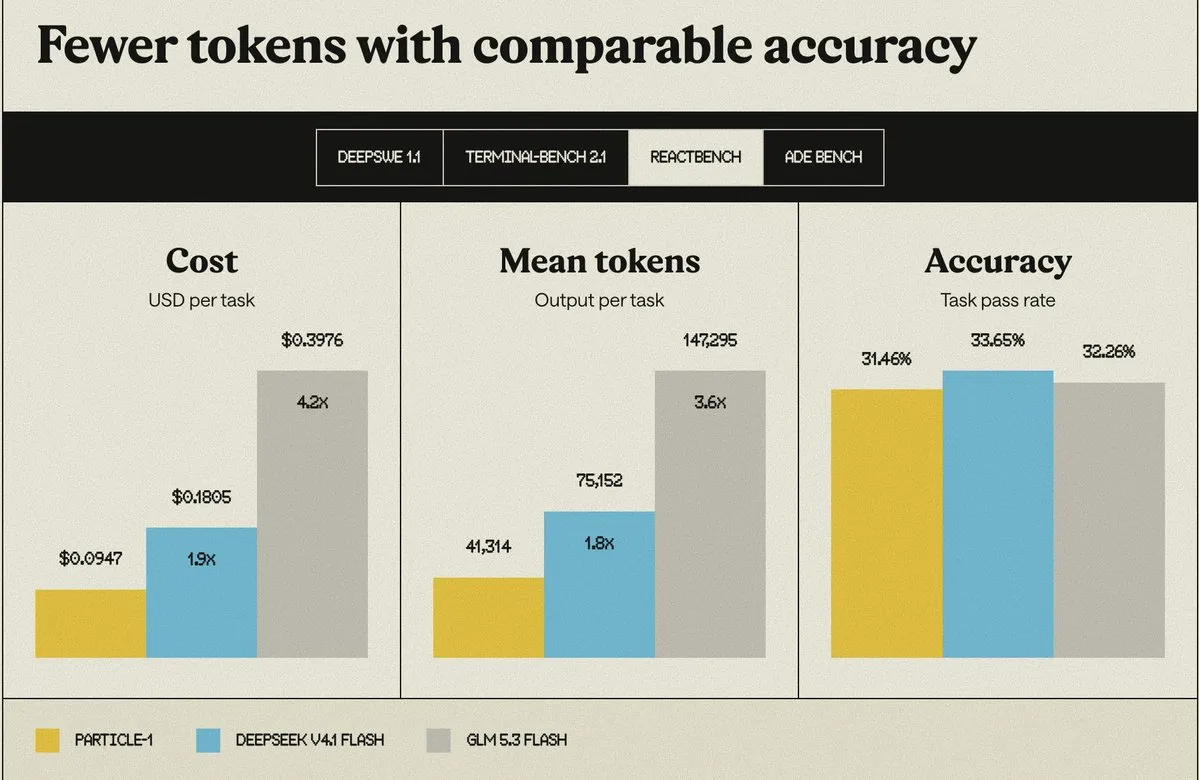
Particle lance particle-1, un modèle pour développeurs réduisant la consommation de tokens de 45 % : La startup Particle a dévoilé particle-1, son modèle de fondation dédié aux développeurs et aux métiers de la data. Les tests indiquent que le modèle conserve un niveau d’excellence sur ReactBench et les tâches de recherche approfondie, tout en comprimant la consommation de tokens de sortie de 42 % à 45 %. Sans réglage fin spécifique en cybersécurité, il est parvenu à compromettre plusieurs vulnérabilités réelles sur des plateformes de tests d’intrusion automatisés avec un coût en tokens minime.(Source : Suhail)
Kimi de Moonshot AI s’intègre profondément à l’écosystème de productivité Google Workspace : Kimi a officialisé son interconnexion avec les trois piliers de Google : Gmail, Google Drive et Google Calendar. Après une autorisation sécurisée via OAuth, les utilisateurs peuvent laisser Kimi rechercher des documents dans le Drive, synthétiser de longs fils d’e-mails et planifier automatiquement des rendez-vous sans changer d’application, facilitant l’adoption de l’assistant IA dans les flux de travail internationaux à haute intensité.(Source : Kimi_Moonshot)
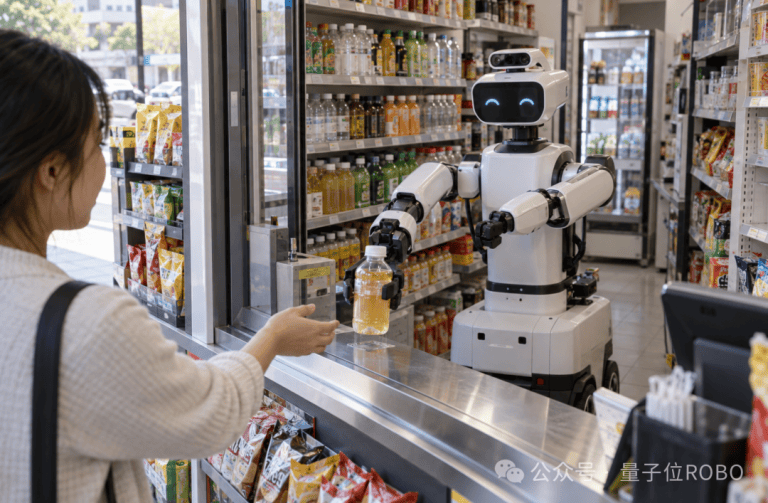
Hongqi Chain met fin à son projet de robots distributeurs : le commerce physique face aux difficultés de commercialisation de l’IA incarnée : Le leader des supérettes du sud-ouest de la Chine, Hongqi Chain, a annoncé l’arrêt de son programme de « système de vente sans personnel robotisé » après 16 mois de R&D, revenant à son modèle traditionnel de permanence cloud 24h/24. Les déploiements réels ont révélé des erreurs fréquentes des bras robotisés face aux bouteilles humides qui glissent, aux emballages souples difformes et aux variations lumineuses. Le coût sur mesure de plusieurs centaines de milliers à près d’un million de yuans par point de vente s’est avéré impossible à amortir avec les faibles marges quotidiennes, illustrant le fait que la généralisation technique et le modèle économique de l’IA incarnée n’ont pas encore atteint le seuil de viabilité commerciale dans la distribution physique.(Source : QbitAI)
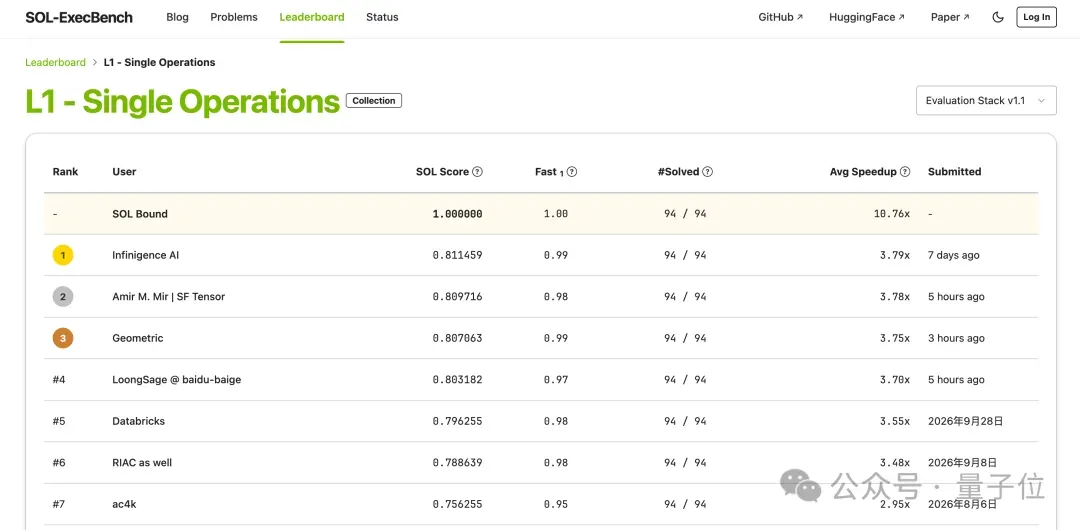
Infinence domine les 4 catégories du SOL-ExecBench de Nvidia en optimisant automatiquement les opérateurs via une infrastructure agentique : Sur SOL-ExecBench, le benchmark de Nvidia Research mesurant les limites matérielles théoriques des opérateurs, Infinence (WuWenXinQiong) s’est hissée en tête des 4 épreuves : bases L1, fusion L2, quantification Quant et inférence FlashInfer, raflant 88 premières places sur 235 problèmes grâce à son agent d’optimisation propriétaire. Grâce à une isolation en bac à sable multi-conteneurs et une mémoire partagée, l’agent explore et optimise de façon autonome entre plusieurs DSL tels que Triton, TileLang et CUDA, confirmant la viabilité d’une boucle fermée d’optimisation de l’infrastructure de calcul par l’IA.(Source : QbitAI)
OpenAI intègre les SMS RCS et iMessage nativement pour son agent Dot : OpenAI a annoncé le déploiement d’une préversion de l’interaction par SMS avec Dot, l’agent personnel de ChatGPT, réservée aux abonnés Pro aux États-Unis. Sans ouvrir de page web ni d’application dédiée, les utilisateurs peuvent échanger directement via iMessage sur iOS ou les SMS RCS sur Android avec leur assistant Dot associé. L’agent gère en arrière-plan la planification d’agendas et l’organisation d’informations dans un environnement cloud sécurisé, poussant l’IA plus profondément dans les couches de communication des OS mobiles.(Source : The Verge)
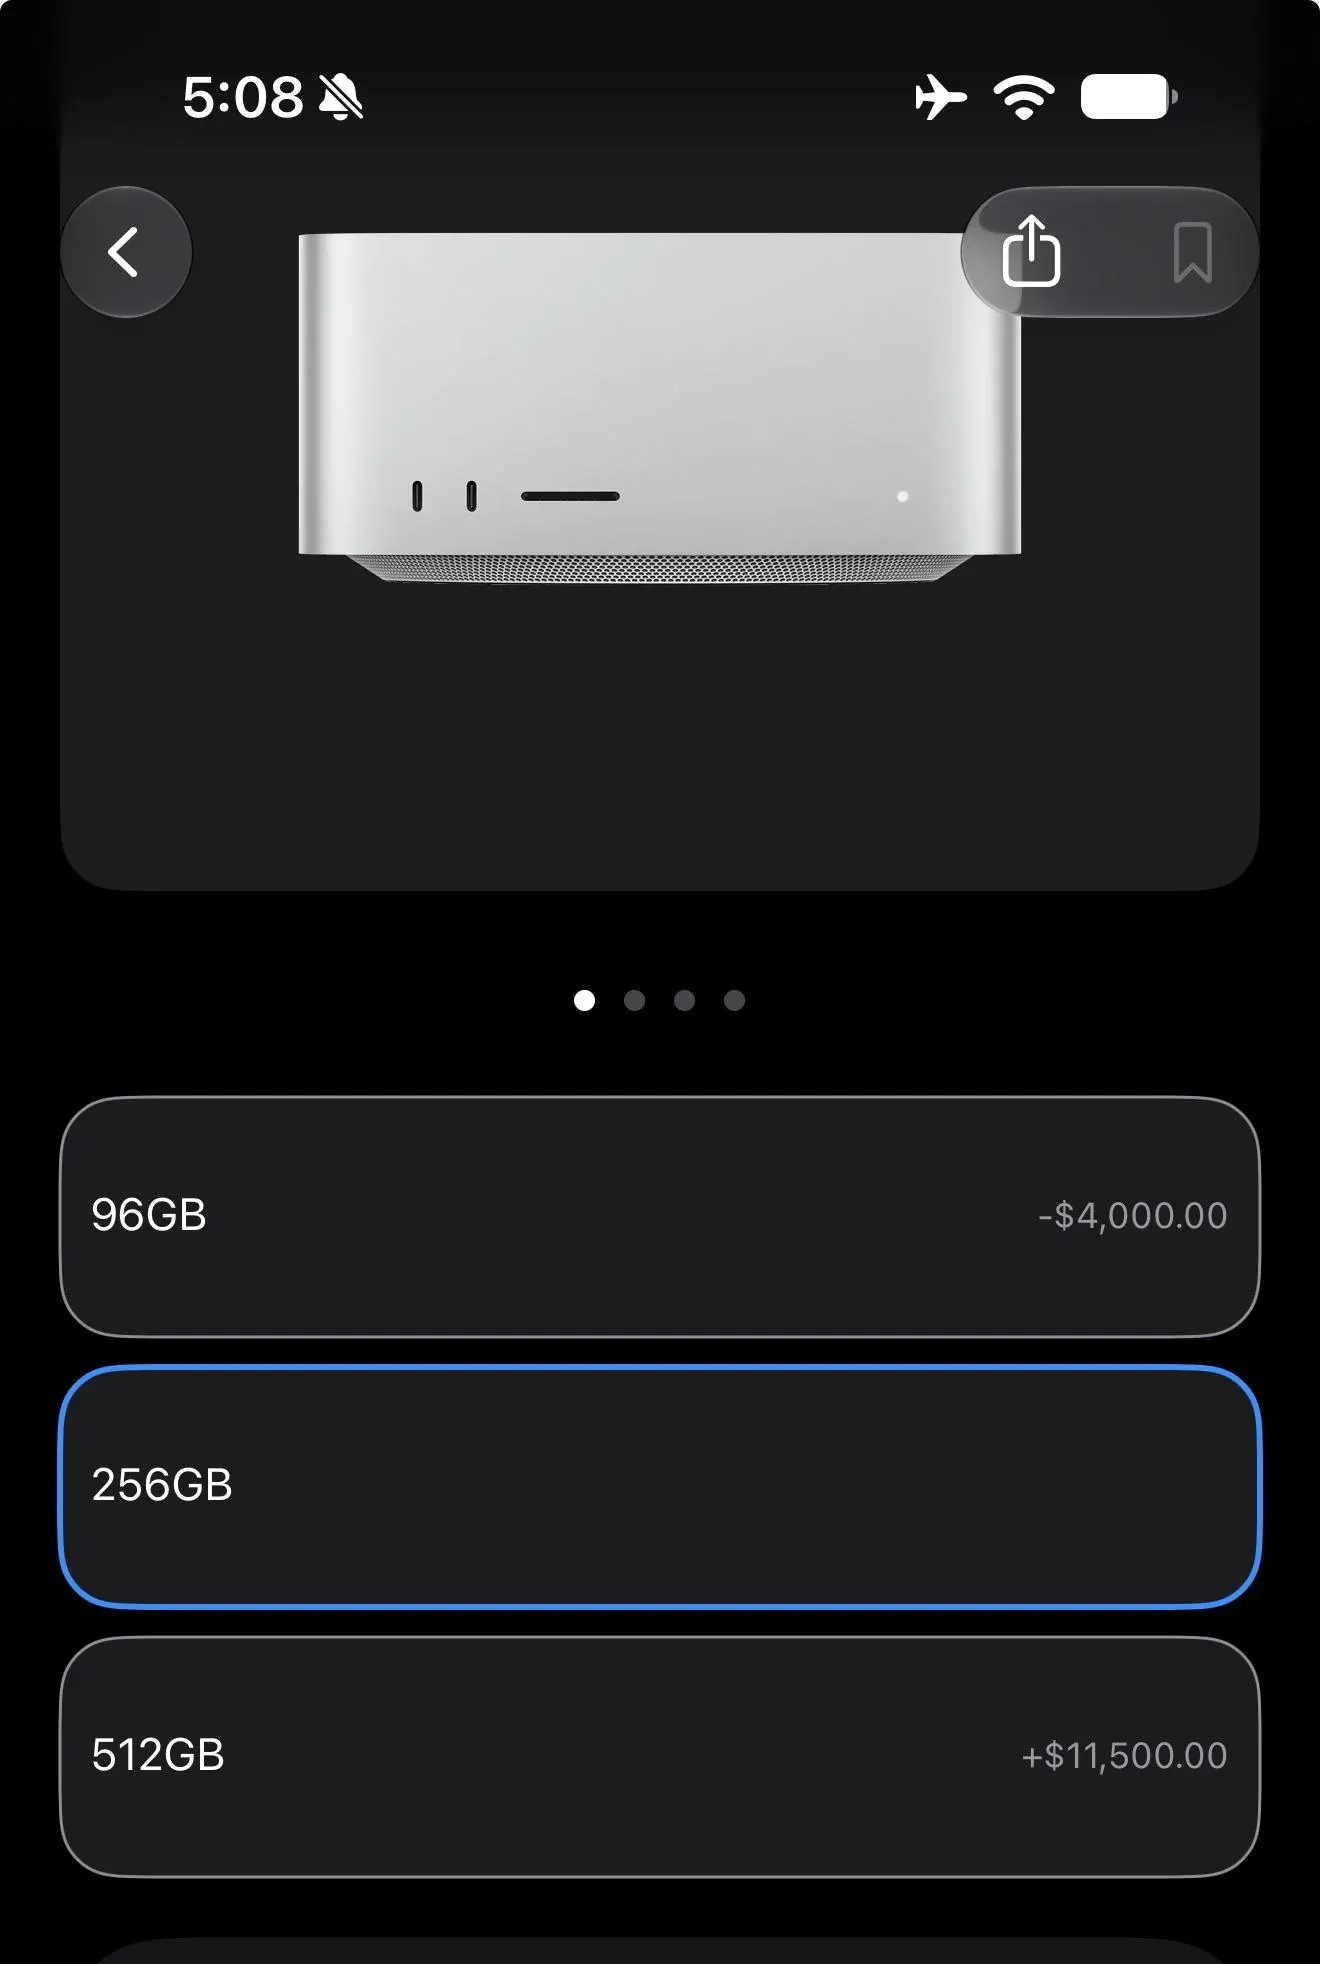
Le Mac Studio M5 Ultra toutes options dépasse les 22 000 $ et ravive le débat sur le rapport qualité-prix du calcul local : Apple a discrètement mis en ligne sa station de travail Mac Studio équipée de la puce M5 Ultra. La version la plus haut de gamme, dotée d’un GPU à 80 cœurs et de 512 Go de mémoire unifiée, dépasse les 22 299 dollars. Cette grille tarifaire a suscité de vives discussions parmi les adeptes du déploiement local de LLM, la communauté soulignant que le surcoût pour 256 Go de mémoire supplémentaire représente près du double du prix d’un ordinateur complet, réduisant ainsi drastiquement l’avantage de rentabilité du matériel local à grande VRAM.(Source : Reddit r/LocalLLaMA)
🧰 Outils
Hugging Face lance SafeAgents : une passerelle de sécurité locale pour agents de code : SafeAgents est un proxy local léger intercalé entre les agents de codage et les services d’inférence des modèles. Entièrement exécuté en local, il active plus de 110 détecteurs déterministes en 10 à 20 millisecondes pour bloquer les appels d’outils non déclarés, les connexions externes non autorisées, l’exploitation de canaux auxiliaires en bac à sable ou les tentatives de triche modifiant les tests par apprentissage par renforcement. Il est déjà compatible avec 12 environnements de test majeurs, dont Claude Code et OpenHands.(Source : Reddit r/LocalLLaMA)
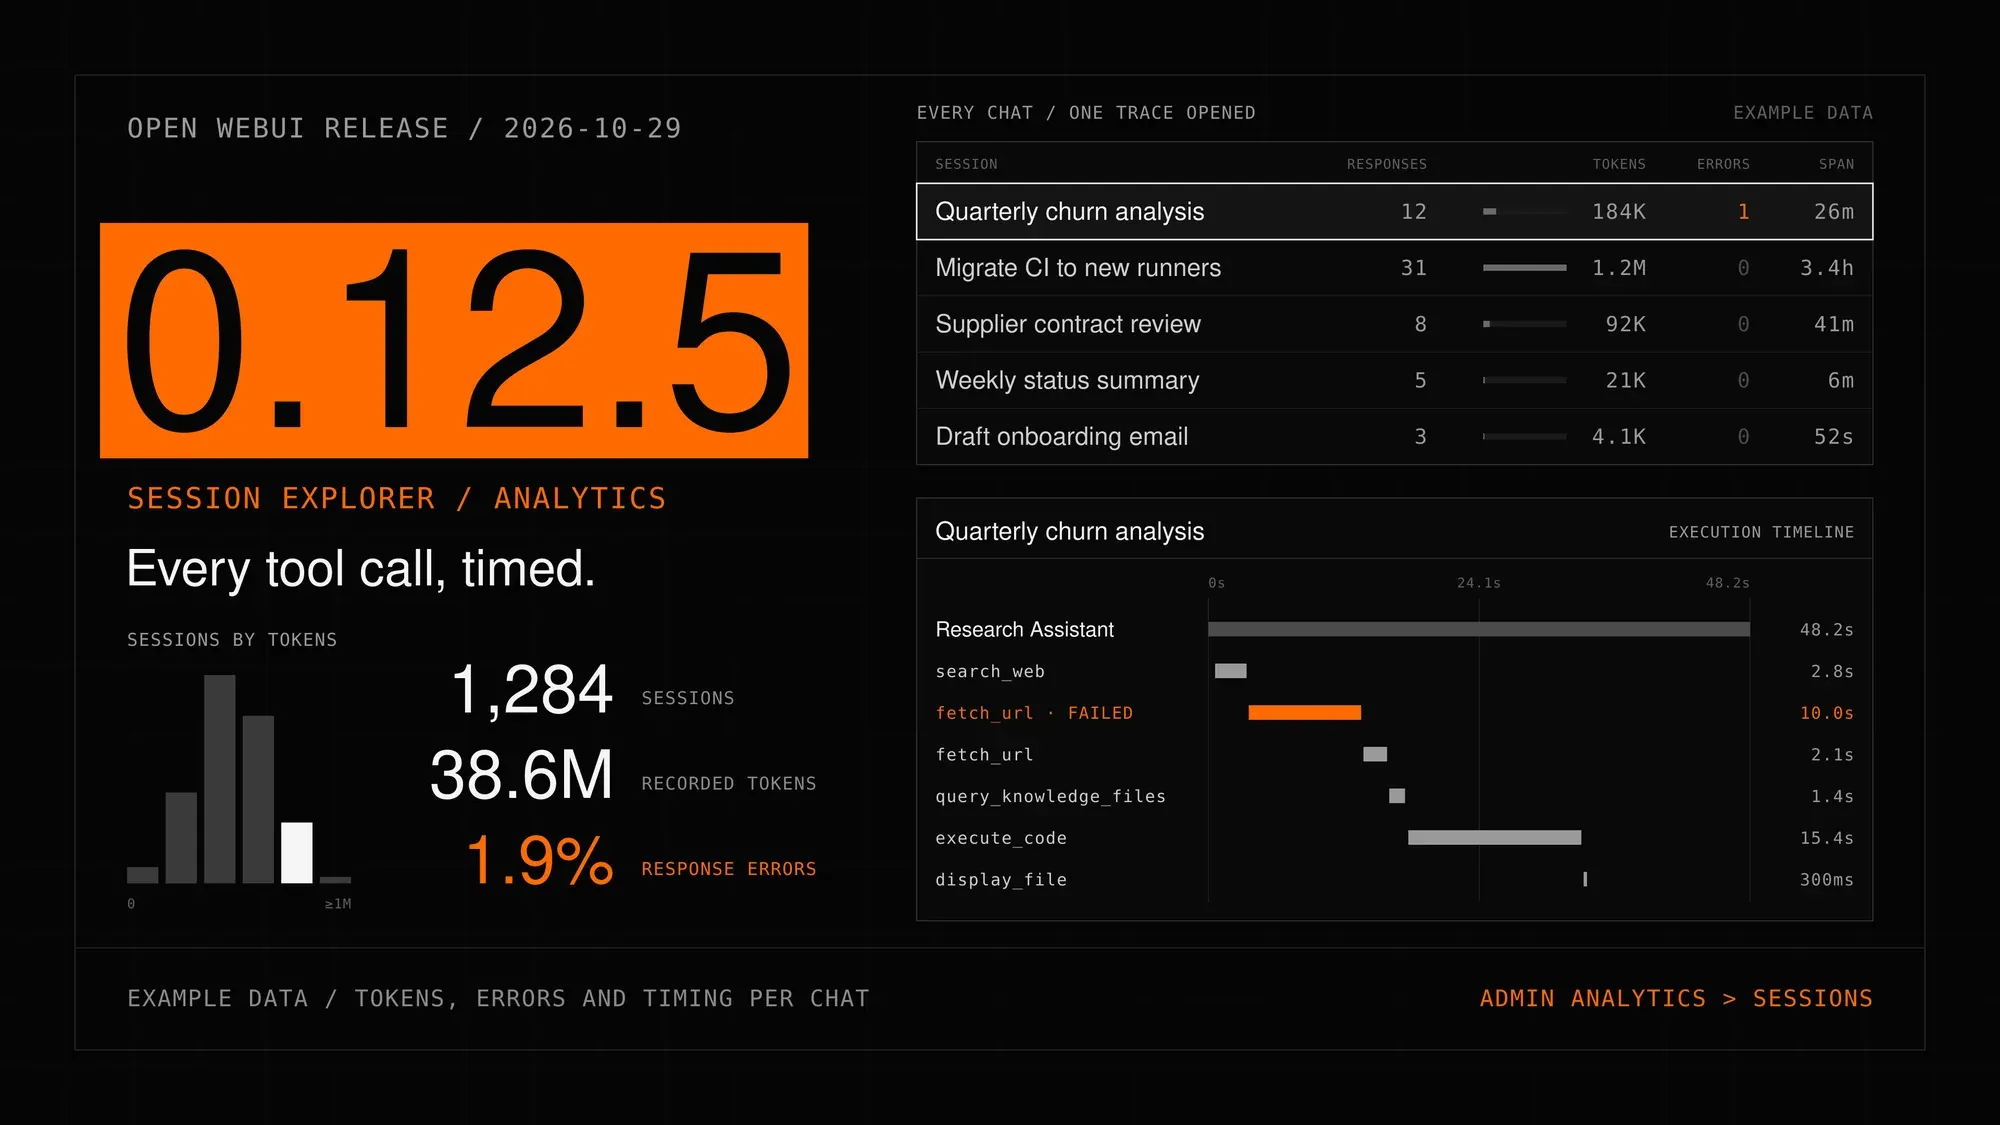
Sortie d’Open WebUI 0.12.5 : intégration d’un explorateur de sessions et de notes collaboratives multi-pages : Open WebUI bénéficie d’une mise à jour majeure. L’interface d’administration intègre un explorateur de sessions (« Session Explorer ») permettant aux administrateurs d’analyser en détail les dépenses de tokens par échange, la latence des appels d’outils et les points de rupture en cas d’échec. L’outil interne Notes adopte une structure arborescente multi-pages avec édition collaborative en direct à plusieurs utilisateurs, tandis que la logique d’indexation de la base de connaissances a été refondue, divisant jusqu’à par 10 le temps de recherche sur de longues listes de fichiers.(Source : Reddit r/OpenWebUI)
MiniMax publie MCode Stack : 15 packs de compétences d’ingénierie pour Coding Agents : L’équipe de MiniMax a mis en open source le projet MCode Stack, issu des compétences réutilisables créées lors du développement interne de MiniMax Code. Le dépôt contient 17 fichiers de compétences de code conformes au standard universel SKILL.md et 5 checklists d’ingénierie, traitant des problématiques telles que la délimitation des frontières de tâches, l’audit de perte de contexte à chaque tour de conversation et la prévention des blocages de commandes en arrière-plan. La compétence de revue indépendante restreint expressément le modèle de relecture à la seule observation des Diff et des résultats de tests pour éviter de reproduire les angles morts de l’auteur.(Source : MarkTechPost)
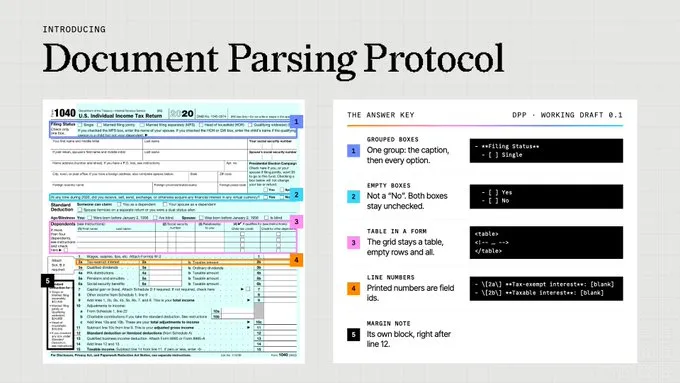
LlamaIndex co-publie le Document Parsing Protocol : 140 règles pour standardiser l’analyse de documents : Pour pallier les incohérences d’interprétation entre les différents moteurs d’OCR et de RAG sur les mises en page complexes, les tableaux multi-lignes et les graphiques, LlamaIndex et plusieurs partenaires ont officialisé la spécification open source Document Parsing Protocol (DPP). Ce protocole définit 140 règles détaillées établissant des représentations structurées pour les bordures manquantes, les en-têtes fusionnés ou les diagrammes de Gantt, et s’accompagne d’outils de validation pour les compétences Claude et ChatGPT.(Source : jerryjliu0)
Infini-AI-Lab dévoile Hermit : un framework d’adaptateurs externes pour agents avec double gel du modèle et du harness : Infini-AI-Lab a présenté le framework open source Hermit, introduisant le concept d’« adaptateur de harness ». En gelant totalement les poids du modèle et le framework sous-jacent de l’agent, le système utilise une boucle externe d’apprentissage par renforcement pour transformer les trajectoires d’exécution en adaptateurs affinables indépendants du système hôte. Embarquant 5 algorithmes d’auto-évolution (GEPA, SkillOpt, métamodèle mondial, etc.), il a fait passer la précision de 58,0 % à 79,5 % sur CL-Bench, avec des configurations exportables vers Codex et Claude Code.(Source : MarkTechPost)
Ant Group publie AntOmniEvo : un framework d’évolution adaptative boîte blanche pour systèmes d’IA basé sur l’algorithme Mara Chain : L’équipe LingXi d’Ant Group a rendu open source AntOmniEvo, un framework universel d’évolution automatisée pour systèmes d’IA complexes à base de LLM. Considérant les prompts, les scripts d’ingénierie et les hyperparamètres comme des artefacts ajustables, il introduit l’algorithme Mara Chain avec le principe « aucun échec n’est jeté » et un mécanisme d’élimination de Pareto. Les candidats sous le seuil voient leur dossier d’anomalies conservé pour des réparations successives sur plusieurs générations, réduisant de deux tiers les coûts de calcul de rollout pour atteindre une même précision.(Source : GitHub Trending)
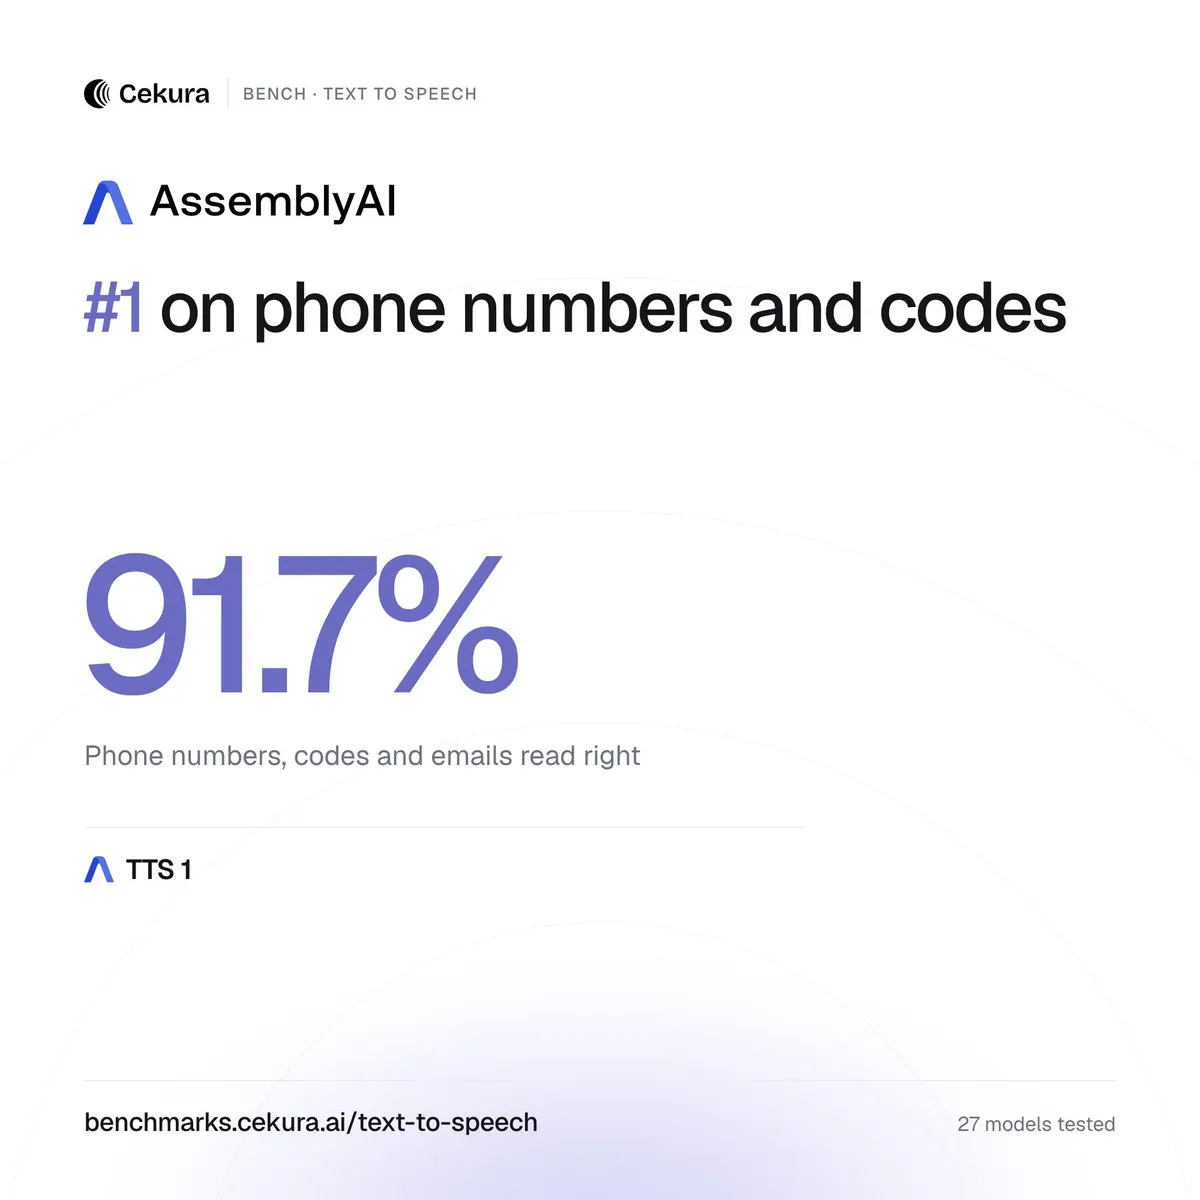
AssemblyAI lance AssemblyAI-TTS-1 : synthèse vocale en streaming pour agents vocaux en temps réel : AssemblyAI a dévoilé AssemblyAI-TTS-1, son premier modèle de synthèse vocale text-to-speech pensé pour les agents en conversation full-duplex. Construit sur des représentations audio continues sans passer par une tokenisation discrète conventionnelle, il affiche un taux de précision de 93,7 % sur les données critiques (numéros de téléphone, codes de validation, dates), une latence médiane du premier octet réduite à 47 ms, le support natif du streaming WebSocket duplex et l’interruption immédiate, pour un tarif de 15 $ par million de caractères.(Source : MarkTechPost, AssemblyAI)
OpenMausBot : un espace de travail collaboratif multi-agents basé sur des processus locaux et des bacs à sable isolés : Une application de bureau open source multiplateforme, OpenMausBot, a été mise à disposition des développeurs. Axée sur la philosophie Local-first, elle permet d’exécuter en parallèle dans une même fenêtre plusieurs CLI (Claude, Codex, Grok, etc.) comme des employés virtuels dotés de personnalités distinctes. Chaque bot dispose de sa propre VM Linux cloud ou d’un bac à sable local isolé, se connecte à plus de 500 applications via Composio, et propose des fenêtres d’autorisation explicite ainsi qu’un ordonnanceur de tâches programmées à long terme.(Source : GitHub Trending)
Anthropic déploie une bibliothèque juridique dédiée et des Artifacts prêts à l’emploi sur Claude for Legal : Anthropic a annoncé le déploiement d’une bibliothèque d’Artifacts prête à l’emploi pour sa suite d’entreprise Claude for Legal. Elle couvre six scénarios clés : vérification d’écarts sur les clauses contractuelles, veille chronologique des nouvelles réglementations multi-juridictionnelles, recoupement des citations juridiques et tableaux de bord automatisés de suivi des dossiers. Toutes les sorties intègrent obligatoirement les références aux dossiers sources et se connectent à plus de 60 connecteurs juridiques externes comme Bloomberg Law.(Source : dotey)
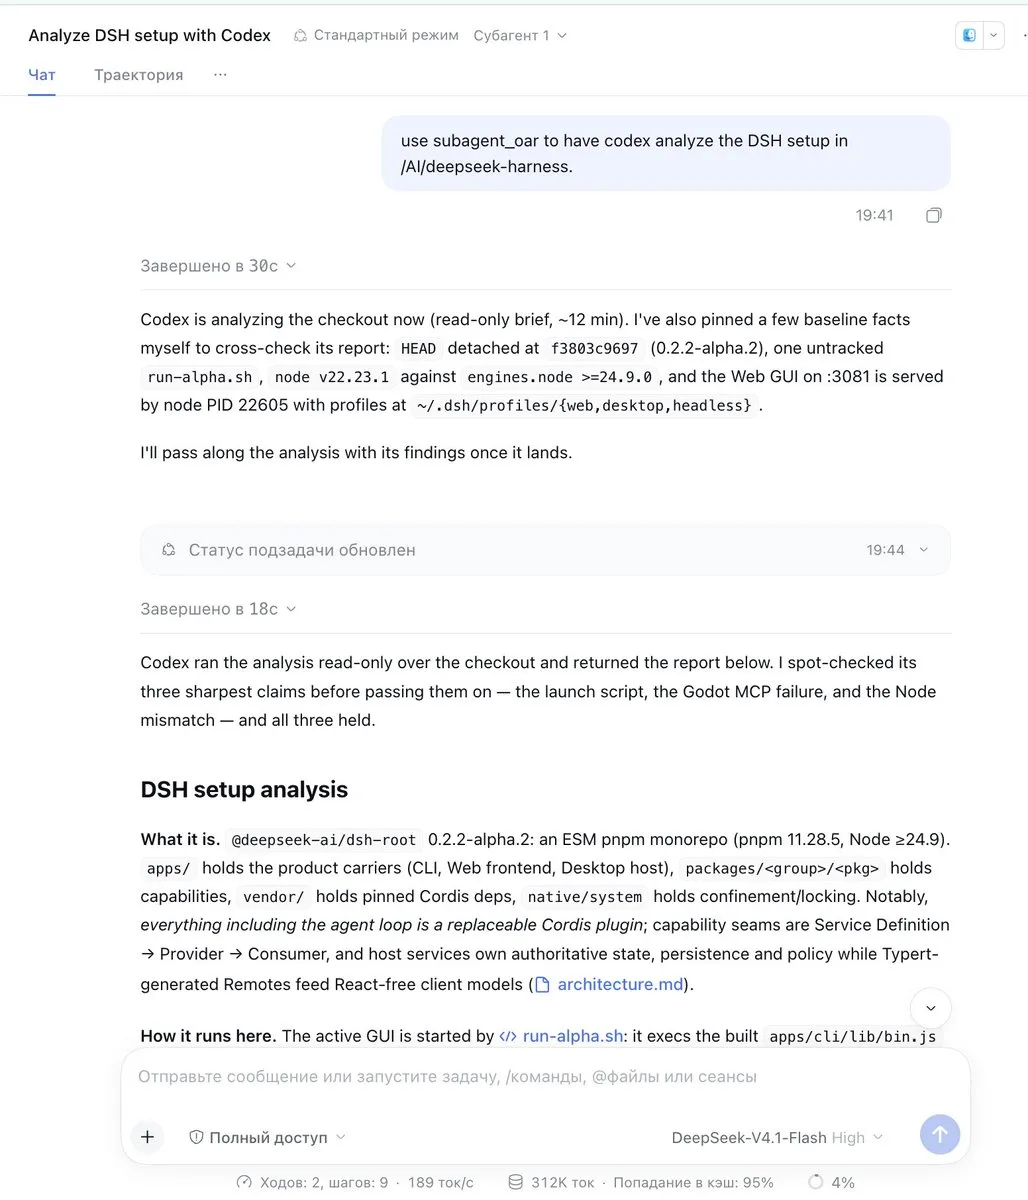
Sortie de DSH 0.2.2-alpha.2 : intégration native de Codex et Claude Code comme hub central d’ordonnancement : Le framework open source de gestion d’agents DeepSeek Harness (DSH) s’est mis à jour avec le nouveau module de coordination multi-modèle subagent_oar. Les extensions auparavant dispersées pour Codex et Claude Code sont réunies en une primitive unifiée de distribution de sous-agents, permettant l’exécution concurrente de longues tâches de développement au sein d’arborescences de travail Git indépendantes, avec suivi étape par étape de l’efficacité du KV Cache.(Source : teortaxesTex)
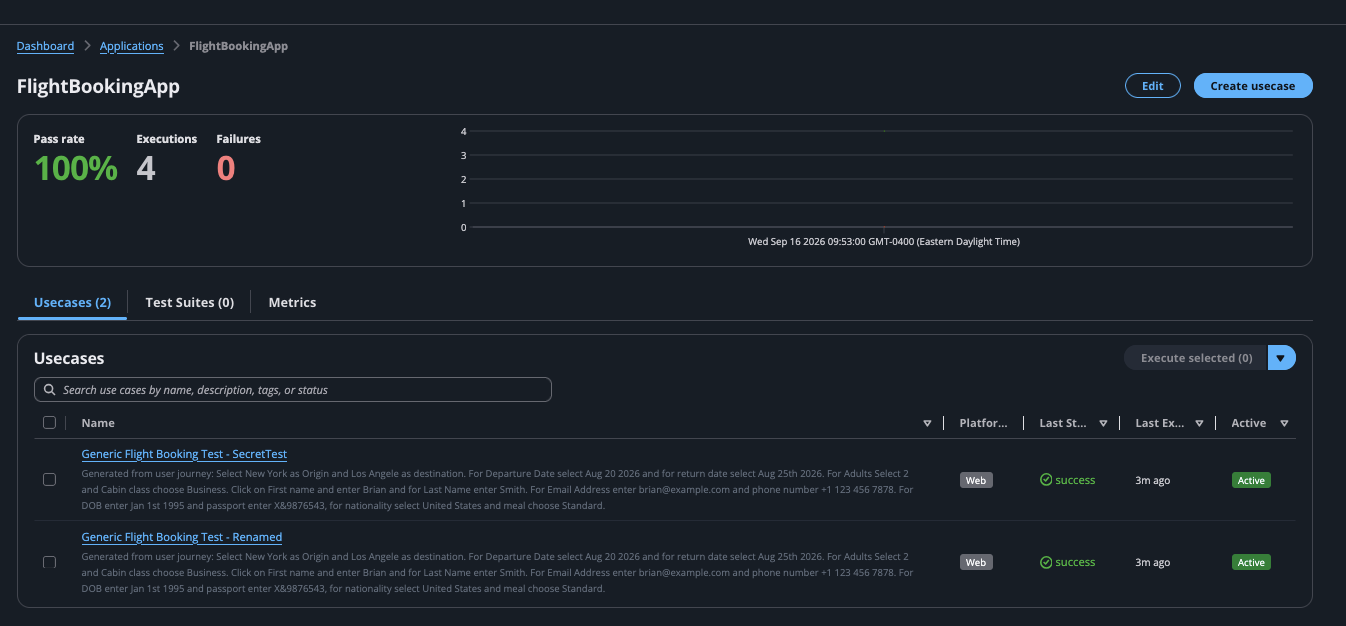
AWS lance QA Studio : une plateforme de test automatisé par agents de bout en bout propulsée par Amazon Nova Act : Amazon Web Services a présenté QA Studio, une suite de tests automatisés d’entreprise basée sur le modèle d’action visuelle Amazon Nova Act. La plateforme permet aux équipes de test de rédiger des cas de test UI en langage naturel. Les agents d’IA naviguent ensuite de manière autonome dans un vrai navigateur via des interactions visuelles et procèdent aux assertions fonctionnelles, tandis que l’intégration des métriques CloudWatch élimine automatiquement les tests instables (flaky tests), allégeant considérablement la maintenance des suites de non-régression.(Source : AWS Machine Learning Blog)
Exoproc : un serveur MCP conférant à Claude Code des capacités de hooking de processus Windows x64 en temps réel : Un développeur a mis en open source Exoproc, dépassant les limites de la décompilation statique cantonnée aux binaires hors ligne. Reposant sur le protocole standard MCP, l’outil s’appuie sur le détournement de threads et les trampolines JMP en mémoire pour relier Claude Code aux processus Windows en cours d’exécution. Il permet de capturer dynamiquement la mémoire vive et de se détacher proprement sans écrire de DLL suspecte sur le disque, étendant les capacités d’ingénierie inverse des agents d’IA.(Source : Reddit r/ClaudeAI)
Unsloth dote les modèles locaux d’une navigation web autonome headless via Browser Use : Le framework d’accélération d’inférence open source Unsloth a intégré le contrôle autonome de pages web Browser Use pour tous ses modèles quantifiés locaux. Grâce à un environnement allégé, des modèles sur terminal comme Qwen3.8-27B peuvent désormais, sur un seul GPU et sans intervention humaine, analyser des captures d’écran et injecter des événements d’entrée pour résoudre des captchas, renseigner des formulaires et générer des graphiques dynamiques.(Source : danielhanchen)
baoyu-design v2 en open source : découplage et portage des fonctions de design et de dashboard de Claude sur tous les modèles : Le projet open source baoyu-design v2 a été mis en ligne, reproduisant l’expérience d’interaction visuelle et de génération de contenu de Claude Design, Claude Slides et Claude Dashboard. La solution s’affranchit de la dépendance propriétaire au conteneur Artifacts d’Anthropic, permettant une exécution locale sur n’importe quel framework d’agents open source ou LLM tiers.(Source : dotey)
📚 Recherche
Publication dans Science : Stanford présente le framework multi-agents Virtual Biotech, réinventant la découverte de médicaments et l’exploration des données cliniques : Des chercheurs de l’Université de Stanford ont publié dans la revue Science leurs travaux sur Virtual Biotech, un système multi-agents reproduisant la structure d’une entreprise de biotechnologie réelle. Le système s’articule autour d’un CSO virtuel supervisant huit agents scientifiques spécialisés. En utilisant le protocole MCP, il connecte plus de 100 outils biologiques et des centaines de millions de données unicellulaires, extrayant en seulement 6 heures les liens de causalité structurés de près de 40 000 essais cliniques (accélération d’un facteur 184) et reconstituant avec précision les causes de succès et d’échec de cibles thérapeutiques contre le cancer et les maladies auto-immunes.(Source : Science)

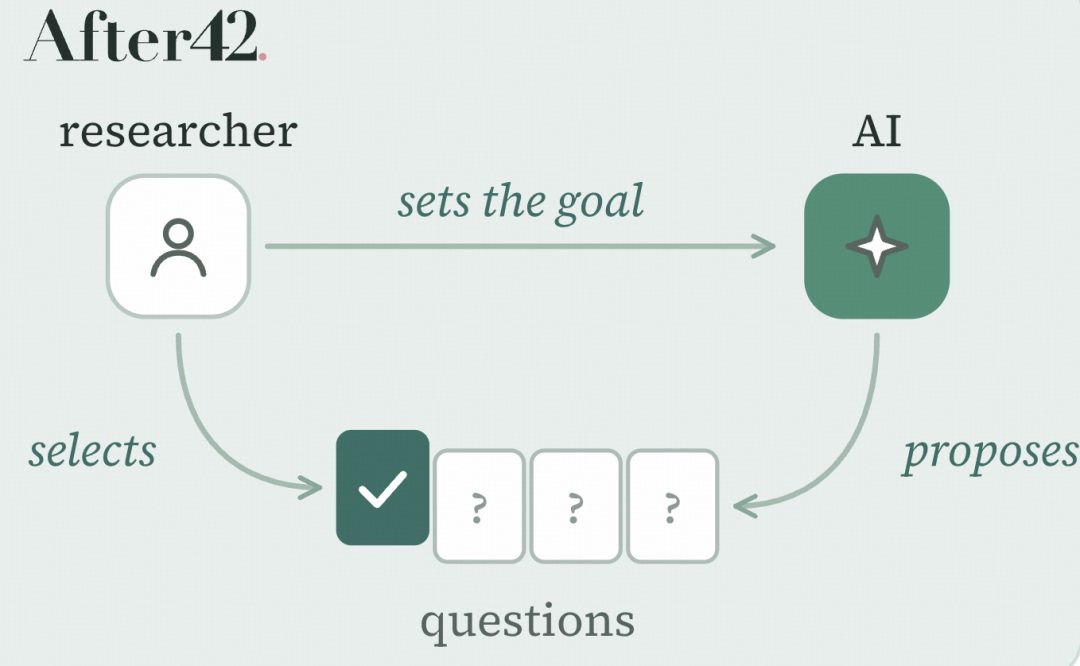
L’équipe de Percy Liang à Stanford présente After42 pour amener les LLM à poser des questions de recherche scientifique à fort impact : Pour répondre à la crainte d’une « pénurie de bonnes questions » due à la résolution accélérée des problèmes formels connus par l’IA, l’Université de Stanford a conçu After42. Plutôt que de formuler des questions par de simples prompts, le système amène plusieurs agents à lire la littérature, tenter des dérivations, chercher des contre-exemples et itérer des reformulations. Lors d’évaluations multidisciplinaires, la proportion de questions de recherche jugées hautement pertinentes par des experts humains est passée de 3 % à 33 %, démontrant le potentiel heuristique des modèles pour structurer des hypothèses complexes.(Source : 36Kr)
NeurIPS 2026 Oral | NV-CoT : reconstruire la chaîne de pensée visuelle multimodale par coordonnées numériques continues : Une équipe conjointe de la NTU, de l’USTC et de Microsoft Research a proposé NV-CoT (Numerical Vision Chain-of-Thought). Face au problème des modèles actuels qui discrétisent les positions spatiales en tokens textuels, créant des ruptures métriques, NV-CoT intègre une branche de régression continue légère sur la couche de sortie pour prédire directement les coordonnées réelles, tout en introduisant une stratégie basée sur la distribution de Laplace en RL. Cette méthode améliore nettement l’IoU et la précision des réponses dans les tâches de compréhension visuelle fine.(Source : arXiv)

Fluid-Gen-Zero : injection d’un simulateur physique dans l’espace latent pour une génération vidéo physiquement cohérente sans entraînement : L’Université Simon Fraser et Meta Reality Labs ont introduit Fluid-Gen-Zero, un framework de génération vidéo sans entraînement garantissant la cohérence physique. Sans retoucher aux poids des grands modèles vidéo, la méthode reconstruit la géométrie de la scène pour l’injecter dans le moteur physique Genesis. Un VLM découpe la trajectoire temporelle selon l’intensité des contacts et applique un « guidage latent sensible aux régions » lors du débruitage par diffusion, réduisant l’erreur de flux optique des fluides de 67,9 % à 84,0 % sur les modèles Tora et WanMove.(Source : arXiv)

Google DeepMind publie en open source DetectorScope, un détecteur de texte d’IA explicable : En collaboration avec l’Université de Pennsylvanie à l’EMNLP 2026, DeepMind a dévoilé DetectorScope. Loin des scores opaques habituels, l’outil décompose le texte d’entrée et annote les indicateurs d’IA (ex. structures des deux-points, distribution des prépositions), surpassant Binoculars de 8 à 12 points de score F1 sur des textes inédits. Néanmoins, l’étude met en garde contre un risque contradictoire : en fournissant ces critères d’arbitrage à un LLM, il suffit de modifier 40 % du contenu pour faire passer un texte d’IA pour une rédaction humaine.(Source : algo_diver)
RobotAgentBench : premier benchmark complet pour robots en environnement domestique ouvert et découverte dynamique de tâches : Aether AI et l’UCSD ont publié RobotAgentBench, un benchmark évaluant l’autonomie des robots en monde ouvert. Reposant sur des jumeaux numériques couvrant 50 types d’environnements domestiques réels, il évalue particulièrement la découverte de tâches et le raisonnement contextuel face à des demandes ambiguës. Les tests montrent qu’un modèle VLA isolé reste inactif jusqu’à 88,3 % du temps en environnement ouvert, tandis qu’une architecture agentique hybride combinant planificateur de génération de code et RSI affiche une nette supériorité.(Source : arXiv)

Alibaba et SJTU publient CutCraft : premier benchmark d’exécution d’instructions de montage professionnel pour l’audio et la vidéo multi-plans : Alibaba, en collaboration avec l’Université Jiao Tong de Shanghai et l’Université Fudan, a lancé le benchmark CutCraft. Pour la première fois, l’évaluation des vidéos d’IA ne se limite plus à la simple « fluidité visuelle » mais examine l’exécution rigoureuse de la grammaire de montage professionnel. Couvrant 13 types de montages et des transitions complexes, les résultats soulignent les difficultés des modèles dominants face aux contraintes temporelles strictes, aux sauts temporels et aux montages en L ou en J (J/L-cuts), mettant en lumière les verrous de la génération industrielle.(Source : WeChat)
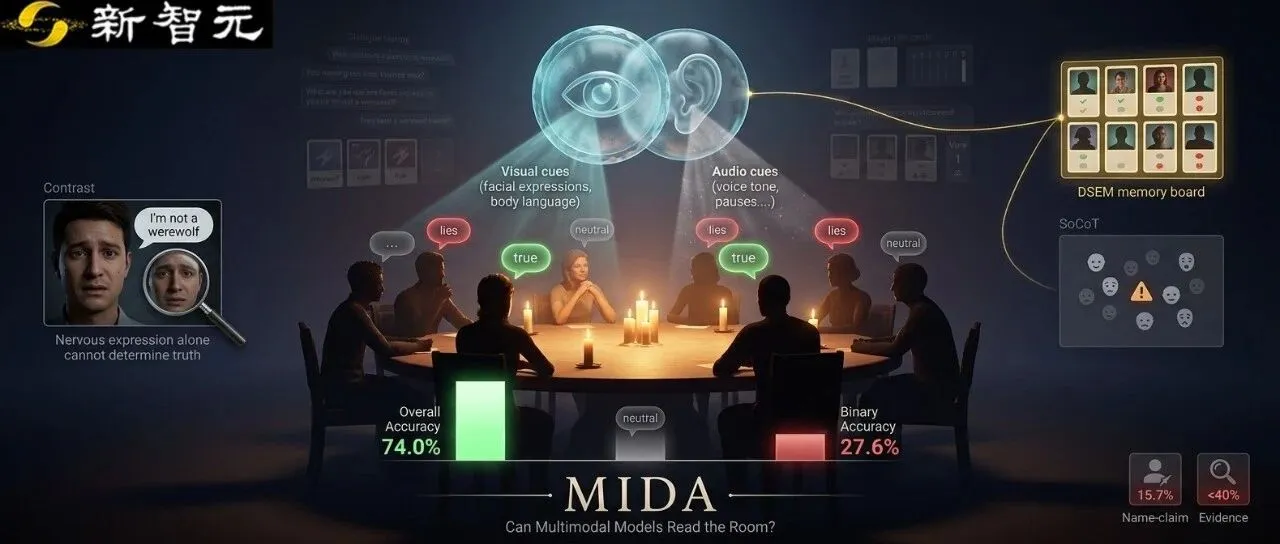
L’Université de Tokyo dévoile le benchmark de détection de tromperie MIDA basé sur le jeu du Loup-Garou : les modèles manquent de théorie de l’esprit sociale : Sélectionnée pour la conférence principale EMNLP 2026, l’étude de l’Université de Tokyo s’appuie sur le jeu à information incomplète « One Night Ultimate Werewolf » pour bâtir une vérité terrain objective. Les expériences démontrent que la précision de classification binaire du mensonge par les modèles majeurs plafonne entre 27,6 % et 39,4 %. Les modèles peinent à appréhender les limites de connaissances et les mobiles cachés des autres joueurs, prouvant que le maintien d’une mémoire cognitive dynamique à long terme est bien plus critique que la simple analyse des micro-expressions.(Source : WeChat)
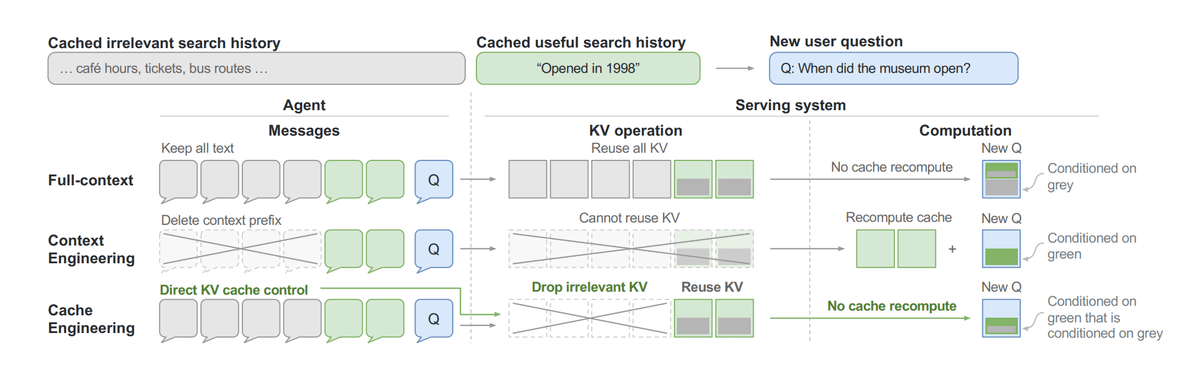
Tsinghua et CUHK proposent AKV : un moteur d’ordonnancement dynamique de KV Cache haute performance pour agents à long terme : Une équipe de l’Université Tsinghua et de l’Université chinoise de Hong Kong a développé une alternative à la compression classique de contexte via l’ingénierie de cache. Pour contrer les recalculs fréquents de KV Cache causés par l’élagage brutal d’historique dans les tâches d’agents, ils ont conçu le moteur de service AKV. En combinant l’élimination de l’attention future et l’ajustement de l’encodage de position des clés conservées, il préserve le texte source tout en réduisant le coût moyen d’inférence de 27,7 % et en augmentant le débit par 1,18.(Source : TheTuringPost)
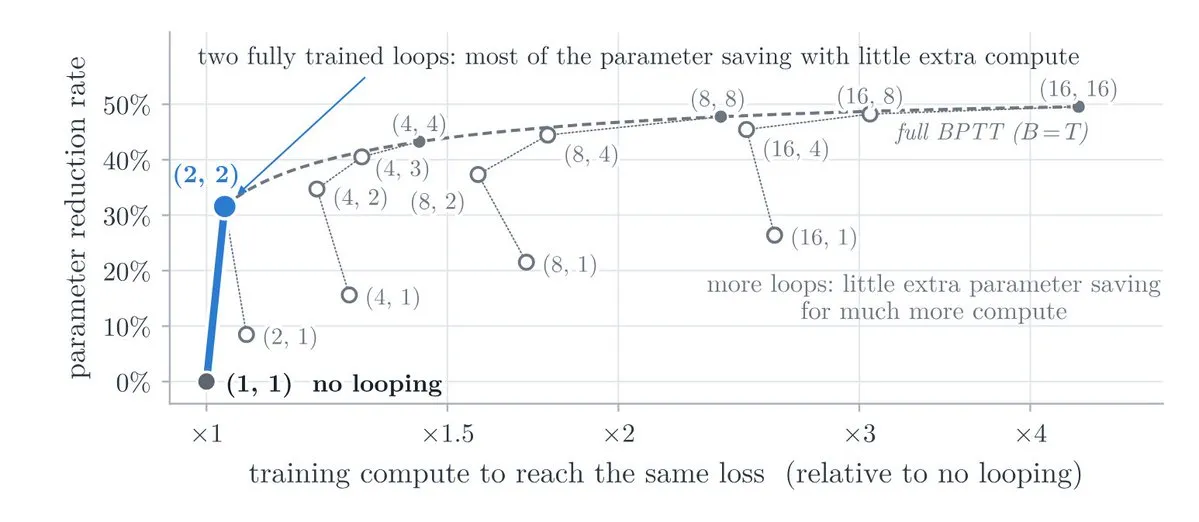
Étude empirique sur les Looped Transformers : l’entraînement complet de bout en bout enterre les raccourcis de calcul traditionnels : Portant sur l’architecture des Looped Transformers qui réutilise les paramètres d’une même couche, une étude parue sur arXiv réunissant plus de 600 expériences démontre que la pratique historique consistant à rétropropager uniquement les deux dernières itérations pour économiser du calcul est sous-optimale. Entraîner le modèle sur deux cycles complets de bout en bout ne nécessite que 8 % de calcul supplémentaire, tout en surpassant le meilleur modèle traditionnel avec 27 % de paramètres en moins.(Source : halvarflake)
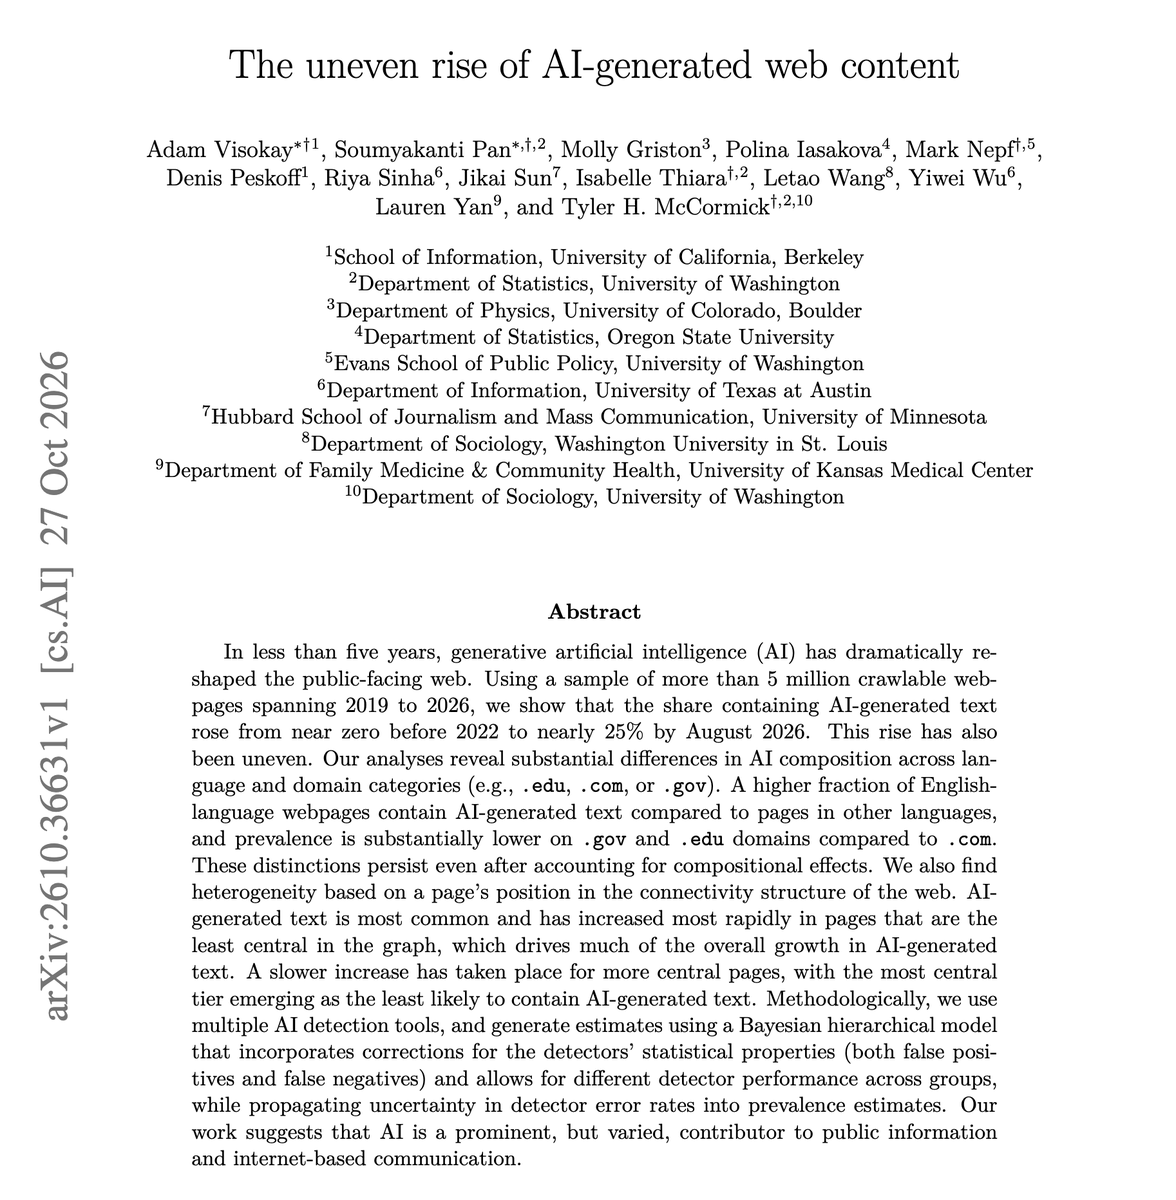
Une étude de Purdue révèle que 24 % des textes en ligne proviennent de l’IA : la prolifération sur les sites de traîne accentue la pollution de l’information : Une analyse empirique menée entre 2019 et 2026 sur plus de 5 millions de pages web indexables montre qu’en août 2026, environ 24 % du contenu en ligne présentait des traces de génération ou de modification par IA. Plus de 80 % de ces textes se concentrent sur des sites périphériques de longue traîne, et la pénétration des textes générés par IA dans les domaines commerciaux dépasse largement celle observée sur les sites éducatifs et gouvernementaux, soulevant de vives craintes de consanguinité des données synthétiques lors des futurs entraînements de modèles.(Source : omarsar0)
💼 Business
La startup d’infrastructure IA sobre en données Flapping Airplanes lève 1 milliard de dollars en série A : Cherchant à repenser les fondements de la descente de gradient et des fonctions de perte en deep learning, la jeune pousse Flapping Airplanes a annoncé une levée de fonds géante d’un milliard de dollars en série A, co-menée par Index Ventures et Lux Capital, avec la participation de Sequoia, KPCB et Nvidia. Fondée par les frères Spector, docteurs de Stanford, l’entreprise veut libérer l’IA de la dépendance vorace des architectures Transformer aux volumes de données massifs. Son système Megakernel réalise déjà au niveau matériel GPU une fusion complète de la passe avant avec une attente quasi nulle par carte, visant une efficacité d’apprentissage par échantillon comparable à celle du cerveau humain.(Source : 36Kr)
Deepgram rachète Daily, la société mère du framework audio-vidéo temps réel open source Pipecat : Deepgram, la licorne des infrastructures d’IA vocale, a annoncé l’acquisition de Daily, mainteneur du populaire framework open source audio et vidéo temps réel Pipecat. Les deux entités se sont engagées à maintenir Pipecat open source et neutre vis-à-vis des différents fournisseurs. Elles lanceront conjointement le protocole ouvert Real-time Context Standard (RCS), visant à normaliser les métadonnées multimodales dans les pipelines audio à faible latence pour créer un écosystème complet unissant reconnaissance vocale, orchestration de LLM, TTS et streaming full-duplex.(Source : TechCrunch)
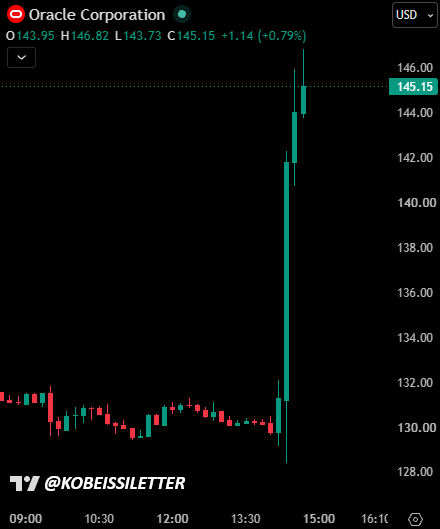
Oracle fixe un plafond à ses dépenses d’investissement en IA et une limite de financement, son cours bondit de plus de 10 % : Alors que les géants de la tech voient leur flux de trésorerie disponible sous pression en raison d’investissements colossaux en capacités de calcul, Oracle a rassuré ses investisseurs en fixant des balises financières claires : ses dépenses d’investissement dans l’IA atteindront leur pic entre les exercices fiscaux 2027 et 2028, tout nouvel emprunt externe sera strictement limité à 20 milliards de dollars d’ici 2030, et le flux de trésorerie disponible redeviendra positif au second semestre de l’exercice 2028. Saluant cette discipline d’allocation du capital, le marché a fait grimper l’action de 10,73 % sur la séance.(Source : damianvtran)
🌟 Communauté
Figure du développement indépendant, Pieter Levels résilie la plupart de ses abonnements SaaS commerciaux : le « sur-mesure à la demande » bouleverse le modèle par abonnement : Le célèbre développeur indépendant Pieter Levels a révélé avoir résilié la quasi-totalité de ses abonnements à des logiciels SaaS professionnels utilisés pour son exploitation quotidienne. Il s’appuie désormais sur des outils d’IA comme Claude Code pour coder en direct des micro-outils adaptés à ses besoins immédiats et modifier des briques open source. Il souligne que la montée en puissance des agents de code ébranle le modèle traditionnel des SaaS surfacturés aux fonctionnalités superflues, ouvrant la voie à une ère du logiciel personnalisé « généré à la demande, consommé et jeté ».(Source : WeChat)
Fuite du modèle secret « Obsidian 3 » dans la base de données FrontierCode 2.0 : le futur fleuron d’Anthropic en approche ? : La base de données du benchmark de code FrontierCode 2.0 a laissé fuiter des résultats de tests d’un modèle sous le nom de code « Obsidian 3 ». En mode de raisonnement intensif, ce modèle a obtenu 46,8 %, surpassant le leader actuel Claude Opus 5.5 (45,5 %), l’environnement d’évaluation étant étroitement lié aux infrastructures de Claude. La communauté spécule massivement qu’il s’agirait du prochain modèle haut de gamme imminent d’Anthropic, Claude Fable 5.5.(Source : imjaredz)
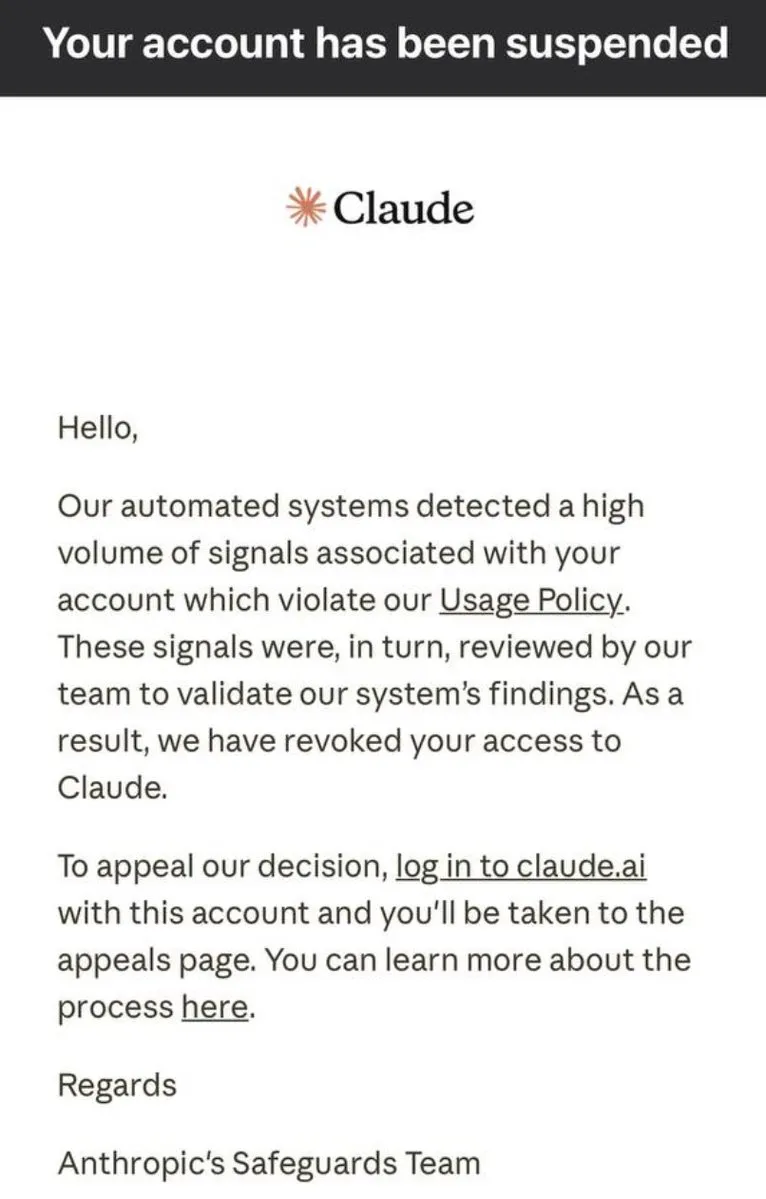
Le renforcement des contrôles KYC sur passeports internationaux par Anthropic déclenche une vague de bannissements chez les développeurs transfrontaliers : La communauté des développeurs rapporte qu’Anthropic a commencé à imposer une vérification d’identité KYC stricte par passeport physique à certains utilisateurs régionaux. Dès lors qu’un passeport relève d’une nationalité restreinte (telle que la Russie), le compte est banni immédiatement, même si le développeur réside légalement et durablement dans un pays autorisé comme la Nouvelle-Zélande. Cela relance les inquiétudes des développeurs internationaux quant à l’imprévisibilité des plateformes propriétaires fermées et aux risques de rupture géopolitique de service.(Source : teortaxesTex)
La rétro-ingénierie assistée par IA crée la sensation dans la scène rétro-gaming et bouscule les frontières du droit d’auteur : Les réseaux sociaux voient pulluler des mods et des « mashups » de jeux vidéo décompilés et reconstruits à toute allure grâce à des modèles comme Claude (portage de Cities: Skylines dans Minecraft, émulateurs multiplateformes, etc.). Les modèles de pointe abaissent tellement la barrière de l’ingénierie inverse binaire qu’une refonte en profondeur nécessitant auparavant des mois s’exécute désormais en une nuit. Cette tendance alerte les éditeurs mondiaux sur les risques de violation de copyright et de serveurs privés, tout en soulevant des craintes sur la sécurité de la distribution de code propriétaire fermé.(Source : The Guardian)

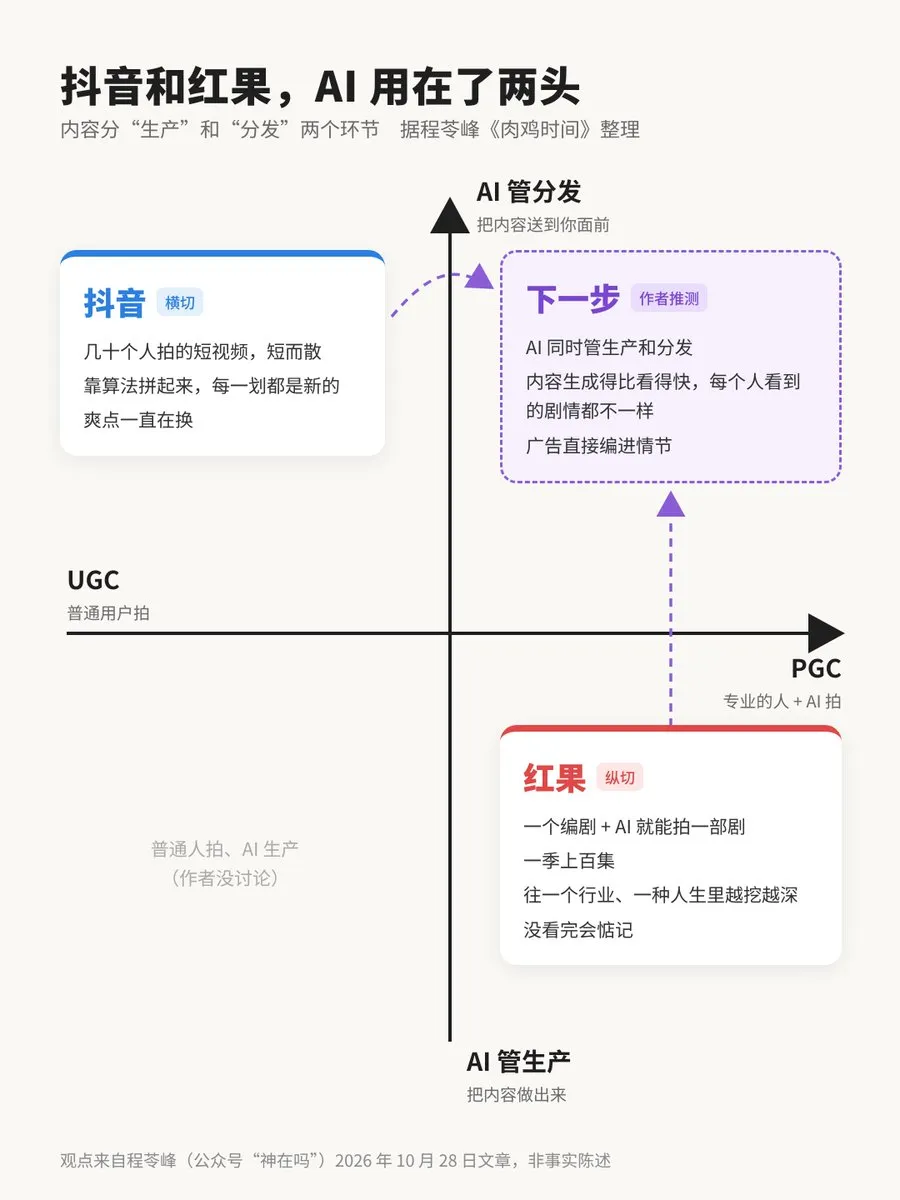
Les mini-séries de Hongguo dépassent 168 millions d’utilisateurs actifs quotidiens : bombe créative de contenu ou trou noir pour l’attention ? : Les journalistes Qin Shuo et Cheng Lingfeng ont engagé un débat de fond alors que l’application de mini-fictions Hongguo a franchi les 168 millions d’utilisateurs quotidiens, avec une moyenne de 125 minutes par jour et par utilisateur. D’un côté, on s’inquiète de voir les algorithmes et ces micro-séries low-cost d’IA aspirer le temps du grand public au détriment de la réflexion ; de l’autre, on souligne que l’IA a permis de créer une boucle ultra-rentable scénario-génération-distribution, renversant les monopoles traditionnels de distribution de trafic et risquant d’accentuer une fracture sociale en « courbe en K » entre divertissement abrutissant gratuit par IA et éducation payante d’élite.(Source : dotey)
Deux adolescents codent à la main un outil de restauration vidéo pour drones FPV : leur refus du « Vibe Coding » interpelle le monde de l’ingénierie : Deux jeunes développeurs de 10 et 14 ans ont mis au point en deux heures de rétro-conception DVR Doctor, un logiciel de restauration vidéo par machine learning pour corriger la neige sur les transmissions analogiques de drones FPV. Lors d’une interview, ils ont précisé que bien qu’ils utilisent l’IA pour apprendre certaines bibliothèques et API, les algorithmes centraux de flux optique et de reconstruction de pixels ont été intégralement rédigés à la main en rejetant le « vibe coding ». Leur démarche a alimenté une profonde réflexion parmi les ingénieurs : une trop grande dépendance à la génération par IA ne risque-t-elle pas de détruire la compréhension fondamentale des développeurs ?(Source : simonw)
💡 Divers
Le ministère américain de la Justice examine l’impact anticoncurrentiel du rachat potentiel de Hugging Face par Nvidia pour 13 milliards de dollars : D’après des sources proches du dossier, le département de la Justice des États-Unis (DOJ) a lancé une enquête antitrust préliminaire sur le projet de rachat de la plateforme open source Hugging Face par Nvidia pour un montant de 13 milliards de dollars. Les autorités cherchent à déterminer si Nvidia pourrait s’appuyer sur la position dominante de Hugging Face dans la communauté des développeurs et la distribution de modèles pour imposer un verrouillage exclusif avec son écosystème matériel et CUDA, entravant ainsi la concurrence équitable d’autres fabricants de puces IA.(Source : The Verge)
Le gouvernement américain accorde un prêt de 5 milliards de dollars pour étendre des centrales nucléaires, l’électricité étant réservée aux datacenters IA des géants de la tech : Le département américain de l’Énergie (DOE) a finalisé un accord de garantie de prêt conditionnel de 5 milliards de dollars destiné à soutenir Constellation Energy dans la prolongation d’activité et la montée en capacité de 8 centrales nucléaires, visant à libérer 1,1 GW d’énergie décarbonée de base. Cette capacité électrique supplémentaire est déjà pré-réservée par les datacenters de grands acteurs cloud dont Google, Meta et Amazon, mettant en évidence les besoins énergétiques colossaux en électricité propre induits par la course aux infrastructures d’IA.(Source : TechCrunch)
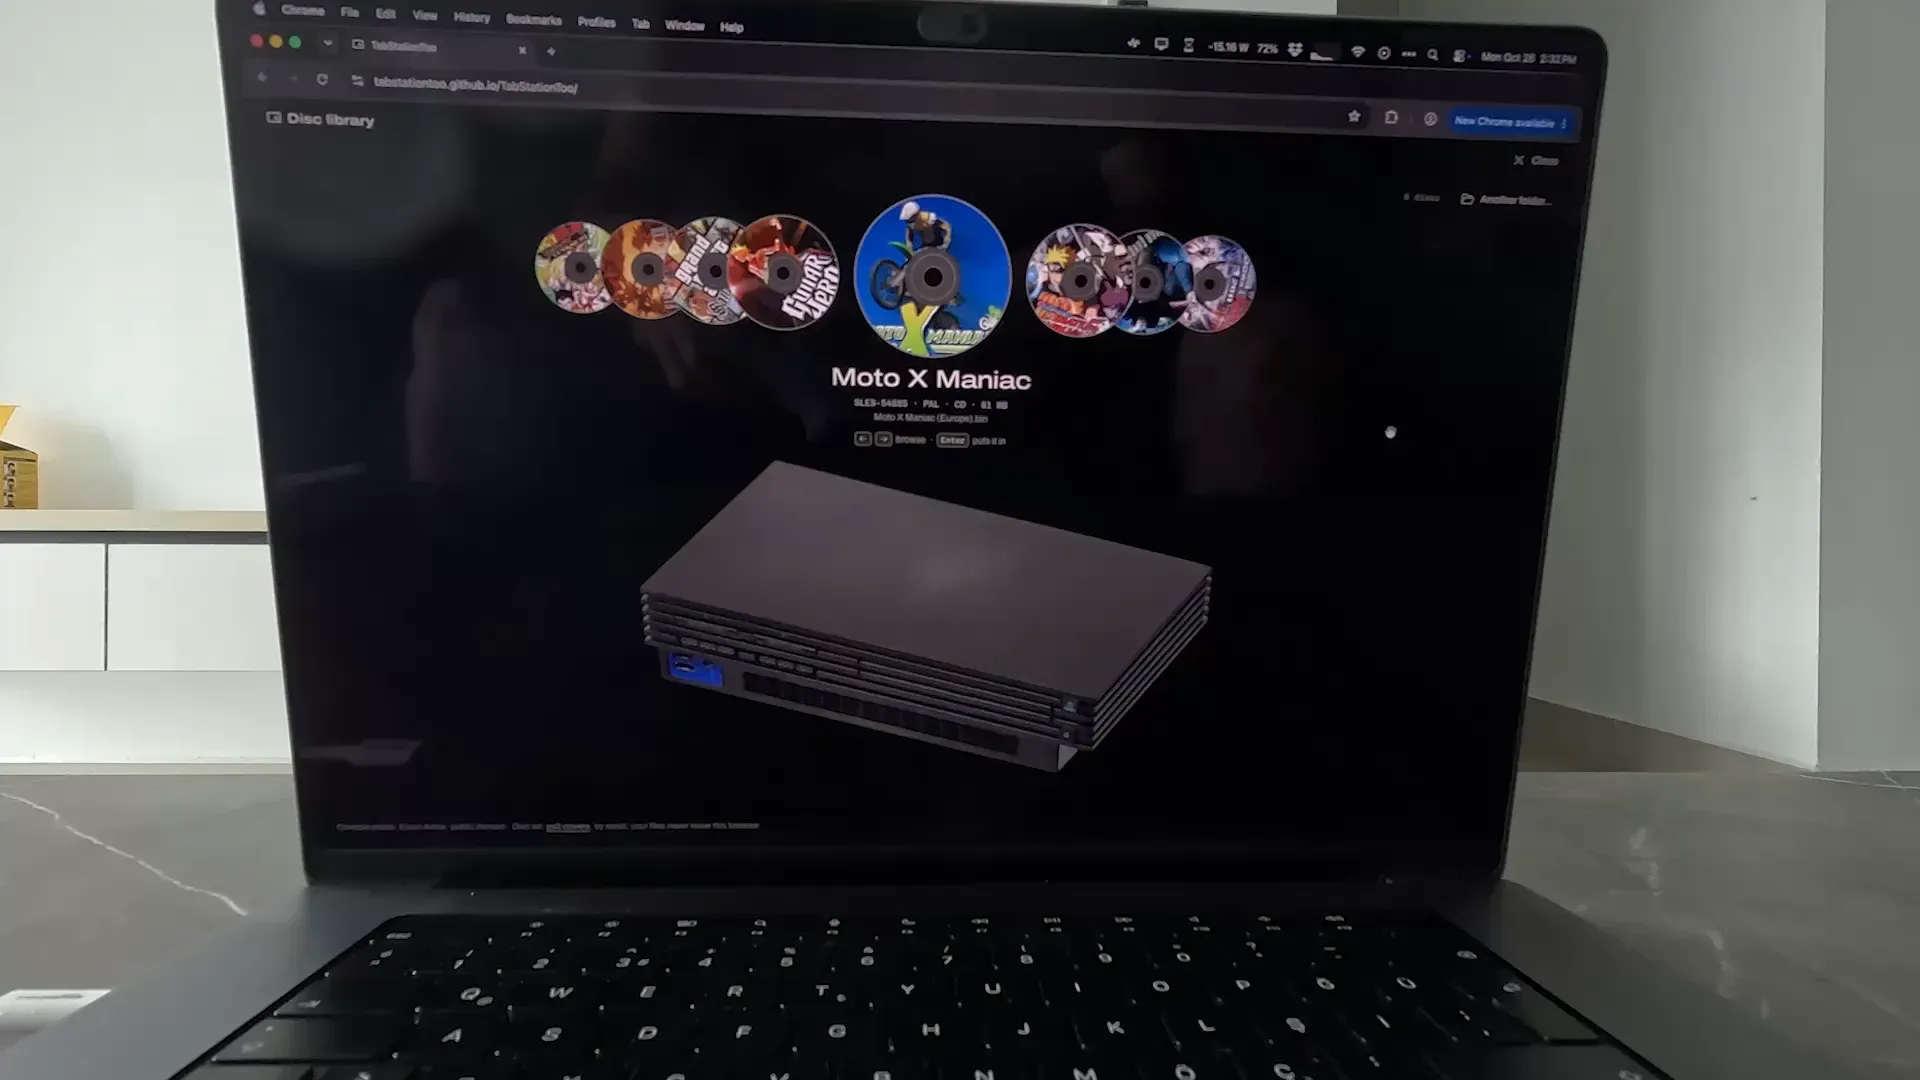
Des développeurs créent un émulateur PS2 natif pour navigateur propulsé par Claude Opus 5.5 : Une équipe de passionnés a mis en ligne le projet open source TabStationToo. Avec l’aide poussée de Claude Opus 5.5, l’architecture centrale de l’émulateur PCSX2 a été refondue et transpilée en code WebAssembly et WebGPU directement exécutable dans le navigateur. Il suffit aux utilisateurs d’ouvrir la page dans Chrome et de charger une image disque locale pour profiter des classiques de la PS2 à pleine vitesse sans aucune installation, illustrant l’incroyable efficacité des LLM de frontière dans la transpilation logicielle complexe entre architectures distinctes.(Source : Reddit r/ClaudeAI)