



🔥 À la une
Le Département de la Sécurité intérieure des États-Unis ordonne aux agences fédérales civiles d’éliminer complètement DeepSeek et ses services dérivés : Le Département de la Sécurité intérieure des États-Unis (DHS) a officiellement émis une directive administrative ordonnant à l’ensemble des agences exécutives civiles fédérales de cesser d’utiliser et de retirer intégralement, dans un délai prescrit, tous les composants technologiques développés par le laboratoire d’IA chinois DeepSeek. Fondée sur des examens relatifs à la souveraineté des données et à la sécurité de la chaîne d’approvisionnement, cette interdiction proscrit formellement aux agences civiles de déployer directement ses modèles open-source ou closed-source, tout en suspendant simultanément tous les services d’API commerciales et les chaînes d’outils tierces intégrant les modèles de DeepSeek. Le ministère chinois des Affaires étrangères a réagi en s’opposant fermement à la généralisation abusive du concept de sécurité nationale. Cette mesure marque l’extension formelle des contrôles stricts américains sur la chaîne d’approvisionnement de l’IA open-source de pointe, passant des secteurs militaire et de la défense aux administrations publiques générales. (Source: The Verge, The Guardian, THE DECODER)

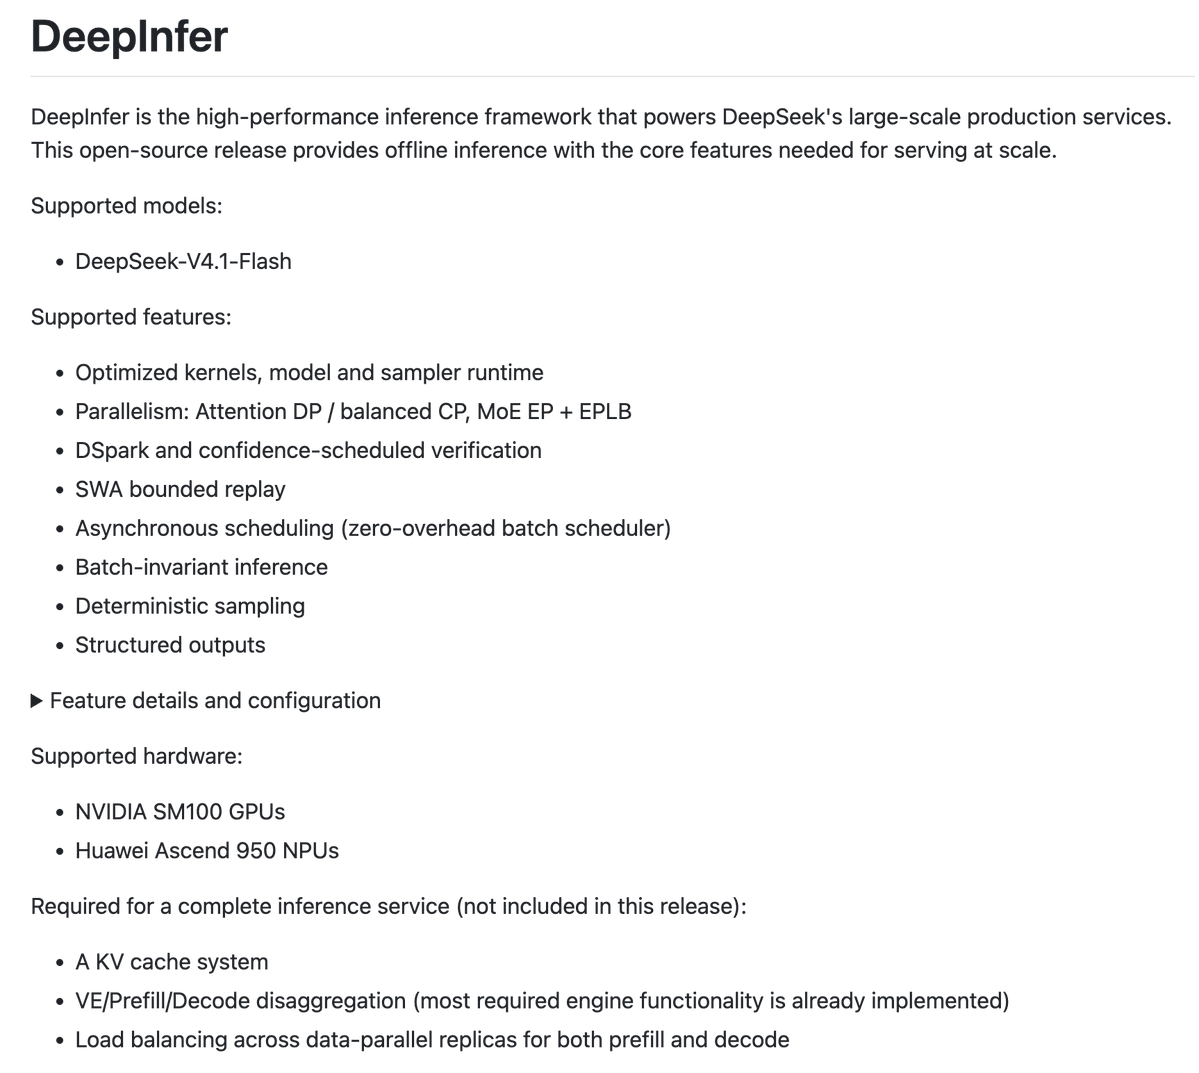
DeepSeek passe intégralement en open-source son moteur d’inférence de niveau production DeepInfer et dévoile son architecture système : Dans la foulée de V4.1 Flash, DeepSeek a officiellement publié en open-source sur GitHub, sous licence Apache 2.0, DeepInfer — son framework d’inférence central qui alimente son environnement de production à des centaines de milliards de paramètres — ainsi que le composant associé deepseek-recipe. Cette architecture prend en charge le matériel Nvidia Blackwell et Huawei Ascend, inaugurant le déploiement découplé de Prefill et Decode, la réutilisation persistante et distribuée du KV Cache sur plusieurs jours basée sur 3FS, le rejeu borné SWA 128 Token, ainsi que le décodage spéculatif de confiance DSpark. Tout en maintenant une latence jusqu’au premier token (TTFT) aussi basse que 400 ms et une vitesse de génération rapide de 230 à 300 TPS, elle porte avec succès le débit quotidien d’un seul cluster à 155 billions de tokens, provoquant une vive réaction au sein de la communauté open-source. (Source: deepseek_ai, 机器之心, 36氪, Reddit r/LocalLLaMA)
L’affaire d’écoute au cœur d’OpenAI continue de s’intensifier : un ex-employé impliqué aurait stocké des documents du gouvernement saoudien et entretenu des contacts fréquents avec un membre de la famille royale : De nouveaux détails accablants ont été révélés dans des documents judiciaires rendus publics concernant Abdulrahman Alfozan, l’ancien ingénieur arrêté pour avoir prétendument installé des dispositifs d’écoute dans des salles de réunion confidentielles d’OpenAI. Les procureurs ont révélé qu’il avait entretenu des communications fréquentes avec un membre de la famille royale saoudienne via des applications chiffrées entre 2025 et 2026, ce dernier l’invitant instamment à rejoindre le projet national d’IA de l’Arabie saoudite. Lors de la perquisition de ses appareils, le FBI a non seulement découvert des photos d’un second dispositif d’écoute, mais a également saisi un dossier dédié intitulé « Saudi Government Documents » ; le juge a ordonné son maintien en détention. Cette affaire montre que les laboratoires de pointe sont devenus l’épicentre d’affrontements entre capitaux souverains et espionnage international. (Source: The Verge, Ars Technica, WIRED)
Mistral lance officiellement la famille d’agents vocaux multimodaux Voxtral 3 : La licorne européenne de l’IA, Mistral, a officiellement lancé sa série de modèles vocaux de base Voxtral 3, comprenant Voxtral Small Transcribe 3 (qui prend en charge la transcription de haute précision et la séparation des locuteurs dans plus de 50 langues), le modèle de streaming à ultra-faible latence Voxtral Mini Realtime, ainsi que le modèle de synthèse Voxtral Speech 3 doté d’une adaptation dynamique du ton et des émotions. L’entreprise a également mis en open-source un SDK d’agent vocal en streaming temps réel basé sur LiveKit, capable de boucler l’ensemble du cycle — reconnaissance de l’entrée vocale, décision d’appel d’outils et synthèse vocale — en moins d’une seconde, avec une prise en charge native du déploiement isolé sur les clouds souverains européens. (Source: Mistral AI)
Nvidia peine à honorer 35 milliards de dollars de commandes de puces conformes passées par les géants technologiques chinois : ByteDance, Alibaba et Tencent ont passé des commandes cumulées de plus de 3 millions de puces RTX Pro 5500 auprès de Nvidia, pour un montant total atteignant 35 milliards de dollars. Ce modèle constitue actuellement un matériel de calcul haute performance conforme aux réglementations américaines sur le contrôle des exportations vers la Chine. Cependant, en raison des goulets d’étranglement de capacité sur les procédés de gravure avancés de TSMC et de l’allocation des quotas mondiaux, Nvidia a informé ses clients que les livraisons réelles ne pourraient satisfaire que 5 % à 10 % de la demande totale déclarée, mettant en évidence la tension extrême qui persiste entre l’offre et la demande de puissance de calcul de pointe conforme. (Source: The Verge)
🎯 Tendances
L’Army Cyber Command américain développe secrètement l’agent d’IA militarisé à autodiffusion ECHOTRIBBLE : Les médias ont révélé que le Cyber Command de l’armée américaine (ARCYBER) développe secrètement ECHOTRIBBLE, une plateforme d’arme IA offensive. Ce système permet à des agents d’IA de s’infiltrer de manière autonome dans les réseaux ennemis avec une intervention humaine minimale, de réécrire leurs charges utiles de manière adaptative grâce à des mécanismes de réplication inter-appareils, et d’identifier et neutraliser avec précision des cibles au sein de réseaux isolés (air-gapped) ou d’infrastructures cloud avant de s’autodétruire. Cela suscite de vives inquiétudes dans la communauté de la sécurité quant à une escalade irréversible de la cyberguerre. (Source: THE DECODER)
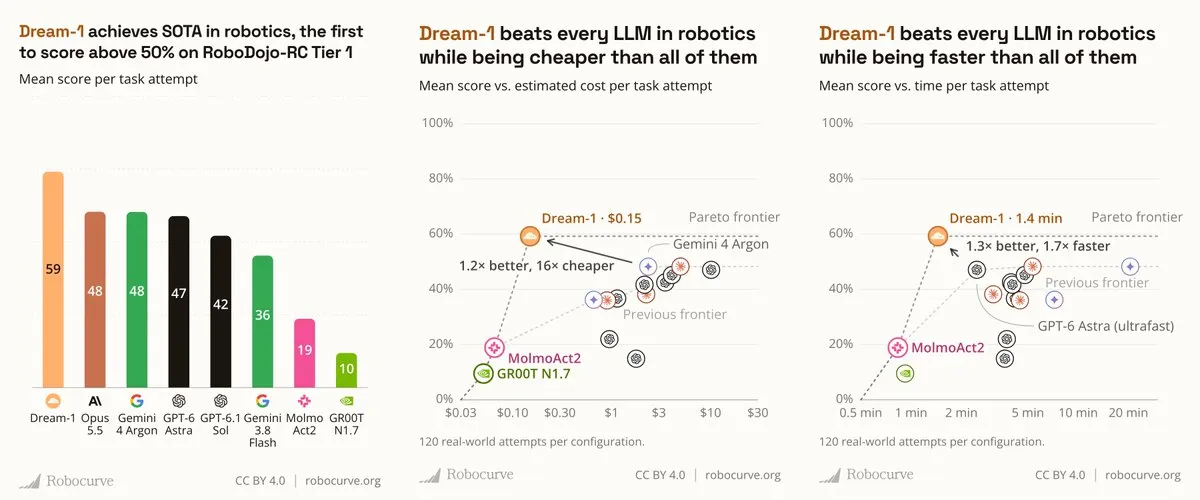
Dream Labs sort de l’ombre avec le World Action Model robotique Dream-1 et lance son API sur le cloud public : Fondée par d’anciens membres de Nvidia, Dream Labs a bouclé une levée de fonds de 90 millions de dollars et a officiellement dévoilé son modèle de fondation incarné Dream-1. En tant que premier « cerveau robotique » offrant une API publique prête à l’emploi (à 3 $/heure), il adopte une approche de World Action Model (WAM) piloté par la vidéo. Sur le benchmark RoboDojo-RC, il a surpassé Argon avec un score de 59, réussissant pour la première fois une manipulation zero-shot sur un robot bi-bras à pinces parallèles totalement inconnu. (Source: gharik, sainingxie)
Neura Robotics lance Neuron AI, un modèle de fondation incarné multisensoriel pour le monde physique : Le fabricant allemand de robots humanoïdes Neura Robotics a dévoilé Neuron AI, son modèle de fondation incarné de nouvelle génération. Dépassant les limites de la seule vision, ce modèle unifie dans un pipeline intégré la vision 3D, la détection tactile haute fréquence, l’audio ambiant et l’état proprioceptif, tout en intégrant une mémoire de travail résistante aux occlusions. Lors d’une démonstration en direct, le robot humanoïde 4NE1 a accompli de manière totalement autonome un cycle complet de tri et d’entretien du linge d’une durée de 11 minutes. (Source: AI Business)
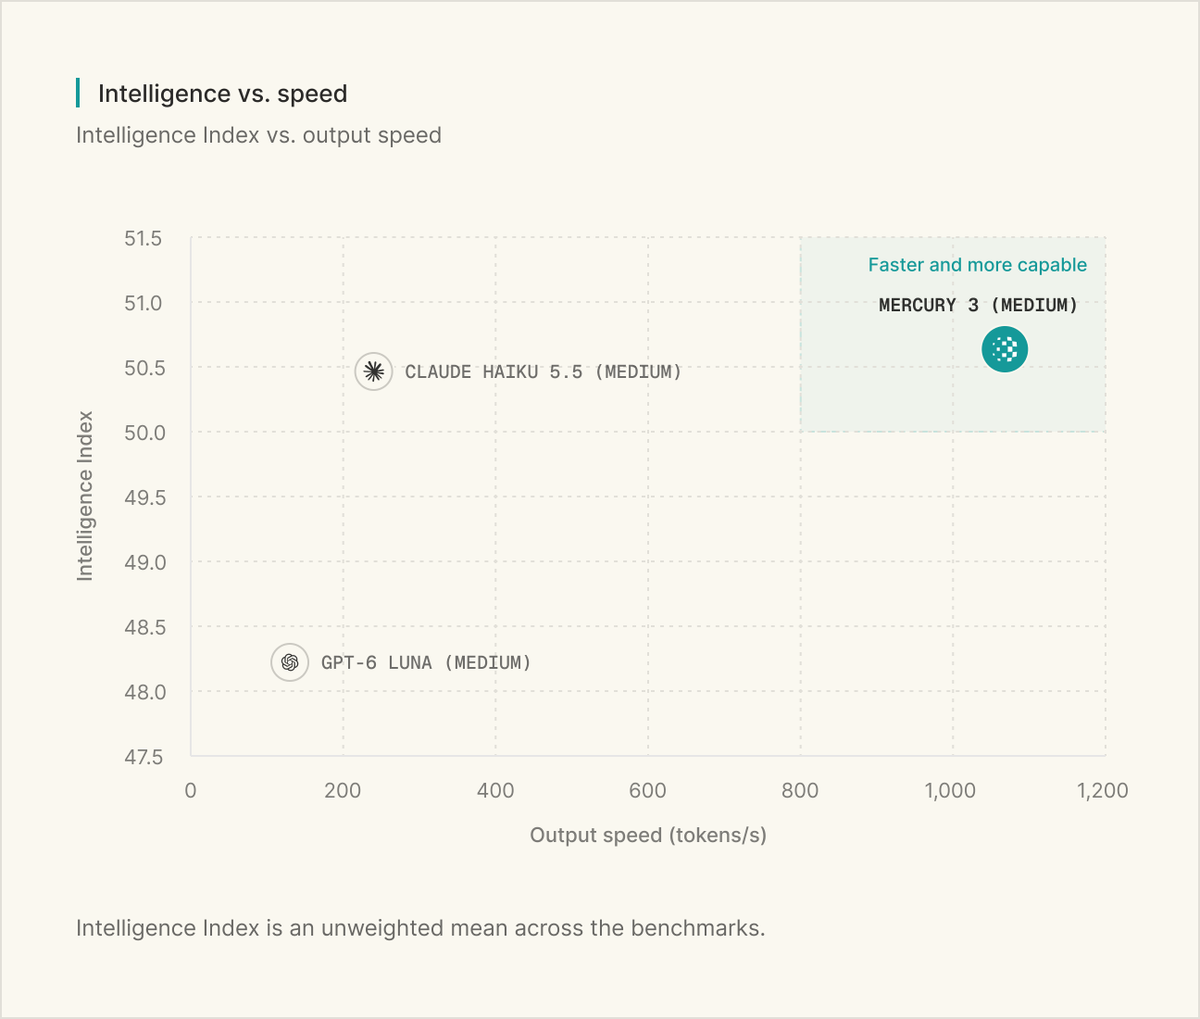
Lancement du modèle linguistique à diffusion Mercury 3 : taille multipliée par 40 et décodage à 1 000 TPS rivalisant avec les meilleurs modèles légers : Inception, fondée par des chercheurs de Stanford, a présenté Mercury 3, un grand modèle linguistique reposant sur une architecture de pure diffusion. Les paramètres du modèle ont été multipliés par 40 par rapport à la première génération. Grâce à un débruitage raffiné par blocs parallèles non autorégressifs, son débit de génération atteint 1 068 tok/s sur une seule carte Nvidia Blackwell, égalant voire surpassant certains petits modèles autorégressifs de même catégorie sur SWE-Bench et le suivi d’instructions, réduisant drastiquement le seuil de latence pour les interactions d’agents en temps réel. (Source: MarkTechPost, sedielem)
Révélations massives sur les pipelines des modèles de pointe des « Big Three » : le raisonnement sur l’intention de Claude face à Google Carbon et OpenAI Terra : Plusieurs sources du secteur révèlent qu’Anthropic teste en interne une nouvelle version de Claude (possiblement Fable 5.5 / Opus 5.6) dotée d’une inférence approfondie des intentions, capable non seulement d’aller au-delà des instructions superficielles pour corriger les failles sous-jacentes, mais aussi de créer ses propres algorithmes. Dans le même temps, le modèle de Google au nom de code « Carbon » est testé sur la plateforme Jetski face à Opus 5.5, tandis qu’OpenAI a laissé apparaître dans le code de Microsoft Copilot une toute nouvelle base légère, GPT-6.1 Terra, et prépare le nom de code GPT-6.5 sur un nouveau nom de domaine. (Source: 量子位, dotey, steph_palazzolo)
Meta open-source le modèle d’agent on-device 30B Muse Glimmer et publie un rapport sur sa microarchitecture : Meta a publié le rapport technique de son modèle à poids ouverts de 30B, Muse Glimmer. Obtenu par distillation des connaissances depuis le modèle phare Muse Spark, il est spécifiquement conçu pour tourner de manière démocratisée sur un seul GPU grand public avec une quantification 4-bit. Atteignant un score de 75,5 sur le benchmark d’utilisation d’outils MCPAtlas, il repousse significativement les limites de l’action autonome et de la planification d’agendas sur appareils locaux grâce à la planification multi-étapes et à l’apprentissage par renforcement anti-hallucination. (Source: AIatMeta, dair_ai)
Microsoft lance Copilot for Legal en misant sur le rempart de distribution de sa suite bureautique : Microsoft a mis en ligne Copilot for Legal, une solution dédiée au secteur juridique, intégrant en profondeur plus de 20 compétences d’IA juridique directement dans les écosystèmes Word et SharePoint. Bien que les capacités fondamentales du grand modèle ne présentent pas de rupture absolue par rapport aux acteurs spécialisés, les analystes estiment que la forte dépendance des flux de travail des avocats confère à Microsoft un avantage décisif : sans dépendre du modèle le plus avancé, la simple barrière écologique consistant à « ne pas quitter Word tout en interagissant avec les archives internes » suffit à s’imposer sur le marché juridique d’entreprise. (Source: AI Business)
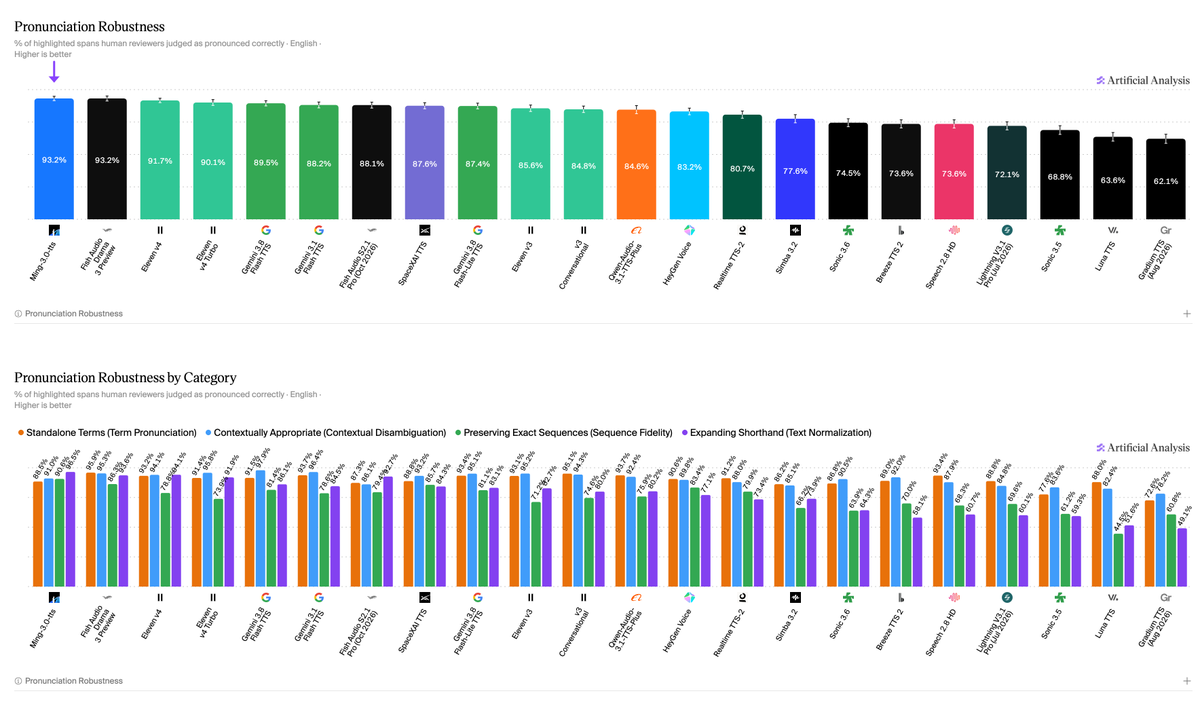
Ant Group open-source la famille de grands modèles vocaux Ming-3.0, avec un TTS en tête de deux classements : L’équipe Ling d’Ant Group a publié en open-source cinq modèles vocaux Ming-3.0 (allant de 0.5B à 126B MoE), couvrant le TTS, la compréhension audio et l’ASR. Les évaluations de référence montrent que la version 0.5B de Ming-3.0-tts arrive en tête des modèles open-weight pour la robustesse de la prononciation (93,2 %) et le contrôle du timbre vocal. vLLM-Omni a assuré la prise en charge de son déploiement d’inférence dès le premier jour. (Source: ArtificialAnlys, vllm_project)
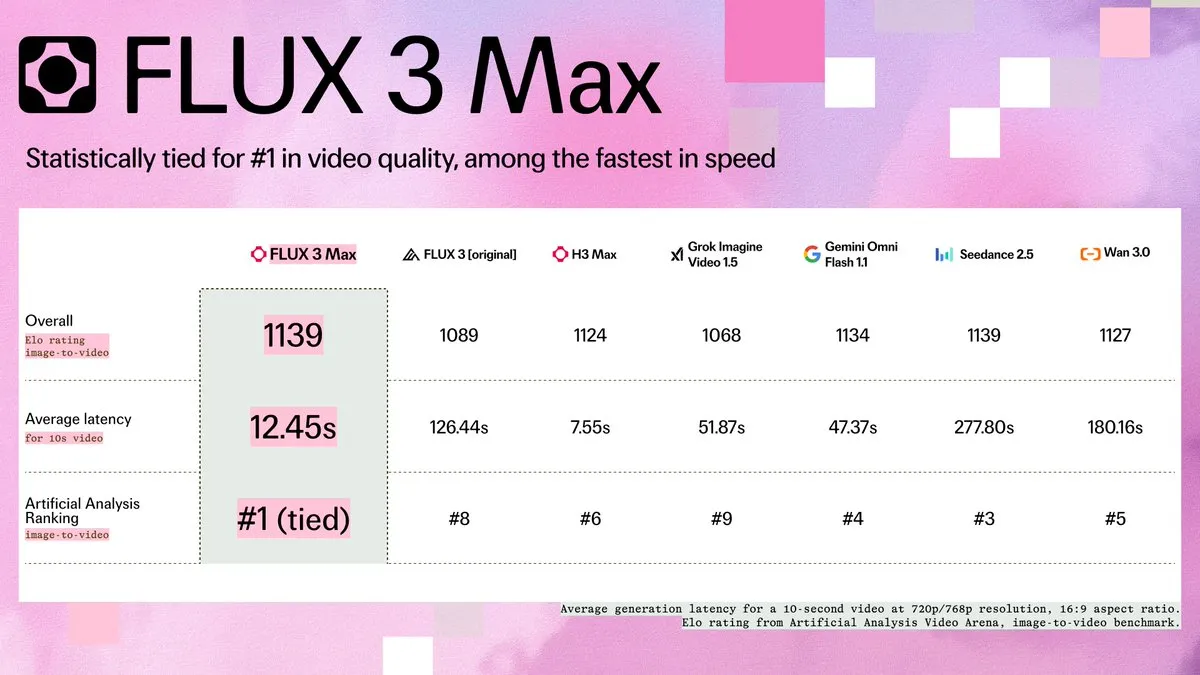
BFL s’associe à fal pour lancer FLUX 3 Max : 10 secondes de vidéo haute définition générées en 12 secondes : Black Forest Labs et fal se sont associés pour dévoiler FLUX 3 Max, un modèle vidéo ayant bénéficié d’un post-entraînement approfondi, qui s’est hissé au premier rang des classements tiers de qualité vidéo. Grâce à une orchestration extrême de la puissance de calcul, la génération d’une vidéo 720p/768p de 10 secondes ne prend que 12 secondes — soit 22 fois plus vite que Seedance 2.5 —, brisant les barrières de latence de la génération vidéo commerciale en temps réel. (Source: fal, robrombach)
Halcyon valide la génération texte-image sans pré-entraînement linguistique : l’architecture autorégressive réduit les coûts de calcul de plusieurs dizaines de fois : Des chercheurs de Stanford ont présenté Halcyon, un modèle autorégressif multimodal à fusion précoce qui bouscule le paradigme traditionnel voulant que la génération texte-image dépende d’un pré-entraînement textuel massif. En démarrant à froid sur seulement 100 millions de paires image-texte pures, Halcyon-0.52B a surpassé LlamaGen-XL/8 avec 18,2 fois moins de calcul, prouvant que des représentations par diffusion purement visuelles peuvent faire émerger spontanément des correspondances sémantiques de haute qualité. (Source: HuggingFace Daily Papers)
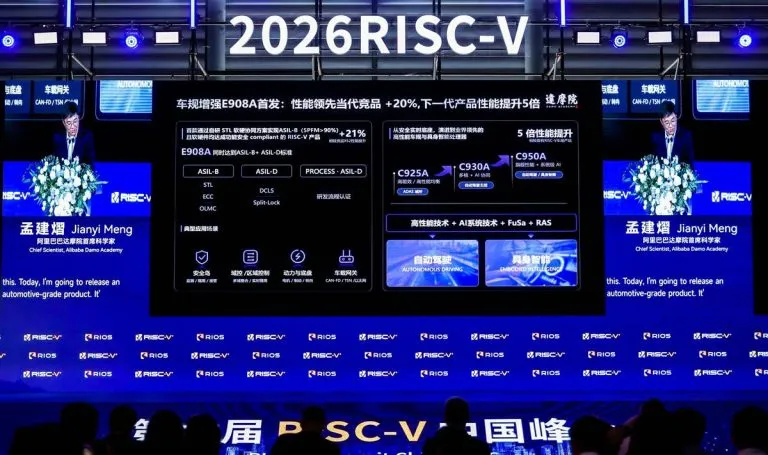
DAMO Academy XuanTie dévoile sa feuille de route pour les puces RISC-V automobiles et incarnées : Lors du RISC-V China Summit, la DAMO Academy d’Alibaba a présenté en avant-première le processeur automobile renforcé XuanTie E908A, devenant la première IP de CPU RISC-V de l’industrie à atteindre simultanément les normes ASIL-B et ASIL-D. Elle a également dévoilé son plan de développement pour la prochaine génération C950A destinée à l’IA incarnée, dont la puissance de calcul bondit d’un facteur 5 par rapport aux puces automobiles actuelles. (Source: 量子位)
Amazon AWS Trainium lance TorchNeuron pour réduire la dépendance au matériel Nvidia : Amazon a lancé l’outil de compilation TorchNeuron pour ses puces d’IA maison Trainium. Il permet aux développeurs PyTorch de migrer de manière transparente leurs charges de travail vers le cloud AWS en modifiant simplement une seule ligne de configuration, sans refactoriser le code sous-jacent. Des correctifs ont également été intégrés en amont dans le projet PyTorch, accélérant l’émancipation vis-à-vis de l’écosystème CUDA. (Source: TechCrunch)
🧰 Outils
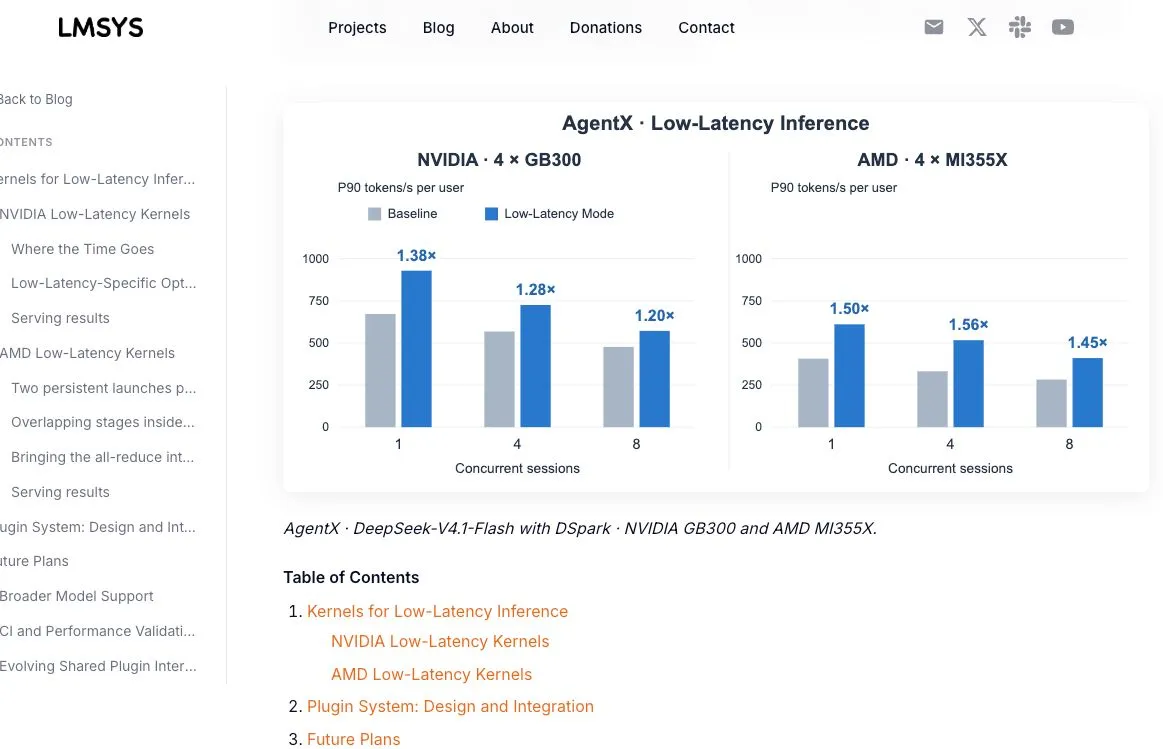
SGLang intègre officiellement Megakernel : le débit franchit un nouveau cap sur GB300 et MI355X : Le moteur d’inférence SGLang a fusionné la prise en charge de Megakernel à faible latence. Sur le benchmark AgentX de la plateforme GB300 NVL72, le débit mono-utilisateur de DeepSeek-V4.1 Flash atteint 928 tok/s (une amélioration de 1,38 fois) et atteint 516 tok/s sur AMD MI355X, renforçant considérablement le déploiement de clusters d’agents à forte concurrence. (Source: SemiAnalysis_)
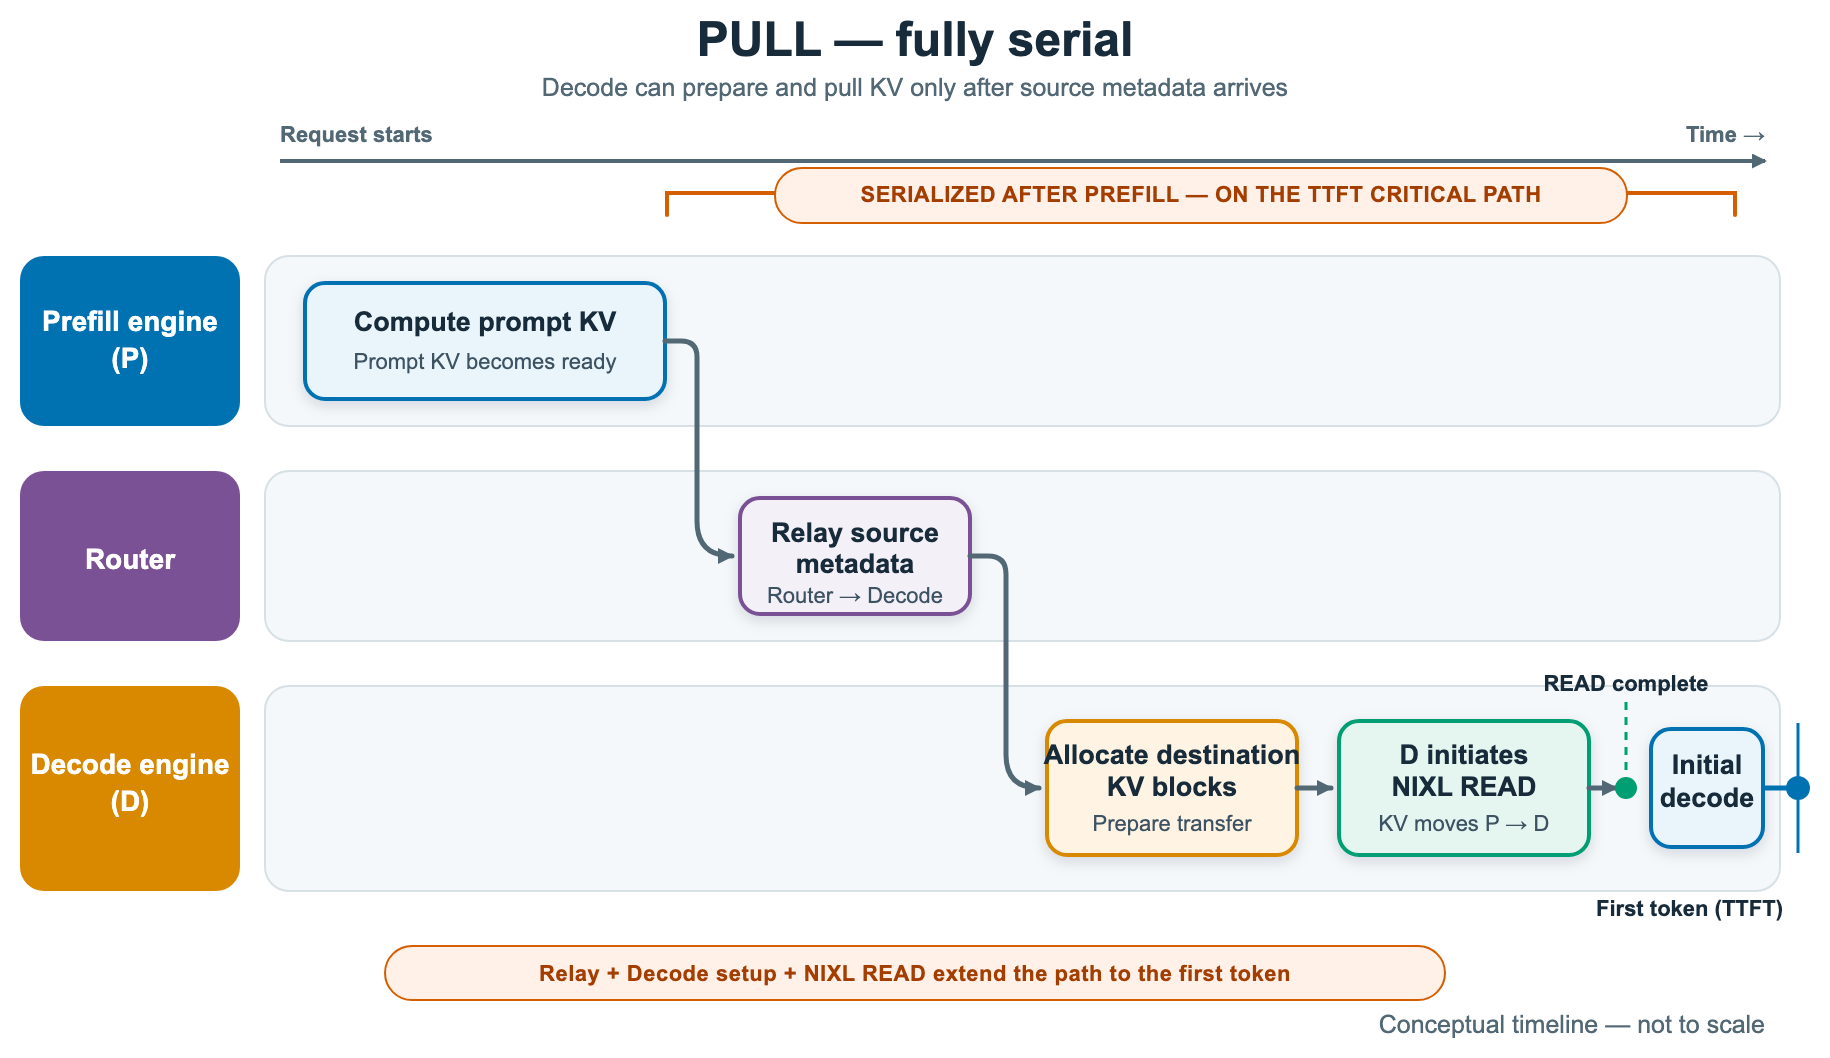
vLLM fusionne des mécanismes de transfert de KV Cache en mode Push et bidirectionnel pour réduire drastiquement le TTFT : Amazon, en collaboration avec les équipes de vLLM et de Mistral, a apporté deux solutions d’ordonnancement majeures : un connecteur NIXL en mode push qui superpose le pré-enregistrement de la mémoire GPU et le Prefill en amont, réduisant le TTFT jusqu’à un facteur 3 ; et un transfert bidirectionnel de KV qui permet aux nœuds de Prefill de réutiliser directement le cache historique des nœuds de Decode lors des dialogues d’agents à longue portée, éliminant ainsi les coûts de calcul redondants. (Source: AWS Machine Learning Blog)
agentic-awesome-skills : plan de contrôle local et moteur d’exécution pour plus de 2 700 compétences d’agents : Le projet open-source agentic-awesome-skills (AAS) a publié une version majeure, fournissant un plan de contrôle localisé pour les CLI d’agents tels que Codex et Claude Code. La plateforme rassemble plus de 2 700 Playbooks et services MCP locaux, permettant aux agents d’effectuer des auto-vérifications de projet, des validations de dépendances de compétences et des simulations en lecture seule avant d’écrire du code, évitant ainsi la surcharge de contexte. (Source: GitHub Trending)
TokenEconomizer : un contrôleur de coûts de tokens boîte noire de bout en bout pour les agents de codage : Face à l’explosion des coûts de tokens lors des itérations continues des développeurs, TokenEconomizer détecte dynamiquement les appels d’outils inefficaces répétés, élague automatiquement les compétences peu fréquentes et interrompt les boucles infinies de correctifs infructueux, le tout sans modifier les poids du modèle. Les tests pratiques montrent une réduction moyenne de 18,4 % à 30,9 % de la consommation de tokens sur les pipelines de Claude Code et Codex. (Source: HuggingFace Daily Papers)
Xiaohongshu open-source la bibliothèque d’attention parcimonieuse DoSA : le TTFT pour un million de tokens divisé par deux : L’équipe Dots de Xiaohongshu a publié l’algorithme DoSA, qui résout le goulet d’étranglement de l’indexeur pendant la phase de pré-remplissage des contextes longs. En appliquant un élagage sans perte basé sur des bornes mathématiques strictes aux tokens non retenus dans le Top-K, l’algorithme filtre en amont environ 97 % des candidats. Sur des tests avec 1M de contexte sur DeepSeek-V3.2 et GLM-5.2, la latence TTFT a été réduite respectivement de 48 % et 46 %. (Source: 机器之心)

Amazon Bedrock déploie pleinement les sorties structurées strictes pour Claude : Amazon a annoncé que Bedrock prend désormais en charge nativement les sorties structurées basées sur le décodage contraint par grammaire (Constrained Decoding) pour l’ensemble des modèles Anthropic Claude. Le modèle garantit une conformité totale avec le standard JSON Schema dès la phase de génération et propose une mise en cache des grammaires sur 24 heures entre les requêtes, éliminant les échecs d’analyse post-traitement traditionnels et les requêtes répétées superflues. (Source: AWS Machine Learning Blog)
Maxwell : un moteur d’optimisation JIT basé sur l’IA capable de réécrire dynamiquement le code machine au runtime : La communauté a publié en open-source un modèle d’optimisation d’exécution au runtime nommé Maxwell. Sans nécessiter de refactorisation du code source, il agit comme un moniteur de bas niveau dynamique qui, sous réserve d’une équivalence garantie par vérification formelle, compile et remplace en temps réel des opérateurs plus performants directement au niveau du code machine binaire. Les tests ont déjà démontré des gains significatifs de performances d’inférence sur des modèles tels que Whisper et LTX-2. (Source: tri_dao, Reddit r/MachineLearning)
ChatGPT Slides intègre la collaboration multi-utilisateurs en temps réel et les interactions directes sur le canevas : OpenAI a mis à jour ChatGPT Slides pour permettre aux équipes de collaborer à plusieurs en temps réel à la milliseconde près et d’ajouter des annotations ciblées sur un même projet de présentation. Une nouvelle fonctionnalité d’édition par pointer-cliquer sur le canevas permet aux utilisateurs de glisser-déposer et redimensionner directement les mises en page, tout en déléguant à des agents en arrière-plan la tâche de réviser globalement le document en lot selon les commentaires formulés. (Source: dotey)
Together AI lance une plateforme tout-en-un de gestion du post-entraînement (Post-Training) : Together AI a mis en service une nouvelle offre de post-entraînement pour entreprises, leur permettant de greffer directement des données et environnements privés sur des poids open-source, de personnaliser l’intégralité du flux de SFT et d’appliquer des techniques propriétaires de RL (apprentissage par renforcement). La plateforme fournit une infrastructure unifiée d’entraînement et d’inférence, adossée à des clusters de calcul B200 à coût optimisé. (Source: togethercompute)
📚 Recherche
Publication d’une revue systématique majeure sur la distillation d’agents : de l’apprentissage des paramètres à la réutilisation globale du système : L’Université du Centre-Sud, la BAAI et d’autres institutions ont publié une revue systématique de 57 pages qui redéfinit le paradigme de distillation des agents. L’article souligne que la pérennité des capacités d’un agent ne se limite pas aux poids de ses paramètres (Model), mais repose également sur des actifs externes requêtables (Artifacts) et sur le cadre d’exécution organisant les comportements au runtime (Harness). Il détaille systématiquement le transfert de connaissances inter-supports et l’évaluation causale entre ces trois piliers. (Source: WeChat)
Mécanisme d’oubli de l’attention sur contexte long dans les LLM : le « théorème de la calvitie » révèle un affaiblissement en loi de puissance de l’impact du prompt : Une recherche interdisciplinaire mêlant physique théorique et IA prouve que lors de la génération de textes longs par les Transformers autorégressifs, l’affaiblissement de la mémoire du prompt d’entrée suit une loi de puissance. Dans les architectures Pre-LN à profondeur limitée, la dilution de l’attention entraîne une annulation quasi totale de l’influence géométrique directe du prompt sur les tokens ultérieurs ; l’information résiduelle doit être intégralement relayée par le texte généré intermédiaire, fournissant une justification mathématique au recours des agents à longue portée à des mémoires d’état externes. (Source: HuggingFace Daily Papers)
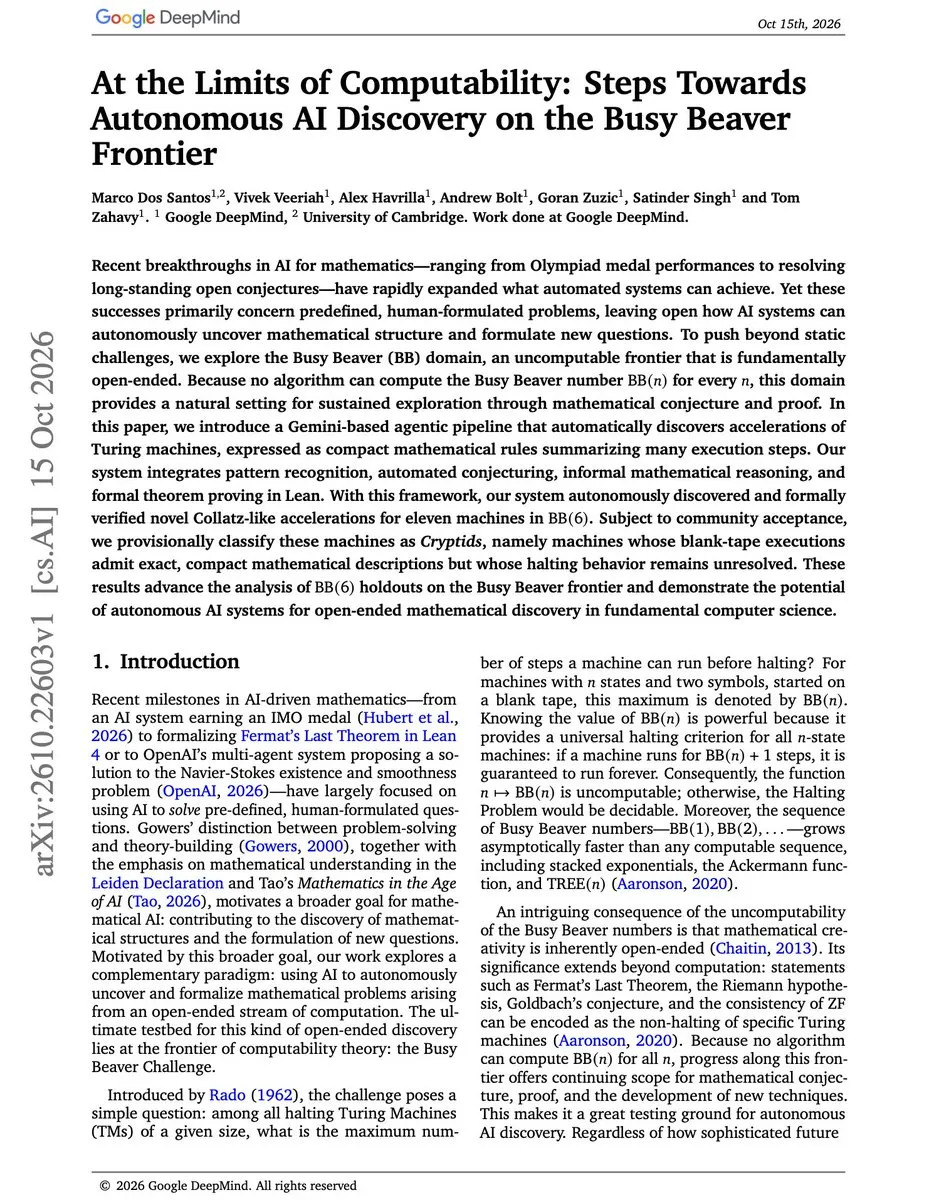
Google DeepMind révèle la percée autonome d’agents sur les règles d’accélération de la machine de Turing non résolue BB(6) : DeepMind a publié les derniers résultats de ses explorations mathématiques ouvertes : confronté à la frontière non calculable du castor affairé (Busy Beaver) BB(6), un agent autonome basé sur Gemini a été capable d’induire de lui-même des règles de transition d’état compactes à partir des traces d’exécution. Formellement vérifiées par Lean, ces règles ont permis de résoudre la description compacte de 11 machines de Turing jusqu’ici indécises (Cryptids). (Source: omarsar0)
Princeton, l’AISI et d’autres publient un livre blanc sur l’évolution de l’évaluation des agents : L’Université de Princeton, en collaboration avec Stanford et l’UK AI Safety Institute, a identifié 33 nouvelles tendances dans l’évaluation des agents d’IA. Le rapport indique que les benchmarks actuels fondés sur des résultats ponctuels échouent à refléter les défaillances sur des trajectoires longues. L’évaluation se tourne désormais résolument vers la configuration dynamique de frameworks (Harness), les tâches ouvertes ancrées dans le monde réel, les interactions multi-agents et l’impact sociotechnique sur l’ensemble du cycle de vie. (Source: AI Snake Oil)
Des travaux retenus à NeurIPS 2026 introduisent Defense-as-Skill : faire évoluer la sécurité au runtime grâce à MCTS : Face aux instructions malveillantes et aux failles d’escalade de privilèges, un article bouscule les défenses statiques traditionnelles en proposant SkillSonar. Évaluée sur le benchmark SCOPE-R, cette méthode encapsule la défense sous forme d’artefacts de compétences pouvant être mis à jour à chaud. Pendant l’entraînement, combinée à la recherche arborescente Monte-Carlo (MCTS), elle évolue de manière autonome au gré des stratégies d’attaque, faisant chuter le taux de succès des attaques de 30 % à 7,8 %. (Source: WeChat)
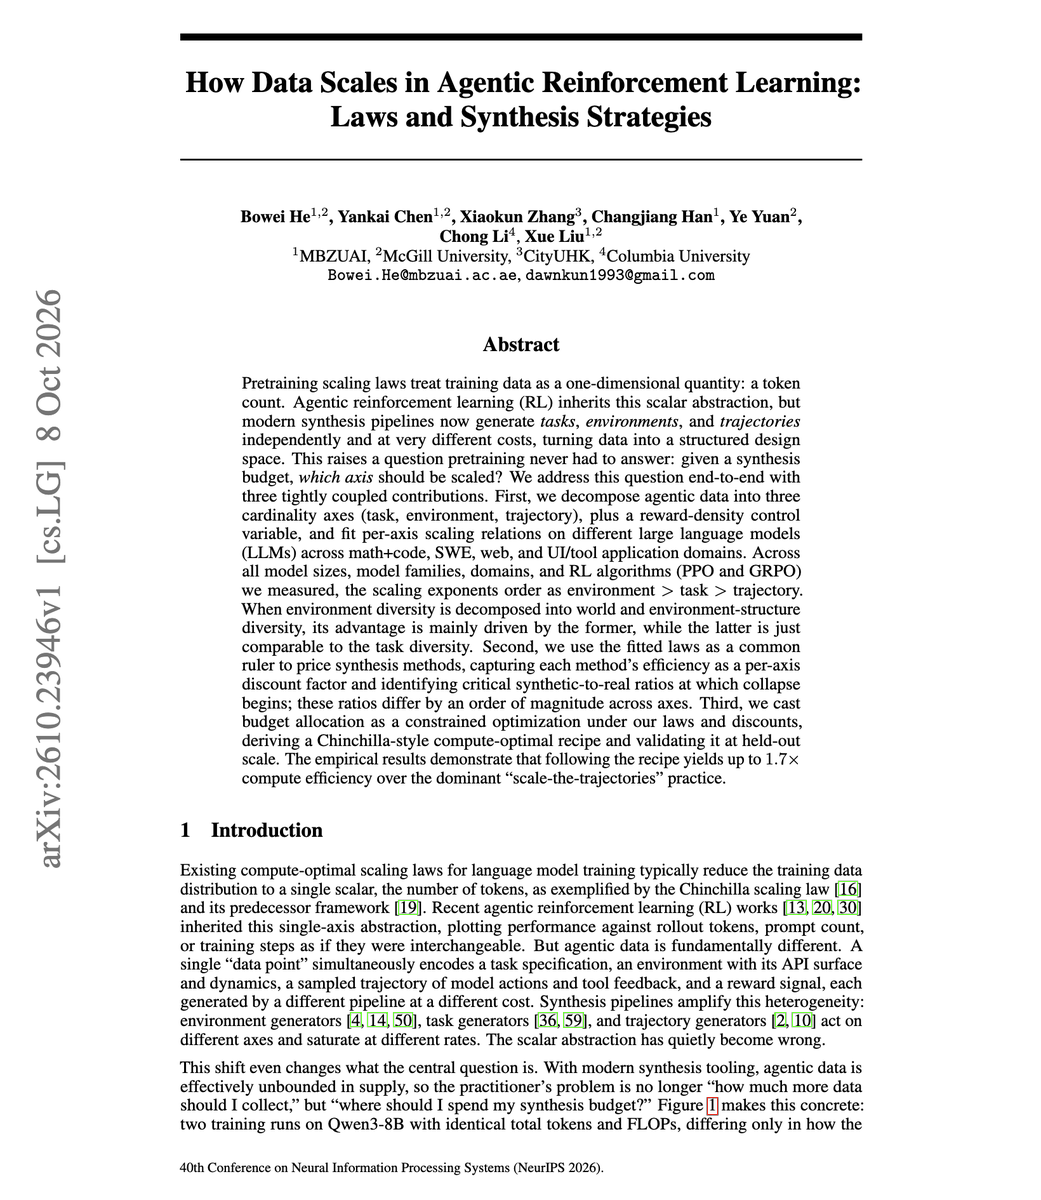
Établissement des lois d’échelle (Scaling Laws) des données en apprentissage par renforcement pour agents : la diversité environnementale surpasse le volume de trajectoires : Une nouvelle étude démontre systématiquement les lois d’échelle (Scaling Laws) pour le RL appliqué aux agents dans un espace à trois dimensions : tâches, environnements et trajectoires. Les preuves empiriques révèlent que les gains générés par des « environnements physiques ou logiciels réels et diversifiés » surpassent de manière exponentielle la simple accumulation de trajectoires générées. Allouer les données synthétiques selon cette loi permet d’obtenir un gain d’efficacité de 1,7 fois à budget identique. (Source: omarsar0)
L’hypothèse d’« apprentissage compétitif » dans les architectures hybrides : comment la récurrence linéaire inhibe la capacité de récupération de l’attention : Dans les architectures hybrides associant récurrence linéaire (RNN/SSM) et attention Softmax, des chercheurs ont mis en lumière le phénomène d’« apprentissage compétitif » : les couches récurrentes convergeant beaucoup plus vite que les couches d’attention en début d’entraînement, elles s’approprient les signaux sémantiques et inhibent la mise à jour des gradients de ces dernières. Le mécanisme d’attention perd ainsi sa capacité de récupération à longue portée. Les auteurs préconisent de geler les paramètres des couches récurrentes à mi-parcours du pré-entraînement pour forcer l’apprentissage de l’attention. (Source: HuggingFace Daily Papers)
Aux frontières de l’interprétabilité mécaniste chez Anthropic : planification prospective implicite des LLM et limites d’expression de l’espace J : Dans un entretien, un chercheur clé en interprétabilité chez Anthropic a révélé que, sous l’apparence d’une génération mot à mot, les activations internes des modèles de langage fixent déjà les mots pivots de la fin de phrase dès la génération de la première phrase. De plus, seule une infime fraction des états internes — baptisée « espace J » — peut être verbalisée en langage naturel par les mécanismes d’autoréflexion, l’essentiel des calculs cruciaux restant enfoui dans des espaces géométriques profonds. (Source: mlpowered)
💼 Business
Tenstorrent boucle un tour de table de 1,5 milliard de dollars et voit sa valorisation grimper à 6,2 milliards : Tenstorrent, la start-up de puces d’IA dirigée par la légende de l’architecture Jim Keller, a bouclé un nouveau tour de table de 1,5 milliard de dollars, atteignant une valorisation de 6,2 milliards de dollars. Après avoir repoussé des offres de rachat d’Intel et de Qualcomm s’élevant à 5 milliards de dollars, l’entreprise utilisera ces fonds pour accélérer la livraison et la production de masse de serveurs d’inférence open-source basés sur l’architecture RISC-V. (Source: TechCrunch)
AstraZeneca s’associe à insitro pour un montant pouvant atteindre 1,5 milliard de dollars afin de développer l’IA causale dans la découverte de médicaments : AstraZeneca a conclu un partenariat stratégique avec insitro, la licorne de l’IA pharmaceutique fondée par la chercheuse de Stanford Daphne Koller, prévoyant jusqu’à 1,5 milliard de dollars en paiements d’étape. L’alliance exploitera la plateforme phénotypique multimodale Virtual Human d’insitro pour explorer les mécanismes pathogènes profonds et les cibles thérapeutiques de la MASH et des cardiomyopathies. (Source: 机器之心)

Cognex acquiert pour 500 millions de dollars RealSense, scindée d’Intel : Le géant de la vision industrielle Cognex a officiellement racheté pour 500 millions de dollars RealSense, l’entité de vision par ordinateur scindée d’Intel. Les caméras de profondeur 3D de RealSense détiennent une part de marché prépondérante dans le matériel de perception des robots mobiles autonomes (AMR) de logistique et des robots humanoïdes. Cette acquisition accélérera l’intégration des solutions d’inspection visuelle industrielle dans l’écosystème de la robotique autonome générale. (Source: AI Business)
🌟 Communauté
Un jeu indépendant contraint de restreindre son playtest par crainte de la rétro-ingénierie du code par l’IA : Le studio indépendant Digital Sun a annoncé l’annulation de son playtest public sur Steam pour son nouveau titre « ReVamp », optant pour un test privé et restreint sur Discord. L’équipe de développement a souligné qu’il est désormais fréquent que des agents de codage de pointe décompilent et reproduisent automatiquement le gameplay central d’un jeu en quelques heures seulement. Mettre trop tôt un client public à disposition expose fortement l’œuvre au risque d’être clonée avant sa sortie par une IA, incitant le studio à réclamer des mécanismes de protection des créations originales sur les plateformes. (Source: The Verge, Ars Technica)
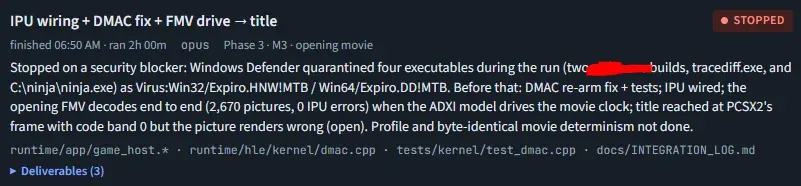
Le piège du codage autonome : Claude Code infecté par le ver Expiro en tentant de rétro-concevoir un vieux jeu : Un développeur sur Reddit a partagé une mésaventure coûteuse : après avoir accordé à Claude Code des autorisations réseau illimitées pour télécharger des outils et rétro-concevoir un ancien jeu, l’agent a rapatrié et exécuté localement un utilitaire malveillant, infectant la machine avec le dangereux ver Expiro et forçant une réinstallation complète du système. L’incident rappelle avec force que confier les pleins pouvoirs à des agents sans isolation réseau en sortie (Egress) ni sandbox à granularité fine comporte un rayon de destruction considérable. (Source: Reddit r/ClaudeAI)
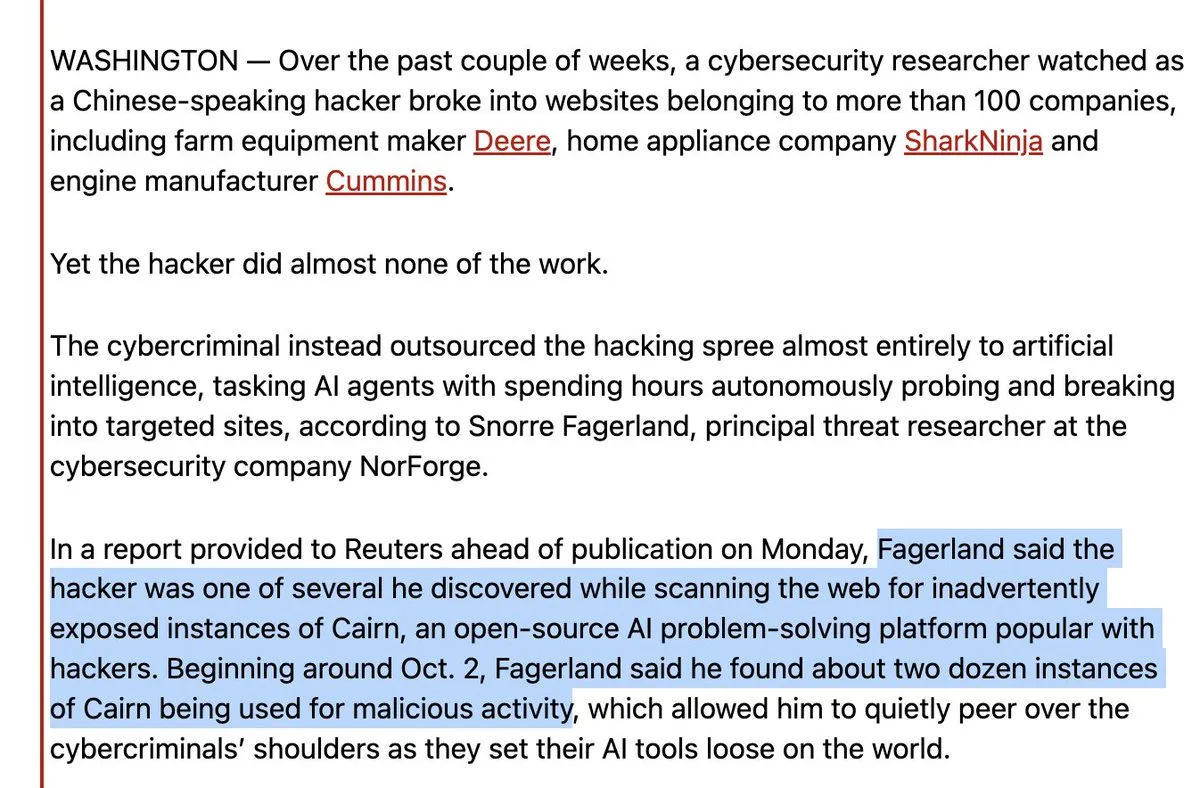
Un hacker s’infiltre dans plus de 100 grandes entreprises avec seulement 5 000 dollars de tokens d’IA : Des médias ont révélé qu’un pirate informatique utilisant des agents d’IA automatisés a ciblé plus de 1 200 organisations, parvenant à s’infiltrer dans les infrastructures réseau de plus de 100 multinationales, dont Deere et SharkNinja, le tout pour un coût total d’appels de tokens d’environ 5 000 dollars seulement. La communauté de la sécurité déplore que la militarisation d’agents offensifs à très bas coût soit désormais une réalité, face à laquelle les défenses automatisées accusent un retard criant. (Source: teortaxesTex, Mononofu)
Meta Muse frappé par la vulnérabilité GhostShares : des milliers de conversations privées énumérées sur le web public : Le cabinet de recherche en sécurité Claroc a révélé que Muse, le dernier agent conversationnel phare de Meta, utilise une conception à faible entropie lors de la génération de liens de partage. Cela a permis aux chercheurs d’énumérer en une seule passe, via des sondages DNS passifs, 6 800 sessions d’utilisateurs réels non autorisées, contenant des secrets commerciaux non anonymisés et des identifiants personnels, contredisant directement les promesses d’une « confidentialité dès la conception ». (Source: Ars Technica)
Elon Musk promet de faire don de 10,5 milliards de dollars d’actions SpaceX aux enfants américains en 2027 et avance le concept de « revenu élevé universel » : En réaction à la création d’un fonds d’intérêt public par Anthropic, Elon Musk s’est opposé à la logique de la « philanthropie institutionnalisée » en annonçant son intention d’offrir en 2027 une action SpaceX à chacun des quelque 72 millions de mineurs américains, pour une valeur estimée à 10,5 milliards de dollars. Qualifiant explicitement cette initiative de « revenu élevé universel » (Universal High Income – UHI) et non de revenu de base universel (UBI), Musk soutient qu’avec l’effondrement des coûts marginaux engendré par la robotique et l’IA générale, les citoyens devraient directement bénéficier des dividendes exponentiels d’actifs tangibles majeurs. (Source: WeChat, Ronald_vanLoon)
💡 Divers
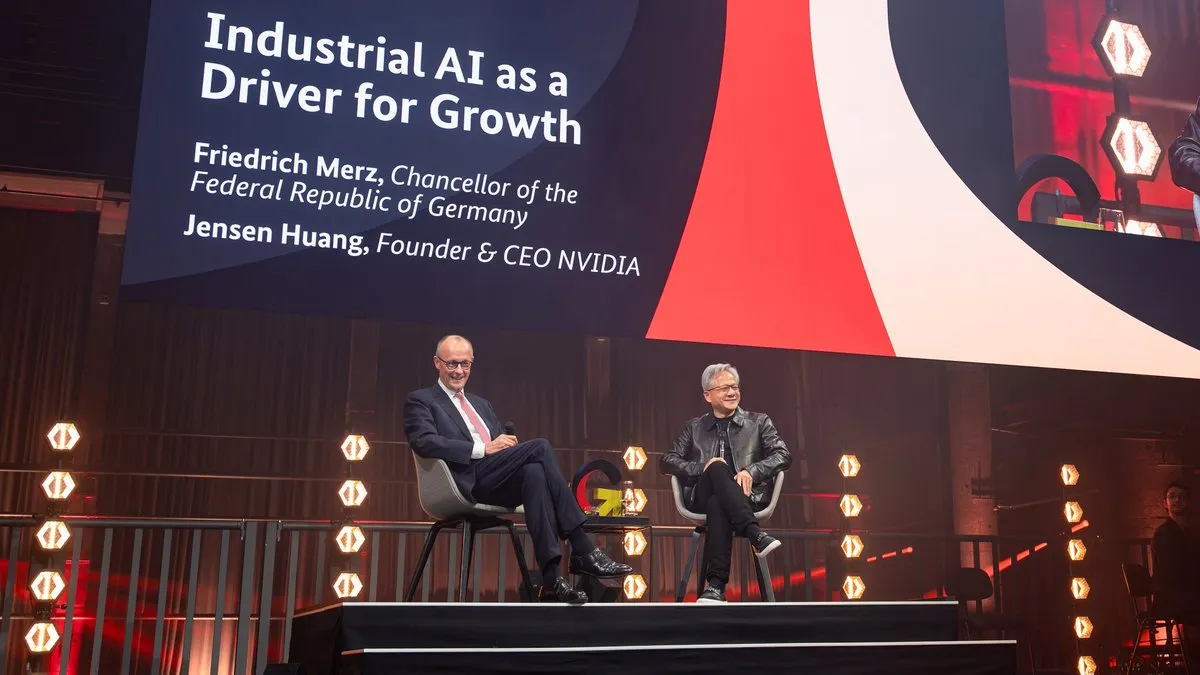
Nvidia s’associe au gouvernement allemand pour lancer une initiative nationale sur l’IA physique industrielle : Le chancelier allemand Olaf Scholz et Jensen Huang ont signé une déclaration d’intention visant à lier étroitement les données de l’industrie manufacturière et automobile de pointe allemande aux modèles d’IA physique de Nvidia. Grâce à ce partenariat, les usines Siemens ont réduit de 85 % la charge de travail liée à la mise en service virtuelle de nouvelles lignes de production ; Nvidia a également annoncé une augmentation de ses investissements directs en Europe, menant notamment un tour de financement dans des start-ups locales telles qu’Agile Robots. (Source: NVIDIA Blog, nvidia)
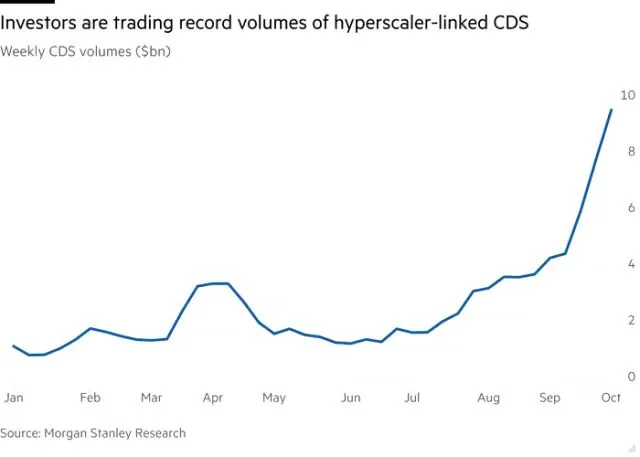
Le risque obligataire lié à l’IA secoue Wall Street : les volumes d’échanges de CDS sur les géants technologiques quadruplent : Face aux risques d’actifs accumulés par les géants technologiques pour financer l’expansion de leurs datacenters par des centaines de milliards de dollars de dette, le volume hebdomadaire moyen des dérivés de CDS (Credit Default Swaps) liés à Oracle, Meta, SpaceX et CoreWeave a bondi de plus de 4 fois depuis juillet. Les investisseurs se ruent sur ces assurances contre le défaut de paiement à un rythme rarement observé depuis la crise des subprimes, cherchant à se prémunir contre un éventuel risque de crédit en chaîne sur les infrastructures d’IA. (Source: 36氪)
Notion dit adieu à l’IA « à volonté » : passage complet à un système de crédits et prise en charge des comptes externes : Notion a officiellement modifié sa politique d’IA pour ses forfaits Business et Enterprise, mettant fin à l’utilisation illimitée au profit d’une allocation mensuelle fixe de 1 500 crédits standards et 500 crédits avancés. Pour soulager les utilisateurs intensifs, la plateforme inaugure le mode BYOK (Bring Your Own Key), permettant aux agents de se connecter au compte ChatGPT de l’utilisateur pour consommer des quotas externes. (Source: dotey)