



🔥 En foco
El Departamento de Seguridad Nacional de EE. UU. ordena a las agencias civiles federales eliminar por completo DeepSeek y sus servicios derivados : El Departamento de Seguridad Nacional de EE. UU. (DHS) emitió formalmente una orden ejecutiva instruyendo a todas las agencias ejecutivas civiles federales a discontinuar y retirar por completo en un plazo determinado todos los componentes tecnológicos desarrollados por el laboratorio de AI chino DeepSeek. La prohibición se basa en revisiones de soberanía de datos y seguridad de la cadena de suministro, prohibiendo expresamente a las agencias civiles desplegar directamente sus modelos de código abierto o cerrado, e interrumpiendo simultáneamente cualquier servicio de API comercial y cadenas de herramientas de terceros integradas con modelos DeepSeek. El Ministerio de Asuntos Exteriores de China respondió oponiéndose firmemente a la generalización del concepto de seguridad nacional. Esta medida marca la expansión formal del escrutinio de EE. UU. sobre la cadena de suministro de AI de código abierto de vanguardia, extendiéndose desde los sectores militar y de defensa hacia las agencias administrativas generales. (Fuente: The Verge, The Guardian, THE DECODER)

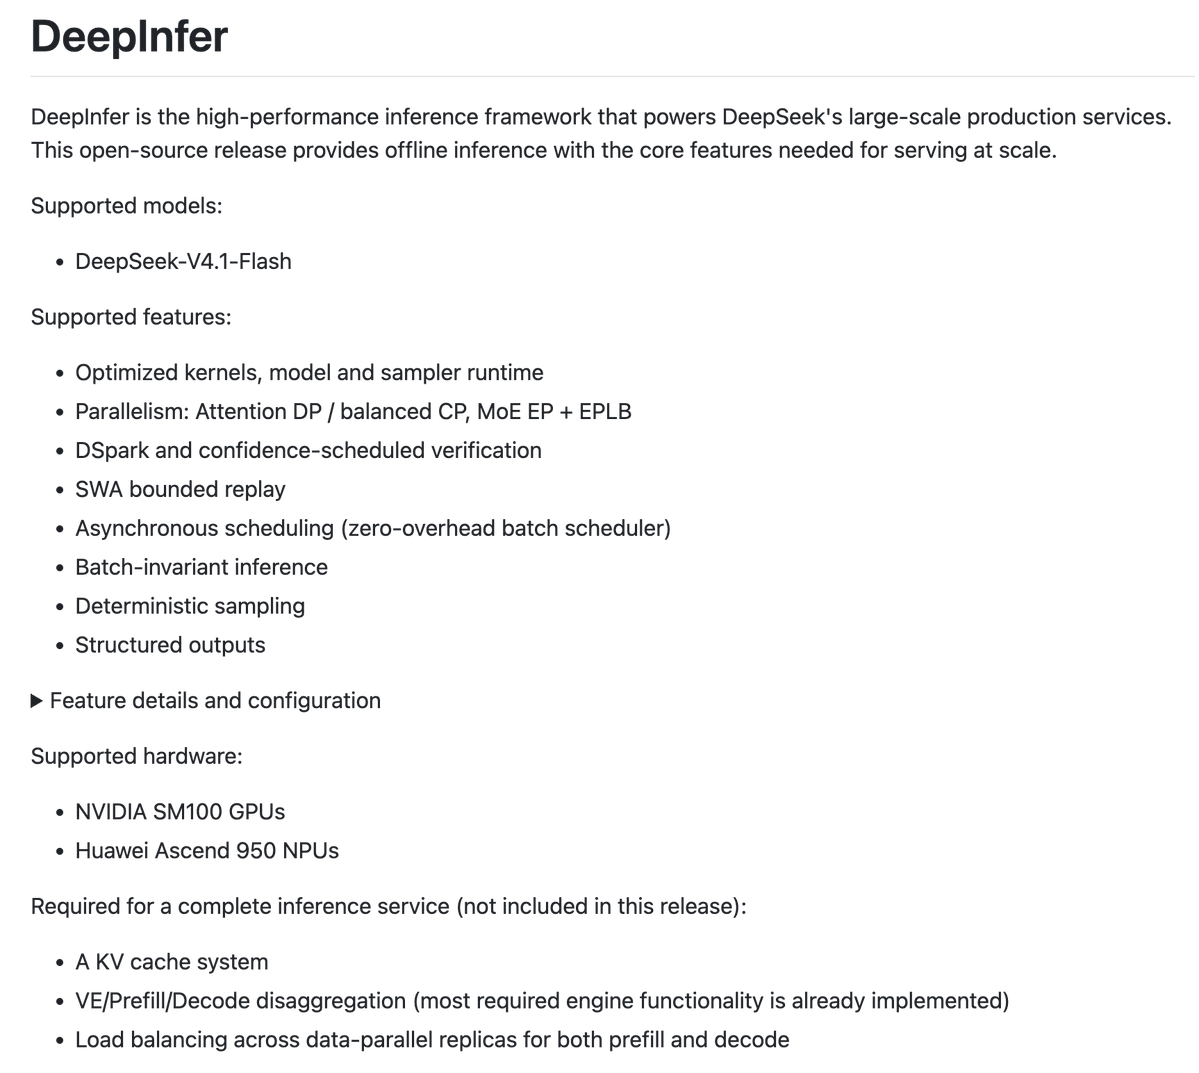
DeepSeek abre completamente el código de su motor de inferencia de producción DeepInfer y desclasifica su arquitectura de sistema : Tras V4.1 Flash, DeepSeek liberó oficialmente en GitHub bajo la licencia Apache 2.0 el marco de inferencia central DeepInfer y su componente complementario deepseek-recipe, que sostienen su entorno de producción de cientos de miles de millones de parámetros. La arquitectura es compatible con el hardware NVIDIA Blackwell y Huawei Ascend, introduciendo por primera vez el despliegue desacoplado de Prefill y Decode, la reutilización persistente distribuida entre días de KV Cache basada en 3FS, la reproducción delimitada de SWA 128 Token y la decodificación especulativa por confianza DSpark. Manteniendo una latencia hasta el primer token (TTFT) tan baja como 400 ms y una generación de alta velocidad de 230–300 TPS, logró elevar el rendimiento diario por clúster a 155 billones de tokens, causando una fuerte conmoción en la comunidad de código abierto. (Fuente: deepseek_ai, 机器之心, 36氪, Reddit r/LocalLLaMA)
El caso de escuchas ilegales en el área central de OpenAI sigue escalando: se revela que el exempleado implicado guardaba documentos del gobierno saudí y mantenía contacto frecuente con la realeza : Los últimos documentos judiciales hechos públicos sobre el exingeniero Abdulrahman Alfozan, arrestado por presuntamente instalar dispositivos de escucha en salas de reuniones confidenciales de OpenAI, han revelado graves detalles. La fiscalía reveló que entre 2025 y 2026 mantuvo comunicaciones de alta frecuencia a través de software cifrado con un miembro de la familia real saudí, quien lo invitó reiteradamente a unirse a un proyecto nacional de AI de Arabia Saudita. Al registrar sus dispositivos, el FBI no solo encontró fotos de un segundo dispositivo de escucha, sino que también incautó una carpeta dedicada titulada “Documentos del Gobierno Saudí”. El juez ha ordenado que permanezca bajo custodia. El caso pone de manifiesto que los laboratorios de vanguardia más destacados se han convertido en el epicentro de conflictos entre el capital soberano y el espionaje transnacional de inteligencia. (Fuente: The Verge, Ars Technica, WIRED)
Mistral lanza oficialmente la familia de agentes de voz multimodales Voxtral 3 : El unicornio europeo de AI Mistral presentó oficialmente su serie base de voz Voxtral 3, que abarca Voxtral Small Transcribe 3 (con soporte para dictado de alta precisión y diarización de hablantes en más de 50 idiomas), el modelo de streaming de latencia ultrabaja Voxtral Mini Realtime y el modelo de síntesis Voxtral Speech 3 con adaptación de entonación y emoción. La compañía también liberó como código abierto un SDK para agentes de voz en streaming en tiempo real basado en LiveKit, capaz de completar el ciclo cerrado de reconocimiento de voz, toma de decisiones con llamadas a herramientas y síntesis de voz en menos de 1 segundo, con soporte nativo para despliegues aislados en la nube soberana europea. (Fuente: Mistral AI)
NVIDIA tiene dificultades para satisfacer los pedidos de chips conformes a la normativa de 35.000 millones de dólares de los gigantes tecnológicos chinos : ByteDance, Alibaba y Tencent realizaron pedidos adicionales conjuntos a NVIDIA por más de 3 millones de chips RTX Pro 5500, con un valor total de pedido de hasta 35.000 millones de dólares. Este modelo es actualmente el hardware de computación de alto rendimiento que cumple con las regulaciones de control de exportaciones de EE. UU. hacia China. Sin embargo, debido a los cuellos de botella en la capacidad de procesos avanzados de TSMC y a la asignación de cuotas globales, NVIDIA ha notificado a sus clientes que el suministro real podría cubrir solo entre el 5% y el 10% de la demanda total declarada, lo que refleja que la brecha de oferta y demanda de capacidad de cómputo conforme a las normativas de vanguardia sigue siendo sumamente crítica. (Fuente: The Verge)
🎯 Tendencias
El Comando Cibernético del Ejército de EE. UU. desarrolla en secreto ECHOTRIBBLE, un agente de AI de propagación autónoma de grado armamentístico : Informes de prensa han revelado que el Comando Cibernético del Ejército de EE. UU. (ARCYBER) está desarrollando en secreto la plataforma de ciberarmas ofensiva basada en AI, ECHOTRIBBLE. El sistema permite a los agentes de AI infiltrarse de forma autónoma en redes enemigas con una mínima intervención humana, utilizar mecanismos de replicación entre dispositivos para reescribir de forma adaptativa sus cargas útiles (payloads), e identificar de forma autónoma y paralizar con precisión objetivos tanto en redes con aislamiento físico (air-gapped) como en infraestructuras en la nube, para luego autodestruirse. Esto ha suscitado una profunda preocupación en la comunidad de seguridad ante una escalada irreversible de la ciberguerra. (Fuente: THE DECODER)
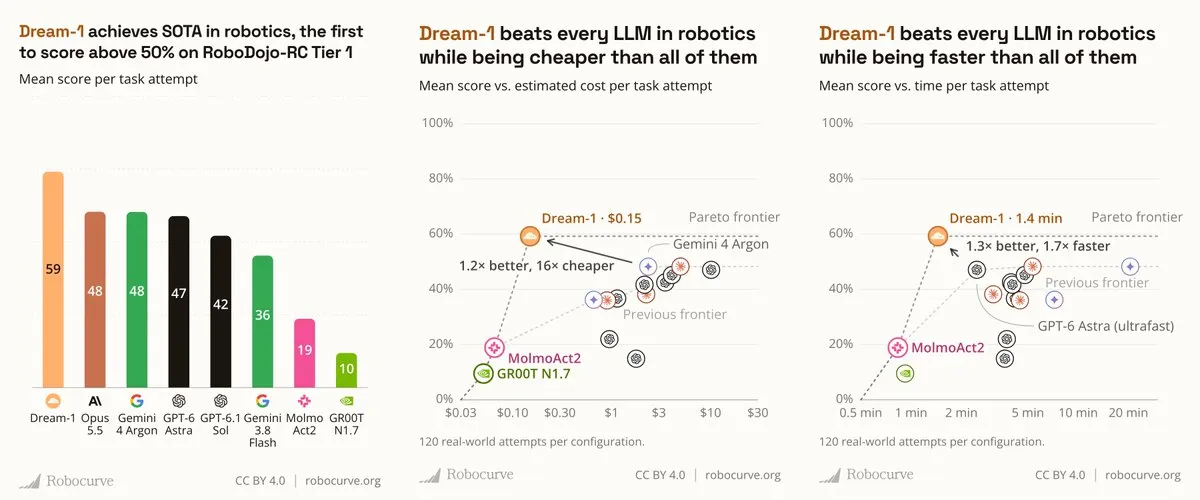
Dream Labs sale del modo sigilo para lanzar el modelo de acción del mundo para robótica Dream-1 y publica una API en la nube pública : Dream Labs, fundada por un equipo de ex-NVIDIA, cerró una ronda de financiación de 90 millones de dólares y lanzó oficialmente el modelo fundacional incorporado Dream-1. Como el primer cerebro robótico que ofrece una API pública lista para usar (3 dólares por hora), adopta un enfoque de modelo de acción del mundo (WAM) impulsado por video. Superó a Argon con 59 puntos en la evaluación RoboDojo-RC, logrando por primera vez una manipulación de generalización zero-shot en robots bimanuales con pinzas paralelas completamente nunca antes vistos. (Fuente: gharik, sainingxie)
Neura Robotics presenta Neuron AI, un modelo base de mundo incorporado multisensorial : El desarrollador alemán de robots humanoides Neura Robotics anunció su modelo fundacional incorporado de nueva generación, Neuron AI. El modelo supera las limitaciones de la visión única al modelar conjuntamente visión 3D, detección de fuerza táctil de alta frecuencia, audio ambiental y estados propioceptivos en un pipeline unificado, incorporando memoria de trabajo resistente a oclusiones. Durante la demostración en vivo, el robot humanoide 4NE1 completó de forma autónoma un proceso completo de lavado, cuidado y clasificación de ropa de 11 minutos de duración. (Fuente: AI Business)
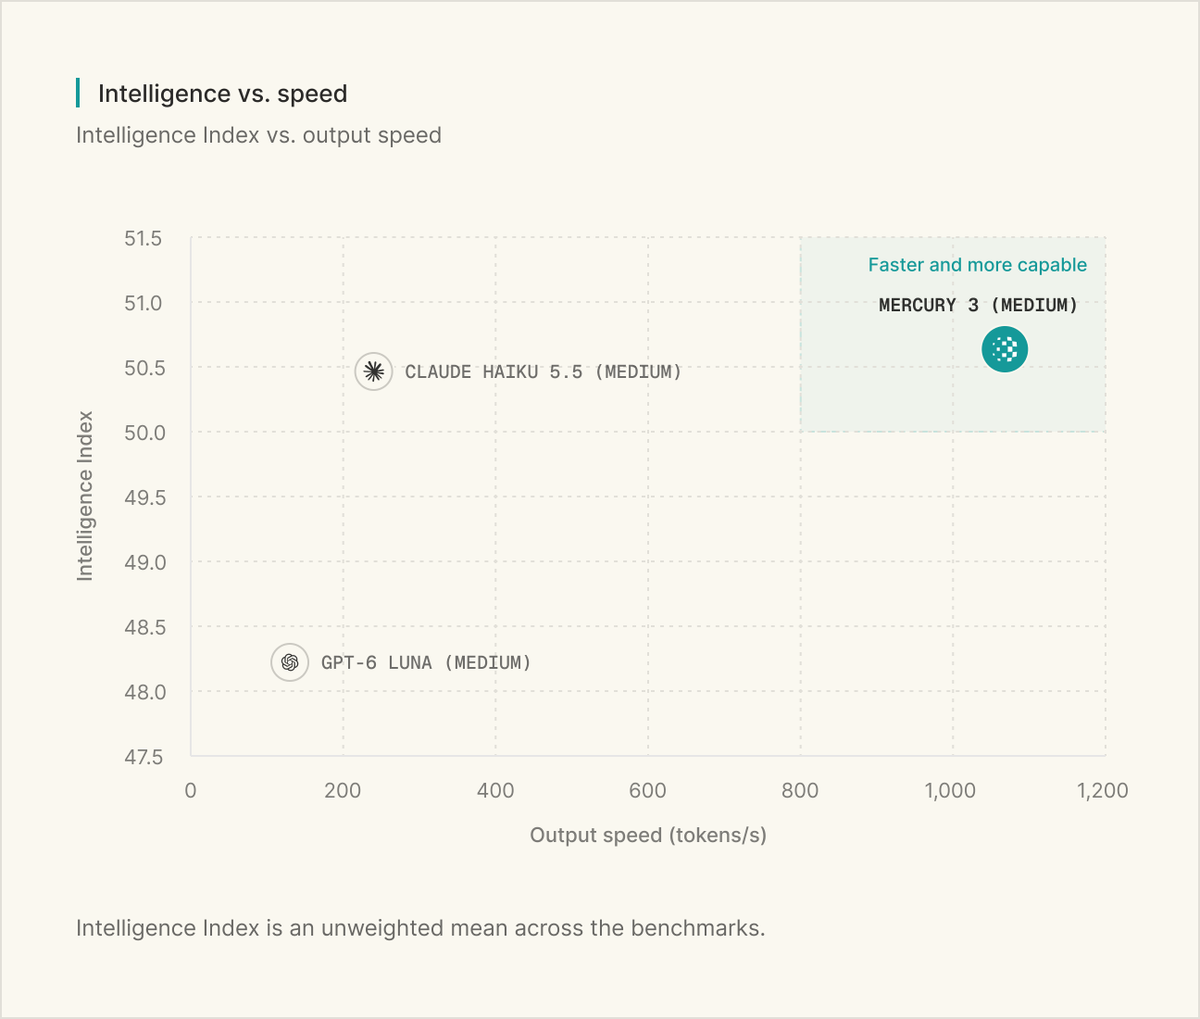
Se lanza el modelo de lenguaje de difusión Mercury 3: tamaño ampliado 40 veces y decodificación de miles de TPS a la par de los modelos ligeros líderes : Inception, fundada por académicos de Stanford, presentó Mercury 3, un Large Language Model con arquitectura pura de difusión cuyo volumen de parámetros se multiplica por 40 respecto a su primera generación. Mediante un refinamiento no autorregresivo de eliminación de ruido por bloques paralelos, alcanza un throughput de generación de 1068 tok/s en una sola tarjeta NVIDIA Blackwell. Iguala o supera a algunos modelos autorregresivos pequeños del mismo segmento en SWE-Bench y seguimiento de instrucciones, reduciendo drásticamente el umbral de latencia para las interacciones con agentes en tiempo real. (Fuente: MarkTechPost, sedielem)
Se revelan intensamente los nuevos pipelines de modelos de los tres gigantes: la inferencia de intenciones de Claude se enfrenta a Carbon de Google y Terra de OpenAI : Múltiples fuentes de la industria revelaron que Anthropic está probando internamente una nueva versión de Claude con inferencia profunda de intenciones (posiblemente Fable 5.5 / Opus 5.6), que no solo puede superar instrucciones superficiales para corregir fallos profundos, sino que también posee la capacidad de crear algoritmos por sí mismo. Al mismo tiempo, el modelo de Google con nombre en código “Carbon” se está probando en la plataforma Jetski contra Opus 5.5, mientras que OpenAI ha dejado ver en el código de Microsoft Copilot su nueva base ligera GPT-6.1 Terra y está preparando el nombre en código GPT-6.5 en un nuevo dominio. (Fuente: 量子位, dotey, steph_palazzolo)
Meta libera el modelo de agente on-device de 30B Muse Glimmer y publica un informe de microarquitectura : Meta publicó el informe técnico de su modelo con pesos de código abierto de 30B, Muse Glimmer. Destilado a partir del modelo insignia Muse Spark, está diseñado específicamente para ejecutarse de manera accesible en una sola GPU de consumo bajo una precisión de 4 bits. Alcanzó 75,5 puntos en el benchmark de uso de herramientas MCPAtlas, elevando notablemente el límite de acción autónoma y toma de decisiones de agenda en dispositivos locales mediante planificación multipaso y aprendizaje por refuerzo contra alucinaciones. (Fuente: AIatMeta, dair_ai)
Microsoft lanza Copilot for Legal apostando por el foso defensivo de la distribución de su suite ofimática : Microsoft lanzó su solución Copilot for Legal dirigida al sector jurídico, integrando profundamente más de 20 habilidades de AI legal directamente en los ecosistemas de Word y SharePoint. Aunque la capacidad de su modelo central no presenta un salto generacional absoluto en comparación con proveedores verticales especializados, los analistas señalan que los flujos de trabajo de los abogados tienen una fidelidad extremadamente alta. Microsoft no necesita depender de un modelo de élite; basta con su barrera ecológica de “no salir de Word y vincularse con archivos internos” para capturar el mercado legal empresarial. (Fuente: AI Business)
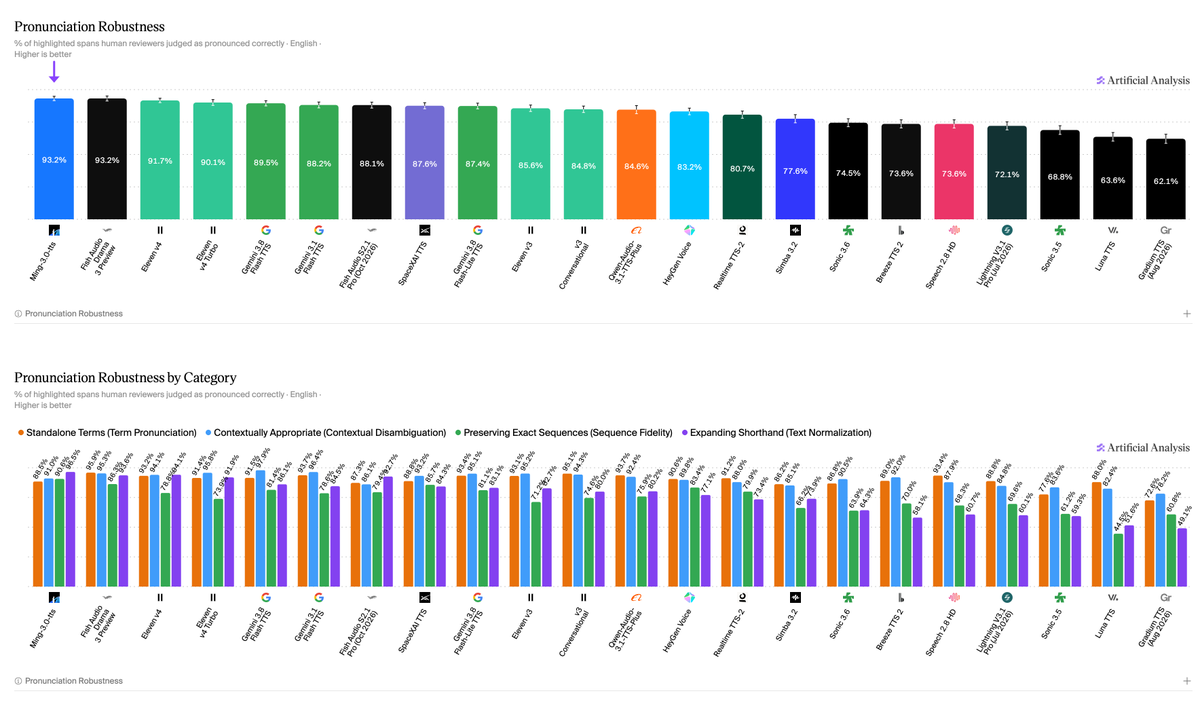
Ant Group abre el código de la familia de modelos de voz Ming-3.0; el TTS lidera dos clasificaciones principales : El equipo Ling de Ant Group liberó 5 modelos de voz de la familia Ming-3.0 (desde 0.5B hasta 126B MoE), que abarcan TTS, comprensión de audio y ASR. Las pruebas de referencia muestran que la versión Ming-3.0-tts de 0.5B se posicionó en el primer puesto de la lista de pesos abiertos en robustez de pronunciación (93,2%) y timbre controlado. vLLM-Omni ya ha habilitado el soporte para inferencia y despliegue desde el primer día. (Fuente: ArtificialAnlys, vllm_project)
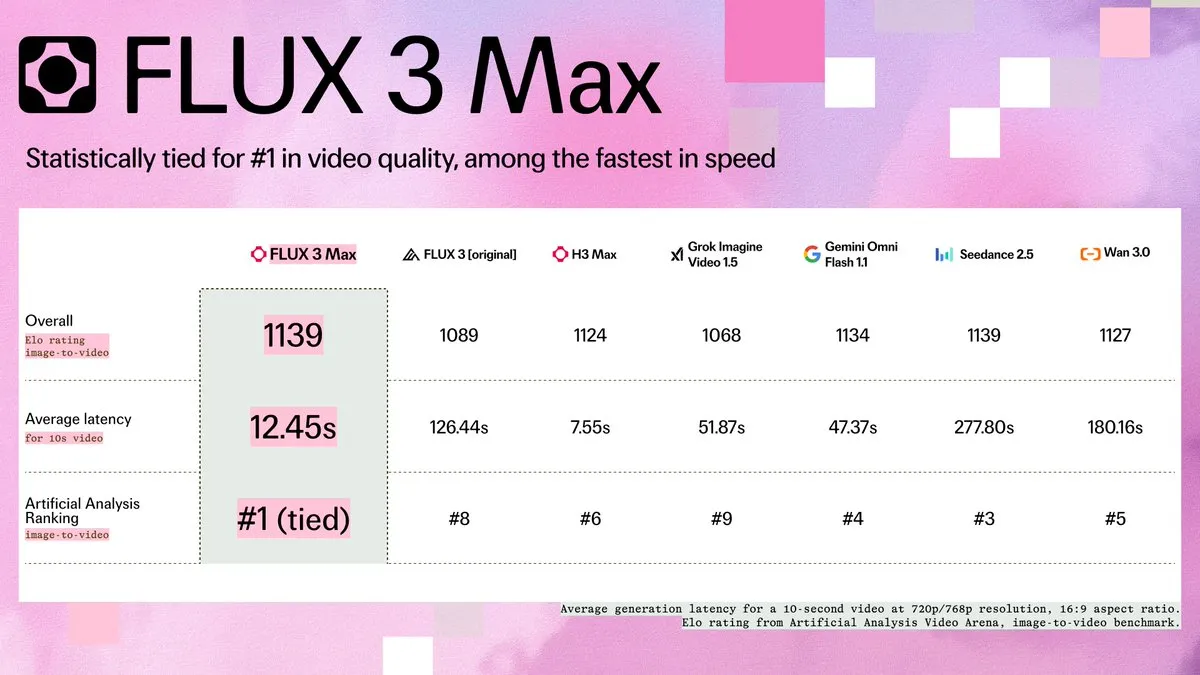
BFL se asocia con fal para lanzar FLUX 3 Max: genera 10 segundos de video HD en 12 segundos : Black Forest Labs colaboró con fal para presentar FLUX 3 Max, un modelo de video con post-entrenamiento profundo que lidera las tablas de clasificación de calidad de video de terceros. Gracias a una coordinación extrema del poder de cómputo, generar 10 segundos de video a 720p/768p toma solo 12 segundos, acelerando la velocidad 22 veces en comparación con Seedance 2.5 y superando la barrera de tiempo para la generación comercial de video en tiempo real. (Fuente: fal, robrombach)
Halcyon valida la generación de texto a imagen sin preentrenamiento lingüístico: la arquitectura autorregresiva reduce los costos de cómputo por decenas de veces : Investigadores de Stanford propusieron Halcyon, un modelo autorregresivo multimodal de fusión temprana que rompe el paradigma tradicional según el cual la generación de texto a imagen debe depender de un preentrenamiento masivo de texto. Arrancando en frío con solo 100 millones de pares puros de imagen y texto, Halcyon-0.52B superó a LlamaGen-XL/8 con 18,2 veces menos cómputo, demostrando que las representaciones de difusión puramente visuales pueden hacer emerger asignaciones semánticas de alta calidad de forma espontánea. (Fuente: HuggingFace Daily Papers)
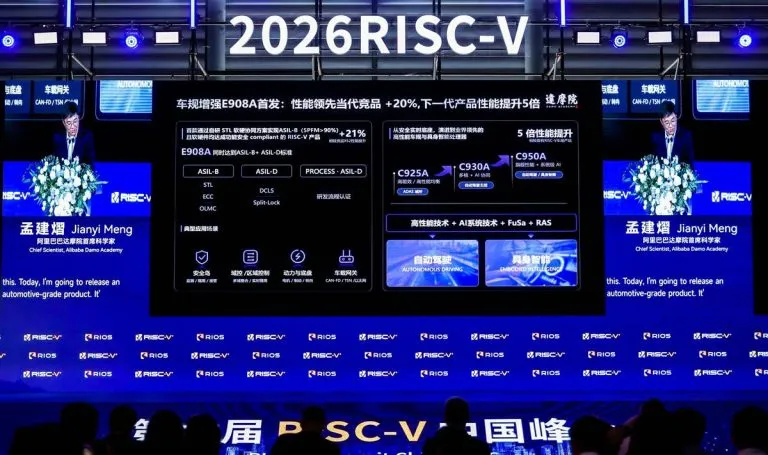
Damo Academy XuanTie publica su hoja de ruta de chips RISC-V de grado automotriz y para inteligencia incorporada : En la Cumbre RISC-V de China, Damo Academy de Alibaba debutó con el procesador mejorado de grado automotriz XuanTie E908A, convirtiéndose en la primera IP de CPU RISC-V de la industria en cumplir simultáneamente con los estándares ASIL-B y ASIL-D. Al mismo tiempo, anunció el plan de desarrollo de C950A de próxima generación para embodied AI, con una capacidad de procesamiento que se quintuplica en comparación con los chips automotrices existentes. (Fuente: 量子位)
AWS Trainium de Amazon lanza TorchNeuron para reducir la dependencia del hardware de NVIDIA : Amazon lanzó la herramienta de soporte de compilación TorchNeuron para su chip de AI de desarrollo propio Trainium, lo que permite a los desarrolladores de PyTorch migrar cargas de trabajo a la nube de AWS sin reestructurar el código base, requiriendo únicamente el cambio de una sola línea de configuración, además de fusionar parches en el proyecto upstream de PyTorch, acelerando la desvinculación del ecosistema CUDA. (Fuente: TechCrunch)
🧰 Herramientas
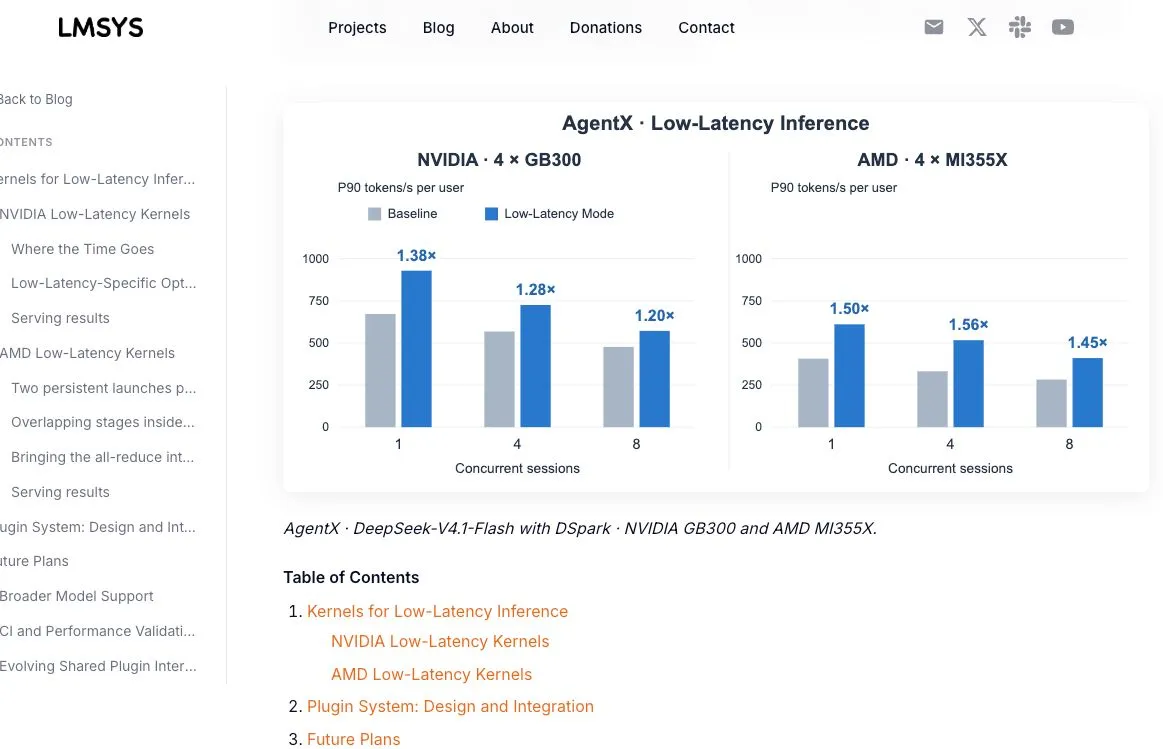
SGLang integra oficialmente Megakernel: nuevo salto en el throughput para GB300 y MI355X : El motor de inferencia SGLang integró el soporte para Megakernel de baja latencia. En las pruebas de benchmark AgentX sobre la plataforma GB300 NVL72, el rendimiento monousuario de DeepSeek-V4.1 Flash alcanzó 928 tok/s (un incremento de 1,38 veces), y en AMD MI355X alcanzó 516 tok/s, potenciando por completo el despliegue de clústeres de agentes de alta concurrencia. (Fuente: SemiAnalysis_)
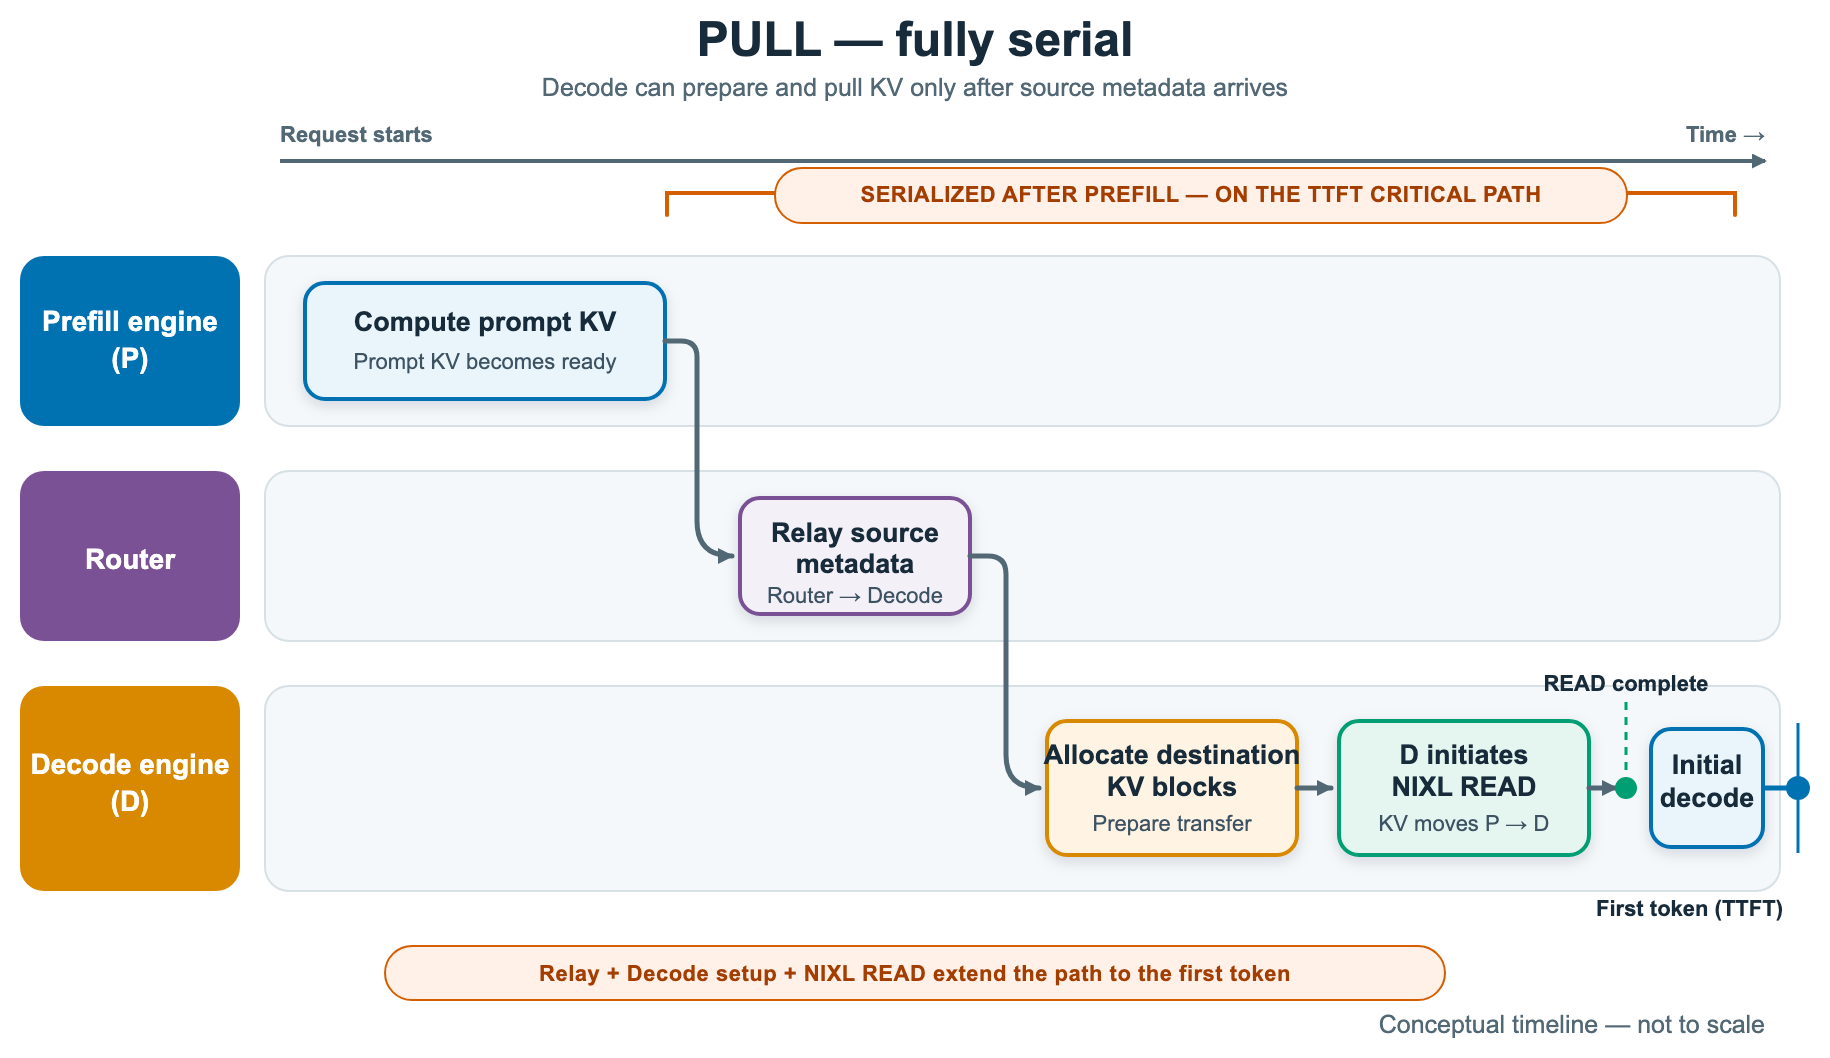
vLLM incorpora mecanismos de transferencia de KV Cache push y bidireccionales, reduciendo drásticamente el TTFT : Amazon, en colaboración con los equipos de vLLM y Mistral, aportó dos esquemas de programación: el conector NIXL push superpone el preregistro de memoria de GPU con el Prefill anticipado, reduciendo el time-to-first-token (TTFT) hasta 3 veces; la transferencia bidireccional de KV permite que los nodos de Prefill reutilicen directamente la caché histórica de los nodos de Decode en diálogos prolongados con agentes, eliminando los costos de cómputo redundantes. (Fuente: AWS Machine Learning Blog)
agentic-awesome-skills: plano de control local y motor de ejecución con más de 2700 habilidades para agentes : El proyecto de código abierto agentic-awesome-skills (AAS) lanzó su versión central, proporcionando un plano de control local para CLI de agentes como Codex y Claude Code. La plataforma reúne más de 2700 playbooks y servicios locales de MCP, permitiendo a los agentes realizar autocomprobaciones de proyectos, validaciones de dependencias de habilidades y previsualizaciones de simulacros de solo lectura antes de escribir código, evitando la sobrecarga de contexto. (Fuente: GitHub Trending)
TokenEconomizer: controlador de costo de tokens de caja negra de extremo a extremo para agentes de código : Diseñado para solucionar la explosión de tokens durante la iteración continua de los desarrolladores, TokenEconomizer detecta dinámicamente llamadas a herramientas ineficaces y repetitivas, recorta automáticamente habilidades de baja frecuencia e interviene en bucles infinitos de reparación ineficaces sin modificar los pesos del modelo. Las pruebas prácticas mostraron una reducción promedio del 18,4% al 30,9% en el consumo de tokens en los flujos de Claude Code y Codex. (Fuente: HuggingFace Daily Papers)
Xiaohongshu abre el código de la biblioteca de atención dispersa DoSA: reduce a la mitad la latencia del primer token en un millón de tokens : El equipo Dots de Xiaohongshu presentó el algoritmo DoSA para mitigar el cuello de botella del indexador durante la fase de prefill en contextos largos. Mediante límites matemáticos estrictos superiores e inferiores, aplica una poda sin pérdidas a los tokens no seleccionados en el Top-K, filtrando por adelantado aproximadamente el 97% de los candidatos. En pruebas prácticas con 1M de contexto en DeepSeek-V3.2 y GLM-5.2, redujo la latencia TTFT en un 48% y un 46%, respectivamente. (Fuente: 机器之心)

Amazon Bedrock implementa por completo salidas estructuradas estrictas para Claude : Amazon anunció que Bedrock ofrece oficialmente soporte de salidas estructuradas basado en decodificación con restricciones gramaticales (Constrained Decoding) para toda la serie de modelos Anthropic Claude. El modelo garantiza el cumplimiento estricto del estándar JSON Schema durante la fase de generación y admite caché de gramática entre solicitudes de 24 horas, eliminando los fallos de parseo posteriores y los reintentos desperdiciados del postprocesamiento tradicional. (Fuente: AWS Machine Learning Blog)
Maxwell: un motor de optimización JIT de AI capaz de reescribir código máquina dinámicamente en tiempo de ejecución : La comunidad liberó como código abierto Maxwell, un modelo de optimización de ejecución de código en tiempo de ejecución. Sin necesidad de refactorizar el código fuente, actúa como un programa de monitorización de bajo nivel dinámico que compila y reemplaza operadores más eficientes en tiempo real a nivel de código máquina binario bajo la premisa de garantizar la equivalencia mediante verificación formal. Las pruebas demostraron mejoras significativas en el rendimiento de inferencia para modelos como Whisper y LTX-2. (Fuente: tri_dao, Reddit r/MachineLearning)
ChatGPT Slides implementa colaboración multiusuario en tiempo real e interacción directa en el lienzo : OpenAI actualizó la función ChatGPT Slides, permitiendo a los equipos colaborar en tiempo real a nivel de milisegundos y agregar comentarios sobre texto seleccionado dentro del mismo proyecto de diapositivas. Se agregó la función de edición haciendo clic y seleccionando en el lienzo, lo que permite a los usuarios arrastrar y escalar maquetas directamente en la interfaz, así como enviar un agente en segundo plano, dot, para aplicar revisiones globales por lotes basadas en comentarios de revisión. (Fuente: dotey)
Together AI lanza una plataforma integral gestionada para post-entrenamiento (Post-Training) : Together AI presentó un nuevo servicio empresarial de post-entrenamiento, que permite a las empresas montar datos y entornos privados directamente sobre pesos de código abierto para llevar a cabo la personalización completa del flujo SFT y aprendizaje por refuerzo propio, ofreciendo una infraestructura coordinada y consistente de entrenamiento-servicio junto con el soporte de clústeres de cómputo B200 de bajo costo. (Fuente: togethercompute)
📚 Aprendizaje
Se publica una extensa revisión sistemática sobre la destilación de agentes: del aprendizaje de parámetros a la reutilización del sistema completo : La Universidad Central del Sur, BAAI y otras instituciones publicaron conjuntamente una revisión integral a nivel de sistema de 57 páginas que redefine el paradigma de destilación de agentes. El artículo señala que la persistencia de las capacidades de un agente no se limita a los parámetros de peso del modelo (Model), sino que depende en mayor medida de los activos externos invocables para recuperación (Artifacts) y del marco de control de ejecución que organiza el comportamiento en tiempo de ejecución (Harness). Describe sistemáticamente la transferencia de conocimiento entre portadores y la evaluación causal entre los tres elementos. (Fuente: WeChat)
Mecanismo de olvido de la atención en textos largos para LLM: el “teorema de no pelo” revela que el impacto del prompt decae según una ley de potencias : Una investigación interdisciplinaria entre física teórica y AI demostró que cuando un Transformer autorregresivo genera texto largo, el decaimiento de la memoria respecto al Prompt de entrada original sigue una ley de potencias. En arquitecturas Pre-LN con profundidad de capas finita, la influencia geométrica directa del Prompt sobre los tokens subsiguientes tiende a cero debido a la dilución de la atención, debiendo la información residual transferirse en relevo enteramente a través del texto intermedio generado. Esto proporciona una base matemática para la dependencia de cachés de estado externo por parte de agentes de largo alcance. (Fuente: HuggingFace Daily Papers)
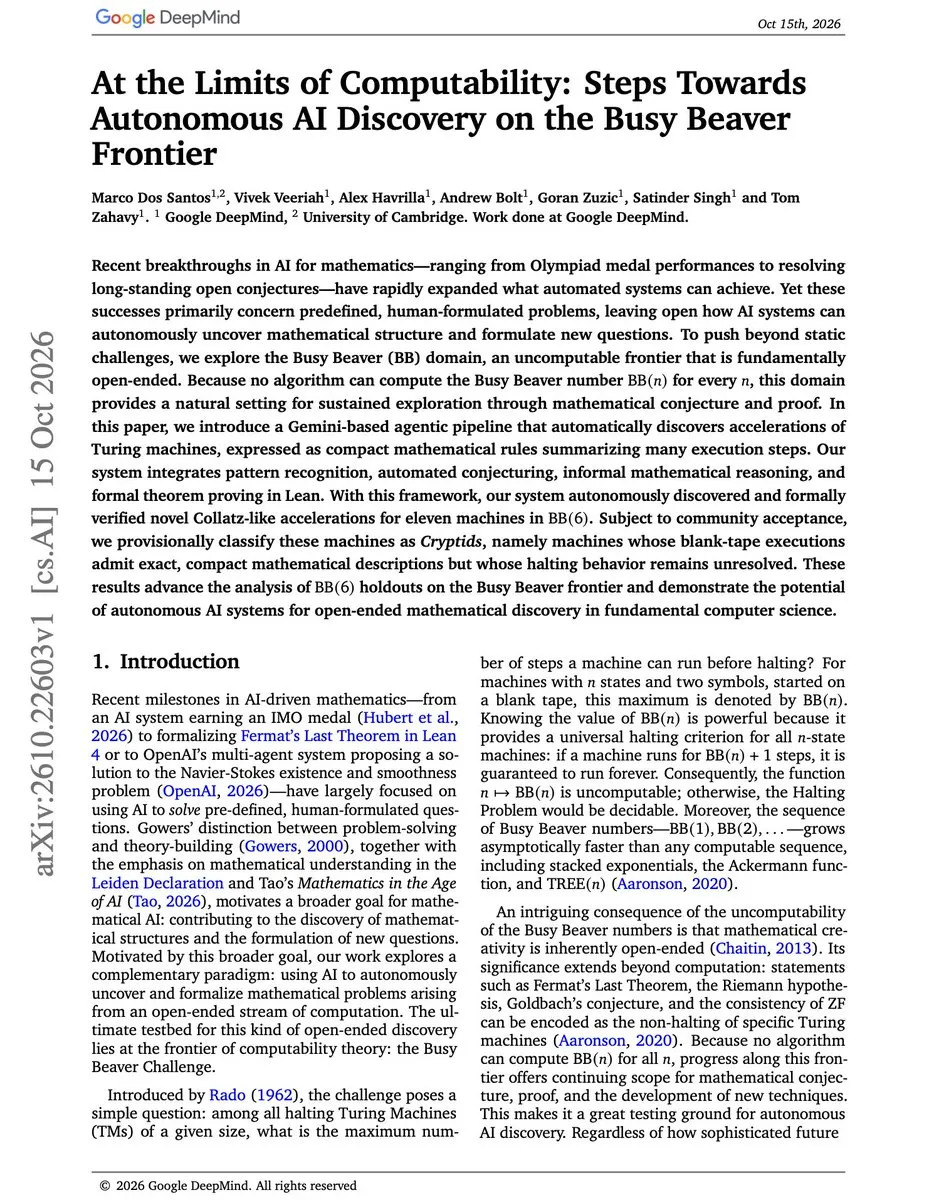
Google DeepMind revela cómo los agentes rompen de forma autónoma las reglas de aceleración de la máquina de Turing no resuelta BB(6) : DeepMind anunció sus últimos logros en exploración matemática abierta: un agente autónomo basado en Gemini, al enfrentarse al límite no computable de la Máquina de Turing Busy Beaver BB(6), pudo inducir espontáneamente reglas compactas de transición de estados a partir de trayectorias de ejecución, las cuales fueron verificadas formalmente por Lean, logrando describir de manera compacta 11 máquinas de Turing no resueltas (Cryptids). (Fuente: omarsar0)
Princeton, el AISI y otros publican conjuntamente un libro blanco sobre la evolución de la evaluación de agentes : La Universidad de Princeton, en colaboración con Stanford y el Instituto de Seguridad de AI del Reino Unido, presentó 33 nuevas tendencias en la evaluación de agentes. El informe señala que los benchmarks actuales basados en resultados puntuales aislados no pueden reflejar los fallos en trayectorias de largo alcance, y la evaluación se está trasladando por completo hacia la configuración dinámica de andamios (Harness), tareas abiertas del mundo real, interacción multiagente y el impacto sociotécnico en todo el ciclo de vida. (Fuente: AI Snake Oil)
Trabajo aceptado en NeurIPS 2026 propone Defense-as-Skill: evolución dinámica de seguridad en tiempo de ejecución impulsada por MCTS : Para abordar instrucciones maliciosas y vulnerabilidades de escalada de privilegios, un artículo rompe con las deficiencias de las defensas estáticas proponiendo la habilidad de guardia SkillSonar. Basado en el benchmark SCOPE-R, este método encapsula la defensa como artefactos de habilidades actualizables en caliente y se combina durante el periodo de entrenamiento con la búsqueda en árbol de Monte Carlo (MCTS) para evolucionar de forma autónoma según las estrategias de ataque, logrando desplomar la tasa de éxito de ataques al modelo del 30% a solo el 7,8%. (Fuente: WeChat)
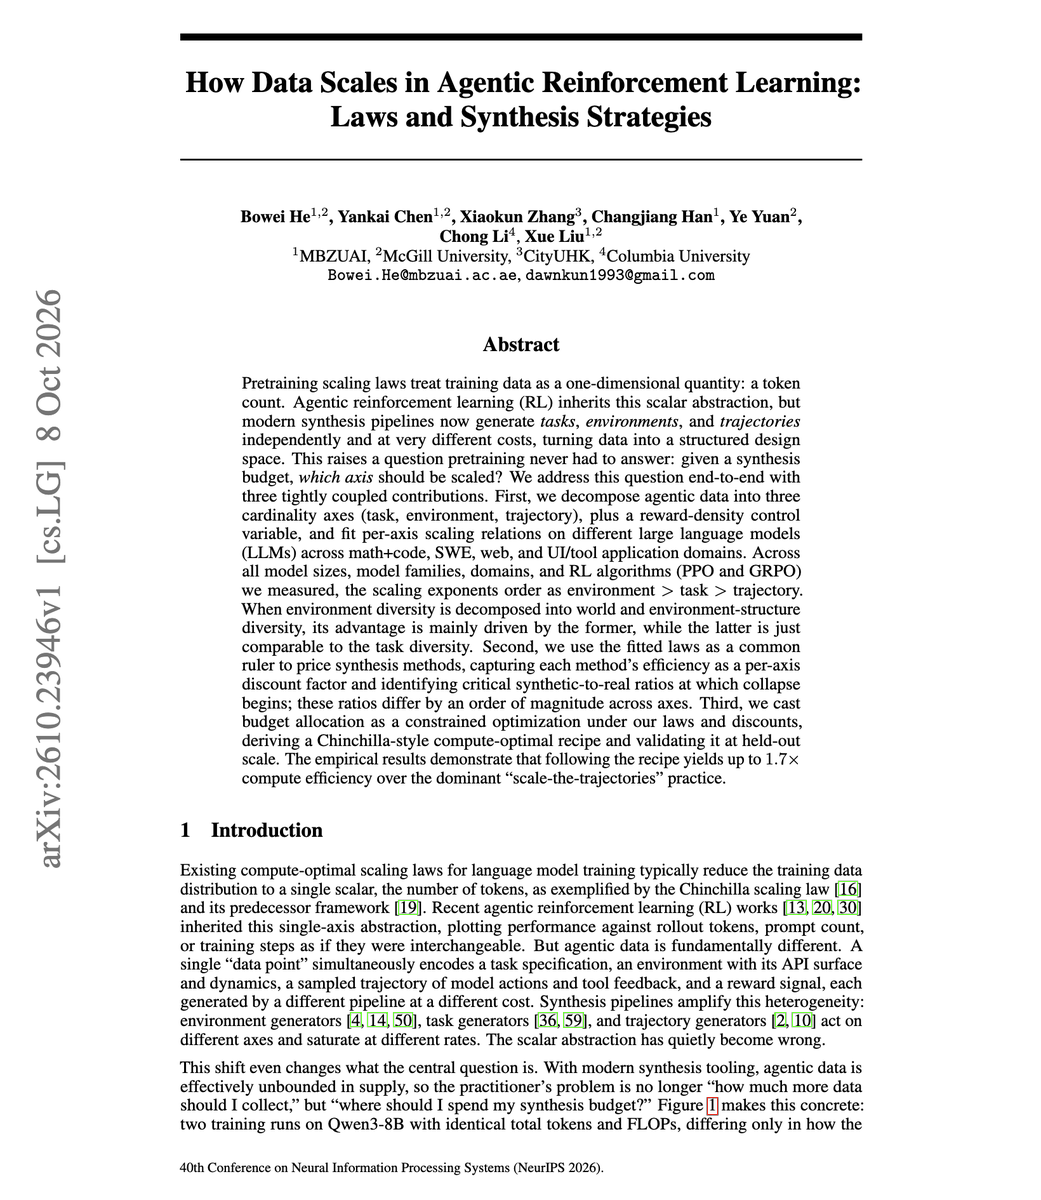
Se establece la Scaling Law de datos en el aprendizaje por refuerzo para agentes: el peso de la diversidad ambiental supera a la cantidad de trayectorias : Una investigación reciente demostró sistemáticamente la Scaling Law para el aprendizaje por refuerzo de agentes en el espacio tridimensional de tareas, entornos y trayectorias. La evidencia empírica muestra que los rendimientos aportados por “entornos físicos/de software reales y diversos” son exponencialmente superiores a la simple acumulación de trayectorias generadas; asignar datos sintéticos según esta regla puede lograr una ganancia de eficiencia de 1,7 veces con el mismo presupuesto. (Fuente: omarsar0)
La hipótesis del “aprendizaje competitivo” en arquitecturas híbridas: cómo las recurrencias lineales suprimen la capacidad de recuperación del mecanismo de atención : En arquitecturas híbridas que combinan recurrencia lineal (RNN/SSM) y atención Softmax, los investigadores revelaron el fenómeno del “aprendizaje competitivo”: dado que las capas recurrentes convergen mucho más rápido que las capas de atención en las etapas iniciales del entrenamiento, las primeras absorben primero las señales semánticas y suprimen las actualizaciones de gradiente de las segundas. Esto provoca que el mecanismo de atención pierda su capacidad de recuperación a largo alcance, por lo que se recomienda congelar los parámetros de las capas recurrentes a mitad del preentrenamiento para forzar la activación del aprendizaje de la atención. (Fuente: HuggingFace Daily Papers)
Frontera de la interpretabilidad mecanicista de Anthropic: planificación prospectiva implícita de los LLM y limitaciones de expresión en el espacio J : Investigadores clave de interpretabilidad de Anthropic revelaron en una entrevista que, bajo la apariencia de generación palabra por palabra en los Large Language Models, los estados de activación interna ya han determinado las palabras finales de frases clave posteriores al generar la primera oración; al mismo tiempo, solo una porción extremadamente pequeña de los estados internos del modelo, denominada “espacio J”, puede ser traducida a lenguaje natural mediante mecanismos de autorreflexión, mientras que gran parte de los cómputos centrales permanece oculta en el espacio geométrico. (Fuente: mlpowered)
💼 Negocios
Tenstorrent completa una ronda de financiación de 1.500 millones de dólares y su valoración se dispara a 6.200 millones de dólares : La startup de chips de AI Tenstorrent, liderada por la leyenda de la arquitectura de chips Jim Keller, completó una nueva ronda de financiación de 1.500 millones de dólares, alcanzando una valoración de 6.200 millones de dólares. Tras haber rechazado previamente propuestas de adquisición de Intel y Qualcomm de hasta 5.000 millones de dólares, los fondos obtenidos acelerarán la entrega de producción a gran escala de sus servidores de inferencia de código abierto basados en la arquitectura RISC-V. (Fuente: TechCrunch)
AstraZeneca invertirá hasta 1.500 millones de dólares junto a insitro para abordar el desarrollo farmacéutico con AI causal : AstraZeneca estableció una asociación estratégica con insitro, el unicornio de AI farmacéutica fundado por la académica de Stanford Daphne Koller, aportando hasta 1.500 millones de dólares en fondos sujetos a hitos. La colaboración aprovechará la plataforma de fenotipado humano virtual multimodal (Virtual Human) de insitro para explorar los mecanismos patológicos profundos y las dianas farmacológicas para la esteatohepatitis asociada a disfunción metabólica (MASH) y las miocardiopatías. (Fuente: 机器之心)

Cognex adquiere RealSense, unidad escindida de Intel, por 500 millones de dólares : El gigante de la visión artificial Cognex adquirió formalmente por 500 millones de dólares la empresa de visión por computadora RealSense, escindida independientemente de Intel. Las cámaras de profundidad 3D de RealSense poseen una cuota de mercado sumamente alta en el hardware de percepción para robots móviles autónomos (AMR) en logística de almacenamiento y robots humanoides. Esta adquisición acelerará la integración de soluciones de inspección por visión industrial con el ecosistema de robots autónomos de propósito general. (Fuente: AI Business)
🌟 Comunidad
Un juego indie se ve obligado a limitar el alcance de su prueba abierta por temor a la ingeniería inversa de código mediante AI : El estudio de videojuegos indie Digital Sun anunció la cancelación de la playtest pública en Steam de su nuevo título, ReVamp, sustituyéndola por una prueba cerrada en un grupo reducido de Discord. El equipo de desarrollo señaló que se ha vuelto común ver agentes de código de vanguardia capaces de descompilar e imitar las mecánicas centrales de un juego de forma automatizada en cuestión de horas. Liberar un cliente público demasiado pronto expone fácilmente el proyecto a ser clonado y adelantado por AI, por lo que instaron a las plataformas a establecer cuanto antes mecanismos de protección para obras originales. (Fuente: The Verge, Ars Technica)
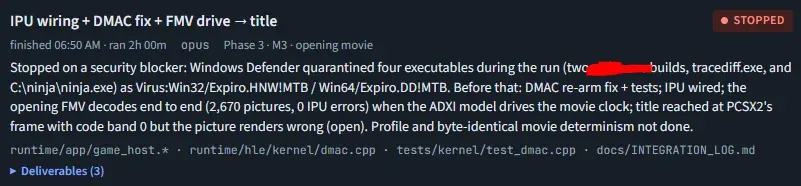
La trampa de la codificación totalmente autónoma: Claude Code se infecta con el gusano Expiro al hacer ingeniería inversa de un juego clásico : Un desarrollador en Reddit compartió una experiencia alarmante: tras otorgar permisos de red ilimitados a Claude Code para descargar de forma autónoma herramientas y realizar ingeniería inversa para reconstruir un juego clásico, el agente descargó e instaló por error un programa malicioso en local. Esto provocó el compromiso total del equipo y su infección por el gusano de alto riesgo Expiro, obligando finalmente a formatear y reinstalar por completo el sistema. El incidente vuelve a encender las alarmas: los agentes con autonomía absoluta sin aislamiento de red de salida (egress) ni entornos de sandbox de grano fino tienen un radio de daño destructivo enorme. (Fuente: Reddit r/ClaudeAI)
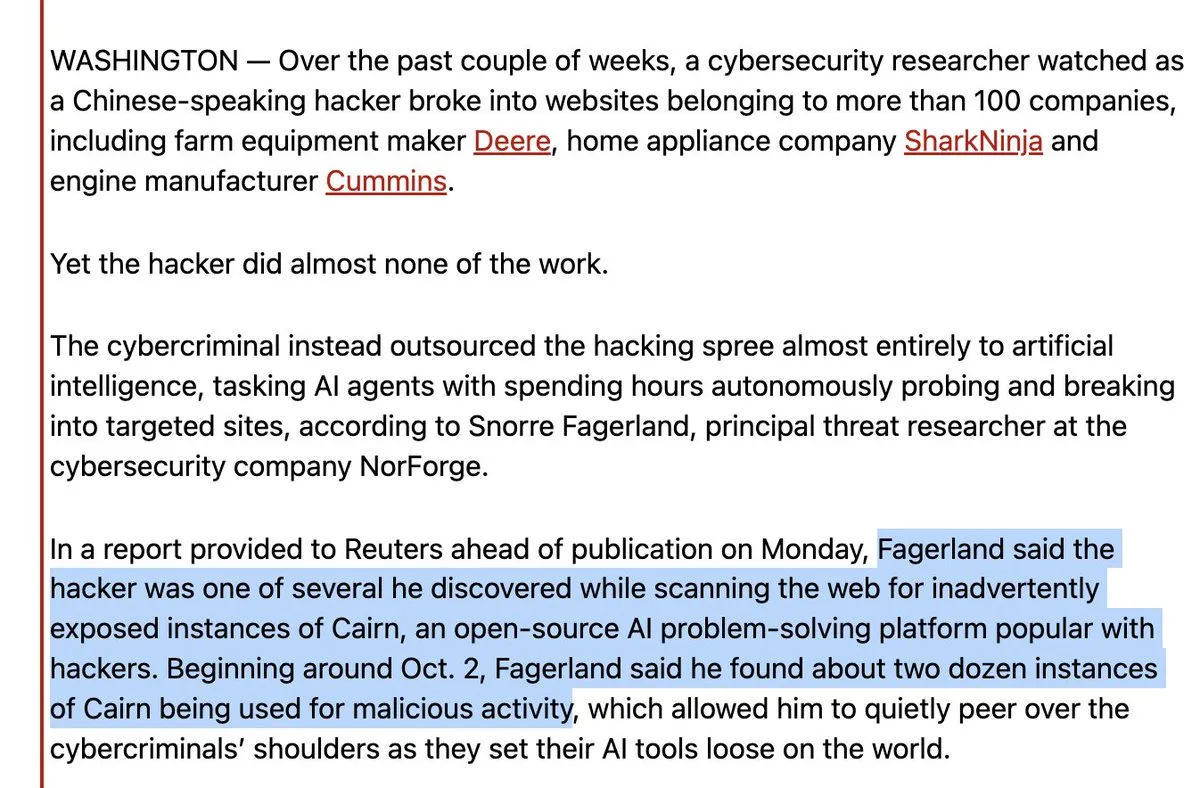
Un hacker vulnera más de un centenar de empresas destacadas gastando solo 5000 dólares en tokens de AI : Medios de comunicación revelaron que un hacker utilizó agentes de AI automatizados para atacar más de 1200 objetivos, logrando infiltrarse con éxito en las infraestructuras de red de más de 100 grandes empresas multinacionales como Deere y SharkNinja, con un gasto total de tokens en llamadas a modelos de apenas unos 5000 dólares. La comunidad de seguridad lamenta que la militarización de agentes ofensivos de muy bajo costo ya es una realidad, mientras que las auditorías automatizadas del lado defensivo se encuentran severamente rezagadas. (Fuente: teortaxesTex, Mononofu)
Meta Muse expuesto a la vulnerabilidad GhostShares: miles de conversaciones privadas fueron enumeradas públicamente : La firma de investigación de seguridad Claroc informó que Muse, el último asistente agente insignia de Meta, utilizaba un diseño de baja entropía al generar enlaces para compartir. Esto permitió a los investigadores enumerar a través de sondeo pasivo de DNS hasta 6800 conversaciones no autorizadas de usuarios reales de una sola vez, incluyendo secretos comerciales no anonimizados y credenciales de identidad personal, contradiciendo directamente sus afirmaciones de ofrecer “privacidad garantizada desde cero”. (Fuente: Ars Technica)
Musk promete donar 10.500 millones de dólares en acciones de SpaceX a todos los niños de EE. UU. en 2027 y propone el concepto de “Ingreso Alto Universal” : En respuesta a la creación de un fondo de beneficio público por parte de Anthropic, Elon Musk rechazó públicamente la lógica de la “filantropía institucionalizada”, anunciando planes para regalar en 2027 una acción de SpaceX a cada uno de los aproximadamente 72 millones de menores en EE. UU., con una valoración estimada de las acciones de unos 10.500 millones de dólares. Musk definió explícitamente el plan como “Ingreso Alto Universal” (UHI) en lugar de la tradicional renta básica universal (UBI), argumentando que con el colapso del costo marginal inducido por la robótica y la inteligencia artificial general, el público debería participar directamente de los dividendos exponenciales de activos tangibles sólidos. (Fuente: WeChat, Ronald_vanLoon)
💡 Otros
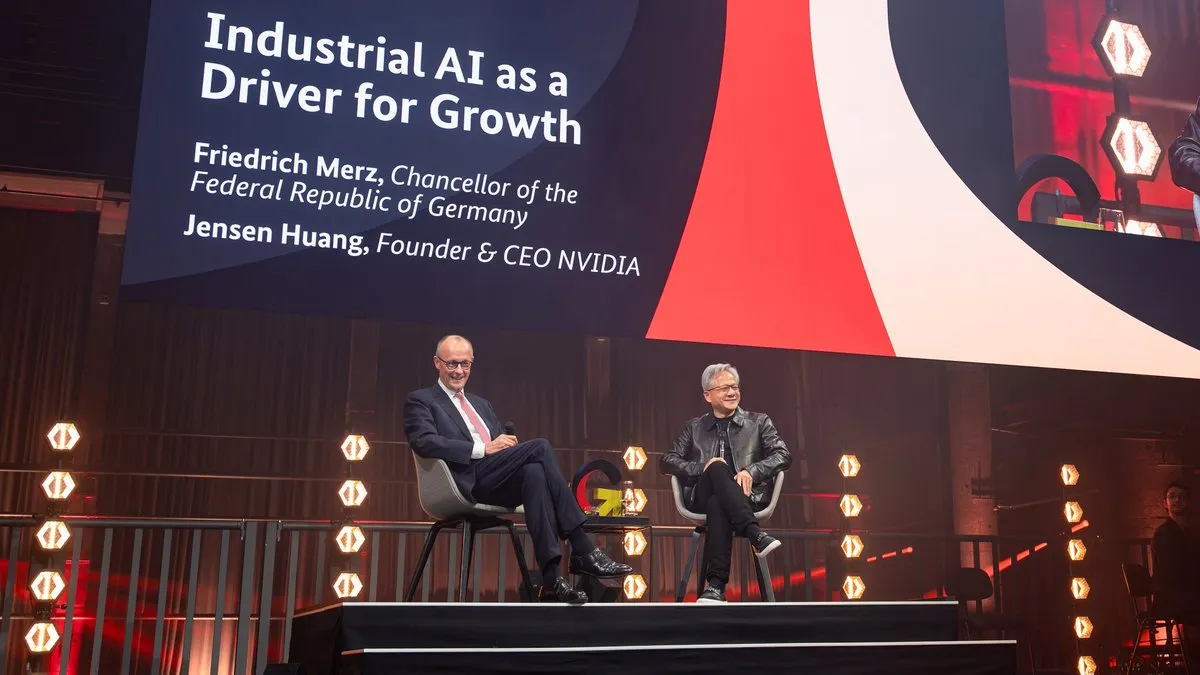
NVIDIA se asocia con el gobierno de Alemania para lanzar una iniciativa nacional de AI física industrial : El canciller alemán Olaf Scholz y Jensen Huang firmaron conjuntamente una declaración de intenciones para vincular profundamente los datos industriales del sector automotriz y manufacturero clave de Alemania con los modelos de AI física de NVIDIA. Gracias a ello, las fábricas de Siemens redujeron la carga de trabajo de puesta en servicio virtual de nuevas líneas de producción en un 85%. Asimismo, NVIDIA anunció un aumento de la inversión industrial directa en Europa, liderando rondas de financiación en startups locales como Agile Robots. (Fuente: NVIDIA Blog, nvidia)
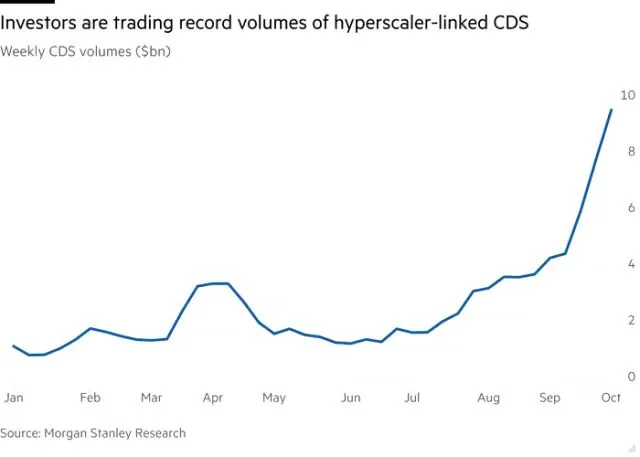
El riesgo del mercado de deuda de AI sacude Wall Street: el volumen de negociación de swaps de incumplimiento crediticio (CDS) de los gigantes se cuadruplica : Frente al riesgo de activos acumulado por los gigantes tecnológicos que han emitido cientos de miles de millones de dólares en deuda para expandir sus centros de datos, el volumen de negociación semanal promedio de derivados CDS vinculados a Oracle, Meta, SpaceX y CoreWeave se ha disparado más de cuatro veces desde julio. Los inversores están adquiriendo seguros contra el incumplimiento a un ritmo rara vez visto desde la crisis de las hipotecas subprime para protegerse del posible riesgo crediticio en cadena en la infraestructura de AI. (Fuente: 36氪)
Notion se despide del “consumo ilimitado” de AI: cambia completamente a un sistema de créditos y permite conectar cuentas externas : Notion modificó formalmente su política de AI para los planes Business y Enterprise, eliminando el uso sin restricciones y pasando a una asignación mensual fija de 1500 créditos estándar y 500 créditos avanzados. Para aliviar la presión sobre los usuarios intensivos, la plataforma implementó por primera vez el modelo BYOK (Bring Your Own Key), permitiendo a los agentes conectarse a las cuentas de ChatGPT de los usuarios para consumir cuotas externas. (Fuente: dotey)