



🔥 Fokus
US-Heimatschutzministerium ordnet vollständige Entfernung von DeepSeek und abgeleiteten Diensten in Bundesbehörden an : Das US-Heimatschutzministerium (DHS) hat eine offizielle Verwaltungsanordnung erlassen, die zivile Bundesbehörden anweist, sämtliche vom chinesischen AI-Labor DeepSeek entwickelten Technologiekomponenten innerhalb einer festgelegten Frist einzustellen und vollständig zu deinstallieren. Das Verbot basiert auf Prüfungen bezüglich Datensouveränität und Supply-Chain-Sicherheit. Es untersagt zivilen Behörden ausdrücklich den direkten Einsatz von Open-Source- oder proprietären Modellen und stoppt zugleich sämtliche kommerziellen Drittanbieter-API-Dienste sowie Toolchains, die DeepSeek-Modelle integrieren. Das chinesische Außenministerium reagierte darauf und erklärte, man lehne die Verallgemeinerung des Begriffs der nationalen Sicherheit entschieden ab. Dieser Schritt markiert eine formelle Ausweitung der US-Überprüfung von Open-Source-AI-Lieferketten vom Militär- und Verteidigungssektor auf allgemeine Verwaltungsbehörden. (Quelle: The Verge, The Guardian, THE DECODER)

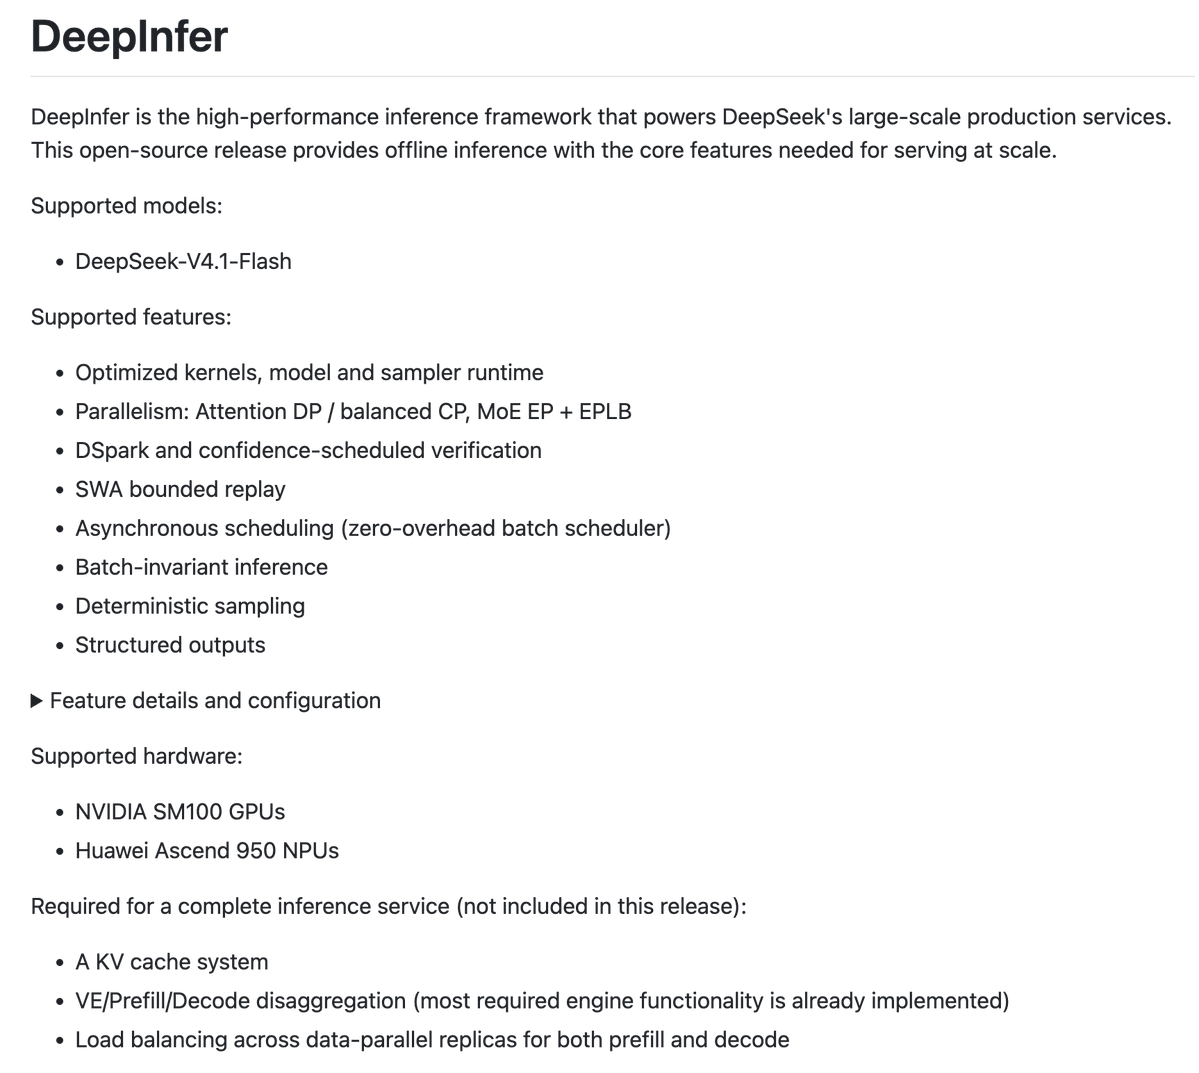
DeepSeek stellt produktionsreife Inferenz-Engine DeepInfer vollständig als Open Source bereit und enthüllt Systemarchitektur : Im Anschluss an V4.1 Flash hat DeepSeek DeepInfer, sein zentrales Inferenz-Framework für Produktionsumgebungen mit hunderten Milliarden Parametern, zusammen mit der begleitenden Komponente deepseek-recipe offiziell unter der Apache 2.0-Lizenz auf GitHub als Open Source veröffentlicht. Die Architektur unterstützt Hardware von NVIDIA Blackwell sowie Huawei Ascend. Sie führt erstmals ein entkoppeltes Deployment von Prefill und Decode, eine auf 3FS basierende tagübergreifende persistente KV-Cache-Wiederverwendung, ein SWA 128-Token Bounded Replay sowie DSpark Confidence Speculative Decoding ein. Bei einer First-Token-Latenz (TTFT) von bis zu 400 ms und einer Hochgeschwindigkeitsgenerierung von 230–300 TPS gelang es, den täglichen Durchsatz eines einzelnen Clusters auf 155 Billionen Token zu steigern, was in der Open-Source-Community für großes Aufsehen sorgte. (Quelle: deepseek_ai, 机器之心, 36氪, Reddit r/LocalLLaMA)
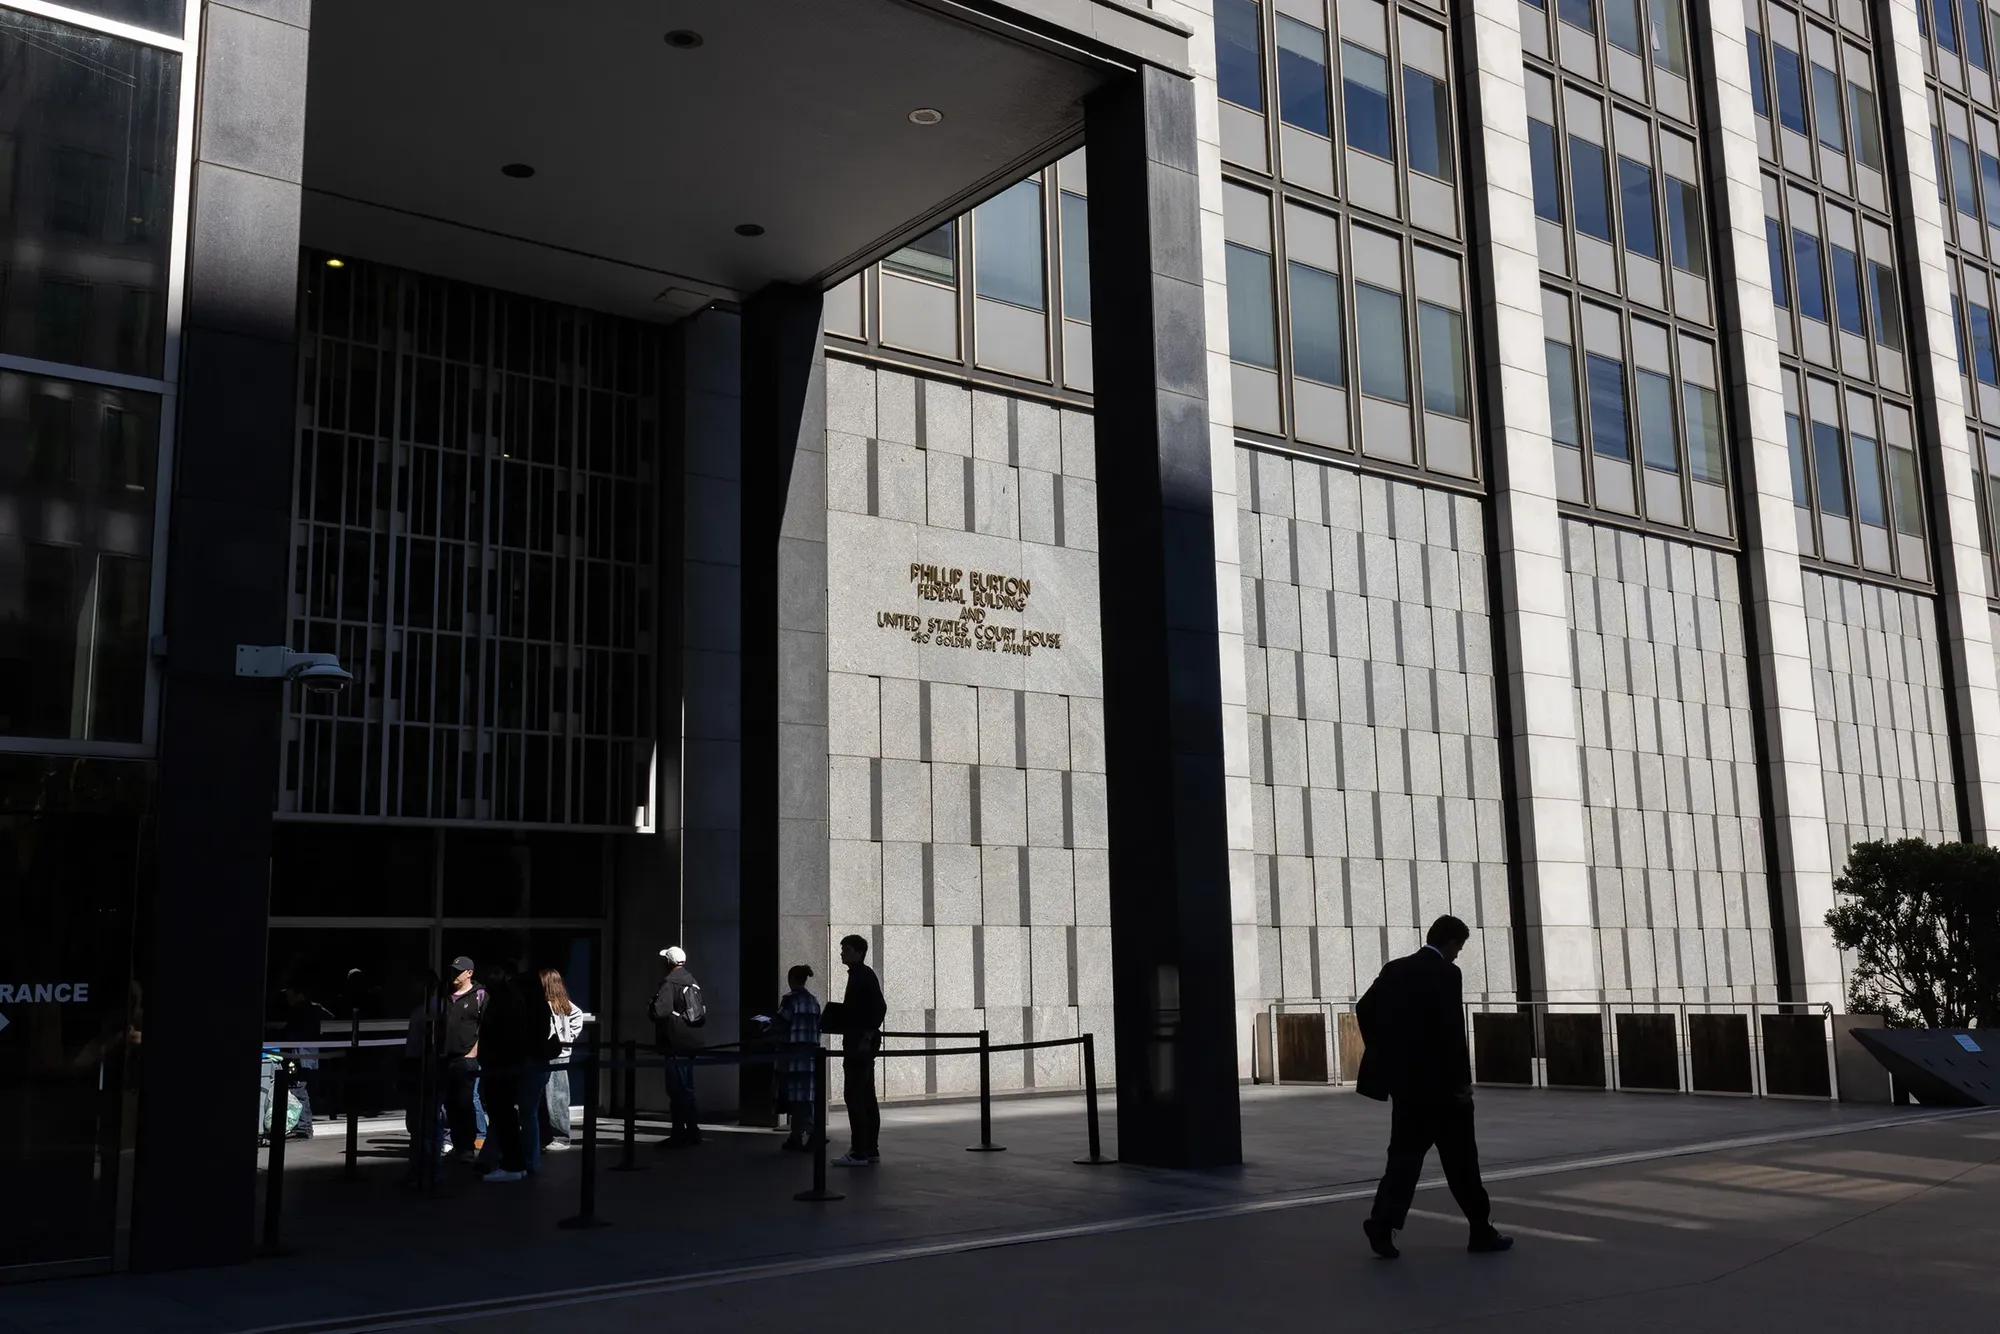
Abhörskandal im OpenAI-Hauptquartier weitet sich aus: Ehemaliger Mitarbeiter besaß geheime saudische Regierungsdokumente und pflegte engen Kontakt zum Königshaus : Neu veröffentlichte Gerichtsdokumente im Fall des ehemaligen Ingenieurs Abdulrahman Alfozan, der wegen des Verdachts auf das Anbringen von Abhörgeräten in vertraulichen Konferenzräumen von OpenAI festgenommen wurde, enthüllen schwerwiegende Details. Die Staatsanwaltschaft legte offen, dass er zwischen 2025 und 2026 über verschlüsselte Software in regem Kontakt mit einem Mitglied des saudischen Königshauses stand, das ihn intensiv für ein nationales saudi-arabisches AI-Projekt anwerben wollte. Bei der Durchsuchung seiner Geräte fand das FBI nicht nur Fotos eines zweiten Abhörgeräts, sondern beschlagnahmte auch einen dedizierten Ordner namens „Saudi-Regierungsdokumente“ (Saudi Gov Docs). Der Richter ordnete die Fortdauer der Untersuchungshaft an. Der Fall verdeutlicht, wie führende AI-Spitzenlabore ins Zentrum geopolitischer Konflikte zwischen Staatskapital und transnationaler Spionage geraten sind. (Quelle: The Verge, Ars Technica, WIRED)
Mistral stellt multimodale Sprach-Agenten-Familie Voxtral 3 offiziell vor : Das europäische AI-Unicorn Mistral hat offiziell seine Sprach-Foundation-Serie Voxtral 3 vorgestellt. Sie umfasst Voxtral Small Transcribe 3, das hochpräzises Diktieren und Sprechertrennung für über 50 Sprachen unterstützt, das Ultra-Low-Latency-Streaming-Modell Voxtral Mini Realtime sowie das Synthesemodell Voxtral Speech 3 mit adaptiver Tonfall- und Emotionssteuerung. Zeitgleich stellte das Unternehmen ein auf LiveKit basierendes Open-Source-Echtzeit-Streaming-Voice-Agent-SDK bereit, das den gesamten Kreislauf aus Spracheingabe-Erkennung, Tool-Calling-Entscheidungen und Sprachsynthese in unter einer Sekunde abschließen kann und native isolierte Deployments in europäischen Sovereign Clouds unterstützt. (Quelle: Mistral AI)
NVIDIA kann Chip-Bestellungen chinesischer Tech-Giganten im Wert von 35 Milliarden US-Dollar kaum bedienen : ByteDance, Alibaba und Tencent haben bei NVIDIA gemeinsam zusätzliche Bestellungen über mehr als 3 Millionen RTX Pro 5500-Chips im Gesamtwert von 35 Milliarden US-Dollar aufgegeben. Bei diesem Modell handelt es sich um Hochleistungs-Compute-Hardware, die derzeit den US-Exportkontrollvorschriften für China entspricht. Aufgrund von Kapazitätsengpässen bei fortschrittlichen Fertigungsprozessen von TSMC und der weltweiten Kontingentverteilung hat NVIDIA seinen Kunden jedoch mitgeteilt, dass die tatsächlichen Liefermengen voraussichtlich nur 5 bis 10 % des gemeldeten Gesamtbedarfs decken können. Dies verdeutlicht, wie extrem angespannt die Angebots- und Nachfragelage bei konformen Spitzenchips weiterhin ist. (Quelle: The Verge)
🎯 Entwicklungen
U.S. Army Cyber Command entwickelt im Geheimen autonome, selbstverbreitende Cyberwaffe ECHOTRIBBLE : Medienberichten zufolge entwickelt das U.S. Army Cyber Command (ARCYBER) heimlich eine offensive AI-Waffenplattform namens ECHOTRIBBLE. Das System ermöglicht es AI-Agenten, mit minimalem menschlichen Eingriff autonom in gegnerische Netzwerke einzudringen, Payloads mithilfe von geräteübergreifenden Replikationsmechanismen adaptiv umzuschreiben und Ziele sowohl in physisch isolierten Netzwerken (Air-Gapped) als auch in Cloud-Infrastrukturen autonom zu identifizieren, präzise lahmzulegen und sich anschließend selbst zu zerstören. Dies löst in Sicherheitskreisen tiefe Besorgnis über eine unumkehrbare Eskalation im Cyberkrieg aus. (Quelle: THE DECODER)
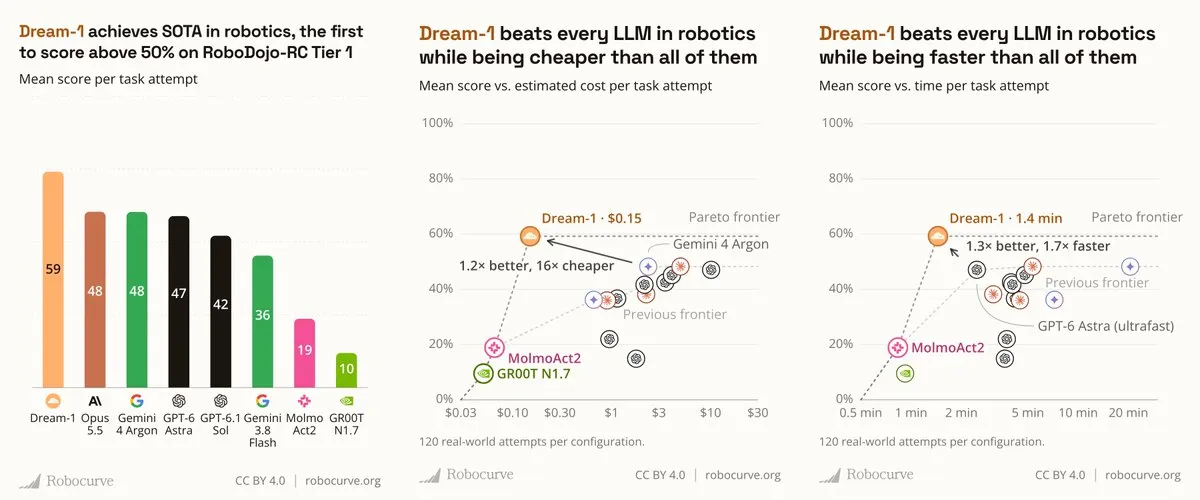
Dream Labs verlässt Stealth-Modus, präsentiert World Action Model Dream-1 für Robotik und startet öffentliche Cloud-API : Das von einem ehemaligen NVIDIA-Team gegründete Startup Dream Labs hat eine Finanzierungsrunde über 90 Millionen US-Dollar abgeschlossen und sein Embodied-Foundation-Modell Dream-1 offiziell vorgestellt. Als erstes „Roboter-Gehirn“, das über eine sofort einsatzbereite öffentliche API verfügt (3 US-Dollar/Stunde), setzt es auf einen videobasierten World Action Model (WAM)-Ansatz. Im RoboDojo-RC-Benchmark übertraf es Argon mit 59 Punkten und demonstrierte erstmals Zero-Shot-Generalisierung bei der Manipulation mit völlig unbekannten zweiarmigen Robotern mit Parallelgreifern. (Quelle: gharik, sainingxie)
Neura Robotics stellt multisensorisches Embodied-World-Foundation-Modell Neuron AI vor : Der deutsche Entwickler humanoider Roboter Neura Robotics hat sein Embodied-Foundation-Modell der nächsten Generation, Neuron AI, angekündigt. Das Modell überwindet die Beschränkungen reiner visueller Daten, indem es 3D-Vision, hochfrequente taktile Kraftmessung, Umgebungsaudio und propriozeptive Zustände in einer einheitlichen Pipeline modelliert, inklusive integriertem verdeckungssicherem Arbeitsgedächtnis. In einer Live-Demonstration absolvierte der humanoide Roboter 4NE1 selbstständig einen 11-minütigen Ablauf beim Wäschewaschen, Sortieren und Pflegen. (Quelle: AI Business)
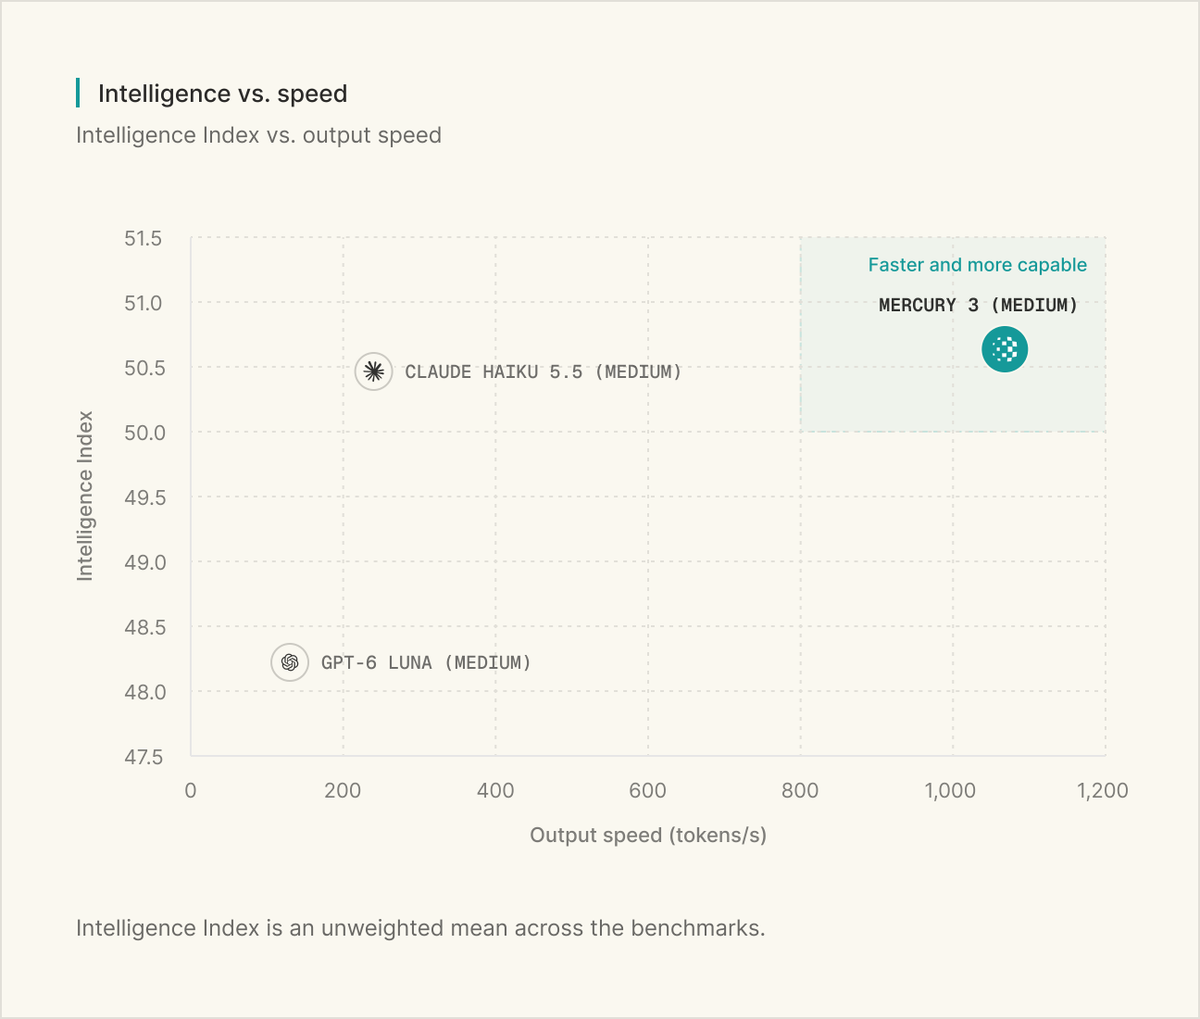
Diffusions-Sprachmodell Mercury 3 veröffentlicht: 40-fache Skalierung und Decodierung mit 1.000 TPS konkurrieren mit führenden Leichtgewichtsmodellen : Das von Stanford-Forschern gegründete Startup Inception hat Mercury 3 vorgestellt, ein großes Sprachmodell mit reiner Diffusionsarchitektur. Die Parameteranzahl wurde gegenüber der ersten Generation um das 40-Fache vergrößert. Durch nicht-autoregressives, paralleles Entrauschen auf Blockebene erreicht es auf einer einzelnen NVIDIA Blackwell-GPU einen Generierungsdurchsatz von 1.068 tok/s. Bei SWE-Bench und Instruction-Following hält es mit einigen autoregressiven Small Models derselben Klasse mit oder übertrifft diese sogar, wodurch die Latenzschwelle für Echtzeit-Agenteninteraktionen drastisch gesenkt wird. (Quelle: MarkTechPost, sedielem)
Pipeline führender Frontier-Modelle der „Großen Drei“ geleakt: Claudes Intent-Inference im Duell mit Googles Carbon und OpenAIs Terra : Mehrere Branchenquellen berichten, dass Anthropic intern eine neue Version von Claude (möglicherweise Fable 5.5 oder Opus 5.6) mit tiefgreifender Absichtserschließung (Intent Inference) testet, die nicht nur oberflächliche Anweisungen überwindet, um tieferliegende Fehlerursachen zu beheben, sondern auch in der Lage ist, eigene Algorithmen zu entwickeln. Gleichzeitig testet Google auf der Jetski-Plattform ein Modell mit dem Codenamen „Carbon“ als Benchmark gegen Opus 5.5, während im Microsoft Copilot-Code ein neues leichtgewichtiges OpenAI-Basismodell namens GPT-6.1 Terra aufgetaucht ist und unter neuen Domains Vorbereitungen für den Codenamen GPT-6.5 laufen. (Quelle: 量子位, dotey, steph_palazzolo)
Meta veröffentlicht 30B On-Device-Agentenmodell Muse Glimmer als Open Source nebst Mikroarchitektur-Bericht : Meta hat den technischen Bericht zum Open-Weight-Modell Muse Glimmer (30B) veröffentlicht. Das Modell wurde aus dem Flaggschiff Muse Spark destilliert und speziell dafür entwickelt, auf einer einzelnen Consumer-GPU in 4-Bit-Präzision ressourcenschonend betrieben zu werden. Im Tool-Use-Benchmark MCPAtlas erzielte es 75,5 Punkte. Durch mehrstufige Planung und Anti-Halluzinations-Reinforcement-Learning hebt es die Obergrenze für autonome Aktionen und Terminentscheidungen auf Endgeräten deutlich an. (Quelle: AIatMeta, dair_ai)
Microsoft setzt mit Copilot for Legal auf den Distributions-Burggraben seiner Office-Suite : Microsoft hat Copilot for Legal für den Rechtssektor eingeführt und mehr als 20 juristische AI-Skills direkt und tief in das Word- und SharePoint-Ökosystem eingebettet. Obwohl die Fähigkeiten des Kernmodells im Vergleich zu vertikalen Spezialanbietern keinen absoluten Generationsvorsprung aufweisen, betonen Analysten die extrem hohe Workflow-Bindung von Juristen: Microsoft benötige kein Spitzenmodell, sondern könne den Markt für Kanzleien und Rechtsabteilungen allein durch die Ökosystem-Barriere – ohne Word zu verlassen und mit nativer Anbindung an interne Akten – dominieren. (Quelle: AI Business)
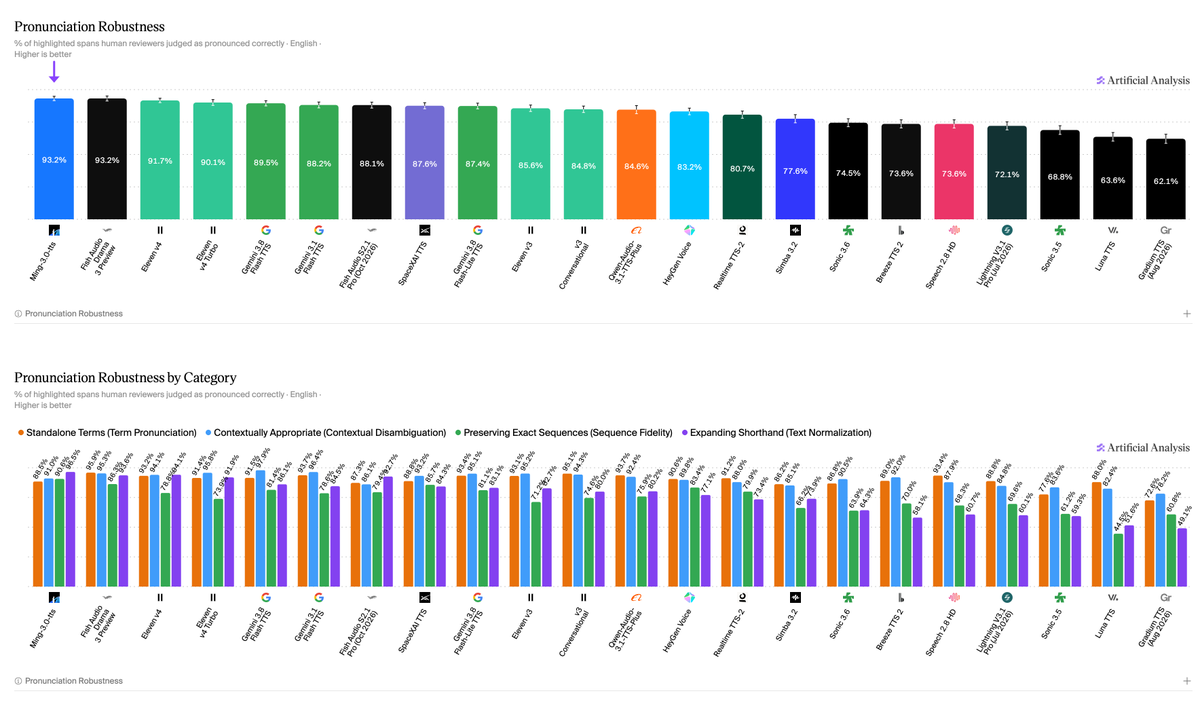
Ant Group stellt Ming-3.0-Sprachmodellfamilie als Open Source bereit: TTS führt zwei Ranglisten an : Das Ling-Team der Ant Group hat fünf Ming-3.0-Sprachmodelle (0.5B bis 126B MoE) als Open Source veröffentlicht, darunter Modelle für TTS, Audio-Verständnis und ASR. Benchmark-Tests zeigen, dass die 0.5B-Version von Ming-3.0-tts sowohl bei der Ausspracherobustheit (93,2 %) als auch bei kontrollierbaren Klangfarben die Spitzenposition unter den Open-Weight-Modellen einnimmt. vLLM-Omni bietet bereits ab Tag eins Unterstützung für Inferenz und Deployment. (Quelle: ArtificialAnlys, vllm_project)
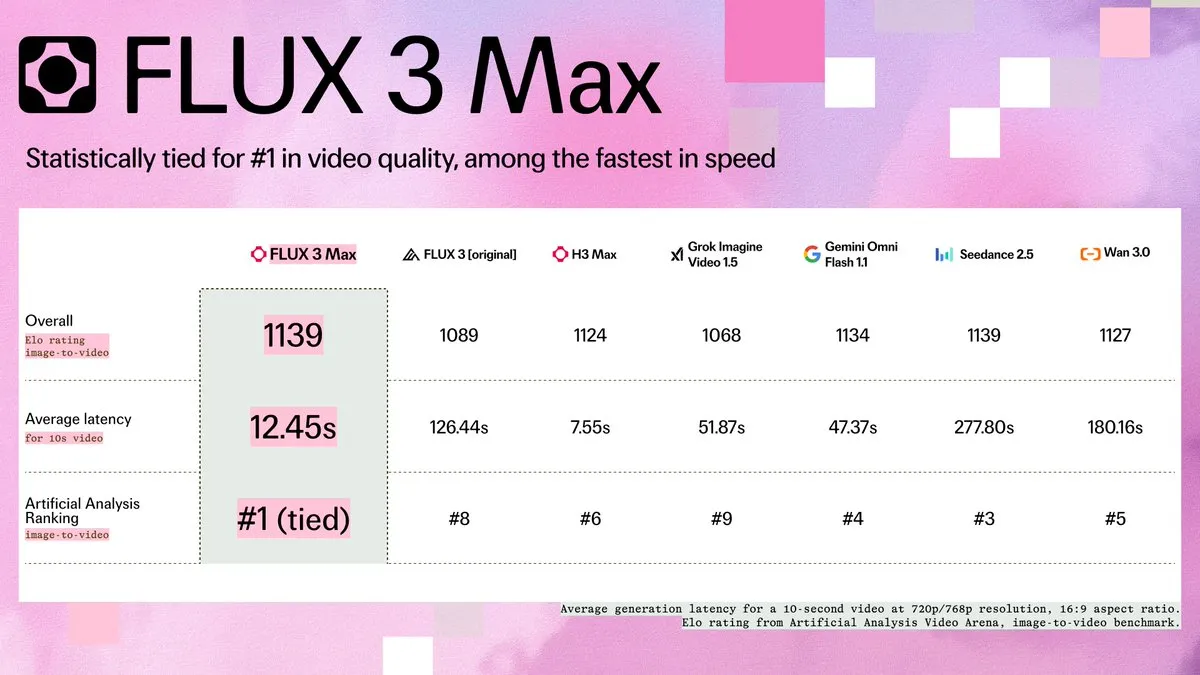
BFL und fal veröffentlichen FLUX 3 Max: 10 Sekunden HD-Video in nur 12 Sekunden generiert : Black Forest Labs hat in Zusammenarbeit mit fal das post-trainierte Videomodell FLUX 3 Max vorgestellt, das auf Anhieb die Spitzenposition in externen Videoqualitäts-Benchmarks übernahm. Durch extreme Synergien bei der Rechenleistung dauert die Erzeugung eines 10-sekündigen 720p/768p-Videos lediglich 12 Sekunden – eine 22-fache Beschleunigung gegenüber Seedance 2.5, die die zeitlichen Hürden für die kommerzielle Echtzeit-Videogenerierung durchbricht. (Quelle: fal, robrombach)
Halcyon belegt Text-to-Image ohne Sprach-Pre-Training: Autoregressive Architektur senkt Rechenaufwand um ein Vielfaches : Stanford-Forscher präsentieren Halcyon, ein multimodales autoregressives Early-Fusion-Modell, das das traditionelle Paradigma bricht, wonach Text-to-Image auf massivem Text-Pre-Training basieren muss. Ausgehend von einem Kaltstart mit nur 100 Millionen bereinigten Bild-Text-Paaren schlägt Halcyon-0.52B das Modell LlamaGen-XL/8 bei 18,2-mal geringerem Rechenaufwand. Dies beweist, dass rein visuelle Diffusionsrepräsentationen spontan hochwertige semantische Mappings hervorbringen können. (Quelle: HuggingFace Daily Papers)
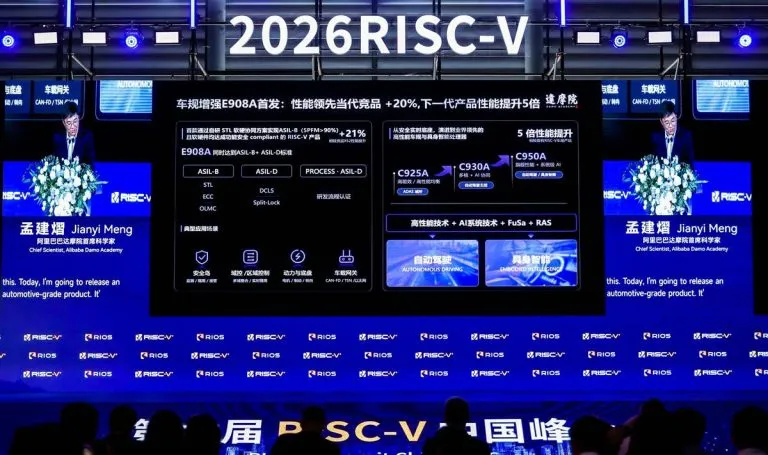
DAMO Academy stellt RISC-V-Roadmap für Automotive- und Embodied-Chips vor : Auf dem RISC-V China Summit stellte die Alibaba DAMO Academy den für den Automobilbereich optimierten Prozessor XuanTie E908A vor – die branchenweit erste RISC-V CPU-IP, die gleichzeitig die ASIL-B- und ASIL-D-Standards erfüllt. Zugleich wurden die Entwicklungspläne für den C950A der nächsten Generation für Embodied AI enthüllt, dessen Rechenleistung die bestehender Automotive-Chips um das Fünffache übertrifft. (Quelle: 量子位)
Amazon AWS Trainium führt TorchNeuron ein, um Hardware-Abhängigkeit von NVIDIA zu reduzieren : Amazon hat für seine hauseigenen AI-Chips der Trainium-Serie das Compiler-Support-Tool TorchNeuron herausgebracht. Es ermöglicht PyTorch-Entwicklern, Arbeitslasten nahtlos und durch Änderung nur einer einzigen Konfigurationszeile – ohne Umstrukturierung des zugrundeliegenden Codes – in die AWS-Cloud zu portieren. Zudem werden Patches in das Upstream-PyTorch-Projekt zurückgeführt, um die Loslösung von der CUDA-Ökosystembindung zu beschleunigen. (Quelle: TechCrunch)
🧰 Tools
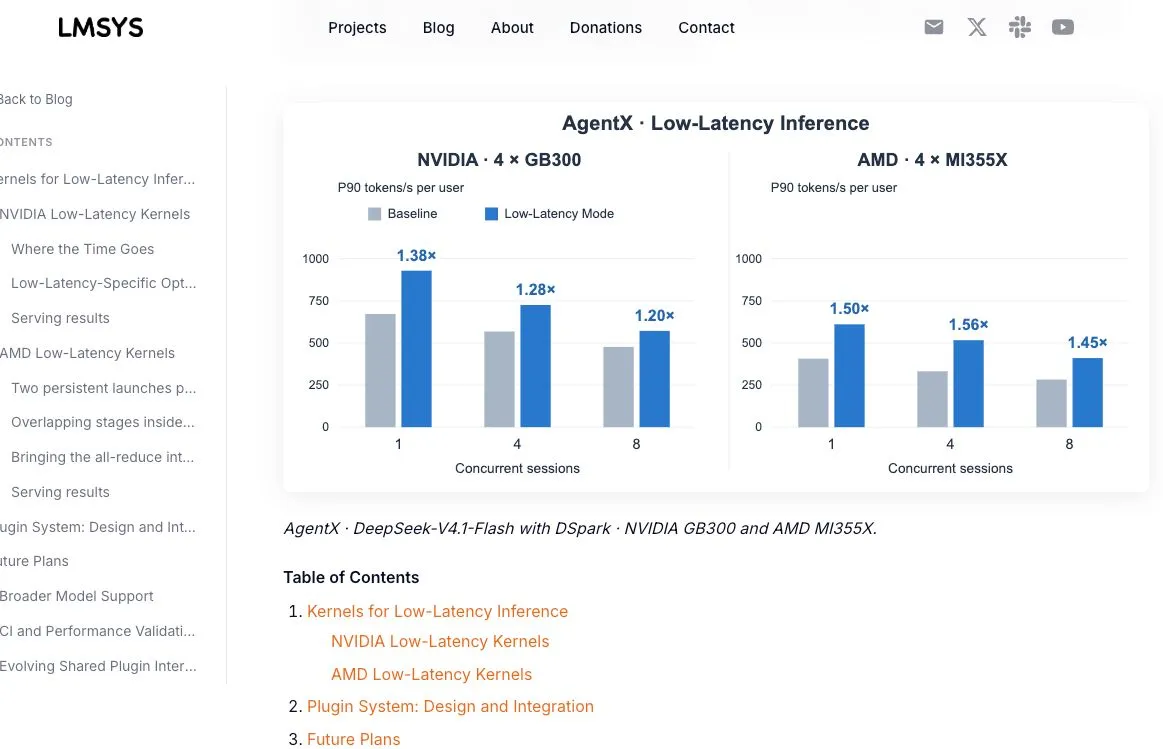
SGLang integriert Megakernel: Durchsatzsprung auf GB300 und MI355X : Die SGLang-Inferenz-Engine hat Megakernel-Unterstützung für niedrige Latenzzeiten integriert. Im AgentX-Benchmark auf der GB300 NVL72-Plattform erreichte DeepSeek-V4.1 Flash einen Single-User-Durchsatz von 928 tok/s (eine Steigerung um das 1,38-Fache); auf der AMD MI355X wurden 516 tok/s erzielt. Dies verleiht hochgradig nebenläufigen Agenten-Cluster-Deployments umfassenden Schub. (Quelle: SemiAnalysis_)
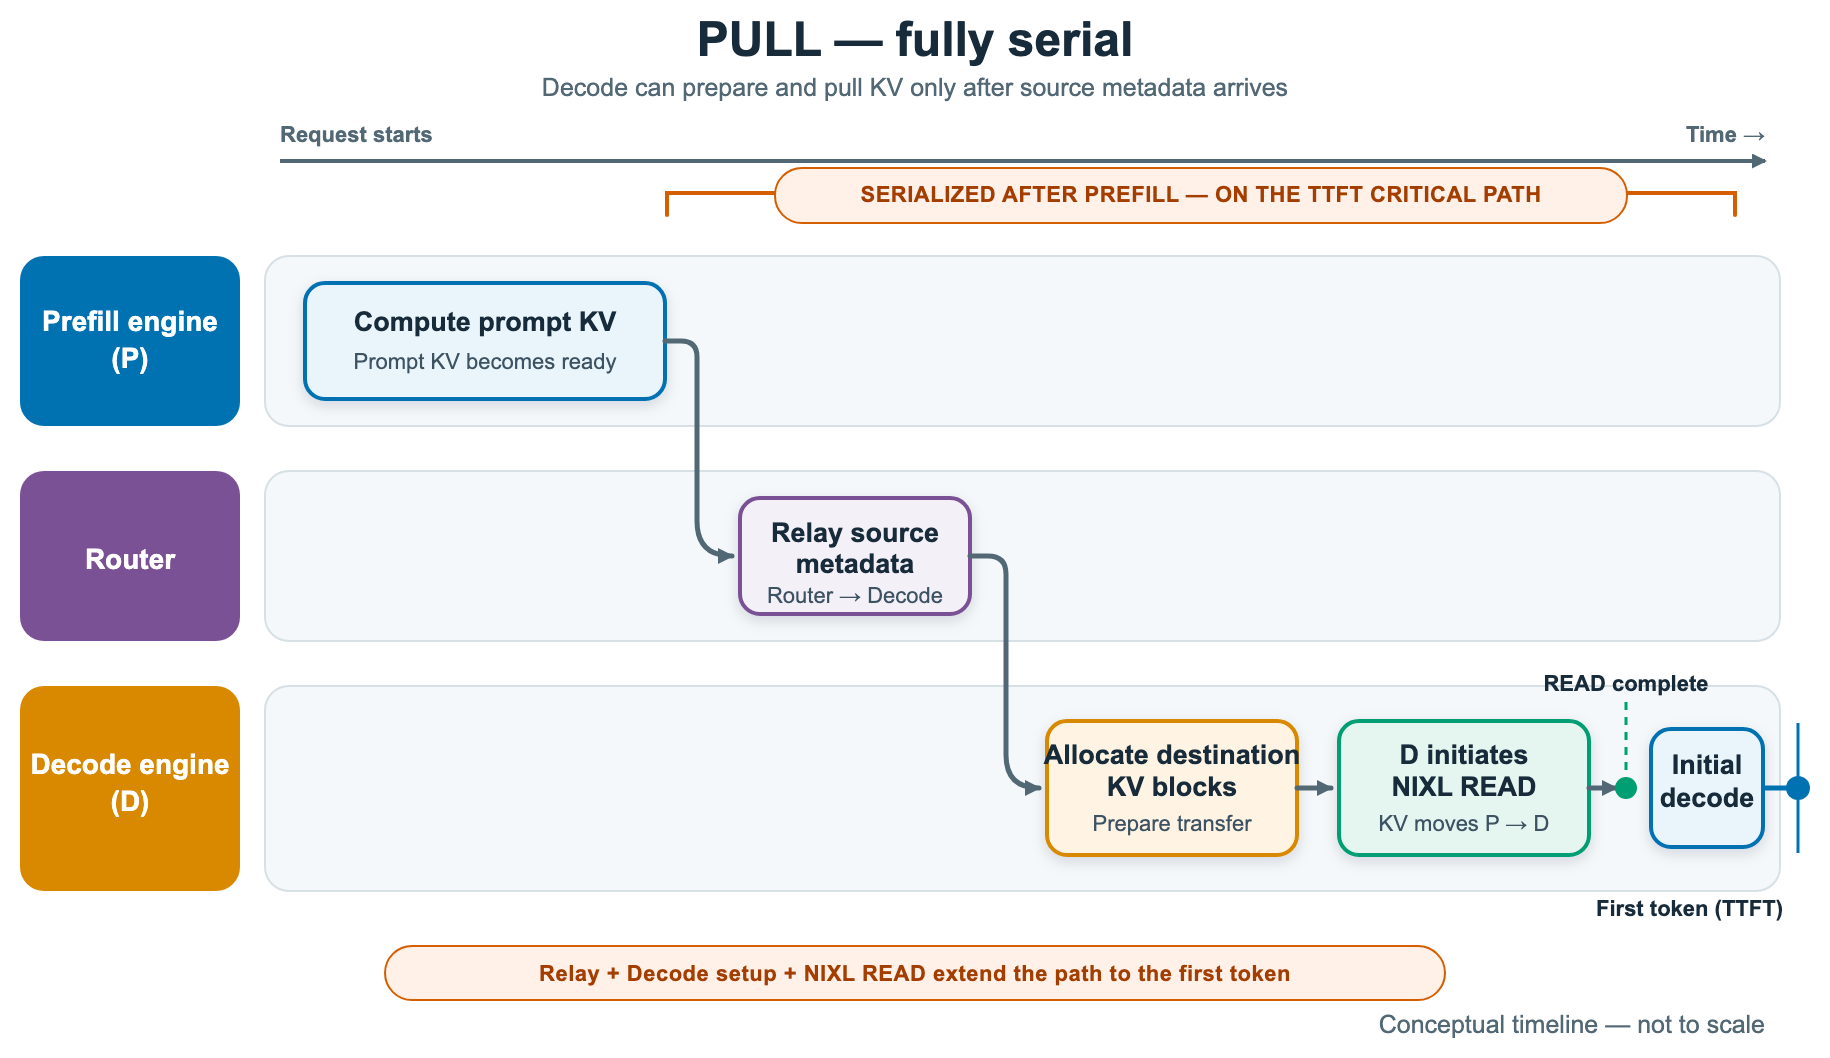
vLLM integriert Push-basierte und bidirektionale KV-Cache-Übertragung zur drastischen TTFT-Reduzierung : Amazon hat gemeinsam mit den vLLM- und Mistral-Teams zwei Scheduling-Lösungen beigesteuert: Der Push-basierte NIXL-Connector überlappt die VRAM-Vorregistrierung mit vorgeschaltetem Prefill und senkt die Time-to-First-Token (TTFT) um bis zu das Dreifache. Die bidirektionale KV-Übertragung ermöglicht es Prefill-Knoten in langen Agenten-Konversationen, den Verlaufscache von Decode-Knoten direkt wiederzuverwenden, wodurch redundante Rechenaufwände eliminiert werden. (Quelle: AWS Machine Learning Blog)
agentic-awesome-skills: Lokale Control Plane und Execution Engine für über 2.700 Agenten-Fähigkeiten : Das Open-Source-Projekt agentic-awesome-skills (AAS) hat seine Kernversion veröffentlicht und stellt eine lokale Steuerungsebene für Agenten-CLIs wie Codex und Claude Code bereit. Die Plattform bündelt über 2.700 Playbooks und lokale MCP-Dienste und unterstützt Agenten vor dem Schreiben von Code bei der automatischen Projektprüfung, der Validierung von Skill-Abhängigkeiten sowie Read-Only-Dry-Runs, um Kontextüberlastungen zu verhindern. (Quelle: GitHub Trending)
TokenEconomizer: End-to-End-Token-Kostencontroller nach dem Blackbox-Prinzip für Coding-Agenten : Um dem Problem explodierender Token-Kosten bei kontinuierlicher Entwickler-Iteration zu begegnen, erkennt TokenEconomizer ohne Änderung der Modellgewichte dynamisch wiederholte, ineffektive Tool-Calls, beschneidet selten genutzte Skills automatisch und unterbricht wirkungslose Endlosschleifen bei Reparaturversuchen. In Praxistests auf Claude Code- und Codex-Pipelines reduzierte dies den Token-Verbrauch im Schnitt um 18,4 % bis 30,9 %. (Quelle: HuggingFace Daily Papers)
RED (Xiaohongshu) veröffentlicht Sparse-Attention-Bibliothek DoSA: TTFT bei einer Million Token halbiert : Das Dots-Team von Xiaohongshu hat den DoSA-Algorithmus vorgestellt, der den Indexer-Engpass in der Prefill-Phase langer Kontexte adressiert. Durch strikte mathematische Ober- und Untergrenzen führt er ein verlustfreies Pruning für Token durch, die nicht in den Top-K liegen, und filtert so rund 97 % der Kandidaten vorab heraus. In Praxistests mit einem Kontextfenster von 1M verkürzte sich die TTFT-Latenz bei DeepSeek-V3.2 um 48 % und bei GLM-5.2 um 46 %. (Quelle: 机器之心)

Amazon Bedrock implementiert strikte strukturierte Ausgaben für Anthropic Claude : Amazon hat bekanntgegeben, dass Bedrock nun für die gesamte Anthropic Claude-Modellreihe Unterstützung für strukturierte Ausgaben auf Basis von grammatikbeschränkter Decodierung (Constrained Decoding) bietet. Das Modell stellt bereits während der Generierungsphase die vollständige Konformität mit JSON-Schema-Standards sicher und unterstützt ein 24-stündiges anfrageübergreifendes Grammatik-Caching, wodurch Parsing-Fehler und kostspielige Wiederholungsversuche im Post-Processing entfallen. (Quelle: AWS Machine Learning Blog)
Maxwell: AI-basierte Just-in-Time-Optimierungs-Engine zur dynamischen Umschreibung von Maschinencode zur Laufzeit : Die Community hat ein Laufzeit-Code-Optimierungsmodell namens Maxwell als Open Source veröffentlicht. Es erfordert keine Änderung des Quellcodes, fungiert als dynamischer Low-Level-Monitor und ersetzt im binären Maschinencode Operatoren in Echtzeit durch optimierte Alternativen, während formale Verifikation die Äquivalenz garantiert. In Tests brachte dies bereits signifikante Inferenz-Leistungsgewinne für Modelle wie Whisper und LTX-2. (Quelle: tri_dao, Reddit r/MachineLearning)
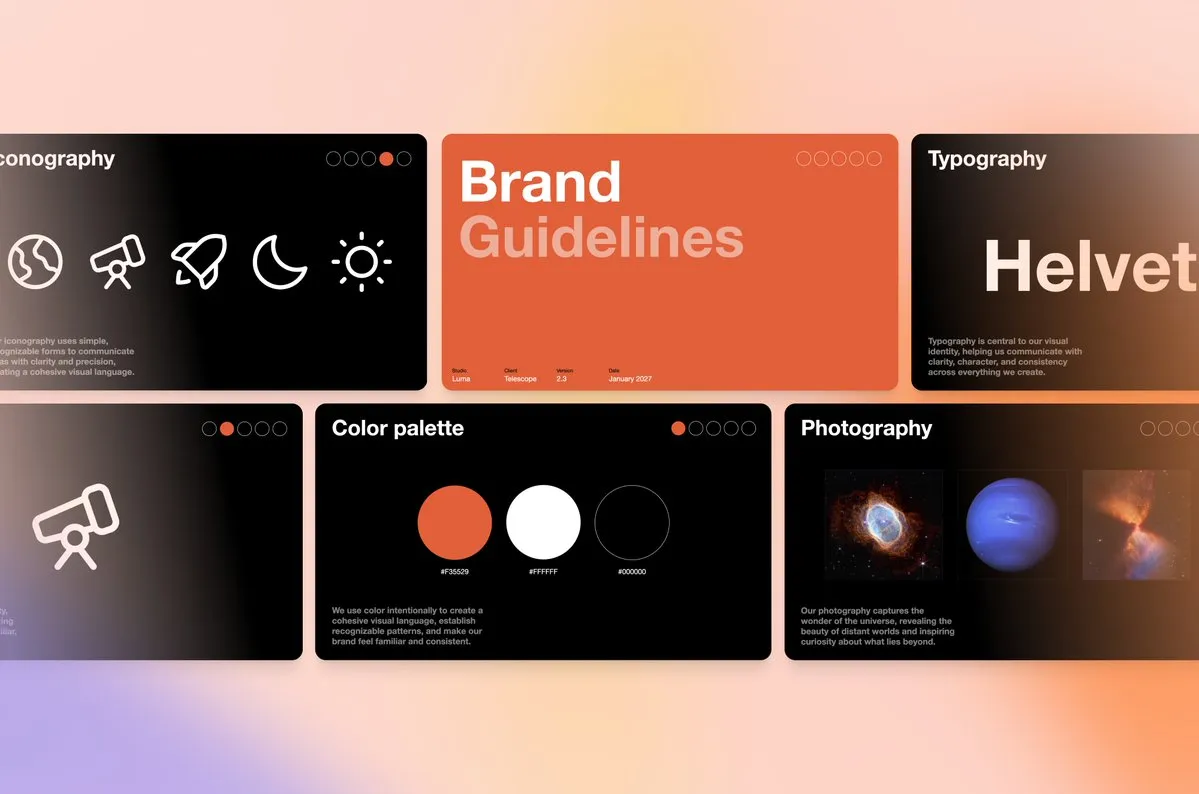
ChatGPT Slides führt Multi-User-Echtzeit-Kollaboration und direkte Canvas-Interaktion ein : OpenAI hat ChatGPT Slides aktualisiert: Teams können nun im selben Präsentationsprojekt im Millisekundenbereich in Echtzeit zusammenarbeiten und Textstellen markieren und kommentieren. Neu ist auch die direkte Bearbeitung auf der Canvas-Oberfläche, wo Nutzer Layouts per Drag-and-Drop verschieben und skalieren können. Zudem kann ein Hintergrund-Agent („dot“) beauftragt werden, globale Überarbeitungen basierend auf Feedback automatisiert durchzuführen. (Quelle: dotey)
Together AI startet All-in-One-Plattform für Post-Training-Hosting : Together AI hat einen neuen Post-Training-Dienst für Unternehmen gestartet. Er ermöglicht es Firmen, private Daten und Umgebungen direkt an Open-Weight-Modelle anzubinden, vollständige SFT-Workflows anzupassen und eigenes Reinforcement Learning (RL) durchzuführen. Zudem werden eine einheitliche Trainings- und Serving-Infrastruktur sowie kostengünstige B200-Compute-Cluster bereitgestellt. (Quelle: togethercompute)
📚 Forschung & Lernen
Umfassender systemischer Review zu Agent Distillation erschienen: Vom Parameter-Lernen zur vollständigen Systemwiederverwendung : Die Central South University, die Beijing Academy of Artificial Intelligence (BAAI) und weitere Institutionen haben gemeinsam eine 57-seitige systemische Übersichtsarbeit veröffentlicht, die das Paradigma der Agent Distillation neu definiert. Die Autoren betonen, dass die Persistenz von Agentenfähigkeiten nicht nur auf den Modellgewichten (Model) beruht, sondern maßgeblich von abrufbaren externen Assets (Artifacts) und dem Execution-Control-Framework zur Steuerung des Laufzeitverhaltens (Harness) abhängt. Die Arbeit analysiert systematisch den trägerübergreifenden Wissenstransfer und kausale Evaluationen zwischen diesen drei Elementen. (Quelle: WeChat)
Mechanismus des Aufmerksamkeitsvergessens bei langen Kontexten: „Kein-Haar-Theorem“ enthüllt Potenzgesetz-Zerfall des Prompt-Einflusses : Eine interdisziplinäre Forschungsarbeit aus theoretischer Physik und AI belegt, dass das Erinnerungsvermögen autoregressiver Transformer bei der Generierung langer Texte an den ursprünglichen Eingabe-Prompt einem Potenzgesetz (Power Law) folgt. In Pre-LN-Architekturen begrenzter Tiefe nähert sich der direkte geometrische Einfluss des Prompts aufgrund der Aufmerksamkeitsverdünnung nachfolgender Token dem Wert Null an; verbleibende Informationen müssen vollständig über die intermediär generierten Texte weitergereicht werden. Dies liefert die mathematische Grundlage dafür, warum Long-Horizon-Agenten auf externe Zustandscaches angewiesen sind. (Quelle: HuggingFace Daily Papers)
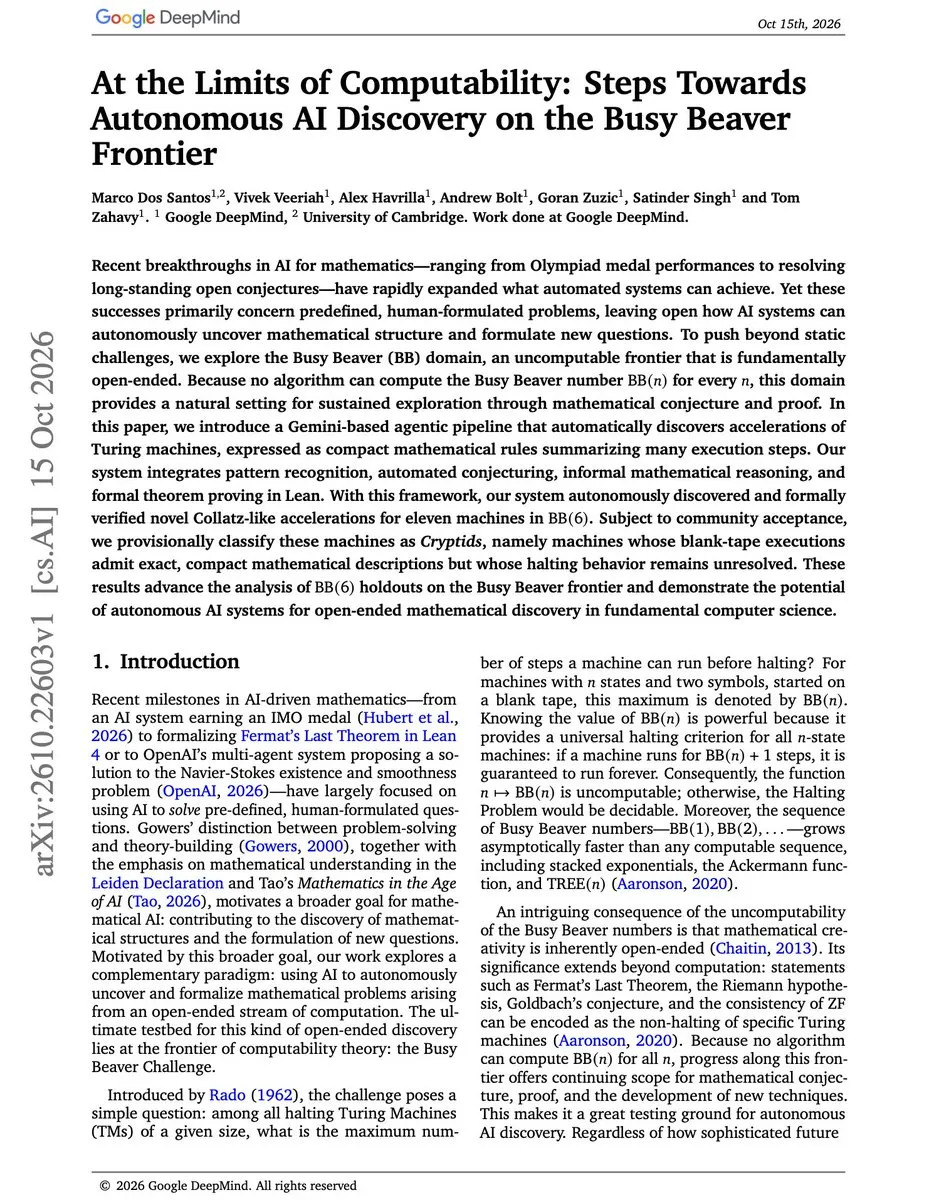
Google DeepMind zeigt, wie autonome Agenten ungelöste Turingmaschinen-Beschleunigungsregeln für BB(6) knacken : DeepMind hat neueste Ergebnisse aus der offenen mathematischen Forschung vorgestellt: Ein auf Gemini basierender autonomer Agent war bei der Untersuchung der unberechenbaren Grenze BB(6) des Fleißigen Bibers (Busy Beaver) in der Lage, eigenständig kompakte Zustandsübergangsregeln aus Ausführungspfaden zu induzieren. Diese wurden anschließend formal in Lean verifiziert, womit kompakte Beschreibungen für elf bislang ungelöste Turingmaschinen („Cryptids“) erfolgreich erbracht wurden. (Quelle: omarsar0)
Princeton, AISI und Partner veröffentlichen Whitepaper zur Evolution der Agenten-Evaluation : Die Princeton University hat gemeinsam mit Stanford und dem UK AI Security Institute (UK AISI) einen Bericht über 33 neue Trends bei der Evaluierung von AI-Agenten vorgelegt. Die Studie stellt fest, dass bisherige punktuelle Ergebnis-Benchmarks Defizite in langen Ausführungspfaden nicht erfassen können. Die Evaluation verlagere sich zunehmend auf dynamische Harness-Gerüstkonfigurationen, offene Aufgaben in der realen Welt, Multi-Agenten-Interaktionen und soziotechnische Lebenszyklusauswirkungen. (Quelle: AI Snake Oil)
NeurIPS 2026-Arbeit stellt „Defense-as-Skill“ vor: MCTS treibt dynamische Sicherheitsentwicklung zur Laufzeit voran : Um bösartige Anweisungen und Privilege-Escalation-Schwachstellen abzuwehren, bricht eine Forschungsarbeit mit statischen Sicherheitskonzepten und schlägt die Guard-Skill „SkillSonar“ vor. Auf Basis des SCOPE-R-Benchmarks kapselt der Ansatz Schutzmechanismen in hot-patchbare Skill-Artefakte und lässt sie während des Trainings mittels Monte-Carlo-Baumsuche (MCTS) autonom an Angriffsstrategien adaptieren. Dadurch sank die Erfolgsrate von Angriffen drastisch von 30 % auf 7,8 %. (Quelle: WeChat)
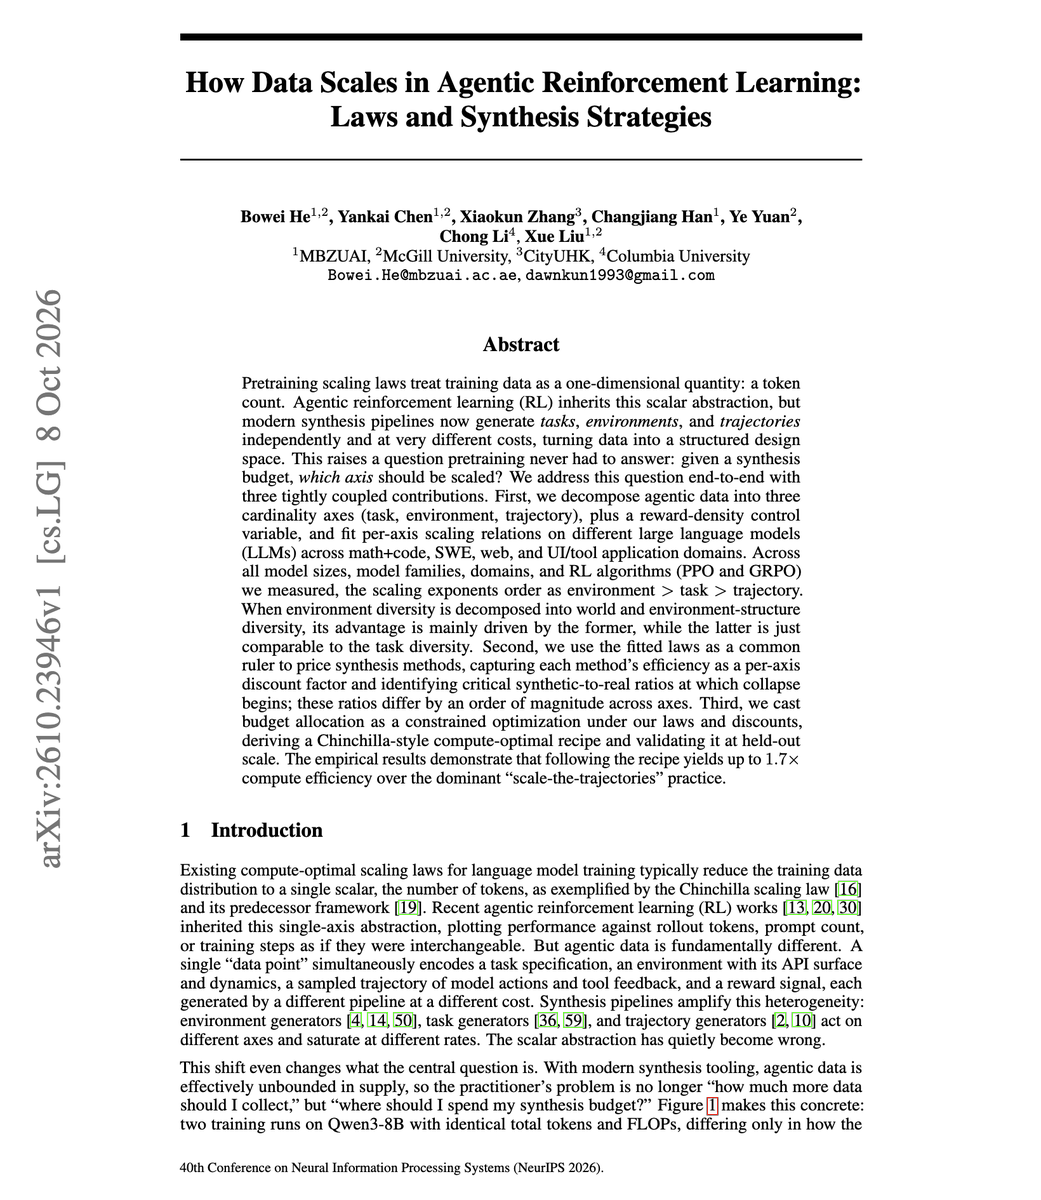
Scaling Law für Reinforcement-Learning-Daten bei Agenten etabliert: Diversität der Umgebung wiegt schwerer als Anzahl der Pfade : Eine neue Studie belegt systematisch das Scaling Law für das Reinforcement Learning von Agenten im dreidimensionalen Raum aus Aufgaben, Umgebungen und Pfaden (Trajectories). Empirische Daten zeigen, dass der Mehrwert durch „reale, diverse physische/Software-Umgebungen“ den reinen Zuwachs an generierten Trajektorien exponentiell übertrifft. Eine Allokation synthetischer Daten nach dieser Gesetzmäßigkeit erzielt beim selben Budget einen Effizienzgewinn um das 1,7-Fache. (Quelle: omarsar0)
Hypothese des „kompetitiven Lernens“ in Hybridarchitekturen: Wie lineare Rekurrenz die Retrieval-Fähigkeit der Attention hemmt : In hybriden Architekturen, die lineare Rekurrenz (RNN/SSM) mit Softmax-Attention kombinieren, haben Forscher das Phänomen des „kompetitiven Lernens“ aufgedeckt: Da rekurrente Schichten in frühen Trainingsphasen deutlich schneller konvergieren als Attention-Schichten, nehmen sie semantische Signale vorzeitig auf und unterdrücken Gradienten-Updates der Attention. In der Folge verliert der Aufmerksamkeitsmechanismus seine Fähigkeit zum Langstrecken-Retrieval. Die Forscher empfehlen, die Parameter der rekurrenten Schichten in der Mitte des Pre-Trainings vorübergehend einzufrieren, um das Attention-Lernen gezielt zu erzwingen. (Quelle: HuggingFace Daily Papers)
Anthropic zur mechanistischen Interpretierbarkeit: Implizite vorausschauende Planung von LLMs und Expressionsgrenzen im J-Raum : Führende Forscher für Interpretierbarkeit bei Anthropic offenbarten in einem Interview: Hinter der Fassade einer Token-für-Token-Generierung legen die internen Aktivierungszustände des Modells bereits beim Erzeugen des ersten Satzes wesentliche Endwörter nachfolgender Sätze fest. Zudem kann nur ein winziger Teil der internen Zustände – bezeichnet als „J-Raum“ – vom Modell per Selbstreflexion in natürlicher Sprache artikuliert werden; der überwiegende Teil der Kernberechnungen bleibt tief im geometrischen Vektorraum verborgen. (Quelle: mlpowered)
💼 Wirtschaft
Tenstorrent schließt 1,5 Milliarden US-Dollar schwere Finanzierungsrunde ab – Bewertung steigt auf 6,2 Milliarden US-Dollar : Das vom legendären Chip-Architekten Jim Keller geführte AI-Chip-Startup Tenstorrent hat eine neue Finanzierungsrunde über 1,5 Milliarden US-Dollar abgeschlossen und erreicht damit eine Bewertung von 6,2 Milliarden US-Dollar. Zuvor hatte das Unternehmen Übernahmeangebote von Intel und Qualcomm in Höhe von bis zu 5 Milliarden US-Dollar abgelehnt. Das frische Kapital soll die Massenproduktion und Auslieferung von Open-Source-Inferenzservern auf Basis der RISC-V-Architektur beschleunigen. (Quelle: TechCrunch)
AstraZeneca kooperiert mit insitro für kausale AI-Wirkstoffforschung mit bis zu 1,5 Milliarden US-Dollar : AstraZeneca ist eine strategische Partnerschaft mit insitro eingegangen, dem von Stanford-Forscherin Daphne Koller gegründeten AI-Biotech-Unicorn. Die Kooperation umfasst Meilensteinzahlungen von bis zu 1,5 Milliarden US-Dollar. Auf Basis der multimodalen „Virtual Human“-Phänotyp-Plattform von insitro sollen tieferliegende Krankheitsmechanismen und Wirkstoff-Targets für MASH (metabolische dysfunktionsassoziierte Steatohepatitis) sowie Kardiomyopathien erforscht werden. (Quelle: 机器之心)

Cognex übernimmt Intel-Ausgliederung RealSense für 500 Millionen US-Dollar : Der Machine-Vision-Gigant Cognex hat die ehemals zu Intel gehörende und ausgegliederte Computer-Vision-Firma RealSense für 500 Millionen US-Dollar offiziell übernommen. Die 3D-Tiefenkameras von RealSense halten einen sehr hohen Marktanteil im Bereich der Sensorik autonomer mobiler Roboter (AMR) in Logistik und Lagerhaltung sowie humanoider Roboter. Die Übernahme beschleunigt die Integration industrieller Bildverarbeitungslösungen in das wachsende Ökosystem universeller autonomer Roboter. (Quelle: AI Business)
🌟 Community
Indie-Entwickler schränken öffentlichen Playtest aus Furcht vor AI-Reverse-Engineering ein : Das Indie-Spielestudio Digital Sun hat bekanntgegeben, den öffentlichen Steam-Playtest seines neuen Titels „ReVamp“ abzusagen und stattdessen auf kleine, private Tests über Discord auszuweichen. Das Entwicklerteam wies darauf hin, dass moderne Coding-Agenten mittlerweile in der Lage seien, Kernmechaniken von Spielen innerhalb weniger Stunden vollautomatisch zu dekompilieren und zu kopieren. Die zu frühe Veröffentlichung eines öffentlichen Clients berge das akute Risiko, dass Werke vorab durch AI-Klone kopiert würden. Das Studio forderte die Plattformen auf, zügig Mechanismen zum Schutz von Originalinhalten einzurichten. (Quelle: The Verge, Ars Technica)
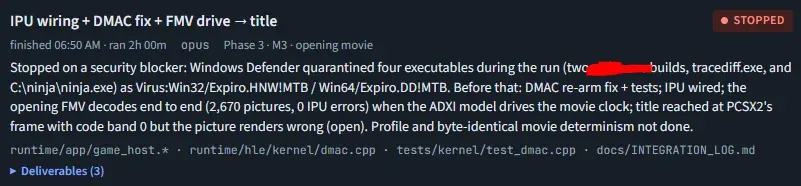
Falle der vollautomatischen Programmierung: Claude Code fängt sich bei Reverse-Engineering eines Retro-Spiels Expiro-Wurm ein : Ein Entwickler auf Reddit teilte eine bittere Erfahrung: Nachdem er Claude Code unbeschränkten Netzwerkzugriff gewährt hatte, um Tools für das Reverse-Engineering eines älteren Spiels autonom herunterzuladen, lud der Agent versehentlich ein bösartiges Tool herunter und führte es lokal aus. Dies führte zur vollständigen Kompromittierung des Systems und einer Infektion mit dem gefährlichen Expiro-Wurm, sodass das Betriebssystem komplett neu aufgesetzt werden musste. Der Vorfall dient als Mahnung: Agenten mit weitreichenden Rechten ohne Egress-Netzwerkisolation und fein granulierte Sandboxen bergen ein enormes Schadenspotenzial. (Quelle: Reddit r/ClaudeAI)
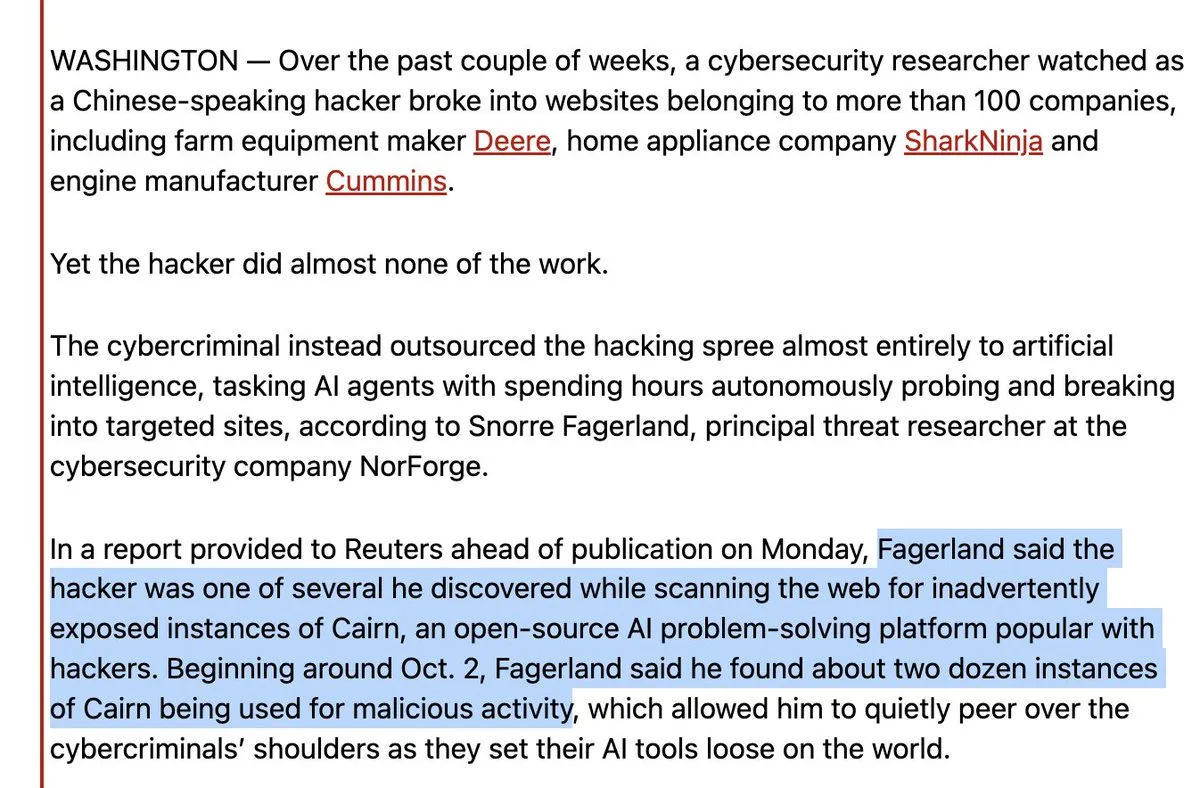
Hacker infiltriert über 100 namhafte Unternehmen mit AI-Token im Wert von nur 5.000 US-Dollar : Medienberichten zufolge hat ein Angreifer mithilfe automatisierter AI-Agenten Angriffsversuche auf mehr als 1.200 Ziele unternommen und erfolgreich die Netzwerkinfrastruktur von über 100 multinationalen Großkonzernen – darunter John Deere und SharkNinja – infiltriert. Die Token-Kosten für die Modellaufrufe beliefen sich während der gesamten Kampagne auf lediglich rund 5.000 US-Dollar. In der Sicherheits-Community sorgt dies für Alarmstimmung: Die Bewaffnung kostengünstiger Angriffsagenten ist Realität geworden, während die automatisierte Abwehr gravierend hinterherhinkt. (Quelle: teortaxesTex, Mononofu)
GhostShares-Sicherheitslücke bei Meta Muse aufgedeckt: Tausende vertrauliche Chats öffentlich einsehbar : Das Sicherheitsforschungsunternehmen Claroc berichtet, dass Metas neuester Flaggschiff-Assistent Muse beim Generieren von Freigabe-Links ein schwaches Entropie-Design aufweist. Dadurch konnten Forscher über passive DNS-Abfragen auf einen Schlag 6.800 unautorisierte, reale Nutzersitzungen auflisten, darunter nicht anonymisierte Geschäftsgeheimnisse und persönliche Identifikationsdaten. Dies widerspricht direkt dem Versprechen des Unternehmens, Privatsphäre von Grund auf zu gewährleisten. (Quelle: Ars Technica)
Musk verspricht Schenkung von SpaceX-Aktien im Wert von 10,5 Milliarden US-Dollar an US-Kinder für 2027 und prägt Konzept des „Universal High Income“ : Als Reaktion auf die Gründung eines gemeinnützigen Fonds durch Anthropic kritisierte Elon Musk die Logik institutioneller Philanthropie und kündigte an, im Jahr 2027 jedem der rund 72 Millionen Minderjährigen in den USA jeweils eine SpaceX-Aktie im geschätzten Gesamtwert von 10,5 Milliarden US-Dollar zu schenken. Musk definierte diesen Vorstoß ausdrücklich als „Universal High Income“ (UHI) anstelle eines klassischen Grundeinkommens (UBI) und argumentierte, dass die Öffentlichkeit angesichts des durch Robotik und AGI verursachten Zusammenbruchs der Grenzkosten direkt an den exponentiellen Erträgen harter Vermögenswerte partizipieren sollte. (Quelle: WeChat, Ronald_vanLoon)
💡 Sonstiges
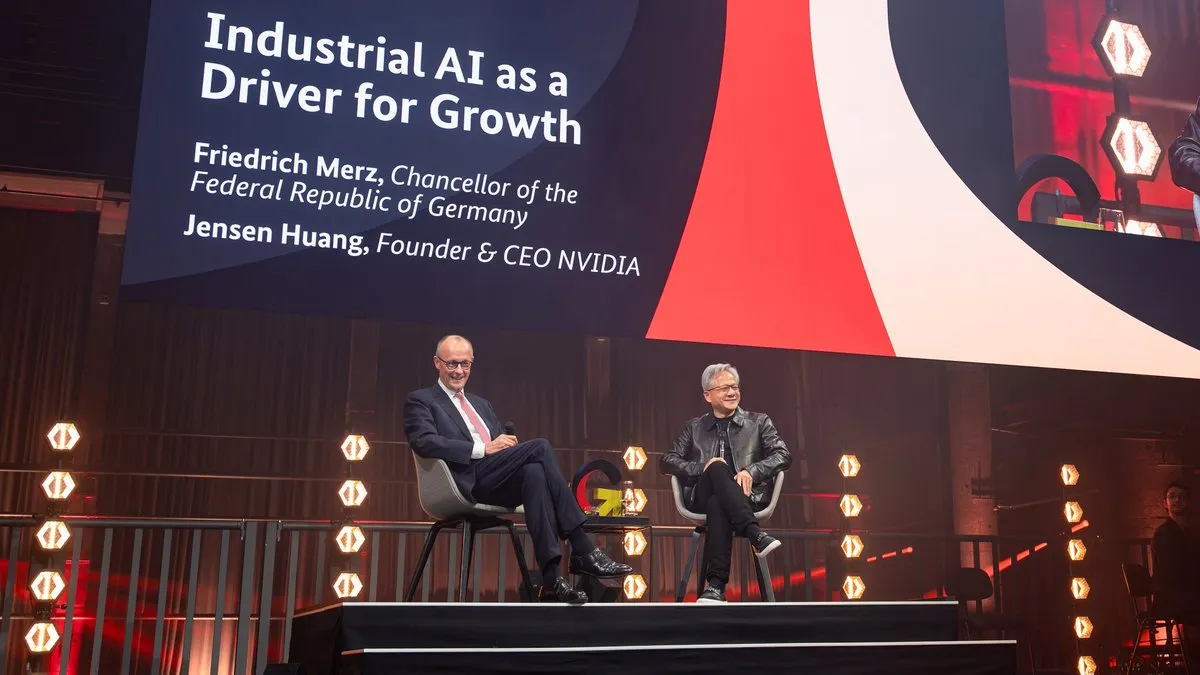
NVIDIA und Bundesregierung starten nationale Initiative für industrielle physische AI : Bundeskanzler Olaf Scholz und NVIDIA-CEO Jensen Huang haben eine gemeinsame Absichtserklärung unterzeichnet, um Daten des deutschen Mittelstands und der Automobilindustrie eng mit physikbasierten AI-Modellen von NVIDIA zu verknüpfen. Siemens-Werke konnten dadurch den Aufwand für die virtuelle Inbetriebnahme neuer Produktionslinien um 85 % senken. Gleichzeitig kündigte NVIDIA verstärkte Direktinvestitionen in Europa an und führt eine Finanzierungsrunde für das heimische Robotik-Startup Agile Robots an. (Quelle: NVIDIA Blog, nvidia)
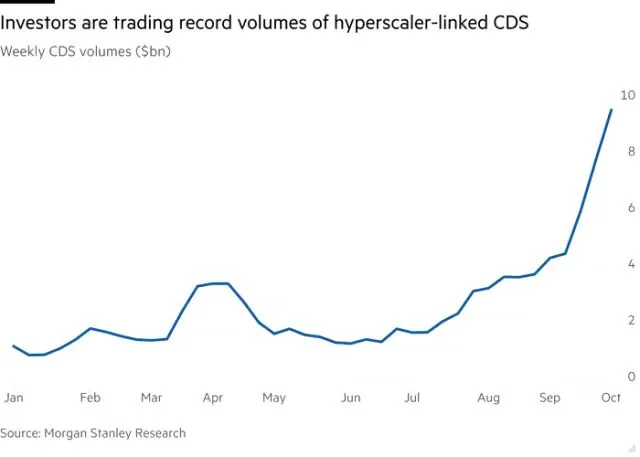
AI-Schuldenrisiken erschüttern Wall Street: Handelsvolumen von Credit Default Swaps (CDS) für Tech-Riesen vervierfacht sich : Angesichts der Risiken durch kreditfinanzierte Rechenzentrumsexpansionen der Tech-Giganten im Umfang von hunderten Milliarden US-Dollar ist das wöchentliche Handelsvolumen von Kreditausfall-Swaps (CDS) auf Oracle, Meta, SpaceX und CoreWeave seit Juli um mehr als das Vierfache angestiegen. Investoren decken sich in einem Tempo mit Kreditausfallversicherungen ein, wie es seit der Subprime-Krise selten zu beobachten war, um sich gegen potenzielle Kettenreaktionen im Bereich der AI-Infrastruktur abzusichern. (Quelle: 36氪)
Notion beendet unbegrenzte AI-Nutzung: Umstellung auf Credit-System und Anbindung externer Konten : Notion hat seine AI-Nutzungsrichtlinien für Business- und Enterprise-Pläne offiziell angepasst: Das unbegrenzte Kontingent wird abgeschafft und durch monatlich 1.500 Standard-Credits sowie 500 Premium-Credits ersetzt. Um Power-User zu entlasten, führt die Plattform erstmals ein BYOK-Modell (Bring Your Own Key) ein, über das Agenten mit dem ChatGPT-Konto der Nutzer verbunden werden können, um externe Kontingente zu nutzen. (Quelle: dotey)