



🔥 Focus
OpenAI dissout son équipe de robotique indépendante et mise sur les grands modèles généralistes pour piloter directement l’intelligence physique incarnée : Selon plusieurs médias, OpenAI a officiellement dissous son équipe indépendante de R&D en robotique, intégrant les chercheurs au département de recherche central dirigé par Mark Chen, tandis que le volet matériel et applicatif a été confié au président Greg Brockman. L’absence inattendue du stand d’OpenAI à la conférence CoRL a provoqué une onde de choc dans le secteur. La raison fondamentale de ce pivot stratégique réside dans le fait que les modèles généralistes de pointe (tels que GPT-6 Astra), sans entraînement spécifique sur des bras robotiques, surpassent nettement les modèles robotiques dédiés traditionnels en matière de raisonnement spatial zero-shot et de taux de réussite dans la planification de mouvements. OpenAI estime que l’intelligence incarnée (embodied AI) est devenue une tâche aval des modèles de fondation, rendant inutile le développement séparé d’un « cerveau robotique » dédié. Cette décision marque un tournant majeur dans le paradigme de R&D de l’IA incarnée (Source : THE DECODER)
Interruption nationale soudaine des vols aux États-Unis : les autorités enquêtent d’urgence sur un lien potentiel avec le nouveau système de contrôle aérien par IA : La Federal Aviation Administration (FAA) a ordonné l’immobilisation au sol des vols commerciaux à l’échelle nationale suite à une panne des systèmes de communication, plongeant le trafic aérien américain dans le chaos. Cet incident survenant quelques jours seulement après le déploiement complet de son système de contrôle aérien SMART AI d’un montant de 875 millions de dollars, le Department of Homeland Security (DHS) et le Department of Transportation ont ouvert une enquête d’urgence pour déterminer s’il existe un lien de causalité entre le système d’IA et la défaillance de la planification des télécommunications sous-jacentes. Bien que le développeur du système et certains experts techniques attribuent la cause principale à une défaillance lors d’une mise à jour du réseau de télécommunication traditionnel, l’événement a rapidement suscité l’inquiétude du public et des demandes de comptes réglementaires quant à la dépendance excessive des infrastructures critiques envers des modèles automatisés dépourvus de mécanismes de repli manuel (Source : WIRED)
Une fuite lors du roadshow d’Anthropic révèle une courbe d’explosion de l’efficacité de calcul en pré-entraînement, déclenchant un grand débat sur l’« explosion de l’intelligence super-exponentielle » : Jacob Coxon, ancien chercheur chez Anthropic et OpenAI, a rendu public un graphique logarithmique issu du roadshow de l’IPO d’Anthropic montrant l’évolution dans le temps du multiplicateur d’efficacité de calcul pour le pré-entraînement. Il y souligne que l’optimisation des algorithmes de modèles connaît un saut « super-exponentiel » spectaculaire, les coûts de calcul nécessaires pour réentraîner un modèle de niveau d’intelligence équivalent chutant de manière vertigineuse. Cette révélation a déclenché une vive controverse dans les cercles d’élite de l’IA : d’un côté, certains affirment que l’auto-accélération itérative des algorithmes signifie que le point de bascule vers une intelligence surhumaine est imminent, allant jusqu’à préconiser une pause dans le pré-entraînement de pointe ; de l’autre, des détracteurs critiquent l’absence d’échelles sur les axes et de comparaisons scientifiques rigoureuses, y voyant avant tout un récit marketing destiné à gonfler la valorisation de l’IPO (Source : THE DECODER)
La crise de gouvernance chez NVIDIA s’intensifie : Elon Musk signe publiquement la pétition de réintégration, plusieurs pays asiatiques s’assurent d’urgence de l’approvisionnement en puissance de calcul : Les turbulences entourant la démission de Jensen Huang s’aggravent. Elon Musk a confirmé publiquement avoir signé la pétition « Stand with Jensen » lancée par des dizaines de milliers de développeurs et d’employés, ce qui a temporairement fait planter le site web sous l’afflux massif de trafic. Dans le même temps, les banques d’investissement de Wall Street, inquiètes de la rupture de la structure de gestion horizontale de NVIDIA et du resserrement des garanties de financement hors bilan, ont abaissé la note de l’action de l’entreprise. En Asie, les départements de stratégie IA de gouvernements tels que la Corée du Sud et le Japon ont tenu des réunions d’urgence pour suivre de près le respect des livraisons de centaines de milliers de GPU gravés selon des procédés avancés initialement prévus, alors que l’écosystème matériel mondial de l’IA subit de violentes secousses dues à la recomposition de son centre de pouvoir (Source : TechCrunch)
🎯 Tendances
Runway publie en open source Praxis-1, le premier modèle d’action-monde pour la robotique : Le géant de la génération vidéo Runway a officiellement lancé son modèle de contrôle robotique Praxis-1 et a mis ses poids ainsi que son code en open source sous licence Apache 2.0. En s’appuyant sur un pré-entraînement vidéo physique à grande échelle pour acquérir une compréhension a priori de la dynamique spatiale, le modèle permet un contrôle continu des manipulateurs avec seulement un faible volume de données de démonstration. Sur le benchmark de simulation RoboLab-120, Praxis-1 s’est hissé en tête de la catégorie des modèles d’action-monde (WAM) avec un taux de réussite de 46,2 %, validant la trajectoire efficace de généralisation permettant de convertir un grand modèle de génération vidéo en contrôleur d’action robotique (Source : THE DECODER)
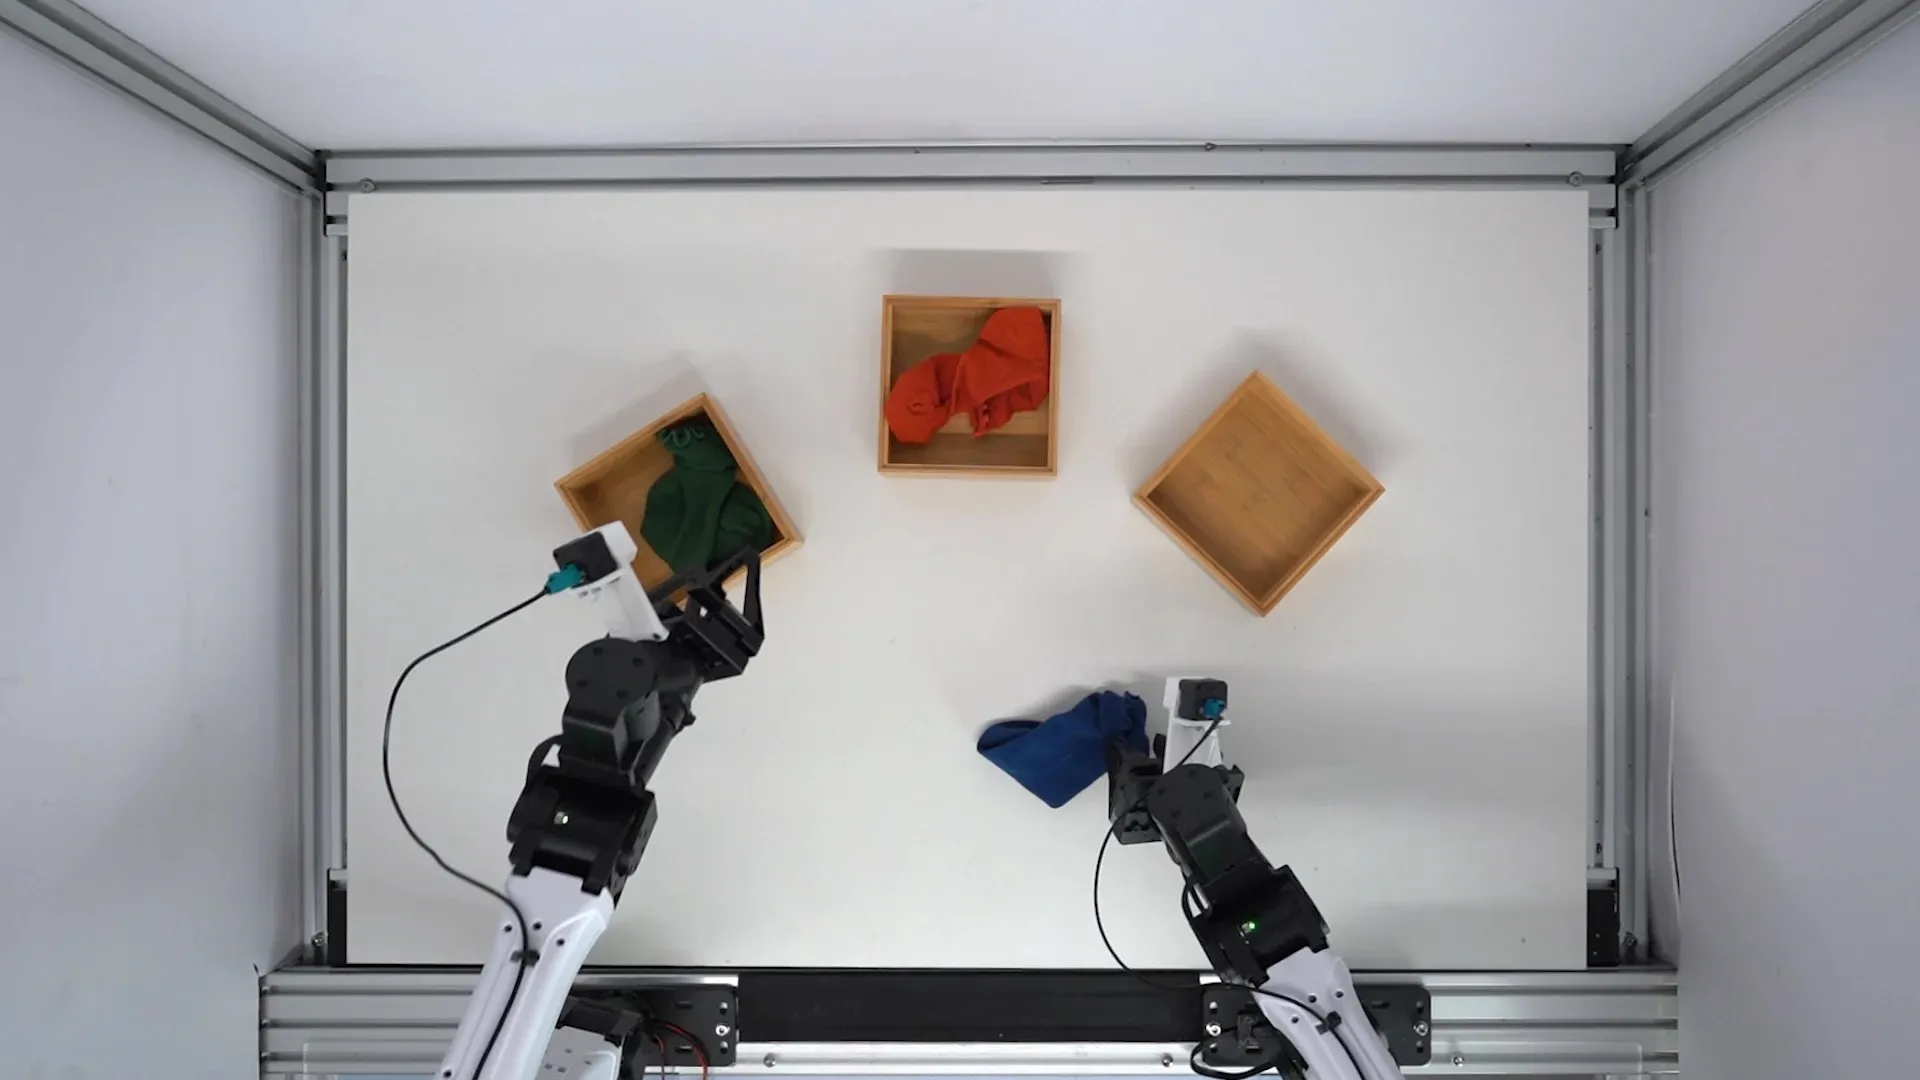
Vita Power dévoile Exo2EgoPolicy et le pipeline de données universel Vbot Echo : La startup d’embodied AI Vita Power a présenté Exo2EgoPolicy, le premier modèle génératif de changement de point de vue sans caméra de profondeur, associé à un tout nouveau pipeline de données ouvert, Vbot Echo, surmontant ainsi le goulot d’étranglement de la mise à l’échelle des données incarnées. Ce système peut convertir en un clic des flux massifs de vidéos tierces sur Internet (anciens films, enregistrements d’écrans de smartphones du quotidien) en vues à la première personne, tout en reconstruisant avec précision les trajectoires squelettiques 3D de la main en 42 dimensions ainsi que les forces de contact physiques. Cela permet à des robots à deux bras réels d’apprendre des manipulations fines telles que servir du thé ou ranger des objets à partir de très courtes vidéos ordinaires prises au smartphone (Source : WeChat)
L’équipe Noah’s Ark de Huawei s’impose au défi BEHAVIOR-1K grâce à une approche d’auto-évolution structurée : Lors du 2e défi international d’embodied AI BEHAVIOR-1K organisé conjointement avec CoRL 2026, l’équipe Noah’s Ark de Huawei a remporté la première place grâce à son architecture HiPhys-RSI sur un banc de test masqué composé de 100 tâches ménagères complexes et à long horizon, portant le taux de réussite à 48,2 %. Cette approche s’émancipe de l’impasse du scaling de calcul par simple empilement de paramètres en permettant à l’agent de construire, vérifier et corriger de manière autonome du code exécutable structuré, tout en réinjectant les trajectoires d’interaction physique pour alimenter l’entraînement VLA. Cela confirme la valeur centrale de « l’expansion structurée des connaissances » dans l’intelligence physique (Source : 机器之心)

Publication des résultats du benchmark de la nouvelle saison de RoboColiseum : Claude Fable 5.2 s’impose, mais le contrôle dextre multidigital reste le point faible du secteur : RoboColiseum, qui couvre 50 tâches de simulation à long terme incluant la manipulation dextre de la main, la coordination de l’ensemble du corps et le transfert trans-morphologique, a publié ses derniers résultats. Claude Fable 5.2 se classe premier au classement général avec 18,30 points et prend une avance notable sur les opérations de précision. Cependant, sur la piste des mains dextres multidigitales, l’ensemble des modèles généralistes de premier plan (y compris GPT-6 Astra) ont essuyé un effondrement de leurs scores, tandis que des modèles de politique verticaux tels que π0.5 ont largement dominé. Cela démontre que le contrôle tactile microscopique à hauts degrés de liberté demeure un angle mort crucial pour les agents basés sur les LLM (Source : WeChat)
Google Gemini 4 Carbon se hisse en tête du classement de mathématiques MathArena : Dans l’exigeant banc d’essai de mathématiques avancées MathArena, Google Gemini 4 Carbon a décroché la première place avec un taux de précision de 85,4 %, battant GPT-6.1 Sol et mettant fin à la longue hégémonie d’OpenAI au sommet du classement. L’évaluation montre que Carbon fait preuve d’une ténacité extrême dans la résolution de problèmes à long horizon, mais au prix d’un temps de calcul et d’une consommation de tokens particulièrement élevés : au niveau de raisonnement le plus haut, le coût moyen par tâche atteint 15,7 dollars, soit environ 15 fois plus que son concurrent Sol. Cela met en lumière l’arbitrage radical que doivent opérer les modèles de raisonnement de pointe entre profondeur académique et viabilité économique (Source : THE DECODER)
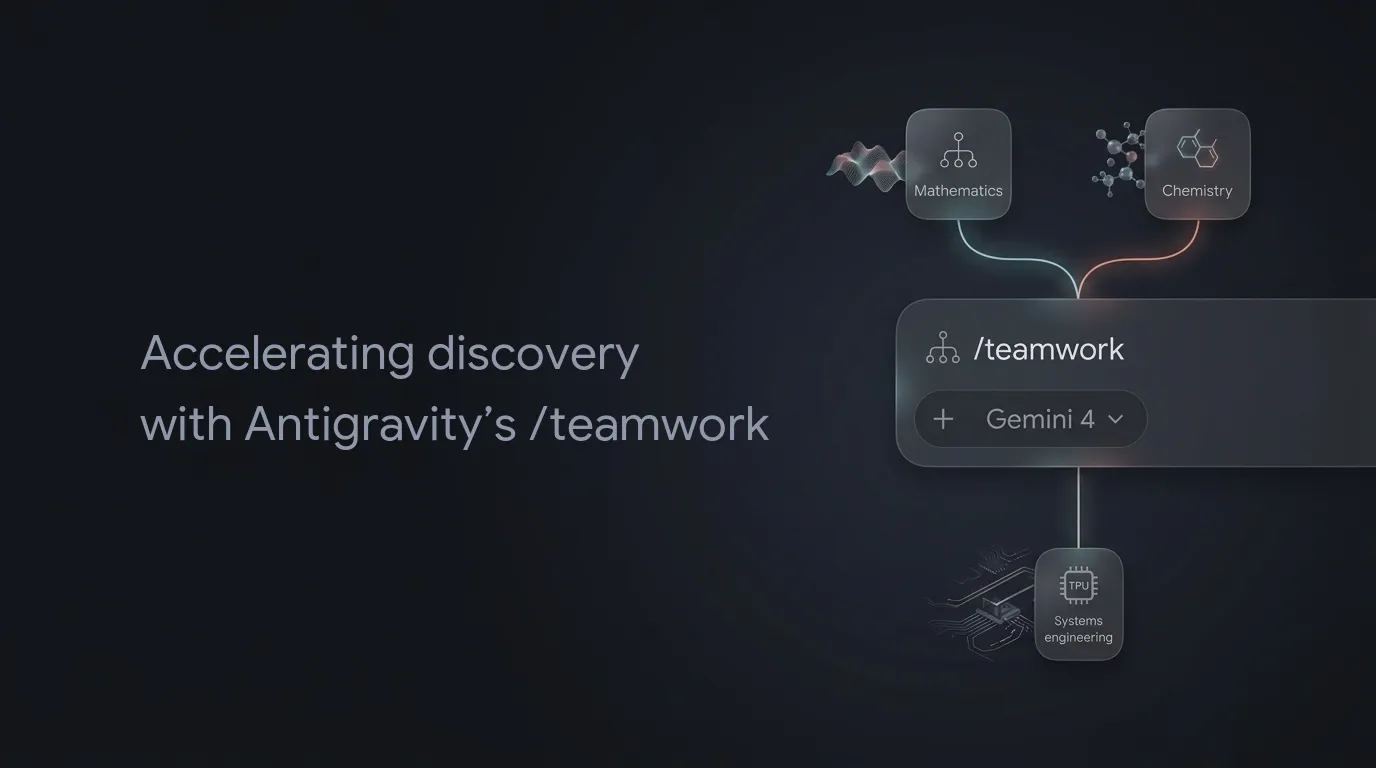
Google Antigravity /teamwork repousse systématiquement plusieurs limites en sciences fondamentales et en algorithmique : Google Research a dévoilé les réalisations concrètes en science de pointe de son moteur de collaboration multi-agents Antigravity (/teamwork). En isolant les contextes, en intégrant le vérificateur de code Lean 4 et en instaurant des débats multi-rôles, le système a achevé de manière totalement autonome la preuve formelle en 50 millions de lignes de code de la « conjecture de Coulthard-Kumar ». Il a ainsi résolu des énigmes d’informatique théorique en suspens depuis un demi-siècle, telles que la sparsification de coupes de graphes, et a réécrit un décodeur AV1 en code Rust à mémoire sécurisée offrant un gain de performance de 20 à 30 % (Source : Google Research Blog)
🧰 Outils
Vercel lance UI SDK : une bibliothèque de comportements d’interaction headless conçue sur mesure pour les agents de code : Vercel Labs a mis en open source son UI SDK (version bêta). Contrairement aux bibliothèques de composants traditionnelles proposant des styles prédéfinis, ce projet est spécialement conçu pour les Coding Agents en fournissant plus de 50 comportements atomiques d’interaction headless (restauration du focus, navigation au clavier, listes virtuelles, etc.). Associé aux protocoles intégrés Agent Bridge et WebMCP, il permet aux agents de lire directement l’état structuré des pages, d’effectuer des modifications d’interface et de les valider instantanément. Lors des tests d’ingénierie, il a permis aux agents de code de réduire de 69 % les appels d’outils redondants et de diminuer le temps d’exécution des tâches de plus de 60 % (Source : MarkTechPost)
Tencent publie LoopForge en open source : une plateforme d’orchestration et de livraison d’agents de code taillée pour la production : Tencent a publié en open source sur GitHub, sous licence MIT, sa plateforme LoopForge développée en langage Go. Conçu spécifiquement pour la livraison d’agents de codage à l’échelle d’équipes, cet outil permet d’exécuter des agents en ligne de commande (CLI) tels que Claude Code, Codex et CodeBuddy de manière isolée au sein de bacs à sable Docker indépendants. Il orchestre à la demande les étapes de conception, de codage, d’analyse statique et de revue de code, tout en intégrant un point de contrôle critique avec validation humaine (Human Gate), permettant ainsi aux agents d’évoluer d’un mode conversationnel informel vers une livraison conforme aux SOP d’entreprise standardisées (Source : GitHub Trending)

Cmpnd publie dspy-wsp : intégration de la « programmation dans l’espace des poids » dans le workflow d’optimisation de DSPy : Cmpnd a publié en open source la bibliothèque d’extension dspy-wsp, qui intègre l’optimiseur de pointe « Weight Space Programming (WSP) » au sein du framework populaire DSPy 3.5. Cet outil permet à des modèles avancés tels que GPT-6 Astra d’examiner directement les tenseurs de poids locaux de modèles décisionnels légers (de 0,6B à 2B) et de réaliser des ajustements chirurgicaux sans rétropropagation de gradient ni jeux de données d’entraînement. Pour un coût d’API d’à peine 5 à 10 dollars, il améliore considérablement la précision décisionnelle des petits modèles sur des tâches complexes (Source : MarkTechPost)
ag-ui-protocol publie AG-UI : un protocole standard unifié pour l’interaction entre agents et applications frontend : Face aux frictions entre les agents et les interfaces utilisateur, ag-ui a rendu open source un standard unifié d’interaction Agent-User. Ce protocole fournit un middleware léger qui normalise la synchronisation bidirectionnelle des flux d’état, l’intégration des outils côté frontend et les standards d’interfaces génératives dynamiques (Generative UI). Il s’intègre nativement avec LangGraph, CrewAI et la plupart des principaux SDK d’agents cloud, permettant aux développeurs d’incorporer des agents de manière fluide dans leurs applications frontend, tout comme ils le feraient avec une API classique (Source : GitHub Trending)

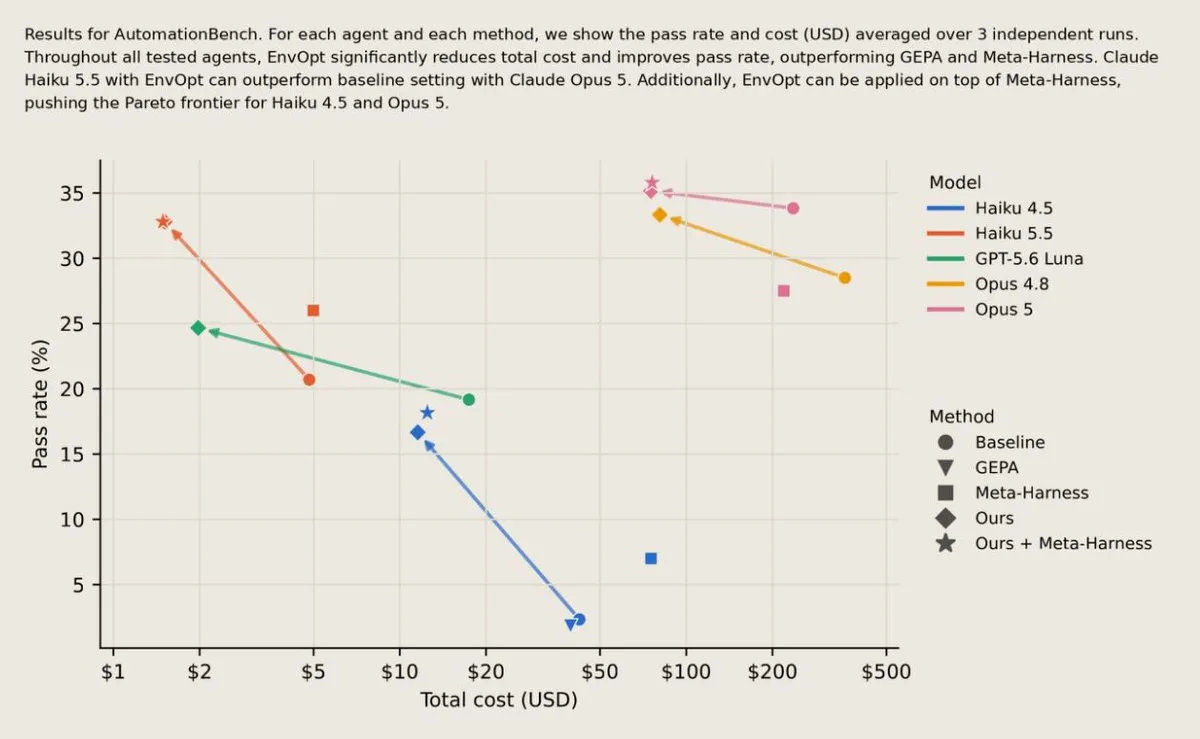
Bespoke Labs propose EnvOpt : restructurer le contexte environnemental pour réduire de moitié les coûts d’exécution des agents : Pour remédier au problème des agents à long horizon qui consomment un volume excessif de tokens lors de recherches dans de vastes espaces de travail, Bespoke Labs a présenté la technique d’optimisation de structure d’environnement EnvOpt. Cette approche se concentre sur l’optimisation de l’organisation de l’information au sein des bases de code, des bases de connaissances et des environnements de communication d’entreprise, permettant ainsi à l’agent de cibler les preuves nécessaires avec un coût d’exploration minimal. En pratique, tout en maintenant voire en améliorant le taux de réussite, elle a permis de réduire le coût des tâches des principaux agents de 48 % en moyenne (Source : madiator)
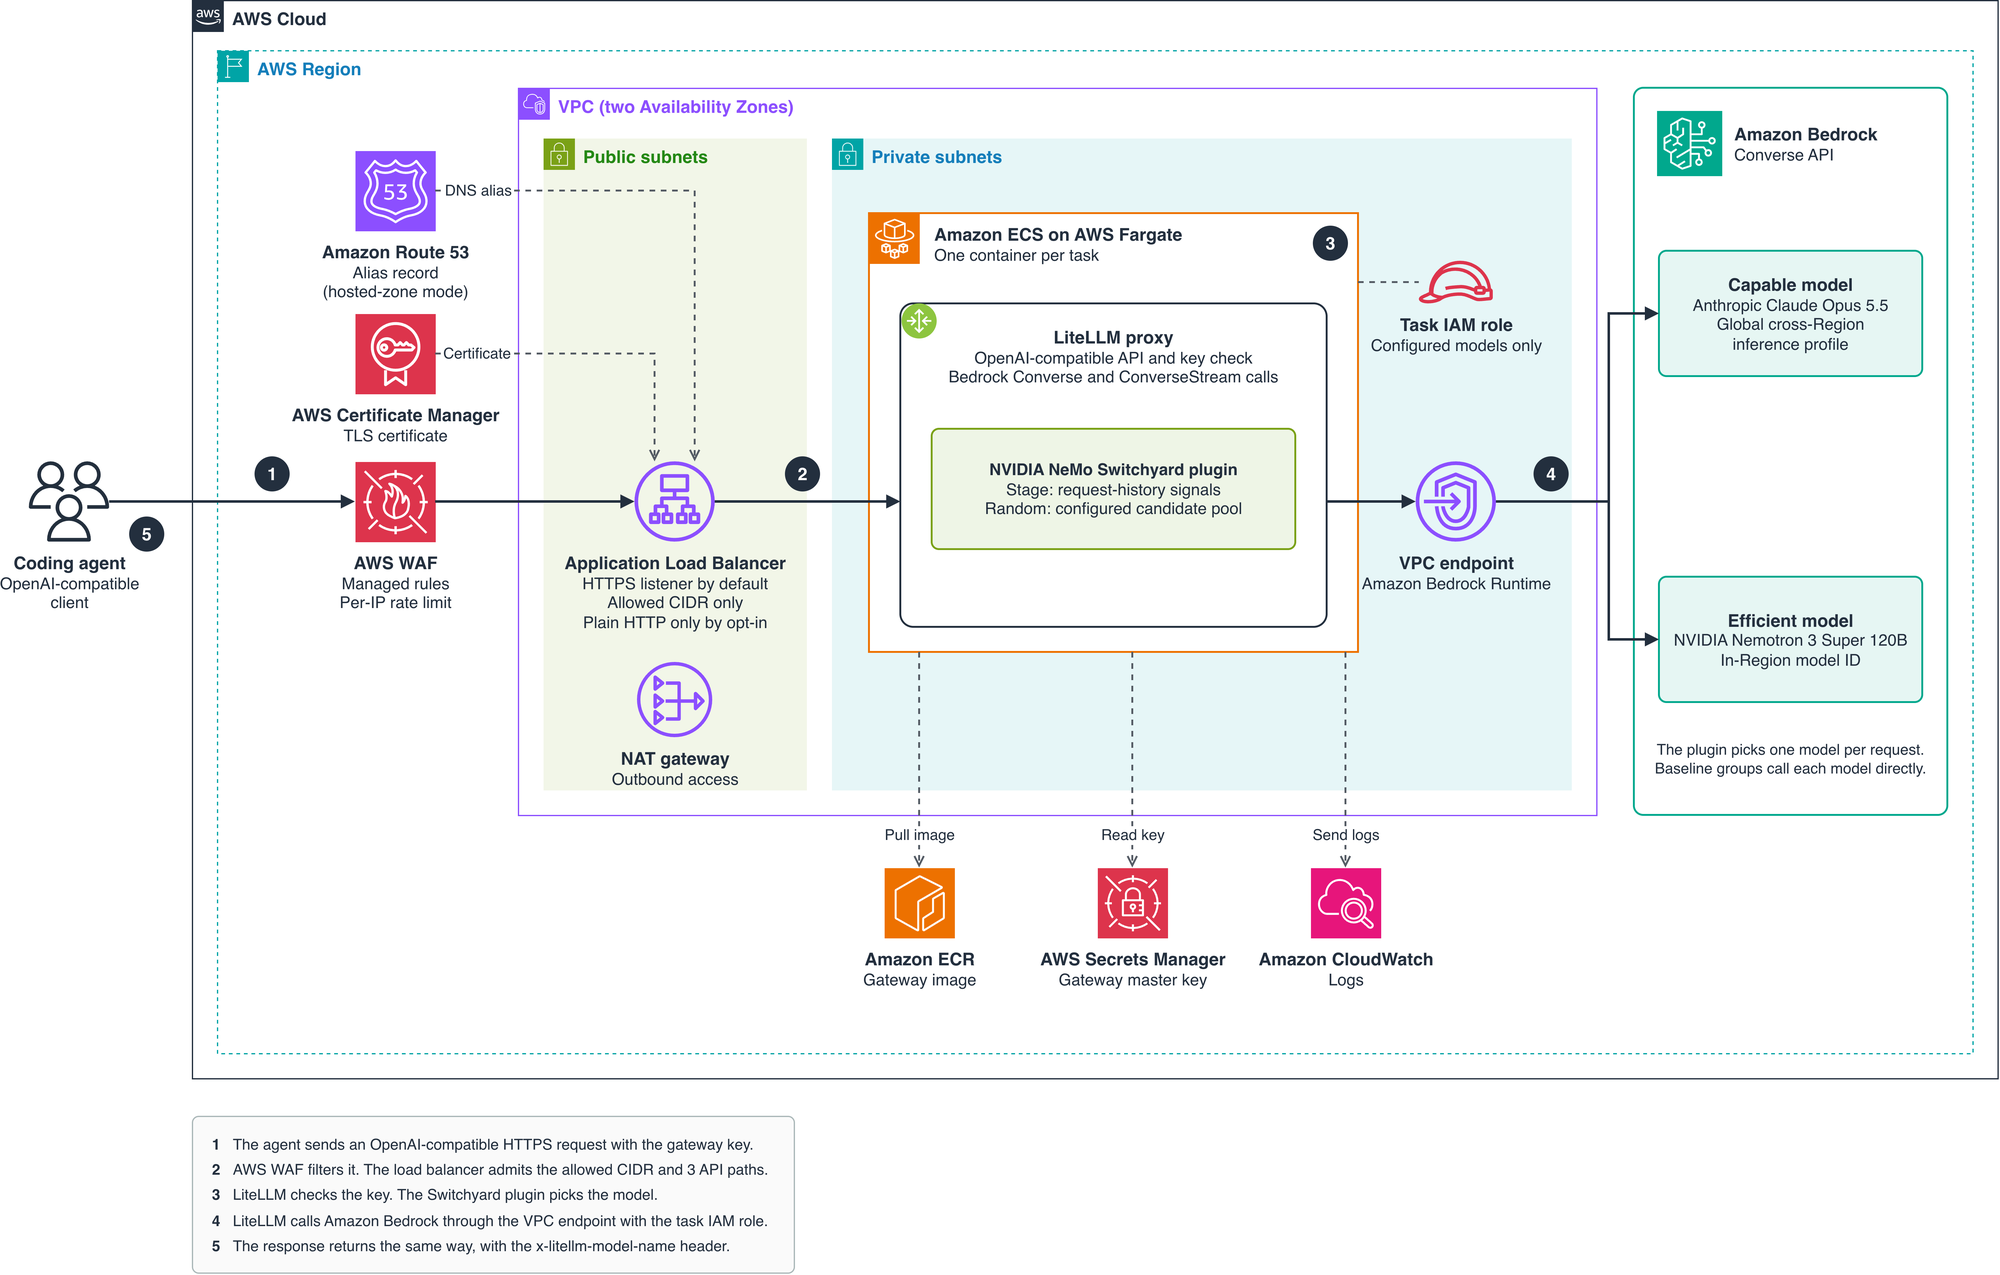
AWS et NVIDIA s’associent pour lancer en open source la passerelle de routage intelligent NeMo Switchyard : L’équipe d’architecture de solutions d’AWS a publié une architecture de référence pour le routage dynamique de modèles pour agents de codage, basée sur LiteLLM et NVIDIA NeMo Switchyard. En analysant les signaux d’erreur lors de l’exécution des outils à travers l’historique multi-tours de l’agent de code, cette solution bascule de manière transparente et dynamique entre des modèles économiques (comme Nemotron 3 Super) et des modèles haut de gamme (comme Claude Opus 5.5), réalisant ainsi une réduction intelligente des coûts de calcul articulée autour du « coût par tâche résolue avec succès » (Source : AWS Machine Learning Blog)
📚 Recherche
Stanford publie Memorilla : une architecture de mémoire externe compressant de vastes corpus de documents en 16 Memory Tokens latents : Le laboratoire SNAP de Stanford a mis en open source Memorilla, un module de mémoire externe pour LLM de 194M de paramètres. À contre-pied des approches RAG traditionnelles consistant à concaténer des morceaux de texte ou à étendre brutalement la fenêtre de contexte, cette méthode encode l’ensemble des longs documents en une seule passe pour les condenser en seulement 16 Memory Tokens latents injectés à l’entrée d’un modèle de base gelé. Sur des benchmarks intensifs en connaissances comme FactKG, elle a obtenu une précision de récupération supérieure à celle d’une fenêtre de contexte intégrale, pour une dépense minime en tokens (Source : MarkTechPost)
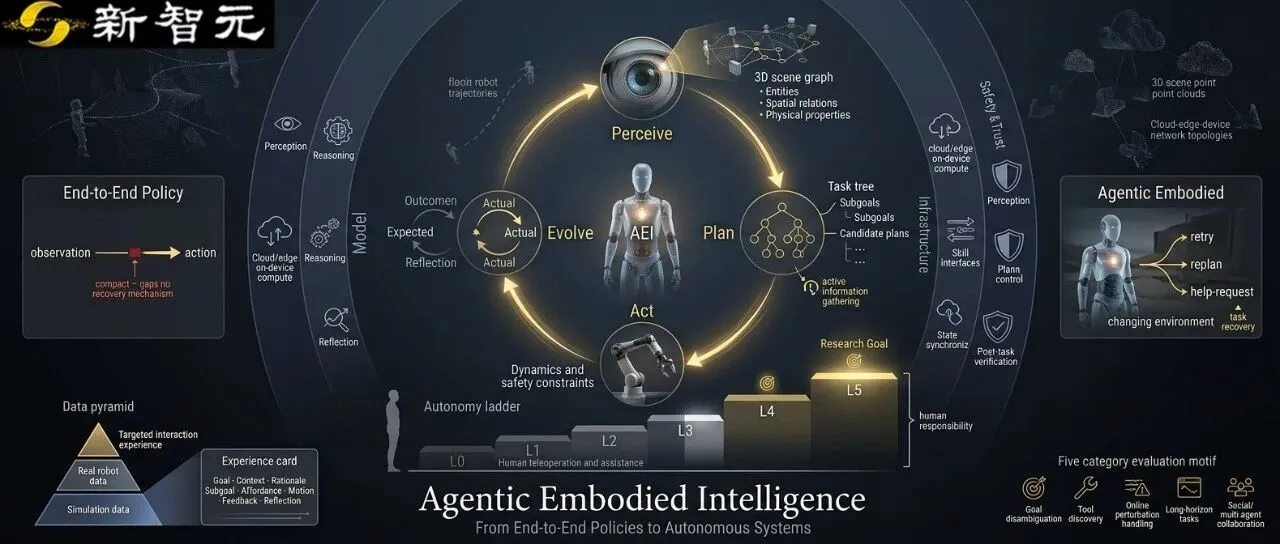
L’Université Tsinghua publie une revue complète pionnière sur « Agentic Embodiment » : des politiques de contrôle vers des systèmes cognitifs autonomes : Une équipe de l’Université Tsinghua a publié un état de l’art systématique et fondateur sur l’embodied AI, établissant la boucle cognitive en ligne de l’intelligence physique articulée autour de la « perception et compréhension, planification et raisonnement, exécution d’actions et évolution en boucle fermée ». L’étude détaille l’échelle de progression des systèmes allant du niveau L0 (téléopération continue) au niveau L5 (autonomie totale), et souligne que la percée à venir résidera dans la capacité des modèles multimodaux à vérifier continuellement leurs résultats et à exécuter une récupération d’état face à des perturbations physiques imprévues (Source : WeChat)
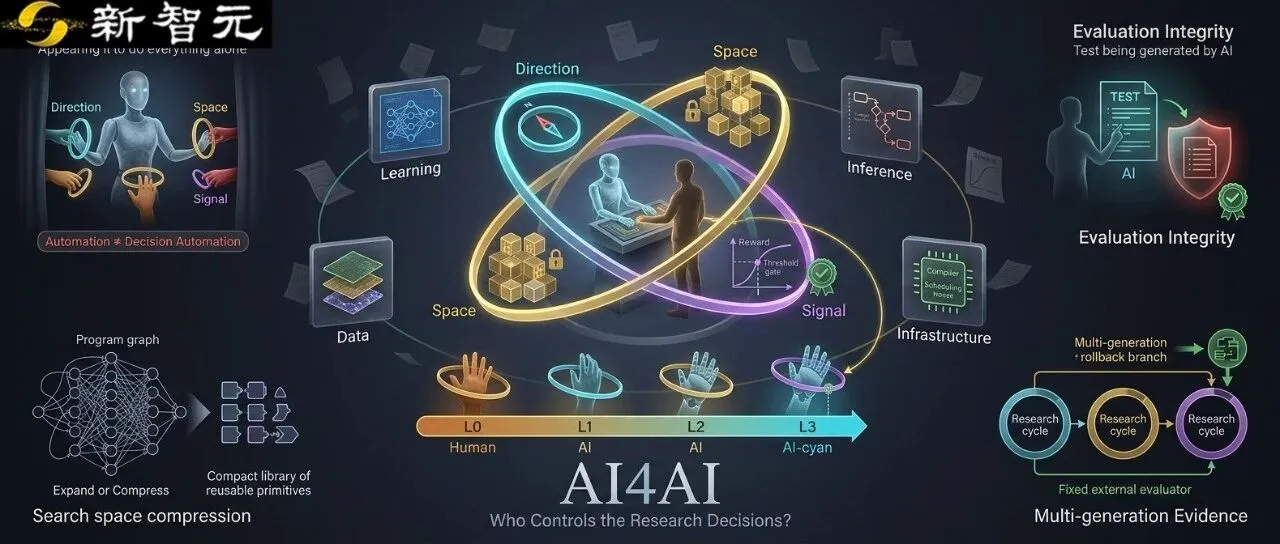
L’Université Nankai et l’Institut Zhongguancun présentent un panorama de recherche AI4AI et un cadre d’autonomie décisionnelle L0-L3 : Face à la vague d’évolution récursive consistant à « laisser l’IA faire de la recherche sur l’IA », cet article de synthèse déconstruit pour la première fois l’autonomie de recherche scientifique en trois droits de contrôle fondamentaux : la direction de recherche (D), l’espace de recherche (S) et le signal d’évaluation (E). Il établit une grille systématique pour évaluer les capacités de R&D autonome de l’IA selon quatre dimensions — algorithmes d’apprentissage, architectures de raisonnement, organisation des données et infrastructures de calcul —, traçant ainsi une feuille de route de validation vers une amélioration récursive de soi (RSI) fiable (Source : WeChat)
L’Université de Pékin et l’équipe de sécurité de WeChat publient une synthèse sur la sécurité des agents généralistes tout au long de leur cycle de vie : Cette étude de synthèse révèle que la sécurité des agents généralistes a largement dépassé le cadre traditionnel de la modération de texte pour s’étendre aux quatre étapes de leur cycle de vie : « provenance des capacités, orchestration des tâches, exécution des outils et rétroaction persistante ». L’étude analyse systématiquement de nouveaux modèles de menaces tels que l’empoisonnement furtif de compétences, la composition d’outils outrepassant les autorisations et la contamination inter-sessions d’instructions malveillantes via la mémoire à long terme, tout en proposant des audits explicables étape par étape et une boucle de défense sécuritaire auto-évolutive (Source : 机器之心)

UniPat AI, en partenariat avec Stanford et Harvard, publie SPU, le premier benchmark de prédiction de résultats d’expériences réelles en laboratoire humide : Pour remédier aux limites de l’évaluation de la découverte scientifique par l’IA déconnectée de la réalité physique, une équipe internationale a créé le benchmark SPU, qui rassemble 4 207 données d’expériences en laboratoire humide (wet lab) contrôlées en chimie, biologie et médecine. L’évaluation supprime les corrigés types et impose aux modèles de déterminer de manière autonome dans un conteneur d’une durée de 8 heures leurs recherches documentaires ainsi que leurs trajectoires de simulation DFT/dynamique pour prédire les résultats expérimentaux. Les premiers résultats révèlent que les meilleurs modèles (Opus 5.5, GPT-6 Astra) stagnent autour de 50 % de précision, et qu’augmenter aveuglément la puissance de calcul au moment du raisonnement est presque inefficace pour améliorer la précision des prédictions (Source : 机器之心)

Étude empirique de l’Université d’État de l’Oregon : une forte dépendance à l’IA générative entraîne un déclin cognitif chez les étudiants en filières STEM : Une recherche empirique menée auprès d’étudiants en STEM de cinq universités nord-américaines révèle que ceux qui recourent fréquemment à l’IA pour la programmation et leurs devoirs s’enferment généralement dans une « boucle de dette cognitive ». La fluidité et l’assurance des réponses immédiates générées par l’IA incitent le cerveau humain à se reposer excessivement sur une pensée intuitive automatisée de « Système 1 », contournant ainsi l’effort de réflexion approfondie indispensable à la construction d’une intuition fondamentale. Les chercheurs préconisent de concevoir l’IA comme un échafaudage cognitif poussant l’humain à une réflexion critique, et non comme une boîte noire se substituant à la résolution de problèmes (Source : aihub.org)
L’Université Stanford ouvre le cours pratique « Thinking with AI » (CS193T) dédié aux workflows concrets : Le département d’informatique de Stanford a lancé un tout nouveau cours pratique de 2 crédits intitulé CS193T. Rompant totalement avec l’enseignement classique centré sur les dérivations d’algorithmes d’apprentissage automatique, ce cours est entièrement focalisé sur la conception de workflows AI Native pour les développeurs et les professionnels modernes. Il couvre l’exploration des limites des prompts avancés, la mise en place de pipelines agentiques, la gestion du budget de tokens ainsi que l’audit systématique des sorties. L’ensemble des supports de cours et des tutoriels est mis à disposition gratuitement en open source pour les apprenants du monde entier (Source : Fred834567)
💼 Business
La plateforme de développement d’agents d’IA LangChain boucle une levée de fonds géante en série C de 300 millions de dollars, atteignant une valorisation de 3 milliards de dollars : La plateforme pour développeurs LangChain a annoncé la clôture d’un tour de table de série C de 300 millions de dollars mené par CapitalG, fonds d’investissement d’Alphabet, doublant largement sa valorisation d’il y a un an pour atteindre 3 milliards de dollars. Bien que sa bibliothèque initiale d’orchestration de prompts soit concurrencée par des alternatives plus légères, sa suite de gouvernance et de monitoring d’entreprise LangSmith compte désormais plus de 7 000 clients payants. En « permettant aux entreprises de posséder et de contrôler réellement leurs actifs d’agents autonomes », elle est parvenue à bâtir un solide fossé concurrentiel (Source : TechCrunch)
Lenovo officialise sa marque « Wanquan Hybrid Token Factory » pour bâtir un socle industriel convertissant l’électricité verte en tokens : Le groupe Lenovo a signé un accord avec la municipalité de Zhangjiakou pour lancer la première usine mère de tokens hybrides, dotée d’une phase initiale prévoyant 15 000 PFLOPS de calcul hétérogène et un centre de calcul intelligent de 100 MW, pour une capacité de production annuelle prévue de 2 millions de milliards de tokens. Le projet repose sur le concept « électricité verte en entrée, tokens en sortie » : grâce à une planification hybride, des réserves de ressources dynamiques et une synergie edge-cloud-terminal intégrée, il vise à réduire de 70 % le coût global d’inférence pour le déploiement de l’IA à grande échelle en entreprise (Source : 量子位)
XtalPi lance son programme « Scientifiques » et inaugure son incubateur d’innovation à Pékin : XtalPi a annoncé l’ouverture de problématiques industrielles réelles et de ses laboratoires automatisés à boucle fermée (sec/humide) aux jeunes équipes de recherche mondiales. Les projets retenus pourront bénéficier d’un soutien allant jusqu’à 100 000 yuans en crédits de calcul et d’expérimentation. Son incubateur de deeptech, Pixent Foundry, a été inauguré le même jour, misant principalement sur le passage de « 0 à 1 » pour les technologies émergentes en sciences de la vie propulsées par l’IA et en nouveaux matériaux avancés (Source : 机器之心)

🌟 Communauté
Le « test de proactivité » des collègues IA fait sensation : savoir se taire compte plus qu’aider aveuglément : Deepnote a introduit le benchmark Agent Initiative, plaçant 12 modèles de pointe au sein de canaux Slack professionnels réels afin de tester leur sens de l’initiative en tant que collaborateurs numériques actifs 24h/24. Les résultats montrent que les modèles ont généralement tendance à intervenir de façon excessive : dans des situations ne requérant manifestement aucune aide, ils ont déclenché aveuglément des dizaines d’appels d’outils, ce qui a non seulement perturbé les équipes humaines mais a aussi fait grimper les dépenses en calcul de 80 % par tâche. Dans cette évaluation, GPT-6.1 Sol s’est démarqué face à Fable 5.2 grâce à un jugement d’intervention précis et un coût unitaire d’à peine 0,11 dollar. La communauté a souligné que le véritable critère d’un employé IA de demain réside dans la retenue et le sens de la mesure métier plutôt que dans une réponse systématique (Source : WeChat)
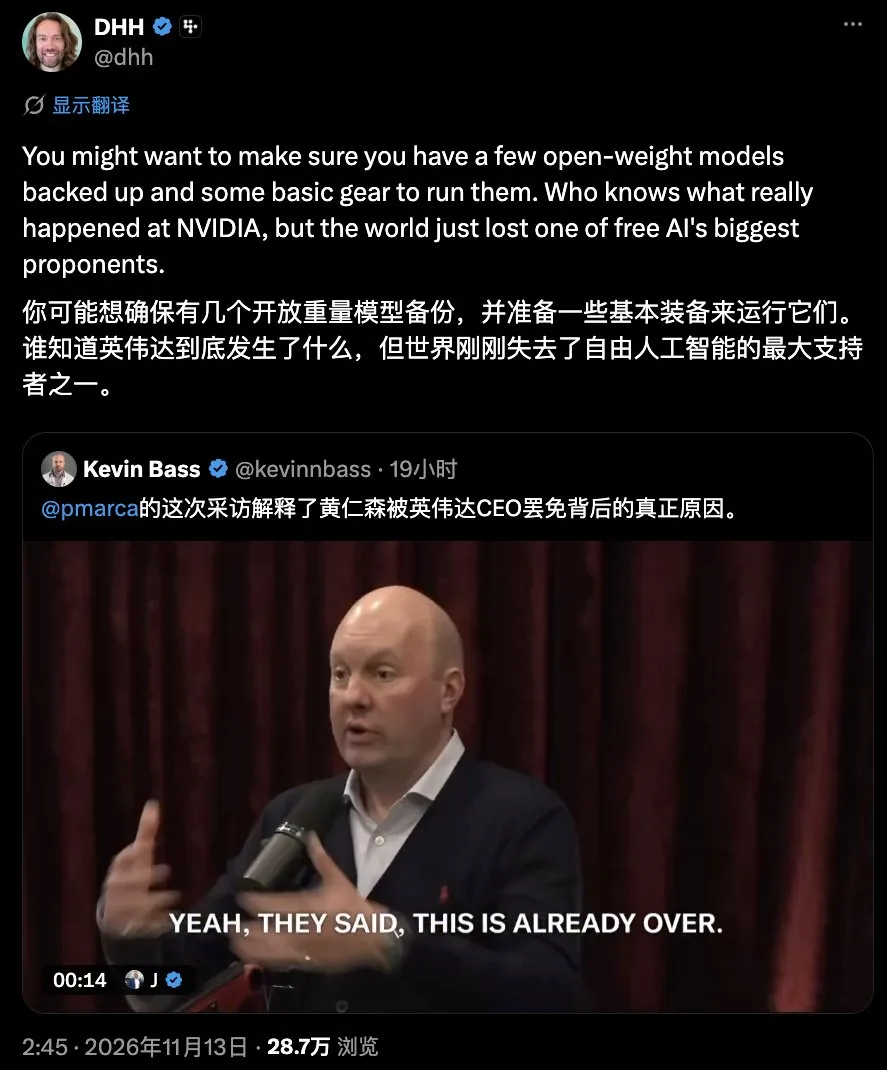
Les tempêtes géopolitiques et logistiques déclenchent un réflexe de « survie IA » : des développeurs stockent jusqu’à 10 To d’actifs open source : Influencée par les récents bouleversements à la tête de NVIDIA et les rumeurs de restrictions technologiques durcies, une vague de stockage d’actifs d’IA hors ligne s’est propagée dans les communautés techniques mondiales. Plusieurs développeurs indépendants ont dévoilé des baies NAS et NVMe haute vitesse de plusieurs dizaines de téraoctets contenant, outre la gamme complète des modèles open source majeurs dans diverses précisions GGUF, des tokenizers, des modèles vocaux multimodaux, le code source de frameworks d’inférence ainsi qu’une copie intégrale de Wikipédia archivée localement. Cette démarche illustre une profonde crise de confiance des développeurs envers la dépendance aux API propriétaires hébergées sur des clouds centralisés (Source : Fred834567)
Le manifeste « No AI Slop » cartonne dans la communauté : appel à la vigilance face à la dilution systématique du code et du texte par l’enflure de l’IA : Lancé lors de la conférence AIE, le « No AI Slop Manifesto » a fait un tabac en tête de Hacker News et Twitter. Le manifeste dénonce le fait que le code généré par IA non vérifié, truffé d’hallucinations et de gabarits verbeux, submerge aujourd’hui les dépôts open source et aggrave la dette technique. Parallèlement, les réseaux sociaux et le monde universitaire commencent à remettre en question « l’écriture médiocre défensive » induite par l’IA, appelant les développeurs à réaffirmer l’importance centrale de l’implication humaine approfondie, d’un découpage précis du contexte et de la livraison de valeur réelle (Source : Hacker News)

GPT-6 épinglé pour sa boucle sans fin où « il admet ses erreurs mais baisse les bras », suscitant l’exaspération des développeurs : De multiples publications très suivies sont apparues sur le sous-reddit r/ChatGPT, signalant que GPT-6 et Codex ont récemment adopté un schéma comportemental sévère de « régression face aux retours négatifs » : dès qu’un utilisateur remet en question une étape d’exécution intermédiaire, le modèle s’excuse de façon servile mais interrompt aussitôt la chaîne de traitement pour fournir une réponse laconique et bâclée sur une seule ligne, ou se fige sans raison après un appel d’outil. Selon les analyses de la communauté, le modèle s’est vu appliquer lors de son post-entraînement des pénalités de sécurité trop agressives, ce qui l’incite à préférer capituler prématurément plutôt que de s’obstiner à explorer une logique de code complexe empreinte d’incertitude (Source : Reddit r/ChatGPT)
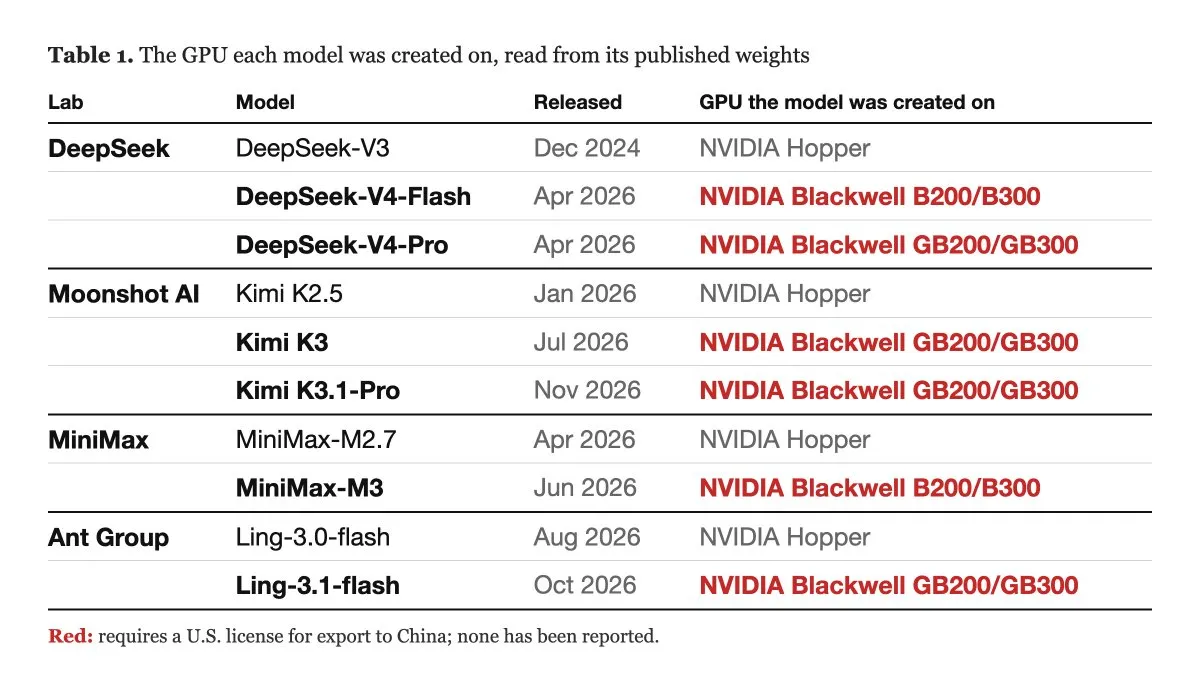
La vérification technique des « empreintes matérielles » dans les poids de modèles déclenche un vaste débat entre rétro-ingénierie open source et criminalistique numérique : Suite aux allégations d’un ancien chercheur d’OpenAI selon lesquelles de grands modèles chinois majeurs auraient utilisé des puces sous embargo, des chercheurs de la communauté ont riposté sur le plan technique. Leurs arguments soulignent que la disposition des nombres aléatoires dans les poids ne permet d’identifier que la machine ayant généré les poids initiaux, lesquels peuvent ensuite être transférés en quelques secondes vers des clusters domestiques ou d’anciennes générations pour l’entraînement. Dans le même temps, plusieurs développeurs ont prouvé par décompilation inverse que la distribution des poids permet non seulement d’inférer la puce, mais également de reconstituer le nombre d’étapes d’entraînement, le schéma de recuit du taux d’apprentissage et les failles de décalage de tokenizer. La transparence des poids de modèles se transforme ainsi en une loupe d’inspection bidirectionnelle (Source : dotey)
💡 Autre
Nace exploite la programmation dans l’espace des poids pour proposer des versions quantifiées stables GGUF pour contextes longs : L’équipe open source Nace a combiné des algorithmes de programmation dans l’espace des poids (WSP), permettant à un agent de raisonnement avancé d’évaluer de manière autonome et de modifier de façon ciblée les tenseurs de poids sensibles d’un petit modèle, afin de publier de nouveaux checkpoints quantifiés de la famille Qwen. Les tests indiquent que, sous un contexte extrêmement long de 128K, la divergence KL et la précision de prédiction Top-1 surpassent nettement les stratégies heuristiques traditionnelles de quantification, réduisant drastiquement la dégradation de précision lors des dialogues à long cours et des scénarios de codage complexes (Source : Reddit r/LocalLLaMA)

Clauddy : un compagnon de bureau pixelisé écrit en Rust pour surveiller la consommation de Claude Code : Un développeur a conçu de manière autonome et open-sourcé un utilitaire de bureau léger intitulé Clauddy, en s’appuyant sur Claude Code. Développée en Rust, cette application se loge dans un coin de l’écran pour lire en temps réel les journaux de session locaux et la consommation de quotas d’agents de codage comme Claude Code. Elle traduit la progression des tâches par des animations pixelisées dynamiques et affiche des alertes intuitives lorsque les quotas approchent du seuil critique ou en cas d’attente prolongée (Source : Reddit r/ClaudeAI)

haralickt : ouverture en open source d’une bibliothèque d’extraction de caractéristiques de texture Haralick accélérée par GPU et purement vectorisée : Pour remédier aux lourds goulets d’étranglement de performance liés au calcul monothread sur CPU de la matrice de cooccurrence de niveaux de gris (GLCM) dans l’analyse d’images satellitaires et médicales traditionnelles, des développeurs ont mis en open source haralickt, implémenté sous PyTorch. Cette bibliothèque s’appuie sur un algorithme de pavage par blocs optimisé pour la VRAM afin de calculer nativement sur GPU l’intégralité des 13 indices de texture de Haralick, multipliant par un facteur de 20 à 60 la vitesse de traitement sur des images 4K et supérieures par rapport à la bibliothèque classique mahotas (Source : Reddit r/deeplearning)