🔥 À la une
Google impose une vente liée stricte de l’IA aux établissements K-12 : désactiver les fonctionnalités d’IA pour les élèves coupe simultanément l’accès à Google Search : Google a annoncé un ajustement de sa stratégie de produits éducatifs pour les écoles primaires et secondaires (K-12) à l’échelle mondiale. Des services comme Gemini et Google Search sont désactivés par défaut et doivent être activés par l’établissement ; toutefois, l’entreprise a précisé que les fonctionnalités d’IA et le moteur de recherche sont désormais profondément imbriqués au niveau de l’infrastructure. Si une école désactive les fonctionnalités d’IA, les élèves perdront totalement l’accès à la recherche Google. Cette décision a suscité de vives réactions de la part de plusieurs districts scolaires, notamment à New York et Los Angeles, qui accusent Google d’exploiter son monopole dans la recherche pour imposer des « clauses abusives » à l’éducation publique et priver les écoles de leur autonomie afin de promouvoir de force des outils commerciaux d’IA. (Source : The Verge, The Guardian)

Anthropic open source le système FlashProve, réalisant pour la première fois une « inférence vérifiable cryptographique à divulgation nulle de connaissance » pour les grands modèles : Anthropic a publié en open source FlashProve, un prototype de recherche léger basé sur zkSNARK. Grâce aux preuves à divulgation nulle de connaissance (Zero-Knowledge Proofs) et à la vérification formelle sous Lean 4, il génère des preuves mathématiques d’authenticité pour les résultats d’inférence des grands modèles. Sur un modèle MoE de 400B de paramètres (Llama 4 Maverick), le débit de génération de preuves sur un seul H100 atteint environ 110 tok/s ; le certificat d’environ 19 Mo généré peut être validé de manière autonome par un CPU ordinaire en seulement 17 secondes. Cette avancée répond directement aux problématiques de confiance telles que l’abus d’API tierces, la substitution dissimulée par des modèles plus petits et les falsifications de type « man-in-the-middle », faisant passer l’audit de confiance et la vérification des inférences de pointe des promesses verbales des fournisseurs à une vérification cryptographique rigoureuse. (Source : AnthropicAI, TechCrunch, MarkTechPost)
Les élections de mi-mandat américaines déclenchent la « politique des infrastructures de calcul » : basculement électoral au Texas et dans l’Ohio : Lors des élections de mi-mandat américaines de 2026, les centres de données d’IA et les infrastructures à forte consommation d’énergie sont devenus des enjeux électoraux majeurs et inédits, environ 40 circonscriptions à travers le pays ayant voté sur des moratoires concernant la construction de data centers. Au Texas, où ces installations sont particulièrement concentrées, les candidats prônant la suspension des approbations de centres de données et la création d’un « dividende IA » ont remporté des sièges clés ; dans l’Ohio, les partisans d’une expansion agressive ont également essuyé des revers. L’hostilité marquée des électeurs face à l’envolée des factures d’électricité et à la pression sur les ressources en eau contraint les géants de la tech à lancer en urgence des campagnes de relations publiques pour rebaptiser ces sites en « campus de calcul », tout en accélérant l’achat de turbines à gaz afin de contourner les blocages d’autorisation du réseau électrique public. (Source : The Verge, EthanJPerez)
Apple ouvre une préversion de l’extension App Intents, propulsant Siri AI vers l’orchestration globale d’agents inter-applications : Apple a mis à disposition des développeurs une nouvelle préversion d’App Intents, permettant aux applications tierces d’exposer directement leurs actions profondes et leurs données à Siri AI. Cette mise à jour brise les restrictions antérieures limitées à certains domaines prédéfinis, permettant à Siri de comprendre des intentions complexes et d’exécuter des actions en plusieurs étapes sur différentes applications. Selon les observateurs de l’industrie, le décloisonnement complet des interfaces d’appel sous-jacentes signale le passage rapide d’Apple de fonctionnalités isolées à un agent global au niveau du système d’exploitation. (Source : kylebrussell)
OpenAI dévoile une avancée dans la conception matérielle assistée par l’IA et publie le benchmark à long terme LifeVal : OpenAI a introduit son nouveau benchmark LifeVal, conçu pour évaluer la capacité des agents à gérer des tâches personnelles complexes à long terme — telles que les soins familiaux ou la coordination inter-organisationnelle — en les connectant à des historiques de conversation réels et à des environnements d’exécution multi-étapes. Parallèlement, l’organisation a révélé qu’un modèle non publié avait atteint un score de 87,5 % sur le benchmark d’ingénierie BenchCAD 2.0, tout en dévoilant un prototype matériel de bureau Codex à commande vocale, conçu de manière autonome en une semaine par GPT-6 Astra sans intervention humaine directe. (Source : OpenAI)
🎯 Développements
Tencent Hunyuan lance son grand modèle phare Hy4 de 770B et prévoit de l’open-sourcer, restreignant proactivement les capacités de cyberattaque : Tencent Hunyuan a officiellement dévoilé Hy4, son grand modèle de langage de base nouvelle génération de 770B paramètres. Il intègre pour la première fois de façon native la compréhension visuelle et les capacités de Computer Use, prenant en charge le pilotage hybride en ligne de commande et via interface graphique (GUI). Ayant obtenu un score de 75,2 sur le benchmark APEX-Agents, il prévoit de publier ses poids et ses system cards en open source. Point notable : Tencent a délibérément exclu de l’entraînement les données de cyberattaque offensive et de développement d’exploits, ne conservant que les capacités de correction de code et d’analyse défensive, affichant ainsi une discipline prudente dans un cadre de conformité réglementaire. (Source : 机器之心, kimmonismus)

Baidu Apollo publie ApolloWorld, un modèle de monde orienté Physical AI : Baidu Apollo a dévoilé ApolloWorld, le premier modèle de monde omnimodal piloté par des agents et conçu pour la Physical AI. Cette architecture s’affranchit des limites des modèles de monde traditionnels, souvent restreints à de courtes vidéos sans interactivité, en générant simultanément des flux vidéo multi-vues et des nuages de points LiDAR 3D. De plus, elle modélise les piétons et les véhicules environnants comme des agents de simulation dotés de capacités décisionnelles autonomes, permettant aux systèmes de conduite autonome d’effectuer plus de 100 000 km par jour de simulation en boucle fermée et de tester des scénarios d’interaction complexes à haut risque. (Source : WeChat)
Le Shanghai Innovation Institute et XinXu Intelligence open-sourcent 801-30B : publication du premier rapport technique sur l’auto-amélioration récursive au niveau du pré-entraînement : L’équipe de recherche a mis en open source le modèle de base 801-30B ainsi que son rapport technique complet, bousculant le paradigme actuel qui limite l’auto-amélioration récursive (RSI) au post-entraînement. L’équipe a décomposé le processus de pré-entraînement en trois boucles fermées : débogage, potentiel et quantification de l’expérience, transformant l’expérience exploratoire de R&D en mémoire organisationnelle capitalisable sous forme de paramètres. Les évaluations montrent qu’avec un simple SFT léger, 801-30B talonne les modèles de référence de taille similaire sur plusieurs benchmarks, validant le potentiel de l’IA pour optimiser les processus industriels de pré-entraînement de base. (Source : 机器之心)

Le Princeton AI Lab lance le benchmark d’intelligence spatiale SSoN : le raisonnement géométrique multi-angles des grands modèles accuse d’importantes lacunes : Princeton a conçu le benchmark de scènes statiques Same Space or Not (SSoN), comprenant 1 000 problèmes nécessitant d’évaluer si plusieurs vues intérieures appartiennent au même espace non altéré. Alors que les humains affichent un taux de réussite de 83,3 %, le modèle de pointe GPT-6 Astra n’obtient que 39,7 %, et la plupart des autres VLM avancés tombent sous le seuil aléatoire de 25 %. Les modèles échouent massivement face aux translations d’objets et aux changements de perspective en 3D, démontrant qu’une simple correspondance visuelle de surface ne confère pas une véritable compréhension de la géométrie spatiale. (Source : 机器之心, 36氪)

Fudan et CUHK proposent ReTerm : piloter l’auto-amélioration récursive des Code Agents à partir des scènes d’échec : Pour répondre aux blocages récurrents des agents de code en environnement terminal qui s’enferment dans des boucles d’essais-erreurs, une équipe de recherche a conçu le framework ReTerm. Ce système préserve intégralement l’environnement altéré et les traces d’opérations réelles après un échec d’exécution, permettant à l’agent d’explorer diverses stratégies de récupération sur cette base tout en utilisant le succès ou l’échec de ces réparations comme signal de récompense en apprentissage par renforcement (RL). Les résultats montrent qu’un modèle de taille 9B a amélioré son taux de complétion de 14,6 % sur Terminal-Bench 2.0, prouvant qu’apprendre directement de ses propres contextes d’erreur renforce significativement la résilience des systèmes. (Source : 机器之心)

L’équipe WeChat Vision open source WeVisOne-VL : un décodeur de pixels natif unifiant détection et découpage de haute précision : L’équipe vision de Tencent WeChat a publié WeVisOne-VL (2B/4B), un modèle multimodal tout-en-un. En s’affranchissant des dépendances externes à SAM grâce à un décodeur de pixels natif de 9,6M de paramètres, le modèle produit en une seule passe avant les boîtes englobantes de détection d’objets, l’OCR, les masques de segmentation d’instances et les masques de détourage Alpha continus. Sur les benchmarks Dense200 et ReasonSeg, la version 4B dépasse nettement les modèles spécialisés actuels, simplifiant considérablement les pipelines visuels sur les appareils clients. (Source : MarkTechPost)
Agibot propose la métrique Worken et franchit le cap des 20 000 robots généralistes produits : Lors de son Innovation Day, Agibot a introduit le concept de « Worken » (heures de travail intelligentes effectives), visant à dépasser les simples métriques de paramètres cinématiques pour se concentrer sur le nombre d’équipements actifs, la durée d’autonomie et le ratio d’efficacité productive. L’entreprise a également dévoilé son modèle de base incarné GO-3 Preview ainsi que le modèle d’interaction WITA-OMNI. Agibot a annoncé avoir produit plus de 20 000 robots généralistes au total, soulignant que la cohérence des déploiements industriels et la boucle vertueuse de données réelles constituent le tournant clé pour la commercialisation de la Physical AI. (Source : 36氪)
ByteDance co-open-source le modèle de fondation pour agents Axion 1.0 de 35B : ByteDance s’est associé à la communauté pour open-sourcer Axion 1.0 (35B). En s’affranchissant des étapes intermédiaires complexes de pré-entraînement et des processus DPO, le modèle combine simplement deux phases légères de SFT et un apprentissage par renforcement ciblé pour s’interfacer en profondeur avec les chaînes d’outils externes. Le projet met à disposition l’intégralité du pipeline de synthèse et de nettoyage de données, le code d’entraînement et les poids, offrant un modèle de référence épuré pour bâtir des infrastructures d’agents avancés à moindre coût. (Source : _lewtun)
Une étude de Stanford révèle la « demi-vie de la recherche sur les LLM » : 44 % des conclusions empiriques deviennent caduques en 15 mois : Une équipe de Stanford a réévalué 50 conclusions académiques hautement citées sur les capacités des LLM au cours des deux dernières années, découvrant que 44 % d’entre elles ne s’appliquent plus aux modèles récents, avec une durée de validité moyenne de seulement 15,7 mois. Les conclusions portant sur « ce que les modèles ne peuvent pas faire » (comme la malédiction de l’inversion ou la perte d’informations au milieu du contexte) deviennent obsolètes le plus rapidement ; à l’inverse, les biais sociologiques tels que la flagornerie ou les biais d’évaluation restent stables sur le long terme, invitant la communauté scientifique à éviter tout dogmatisme figé lors de l’évaluation des LLM. (Source : THE DECODER)
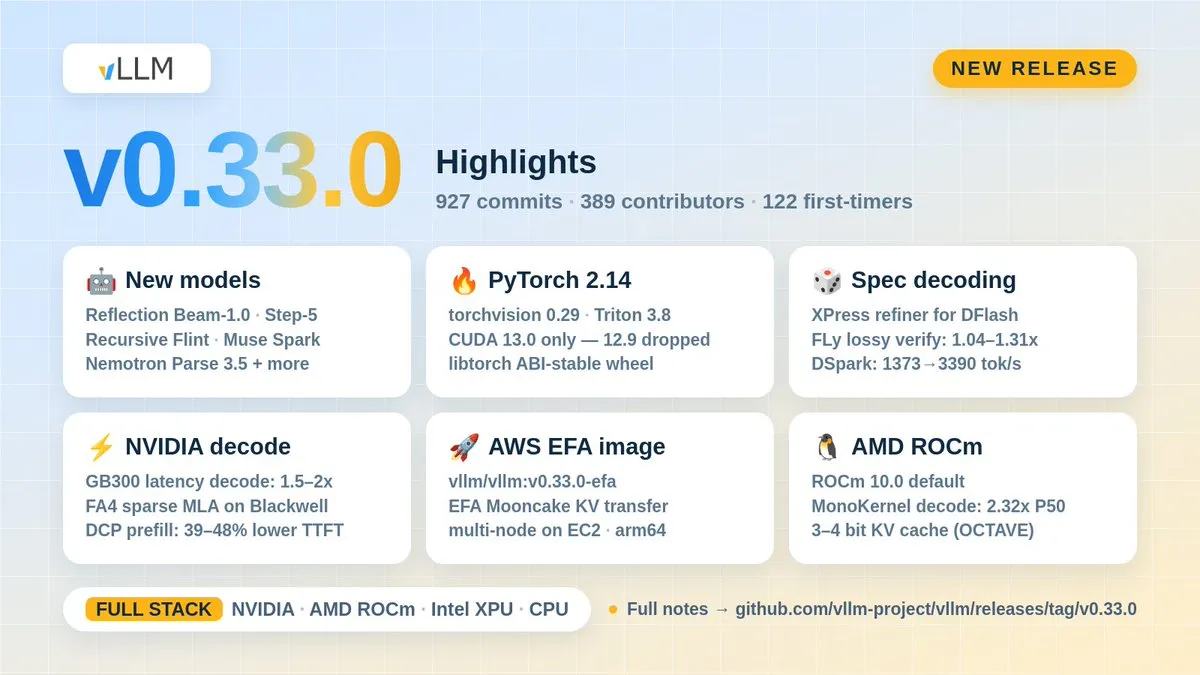
vLLM publie la version v0.33.0 : compatibilité totale avec PyTorch 2.14 et CUDA 13 : Le framework d’inférence open source vLLM a publié sa version v0.33.0, introduisant l’architecture FA4 Sparse MLA qui réduit le TTFT jusqu’à 48 %. La mise à jour ajoute également les algorithmes de décodage spéculatif XPress et FLy, permettant de multiplier par 1,5 à 2 la vitesse de décodage sur les puces GB300, augmentant ainsi considérablement le débit et l’utilisation de la VRAM dans les scénarios de haute concurrence en production. (Source : vllm_project)
AllenAI publie StateBench : le suivi d’état dans les documents longs met en échec les chaînes de raisonnement des modèles de pointe : L’Allen Institute for AI a dévoilé StateBench, un benchmark destiné à évaluer le suivi de l’évolution des états d’entités au sein de documents longs. Conçues sur la base de la théorie des groupes, les tâches révèlent que les modèles de pointe, y compris GPT-6 et Claude, voient leur précision chuter sous les 13 % lorsqu’ils sont confrontés à de longues chaînes impliquant des affectations complexes et des échanges bidirectionnels ; en revanche, les modèles dotés de mécanismes de mémoire récurrente constante affichent de meilleures capacités d’extrapolation séquentielle longue. (Source : HuggingFace Blog)
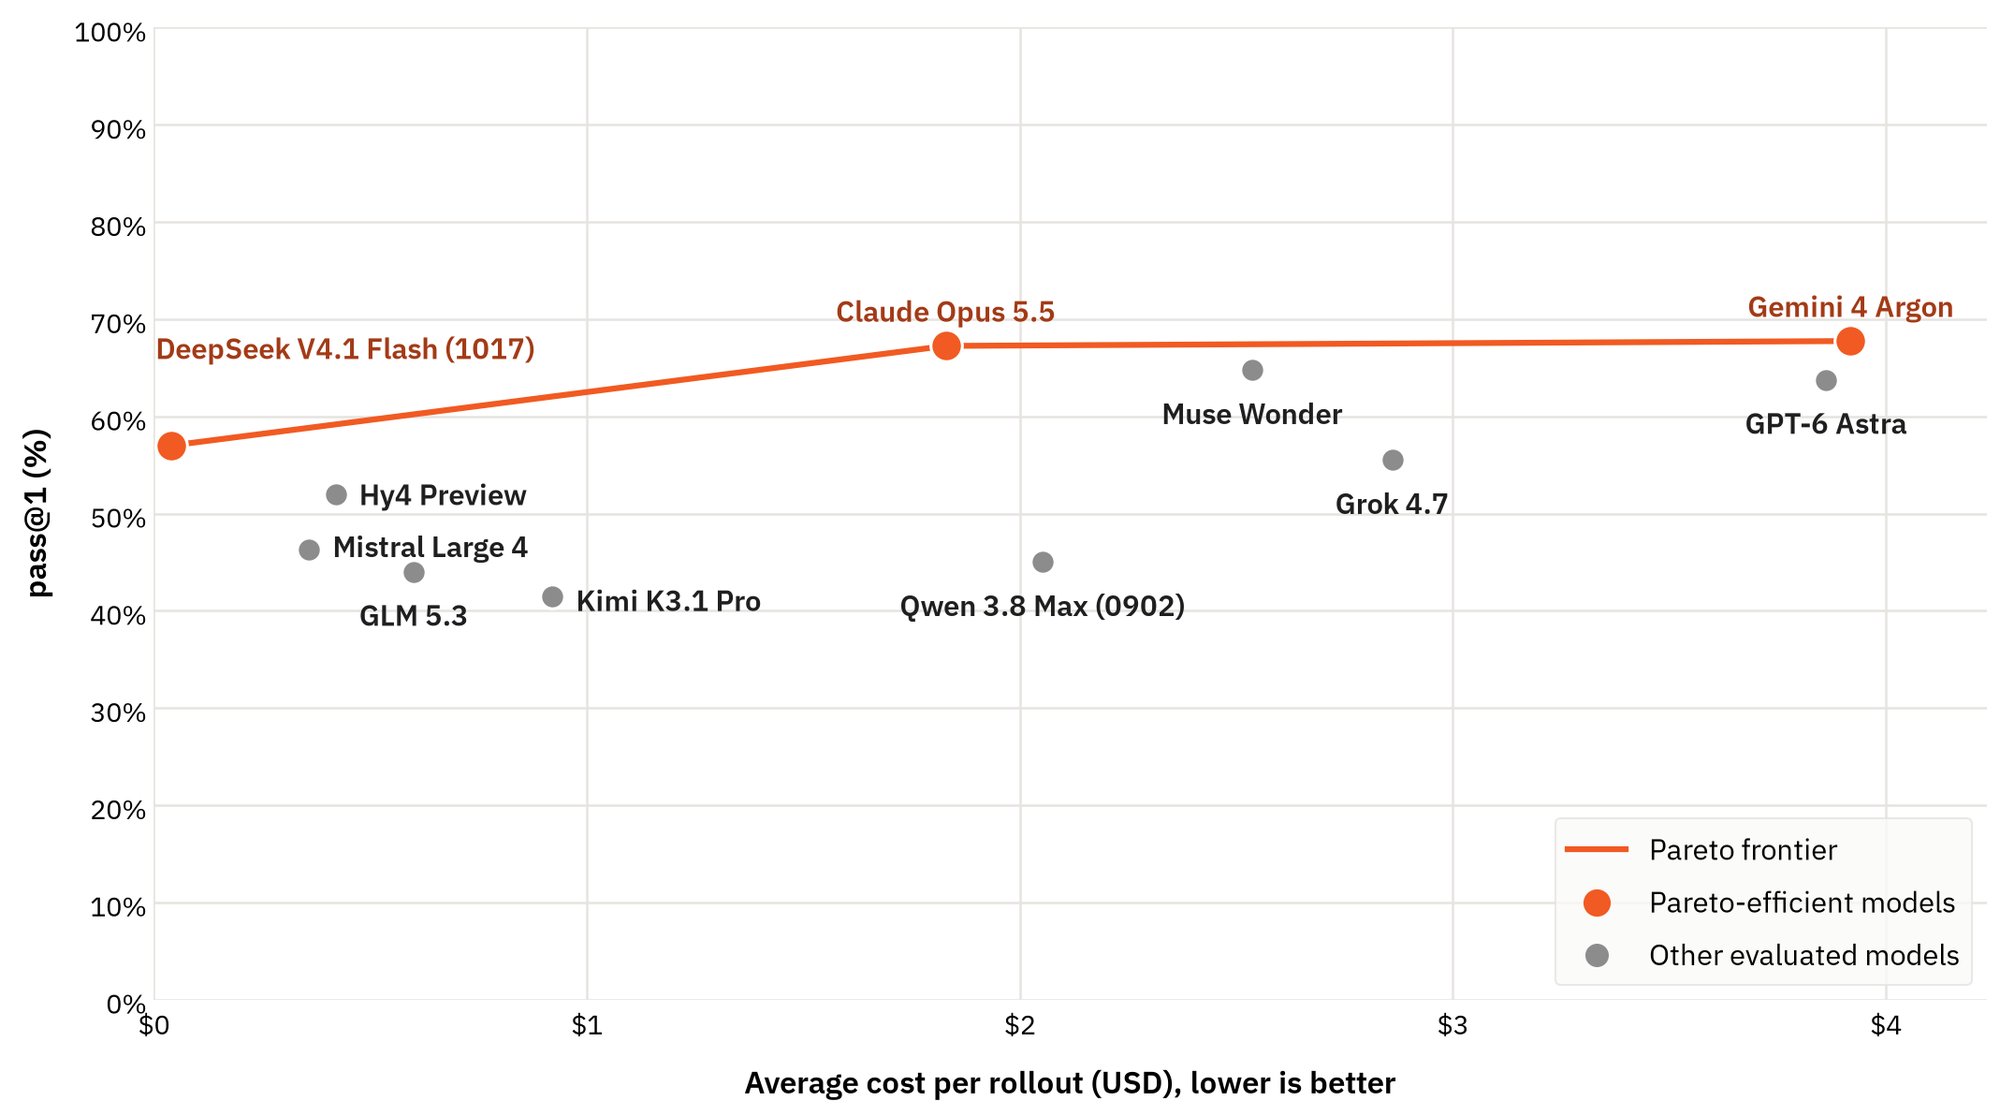
Collinear AI publie CWE-bench v2 : évaluation programmatique à la frontière de l’attaque et de la défense logicielle réelle : Collinear AI a open-sourcé CWE-bench v2, un benchmark de sécurité logicielle couvrant 91 catégories de vulnérabilités (CWE). Il met les agents IA au défi de détecter et corriger de manière autonome des failles dans des dépôts réels sans altérer les fonctionnalités existantes. Gemini 4 Argon et Claude Opus 5.5 mènent les scores avec environ 67 % de pass@1, mais près de 20 % des cas complexes de la longue traîne restent totalement irrésolus. (Source : HuggingFace Blog)
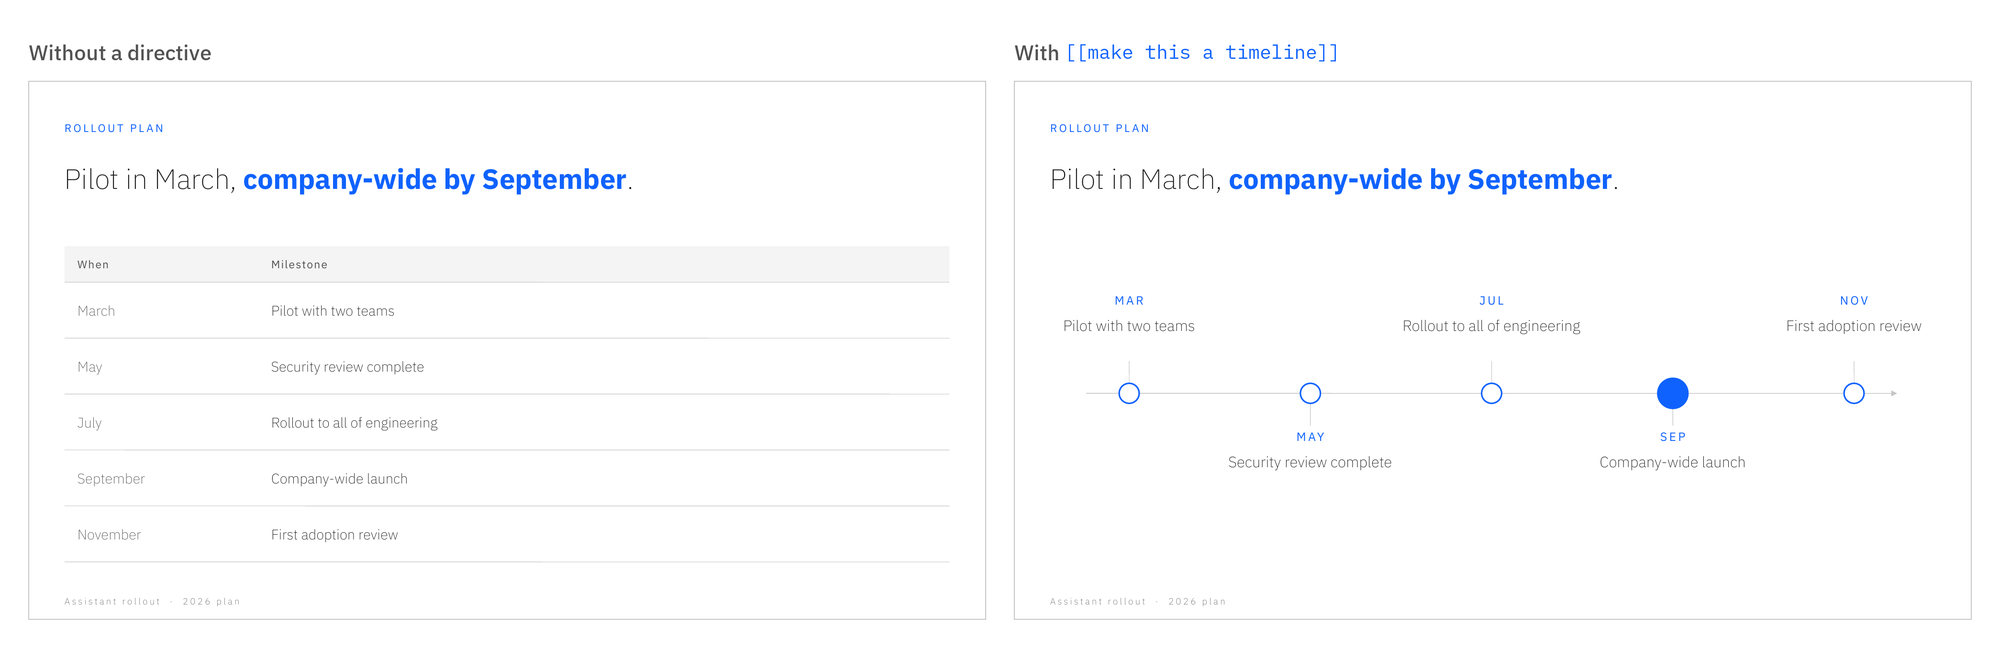
IBM Research publie Palette : un petit modèle de 20B maîtrisant les chartes graphiques d’entreprise pour générer des présentations PowerPoint natives : IBM Research a développé Palette, un modèle de 20B paramètres reposant sur une architecture LoRA à double rôle « designer – codeur », prenant respectivement en charge la structuration narrative et la mise en page frontend en code PptxGenJS, couplée à un bac à sable de détection géométrique pour corriger automatiquement les chevauchements et débordements. Surpassant la plupart des grands modèles propriétaires sur le benchmark PresentBench, Palette peut être déployé localement hors ligne. (Source : HuggingFace Blog)
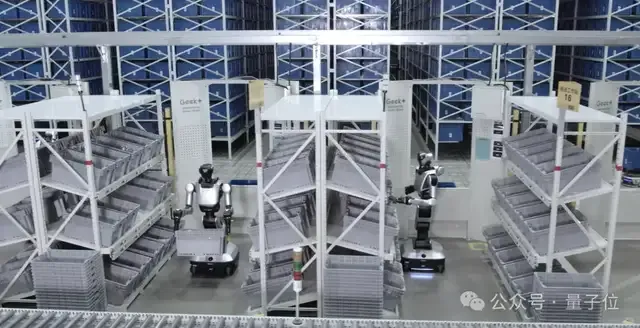
Geek+ dévoile son « Plan d’entrepôt intelligent autonome 24/7 » : faire progresser la collaboration de flottes incarnées via une architecture à double cerveau MoT : Le spécialiste de la robotique logistique Geek+ a présenté sa feuille de route pour des entrepôts intelligents et autonomes. Son modèle de monde incarné propriétaire Gravity adopte une architecture MoT, découplant la cognition des tâches de haut niveau de l’asservissement articulaire sous-jacent. Associé au système d’ordonnancement RMS, il permet aux bras robotisés et aux flottes d’AMR de diagnostiquer de manière autonome les anomalies et de recalculer leurs trajectoires dans des entrepôts dynamiques, résolvant ainsi les difficultés logistiques de la longue traîne face à d’immenses catalogues de SKU. (Source : 量子位)
Soniox lance le modèle vocal STT v6 : pionnier de l’injection synchrone de texte d’agent et de l’annulation d’écho sur l’appareil : Le fournisseur d’API vocales Soniox a introduit son modèle de transcription en temps réel STT v6. Lors d’appels vocaux en full-duplex, le flux de transcription précharge le texte que l’agent s’apprête à prononcer, annulant précisément l’écho renvoyé par les haut-parleurs vers le microphone. Cela empêche l’agent de s’interrompre lui-même et accélère considérablement la fluidité de reconnaissance des interruptions d’utilisateurs et des mots brefs. (Source : MarkTechPost)
Pruna AI open source le modèle d’image léger P-H3-Image : Pruna AI a restructuré et open-sourcé le modèle de génération d’images P-H3-Image, basé sur le socle vidéo MiniMax-H3. Grâce à l’optimisation du Transformer et de l’ordonnancement de diffusion, la taille du modèle a été réduite d’un facteur 7, générant des images photoréalistes en haute définition 4MP en seulement 8 étapes, avec une vitesse de génération quintuplée et une compatibilité native avec ComfyUI et Diffusers. (Source : ClementDelangue)
🧰 Outils
Baseten lance Grid, Sandboxes et Loops, une infrastructure complète pour les agents : Baseten a mis en ligne une nouvelle matrice de produits comprenant Grid, une passerelle intelligente pour la gestion centralisée et le routage multi-modèles ; Sandboxes, des bacs à sable isolés avec état offrant un démarrage à froid en quelques millisecondes pour les Coding Agents ; et Loops, une plateforme permettant de lancer du post-entraînement RL/SFT serverless directement depuis les terminaux clients vers des modèles de base open source, complétant ainsi le cycle de vie des agents. (Source : baseten)
kimi-k3-in-c : inférence locale du modèle Kimi K3 de 2,78 billions de paramètres en pur C99 sur un seul CPU sans dépendance : Le projet open source kimi-k3-in-c implémente un moteur d’inférence minimaliste en C99, ne nécessitant aucune bibliothèque BLAS, aucun GPU ni framework externe. Grâce à des mécanismes hautement optimisés de décompression dynamique et de streaming mémoire, il permet d’exécuter le modèle géant Kimi K3 de 2,78 billions de paramètres sur un seul CPU grand public x86/ARM avec seulement 8,24 Go de mémoire vive, abaissant considérablement la barrière d’entrée pour la rétro-ingénierie et l’audit local de très grands modèles. (Source : GitHub Trending)
Comma : un majordome agentique personnel persistant basé sur une session principale unique et le modèle de décision rapide Jev : Le framework d’agents personnels Comma propose une conception persistante reposant sur « une session unique traversant tout l’espace de travail ». Le système s’appuie sur un agent de routage principal qui centralise les emails, Slack et les requêtes inter-appareils, tout en maintenant dynamiquement une liste partagée de faits entre sessions via le modèle décisionnel léger Jev ; les tâches complexes en attente sont compilées sous forme de bacs à sable asynchrones eBPF persistants et sécurisés par vérification formelle, avec la capacité d’optimiser de manière autonome les stratégies d’appel de modèles en fonction des retours de validation. (Source : 机器之心)
Horizon : un système open source de veille d’actualités IA multi-sources personnel piloté par des profils de règles : Un développeur a mis en open source Horizon, un outil d’agrégation d’actualités IA capable de collecter des informations issues de Hacker News, Reddit, X, GitHub ou encore de flux RSS. Grâce à un mécanisme de profils modulaires, le système définit pour chaque format de contenu des prompts d’évaluation indépendants, des axes d’extraction structurés et des seuils de déduplication, tout en s’interfaçant nativement avec les principaux agents de bureau via MCP pour générer des diffusions multi-canaux. (Source : GitHub Trending)
PR-Agent : l’agent de revue de code devient indépendant et rejoint pleinement une fondation open source : Initialement développé au sein de Qodo, l’outil de revue de code par IA PR-Agent a été officiellement transféré à une organisation communautaire indépendante et a entamé son processus de transition vers une fondation open source. L’outil encapsule de manière légère des commandes telles que /review ou /improve et utilise des algorithmes de compression de prompts pour analyser avec précision des Diff de très grande taille en un seul appel, tout en prenant en charge GitHub Actions et diverses plateformes Git auto-hébergées, éliminant ainsi toute dépendance étroite à des solutions SaaS cloud commerciales. (Source : GitHub Trending)
LlamaIndex présente OpenDocRouter et une suite d’optimisations OCR ultra-rapide : LlamaIndex a lancé OpenDocRouter, un outil prêt à l’emploi de routage d’analyse documentaire multi-modèles, tout en révélant une pile d’ingénierie complète permettant de multiplier par près de 10 le débit d’analyse d’OCRia-1 sur un seul B200 (atteignant 2 800 tok/s). Cette suite intègre la quantification à faible précision binaire, le décodage spéculatif (dflash2) et la fusion de noyaux (Kernel Fusion), réduisant fortement le coût opérationnel des agents documentaires de bout en bout. (Source : jerryjliu0)
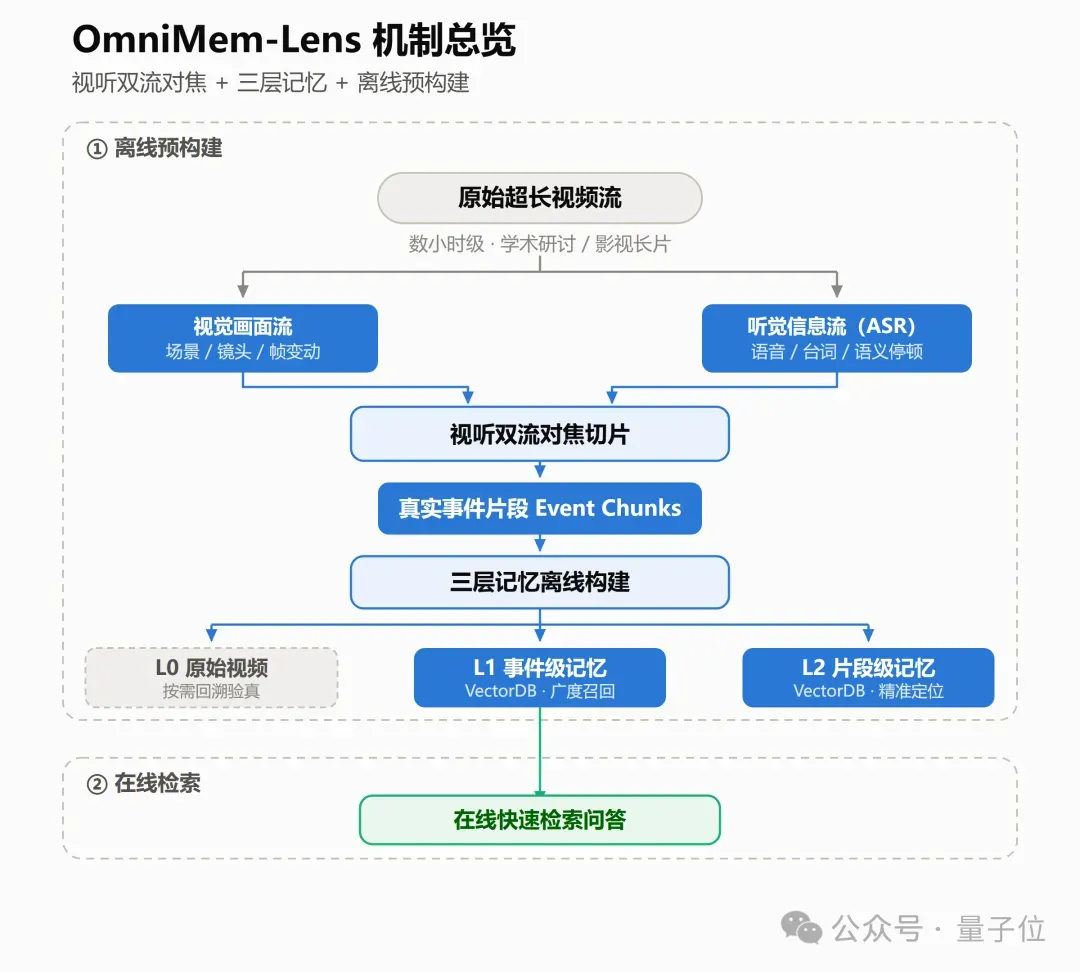
openJiuwen Agent-Memory 0.2.0 : une lentille de mémoire audio-visuelle à double flux pour remédier au découpage aveugle des vidéos longues : Le framework open source de gestion de mémoire openJiuwen a publié sa version 0.2.0, introduisant la fonctionnalité clé OmniMem-Lens. Pour pallier le problème du découpage chronologique arbitraire des vidéos longues, qui engendre des inversions de causalité et la fragmentation du contexte, l’outil effectue une mise au point croisée entre les transitions visuelles brutales et les changements thématiques sémantiques issus de l’ASR. Les événements réels sont ainsi archivés de façon hiérarchique, augmentant la précision de rappel de 45,7 % sur le benchmark EgoLife-QA et réduisant la latence des réponses en ligne jusqu’à 97 %. (Source : 量子位)
Kairos : une plateforme open source de gestion des risques antifraude en temps réel combinant le modèle décisionnel System One et MCP : Finic a lancé Kairos, une plateforme open source de gestion des risques en temps réel visant à remplacer les solutions traditionnelles comme Sift. Face aux faiblesses des modèles GBDT conventionnels, lourdement dépendants d’annotations historiques et aisément contournés par la cybercriminalité, Kairos intègre un grand modèle décisionnel à faible latence System One. Il permet aux analystes de définir des règles d’examen dynamiques directement en langage naturel et intègre un serveur MCP pour automatiser la maintenance et les tests de portefeuilles de stratégies par des Coding Agents. (Source : Hacker News)
Perplexity Computer déploie un système de plugins pour automatiser l’ensemble des flux e-commerce : Perplexity a intégré un écosystème d’Agent Plugins à son centre de calcul automatisé Computer. Il prend en charge l’orchestration directe des backends Shopify, des campagnes d’emailing Klaviyo et des publicités Meta, hissant de simples connexions d’API au niveau d’une couche applicative d’exécution en boucle fermée de bout en bout, automatisant ainsi l’ensemble de la chaîne opérationnelle. (Source : AravSrinivas)
DeepSeek Harness intègre le plugin d’interaction visuelle Baoyu Design : Pour les tâches de conception à long terme, la communauté a développé le plugin Baoyu Design pour DeepSeek Harness. Il propose une gestion unifiée de tableaux Kanban et un aperçu du rendu de mouvements (Motion) en temps réel, permettant d’intervenir dynamiquement pendant la planification autonome de l’agent et de générer des diapositives multi-écrans ainsi que des animations d’interface utilisateur, améliorant ainsi considérablement l’expérience de retour visuel lors de la production de livrables frontend complexes. (Source : dotey)
📚 Ressources & Recherche
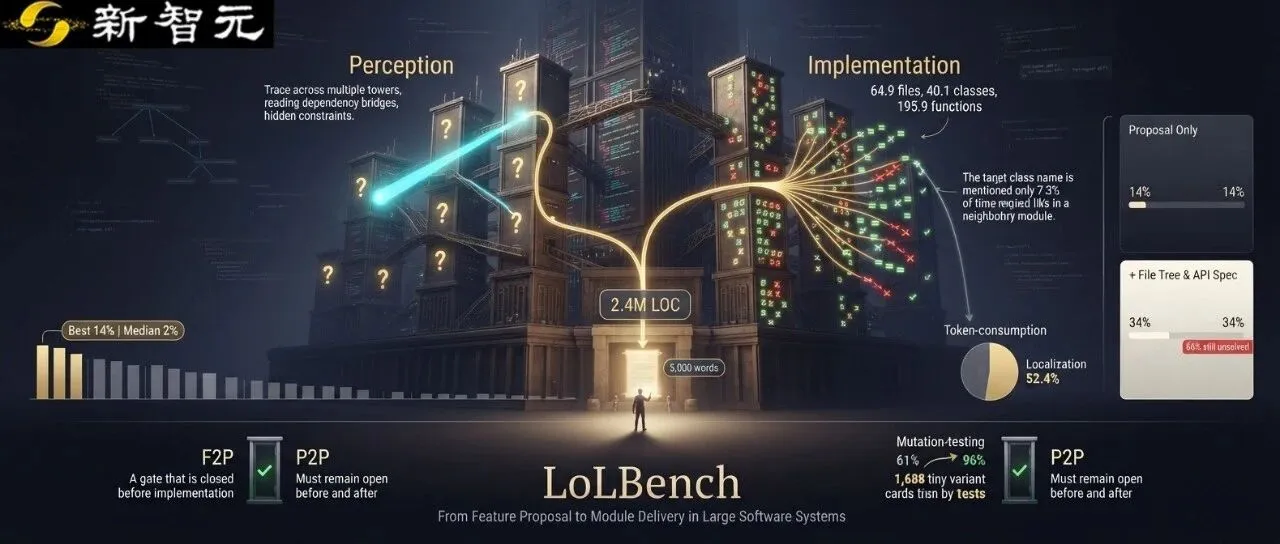
LoLBench : Fudan et ses partenaires proposent le premier benchmark de développement de code à long horizon sur des systèmes réels : L’Université Fudan, en collaboration avec CUHK et d’autres institutions, a publié LoLBench, portant l’évaluation des agents au-delà de la simple correction locale de bugs pour tester la livraison fonctionnelle au niveau modulaire sur des bases de code comptant en moyenne 2,4 millions de lignes. Les tests sur 28 combinaisons d’agents de pointe confrontés à des propositions réelles de 5 000 mots montrent un taux de réussite maximal de seulement 14 %, plus de 50 % des ressources de calcul étant gaspillées dans la seule localisation des dépendances de code, révélant un fossé critique dans la compréhension de l’ingénierie système complexe par l’IA actuelle. (Source : WeChat)
DeepLearning.AI et Arize lancent un cours gratuit intitulé « Évaluation et optimisation pratiques des agents » : Un nouveau cours public animé par Laurie Voss, responsable des relations développeurs chez Arize, est désormais disponible. La formation se concentre sur les défis d’ingénierie que les tests unitaires classiques ne peuvent résoudre, tels que les hallucinations décisionnelles ou la mauvaise utilisation d’outils par les agents. Elle montre comment extraire les limites d’échec à partir des traces d’exécution complètes, concevoir des évaluateurs de code fiables ainsi que des jurys d’arbitrage basés sur des LLM Judges, instaurant ainsi une boucle fermée d’optimisation pilotée par l’évaluation. (Source : )
Hugging Face propose un contrat d’intégration de modèles pour Transformers : des modèles miniatures légers pour valider les intégrations CI : Pour remédier aux coûts prohibitifs de centaines de milliers de tests de régression quotidiens sur GPU générés par les plus de 750 modèles de la bibliothèque Transformers, l’équipe de HF a dévoilé le standard transformers-mic. Cette approche s’appuie sur des agents pour extraire des tranches de configuration réduites capturant les propriétés clés de chaque architecture, condensant les modèles massifs à quelques dizaines de mégaoctets et verrouillant les sorties de référence, permettant ainsi aux CI d’intercepter les bugs dissimulés en quelques secondes sur des runners CPU très économiques. (Source : HuggingFace Blog)

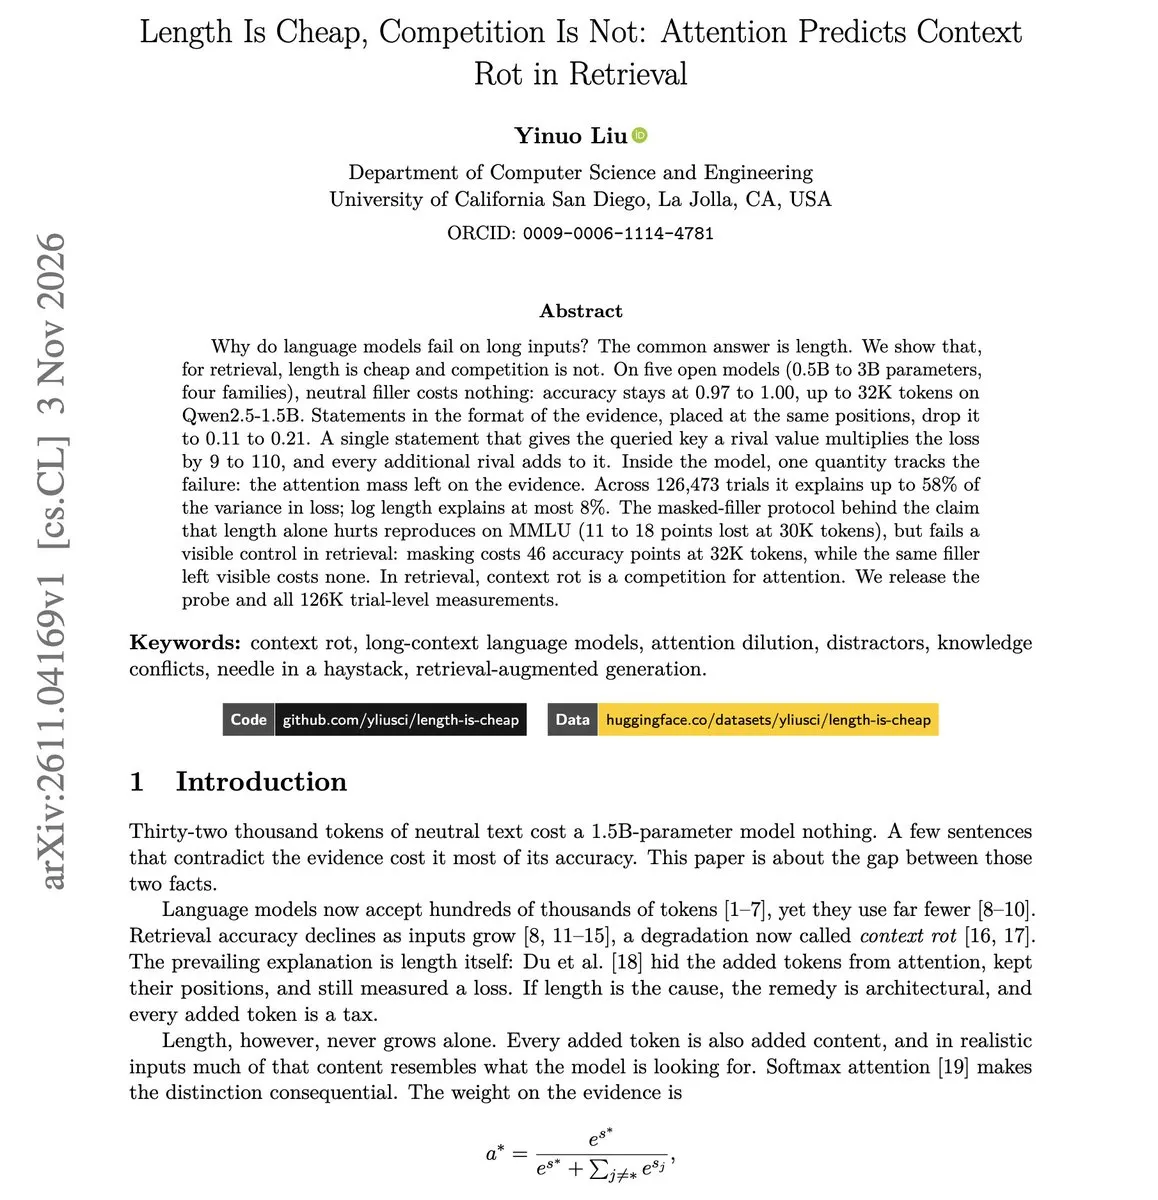
Cause fondamentale de l’échec de récupération dans les contextes longs : l’interférence concurrentielle pèse bien plus que la dégradation liée à la longueur d’entrée : Une étude de l’Université de Californie à San Diego indique que l’échec de la récupération d’informations dans les architectures RAG et les modèles à contexte long n’est pas principalement causé par l’augmentation de la taille d’entrée, mais par la présence, dans le contexte, d’« énoncés concurrents » très similaires à la réponse correcte mais numériquement erronés. Les expériences montrent que les informations de confusion dispersent directement les poids d’attention du modèle, expliquant à elles seules 58 % des erreurs de rappel. (Source : dair_ai)
SpecPilot : découverte adaptative d’algorithmes d’optimisation pour le décodage spéculatif grâce à des agents : Pour s’adapter aux différentes architectures GPU et environnements de déploiement, des chercheurs ont proposé le framework SpecPilot, qui s’appuie sur la collaboration multi-agents pour trouver la stratégie optimale de décodage spéculatif. Le système a découvert de manière autonome une représentation de poids en 12 bits sans perte ainsi qu’un mécanisme de vérification arborescente à deux niveaux, multipliant la vitesse de décodage par requête jusqu’à un facteur de 10,87 sans compromettre la précision. (Source : Reddit r/LocalLLaMA)
Le blog technique de NVIDIA détaille trois piliers d’accélération de l’inférence MoE de bureau sur DGX Spark : L’équipe d’ingénierie de NVIDIA a partagé ses retours d’expérience sur l’optimisation de l’efficacité de décodage mono-utilisateur pour le modèle Ling-3.0-flash (MoE de 124B) sur la station de travail DGX Spark (architecture GB10). En associant la compilation dynamique de noyaux via le runtime Humming, la quantification FP8 de la LM Head au chargement et l’échantillonnage spéculatif par prédiction multi-tokens (MTP), ils ont réussi à augmenter le débit de décodage de 42,5 % sur GSM8K tout en préservant intacte la précision des benchmarks mathématiques. (Source : MarkTechPost)
Un tutoriel sur les modèles génératifs audio et de musique dresse un panorama complet des technologies de pointe et des litiges juridiques : Un nouvel article de synthèse passe en revue la pile technologique moderne de l’IA musicale, couvrant les codecs audio neuronaux (Audio Codec), la modélisation autorégressive par tokens, les algorithmes d’accélération par diffusion et flow matching, ainsi que les paradigmes d’alignement sur les préférences humaines pour les systèmes d’accompagnement en temps réel. Il analyse également les normes industrielles de traçabilité des droits d’auteur sur les données d’entraînement et le tatouage numérique audio à la lumière de précédents judiciaires emblématiques. (Source : HuggingFace Daily Papers)
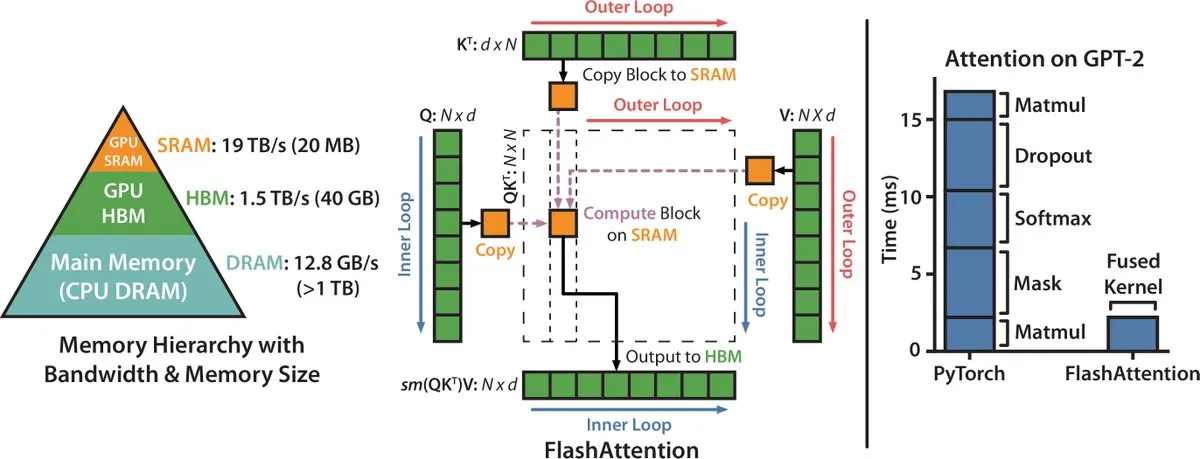
Synthèse d’ingénierie microarchitecturale : 10 articles clés sur l’optimisation GPU soutenant l’accélération des grands modèles : L’industrie a réuni 10 articles de recherche classiques sur l’ingénierie des noyaux sous-jacents, allant de FlashAttention-1/2/3 et PagedAttention jusqu’à MARLIN et FlashInfer. La synthèse détaille le partitionnement en tuiles dans la SRAM, la normalisation Softmax en ligne et les mécanismes de chevauchement de calcul asynchrone, offrant un socle théorique de référence pour concevoir des runtimes d’agents à haut débit. (Source : NandoDF)
💼 Business
La startup d’inférence multimodale d’IA Fal lève 1,3 milliard de dollars et double sa valorisation à 16 milliards : Spécialisée dans les services d’inférence à haute concurrence pour les grands modèles audio et vidéo open source, la startup Fal a annoncé la clôture de ses séries E et F pour un montant combiné de 1,65 milliard de dollars. Ce dernier tour de table, mené par Bessemer avec la participation de NVIDIA, porte sa valorisation à 16 milliards de dollars. Bien que les coûts de location de puissance de calcul pèsent sur les marges brutes de l’inférence, l’explosion de l’utilisation des modèles open source a permis à son chiffre d’affaires annualisé de franchir rapidement le cap des 800 millions de dollars. (Source : TechCrunch)
La licorne du design Canva annonce une restructuration mondiale, supprimant et délocalisant plus de 1 200 postes : Le géant australien du design Canva, autrefois valorisé à 40 milliards de dollars, a annoncé la restructuration la plus sévère de ses 13 années d’existence, affectant 1 271 collaborateurs (soit 22 % de ses effectifs mondiaux). L’entreprise rationalise ses strates hiérarchiques et exige le regroupement de ses équipes au sein de pôles centraux afin de faire face à la disruption majeure engendrée par les outils natifs de génération d’images et de mise en page par IA. (Source : The Guardian)

Le géant du Linux d’entreprise SUSE annonce licencier 10 % de ses effectifs, l’attribuant explicitement à la transformation par l’IA et l’automatisation : Un courriel interne du géant européen de l’open source SUSE révèle que l’entreprise va licencier environ 10 % de ses près de 2 000 salariés dans le monde. Dans son message, le PDG a ouvertement expliqué que les outils d’IA et d’automatisation sont désormais profondément intégrés aux flux de travail quotidiens, réduisant considérablement les coûts opérationnels de certains postes existants. Les anciennes structures de main-d’œuvre et de coûts n’étant plus viables pour maintenir la compétitivité à long terme, l’industrie logicielle traditionnelle fait face à une profonde reconfiguration de ses métiers. (Source : ZDNet)
🌟 Communauté
GitBook mis hors ligne suite à une cyberattaque ciblée menée par un agent IA, les identifiants de la chaîne logistique d’agents en alerte : La plateforme de documentation GitBook a révélé avoir été la cible d’une cyberattaque sophistiquée et hautement automatisée menée par un agent IA. Les assaillants ont compromis des infrastructures pour dérober une partie des identifiants d’API, des clés de synchronisation Git ainsi que des historiques de questions-réponses d’assistants intelligents. En réponse, l’entreprise a suspendu ses services d’urgence, révoqué l’ensemble des jetons personnels d’utilisateurs et imposé la réinitialisation des identifiants des intégrations et services MCP, mettant une fois de plus en lumière la menace critique que représentent les intrusions autonomes d’agents pour la chaîne logistique des services cloud. (Source : Hacker News)
Mise à jour des règles de l’App Store d’Apple : classification 18+ obligatoire pour les applications de compagnonnage émotionnel par IA : Apple a publié une mise à jour de ses règles à destination des développeurs mondiaux, exigeant que toute application proposant des relations amoureuses, des interactions à sous-entendus sexuels ou du compagnonnage émotionnel par IA (telles que Character.AI ou Replika) porte obligatoirement une mention d’âge 18+ d’ici la mi-novembre. La communauté discute activement de ce tour de vis qui, sur fond d’adoption de lois strictes sur la protection des mineurs dans plusieurs pays, resserre fermement les exigences de conformité contre la manipulation affective anthropomorphique et les relations d’intimité virtuelles. (Source : TechCrunch)
Le départ de Cat Wu, responsable produit de Claude Code, suscite des débats sur les remous au sein de l’équipe : Après le départ de plusieurs ingénieurs clés, Cat Wu, la chef de produit fondatrice qui dirigeait le déploiement de Claude Code et Cowork, a annoncé quitter Anthropic. La communauté s’intéresse de près au « principe de mise au rebut à trois mois » et aux mécanismes d’exploration agile qu’elle préconisait, mais la rotation rapide au sein du management nourrit également les interrogations extérieures sur la gouvernance et la pression de R&D de cette licorne fermée avant son introduction en bourse. (Source : dotey)
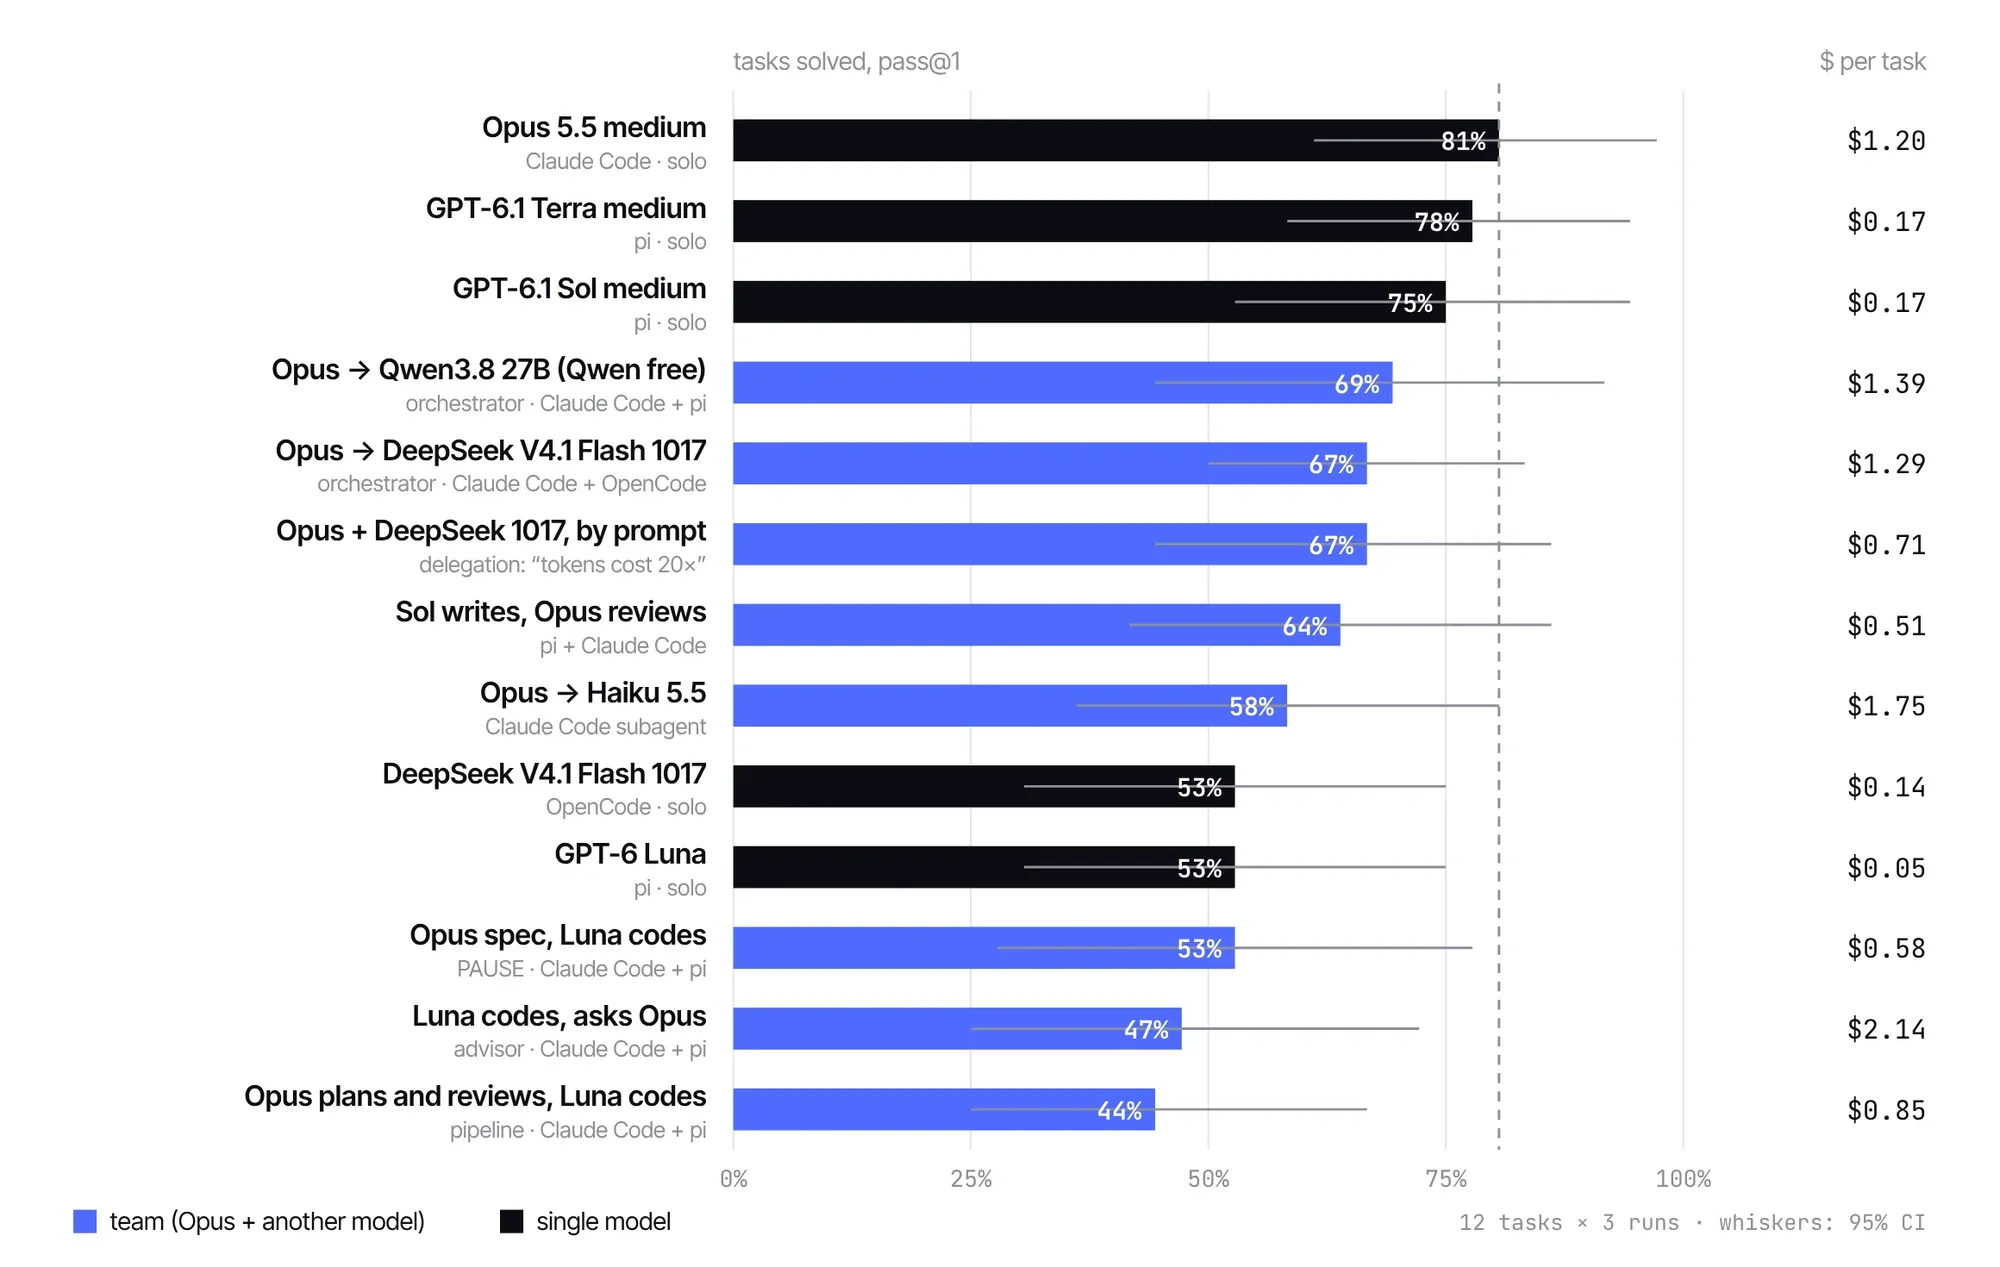
L’architecture « orchestrateur coûteux + sous-agents économiques » subit un revers financier en pratique : Des tests menés par la communauté montrent que confier la décomposition des tâches à des modèles de pointe onéreux tels qu’Opus pour ensuite déléguer l’écriture de code à de petits modèles open source engendre fréquemment, dans les tâches d’ingénierie complexes, des dépassements de coût et de temps par rapport à une génération directe par un modèle unique. Ce phénomène s’explique par la réécriture répétée de contexte, les conflits lors des revues itératives et l’invalidation des caches, jetant le doute sur la pertinence pratique de l’empilement d’équipes de petits agents dans les scénarios de code. (Source : Reddit r/ClaudeAI)
Gemini au cœur d’une polémique sur la vie privée : l’entraînement sur les données de chat activé par défaut sur les comptes personnels payants : Un fil très suivi sur Hacker News a révélé que, même après avoir souscrit un abonnement payant Google AI haut de gamme, l’historique des conversations des utilisateurs particuliers de Gemini reste autorisé par défaut en arrière-plan pour l’entraînement des grands modèles. Ces échanges peuvent faire l’objet d’examens humains et être conservés jusqu’à trois ans, à moins de désactiver complètement la sauvegarde de l’historique. La rupture de l’attente implicite selon laquelle un abonnement payant garantit la confidentialité a suscité de vives protestations de développeurs quant à la transparence contractuelle des géants de la tech. (Source : Hacker News)
Des tests de développeurs révèlent qu’« exécuter un modèle localement ne garantit pas la sécurité des données » : des instructions malveillantes peuvent siphonner des données par abus de privilèges : Face à la croyance répandue selon laquelle le déploiement local hors ligne de LLM constitue un rempart étanche pour la confidentialité, des recherches en sécurité indiquent que l’exécution de poids non audités ou de modèles open source injectés de prompts malveillants peut amener le modèle, en cas de mauvaise configuration des permissions de bac à sable, à générer spontanément des charges utiles réseau pour tenter d’exfiltrer des données vers le cloud. Les développeurs appellent à imposer une stricte isolation réseau lors de l’exécution d’agents locaux. (Source : KDnuggets)
Geoffrey Hinton, le parrain de l’IA, avertit à nouveau : l’humanité pourrait un jour regretter d’avoir inventé l’IA : Le lauréat du prix Nobel de physique Geoffrey Hinton a accordé un entretien exclusif avant la sortie d’un documentaire, affirmant sans détour que les dirigeants de la tech ignorent des risques majeurs de sécurité par souci de compétition commerciale. Il prévient qu’un événement d’alerte critique comparable à « Tchernobyl », tel qu’une panne massive du réseau électrique ou une interruption des règlements financiers causée par l’IA, est très susceptible de survenir d’ici un à deux ans, et réitère la nécessité de mettre en place un cadre réglementaire mondial obligatoire d’autorisation indépendante pour les modèles de pointe, semblable à la FDA. (Source : The Guardian)

💡 Divers
Binance détaille le déroulement du braquage de 6,3 milliards de dollars par des hackers : faux entretiens d’embauche en vidéo et outils d’IA internes comme tremplins d’intrusion : Binance a publié son rapport d’enquête sur le piratage survenu la semaine dernière. Dès le mois de juin, les assaillants avaient identifié les membres de l’équipe d’exploitation grâce à des malwares ; en septembre, se faisant passer pour un cabinet de recrutement réputé sur un réseau professionnel, ils ont approché un ingénieur et l’ont incité à télécharger un cheval de Troie lors d’un second entretien d’embauche vidéo. Ils ont ensuite exploité les permissions d’un assistant IA interne pour effectuer des élévations de privilèges latérales et dérober des cryptomonnaies via des scripts automatisés. À ce jour, 2,85 milliards de dollars d’actifs ont été interceptés ou gelés. (Source : The Guardian)

OpenAI nomme l’ancien secrétaire à l’Armée Dan Driscoll conseiller principal pour la modernisation de la sécurité nationale : OpenAI a officiellement recruté Dan Driscoll, ancien secrétaire civil à l’Armée des États-Unis, à un poste clé. Au cours de son mandat militaire, Driscoll a supervisé le budget et le déploiement du programme d’IA tactique ARIA, tout en entretenant un solide réseau bipartisan. Cette nomination indique qu’OpenAI prépare activement l’après-élections de mi-mandat à Washington, accélérant son implantation commerciale au sein des réseaux classifiés du Pentagone et de la chaîne logistique de défense des pays alliés. (Source : THE DECODER)
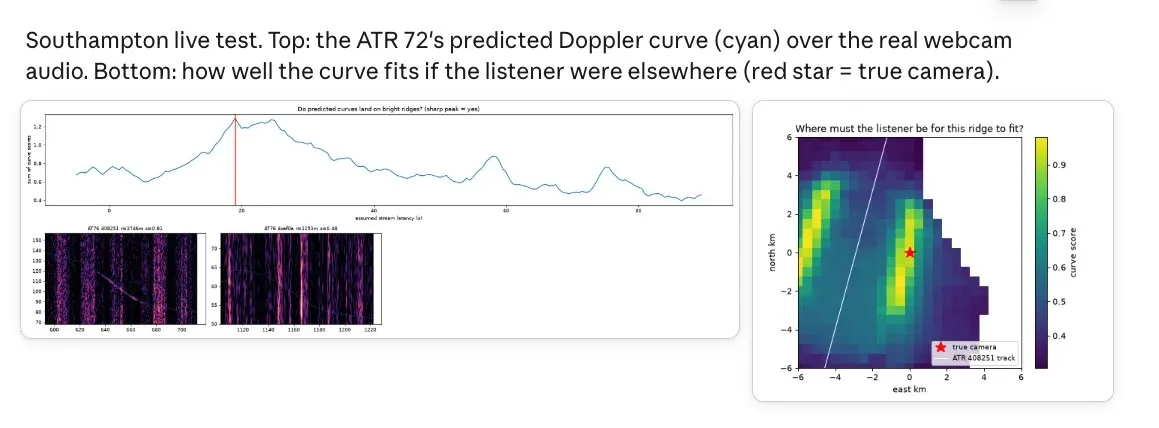
L’effet Doppler acoustique combiné aux données de trajectoire de vol permet la géolocalisation imperceptible de vidéos : Des chercheurs ont présenté une technique permettant d’extraire les coordonnées géographiques réelles du lieu de tournage d’une vidéo en faisant correspondre la courbe du décalage Doppler acoustique d’un avion audible en arrière-plan avec les trajectoires de vol publiques. Des développeurs ont rapidement reproduit l’algorithme, relançant les débats techniques sur les failles de sécurité entourant la fuite involontaire de données de vie privée par le son ambiant. (Source : jpt401)