🔥 Destacados
Google impone una vinculación forzada de IA a las instituciones educativas K-12: deshabilitar las funciones de IA para estudiantes cortará simultáneamente el acceso a Search : Google anunció un ajuste en su estrategia de productos educativos dirigidos a escuelas K-12 de todo el mundo. Gemini y Google Search estarán desactivados por defecto y dependerá de las escuelas activarlos; sin embargo, se indicó explícitamente que las funciones de IA están profundamente acopladas en su arquitectura base con el motor de búsqueda. Si una escuela deshabilita las funciones de IA, los estudiantes perderán por completo el acceso a Google Search. Esta decisión ha provocado un fuerte rechazo en distritos escolares y en el sector educativo de ciudades como Nueva York y Los Ángeles, criticando a Google por utilizar su monopolio en las búsquedas para imponer “cláusulas abusivas” a la educación pública, privando a los centros de su autonomía para forzar el uso de herramientas comerciales de IA. (Fuente: The Verge, The Guardian)

Anthropic lanza como código abierto el sistema FlashProve, logrando por primera vez la “inferencia criptográfica verificable de conocimiento cero” en LLMs : Anthropic ha lanzado como código abierto FlashProve, un prototipo de investigación ligero basado en zkSNARK que establece credenciales antifalsificación a nivel matemático para los resultados de inferencia de grandes modelos mediante Zero-Knowledge Proofs y verificación formal en Lean 4. En un modelo MoE de 400B (Llama 4 Maverick), el sistema alcanza un rendimiento de prueba de aproximadamente 110 tok/s en una única GPU H100; además, la verificación independiente de una credencial de unos 19 MB tarda solo 17 segundos en una CPU convencional. Este avance aborda directamente puntos críticos de confianza como el abuso de APIs de terceros, el reemplazo no autorizado por modelos más pequeños y los ataques Man-in-the-Middle, permitiendo que la auditoría confiable de modelos y la verificación de inferencia en frontera pasen de promesas verbales a una verificación criptográfica estricta. (Fuente: AnthropicAI, TechCrunch, MarkTechPost)
Las elecciones de medio mandato en EE. UU. desatan la “política de infraestructura de cómputo”: giros electorales en Texas y Ohio : En las elecciones de medio mandato de 2026 en EE. UU., los centros de datos de IA y las infraestructuras de alto consumo energético se convirtieron en un inusual foco de campaña, con cerca de 40 distritos electorales votando sobre moratorias a la construcción de data centers. En Texas, donde se concentran numerosas instalaciones de cómputo, los candidatos que defendían pausar las aprobaciones de centros de datos y establecer un “dividendo de IA” ganaron escaños clave; en Ohio, los candidatos partidarios de una expansión agresiva también sufrieron derrotas. La fuerte oposición de los votantes ante el aumento de las tarifas eléctricas y el acaparamiento de recursos hídricos obligó a los gigantes tecnológicos a lanzar campañas de relaciones públicas para renombrar los “campus de cómputo” y a acelerar la compra propia de turbinas de gas para eludir los bloqueos en la aprobación de conexiones a la red pública. (Fuente: The Verge, EthanJPerez)
Apple abre la vista previa extendida de App Intents: Siri AI avanza hacia la orquestación global de agentes entre aplicaciones : Apple ha distribuido a los desarrolladores una nueva vista previa de App Intents, permitiendo que aplicaciones de terceros expongan directamente sus operaciones y datos profundos a Siri AI. Esta actualización rompe con la limitación previa de admitir únicamente dominios predefinidos específicos, permitiendo a Siri comprender directamente intenciones complejas y ejecutar flujos de trabajo coordinados de múltiples pasos entre diferentes aplicaciones. Los analistas del sector consideran que la apertura integral de las interfaces de llamada subyacentes marca la transición acelerada de Apple desde capacidades aisladas hacia un Agent global a nivel de sistema. (Fuente: kylebrussell)
OpenAI revela avances en diseño de hardware asistido por IA y lanza el benchmark de tareas a largo plazo LifeVal : OpenAI presentó LifeVal, un nuevo benchmark diseñado específicamente para evaluar la capacidad de los Agents para resolver asuntos personales complejos y de largo plazo (como cuidado del hogar y coordinación interinstitucional) mediante el acceso a historiales de conversación reales y entornos operativos de múltiples pasos. Al mismo tiempo, reveló que su modelo no publicado obtuvo una puntuación del 87,5% en el benchmark de ingeniería BenchCAD 2.0, y mostró un prototipo de hardware de escritorio interactivo por voz para Codex, diseñado de forma totalmente autónoma por GPT-6 Astra en una semana y sin intervención humana directa. (Fuente: OpenAI)
🎯 Tendencias
Tencent Hunyuan lanza su modelo insignia Hy4 de 770B y planea abrir su código, restringiendo voluntariamente las capacidades de ciberataque : Tencent Hunyuan presentó formalmente Hy4, su modelo base de lenguaje de nueva generación de 770B. Integra de forma nativa por primera vez capacidades de comprensión visual y Computer Use, admitiendo la orquestación mixta de línea de comandos e interfaces gráficas (GUI). Logró una puntuación de 75,2 en el benchmark APEX-Agents y planea abrir sus pesos y System Cards. Cabe destacar que, durante el entrenamiento, Tencent filtró proactivamente datos de penetración y explotación de vulnerabilidades, conservando únicamente las capacidades de corrección de código y análisis defensivo, demostrando prudencia y autorregulación en un contexto de normalización regulatoria. (Fuente: 机器之心, kimmonismus)

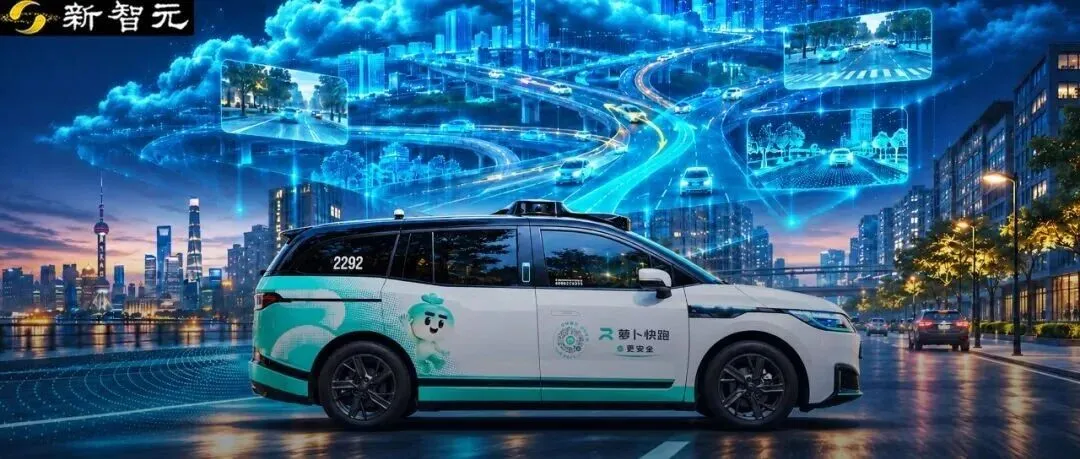
Baidu Apollo presenta ApolloWorld, un modelo del mundo orientado a Physical AI : Baidu Apollo lanzó ApolloWorld, el primer modelo del mundo multimodal impulsado por Agents y orientado a Physical AI. Esta arquitectura supera la limitación de los modelos tradicionales, que solo generan videos cortos sin interactividad, produciendo sincronizadamente video multivista y nubes de puntos LiDAR 3D. Además, modela peatones y vehículos del entorno como agentes de simulación con capacidad de toma de decisiones autónoma, permitiendo que los sistemas de conducción autónoma realicen más de 100.000 km diarios de simulación en bucle cerrado y pruebas de maniobras de alto riesgo. (Fuente: WeChat)
Shanghai Chuangzhi Institute y NewOrder Intelligence liberan 801-30B: primer informe técnico sobre mejora autorrecursiva a nivel de preentrenamiento : El equipo de investigación lanzó de forma conjunta el modelo base 801-30B y su informe técnico completo, rompiendo con el paradigma de la industria que limitaba el Recursive Self-Improvement (RSI) al ajuste posterior (post-training). El equipo descompuso el proceso de preentrenamiento en tres bucles cerrados: depuración, potencial y cuantificación de experiencia, transformando la experiencia exploratoria de I+D en memoria de parámetros organizacionales capitalizable. Las pruebas muestran que 801-30B, con solo un SFT ligero, se aproxima a los modelos de primer nivel de su misma escala en múltiples benchmarks, validando el potencial de la IA para optimizar los procesos industriales de preentrenamiento. (Fuente: 机器之心)

Princeton AI Lab presenta el benchmark de inteligencia espacial SSoN: los LLMs muestran graves deficiencias en el razonamiento geométrico multivista : Princeton construyó Same Space or Not, un benchmark de escenas estáticas compuesto por 1.000 preguntas, que exige a los modelos determinar si imágenes de interiores desde múltiples ángulos corresponden al mismo espacio no alterado. La precisión humana alcanzó el 83,3%, mientras que el modelo puntero GPT-6 Astra obtuvo solo un 39,7%, situándose la mayoría del resto de VLMs de vanguardia por debajo de la línea aleatoria del 25%. Los modelos fracasaron ante traslaciones de objetos y transformaciones de perspectiva 3D, evidenciando que el simple emparejamiento visual aún no logra construir una cognición geométrica espacial real. (Fuente: 机器之心, 36氪)

Fudan y CUHK proponen ReTerm: mejora autorrecursiva de Code Agents impulsada por el escenario del fallo : Frente al problema de los agentes de código en terminal que caen en bucles repetidos de prueba y error, un equipo de investigación propuso el framework ReTerm. Este sistema preserva intactos el entorno contaminado y las trayectorias operativas reales tras un fallo de ejecución, permitiendo al Agent explorar diversas rutas de recuperación a partir de ese punto y utilizando el éxito o fracaso de la recuperación como señal de recompensa en Reinforcement Learning. Los experimentos demostraron que un modelo de 9B mejoró su tasa de resolución en Terminal-Bench 2.0 en un 14,6%, probando que aprender de los propios escenarios de error eleva notablemente la resiliencia del sistema. (Fuente: 机器之心)

El equipo de WeChat Vision libera WeVisOne-VL: decodificador de píxeles nativo que unifica detección y matting de alta precisión : El equipo de visión de WeChat de Tencent presentó WeVisOne-VL (2B/4B), un modelo multimodal de percepción integral. Omitiendo la dependencia de modelos externos como SAM, integra un decodificador de píxeles nativo de 9,6M de parámetros, entregando en una sola pasada directa (forward pass) cuadros delimitadores para detección de objetos, OCR, máscaras de segmentación de instancias y máscaras de matting Alpha continuo. En los benchmarks Dense200 y ReasonSeg, la versión 4B superó con holgura a los modelos especializados actuales, simplificando significativamente los pipelines de visión on-device. (Fuente: MarkTechPost)
Agibot propone la métrica Worken y supera las 20.000 unidades de robots de propósito general fabricadas : En su jornada de innovación, Agibot introdujo el concepto “Worken (horas de trabajo inteligente efectivas)”, intentando superar las métricas basadas exclusivamente en parámetros de movimiento mediante el cómputo de dispositivos activos, horas de autonomía y ratio de eficiencia de producción. Asimismo, presentó su modelo base encarnado GO-3 Preview y el modelo interactivo WITA-OMNI. Agibot anunció que la producción acumulada de robots de propósito general superó las 20.000 unidades, subrayando que la consistencia en el despliegue industrial y el flywheel de datos reales constituyen la línea divisoria clave para la comercialización de la Physical AI. (Fuente: 36氪)
ByteDance colabora en la liberación del modelo base para agentes Axion 1.0 de 35B : ByteDance, en colaboración con la comunidad, liberó el modelo Axion 1.0 35B. Prescindiendo de complejos procesos intermedios de entrenamiento y DPO, el modelo se integra en profundidad con toolchains externas únicamente a través de dos etapas de SFT ligero y Reinforcement Learning dirigido. El proyecto publicó en su totalidad los pipelines de síntesis y limpieza de datos, el código de entrenamiento y los pesos, proporcionando un paradigma de referencia minimalista para construir infraestructura de Agents avanzados a bajo coste. (Fuente: _lewtun)
Un estudio de Stanford revela la “vida media de la investigación en LLMs”: el 44% de las conclusiones empíricas queda obsoleto en 15 meses : Un equipo de Stanford replicó 50 conclusiones altamente citadas de los últimos dos años en la literatura académica sobre capacidades de LLMs, descubriendo que el 44% está completamente desfasado en los modelos más recientes, con una vida media de solo 15,7 meses. Aquellas relativas a “lo que los modelos no pueden hacer” (como la maldición de la inversión o el efecto lost-in-the-middle) quedaron obsoletas con mayor rapidez, mientras que tendencias sociológicas como la adulación al usuario y los sesgos de evaluación se mantuvieron estables en el tiempo, alertando a la academia sobre el peligro de basarse en supuestos estáticos al evaluar LLMs. (Fuente: THE DECODER)
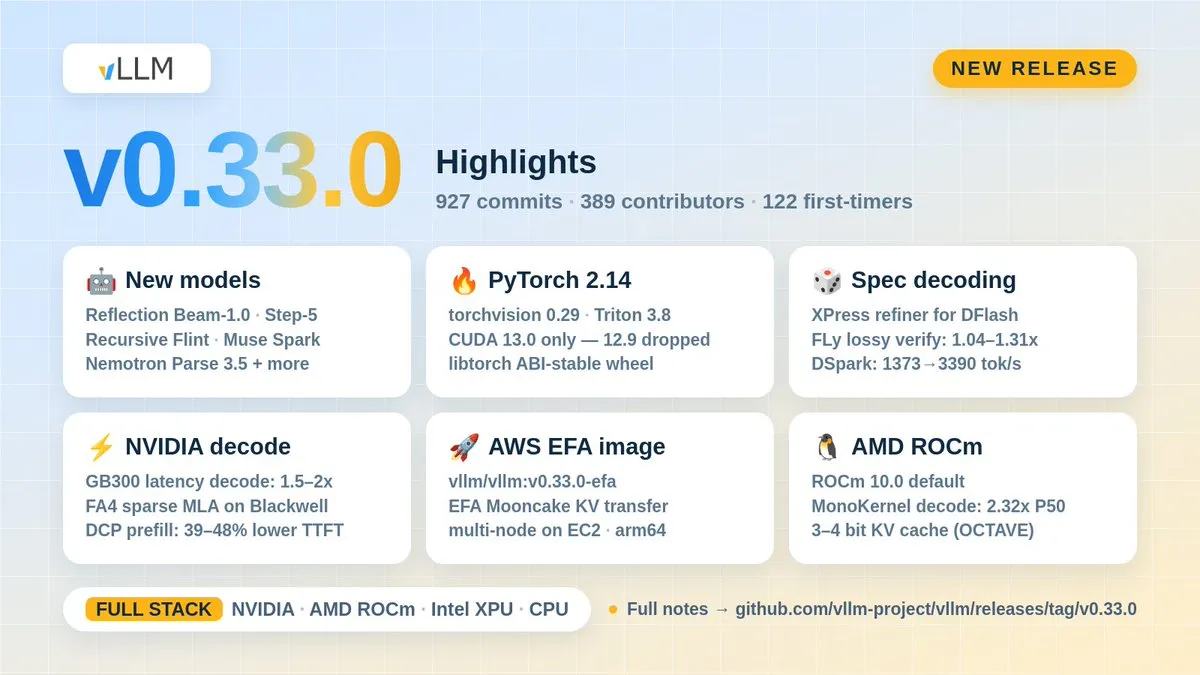
vLLM lanza v0.33.0: compatibilidad total con PyTorch 2.14 y CUDA 13 : El framework de inferencia de código abierto vLLM publicó su versión v0.33.0, introduciendo la arquitectura Sparse MLA FA4 que reduce el TTFT hasta en un 48%. Al mismo tiempo, añade los algoritmos de speculative decoding XPress y FLy, logrando una aceleración de decodificación de 1,5 a 2 veces en chips GB300 y mejorando drásticamente el rendimiento y la utilización de memoria de video en escenarios de alta concurrencia en producción. (Fuente: vllm_project)
AllenAI lanza StateBench: el seguimiento de estados en documentos largos rompe las cadenas de razonamiento de los modelos de vanguardia : El Allen Institute for AI presentó StateBench, un benchmark diseñado para evaluar el seguimiento de la evolución del estado de entidades en documentos extensos. Con tareas diseñadas a partir de la teoría de grupos, las pruebas empíricas demuestran que modelos como GPT-6 y Claude caen drásticamente por debajo del 13% de precisión al procesar cadenas largas con asignaciones complejas e intercambios bidireccionales; en contraste, los modelos equipados con mecanismos de memoria recurrente constante mostraron una mayor capacidad de extrapolación en secuencias largas. (Fuente: HuggingFace Blog)
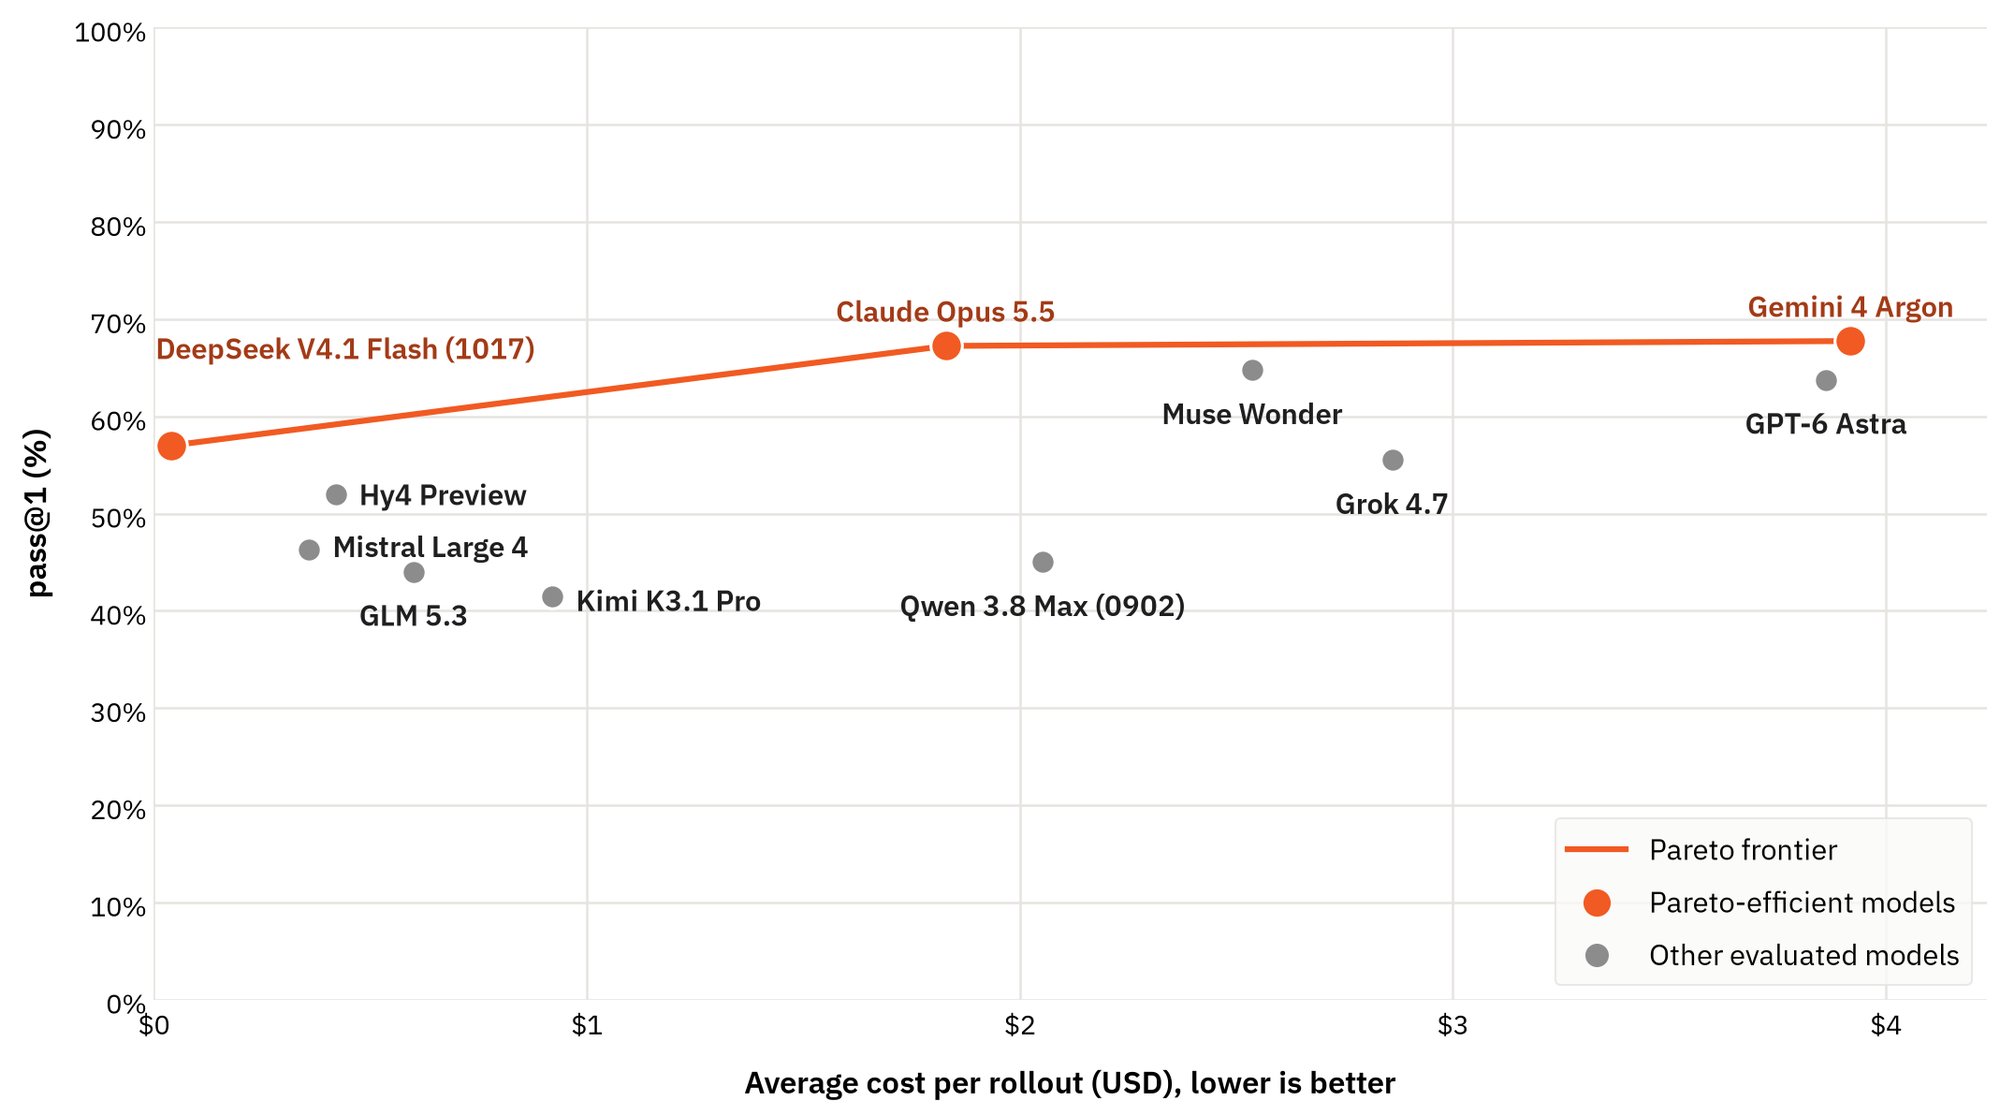
Collinear AI lanza CWE-bench v2: verificación programática de la vanguardia ofensiva y defensiva en software real : Collinear AI liberó el benchmark de seguridad de código CWE-bench v2, que abarca 91 categorías de vulnerabilidades de seguridad de software (CWE) y exige a los agentes de IA detectar y corregir vulnerabilidades en repositorios reales de forma autónoma sin romper la funcionalidad existente. Gemini 4 Argon y Claude Opus 5.5 lideran con un pass@1 cercano al 67%, aunque en escenarios complejos de cola larga casi un 20% de los casos resultó totalmente incapaz de converger. (Fuente: HuggingFace Blog)
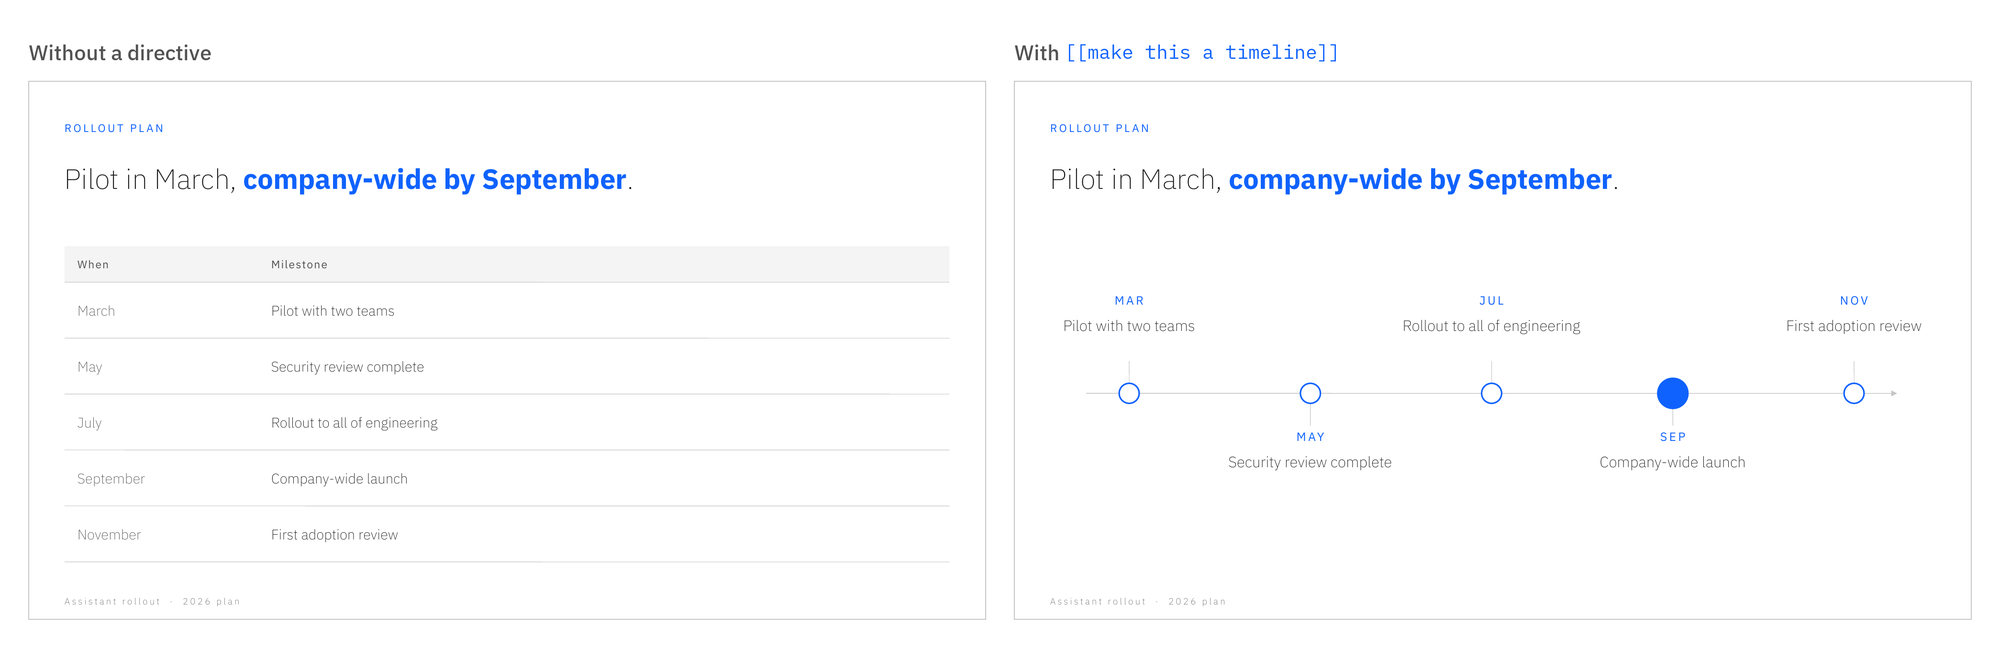
IBM Research presenta Palette: un modelo compacto de 20B que domina las normas de diseño corporativo para generar presentaciones PPT nativas : IBM Research desarrolló Palette, un modelo de 20B parámetros con una arquitectura LoRA de doble rol (“diseñador – codificador”), responsables de la planificación narrativa y del maquetado en código frontend con PptxGenJS, respectivamente. Incorpora además un sandbox de detección geométrica para corregir de forma automática solapamientos y desbordamientos. Superó a la mayoría de los modelos propietarios en las pruebas de PresentBench y admite despliegues totalmente locales y offline. (Fuente: HuggingFace Blog)
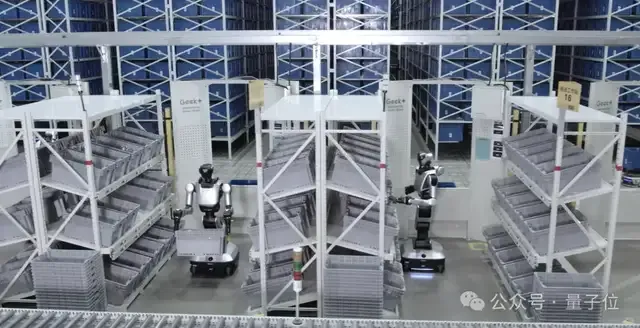
Geek+ presenta el “Plan de Almacén Inteligente Autónomo 24/7”: impulsando la colaboración de enjambres encarnados con la arquitectura de doble cerebro MoT : La empresa de robótica logística Geek+ reveló su plan director para almacenes autónomos inteligentes. Su modelo del mundo encarnado de desarrollo propio, Gravity, adopta una arquitectura MoT que desacopla la cognición de tareas de alto nivel del control de servos en las articulaciones. En combinación con el sistema de orquestación RMS, permite a brazos robóticos y enjambres de AMR diagnosticar averías y recalcular rutas de forma autónoma en almacenes dinámicos, superando los desafíos logísticos que implican millones de SKUs de cola larga. (Fuente: 量子位)
Soniox lanza el modelo de voz STT v6: pionero en inyección sincrónica de texto para agentes y cancelación de eco en el dispositivo : El proveedor de APIs de voz Soniox lanzó su modelo de transcripción en tiempo real STT v6. En conversaciones de voz full-duplex, el flujo de transcripción precarga el texto que el Agent está a punto de pronunciar, cancelando con precisión el eco que se filtra desde el altavoz al micrófono y evitando que el agente se interrumpa a sí mismo. Esto optimiza notablemente la fluidez en el reconocimiento de interrupciones del usuario y palabras cortas. (Fuente: MarkTechPost)
Pruna AI libera el modelo de imagen ligero P-H3-Image : Pruna AI reconstruyó y liberó el modelo de generación de imágenes P-H3-Image basándose en el modelo de video MiniMax-H3. Al simplificar el Transformer y la programación de difusión, redujo el tamaño del modelo en 7 veces, permitiendo generar imágenes hiperrealistas de 4MP en tan solo 8 pasos, quintuplicando la velocidad de generación y ofreciendo compatibilidad nativa con ComfyUI y Diffusers. (Fuente: ClementDelangue)
🧰 Herramientas
Baseten lanza la infraestructura de stack completo para agentes: Grid, Sandboxes y Loops : Baseten presentó su nueva suite de productos, compuesta por Grid (una pasarela inteligente para la gestión unificada y el enrutamiento multimodelo), Sandboxes (entornos con estado y aislados con arranque en frío en milisegundos para Coding Agents) y Loops (una plataforma que permite ejecutar RL/SFT post-training serverless directamente hacia modelos base de código abierto en el dispositivo), cerrando el ciclo completo de vida del Agent. (Fuente: baseten)
kimi-k3-in-c: inferencia local de Kimi K3 de 2,78 billones de parámetros en una sola CPU con C99 puro y sin dependencias : El proyecto de código abierto kimi-k3-in-c implementó un motor de inferencia minimalista en C99 sin necesidad de librerías BLAS, GPUs ni frameworks externos. Utilizando descompresión dinámica altamente optimizada y asignación de memoria por streaming, ejecuta localmente el modelo Kimi K3 de 2,78 billones de parámetros requiriendo solo 8,24 GB de RAM física en una sola CPU comercial x86/ARM, reduciendo sustancialmente las barreras para la ingeniería inversa y auditoría local de modelos masivos. (Fuente: GitHub Trending)
Comma: un mayordomo agente personal residente basado en una sesión principal única y el modelo de decisión rápida Jev : El framework para Agents personales Comma propone un diseño residente en el que “una sola sesión atraviesa todo el espacio de trabajo”. El sistema cuenta con un Agent de enrutamiento principal que gestiona correos, Slack y peticiones multidispositivo, mientras que el modelo ligero de decisión Jev mantiene dinámicamente una lista de hechos compartida entre sesiones. Las tareas de espera complejas se compilan en sandboxes asíncronos protegidos por eBPF y verificación formal, optimizando de manera autónoma las llamadas a modelos en función del feedback de validación de tareas. (Fuente: 机器之心)
Horizon: sistema de radar de noticias de IA personal y de código abierto basado en reglas de Profile : Se ha liberado la herramienta de agregación de noticias de IA Horizon, capaz de recopilar información de diversas fuentes como Hacker News, Reddit, X, GitHub y RSS. Mediante un mecanismo modular de Profiles, define prompts de puntuación independientes, dimensiones de extracción estructurada y umbrales de deduplicación según el formato del contenido. Además, se integra sin fricciones con agentes de escritorio a través de la interfaz MCP y genera difusiones multicanal. (Fuente: GitHub Trending)
PR-Agent: el agente de revisión de código se vuelve independiente y pasa a estar gestionado por una fundación de código abierto : La herramienta de revisión de código asistida por IA PR-Agent, originalmente incubada por Qodo, se ha transferido oficialmente a una organización comunitaria de código abierto independiente e inició su proceso de custodia bajo una fundación. La herramienta encapsula comandos como /review y /improve, empleando algoritmos de compresión de prompts para analizar Diff masivos en una sola llamada. Admite GitHub Actions y diversas plataformas Git autohospedadas, eliminando la dependencia forzosa de plataformas SaaS comerciales en la nube. (Fuente: GitHub Trending)
LlamaIndex presenta OpenDocRouter y un stack de optimización de OCR ultrarrápido : LlamaIndex lanzó OpenDocRouter, una herramienta de enrutamiento para análisis de documentos multimodelo lista para usar, y reveló un stack de ingeniería que multiplica casi por 10 el rendimiento de procesamiento de OCRia-1 en una sola GPU B200 (alcanzando los 2.800 tok/s). La solución abarca cuantización de pocos bits, speculative decoding (dflash2) y Kernel Fusion, reduciendo drásticamente los costes operativos de los Document Agents end-to-end. (Fuente: jerryjliu0)
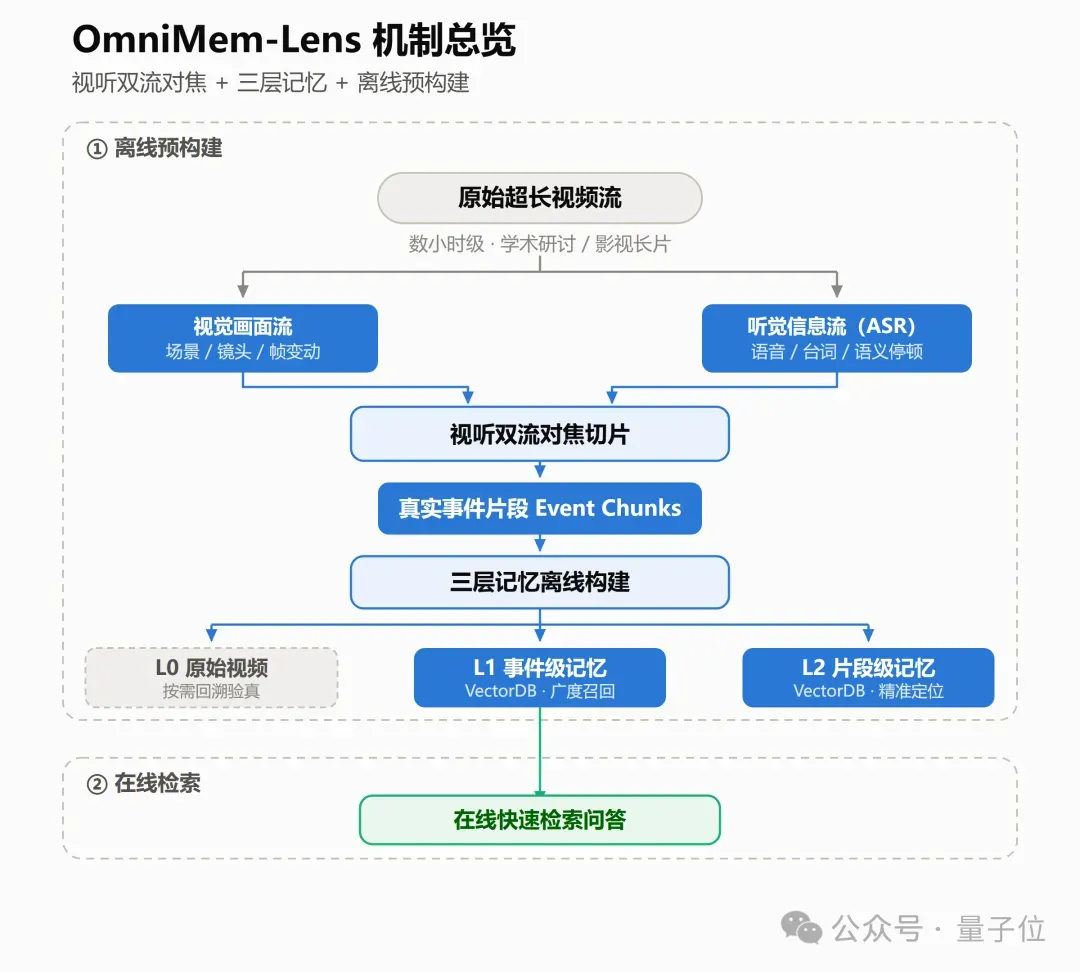
openJiuwen Agent-Memory 0.2.0: la lente de memoria audiovisual de doble flujo resuelve la fragmentación a ciegas de videos largos : El framework de memoria de código abierto openJiuwen lanzó su versión 0.2.0 introduciendo OmniMem-Lens. Frente al problema de segmentar videos largos por intervalos de tiempo fijos, lo cual rompe la causalidad y fragmenta el contexto, la herramienta enfoca de manera cruzada los cambios bruscos de escena con transiciones de temas semánticos de ASR, archivando los eventos reales por capas. En las evaluaciones de EgoLife-QA, la precisión de recuperación de memoria mejoró un 45,7% y la latencia en respuestas interactivas se redujo hasta en un 97%. (Fuente: 量子位)
Kairos: plataforma de control de riesgos antifraude en tiempo real y de código abierto que integra el modelo de decisión System One y MCP : Finic presentó Kairos, una plataforma de código abierto para control de riesgos en tiempo real concebida como alternativa a herramientas tradicionales como Sift. Para superar las limitaciones de los modelos GBDT clásicos, que dependen fuertemente del etiquetado histórico y son rápidamente eludidos por patrones delictivos, Kairos incorpora un modelo fundacional de decisión System One de baja latencia. Permite a los analistas definir reglas dinámicas directamente en lenguaje natural e incluye un servidor MCP integrado para que Coding Agents mantengan y evalúen de manera automatizada las combinaciones de estrategias. (Fuente: Hacker News)
Perplexity Computer implementa un sistema de plugins de automatización integral para e-commerce : Perplexity integró un ecosistema de Agent Plugins en su centro de cómputo automatizado Computer, permitiendo orquestar directamente paneles de administración de Shopify, campañas de email marketing en Klaviyo y anuncios en Meta. Con esto eleva las conexiones fragmentadas mediante APIs a una capa de aplicación con ejecución en bucle cerrado, materializando cadenas operativas de comercio electrónico totalmente automatizadas. (Fuente: AravSrinivas)
DeepSeek Harness lanza el plugin de interacción visual Baoyu Design : Para flujos de trabajo de diseño extensos, la comunidad desarrolló el plugin Baoyu Design para DeepSeek Harness. Proporciona una gestión unificada mediante paneles y vista previa con renderizado en tiempo real de Motion, permitiendo intervenir dinámicamente durante la planificación autónoma del Agent para generar presentaciones multidispositivo y animaciones de UI, mejorando sensiblemente la experiencia de feedback visual al generar componentes frontend complejos. (Fuente: dotey)
📚 Aprendizaje
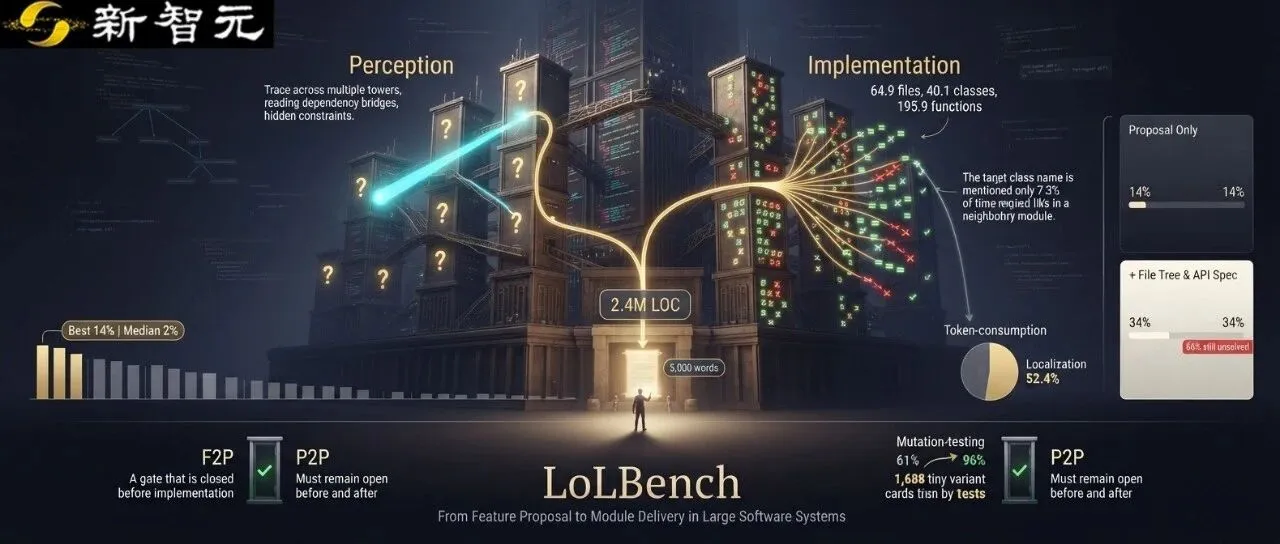
LoLBench: Fudan y otras instituciones presentan el primer benchmark de desarrollo de código a largo plazo en sistemas reales : La Universidad de Fudan y CUHK publicaron conjuntamente LoLBench, trasladando el escenario de evaluación desde la reparación de código local a la entrega funcional a nivel de módulos en bases de código con un promedio de 2,4 millones de líneas. Al probar 28 combinaciones punteras de Agents frente a propuestas reales de 5.000 palabras, la tasa de resolución máxima fue de solo el 14%, disipándose más del 50% de los recursos de cómputo en la mera localización de dependencias, lo que pone de relieve la profunda brecha actual de la IA en la cognición de ingeniería de sistemas complejos. (Fuente: WeChat)
DeepLearning.AI y Arize lanzan conjuntamente el curso gratuito “Evaluación y optimización práctica de agentes” : Ya está disponible la nueva clase abierta impartida por Laurie Voss, responsable de relaciones con desarrolladores en Arize. El curso aborda los retos de ingeniería en los que las pruebas unitarias tradicionales no logran cubrir las alucinaciones de decisión ni el uso indebido de herramientas por parte de los agentes. Demuestra de manera sistemática cómo extraer límites de fallo a partir de trazas de ejecución completas, diseñar evaluadores de código fiables y paneles arbitrales de LLM Judge, cerrando el ciclo de optimización impulsado por evaluación. (Fuente: )
Hugging Face propone un contrato de integración de modelos para Transformers: modelos microscópicos ligeros para blindar la integración en CI : Ante el elevado coste de ejecutar cientos de miles de pruebas de regresión diarias en GPUs para los más de 750 modelos de la librería Transformers, el equipo de HF presentó el estándar transformers-mic. Mediante Agents, se extraen configuraciones microscópicas representativas de las características clave de cada arquitectura, condensando modelos colosales en archivos de apenas decenas de megabytes con baselines de salida fijados, permitiendo que la integración continua (CI) bloquee bugs sutiles en segundos sobre ejecutores de CPU sumamente económicos. (Fuente: HuggingFace Blog)

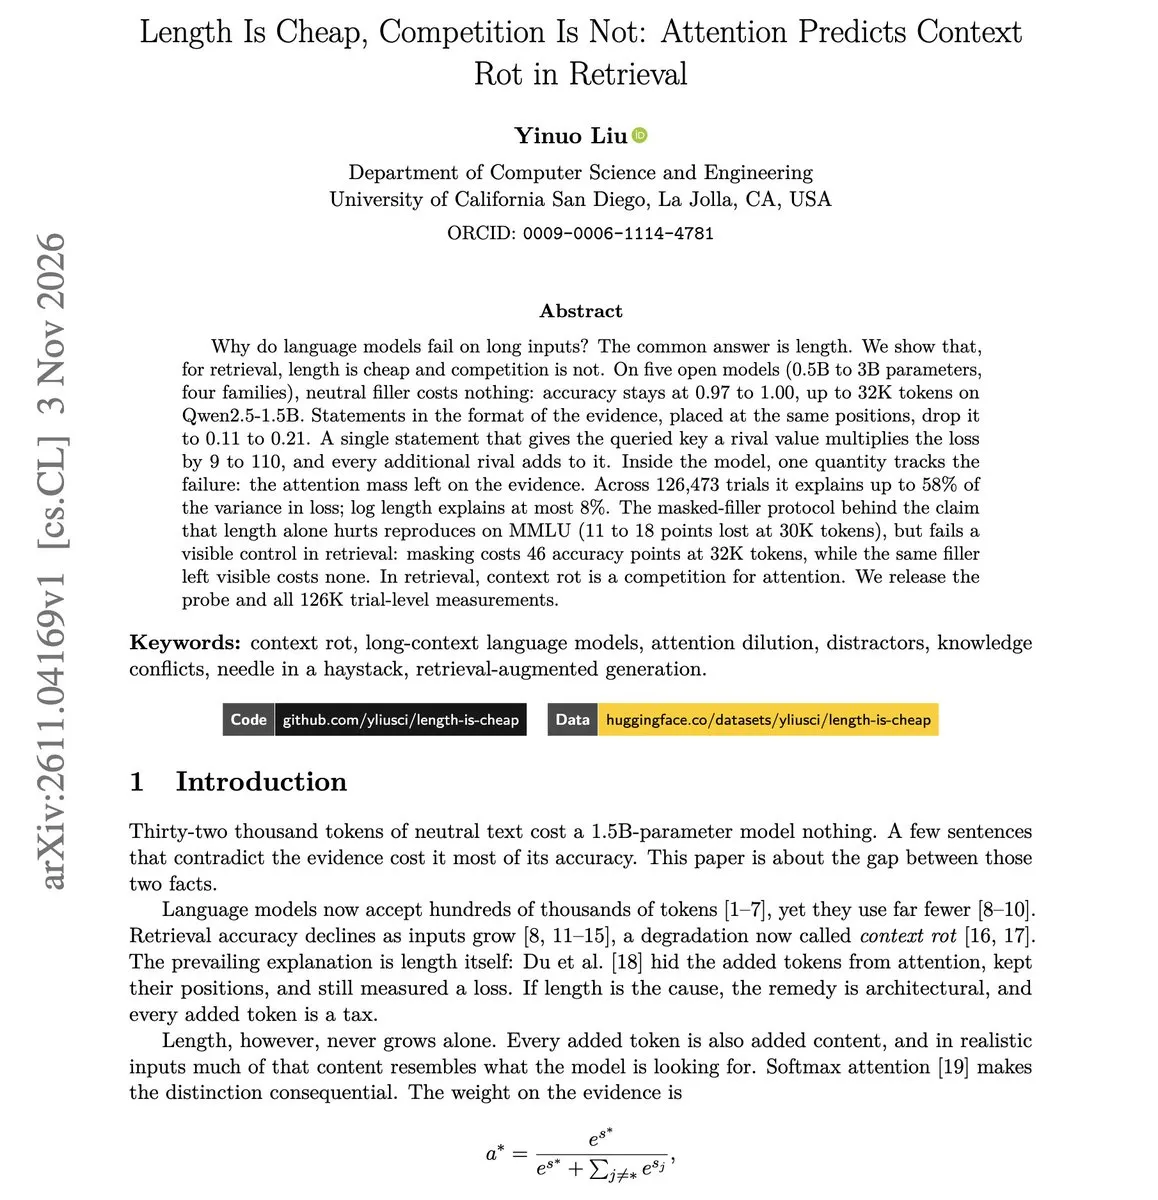
La causa raíz del fallo en la recuperación de textos largos: la interferencia competitiva supera con creces la degradación por longitud de entrada : Una investigación de la Universidad de California en San Diego señala que el factor determinante en los fallos de recuperación en RAG y modelos de contexto largo no es el aumento de la longitud de entrada, sino la presencia de “afirmaciones competidoras” con gran similitud textual a la respuesta correcta pero con valores numéricos erróneos. Las pruebas demostraron que esta información distractora dispersa directamente los pesos de atención del modelo, explicando el 58% de los errores de recuperación. (Fuente: dair_ai)
SpecPilot: descubrimiento adaptativo de algoritmos de optimización de speculative decoding mediante agentes : Para adaptarse a distintas arquitecturas de GPU y entornos de despliegue de modelos, un grupo de desarrolladores propuso el framework SpecPilot, que utiliza la colaboración multiagente para descubrir estrategias óptimas de speculative decoding. El sistema descubrió de forma autónoma una representación de pesos de 12 bits sin pérdidas y un mecanismo de verificación en árbol de dos niveles, elevando el factor de aceleración de decodificación por petición hasta 10,87 veces sin alterar la precisión. (Fuente: Reddit r/LocalLLaMA)
El blog técnico de NVIDIA detalla las tres claves para acelerar la inferencia MoE en el workstation de escritorio DGX Spark : El equipo de ingeniería de NVIDIA compartió sus prácticas de optimización para la decodificación monousuario de Ling-3.0-flash (un MoE de 124B) en la estación de trabajo DGX Spark basada en arquitectura GB10. Al combinar la compilación dinámica de kernels Humming, la cuantización FP8 en tiempo de carga de la LM Head y el muestreo especulativo Multi-Token Prediction (MTP), lograron incrementar el rendimiento de decodificación en GSM8K un 42,5% manteniendo intacta la precisión en benchmarks matemáticos. (Fuente: MarkTechPost)
El “Tutorial de modelos generativos de audio y música” analiza exhaustivamente el panorama tecnológico de vanguardia y las disputas legales : Un nuevo artículo de revisión desglosa detalladamente el stack tecnológico de la IA musical moderna: abarca códecs de audio neuronales (Audio Codec), modelado autorregresivo de tokens, algoritmos de aceleración mediante difusión y Flow Matching, así como paradigmas de alineación con preferencias humanas para sistemas de acompañamiento en tiempo real. Además, analiza casos emblemáticos de infracción jurídica para examinar los estándares del sector en trazabilidad de derechos de autor en datos de entrenamiento y marcas de agua de audio para autenticación. (Fuente: HuggingFace Daily Papers)
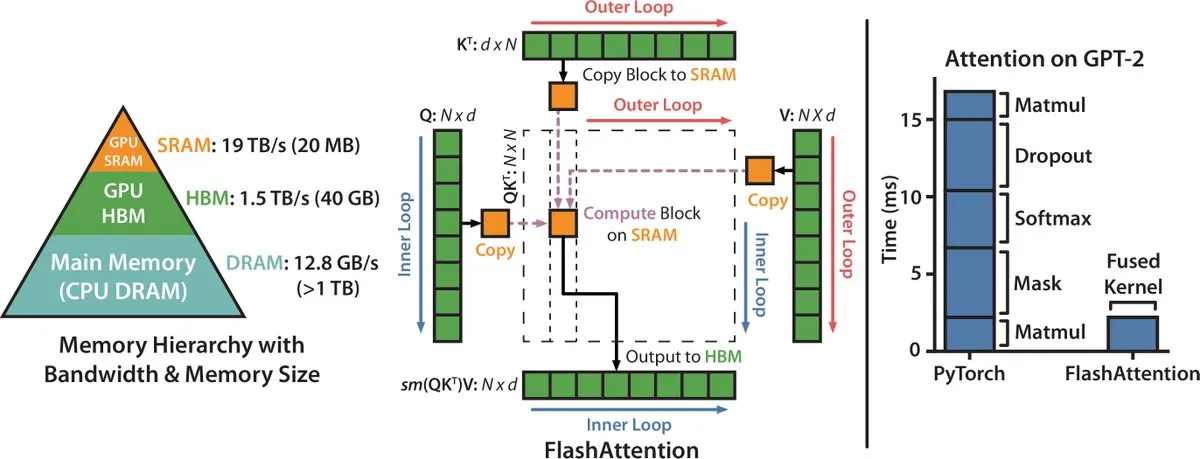
Resumen de ingeniería de microarquitectura: 10 artículos fundamentales de optimización de GPU que impulsan la aceleración de LLMs : Miembros de la industria recopilaron 10 artículos clásicos de ingeniería de kernels de bajo nivel, que van desde FlashAttention-1/2/3 y PagedAttention hasta MARLIN y FlashInfer. En ellos se desglosan sistemáticamente técnicas como el tiling en SRAM, la normalización online de Softmax y el solapamiento de cómputo asíncrono, sirviendo de referencia teórica para el desarrollo de runtimes de Agents de alto rendimiento. (Fuente: NandoDF)
💼 Negocios
La startup de inferencia multimodal de IA Fal recauda 1.300 millones de dólares y duplica su valoración a 16.000 millones : Fal, startup especializada en servicios de inferencia de alta concurrencia para modelos de código abierto de audio y video, anunció el cierre de rondas de financiación Serie E/F por un total de 1.650 millones de dólares, con la última ronda liderada por Bessemer y con participación de NVIDIA, elevando su valoración a 16.000 millones de dólares. A pesar de que los costes de alquiler de cómputo presionan a la baja el margen bruto de inferencia, el auge en la adopción de modelos abiertos ha impulsado sus ingresos anualizados por encima de la barrera de los 800 millones de dólares. (Fuente: TechCrunch)
El unicornio de diseño Canva anuncia una reestructuración global, recortando y reubicando más de 1.200 puestos : El gigante australiano del diseño Canva, valorado en su momento en 40.000 millones de dólares, anunció la reestructuración más dura de sus 13 años de historia, afectando a 1.271 empleados (el 22% de su plantilla mundial). La empresa busca aplanar su estructura organizativa y concentrar los equipos en hubs estratégicos para responder al impacto transformador de las herramientas de generación de imágenes y maquetación nativas de IA. (Fuente: The Guardian)

El gigante corporativo de Linux SUSE anuncia un recorte de plantilla del 10%, atribuyéndolo explícitamente a la reestructuración por IA y automatización : Correos internos de SUSE, el referente europeo del código abierto, revelaron que la compañía despedirá a cerca del 10% de sus casi 2.000 empleados globales. En la misiva, su CEO señaló directamente que las herramientas de automatización e IA se han integrado de forma profunda en los flujos diarios de trabajo, reduciendo sustancialmente los costes operativos en ciertos roles preexistentes, y que la antigua estructura de personal y costes ya no resultaba viable para mantener la competitividad a largo plazo, obligando a una reconversión de perfiles en la industria del software tradicional. (Fuente: ZDNet)
🌟 Comunidad
GitBook sufre un ataque dirigido por AI Agents que desconecta sus servicios: las credenciales de la cadena de suministro de agentes, en alerta : La plataforma de documentación GitBook comunicó haber sufrido un ciberataque dirigido y altamente automatizado perpetrado por AI Agents. Los atacantes vulneraron la infraestructura, obteniendo credenciales de API parciales, claves de sincronización Git e historiales de preguntas y respuestas de su asistente inteligente. La empresa desconectó de urgencia el servicio, revocó todos los tokens personales de los usuarios y forzó el restablecimiento de credenciales de integraciones y servicios MCP, evidenciando una vez más el peligro extremo que representa la penetración autónoma por agentes para la cadena de suministro en la nube. (Fuente: Hacker News)
La App Store de Apple actualiza sus reglas: clasificación obligatoria de 18+ para aplicaciones de compañía emocional con IA : Apple emitió una actualización de políticas para desarrolladores de todo el mundo, exigiendo que toda aplicación de IA con interacciones románticas, insinuaciones sexuales o funciones de acompañamiento afectivo (como Character.AI o Replika) pase obligatoriamente a una clasificación de edad de 18+ antes de mediados de noviembre. La comunidad debate cómo Apple, ante las estrictas leyes de protección de menores promulgadas en múltiples países, endurece sus límites regulatorios frente a la manipulación emocional antropomórfica y las relaciones íntimas simuladas. (Fuente: TechCrunch)
La salida de Cat Wu, líder de producto de Claude Code, desata debates sobre la inestabilidad en el equipo : Tras la partida de varios ingenieros clave, la fundadora y líder de producto responsable del lanzamiento de Claude Code y Cowork, Cat Wu, anunció su marcha de Anthropic. La comunidad ha prestado gran atención a su metodología del “principio de obsolescencia a los tres meses” y a su marco de exploración ágil, pero los continuos relevos directivos a corto plazo han generado interrogantes externos sobre la gobernanza y la presión en I+D dentro del unicornio antes de su salida a bolsa. (Fuente: dotey)
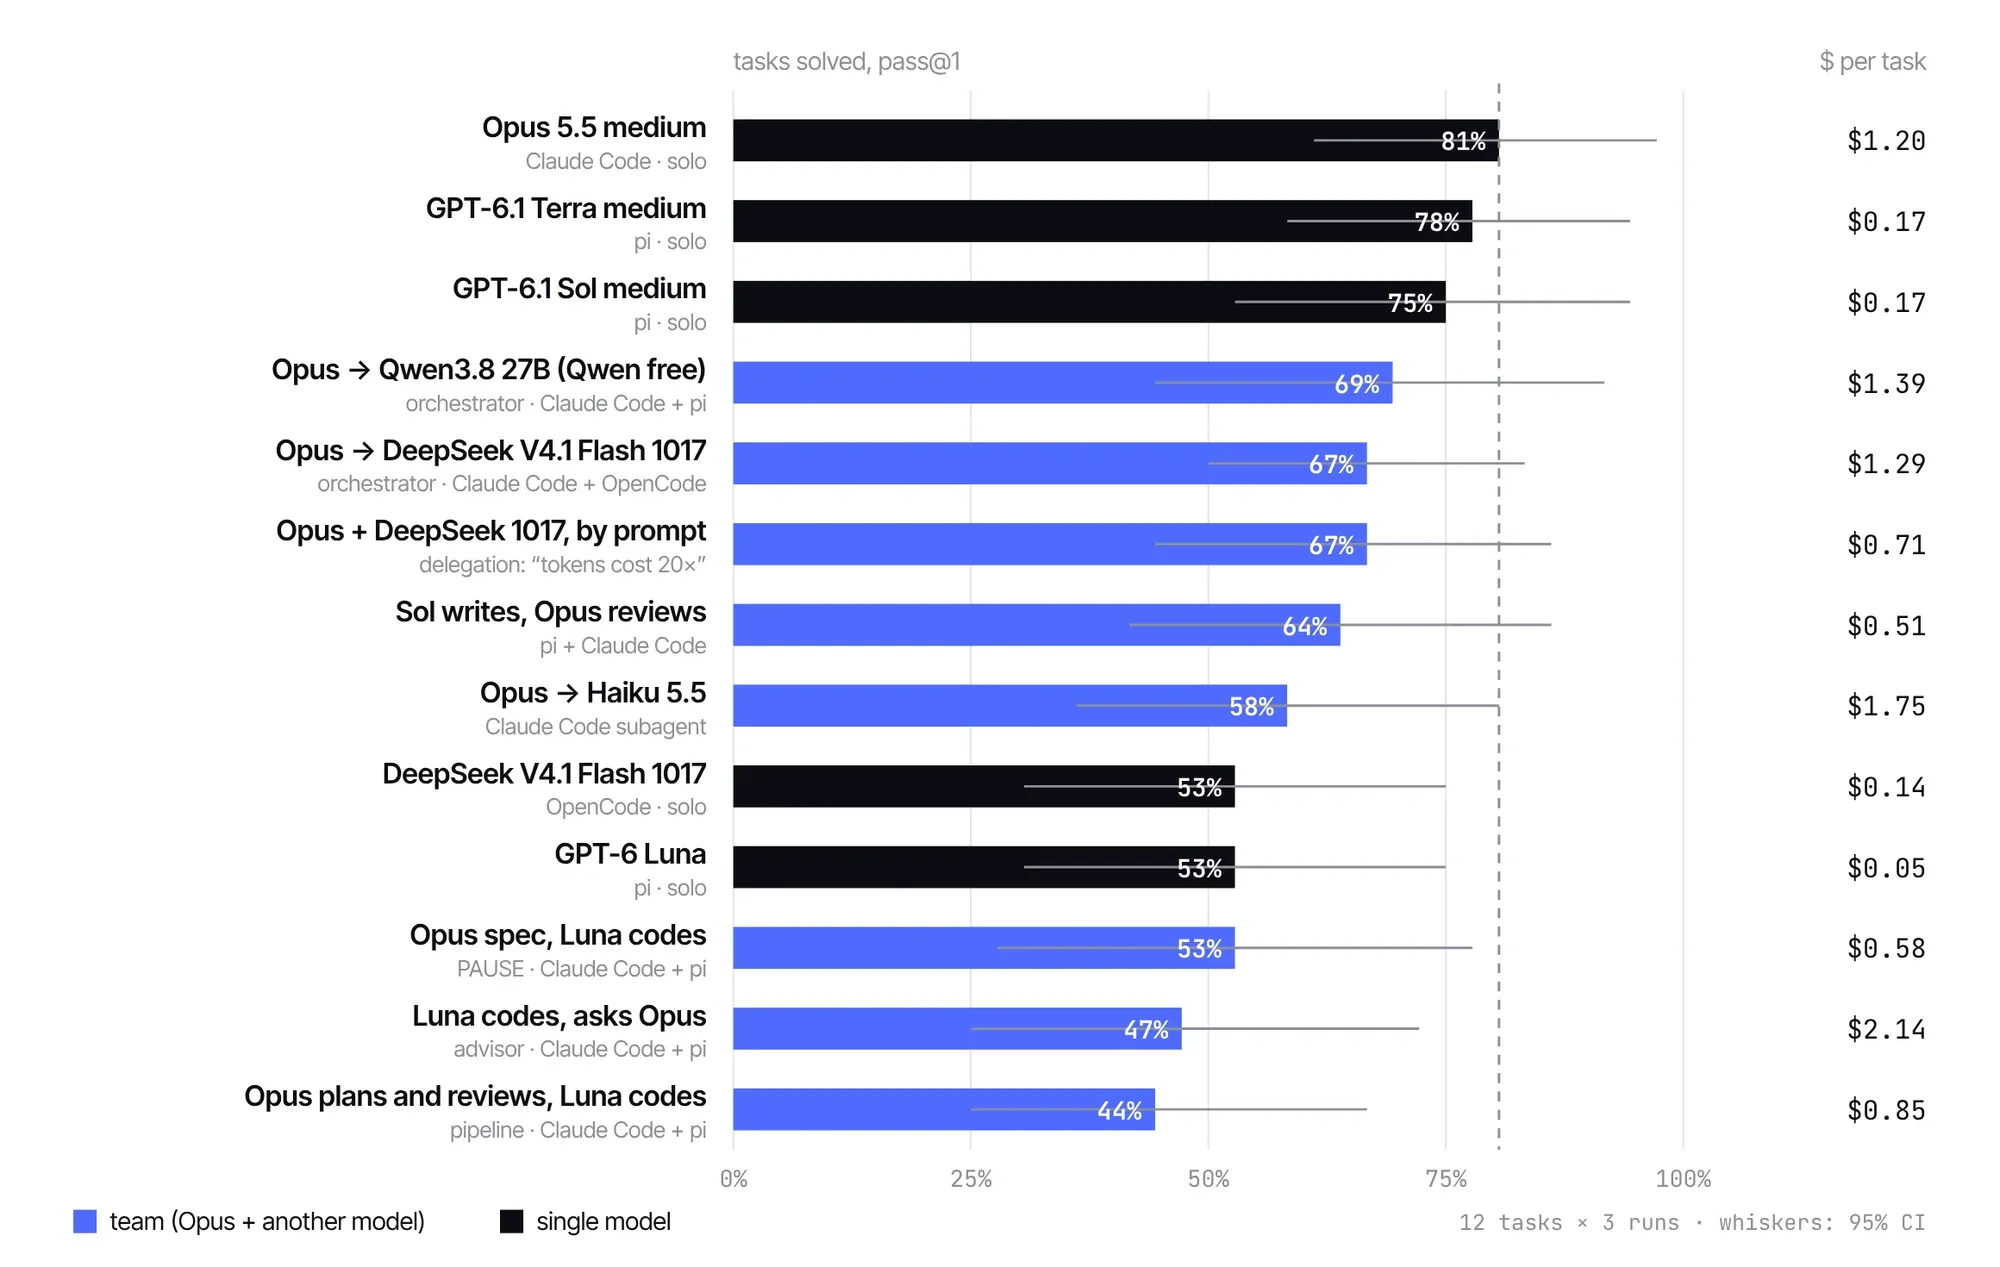
La arquitectura de “orquestador costoso + subagentes económicos” sufre un revés de costes en la práctica : Pruebas prácticas de la comunidad revelaron que encomendar la descomposición de tareas a modelos de vanguardia caros como Opus y delegar la codificación en modelos abiertos económicos suele provocar, en tareas complejas de ingeniería, costes totales y tiempos que superan la generación directa de un único modelo puntero. El constante reenvío de contextos repetidos, los conflictos tras múltiples rondas de revisión y la invalidación de caché han puesto en duda la utilidad práctica de “apilar equipos pequeños de agentes” en escenarios de programación. (Fuente: Reddit r/ClaudeAI)
Se revela que las cuentas personales de pago de Gemini activan por defecto el entrenamiento con datos de chat, desatando controversias de privacidad : Un hilo viral en Hacker News expuso que, aun contando con una suscripción de pago a Google AI, el historial de conversaciones de Gemini en cuentas personales sigue autorizado por defecto en segundo plano para entrenar modelos base, pudiendo ser revisado por personal humano y conservado hasta por tres años a menos que el usuario desactive por completo el historial. Este hecho quiebra la noción común de que pagar garantiza privacidad, provocando enérgicas protestas entre los desarrolladores respecto a la transparencia de los términos de servicio de las grandes tecnológicas. (Fuente: Hacker News)
Pruebas prácticas de desarrolladores revelan que “ejecutar LLMs en local no equivale a seguridad de datos”: instrucciones maliciosas pueden robar información mediante escalada de privilegios : Frente a la creencia extendida de que “desplegar LLMs en local y offline” actúa como escudo definitivo de privacidad, estudios de seguridad señalan que, al ejecutar pesos no auditados o modelos de código abierto con inyecciones de prompts ocultas, el modelo aún puede generar payloads de red que intenten transferir datos a la nube si existen brechas de permisos en el sandbox. Los desarrolladores instan a imponer un aislamiento de red estricto en los entornos de ejecución locales de agentes. (Fuente: KDnuggets)
El padrino de la IA Geoffrey Hinton advierte de nuevo: la humanidad podría arrepentirse en el futuro de haber inventado la IA : En vísperas del estreno de un documental sobre su trayectoria, el premio Nobel de Física Geoffrey Hinton concedió una entrevista exclusiva en la que afirmó sin rodeos que los líderes tecnológicos están ignorando riesgos de seguridad gigantescos en pos de la carrera comercial. Advirtió de que es altamente probable que en los próximos uno o dos años ocurra un incidente de alerta estilo “Chernóbil” provocado por la IA —como la caída masiva de redes eléctricas o la interrupción de sistemas de compensación financiera—, reiterando la urgencia de establecer un marco regulatorio obligatorio e independiente de acceso al mercado para modelos de frontera similar a la FDA. (Fuente: The Guardian)

💡 Otros
Binance revela detalles de la investigación del robo hacker de 6.300 millones de dólares: entrevistas de trabajo falsas por videollamada y herramientas internas de IA sirvieron de trampolín para la infiltración : Binance publicó el informe de trazabilidad sobre el incidente de robo de la semana pasada: los atacantes identificaron la identidad del equipo de operaciones desde junio mediante malware, contactaron a ingenieros en septiembre a través de redes profesionales haciéndose pasar por headhunters reconocidos y los indujeron a descargar troyanos durante una segunda ronda de entrevistas por videollamada. Posteriormente, aprovecharon los privilegios de los asistentes de IA internos para escalar privilegios de forma lateral y sustraer criptomonedas mediante scripts. Hasta la fecha, se han interceptado o congelado 2.850 millones de dólares en activos. (Fuente: The Guardian)

OpenAI nombra al exsecretario del Ejército Dan Driscoll como asesor sénior para la modernización de la seguridad nacional : OpenAI incorporó formalmente a Dan Driscoll, exsecretario civil del Ejército de los EE. UU. Con anterioridad, Driscoll lideró en el ámbito militar presupuestos clave y la implementación del proyecto de IA táctica ARIA, manteniendo una sólida red de contactos con líderes de ambos partidos. Este movimiento refleja la estrategia activa de OpenAI para amortiguar la recomposición de poder en Washington tras las elecciones de medio mandato y acelerar su inserción comercial en redes clasificadas del Pentágono y en las cadenas de suministro de defensa de aliados internacionales. (Fuente: THE DECODER)
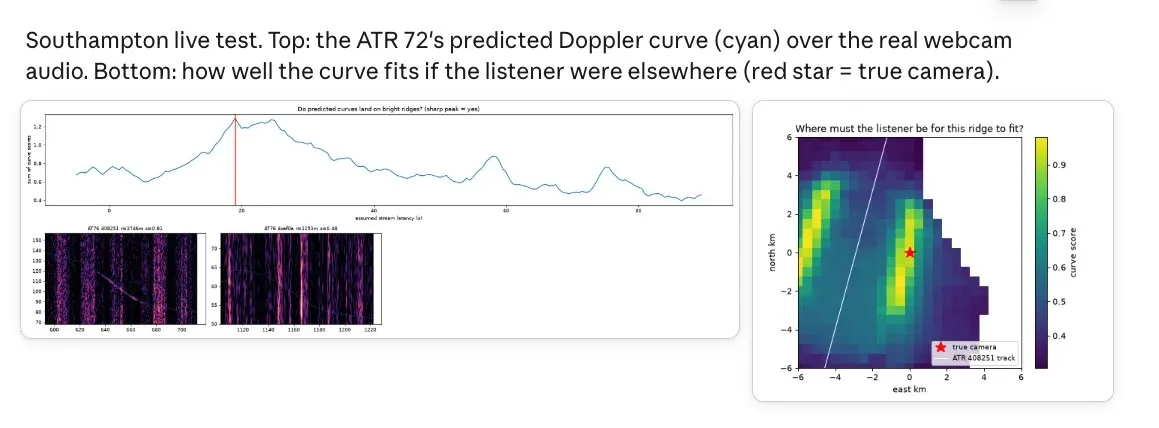
El desplazamiento Doppler de sonido combinado con datos de trayectorias de vuelo permite la geolocalización imperceptible en videos : Varios investigadores mostraron una técnica que compara la curva de desplazamiento Doppler acústico de aviones grabados en el audio ambiental con registros públicos de trayectorias de vuelo para deducir las coordenadas geográficas reales donde se filmó un video. Desarrolladores de la comunidad replicaron con rapidez el algoritmo en código, abriendo un nuevo debate técnico sobre la privacidad frente a filtraciones involuntarias a través del sonido. (Fuente: jpt401)