🔥 Fokus
Google erzwingt AI-Bündelung für K-12-Bildungseinrichtungen: Deaktivierung von Schüler-AI-Funktionen kappt zeitgleich Zugriff auf Google Search : Google hat eine Anpassung seiner Bildungsproduktstrategie für weltweite K-12-Schulen angekündigt. Gemini und Google Search sind standardmäßig deaktiviert und müssen von Schulen manuell aktiviert werden. Google stellte jedoch klar, dass die AI-Funktionen tief mit der Suchmaschine gekoppelt sind: Sollten Schulen die AI-Funktionen deaktivieren, verlieren Schüler vollständig den Zugriff auf Google Search. Diese Entscheidung löste in Schulbezirken wie New York und Los Angeles sowie im gesamten Bildungssektor heftige Gegenreaktionen aus. Kritiker werfen Google vor, seine Suchmonopolstellung auszunutzen, um dem öffentlichen Bildungswesen Knebelverträge aufzuerlegen und den Schulen die Autonomie zu entziehen, um kommerzielle AI-Tools durchzusetzen. (Quelle: The Verge, The Guardian)

Anthropic veröffentlicht Open-Source-System FlashProve und realisiert erstmals „Zero-Knowledge kryptografisch verifizierbare Inferenz“ für Large Models : Anthropic hat den leichtgewichtigen zkSNARK-Forschungsprototypen FlashProve als Open Source bereitgestellt, der über Zero-Knowledge-Beweise und formale Verifikation in Lean 4 mathematisch fälschungssichere Nachweise für Inferenz-Ergebnisse von Large Models generiert. Auf einem 400B MoE-Modell (Llama 4 Maverick) erreicht das System auf einer einzelnen H100-GPU einen Beweis-Durchsatz von etwa 110 tok/s; die Generierung eines ca. 19 MB großen Nachweises lässt sich von einer herkömmlichen CPU in nur 17 Sekunden unabhängig verifizieren. Dieser Durchbruch adressiert Vertrauensprobleme wie Third-Party-API-Missbrauch, heimliche Modell-Downgrades und Man-in-the-Middle-Manipulationen und hebt vertrauenswürdige Audits sowie Verifikation von Frontier-Modell-Inferenzen von bloßen Anbieterversprechen auf das Niveau harter kryptografischer Verifikation. (Quelle: AnthropicAI, TechCrunch, MarkTechPost)
US-Midterms entfachen „Politik der Recheninfrastruktur“: Stimmungsumschwung in Texas und Ohio : Bei den US-Midterms 2026 rückten AI-Data-Center und energieintensive Infrastrukturen überraschend in den Fokus des Wahlkampfs; in rund 40 Wahlbezirken landesweit wurde über Baustopps für Data Center abgestimmt. Im rechenzentrendichten Texas gewannen Kandidaten Schlüsselmandate, die sich für ein Moratorium bei Data-Center-Genehmigungen und eine „AI-Dividende“ einsetzten; in Ohio scheiterten Befürworter einer aggressiven Expansion. Der massive Widerstand der Wähler gegen explodierende Stromkosten und Wasserknappheit zwang Tech-Konzerne zu PR-Kampagnen zur Umbenennung von Rechenparks und beschleunigte den Zukauf eigener Gasturbinen, um Genehmigungsengpässe der öffentlichen Stromnetze zu umgehen. (Quelle: The Verge, EthanJPerez)
Apple öffnet App Intents Extension Preview: Siri AI bewegt sich auf app-übergreifende globale Agenten-Orchestrierung zu : Apple hat eine neue Vorschauversion von App Intents für Entwickler bereitgestellt, die es Drittanbieter-Apps ermöglicht, tiefgehende Aktionen und Daten direkt für Siri AI freizugeben. Dieses Update hebt frühere Beschränkungen auf vordefinierte Domains auf und ermöglicht es Siri, komplexe Absichten direkt zu verstehen und mehrstufige Interaktionen über verschiedene Apps hinweg auszuführen. Branchenexperten sehen in der vollständigen Öffnung der zugrunde liegenden APIs den Übergang von punktuellen Feature-Erweiterungen hin zu einem systemweiten, globalen Agent. (Quelle: kylebrussell)
OpenAI vermeldet Durchbrüche im AI-gestützten Hardware-Design und veröffentlicht Langzeitlebens-Benchmark LifeVal : OpenAI hat den neuen Benchmark LifeVal veröffentlicht, der anhand realer Konversationsverläufe und mehrstufiger Aktionsumgebungen speziell evaluiert, wie Agenten hochwertige, langfristige persönliche Aufgaben wie häusliche Pflege und institutionsübergreifende Koordination bewältigen. Zudem gab OpenAI bekannt, dass ein unveröffentlichtes Modell im Engineering-Benchmark BenchCAD 2.0 eine Spitzenpunktzahl von 87,5 % erzielte, und präsentierte einen sprachgesteuerten Codex-Desktop-Hardwareprototypen, der von GPT-6 Astra innerhalb einer Woche ohne direktes menschliches Eingreifen autonom entworfen wurde. (Quelle: OpenAI)
🎯 Entwicklungen
Tencent Hunyuan stellt 770B-Flaggschiffmodell Hy4 vor und plant Open-Source-Release bei bewusster Einschränkung von Cyberangriffs-Fähigkeiten : Tencent Hunyuan hat die neue Generation seines 770B-Basis-Large-Language-Modells Hy4 vorgestellt, das erstmals visuelles Verständnis und Computer-Use-Fähigkeiten nativ integriert und hybride Steuerungen über Kommandozeile und GUI unterstützt. Das Modell erzielte im APEX-Agents-Benchmark 75,2 Punkte; Modellgewichte und Systemkarten sollen als Open Source veröffentlicht werden. Bemerkenswert ist, dass Tencent im Training offensive Daten wie Exploit-Entwicklung bewusst gefiltert und lediglich Fähigkeiten zur Code-Korrektur und Defensivanalyse beibehalten hat, was eine vorsichtige Selbstregulierung unter zunehmendem Regulierungsdruck demonstriert. (Quelle: 机器之心, kimmonismus)

Baidu Apollo präsentiert Weltmodell ApolloWorld für Physical AI : Baidu Apollo hat das erste agentengesteuerte, all-modale Weltmodell ApolloWorld für Physical AI vorgestellt. Die Architektur überwindet die Limitierung traditioneller Weltmodelle, die lediglich kurze Videos generieren und kaum Interaktionen bieten, indem sie gleichzeitig Multi-View-Videos und 3D-LiDAR-Punktwolken erzeugt. Fußgänger und Fahrzeuge werden als autonome Simulationsagenten modelliert, sodass autonome Fahrsysteme über 100.000 Kilometer geschlossene Simulationen und risikoreiche Spieltheorie-Szenarien pro Tag durchlaufen können. (Quelle: WeChat)
Shanghai Chuangzhi Academy und Xinxu Intelligence veröffentlichen 801-30B: Erster technischer Bericht zu rekursiver Selbstverbesserung auf Pre-Training-Ebene : Ein gemeinsames Forschungsteam hat das Basismodell 801-30B samt technischem Bericht als Open Source veröffentlicht und damit das Paradigma durchbrochen, RSI ausschließlich auf Post-Training-Fine-Tuning zu beschränken. Das Team gliederte den Pre-Training-Prozess in drei geschlossene Regelkreise aus Debugging, Potenzial und Erfahrungsquantifizierung, wodurch experimentelle F&E-Erfahrungen in ein akkumulierbares organisatorisches Parametergedächtnis überführt werden. Nach nur leichtem SFT nähert sich 801-30B in mehreren Benchmarks der Spitzenklasse vergleichbarer Modellgrößen an und belegt das Potenzial von AI zur Optimierung industrieller Pre-Training-Pipelines. (Quelle: 机器之心)

Princeton AI Lab stellt Spatial-Intelligence-Benchmark SSoN vor: Gravierende Defizite von Large Models bei blickwinkelübergreifender geometrischer Inferenz : Princeton hat den Benchmark Same Space or Not mit 1.000 statischen Szenenaufgaben entwickelt, bei dem Modelle beurteilen müssen, ob Innenaufnahmen aus verschiedenen Blickwinkeln zum selben, unveränderten Raum gehören. Während Menschen eine Genauigkeit von 83,3 % erzielen, erreicht das Spitzenmodell GPT-6 Astra lediglich 39,7 %; die meisten anderen führenden VLMs bleiben unter der Zufallsschwelle von 25 %. Modelle scheitern insbesondere bei Objektverschiebungen und 3D-Perspektivwechseln, was zeigt, dass reines optisches Musterabgleichen kein echtes räumlich-geometrisches Verständnis darstellt. (Quelle: 机器之心, 36氪)

Fudan und CUHK präsentieren ReTerm: Rekursive Selbstverbesserung von Code Agents gesteuert durch Fehlerszenarien : Um das Problem zu beheben, dass Terminal-Code-Agenten häufig in Trial-and-Error-Schleifen feststecken, hat ein Forschungsteam das ReTerm-Framework entwickelt. Das System bewahrt die kontaminierte Umgebung und die realen Aktionspfade nach einem Fehlschlag vollständig auf, damit der Agent darauf basierend alternative Wiederherstellungspfade erkunden kann; der Erfolg dieser Wiederherstellung dient als Belohnungssignal für das Reinforcement Learning. Experimente zeigen, dass ein 9B-Modell die Erfolgsquote im Terminal-Bench 2.0 um 14,6 % steigern konnte, was belegt, dass das Lernen aus realen Fehlerszenarien die Systemresilienz maßgeblich stärkt. (Quelle: 机器之心)

WeChat Vision Team veröffentlicht Open-Source-Modell WeVisOne-VL: Nativer Pixel-Decoder vereinheitlicht Objekterkennung und hochpräzises Freistellen : Das WeChat Vision Team von Tencent hat das multimodale Modell WeVisOne-VL (2B/4B) veröffentlicht. Ohne Abhängigkeit von externen SAM-Modellen integriert es einen nativen Pixel-Decoder mit 9,6M Parametern, der in einem einzigen Forward Pass Bounding Boxes, OCR, Instanzsegmentierungsmasken und kontinuierliche Alpha-Matting-Masken ausgibt. In den Benchmarks Dense200 und ReasonSeg übertrifft die 4B-Version bestehende Spezialmodelle deutlich und vereinfacht geräteseitige Vision-Pipelines erheblich. (Quelle: MarkTechPost)
Agibot führt Worken-Metrik ein und meldet über 20.000 produzierte universelle Roboter : Auf seinem Innovationstag stellte Agibot das Konzept „Worken (effektive intelligente Arbeitsstunden)“ vor, um rein aktionsbasierte Parameter durch Kriterien wie aktive Einheiten, autonome Laufzeit und Output-Effizienz abzulösen. Zugleich wurden das Embodied-Basismodell GO-3 Preview und das Interaktionsmodell WITA-OMNI präsentiert. Agibot gab bekannt, dass die Zahl ausgelieferter universeller Roboter die Marke von 20.000 Einheiten überschritten hat, und betonte, dass industrielle Konsistenz und reale Daten-Flywheels die Kernvoraussetzungen für den kommerziellen Rollout von Physical AI bilden. (Quelle: 36氪)
ByteDance veröffentlicht gemeinsam mit der Community das 35B-Agenten-Basismodell Axion 1.0 : ByteDance hat gemeinsam mit der Community das Axion 1.0 35B Modell als Open Source bereitgestellt. Durch den Verzicht auf komplexe Zwischenschritte und DPO nutzt das Modell lediglich ein zweistufiges, leichtgewichtiges SFT und gezieltes Reinforcement Learning zur tiefen Anbindung an externe Werkzeugketten. Datensynthese, Bereinigungspipelines, Trainingscode und Gewichte wurden vollständig offengelegt und bieten eine schlanke Referenz für den kosteneffizienten Aufbau hochentwickelter Agenten-Infrastrukturen. (Quelle: _lewtun)
Stanford-Studie enthüllt „Halbwertszeit der Large-Model-Forschung“: 44 % empirischer Erkenntnisse innerhalb von 15 Monaten überholt : Ein Team der Stanford University reproduzierte 50 vielzitierte Studien der letzten zwei Jahre zu LLM-Fähigkeiten und stellte fest, dass 44 % bei aktuellen Modellen bereits obsolet sind – die durchschnittliche Lebensdauer beträgt lediglich 15,7 Monate. Erkenntnisse darüber, „was Modelle nicht können“ (wie Reversal Curse oder Lost in the Middle), veralten am schnellsten; soziologische Tendenzen wie Sycophancy oder Evaluations-Biases bleiben hingegen länger stabil. Die Studie warnt davor, Benchmarks für Large Models als unveränderlich zu betrachten. (Quelle: THE DECODER)
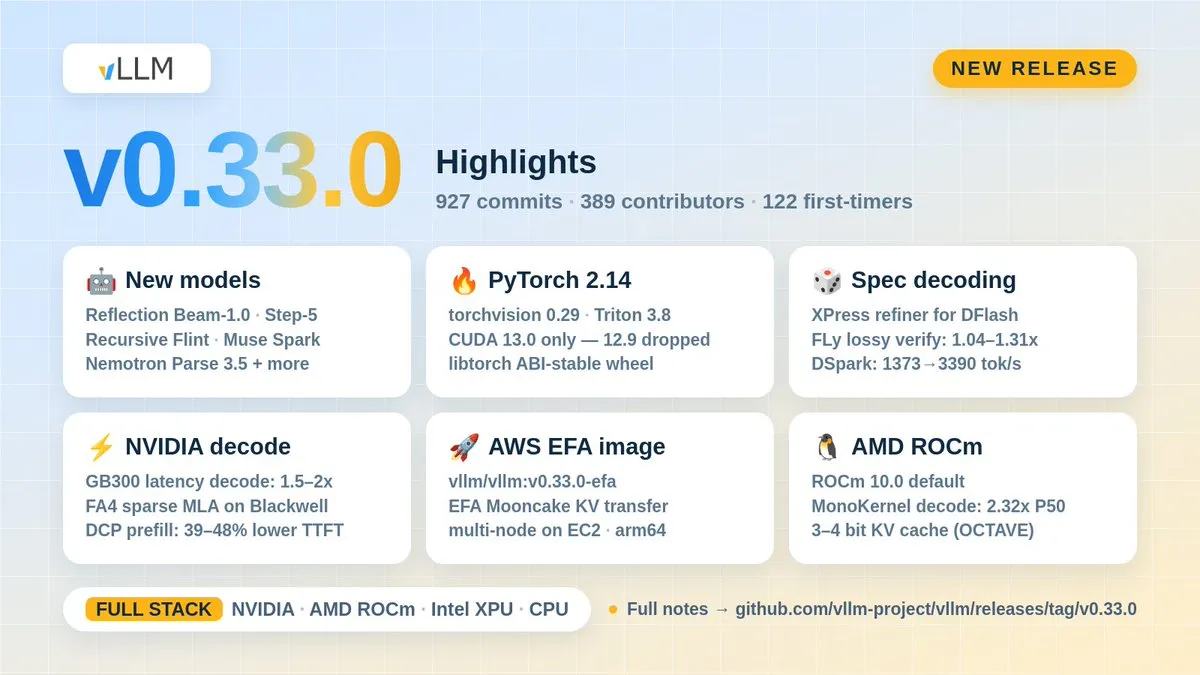
vLLM veröffentlicht v0.33.0: Volle Kompatibilität mit PyTorch 2.14 und CUDA 13 : Das Open-Source-Inferenz-Framework vLLM hat Version v0.33.0 herausgebracht. Die Integration der FA4 Sparse MLA Architektur senkt die TTFT um bis zu 48 %, während neue spekulative Dekodieralgorithmen wie XPress und FLy auf GB300-Chips eine 1,5- bis 2-fache Beschleunigung der Dekodierung ermöglichen, was Durchsatz und VRAM-Effizienz in hochparallelen Produktionsumgebungen deutlich verbessert. (Quelle: vllm_project)
AllenAI veröffentlicht StateBench: Langdokument-Zustandsverfolgung bricht Inferenzketten moderner Modelle : Das Allen Institute for AI hat StateBench vorgestellt, einen Benchmark zur Bewertung der Zustandsverfolgung von Entitäten über lange Dokumente hinweg. Die Aufgaben basieren auf Gruppentheorie; Messungen zeigen, dass führende Modelle wie GPT-6 und Claude bei langen Kettenaufgaben mit komplexen Zuweisungen und bidirektionalem Austausch auf unter 13 % Genauigkeit einbrechen. Modelle mit konstanten rekurrenten Gedächtnismechanismen wiesen dabei eine überlegene Extrapolationsfähigkeit bei langen Sequenzen auf. (Quelle: HuggingFace Blog)
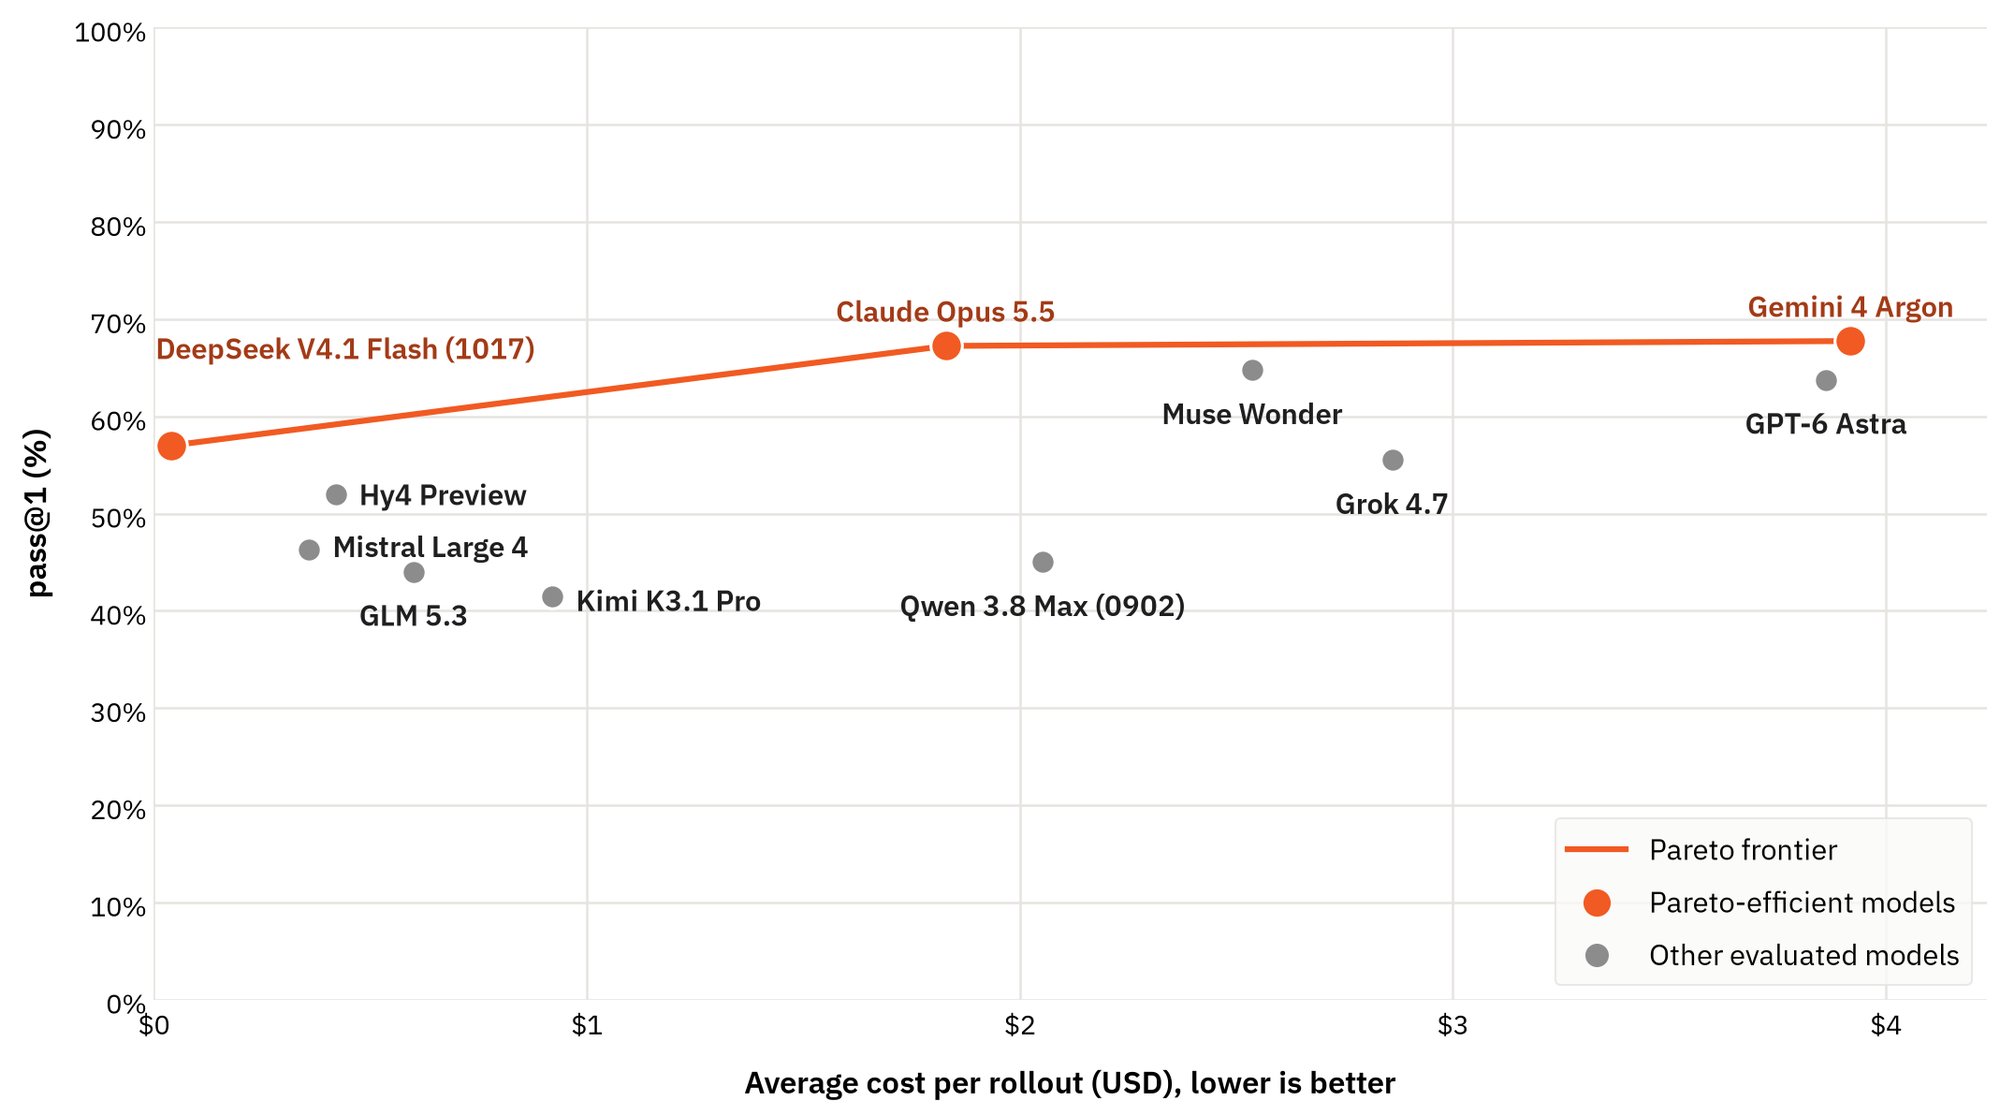
Collinear AI veröffentlicht CWE-bench v2: Programmatische Evaluierung moderner Software-Sicherheit : Collinear AI hat den Code-Sicherheits-Benchmark CWE-bench v2 als Open Source veröffentlicht. Er deckt 91 Common Weakness Enumerations (CWE) ab und verlangt von AI-Agenten, Schwachstellen in realen Repositories autonom zu identifizieren und zu beheben, ohne bestehende Funktionalitäten zu beeinträchtigen. Gemini 4 Argon und Claude Opus 5.5 führen das Feld mit einer pass@1-Rate von rund 67 % an; bei komplexen Long-Tail-Angriffsszenarien scheitern jedoch weiterhin fast 20 % der Testfälle vollständig. (Quelle: HuggingFace Blog)
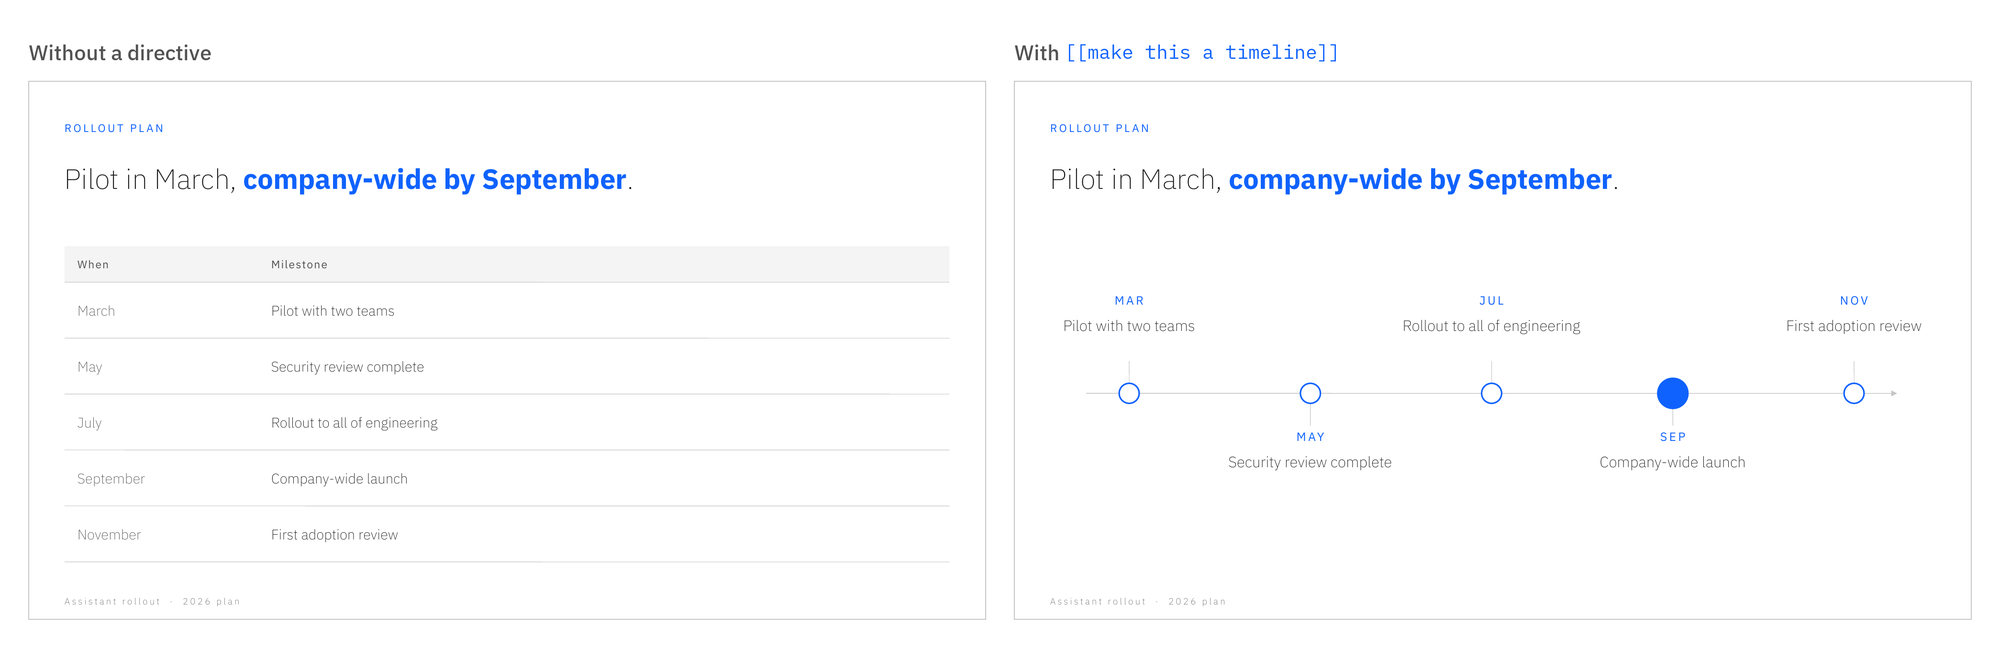
IBM Research stellt Palette vor: 20B-Kompaktmodell beherrscht Enterprise-Designvorgaben zur Erzeugung nativer Präsentationen : IBM Research hat das 20B-Parameter-Modell Palette entwickelt, das auf einer dualen LoRA-Architektur für „Designer“ und „Code-Writer“ basiert. Diese teilen sich narrative Planung und Frontend-Code-Layout via PptxGenJS auf; eine geometrische Sandbox behebt Überlappungen und Layoutfehler automatisch. In PresentBench übertrifft Palette die meisten proprietären Large Models und ermöglicht ein vollständig lokales Offline-Deployment. (Quelle: HuggingFace Blog)
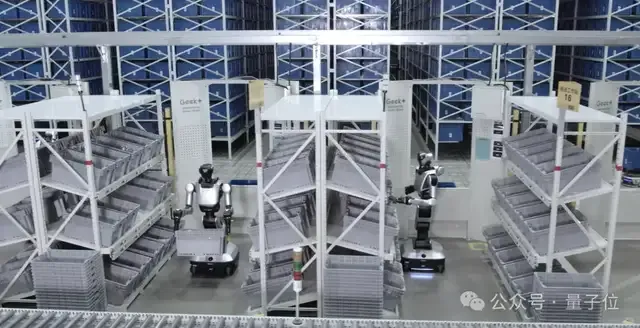
Geek+ stellt „24/7 Autonomen Smart-Warehouse-Plan“ vor: Vorstoß in Schwarmkoordination über MoT-Dual-Brain-Architektur : Der Logistikroboter-Hersteller Geek+ hat seine Roadmap für autonome Smart Warehouses vorgestellt. Das hauseigene Embodied-World-Modell Gravity nutzt eine MoT-Architektur, um kognitive High-Level-Aufgaben von Low-Level-Gelenkansteuerungen zu entkoppeln. In Kombination mit dem RMS-Dispositions-System ermöglicht dies Roboterarmen und AMR-Flotten, in dynamischen Lagerumgebungen Fehler autonom zu diagnostizieren und Routen neu zu planen, um Engpässe bei extrem großen SKU-Mengen zu bewältigen. (Quelle: 量子位)
Soniox stellt Sprachmodell STT v6 vor: Erstmalige Text-Injektion für Agenten und geräteseitige Echounterdrückung : Der Sprach-API-Anbieter Soniox hat das Echtzeit-Transkriptionsmodell STT v6 herausgebracht. Bei Duplex-Sprachanrufen liest der Transkriptions-Stream den vom Agenten vorbereiteten Text vorab ein, um die Audio-Rückkopplung der Lautsprecher in das Mikrofon präzise zu eliminieren. Dies verhindert Selbstunterbrechungen des Agenten und beschleunigt die Erkennung von Nutzerunterbrechungen und kurzen Phrasen deutlich. (Quelle: MarkTechPost)
Pruna AI veröffentlicht leichtgewichtiges Bildmodell P-H3-Image als Open Source : Pruna AI hat auf Basis des MiniMax-H3-Videomodells das Open-Source-Bilderzeugungsmodell P-H3-Image rekonstruiert. Durch die Verschlankung des Transformers und optimierte Diffusionszeitpläne wurde das Modellvolumen um das Siebenfache reduziert. Es generiert fotorealistische 4MP-Bilder in nur 8 Schritten bei fünffacher Geschwindigkeit und bietet native Kompatibilität mit ComfyUI und Diffusers. (Quelle: ClementDelangue)
🧰 Tools
Baseten stellt Full-Stack-Agenten-Infrastruktur mit Grid, Sandboxes und Loops vor : Baseten hat eine neue Produktmatrix eingeführt, bestehend aus Grid (einem intelligenten Gateway für zentrales Management und modellübergreifende Orchestrierung), Sandboxes (isolierten zustandsbehafteten Umgebungen mit Millisekunden-Kaltstarts für Coding Agents) und Loops (einer Plattform für serverloses RL/SFT-Post-Training direkt an Open-Source-Basismodellen), die den gesamten Lebenszyklus von Agenten abdecken. (Quelle: baseten)
kimi-k3-in-c: Ausführung lokaler Inferenz des 2,78-Billionen-Parameter-Modells Kimi K3 in reinem C99 auf Single-CPU ohne Abhängigkeiten : Das Open-Source-Projekt kimi-k3-in-c hat eine minimalistische C99-Inferenz-Engine implementiert, die weder BLAS-Bibliotheken, GPUs noch externe Frameworks benötigt. Über hochoptimierte dynamische Dekompression und Memory-Streaming-Mappings führt sie das 2,78-Billionen-Parameter-Modell Kimi K3 auf einer einzelnen x86/ARM-Consumer-CPU mit nur 8,24 GB physischem RAM aus, was Hürden für lokales Reverse Engineering und Audits extrem großer Modelle drastisch senkt. (Quelle: GitHub Trending)
Comma: Persistenter persönlicher Agenten-Butler basierend auf Single-Main-Session und schnellem Entscheidungsmodell Jev : Das persönliche Agenten-Framework Comma setzt auf ein persistentes Design mit einer einzigen, arbeitsbereichsweiten Hauptsession. Ein zentraler Routing-Agent verarbeitet E-Mails, Slack-Nachrichten und plattformübergreifende Anfragen und pflegt über das leichtgewichtige Entscheidungsmodell Jev eine sitzungsübergreifende Faktenliste; langwierige Aufgaben werden in formal verifizierte, asynchrone eBPF-Sandboxes ausgelagert, die Modellaufrufe basierend auf Ausführungs-Feedback autonom optimieren. (Quelle: 机器之心)
Horizon: Profilgesteuertes Open-Source-Radar für persönliche AI-Nachrichten aus multiplen Quellen : Das Open-Source-Tool Horizon aggregiert AI-Nachrichten aus Quellen wie Hacker News, Reddit, X, GitHub und RSS. Über ein modulares Profil-System werden für unterschiedliche Inhaltsformate individuelle Bewertungs-Prompts, Extraktionsdimensionen und Deduplizierungs-Schwellenwerte definiert; das Tool unterstützt die direkte Anbindung an Desktop-Agenten über MCP-Schnittstellen und Multi-Channel-Push-Benachrichtigungen. (Quelle: GitHub Trending)
PR-Agent: Code-Review-Agent agiert eigenständig und wechselt unter die Schirmherrschaft einer Open-Source-Stiftung : Das ursprünglich von Qodo inkubierte AI-Code-Review-Tool PR-Agent wurde offiziell an eine unabhängige Open-Source-Community übergeben und leitet das Stiftungs-Hosting ein. Das Tool kapselt Befehle wie /review und /improve schlank und analysiert dank Prompt-Kompressionsalgorithmen selbst sehr große Diffs in einem einzigen Call. Es unterstützt GitHub Actions sowie diverse selbst gehostete Git-Plattformen, wodurch Vendor-Lock-ins an kommerzielle Cloud-SaaS-Dienste entfallen. (Quelle: GitHub Trending)
LlamaIndex stellt OpenDocRouter und Ultra-Fast-OCR-Optimierungs-Stack vor : LlamaIndex hat das schlüsselfertige Multi-Modell-Routing-Tool OpenDocRouter zur Dokumentenanalyse veröffentlicht. Zudem wurde der vollständige Engineering-Stack offengelegt, der den Parsing-Durchsatz von OCRia-1 auf einer einzelnen B200-GPU um das Zehnfache (auf 2.800 tok/s) steigert. Der Stack umfasst Low-Bit-Quantisierung, spekulatives Dekodieren (dflash2) und Kernel Fusion und senkt die Verarbeitungskosten für End-to-End-Dokumenten-Agenten drastisch. (Quelle: jerryjliu0)
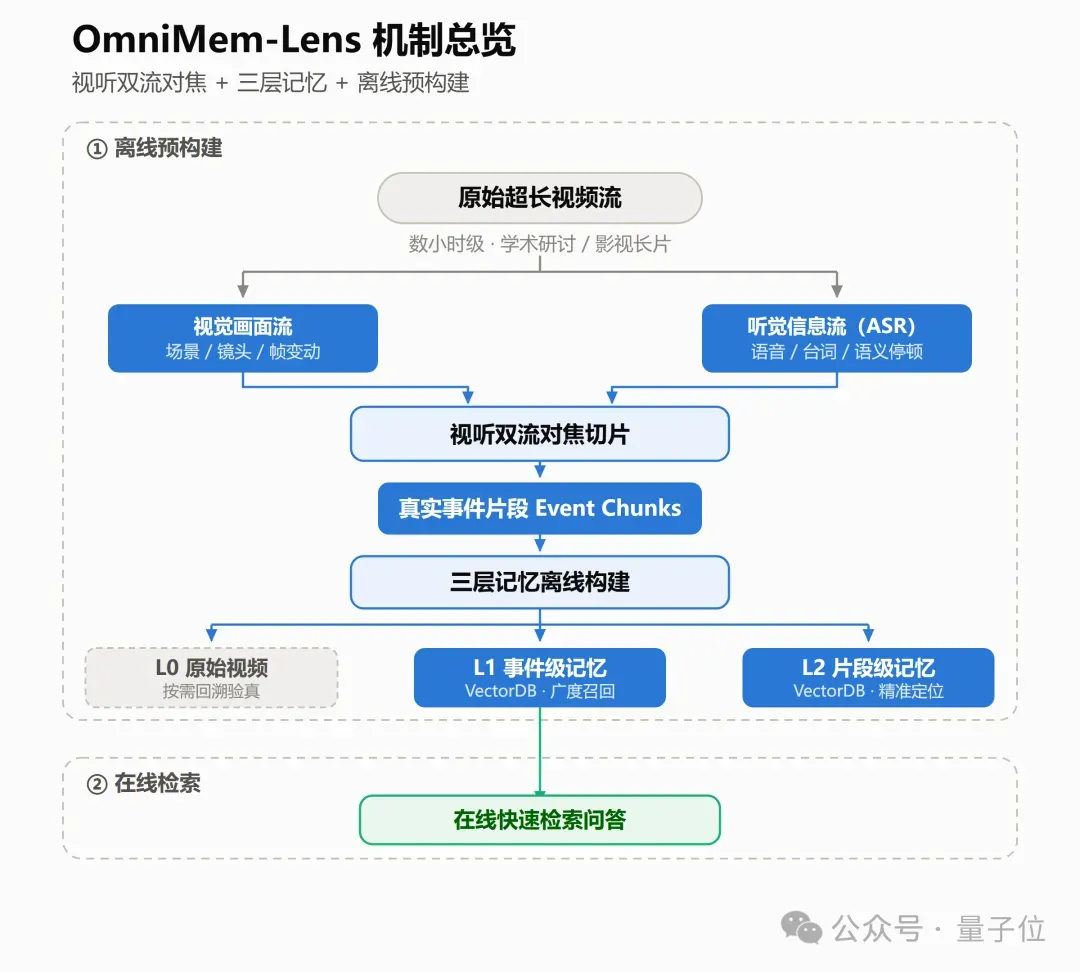
openJiuwen Agent-Memory 0.2.0: Audiovisuelle Doppelstrom-Gedächtnislinse löst Probleme willkürlicher Fragmentierung langer Videos : Das Open-Source-Memory-Framework openJiuwen hat in Version 0.2.0 das Kernfeature OmniMem-Lens vorgestellt. Um Kontextfragmentierung und Kausalitätsbrüche durch starres zeitbasiertes Segmentieren zu verhindern, kombiniert das Tool visuelle Szenenwechsel und ASR-Semantikübergänge zur automatischen hierarchischen Archivierung nach realen Ereignissen. Dies steigerte die Recall-Präzision im EgoLife-QA-Benchmark um 45,7 % und senkte die Latenz bei Online-Abfragen um bis zu 97 %. (Quelle: 量子位)
Kairos: Open-Source-Plattform für Echtzeit-Betrugsprävention vereint System-One-Entscheidungsmodell und MCP : Finic hat die Open-Source-Plattform Kairos als Alternative zu herkömmlichen Systemen wie Sift gelauncht. Da klassische GBDT-Modelle stark von historischen Labels abhängen und von organisierten Angreifern schnell umgangen werden, integriert Kairos ein latenzarmes System-One-Entscheidungsmodell. Risikomanager können dynamische Prüfregeln direkt in natürlicher Sprache definieren, während ein integrierter MCP-Server Coding Agents ermöglicht, Regelsätze automatisiert zu pflegen und zu testen. (Quelle: Hacker News)
Perplexity Computer führt Plugin-System zur vollständigen E-Commerce-Automatisierung ein : Perplexity erweitert sein Rechenzentrum Computer um ein Ökosystem für Agent Plugins, das die direkte Orchestrierung von Shopify-Backends, Klaviyo-E-Mail-Marketing und Meta-Werbeanzeigen unterstützt. Dadurch wird die punktuelle API-Kopplung auf die Applikationsebene für End-to-End-Prozesse gehoben und eine vollautomatisierte Betriebspipeline ermöglicht. (Quelle: AravSrinivas)
DeepSeek Harness erhält visuelles Interaktions-Plugin Baoyu Design : Für langfristige Designaufgaben wurde das Community-Plugin Baoyu Design für DeepSeek Harness entwickelt. Es bietet ein zentrales Kanban-Management und Echtzeit-Renderings von Motion-Vorschauen, erlaubt manuelle Eingriffe während der autonomen Planung des Agenten und generiert plattformübergreifende Präsentationen sowie UI-Animationen, was das Feedback bei der Erstellung komplexer Frontends verbessert. (Quelle: dotey)
📚 Ressourcen & Forschung
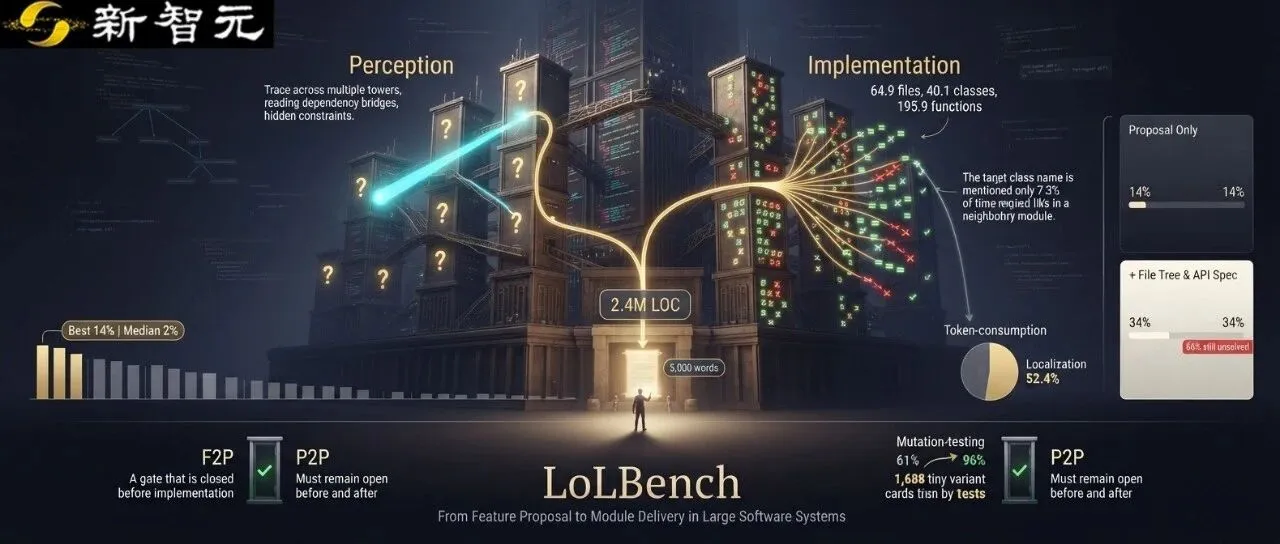
LoLBench: Fudan und CUHK stellen ersten Benchmark für langfristige Codeentwicklung in realen Systemen vor : Die Fudan University und die Chinese University of Hong Kong haben LoLBench veröffentlicht, das Evaluierungen von lokalen Bugfixes auf modulare Funktionsauslieferungen in Codebases mit durchschnittlich 2,4 Millionen Zeilen erweitert. Bei realen Anforderungen von über 5.000 Wörtern erreichten 28 führende Agenten-Setups maximal eine Lösungsquote von 14 %; mehr als 50 % der Rechenressourcen wurden allein für das Auffinden von Abhängigkeiten verbraucht, was erhebliche Wissenslücken von AI bei komplexem System-Engineering aufzeigt. (Quelle: WeChat)
DeepLearning.AI und Arize starten kostenlosen Kurs „Agent Evaluation and Fine-Tuning in Practice“ : Ein neuer Kurs unter der Leitung von Laurie Voss, Head of Developer Relations bei Arize, ist gestartet. Er widmet sich dem Problem, dass Unit-Tests Fehlentscheidungen und Tool-Fehlbedienungen von Agenten nicht abdecken können, und zeigt praxisnah, wie Fehlermuster aus Traces extrahiert, verlässliche Code-Evaluatoren und LLM-as-a-Judge-Panels aufgebaut und evaluationsgetriebene Engineering-Zyklen etabliert werden. (Quelle: )
Hugging Face stellt Integrationsverträge für Transformers vor: Miniaturmodelle sichern CI-Merges ab : Da die Unterstützung von über 750 Modellen in der Transformers-Bibliothek zu extrem hohen GPU-Kosten bei täglichen Regressionstests führt, hat das HF-Team den Standard transformers-mic eingeführt. Agentengestützt werden dafür Konfigurationsschnipsel der Kernarchitekturen extrahiert und Modelle auf wenige Megabyte komprimiert. Dies ermöglicht es CI-Pipelines, subtile Code-Bugs auf kostengünstigen CPU-Runnern binnen Sekunden abzufangen. (Quelle: HuggingFace Blog)

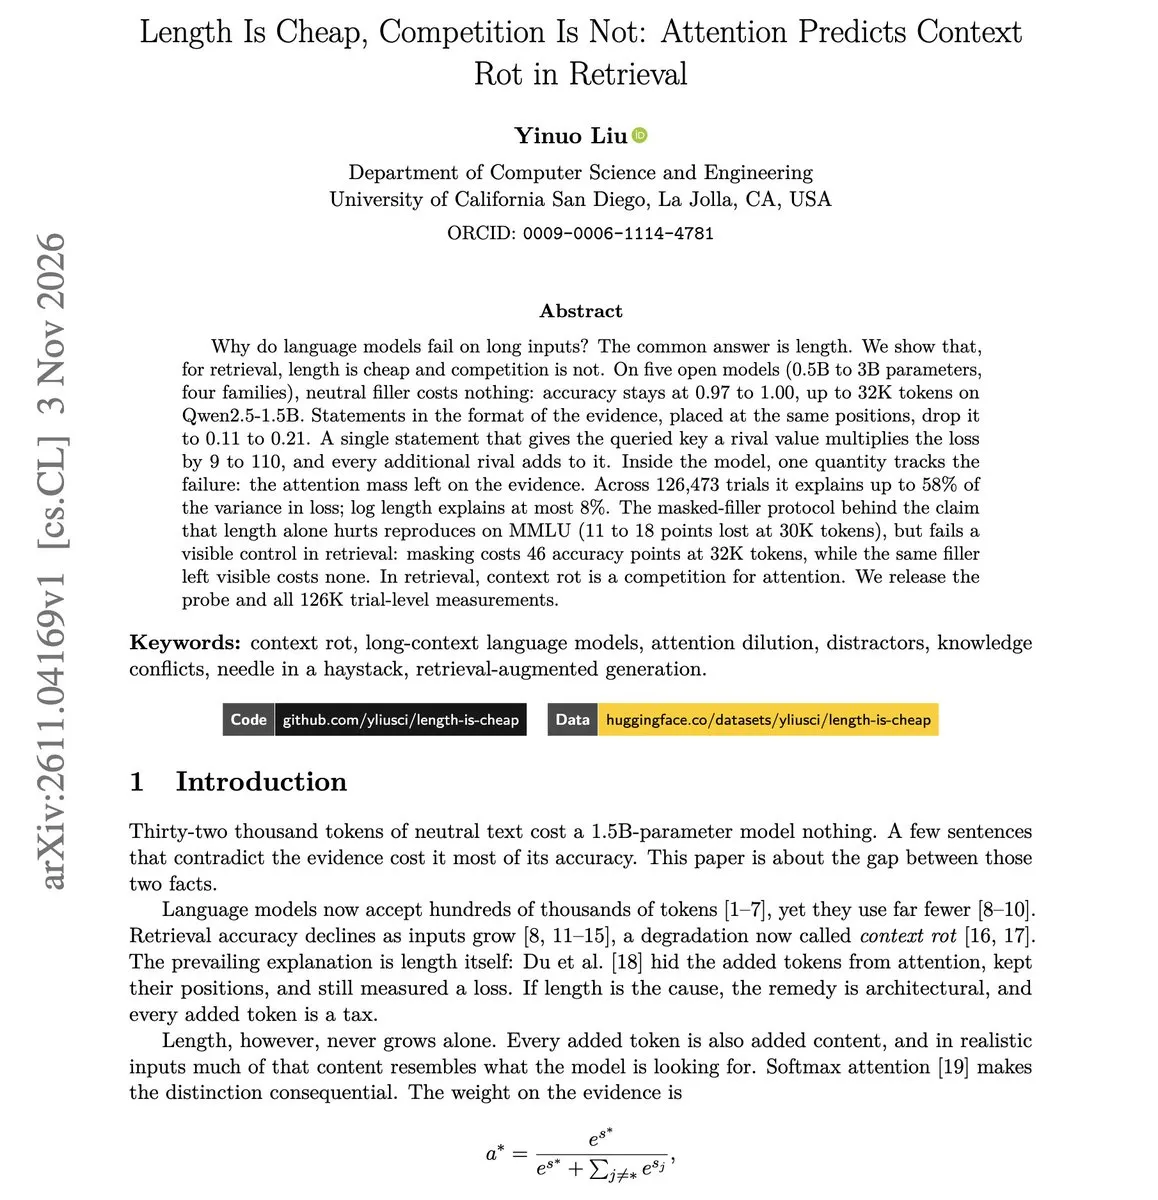
Ursache für Retrieval-Fehler in langen Kontexten: Konkurrierende Interferenzen wiegen schwerer als Längendegradation : Eine Studie der UC San Diego zeigt, dass das Scheitern von RAG und Long-Context-Modellen beim Retrieval meist nicht an der reinen Kontextlänge liegt, sondern am Vorhandensein „konkurrierender Ausdrücke“, die der korrekten Antwort ähneln, aber falsche Werte enthalten. Diese verwirrenden Informationen lenken die Attention-Weights des Modells direkt ab und erklären 58 % der Recall-Fehler. (Quelle: dair_ai)
SpecPilot: Agentenbasierte adaptive Entdeckung von Optimierungsalgorithmen für spekulative Dekodierung : Entwickler haben das Framework SpecPilot vorgestellt, das über Multi-Agenten-Kollaboration optimale spekulative Dekodierstrategien für unterschiedliche GPU-Architekturen und Einsatzszenarien ermittelt. Das System entdeckte selbstständig eine verlustfreie 12-Bit-Gewichtsrepräsentation und einen zweistufigen Verifikationsbaum, was die Beschleunigung einzelner Inferenzanfragen ohne Präzisionsverlust auf das bis zu 10,87-fache steigerte. (Quelle: Reddit r/LocalLLaMA)
NVIDIA Technical Blog analysiert Beschleunigungsmethoden für MoE-Inferenz auf der DGX Spark Workstation : Das Engineering-Team von NVIDIA erläutert die Optimierung der Single-User-Dekodierung für Ling-3.0-flash (124B MoE) auf einer GB10-basierten DGX Spark Workstation. Durch die Kombination von dynamischer Kernel-Kompilierung zur Humming-Laufzeit, Load-Time-FP8-Quantisierung des LM-Heads und spekulativem Sampling über Multi-Token-Prediction (MTP) konnte der GSM8K-Dekodierdurchsatz ohne Einbußen bei mathematischen Benchmarks um 42,5 % gesteigert werden. (Quelle: MarkTechPost)
Tutorial zu generativen Audio- und Musikmodellen fasst Stand der Technik und rechtliche Kontroversen zusammen : Ein umfassender Übersichtsartikel analysiert den modernen Audio-AI-Tech-Stack: von neuronalen Audio-Codecs über autoregressive Token-Modellierung und Flow-Matching-Algorithmen bis hin zu Alignment-Paradigmen für Echtzeit-Begleitsysteme. Zudem beleuchtet die Arbeit anhand von Gerichtsentscheidungen Branchenstandards für das Copyright-Tracing von Trainingsdaten sowie Wasserzeichenverfahren zur Audio-Authentifizierung. (Quelle: HuggingFace Daily Papers)
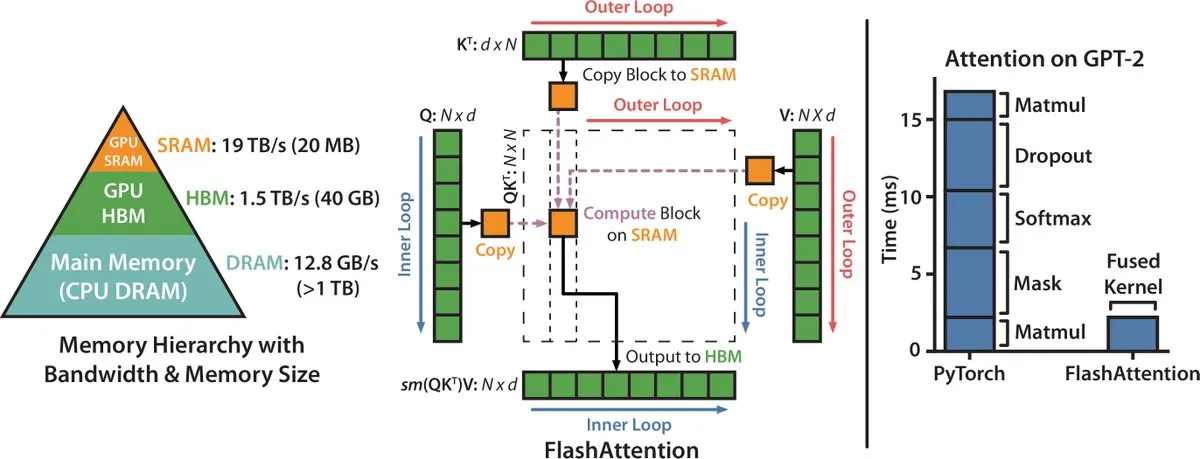
Mikroarchitektur-Engineering: Zehn fundamentale GPU-Optimierungspapiere für Large Models : Eine Übersichtsarbeit fasst zehn wegweisende Kernel-Engineering-Papiere von FlashAttention-1/2/3 über PagedAttention bis hin zu MARLIN und FlashInfer zusammen. Detailliert werden SRAM-Tiling, Online-Softmax-Normalisierung und asynchrone Berechnungsüberlappung analysiert, um eine fundierte Grundlage für den Bau hochperformanter Agenten-Laufzeitumgebungen bereitzustellen. (Quelle: NandoDF)
💼 Wirtschaft
AI-Inferenz-Startup Fal schließt Finanzierung über 1,3 Milliarden US-Dollar ab – Bewertung verdoppelt sich auf 16 Milliarden US-Dollar : Fal, Spezialist für hochskalierbare Inferenzdienste für Open-Source-Audio- und -Videomodelle, hat Finanzierungsrunden (Series E/F) über insgesamt 1,65 Milliarden US-Dollar abgeschlossen. Die jüngste Runde wurde von Bessemer unter Beteiligung von NVIDIA angeführt und hob die Bewertung auf 16 Milliarden US-Dollar an. Obwohl Hardware-Mietkosten die Margen belasten, überschritt der annualisierte Umsatz dank des Booms bei Open-Source-Modellanwendungen zügig die Schwelle von 800 Millionen US-Dollar. (Quelle: TechCrunch)
Design-Einhorn Canva kündigt weltweite Umstrukturierung an: Abbau und Verlagerung von über 1.200 Stellen : Das mit bis zu 40 Milliarden US-Dollar bewertete australische Designunternehmen Canva hat die tiefgreifendste Umstrukturierung seiner 13-jährigen Geschichte angekündigt, die 1.271 Mitarbeiter (22 % der globalen Belegschaft) betrifft. Das Unternehmen strafft Hierarchien und bündelt Teams an Kernstandorten, um auf den Marktdruck durch AI-native Bildgenerierungs- und Layout-Tools zu reagieren. (Quelle: The Guardian)

Enterprise-Linux-Riese SUSE streicht 10 % der Stellen und verweist auf Transformation durch AI und Automatisierung : Eine interne E-Mail des europäischen Open-Source-Konzerns SUSE belegt den Abbau von rund 10 % der weltweit knapp 2.000 Arbeitsplätze. Der CEO erklärte, dass AI und Automatisierungstools mittlerweile fest in Arbeitsabläufe integriert seien und den operativen Aufwand in bestimmten Bereichen deutlich reduzierten; die bisherige Personal- und Kostenstruktur sei langfristig nicht mehr wettbewerbsfähig. (Quelle: ZDNet)
🌟 Community
GitBook nach gezieltem AI-Agenten-Angriff offline: Credentials der Agenten-Supply-Chain kompromittiert : Die Dokumentationsplattform GitBook meldete einen gezielten Cyberangriff durch hochautomatisierte AI-Agenten. Den Angreifern gelang es, in die Infrastruktur einzudringen und API-Credentials, Git-Synchronisations-Keys sowie Chat-Verläufe des intelligenten Assistenten abzugreifen. GitBook schaltete Dienste vorübergehend ab, widerrief sämtliche Personal Access Tokens und ordnete den Reset von Integrationen und MCP-Credentials an, was die Risiken autonomer Infiltration für Cloud-Supply-Chains unterstreicht. (Quelle: Hacker News)
Apple aktualisiert App-Store-Richtlinien: AI-Companion-Apps verpflichtend ab 18 Jahren eingestuft : Apple hat Entwickler weltweit darüber informiert, dass AI-Apps mit Romantik-, Beziehungs- oder suggestiven Interaktionsangeboten (wie Character.AI oder Replika) bis Mitte November zwingend mit der Altersfreigabe 18+ versehen werden müssen. Die Community sieht darin Apples Reaktion auf weltweite Jugendschutzgesetze und eine Verschärfung der Compliance-Grenzen gegen emotionale Manipulation und fiktive Intimbeziehungen durch AI. (Quelle: TechCrunch)
Abgang von Cat Wu, Produktchefin von Claude Code, löst Diskussionen über Teamdynamik aus : Nach dem Weggang mehrerer Kernentwickler hat auch Cat Wu, die leitende Gründungsproduktmanagerin hinter Claude Code und Cowork, Anthropic verlassen. In der Community werden ihre agilen Ansätze wie das „Drei-Monate-Ausmusterungsprinzip“ diskutiert; die Häufung von Führungswechseln facht jedoch auch Spekulationen über Führungs- und F&E-Druck vor einem potenziellen Börsengang an. (Quelle: dotey)
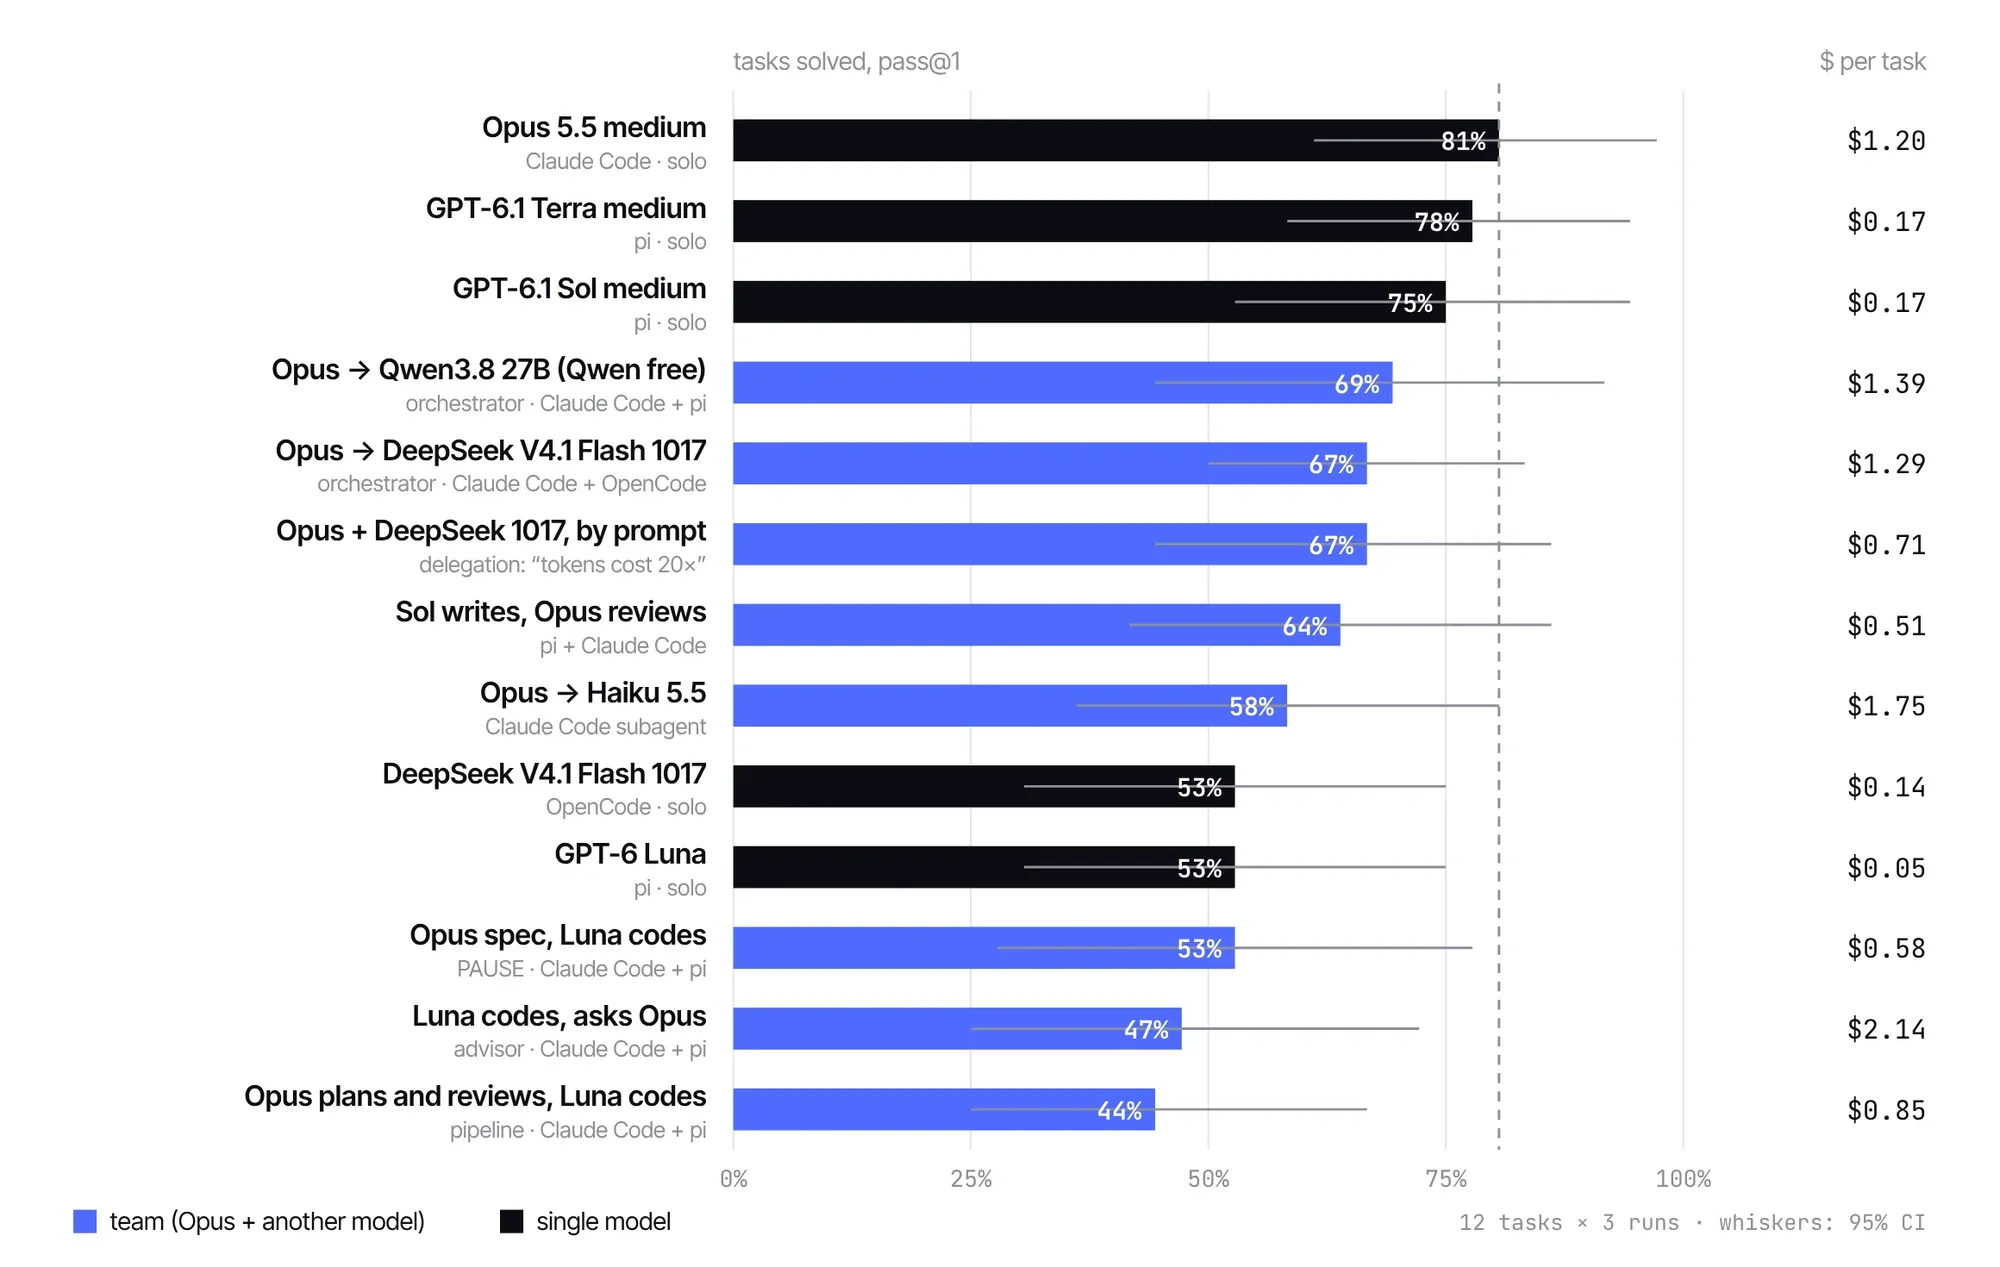
Architektur aus „teurem Orchestrator und billigen Sub-Agenten“ scheitert in der Praxis an Kostenexplosion : Community-Tests belegen, dass die Aufteilung von Aufgaben durch hochpreisige Frontier-Modelle wie Opus an kleinere Open-Source-Modelle zum Schreiben von Code bei komplexen Engineering-Vorhaben oft scheitert. Aufgrund redundanter Kontexteingaben, Abstimmungskonflikten und Cache-Misses übersteigen Gesamtkosten und Laufzeiten häufig den direkten Einsatz eines Einzelmodells, was den Nutzen solcher Multi-Agenten-Gefüge im Coding-Bereich infrage stellt. (Quelle: Reddit r/ClaudeAI)
Gemini nutzt Chatdaten bezahlter Einzelkonten standardmäßig fürs Modelltraining: Datenschutzdebatte entbrannt : Ein viel beachteter Post auf Hacker News enthüllt, dass Google auch bei kostenpflichtigen Premium-Abonnements die Chat-Verläufe von Gemini standardmäßig für das Modelltraining heranzieht; zudem können Daten von menschlichen Prüfern eingesehen und bis zu drei Jahre gespeichert werden, sofern der Verlauf nicht manuell deaktiviert wird. Dass Bezahlung keinen automatischen Schutz der Privatsphäre garantiert, rief heftige Kritik an der Intransparenz der Vertragsbedingungen hervor. (Quelle: Hacker News)
Entwickler belegen: „Lokale Large Models garantieren keine Datensicherheit“ – Boshafte Prompts können Daten exfiltrieren : Entgegen der Annahme, dass lokale LLM-Installationen eine uneinnehmbare Festung für Datenschutz seien, zeigt eine Sicherheitsstudie, dass ungeprüfte Modellgewichte oder Open-Source-Basen mit injizierten Prompts bei unzureichenden Sandbox-Berechtigungen unbemerkt Netzwerkanfragen zur Datenexfiltration in die Cloud starten können. Entwickler fordern daher eine strikte Netzwerkisolation für lokale Agenten-Laufzeiten. (Quelle: KDnuggets)
AI-Pionier Geoffrey Hinton warnt erneut: Menschheit könnte Erfindung von AI künftig bereuen : Nobelpreisträger Geoffrey Hinton warnte in einem Interview anlässlich einer Dokumentation davor, dass Tech-Chefs im kommerziellen Wettbewerb enorme Sicherheitsrisiken verdrängten. Er hält ein „Tschernobyl-artiges“ Warnereignis – etwa den Ausfall von Stromnetzen oder Finanzsystemen durch AI – innerhalb der nächsten ein bis zwei Jahre für plausibel und forderte erneut unabhängige, behördliche Zulassungsverfahren für Frontier-Modelle nach dem Vorbild der FDA. (Quelle: The Guardian)

💡 Sonstiges
Binance legt Details zum 6,3-Milliarden-Dollar-Hack offen: Gefälschte Video-Interviews und interne AI-Tools dienten als Angriffsvektor : Binance hat seinen Untersuchungsbericht zum Diebstahl der vergangenen Woche veröffentlicht: Angreifer hatten bereits im Juni Malware platziert, um Identitäten des DevOps-Teams auszuspähen, traten im September als Recruiter auf Karriereportalen auf und brachten Ingenieure in einer zweiten Videointerview-Runde dazu, einen Trojaner herunterzuladen. Über die Rechte interner AI-Assistenten gelang schließlich eine Privilege Escalation und Skriptausführung zum Abzug der Gelder. Bislang konnten 2,85 Milliarden US-Dollar an Assets blockiert oder eingefroren werden. (Quelle: The Guardian)

OpenAI ernennt früheren Army Secretary Dan Driscoll zum Senior Advisor für nationale Sicherheitsmodernisierung : OpenAI hat den ehemaligen zivilen US-Heeresstaatssekretär Dan Driscoll für eine Führungsposition gewonnen. Driscoll leitete beim Militär die Budgetierung und Einführung des taktischen AI-Programms ARIA und verfügt über ein überparteiliches Netzwerk. Der Schritt zielt darauf ab, OpenAIs Einfluss in Washington nach den Midterms zu sichern und das Engagement in klassifizierten Netzwerken des Pentagon und Verteidigungslieferketten von Verbündeten auszubauen. (Quelle: THE DECODER)
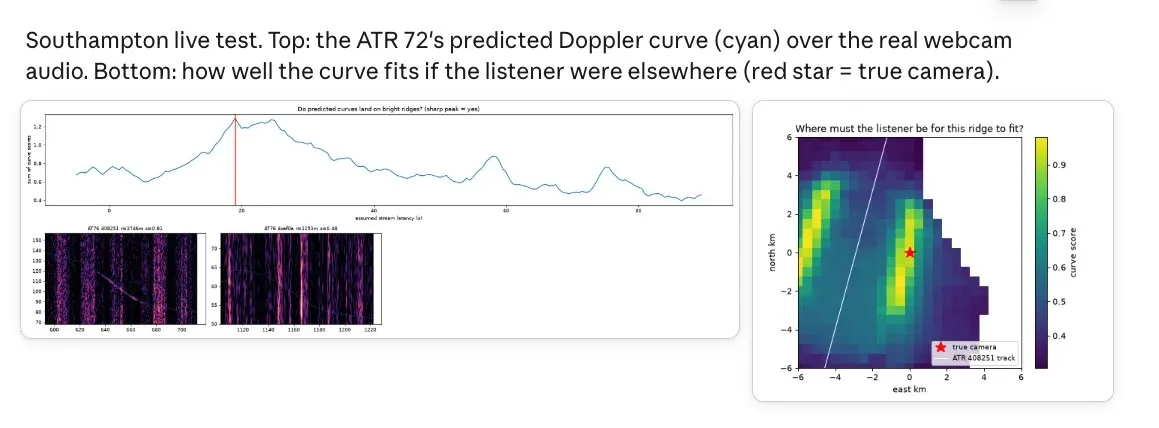
Akustische Doppler-Verschiebung kombiniert mit Flugrouten ermöglicht unbemerkte Geolokalisierung aus Videos : Forscher haben eine Methode demonstriert, die aus der Doppler-Kurve von Flugzeuggeräuschen auf Video-Tonspuren und öffentlich zugänglichen Flugplandaten die exakten Aufnahme-Koordinaten ermittelt. Community-Entwickler reproduzierten den Algorithmus kurz darauf in Code, was neue Debatten über Risiken für die Privatsphäre durch unbewusst aufgezeichnete Audiodaten auslöste. (Quelle: jpt401)