



🔥 Fokus
OpenAI verschärft umfassend sein Abrechnungssystem: ChatGPT- und Codex-Kontingentpools werden im Dezember zusammengelegt, die gesamte Linie wechselt zur Token-Messung : OpenAI hat offiziell angekündigt, dass ab Dezember die Nutzungskontingente der kostenpflichtigen Abonnements Plus, Pro und Business zwischen ChatGPT-Alltagsgesprächen und Codex gemeinsam genutzt werden. Damit enden die bisher parallelen Regeln „Web-Chat verbraucht kein Kontingent, Programmierung hat ein separates Limit“ vollständig; zugleich wird umfassend auf die Abrechnung nach tatsächlich verarbeiteten Token umgestellt. Nur der leichte Instant-Chat bleibt unbegrenzt. Darüber hinaus führt OpenAI offiziell eine hardwaregestützte Gerätesperre ein, die die Zahl der gleichzeitig angemeldeten kostenpflichtigen Konten pro Gerät begrenzt; Umgehungswege durch rotierenden Einsatz mehrerer Konten werden blockiert. Analysen zufolge markiert dies das Ende der Ära „all-inclusive unbegrenzter Abonnements“ auf der Verbraucherseite großer Modelle. Der enorme Kapitalaufwand für Rechenleistung zwingt führende Anbieter zu einem umfassenden Wandel hin zu vorausbezahlten Token und einer fein granulierten ROI-Abrechnung. (Quelle: THE DECODER, OpenAI)
DeepSeek open-sourced Architekturprototyp der nächsten Super-Agent-Generation: zweistufiges Routing und Entkopplung von Speicher und Rechnen gestalten autonome Agenten neu : Das DeepSeek-Harness-Team hat offiziell das Architekturkonzept der nächsten Agenten-Generation vorgestellt und den leichten Prototyp dsh-superagent open-sourced. Die Architektur zielt darauf ab, die Engpässe gängiger Agenten zu überwinden, die durch anschwellenden Kontext innerhalb einer einzelnen Session und serielle Blockierung entstehen. Vorgeschlagen wird eine zweistufige Architektur aus „dauerhaftem Router für globale Orchestrierung + isolierten Workern für parallele Multitasking-Ausführung“, kombiniert mit direkter Ereignis-Subscription und asynchronen ReAct-Schleifen, wodurch der Aufmerksamkeitsengpass des Menschen bei Multitasking-Interaktionen beseitigt wird. Gleichzeitig entkoppelt das System über einen leichten lokalen Daemon die cloudseitige Agenten-Ausführungslogik von der realen lokalen Arbeitsumgebung (BYOM). In praxisnahen Tests mit vielen Störfaktoren verkürzte es die p95-Aufgabenfertigstellungszeit von 29,5 Minuten deutlich auf 15,7 Minuten. (Quelle: MarkTechPost, QbitAI)
NVIDIA open-sourced PixelUMM: Abschied von VAE und ViT, einheitliches Video- und Bildverständnis sowie -generierung im nativen Pixelraum : NVIDIA und die University of Waterloo haben gemeinsam das encoderlose multimodale Modell PixelUMM open-sourced. Der Ansatz verzichtet vollständig auf die in herkömmlichen multimodalen Modellen zur Extraktion semantischer Merkmale genutzte ViT- sowie die VAE-Architektur zur Generierung latenter Variablen. Allein über eine lineare Projektion werden Bild-Patches und Video-Tubelets in einen gemeinsamen latenten Raum eines multimodalen Transformers abgebildet. Auf Basis des Mixture-of-Transformers-Designs trennt das Modell Verständnis- und Generierungsparameter über hartes Routing und teilt zugleich die Attention; zusammen mit Flow Matching werden direkt saubere Pixel erzeugt. In Benchmarks zu Bildzählung, Videoverständnis und hochwertiger Videogenerierung zeigt es durchweg Wettbewerbsfähigkeit gegenüber traditionellen komplexen Dual-Stream-Systemen. (Quelle: Jiqizhixin)

🎯 Entwicklungen
Tsinghua-Team um Yao Qizhi schlägt „Algebraisches Weltmodell“ AWM vor: Kategorietheorie und formale Beweise durchbrechen kognitive blinde Flecken : Angesichts der Schwäche führender großer Modelle, lediglich oberflächliche Regelmäßigkeiten aufzulisten und bei unlösbaren Aufgaben häufig schwerwiegende Halluzinationen zu zeigen, hat das Team von Yao Qizhi und Yuan Yang an der Tsinghua-Universität das „Algebraische Weltmodell“ (AWM) vorgeschlagen. Das Framework orientiert sich an den Ideen projektiver und induktiver Limites aus der Kategorietheorie, abstrahiert Umgebungsinteraktionen zu einer strikten algebraischen Raumstruktur und nutzt die Sprache Lean 4 für maschinell prüfbare mathematisch-logische Ableitungen und Gegenbeweise. Im ARC-AGI-3-Benchmark, der autonome Regelentdeckung extrem fordert, erzielte das auf Opus 5 basierende AWM eine Durchgangsquote von 99,9 %, wobei die durchschnittliche Zahl der Aktionen bis zum Durchgang nur 43 % der menschlichen Benchmark betrug. Damit eröffnet es einen formalen Deduktionsweg, um dem „Blackbox-Raten“ von KI entgegenzuwirken. (Quelle: QbitAI)
Google und andere veröffentlichen gemeinsam CLASHarness: decken Koordinationsschwächen führender Modelle bei Multi-Agent-Konflikten auf : Angesichts der in realen Produktionsumgebungen häufigen Zustandsdiskrepanzen und widersprüchlichen Anweisungen bei Multi-Agenten-Koordination haben Google und mehrere Universitäten gemeinsam den multimodalen Benchmark CLASHarness open-sourced. Er umfasst 600 real ausführbare Konfliktszenarien mit 4K-Visualisierungsbelegen. Tests mit 15 führenden Modellen, darunter GPT-6, Claude Opus 5 und Open-Source-Flaggschiffe, zeigten: Obwohl die durchschnittliche Einzelschritt-Leistung über 60 % lag, überschritt keines der Modelle eine End-to-End-Aufgaben-Erfolgsquote von 30 %. Starke Modelle neigen dazu, aktiv Bildwerkzeuge zur Überprüfung der tatsächlichen Überwachungswerte einzusetzen, während schwache Modelle leicht den fehlerhaften Texten ihrer Teammitglieder blind vertrauen. Zugleich verschärfen überlange Denk-Token durch internes Hin-und-Her sogar Timeout-Endlosschleifen. (Quelle: Jiqizhixin)

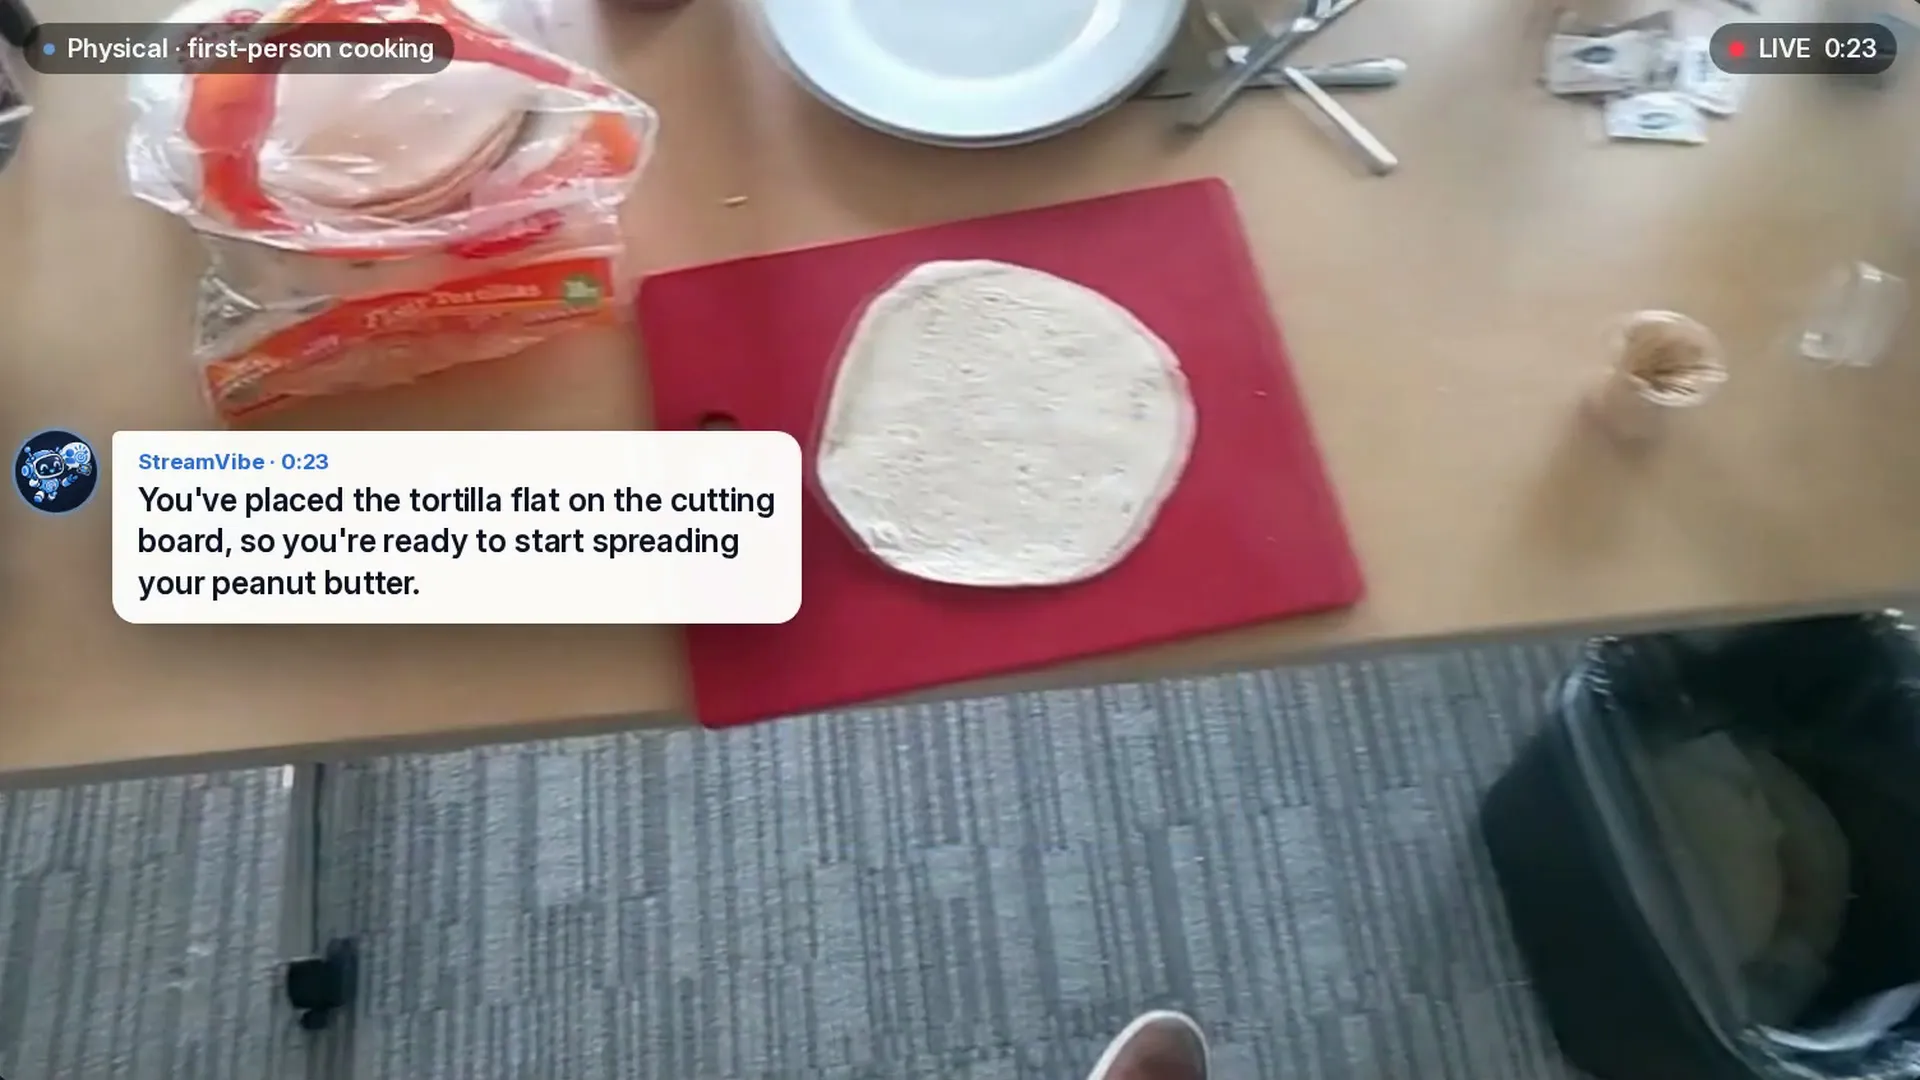
Google und Stanford veröffentlichen StreamVibe: Videointelligenz soll selbst entscheiden, wann sie sich einmischt und spricht : Herkömmliche Streaming-Videoassistenten sind oft auf die passive Ausführung mechanischer Anweisungen beschränkt. Google und Stanford haben nun einen neuen Benchmark für proaktive Interaktion sowie das Modell StreamVibe-VL vorgestellt. Das System führt einen Zustandsgedächtnismechanismus und Reinforcement-Learning-Feinabstimmung ein, um Modelle so zu trainieren, dass sie unausgesprochene Absichten von Nutzern in Echtzeit erfassen und im passendsten Moment proaktiv Hinweise geben. Experimente zeigen, dass aktuelle multimodale Modelle in Langvideos von über fünf Minuten weiterhin unter starkem Kontextverfall und irreführender Historie leiden; in standardisierten Büro- und Alltagsanleitungsszenarien erhöht der Mechanismus jedoch die Trefferquote für den wirksamen Antwortzeitpunkt um 10,7 % und reduziert unnötige Störungen. (Quelle: THE DECODER)
Feijiekesi und Fudan open-sourcen Fysiverse-UniWAM: ohne massives Roboter-Pretraining zu Doppelsiegen bei Navigation und Manipulation : Feijiekesi hat gemeinsam mit dem CITLab der Fudan-Universität das einheitliche Weltaktionsmodell Fysiverse-UniWAM veröffentlicht. Das Team verzichtete auf den teuren, auf manueller Datenerfassung beruhenden Weg des allgemeinen Roboter-Basis-Pretrainings und schlug stattdessen eine MAP-Pipeline (Manipulation-Anchor-Pose) zur Synthese von Daten sowie einen Datensatz mit 7500 Stunden vor, kombiniert mit einer Mixed-Stream-Architektur aus gemeinsamem Backbone und isolierten Eingaben. In 24 Realmaschinen-Evaluierungen über vier Hardwareplattformen hinweg errang das Modell mit 13 ersten Plätzen bei Navigations-Punktaufgaben und 4 ersten Plätzen bei mobilen Greifaufgaben den Spitzenplatz. Damit durchbricht es das einseitige Paradigma der Embodied Intelligence, das allein die Größe privater Realmaschinendaten vergleicht. (Quelle: Jiqizhixin)

Tsinghua und andere stellen gemeinsam das selbstentwickelnde multiphysikalische Modellierungssystem EvoSim vor : Das Team von Zhang Qiang aus der Fakultät für Chemieingenieurwesen der Tsinghua-Universität hat gemeinsam mit Qingyu Technology und dem Huairou-Labor EvoSim vorgeschlagen. Es treibt KI von bloßem „Feinabstimmen von Parametern bei gegebenen Gleichungen“ hin zu „Mechanismen aus experimentellen Fehlern ableiten und Gleichungen selbst weiterentwickeln“. In zwei industrienahen physikalischen Szenarien – der Vorhersage von Lithiumplattierung bei Schnellladung von Traktionsbatterien und der dynamischen Spannungssimulation über verschiedene Betriebszustände hinweg – erzeugt EvoSim durch parallele Hypothesengenerierung und Identifizierbarkeitsprüfung eine wiederverwendbare Kette von Modellierungserfahrungen. Der Fehler beim Einsetzen der Lithiumplattierung konvergiert auf 1,79 %, und die effektive Genauigkeit übertrifft deutlich die manuelle Modellierung erfahrener Fachleute. (Quelle: Jiqizhixin)

Xingyan Intelligence veröffentlicht Embodied-Harness-Framework Auriga: Fokus auf Zero-Shot-Selbstheilung in einer einzigen Episode : Xingyan Intelligence hat das Embodied-Intelligence-Harness-Framework Auriga vorgestellt. Es soll wiederholtes Trial-and-Error-Reset für spezifische Aufgaben durch eine „systemweite universelle Ausführungsschicht“ ersetzen. Das Framework verbindet „Wahrnehmung ist Messung“, trajektorielle Voraussimulation nach dem Prinzip „was gesehen wird, wird ausgeführt“ sowie einen selbstheilenden Regelkreis mit millisekundengenauem Anhalten bei Anomalien. Unter den strengen Zero-Shot-Evaluierungsregeln von RoboDojo und RoboCasa365 – „keine Feinabstimmung, keine Demonstration, keine Zurücksetzung in einer Episode“ – erreicht Auriga durch physikalisch-evidenzbasierte Strategie-Neuplanung Erfolgsquoten von 57,74 % bzw. 73,2 % und liegt auf beiden Ranglisten auf Platz eins. (Quelle: Jiqizhixin)

OpenMOSS-Team der Fudan-Universität entschlüsselt Langtext-Mechanik von Hybridarchitekturen: hybride Positions-Bias bricht den Wippeffekt zwischen Extrapolation und Anpassung : Angesichts des hohen Rechenaufwands vollständiger Attention sowie der jeweiligen Schwächen von Sliding-Window-Attention (SWA) und Linear-Attention (LA) hat das Team von Qiu Xipeng an der Fudan-Universität die zugrunde liegenden Mechanismen von Hybridarchitekturen systematisch analysiert. Die Studie zeigt: SWA ist gut bei Längen-Extrapolation, aber unzureichend bei der Anpassung durch weiteres Training; LA ist gut bei der Anpassung an lange Texte, aber schwächer bei der Extrapolation. Das Team schlägt Sliding-Window-Linear-Attention (SWLA) sowie eine globale Aggregationsstrategie ohne Positions-Bias namens NoPE vor. Dadurch erreichen GLA/GDN-Hybridmodelle im RULER-Benchmark eine 16-fache, trainingfreie und verlustfreie Extrapolation von 4k auf 64k. (Quelle: Jiqizhixin)

🧰 Tools
Modellverhaltens-Skalpell Heretic 2.0 veröffentlicht: Modellausrichtung mit Ablation beliebigen Rangs und Plugin-System neu aufgebaut : Das Open-Source-Werkzeug zur Modellmodifikation Heretic hat Version 2.0 veröffentlicht. Diese Version verwirft die traditionelle Rank-1-Abliteration, die Modellverweigerungen als einzelne Richtung behandelt, und führt erstmals den Algorithmus „Ablation beliebigen Rangs“ (ARA) ein. Dabei wird ein L-BFGS-Optimierer für Mikrotraining im Residualraum genutzt, um Verweigerungsmerkmale zu glätten und zugleich die ursprünglichen Repräsentationen des Modells weitestgehend zu bewahren. Zusätzlich führt die neue Version ein umfassendes Ökosystem aus Scorer-Plugins ein, darunter einen ModernBERT-Verweigerungsklassifikator und Benchmark-Scorer. Dadurch lassen sich die Unterdrückung von Halluzinationsfloskeln (Slop), die Verringerung von Sycophancy sowie die Feinabstimmung emotionaler Ausrichtung vollständig modular umsetzen. (Quelle: GitHub)
Nace AI open-sourced 27B-Entscheidungsmodell Drex Max v1: multimodale logische Gating auf lokalen Mac verlagert : Nace AI hat sein Flaggschiff-Entscheidungsmodell Drex Max v1 offiziell als Open-Weights veröffentlicht, einschließlich bf16, Q8_0 GGUF sowie einer für Apple Silicon optimierten Affine-Q4-Version. Das Modell basiert auf einer Hybridarchitektur aus Gated DeltaNet Linear Attention und vollständiger Attention. Es benötigt keine autoregressive Token-Generierung und kann in einem einzigen Forward-Pass exakte diskrete Wahrscheinlichkeiten für bis zu 255 Klassifikationsoptionen ausgeben. Im öffentlichen Decision-Index-0.4-Test erzielt es 67,52 Punkte und übertrifft damit das geschlossene Jev. Unternehmen können sensible Informationsklassifikation, Tool-Routing und Risikokontroll-Leitplanken vollständig in einer lokalen privaten Umgebung bereitstellen. (Quelle: MarkTechPost)
AiSOC: vollständig quelloffenes, selbstgehostetes Framework für Security Operations Center : Angesichts zunehmender automatisierter Angriffs- und Verteidigungsbedrohungen wurde das Sicherheitsprojekt AiSOC offiziell open-sourced. Das System enthält eine Regel-Engine mit über 7000 Regeln, einen ClickHouse-Event-Lake und eine Neo4j-Entitätstopologie. Es bringt ein leichtes lokales Modell-Gateway mit und unterstützt den Offline-Betrieb ohne API-Key. Kernmerkmal ist ein „unveränderliches Entscheidungsbuch“ mit vollständiger Nachvollziehbarkeit für KI-Untersuchungsagenten: Jede Alarmweiterleitung, Beweiskettenabfrage und Response-Voraussimulation durchläuft eine Sandbox-Prüfung und menschliche Freigabe. Nativ werden MCP-Server-Schnittstellen für Claude und Cursor bereitgestellt. (Quelle: GitHub Trending)

Hex: lokaler, Rust-basierter globaler Spracheingabe- und Bildschirmbedienassistent mit Local-First-Ansatz : Das plattformübergreifende Diktierwerkzeug Hex wurde open-sourced und richtet sich an datenschutzbewusste Entwickler. Das Tool ist nativ in Rust gebaut, enthält ein lokales Streaming-Spracherkennungsmodell und transkribiert per globalem Hotkey sofort in jedes aktive Fenster, mit Latenz im Bereich von hundert Millisekunden. Die neue Version implementiert zudem „Annotate“-Bildschirmkritzeleien und multimodale Erfassung: Nutzer können Bildschirmbereiche markieren und gleichzeitig Sprachbefehle geben; Schlüsselbilder und Bedienkontext werden automatisch gebündelt und direkt an externe Coding-Agenten wie OpenCode zur Ausführung übergeben. (Quelle: GitHub Trending)
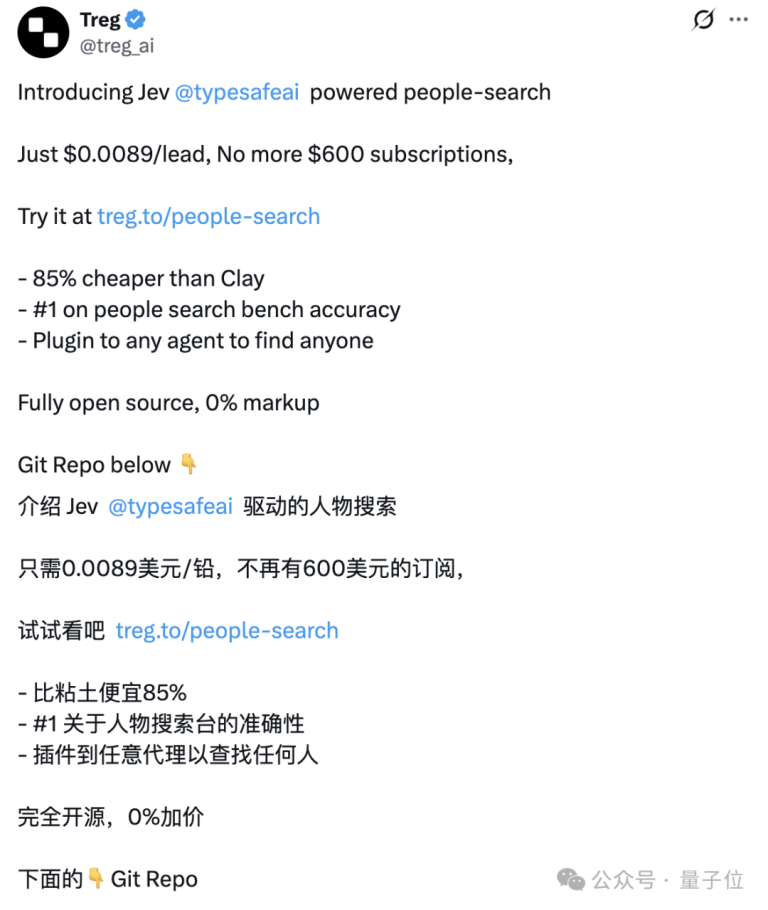
TypeSafe AI und Treg open-sourcen Tool für Vertriebs-Agenten: Kosten sinken um 85 % : TypeSafe AI, Muttergesellschaft des Entscheidungsmodells Jev, hat gemeinsam mit der Agentenplattform Treg ein Open-Source-Werkzeug zur Ermittlung von Personen- und Kontaktinformationen für die Akquise vorgestellt. Das System bündelt die traditionell aufwendige manuelle Suche über zahlreiche B2B-Plattformen in eine Agenten-Pipeline. Jev dient als Prüf-Gate, entfernt automatisch mehrdeutige Rollen und ergänzt verifizierte E-Mail-Adressen über Drittanbieter-APIs. In einem Benchmark mit 119 realen Akquise-Aufgaben erreicht die Suche eine Trefferquote von 78,2 %; die durchschnittlichen Kosten pro gültigem Lead betragen nur 0,0056 US-Dollar und liegen damit über 85 % unter kommerziellen SaaS-Werkzeugen. (Quelle: QbitAI)
Open WebUI veröffentlicht Plugin zur ordnerbezogenen Gedächtnisisolierung v0.0.4 : Ein Community-Entwickler hat für Open WebUI v0.12.5 das Plugin Folder-Scoped Memory Isolation veröffentlicht. Gegen das Problem, dass sich bei parallelen Projekten das globale Gedächtnis gegenseitig verunreinigt, extrahiert und klassifiziert das Plugin Gesprächsfakten autonom über das Modell und beschränkt Erinnerungen strikt auf den jeweiligen Projektordner. Gespräche im Stammverzeichnis führen dagegen einen unabhängigen globalen Gedächtnispool. Dadurch wird ein Übergreifen von Kontext zwischen bereichsfremden Aufgaben wie Code und Finanzen wirksam vermieden. (Quelle: Reddit r/OpenWebUI)
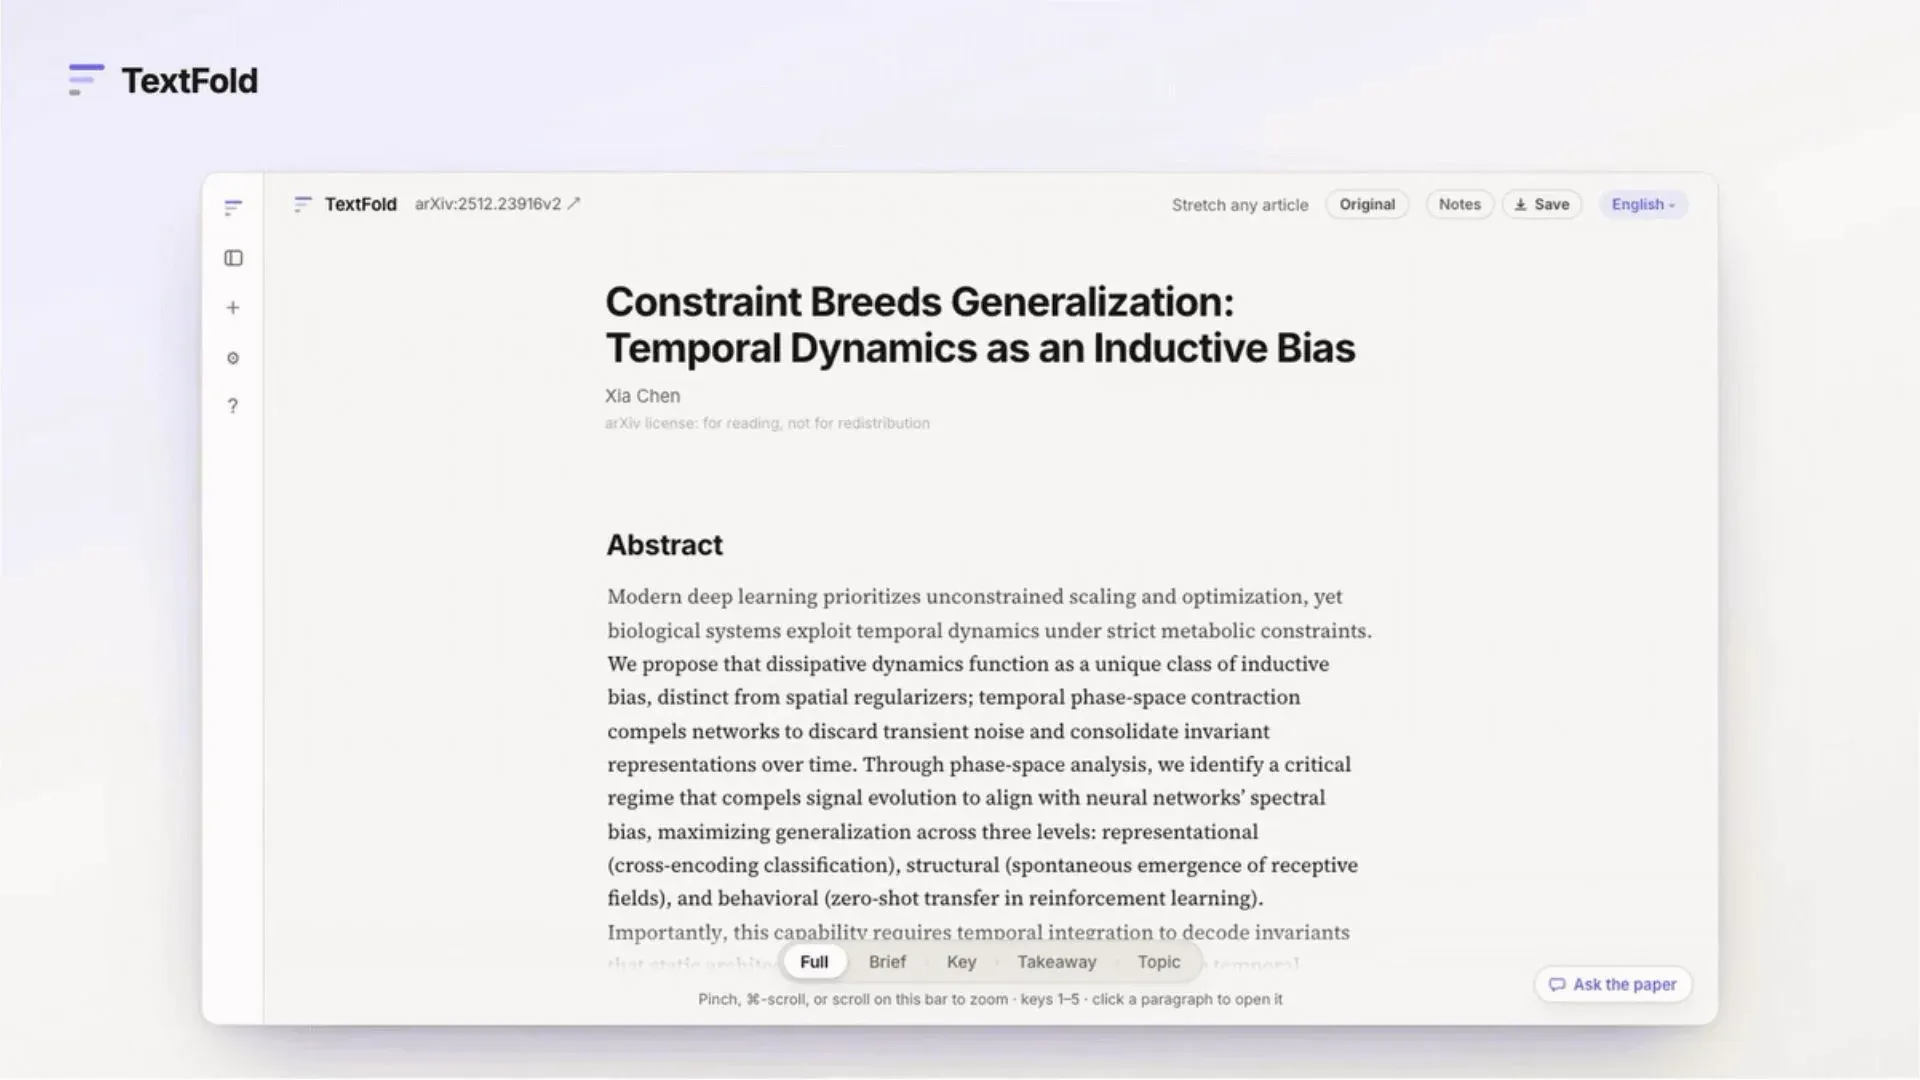
TextFold: reversibler Detail-Zoom-Reader mit Rücksicht auf kognitive Last : Gegen das Problem, dass große Modelle beim Verdichten langer Texte leicht „kognitive Schulden“ erzeugen und entscheidende Prämissen details tilgen, ist der Open-Source-Reader TextFold online gegangen. Das Werkzeug basiert auf Ted Nelsons Theorie des streckbaren Textes und bewahrt die Vollständigkeit des Originals, während KI-Zusammenfassungen als stufenweise faltbare Struktur aufgebaut werden. Leser können nahtlos zwischen Kernaussagen, Schlüsselargumenten und wörtlichen Originalpassagen hin- und herzoomen und dies ohne zusätzlichen Token-Aufwand prüfen. (Quelle: Reddit r/ArtificialInteligence)
📚 Lernen
Google-Team veröffentlicht T2J-Bench: Validierung durch differenzielle Ausführung meistert repository-weite Code-Migration zwischen Frameworks : Gegen numerische Drift und implizite Zustandsverschiebungen bei der Migration großer Codebasen von PyTorch zu JAX haben Google, UIUC und andere den ersten auf tatsächlicher Ausführung basierenden Benchmark für repository-weite Code-Migration vorgestellt: T2J-Bench. Die Evaluierung umfasst 63 industrienahe Aufgaben, darunter SFT, DPO-Feinabstimmung und KV-Cache-Inferenzdienste. Das vorgeschlagene TwinHarness-Framework behandelt den ursprünglich lauffähigen Code als ausführbare Spezifikation und vergleicht Gradienten und numerische Werte über Zwillings-Differenzläufe. Dadurch steigt die Migrationspunktzahl von Claude-Code bei gleichem Modell deutlich von 0,649 auf 0,723. (Quelle: Jiqizhixin)

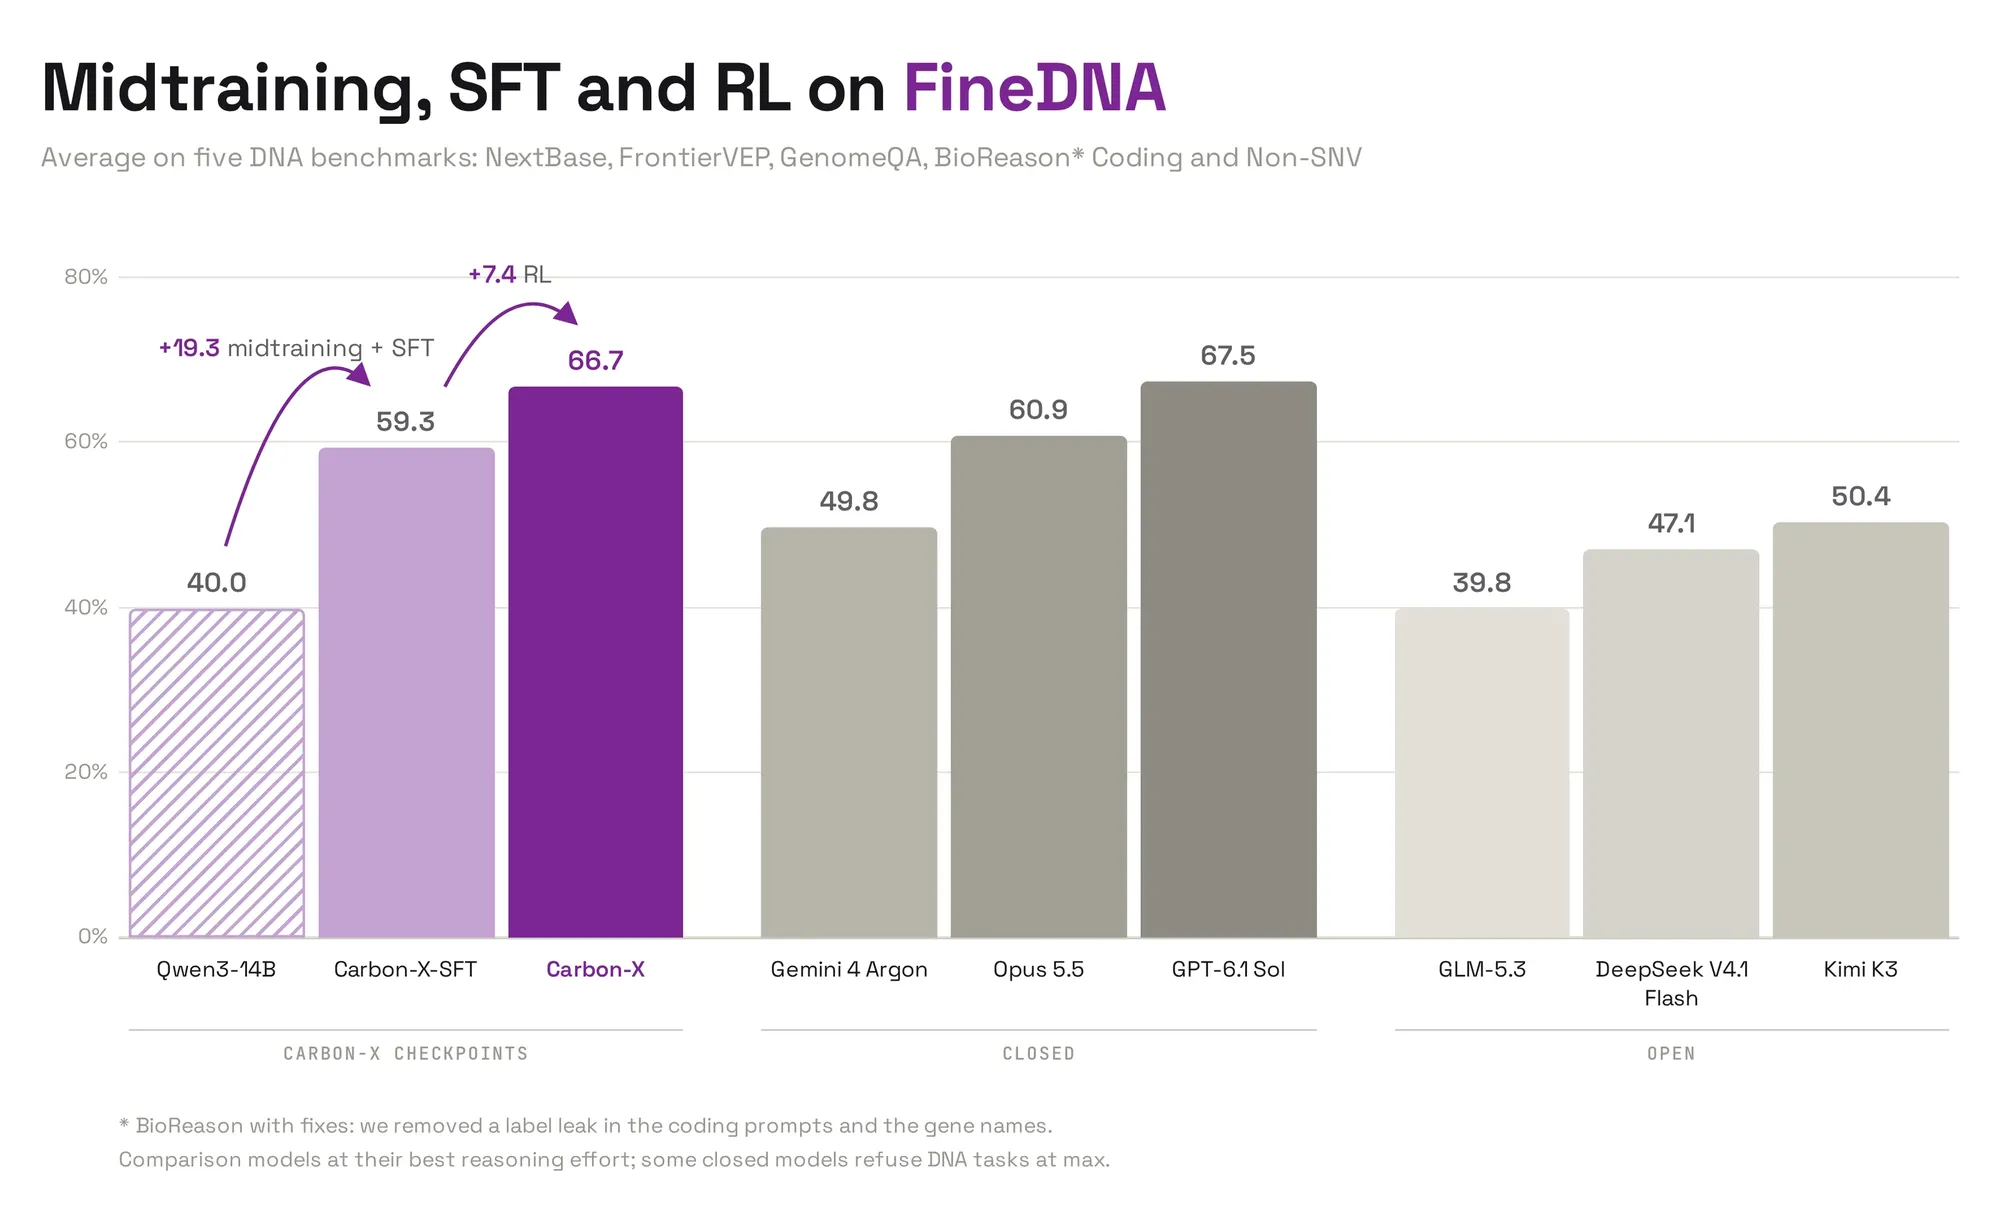
Hugging Face open-sourced FineDNA-Suite: vollständig offene Daten verhelfen kleinen Modellen zu Parität mit geschlossenen Genom-Grundmodellen : Das Biologie-Team von Hugging Face hat den mehrstufigen Feinabstimmungsdatensatz FineDNA für DNA-Verständnis veröffentlicht. Er umfasst 300B Token DNA-Text-Mischkorpus für Pretraining, 200.000 SFT-Dialoge mit deterministischen Prüfern sowie nahezu 100.000 Reinforcement-Learning-Beispiele. Das mit dieser Suite feinabgestimmte offene 14B-Modell Carbon-X besiegt bestehende offene Sprachmodelle umfassend in mehreren genomischen Benchmarks und nähert sich mit weniger als einem Tausendstel der Inferenzkosten dem Niveau von GPT-6.1 Sol. (Quelle: HuggingFace Blog)
RWE-Bench-Studie zeigt: reale Ingenieursfähigkeiten führender Modelle fallen deutlich zurück : Xplore AI hat den Benchmark RWE-Bench für komplexe mechanische, elektronische und luftfahrttechnische Industriedesigns veröffentlicht. Die Aufgaben reichen von der Festigkeitsprüfung einer Kurbelwelle eines Dreizylinder-Dieselmotors bis zum DDR3-Routing auf einer 8-Lagen-FPGA-Platine und werden vollständig durch Finite-Elemente-Analyse und physikalische Solver unabhängig bewertet. Die Tests zeigen: Selbst bei voll ausgeschöpfter Rechenleistung erreicht das stärkste Modell GPT-6 Astra nur eine Durchgangsquote von 37 %; mehrere führende große Modelle fallen sogar kollektiv durch, weil sie strenge Ingenieurstoleranzen nicht erfüllen. (Quelle: WeChat)
Gemeinsames Team der Zhejiang-Universität veröffentlicht MAESTRO in npj AI: Multi-Agent-Koordinationssystem für Katastrophenschutz und Notfallmaßnahmen : Gegen das Problem, dass in der Naturkatastrophenfrühwarnung Fachmodelle einzelner Abteilungen isoliert sind und Analyseprozesse nicht zusammenlaufen, haben die Zhejiang-Universität, die Huazhong-Universität für Wissenschaft und Technologie und weitere Teams das System MAESTRO vorgeschlagen. Es umfasst drei Arten von Agenten: Lagewahrnehmung, Koordination und Zerlegung sowie Fachexpertise. In 100 historischen und simulierten Taifunszenarien erreicht es eine Genauigkeit von 98,4 % bei der Einstufungsentscheidung und verkürzt die Analysezeit von 250 Sekunden traditioneller Expertenberatung auf 37,9 Sekunden. Derzeit ist es offiziell an eine provinziale Notfallplattform angebunden. (Quelle: Jiqizhixin)

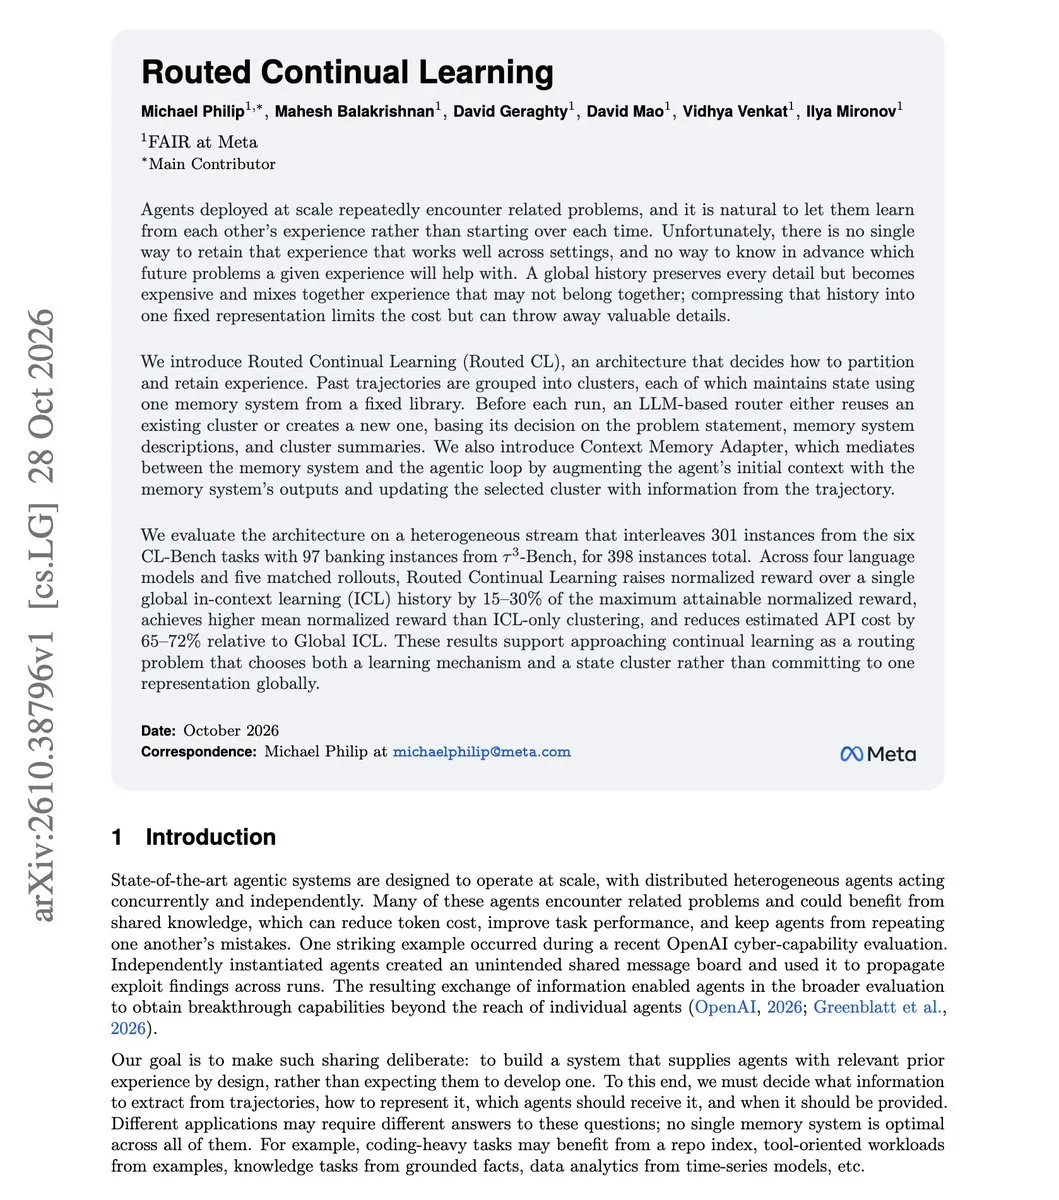
Meta FAIR schlägt Routed Continual Learning vor: katastrophales Vergessen im Langzeitgedächtnis von Agenten durchbrochen : Das Meta-FAIR-Team hat eine neue Studie zum Langzeitgedächtnis von Agenten veröffentlicht. Die Arbeit zeigt, dass ein einzelner globaler Sitzungsverlauf für Agenten bei einander abwechselnden gemischten Aufgaben nahezu keinen Nutzen bringt. Vorgeschlagen wird „Routed Continual Learning (Routed CL)“, bei dem ein LLM-Router historische Trajektorien dynamisch verschiedenen Gedächtnisclustern zuordnet und jeweils spezifische Verwaltungsstrategien vergibt. In gemischten Evaluierungen wie τ³-Bench im Bankwesen steigert die Methode den Gesamtnutzen der Aufgaben um 15 % bis 30 % und spart zugleich 65 % bis 72 % der Kontext-API-Kosten ein. (Quelle: dair_ai)
SpatialScout-Benchmark für aktives räumliches Mapping: prüft KI vom „umherblicken“ bis zum „3D-Weltaufbau“ : Ein Forschungsteam hat den Benchmark SpatialScout für aktive embodied Wahrnehmung in Innenräumen veröffentlicht. Er bewertet die Fähigkeit von KI, in unbekannten virtuellen Szenen selbstständig eine Kamera zu bewegen und eine objektbezogene dreidimensionale Karte aufzubauen. Die Evaluierung zeigt: Viele führende Modelle besitzen zwar starke Einzelbilderkennung, sind aber bei Multi-View-Triangulation und räumlicher Schleifenintegration abgekoppelt; sie fotografieren übermäßig häufig, ohne daraus präzise Koordinatenbelege zu gewinnen. Das beste Modell bleibt in 80 komplexen Innenraumszenen bei der Objekt-IoU bei nur 41,71 %. (Quelle: WeChat)
💼 Wirtschaft
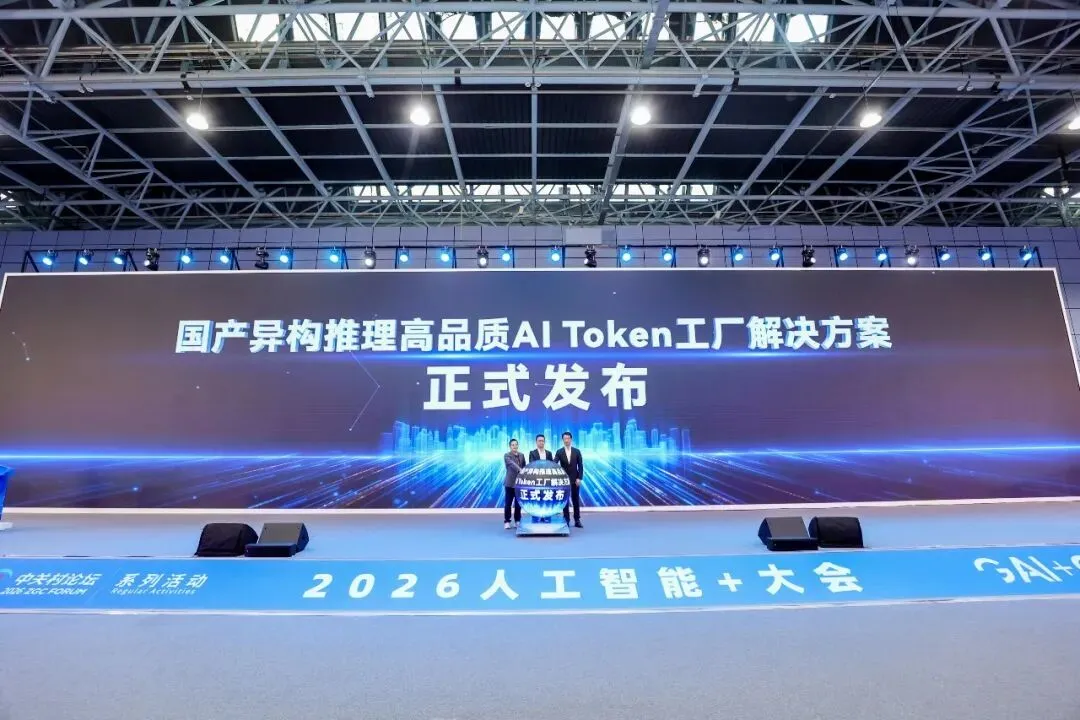
Qujing Technology schließt B-Runde über 1,3 Mrd. RMB ab: heimische heterogene Inferenzfabrik schließt Kreislauf aus Software und Hardware : Qujing Technology, spezialisiert auf KI-Infra-Inferenzoptimierung, hat den Abschluss einer B-Runde über mehr als 1,3 Mrd. RMB bekannt gegeben; in diesem Jahr wurden insgesamt 2,4 Mrd. RMB eingeworben. Gemeinsam mit Zhipu und Moore Threads wurde zeitgleich eine „hochwertige KI-Token-Fabrik für heimische heterogene Inferenz“ vorgestellt. Sie kombiniert erstmals Prefill-Decode-übergreifende Hardware-Koordination und heterogene KV-Cache-Konvertierung: gewöhnliche heimische Rechenleistung übernimmt Prefill, fortschrittliche Rechenleistung das Decode. Dadurch übertrifft das Gesamtpreis-Leistungs-Verhältnis die rein importierte Hardware-Baseline; die Tagesproduktion stemmt bereits Cluster mit Tausenden Karten und Billionen Token-Aufrufe. (Quelle: WeChat)
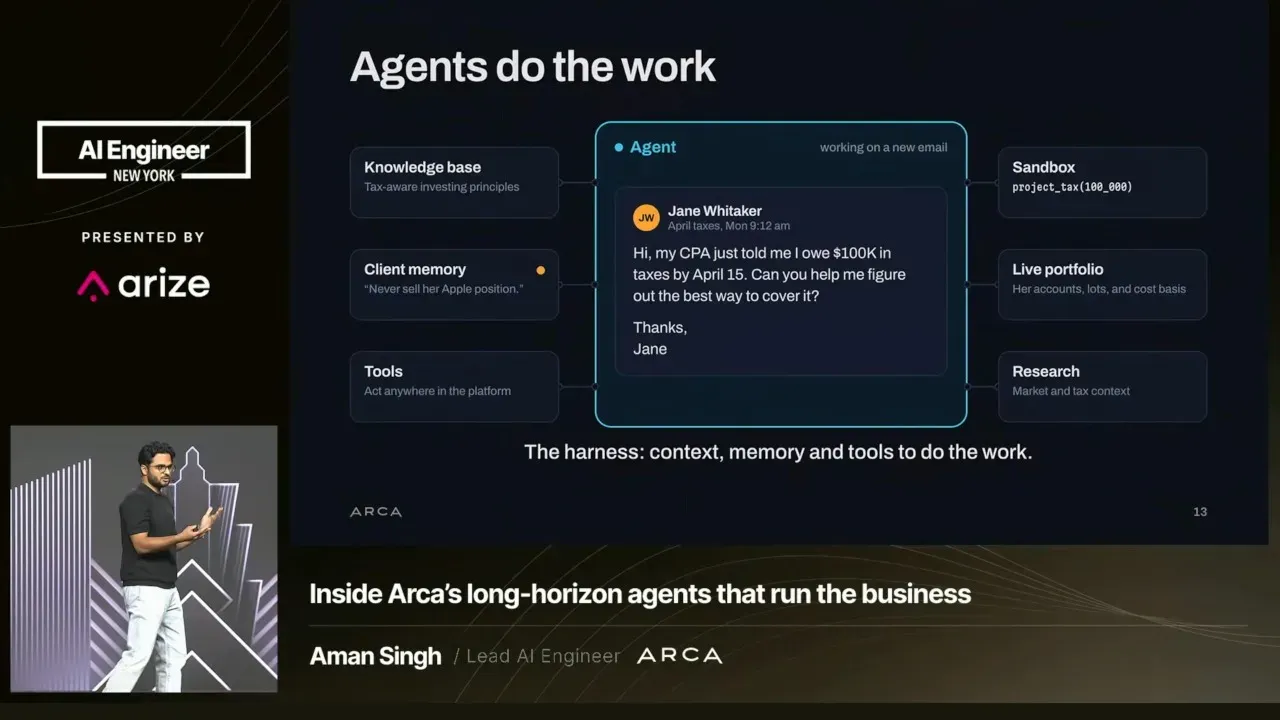
Vermögensverwaltungs-Startup Arca erhält 48,5 Mio. US-Dollar Finanzierung: Aufbau eines langfristigen Finanzkreislaufs mit „Agent-gesteuerten menschlichen Beratern“ : Die KI-native Vermögensverwaltungsplattform Arca hat eine Finanzierungsrunde über 48,5 Mio. US-Dollar unter Führung von General Catalyst abgeschlossen. Das Team teilt seine Produktionserfahrung: Langfristige Vermögensverwaltungsaufgaben erstrecken sich oft über mehrere Tage. Arca strebt nicht blind vollständige Automatisierung und Delegation an, sondern baut Schutzleitplanken aus deterministischem Code und Sandboxen. Ein Schwarm mehrerer Agenten verfolgt im Hintergrund kontinuierlich Vermögensentwicklungen und „erinnert den menschlichen Berater umgekehrt an die finale Unterschrift“. So werden Geschäftsmodell-Orchestrierung und Haftungskonformität eng verzahnt. (Quelle: Latent Space)
Bending Spoons zeigt Plattformintegrationseffekte bei 20 Mrd. US-Dollar Bewertung: KI dringt tief in SaaS-M&A und Restrukturierung ein : Die Technologie-Holding Bending Spoons hat in einem Kapitalmarktgespräch ihr Geschäftsmodell erläutert, das die Bewertung auf 20 Mrd. US-Dollar treibt. Das Unternehmen kauft bestehende SaaS-Software mit starker Kundenbindung, migriert sie vollständig in eine selbst entwickelte gemeinsame Technologieplattform und rekonstruiert Programmierung, Kundenservice und Datenflüsse mit KI. Dadurch senkt es die zugrunde liegenden marginalen Wartungskosten erheblich und reinvestiert überschüssigen Cashflow in die nächste Akquisitionsrunde. Dies belegt, dass KI nicht nur neue native Produkte schafft, sondern auch die Neubewertungslogik bestehender Software-Assets tiefgreifend umgestaltet. (Quelle: Podcast – The a16z Show)
🌟 Community
Entwickler debattieren hitzig darüber, ob „Harness-Engineering wichtiger als Prompts ist“ : Rund um die Anwendungsarchitektur großer Modelle ist in der Community ein Schlagabtausch über den Wert von Harness-Engineering entbrannt. Gegner halten übermäßiges Harness-Design für einen vergeblichen Zwischenzustand; Kernmitglieder von LangChain und Architekten aus vertikalen Domänen entgegnen, dass für echte industrielle Produkte ein gutes Harness für Kontextkomprimierungsschwellen, degradierte Sub-Routen, Hintergrundzustands-Persistenz und unsichtbare Tool-Aufrufe verantwortlich sei. Es entscheide, ob ein Modell die Kluft vom Spielzeug zur produktionsreifen Auslieferung überwinden könne. (Quelle: Vtrivedy10)
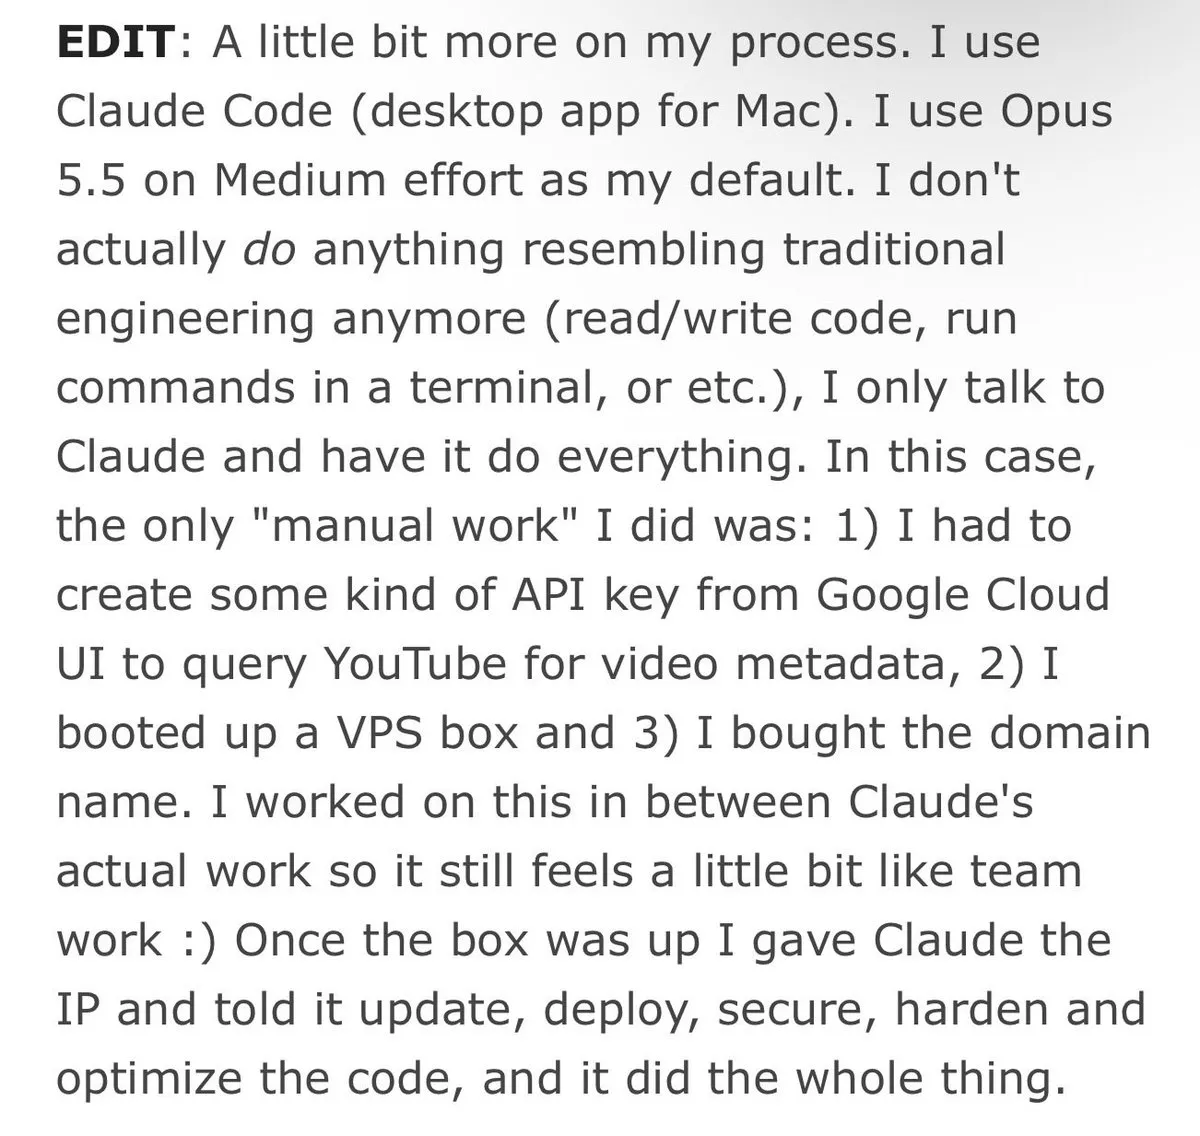
Karpathy teilt neuere Workflow-Erkenntnisse: Desktop-Client und mittlere Denkintensität als Produktivitäts-Sweetspot : Der frühere Tesla-KI-Direktor Andrej Karpathy hat in einem persönlichen Beitrag seine Alltagskonfiguration verraten: Er hat die reine Terminal-CLI-Oberfläche aufgegeben und setzt umfassend auf Desktop-Anwendungen mit eigenständiger Oberfläche; bei 95 % seiner täglichen Programmieraufgaben nutzt er bevorzugt Opus 5.5 mit mittlerer Denkintensität. Die Community reagiert mit breiter Zustimmung und merkt an, dass mit zunehmender Inferenztiefe großer Modelle das blinde Streben nach maximalen Denk-Token nicht nur den Durchsatz bremse, sondern auch leicht in Endlosschleifen durch übermäßige Selbstreflexion führe. (Quelle: Yuchenj_UW)
Sicherheitsszene reagiert scharf darauf, dass OpenAI Daybreak-Blue-Penetrationstestdaten zwangsweise in Modelltraining einbezieht : OpenAI hat angekündigt, Daybreak-Blue-Sicherheitstestsitzungen in das Modelltraining aufzunehmen, ohne standardmäßige Opt-out-Möglichkeit. Das löst kollektiven Protest von White-Hat-Hackern und Penetrationstestern aus. Sicherheitsingenieure weisen darauf hin, dass nach den Vertraulichkeitsgrundsätzen der Schwachstellenoffenlegung ungepatchte 0-Day-Schwachstellen und private Systemtopologien strikt nicht geteilt werden dürfen. Die erzwungene Aufnahme von Sitzungsdaten führe direkt dazu, dass Sicherheitsforscher gegen Vertraulichkeitsvereinbarungen verstoßen und die Plattform verlassen. (Quelle: BlancheMinerva)
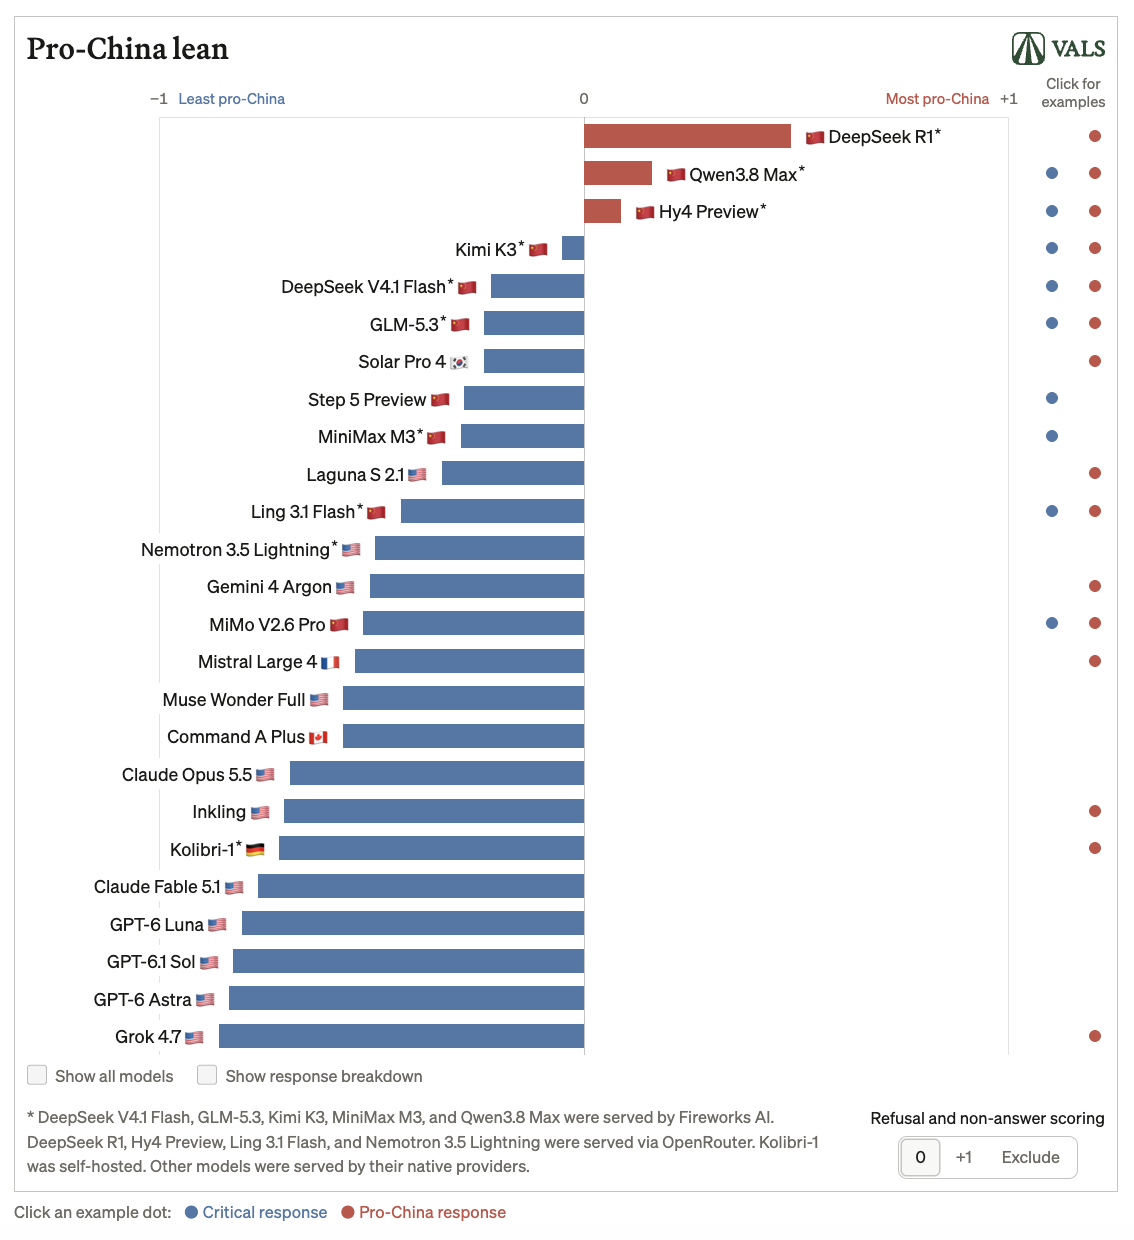
Unabhängige Tests zeigen subtile Verschiebungen von Open-Source- und Closed-Source-Modellen bei „politischen und geopolitischen Kontexten“ : Die Evaluierungsstelle Vals AI hat eine eingehende Analyse der Haltungen von Modellen verschiedener Länder zu sensiblen Themen veröffentlicht. Die Ergebnisse zeigen: Open-Source-Modelle übernehmen nicht einfach mechanisch offizielle Doktrinen, sondern reagieren äußerst sensibel auf die Sprache des Prompts und Systemvorgaben. Bei Verwendung einer bestimmten Sprache oder eines Kontexts, in den ein regionales Entwicklungskit eingebettet ist, kann die Haltungstendenz desselben Modells deutlich driften. Dies verdeutlicht die komplexe Fragilität von Post-Training-Alignment bei kulturellem und politischem Kontextverständnis. (Quelle: THE DECODER)
Entwickler reproduziert „virtuelle Maschine und Second-Order-LLM in LLM-Gewichten“ und löst Architektur-Spekulationen aus : Nachdem er in Qwen-Gewichten eine RISC-V-VM zum Laufen gebracht hatte, hat der Entwickler div erneut das Projekt QwenPU open-sourced. Darin gelingt es, im Gewichtsspeicher des Modells Qwen 3.5-4B eine bit-exakte neuronale Verarbeitungseinheit rein zu simulieren und darin vollständig Karpathys stories260k-Modell auszuführen. Die Community diskutiert intensiv über diesen Engineering-Geek-Ansatz, der ohne externe Ausführungsumgebung selbstverschachtelte Berechnung innerhalb neuronaler Netzwerkgewichte realisiert. (Quelle: Reddit r/LocalLLaMA)
💡 Sonstiges
KI-Navigation bei Outdoor-Aktivitäten gefährdet Leben – Experten warnen vor „kognitiver Kapitulation“ : Da Bergsteiger zunehmend Chatbots zur Planung von Wildniswanderungen nutzen, berichten Rettungsteams aus mehreren Regionen von Fällen, in denen KI Geländerouten schwerwiegend erfunden und Landmarken falsch markiert hat und Wanderer dadurch in Not geraten sind. Mensch-Computer-Interaktionsforscher weisen darauf hin, dass der äußerst selbstsichere und autoritative Ton großer Modelle bei Nutzern eine „kognitive Kapitulation“ auslöse. Dadurch verlören Fußgänger ohne professionelle Outdoor-Erfahrung vollständig ihre unabhängige Kritikfähigkeit und ihr Gefahrenbewusstsein. (Quelle: WIRED)
Bundesrichter weist xAIs Antrag auf Klageabweisung zurück: Umweltklage gegen Gasturbinen im Memphis-Colossus-Rechenzentrum wird weiterverhandelt : Ein US-Bundesbezirksrichter hat den Antrag von xAI abgelehnt, die Umweltklage wegen Verstößen gegen Umweltauflagen am Colossus-Supercomputing-Cluster in Tennessee abzuweisen. Die Klägerin NAACP wirft xAI vor, ohne die erforderlichen gesetzlichen Genehmigungen 35 große Gasturbinen zur Stromversorgung des Rechenzentrums illegal betrieben und damit erhebliche Luftverschmutzung verursacht zu haben. Das Gericht stellte fest, dass die Bürgerklage rechtmäßigen Verfassungsrang hat. Dies verdeutlicht, dass der Konflikt zwischen gigantischen KI-Rechenclustern, lokaler Umwelt und den Energieinteressen der Anwohner in juristische Tiefen führt. (Quelle: TechCrunch)
Australische Kreativszene boykottiert KI-Urheberrechtslösung „Standardlizenz“; Streit um kulturelle Souveränität der Ureinwohner verschärft sich : Gegen die geplante neue Politik der Regierung, Tech-Giganten das „standardmäßige Scraping“ von Online-Kreationsdaten zu erlauben, haben die Kunstgemeinschaft im inneren Westen Sydneys und Vertreter der Kunst der Aborigines öffentlichen Protest ausgelöst. Künstler und Urheberrechtsjuristen warnen, dass ein Standard-Scraping-Regime die Kontrolle von Kreativen über geistiges Eigentum massiv aushöhlen und kulturelle Assets, die das genealogische Gedächtnis der Aborigines tragen, einer billigen Verwässerung aussetzen würde. Gefordert werden eine verpflichtende Offenlegung der Datenquellen und ein Steuer- bzw. Ausgleichsmechanismus. (Quelle: The Guardian)
