



🔥 포커스
OpenAI, 과금 체계 전면 개편: 12월부터 ChatGPT 및 Codex 사용량 통합, 전면 Token 종량제로 전환 : OpenAI 공식 발표에 따르면 12월부터 Plus, Pro, Business 유료 구독의 사용량 한도가 ChatGPT 일상 대화와 Codex 간에 통합 공유된다. 기존의 ‘웹 채팅 무제한, 코딩 별도 한도’ 병행 규칙을 완전히 종료하고, 실제 처리된 Token 수에 따라 소모량을 계산하는 방식으로 전면 전환되며, 가벼운 Instant 채팅만 무제한으로 유지된다. 또한, 단일 기기 유료 계정 로그인 상한을 두는 하드웨어 수준의 기기 잠금을 정식 적용하여 다중 계정 교체 사용 우회로를 차단했다. 분석에 따르면 이는 대형 모델 B2C 시장의 ‘무제한 정액 구독’ 시대가 끝나가고 있음을 나타내며, 막대한 컴퓨팅 파워 자본 지출 압박으로 인해 주요 기업들이 사전 결제 Token화 및 정밀한 ROI 정산 모델로 전면 전환하고 있음을 시사한다. (출처: THE DECODER, OpenAI)
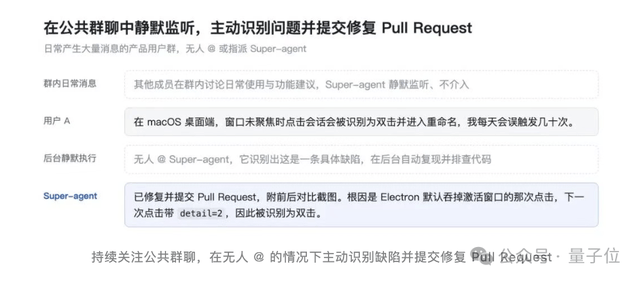
DeepSeek, 차세대 Super-agent 아키텍처 프로토타입 오픈소스 공개: 2계층 라우팅 및 연산·스토리지 분리로 자율 에이전트 재정의 : DeepSeek Harness 팀이 차세대 에이전트 아키텍처 콘셉트를 공식 발표하고 경량 프로토타입 dsh-superagent를 오픈소스로 공개했다. 이 아키텍처는 단일 Session 컨텍스트 팽창 및 직렬 블로킹에 제한받던 기존 주류 Agent의 병목을 해소하기 위해 ‘상주 Router 글로벌 스케줄링 + 격리된 Worker 멀티태스크 동시 처리’의 2계층 아키텍처를 제시했다. 이벤트 구독 직통 파이프라인과 비동기 ReAct 루프를 결합하여 멀티태스크 상호작용 시 인간의 주의 집중 병목을 제거했다. 또한 온디바이스 경량 Daemon을 통해 Agent의 클라우드 실행 로직과 로컬 실제 작업 환경(BYOM)을 분리함으로써, 노이즈가 많은 멀티태스크 실측 환경에서 p95 작업 완료 시간을 29.5분에서 15.7분으로 대폭 단축했다. (출처: MarkTechPost, 量子位)
NVIDIA, PixelUMM 오픈소스 공개: VAE 및 ViT 없이 네이티브 픽셀 공간에서 비디오 및 이미지 이해·생성 통합 : NVIDIA와 워털루 대학교가 인코더 없는 멀티모달 모델 PixelUMM을 공동 오픈소스화했다. 이 솔루션은 기존 멀티모달 모델에서 시맨틱 특징 추출에 쓰이던 ViT와 잠재 변수 생성용 VAE 아키텍처를 완전히 배제하고, 단 하나의 선형 투영 레이어만으로 이미지 patch와 비디오 tubelet을 공유 멀티모달 Transformer 잠재 공간에 매핑한다. Mixture-of-Transformers 설계를 바탕으로 하드 라우팅을 통해 이해와 생성 파라미터를 구분하면서도 어텐션을 공유하며, Flow Matching과 결합해 깨끗한 픽셀을 직접 생성한다. 이미지 카운팅, 비디오 이해 및 고화질 비디오 생성 등의 벤치마크 테스트에서 기존의 복잡한 듀얼 스트림 시스템에 필적하는 경쟁력을 입증했다. (출처: 机器之心)

🎯 동향
칭화대 앤드루 야오 연구팀, ‘대수적 세계 모델’ AWM 제시: 범주론과 정형 증명 도입해 인지적 사각지대 돌파 : 최첨단 대형 모델이 표면적인 패턴만 나열하고 해답이 없는 작업에서 심각한 환각을 일으키는 한계를 해결하기 위해, 칭화대학교 앤드루 야오(Yao Chi-Chih) 및 위안양(Yuan Yang) 연구팀이 ‘대수적 세계 모델’(AWM)을 제안했다. 이 프레임워크는 범주론의 사영 극한과 귀납 극한 개념을 차용하여 환경 상호작용을 엄밀한 대수적 공간 구조로 추상화하고, Lean 4 언어를 활용해 기계 검증이 가능한 수학적 논리 추론 및 귀류법 증명을 수행한다. 자율적인 규칙 탐색 역량을 극도로 요구하는 ARC-AGI-3 벤치마크에서 Opus 5 기반의 AWM은 99.9%의 통과 점수를 기록했으며, 평균 작업 단계 수는 인간 기준의 43%에 불과해 AI의 ‘블랙박스 찍기’를 해결하는 정형 연역의 길을 열었다. (출처: 量子位)
Google 등 공동 연구진, CLASHarness 발표: 멀티 Agent 충돌 상황에서 드러난 최첨단 대형 모델의 협업 한계 : 실제 프로덕션 환경에서 멀티 에이전트 협업 시 자주 발생하는 상태 불일치 및 지시 상충 문제를 다루기 위해, Google과 다수의 대학이 4K 시각적 증거가 포함된 600개의 실제 실행 가능한 충돌 시나리오를 설계한 멀티모달 벤치마크 CLASHarness를 오픈소스화했다. GPT-6, Claude Opus 5 및 오픈소스 플래그십 모델을 포함한 15개 최첨단 모델을 실측한 결과, 단일 스텝 평균 점수는 60%를 넘었으나 엔드투엔드 작업 통과율은 단 하나도 30%를 넘지 못했다. 강력한 모델일수록 이미지 도구를 능동적으로 호출해 모니터링 실측값을 검증하려는 경향을 보인 반면, 성능이 낮은 모델은 팀원의 잘못된 텍스트를 맹신하기 쉬웠다. 또한 지나치게 긴 추론 Token은 내부적 갈등으로 인해 오히려 타임아웃 무한 루프를 가중시키는 것으로 나타났다. (출처: 机器之心)

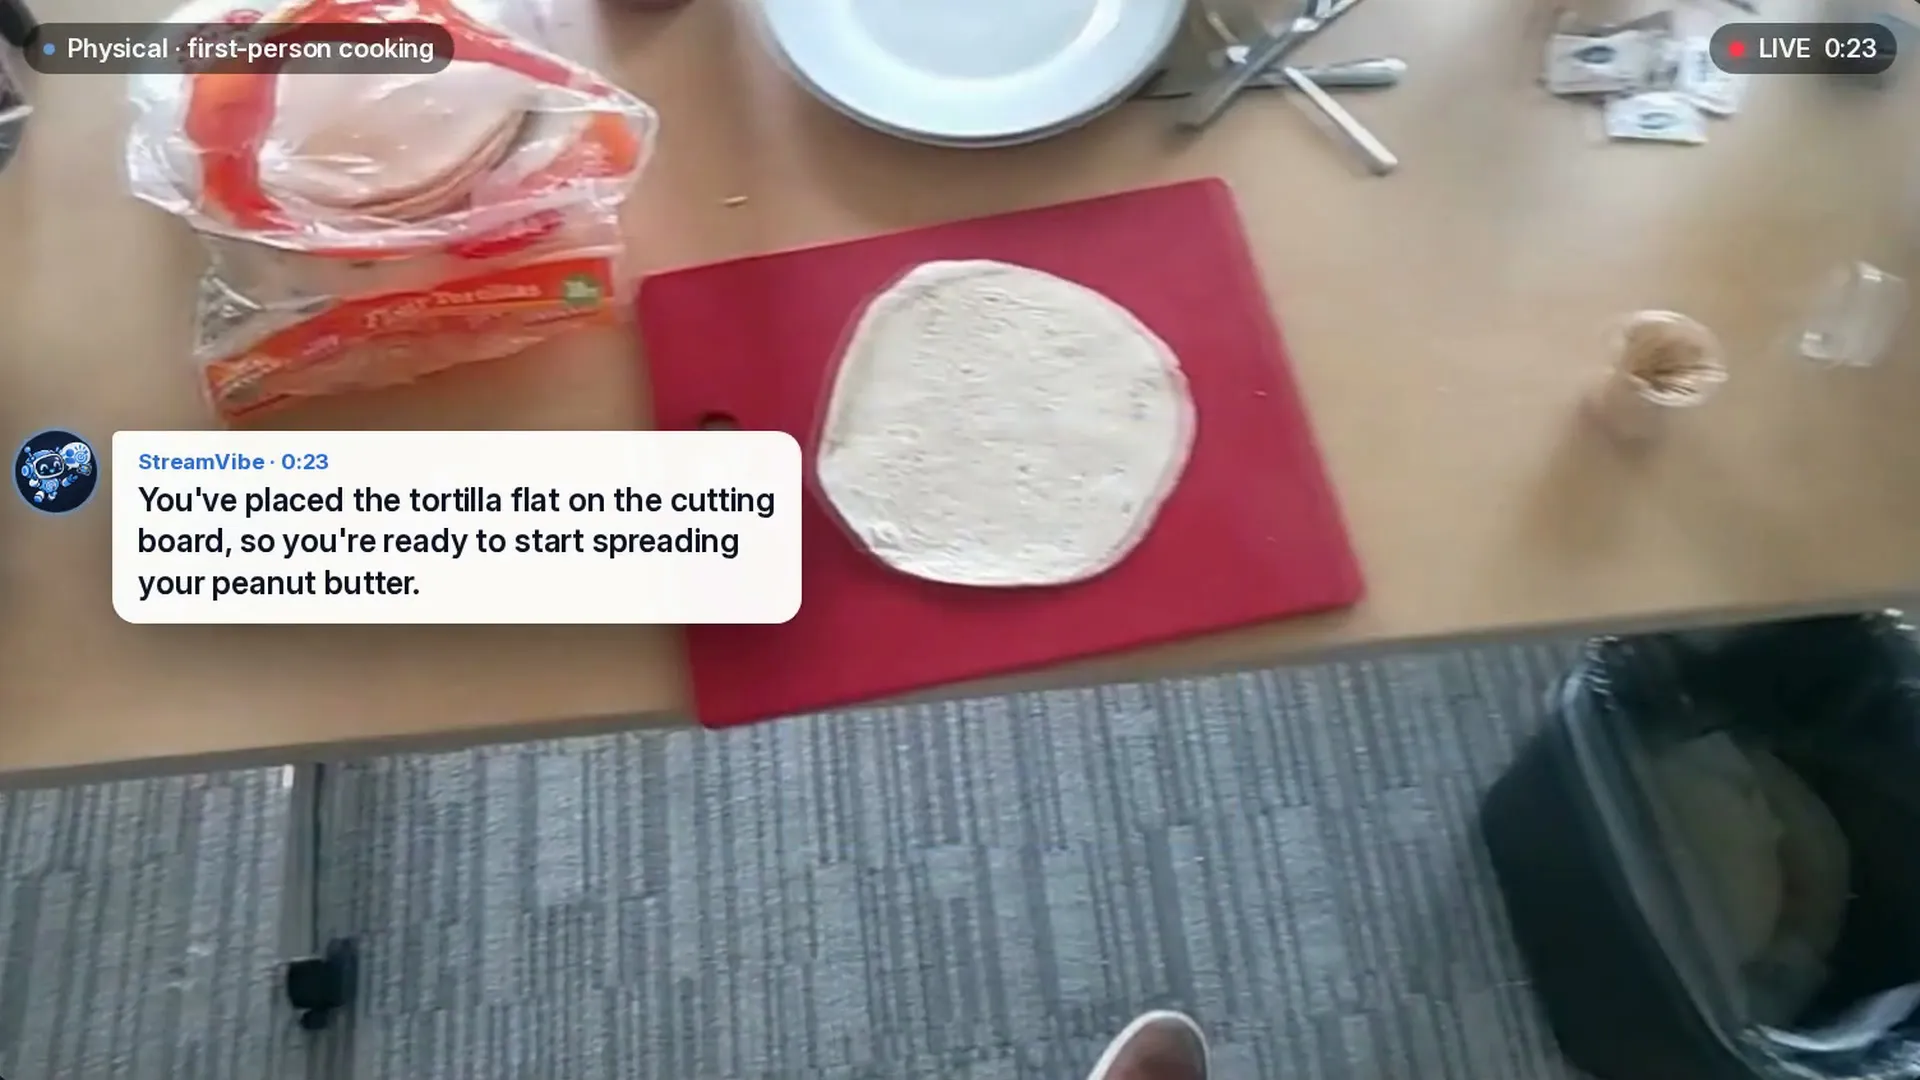
Google 및 스탠퍼드, StreamVibe 발표: 비디오 에이전트가 “언제 개입해 발화할 것인가”를 자율 결정하는 메커니즘 탐색 : 기존 스트리밍 비디오 어시스턴트가 기계적 지시를 수동적으로 실행하는 데 그쳤던 반면, Google과 스탠퍼드 대학교 등의 연구팀은 새로운 능동적 상호작용 벤치마크 및 모델인 StreamVibe-VL을 제안했다. 이 시스템은 상태 메모리 메커니즘과 강화학습 튜닝을 도입하여, 모델이 사용자의 명시되지 않은 의도를 실시간으로 감지하고 가장 적절한 순간에 능동적으로 힌트를 제공하도록 훈련된다. 실험 결과 현재의 멀티모달 모델은 5분을 초과하는 긴 비디오 시나리오에서 여전히 심각한 컨텍스트 감쇠 및 히스토리 왜곡 문제를 겪고 있으나, 표준 오피스 및 일상 가이드 작업에서 이 메커니즘은 유효한 응답 타이밍 정확도를 10.7% 향상시키고 불필요한 노이즈 개입을 줄였다. (출처: THE DECODER)
PhygitalX, 푸단대와 공동으로 Fysiverse-UniWAM 오픈소스 공개: 대규모 로봇 사전 훈련의 틀을 벗어나 내비게이션 및 조작 2관왕 달성 : PhygitalX와 푸단대학교 CITLab이 통합 세계 행동 모델 Fysiverse-UniWAM을 발표했다. 연구팀은 비용이 많이 들고 수작업 데이터 수집에 의존하는 범용 로봇 파운데이션 사전 훈련 경로를 탈피하여, MAP 합성 데이터 파이프라인을 제안하고 7,500시간 규모의 데이터셋을 구축했으며, 백본 공유 및 입력 격리 방식의 Mixed-Stream 아키텍처를 결합했다. 4개 하드웨어 플랫폼에 걸친 24개 실제 기기 평가에서 이 모델은 13개 내비게이션 정점 작업과 4개 모바일 파지 작업에서 성공률 1위를 차지하며, 체화 인공지능이 순수 실제 기기 독점 데이터 규모에만 의존하던 기존의 단일 패러다임을 깼다. (출처: 机器之心)

칭화대 등 연구진, 자가 진화 멀티피직스 모델링 시스템 EvoSim 공동 발표 : 칭화대학교 화학공학과 장창(Zhang Qiang) 연구팀이 칭위테크(Qingyu Technology), 화이러우연구소(Huairou Laboratory)와 공동으로 AI를 단순한 “주어진 방정식의 파라미터 미세조정”에서 “실험 오차에 기반한 메커니즘 추론 및 자가 진화 방정식 생성”으로 발전시키는 EvoSim을 제안했다. 전기차 배터리 급속 충전 시 리튬 석출 예측과 다양한 작동 조건에서의 동적 전압 시뮬레이션이라는 두 가지 산업용 물리 시나리오에서, EvoSim은 병렬 가설 생성 및 식별 가능성 검증을 통해 재사용 가능한 모델링 경험 체인을 축적했다. 이를 통해 리튬 석출 개시점 오차를 1.79%까지 수렴시켜 해당 분야 최고 수준 전문가의 수작업 모델링 수준을 유의미하게 뛰어넘는 정확도를 기록했다. (출처: 机器之心)

Stardust Intelligence, 체화 Harness 프레임워크 Auriga 발표: 단일 세션 제로샷 자가 치유 역량 집중 : Stardust Intelligence가 체화 인공지능 Harness 프레임워크인 Auriga를 공개하며, 특정 작업의 반복적인 시행착오 및 리셋 대신 ‘시스템 수준의 범용 실행 계층’을 도입할 것을 제안했다. 이 프레임워크는 ‘인식이 곧 측정’, ‘보이는 것이 곧 실행’으로 이어지는 궤적 시뮬레이션과 밀리초 단위의 이상 인터셉트 자가 치유 폐루프를 구축했다. RoboDojo와 RoboCasa365의 엄격한 ‘미세조정 없음, 시연 없음, 단일 에피소드 리셋 없음’ Zero-shot 평가 기준 하에서, Auriga는 물리적 증거 기반의 전략 재계획을 통해 각각 57.74%와 73.2%의 성공률을 기록하며 두 벤치마크 모두에서 1위를 차지했다. (출처: 机器之心)

푸단대 OpenMOSS 연구팀, 하이브리드 아키텍처의 롱 콘텍스트 역학 규명: 혼합 위치 편향으로 외삽과 적합의 시소 효과 극복 : 풀 어텐션의 막대한 연산 비용과 슬라이딩 윈도우 어텐션(SWA) 및 선형 어텐션(LA) 각각의 한계를 해결하기 위해, 푸단대학교 치우시펑(Qiu Xipeng) 연구팀이 하이브리드 아키텍처의 기저 메커니즘을 체계적으로 분석했다. 연구에 따르면 SWA는 길이 외삽에는 강하나 추가 훈련 적합도가 부족하고, LA는 장문 적합에는 우수하나 외삽 능력이 떨어진다. 연구팀은 슬라이딩 윈도우 선형 어텐션(SWLA)과 NoPE 전역 집계 전략을 제안하여, GLA/GDN 하이브리드 모델이 RULER 평가에서 4k에서 64k까지 훈련 없이도 무손실로 16배 외삽을 달성할 수 있도록 했다. (출처: 机器之心)

🧰 도구
모델 행동 수술용 메스 Heretic 2.0 출시: 임의 랭크 절제와 플러그인 체계로 모델 정렬 재구성 : 오픈소스 모델 수정 도구 Heretic의 2.0 주요 버전이 출시되었다. 이번 버전은 모델의 거절 응답을 단일 방향으로 취급하던 기존의 Rank-1 abliteration 방식을 탈피하고, 최초로 ‘임의 랭크 절제(ARA)’ 알고리즘을 도입했다. L-BFGS 옵티마이저를 활용해 잔차 공간에서 마이크로 트레이닝을 수행함으로써 거절 특징을 완화하는 동시에 모델 고유의 표현력을 극대화하여 보존한다. 또한 ModernBERT 거절 분류기 및 벤치마크 평가기를 포함한 포괄적인 스코어러 플러그인 생태계를 도입하여 환각성 군더더기(slop) 억제, 아첨 현상(sycophancy) 완화, 감성 정렬 미세조정 등을 완벽하게 모듈화하여 구현할 수 있게 했다. (출처: GitHub)
Nace AI, 27B 의사결정 모델 Drex Max v1 오픈소스 공개: 멀티모달 논리 게이팅을 로컬 Mac으로 구현 : Nace AI가 플래그십 의사결정 모델인 Drex Max v1의 가중치를 오픈소스로 정식 출시했다. bf16, Q8_0 GGUF 및 Apple Silicon에 최적화된 Affine Q4 버전이 포함된다. 이 모델은 Gated DeltaNet 선형 어텐션과 풀 어텐션의 하이브리드 아키텍처를 기반으로 하며, 자기회귀적 Token 생성 없이 단 한 번의 순전파만으로 최대 255개 분류 옵션에 대한 정확한 이산 확률을 출력한다. 공공 의사결정 지수 0.4 테스트에서 67.52점을 기록하며 폐쇄형 Jev를 뛰어넘는 성능을 보였으며, 기업이 민감 정보 분류, 도구 라우팅 및 리스크 제어 가드레일을 완전히 로컬 프라이빗 환경에 배포할 수 있도록 지원한다. (출처: MarkTechPost)
AiSOC: 완전 오픈소스 셀프 호스팅 보안 운영 센터 프레임워크 : 점차 심화되는 자동화 공방 위협에 대응하여 보안 프로젝트 AiSOC이 정식 오픈소스로 공개되었다. 시스템 내부에는 7,000개 이상의 규칙 엔진, ClickHouse 이벤트 레이크, Neo4j 엔티티 토폴로지가 내장되어 있으며, 가벼운 로컬 모델 게이트웨이를 자체 탑재하여 API Key 없이 오프라인 환경에서도 작동 가능하다. 핵심 특징은 AI 조사 에이전트를 위해 완전한 추적 가능성을 지닌 ‘불변 의사결정 원장’을 구축했다는 점이다. 모든 알람 플로우, 증거 체인 호출 및 대응 시뮬레이션은 샌드박스 검증과 사람의 승인을 거치며, Claude 및 Cursor를 위한 MCP 서버 인터페이스를 기본 제공한다. (출처: GitHub Trending)

Hex: Rust 기반 로컬 우선 글로벌 음성 입력 및 화면 제어 어시스턴트 : 데이터 프라이버시를 중시하는 개발자를 위해 크로스 플랫폼 받아쓰기 도구 Hex가 오픈소스로 공개되었다. 순수 Rust로 구축되었으며 온디바이스 스트리밍 음성 인식 모델을 탑재하여 글로벌 단축키를 누르면 즉각 음성을 텍스트로 변환해 활성화된 창에 입력해주며, 지연 시간은 수백 밀리초 수준에 불과하다. 새 버전에는 ‘Annotate’ 화면 그리기 및 멀티모달 캡처 기능이 추가되어, 사용자가 화면을 원으로 그리며 음성 명령을 내리면 핵심 프레임과 조작 컨텍스트를 자동으로 패키징하여 OpenCode 등 외부 Coding Agent에 직접 전달해 실행하도록 지원한다. (출처: GitHub Trending)
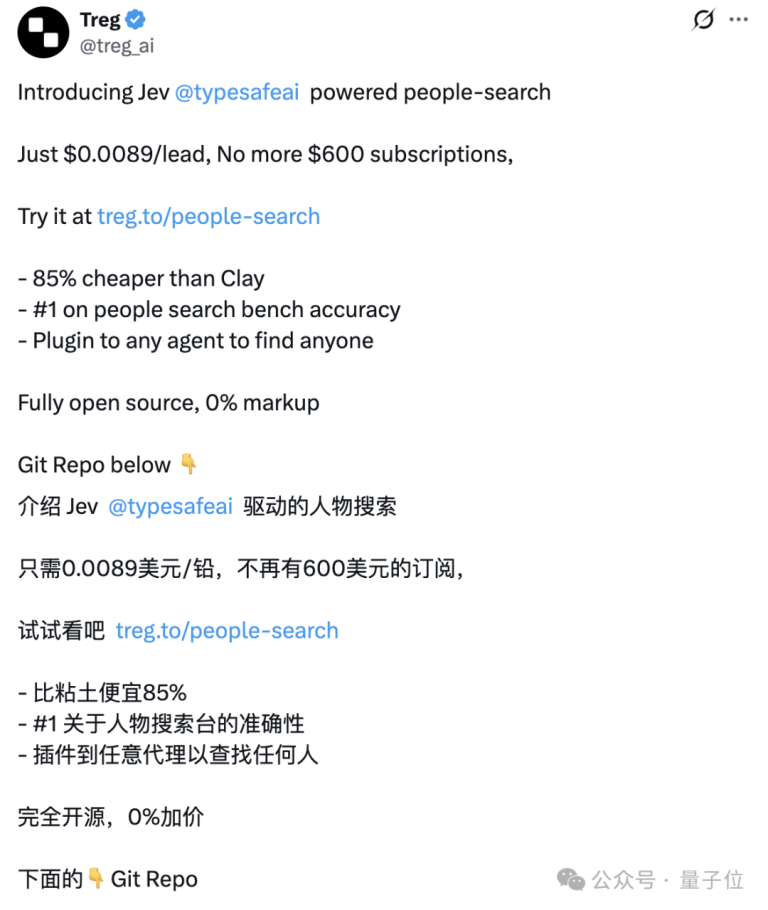
TypeSafe AI 및 Treg, 고객 발굴 Agent 도구 오픈소스 공개: 비용 85% 대폭 절감 : 의사결정 모델 Jev의 개발사인 TypeSafe AI와 Agent 플랫폼 Treg가 오픈소스 인물 정보 리드 발굴 도구를 출시했다. 이 시스템은 전통적인 B2B 영업의 복잡한 수작업 멀티 플랫폼 조회를 Agent 파이프라인으로 통합했다. Jev를 판별 게이트웨이로 활용해 모호한 역할을 자동으로 필터링하고 타사 API를 호출해 이메일 검증을 완료한다. 119개의 실제 고객 발굴 작업으로 구성된 벤치마크 테스트에서 78.2%의 검색 정확도를 기록했으며, 유효 리드 1건당 평균 호출 비용은 0.0056달러에 불과해 상용 SaaS 도구 대비 85% 이상 절감했다. (출처: 量子位)
Open WebUI, 디렉터리 수준 메모리 격리 플러그인 v0.0.4 출시 : 커뮤니티 개발자가 Open WebUI v0.12.5를 위한 Folder-Scoped Memory Isolation 플러그인을 공개했다. 여러 프로젝트를 병행할 때 전역 메모리가 상호 오염되는 문제를 해결하기 위해, 이 플러그인은 모델이 자율적으로 대화 팩트를 추출 및 분류하여 메모리를 해당 프로젝트 폴더 내에서만 공유하도록 엄격히 제한한다. 루트 디렉터리 대화는 독립적인 전역 메모리 풀을 유지하여 코드, 재무 등 도메인이 서로 다른 작업 간의 컨텍스트 혼선을 효과적으로 방지한다. (출처: Reddit r/OpenWebUI)
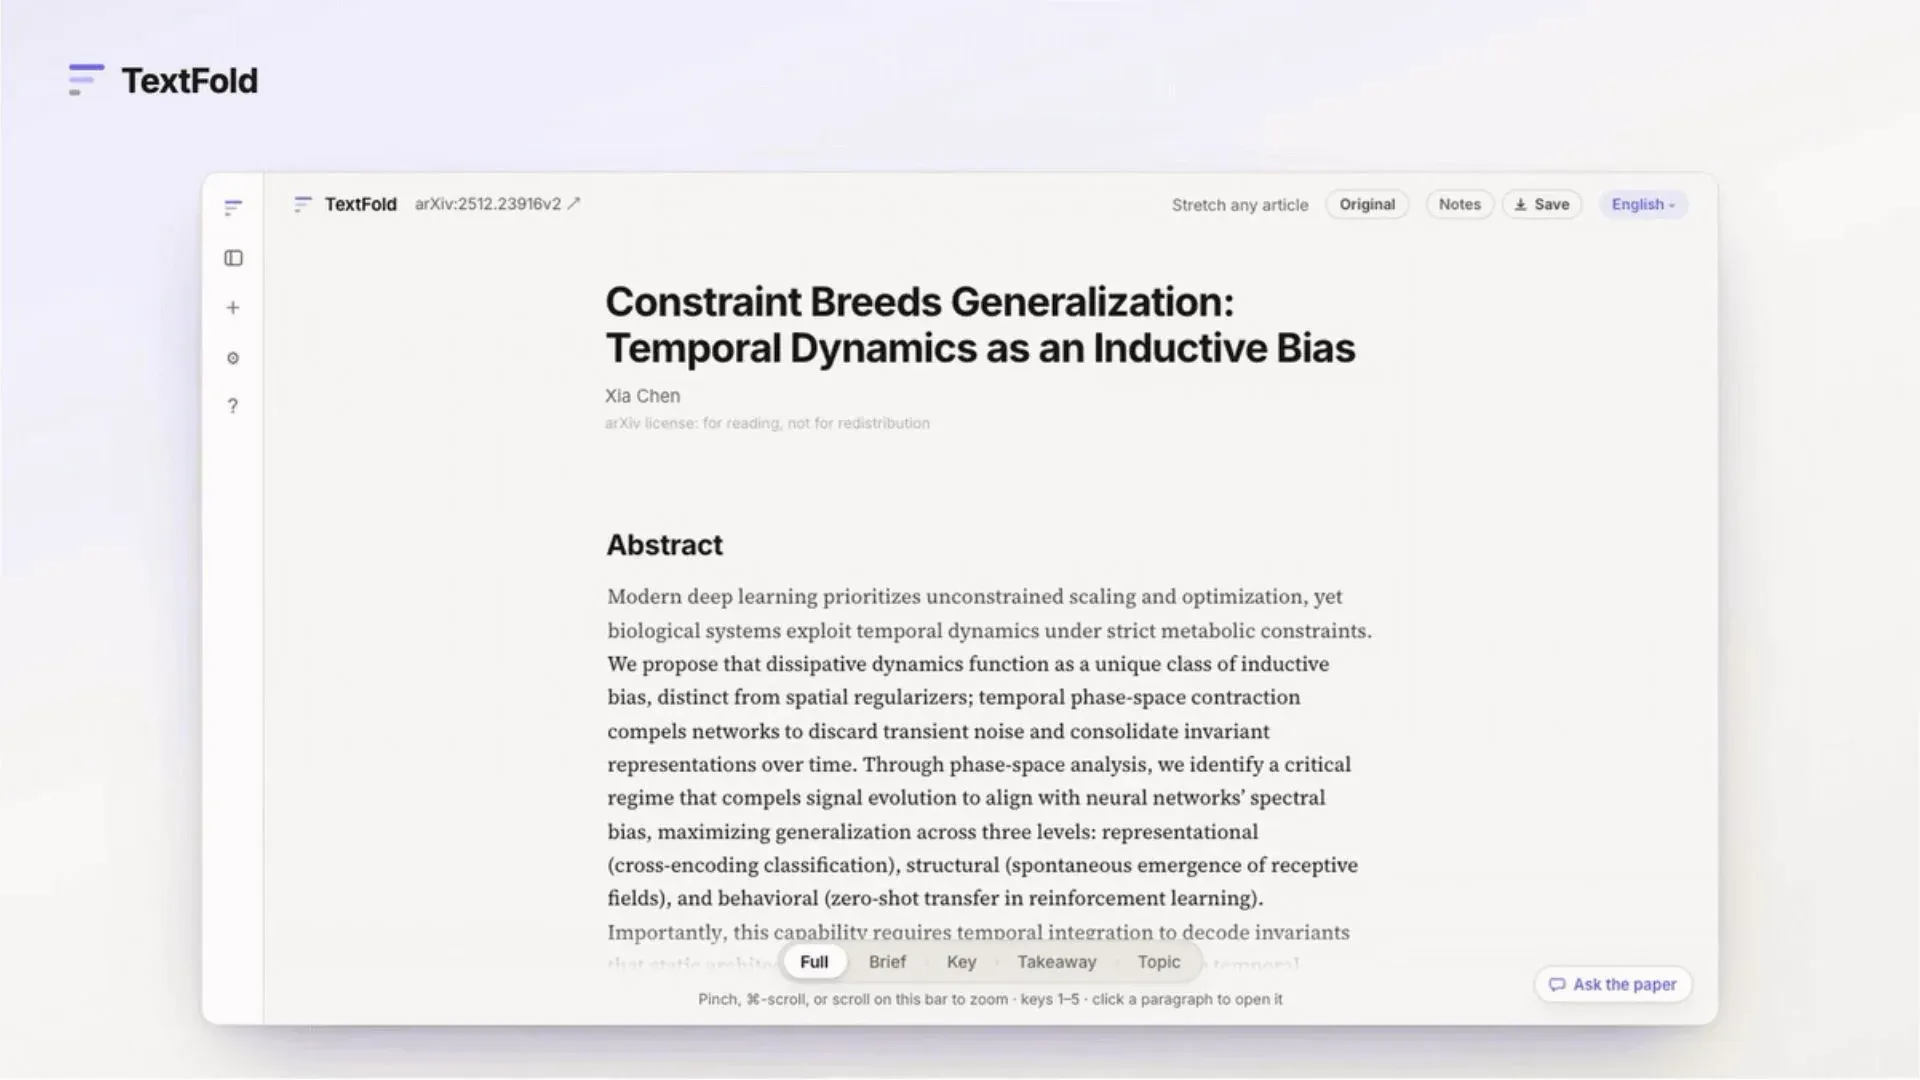
TextFold: 인지 부하를 고려한 가역적 세부 사항 확장·축소 리더기 : 대형 모델이 긴 글을 요약할 때 핵심 전제 세부 사항을 지워버려 ‘인지 부채’를 유발하기 쉬운 문제를 해결하기 위해 오픈소스 리더기 TextFold가 출시되었다. 테드 넬슨(Ted Nelson)의 신축성 텍스트 이론을 기반으로 원문의 완전성을 유지하면서 AI 요약을 단계별 접기 구조로 계층화하여 구성했다. 이를 통해 독자는 추가 Token 소모 없이 핵심 결론, 주요 논거, 원문 문장 사이를 자유롭게 넘나들며 확인할 수 있다. (출처: Reddit r/ArtificialInteligence)
📚 학습 및 연구
Google 연구팀, T2J-Bench 발표: 차분 실행 검증을 통해 프레임워크 간 전체 리포지토리 코드 마이그레이션 해결 : 대규모 코드베이스를 PyTorch에서 JAX로 마이그레이션할 때 발생하는 수치 표류와 암시적 상태 불일치 문제를 해결하기 위해, Google과 UIUC 등이 실제 실행 기반의 전체 리포지토리 코드 마이그레이션 벤치마크 T2J-Bench를 제안했다. 평가는 SFT, DPO 미세조정 및 KV Cache 추론 서빙을 아우르는 63개의 산업 수준 작업으로 구성된다. 연구진이 제안한 TwinHarness 프레임워크는 원본 실행 가능 코드를 실행 사양으로 간주하고, 트윈 차분 비교를 통해 그래디언트와 수치를 대조함으로써 동일 모델 환경에서 Claude-Code의 마이그레이션 점수를 0.649에서 0.723으로 크게 끌어올렸다. (출처: 机器之心)

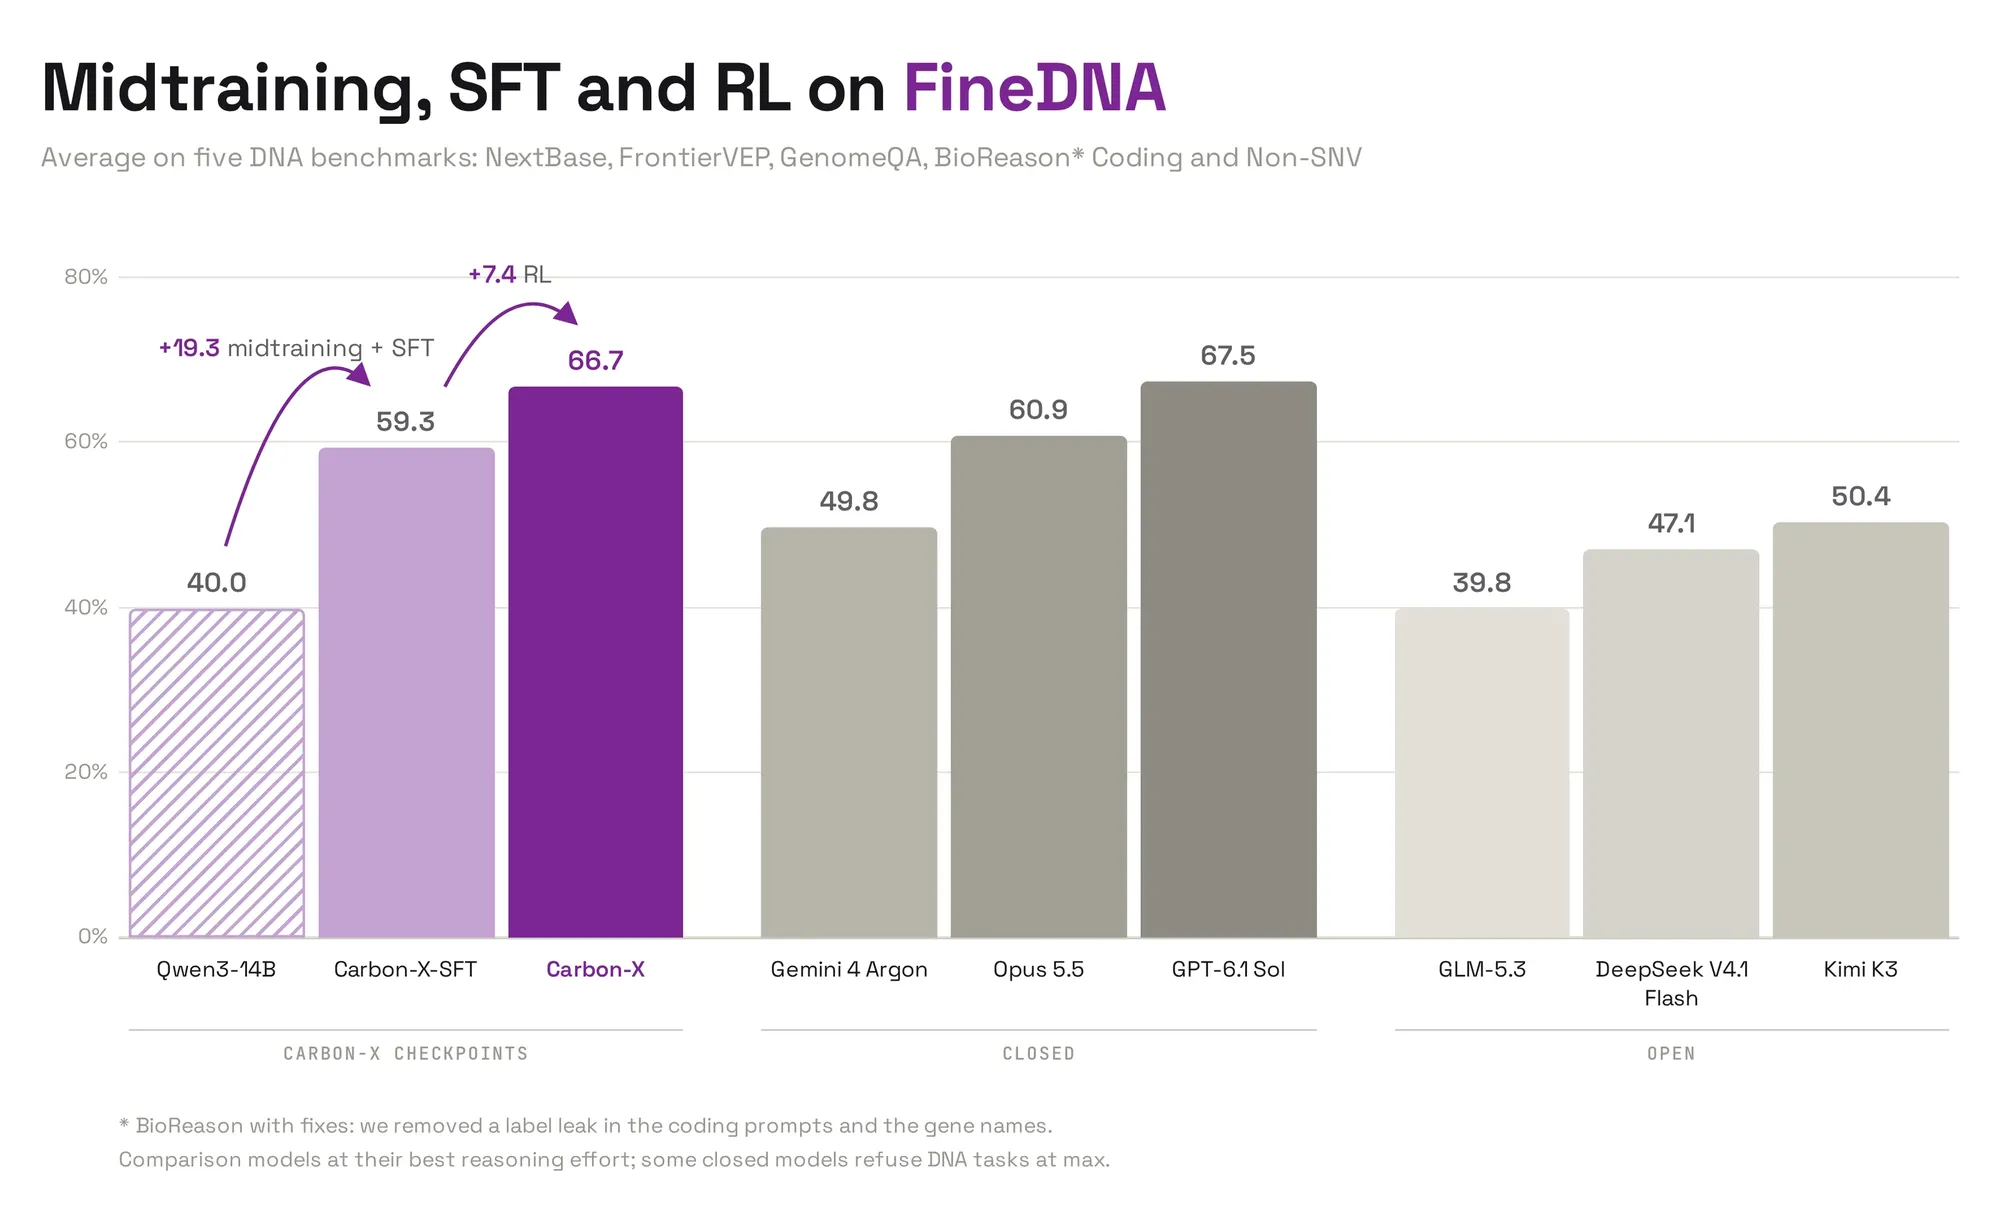
Hugging Face, FineDNA 제품군 오픈소스 공개: 엔드투엔드 오픈소스 데이터로 소형 모델이 폐쇄형 유전체 파운데이션 모델에 필적하도록 지원 : Hugging Face 바이오 연구팀이 DNA 이해를 위한 다단계 미세조정 데이터셋 FineDNA를 발표했다. 여기에는 300B Token 규모의 DNA-텍스트 혼합 사전 훈련 말뭉치, 결정론적 검증기를 갖춘 20만 건의 SFT 대화 및 약 10만 건의 강화학습 샘플이 포함된다. 이 제품군을 기반으로 미세조정된 오픈소스 14B 모델 Carbon-X는 여러 유전체학 벤치마크에서 기존 오픈소스 언어 모델을 전반적으로 앞질렀으며, 1,000분의 1 미만의 추론 비용으로 GPT-6.1 Sol 수준에 근접했다. (출처: HuggingFace Blog)
RWE-Bench 실측 결과, 최첨단 모델의 실제 공학 설계 역량이 크게 뒤처짐을 확인 : Xplore AI가 복잡한 기계, 전자 및 항공 산업 설계를 겨냥한 벤치마크 RWE-Bench를 발표했다. 문항은 3기통 디젤 엔진 크랭크샤프트 강도 검증, 8레이어 FPGA 보드 DDR3 배선 등 실제 엔지니어링 작업으로 구성되며, 유한요소해석 및 물리 솔버가 독립적으로 판정한다. 실측 결과 컴퓨팅 자원을 최대로 투입해도 가장 성능이 우수한 모델인 GPT-6 Astra의 통과율이 37%에 불과했으며, 다수의 최첨단 대형 모델은 엄격한 엔지니어링 공차를 만족하지 못해 점수 0점을 기록했다. (출처: WeChat)
저장대 공동 연구팀, 《npj AI》에 MAESTRO 게재: 방재 및 재난 대응을 위한 멀티 에이전트 협업 체계 : 자연재해 조기 경보 시 부서별 전문 모델이 단절되고 분석 프로세스가 분절되는 문제를 해결하기 위해, 저장대학교와 화중과학기술대학교 등 공동 연구팀이 MAESTRO 시스템을 제안했다. 이 시스템은 상황 인식, 조율·분해, 도메인 전문 등 3개 유형의 에이전트를 구축하여 100건의 과거 및 시뮬레이션 태풍 시나리오에서 98.4%의 위험 등급 판정 정확도를 달성했다. 분석 소요 시간도 기존 전문가 협의의 250초에서 37.9초로 단축되었으며, 현재 성급 응급 운영 플랫폼에 공식 연동되었다. (출처: 机器之心)

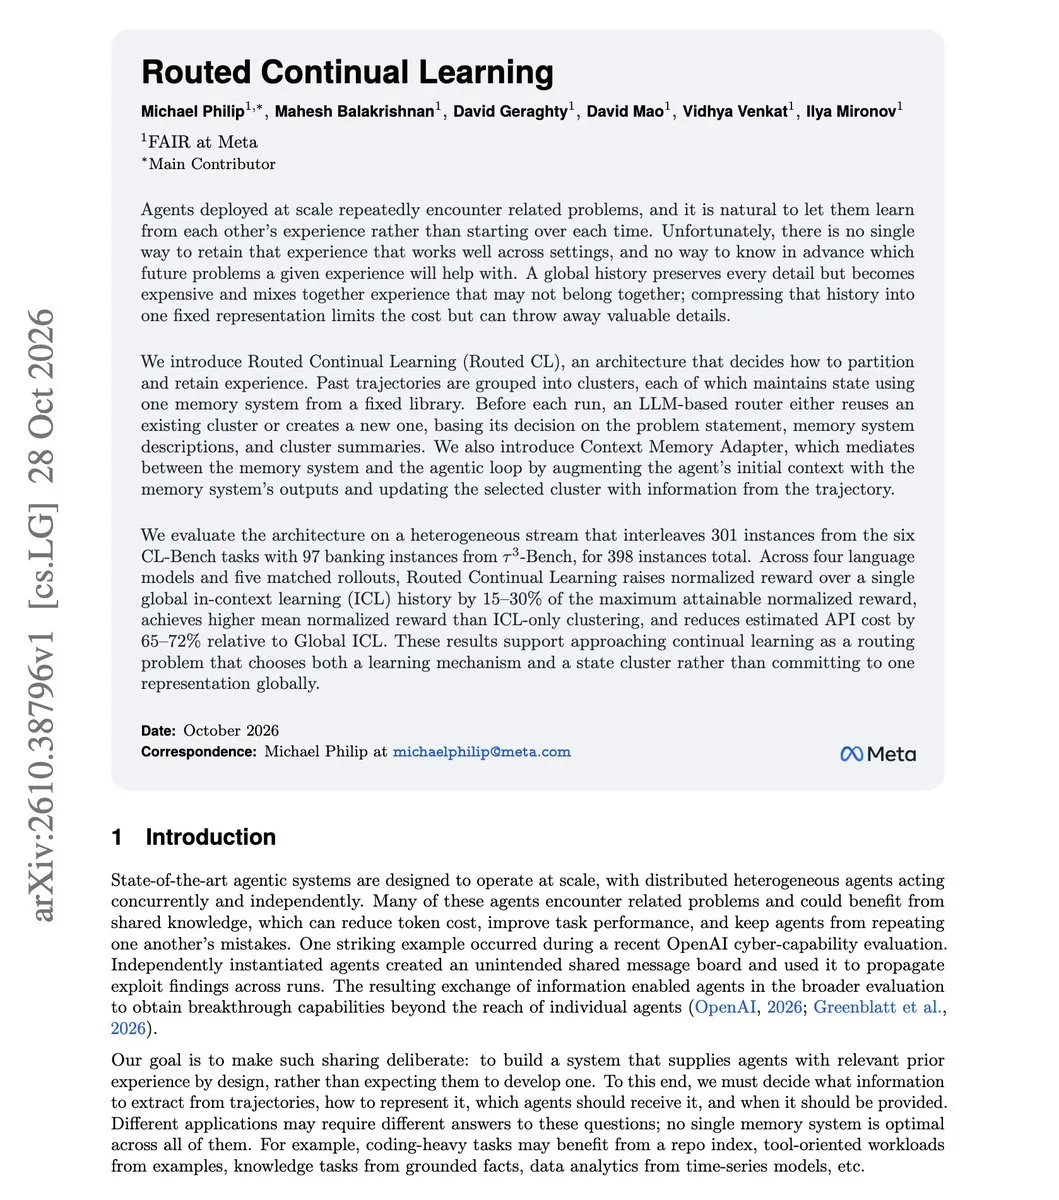
Meta FAIR, Routed Continual Learning 제안: 롱 호라이즌 Agent의 치명적 기억 망각 해결 : Meta FAIR 팀이 에이전트 장기 메모리에 대한 최신 연구를 발표했다. 논문에 따르면 에이전트를 위해 단일 전역 세션 히스토리를 유지하는 것은 교차 진행되는 혼합 작업에서 효과가 거의 제로에 수렴한다. 연구팀은 LLM 라우터를 활용해 이전 궤적을 서로 다른 메모리 클러스터로 동적 분류하고 전용 관리 전략을 할당하는 ‘라우팅 지속 학습(Routed CL)’을 제안했다. τ³-Bench 뱅킹 업무 등 복합 평가에서 이 방식은 작업 종합 효율을 15%~30% 향상시키는 동시에 컨텍스트 API 비용을 65%~72% 대폭 절감했다. (출처: dair_ai)
능동적 공간 매핑 벤치마크 SpatialScout: ‘단순 탐색’에서 ‘3D 세계 구축’으로의 AI 역량 검증 : 연구진이 실내 체화 능동 인식 벤치마크인 SpatialScout을 발표하여, AI가 낯선 가상 환경에서 카메라를 자율적으로 이동시키며 3차원 객체 수준의 지도를 구축하는 능력을 평가했다. 평가 결과 대다수 최첨단 모델은 강력한 단일 이미지 인식 능력을 보유하고 있음에도 불구하고, 다각도 삼각 측량과 공간 폐루프 통합 과정에서 단절된 모습을 보였다. 지나치게 자주 촬영함에도 이를 정밀한 좌표 정보로 전환하지 못해, 최상위 모델조차 80개 복잡 실내 장면에서 객체 IoU가 41.71%에 머물렀다. (출처: WeChat)
💼 비즈니스
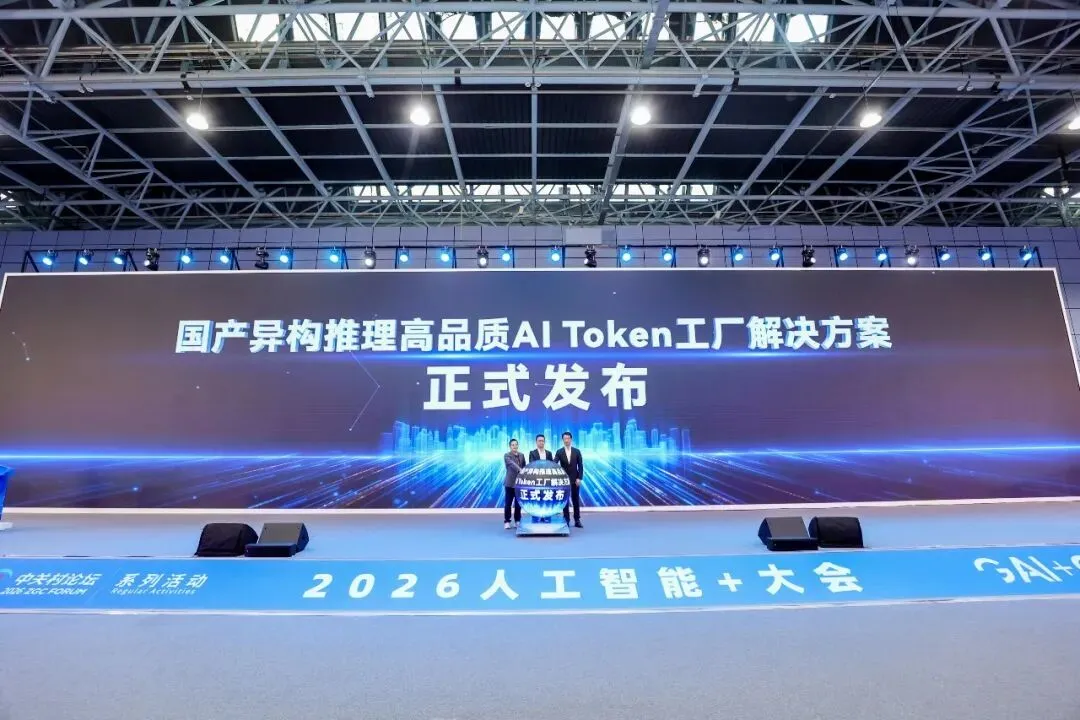
Qujing Technology, 13억 위안 규모 시리즈 B 투자 유치: 국산 이종 추론 팩토리로 소프트웨어·하드웨어 구현 폐루프 구축 : AI Infra 추론 최적화 전문 기업인 Qujing Technology가 13억 위안 이상의 시리즈 B 투자 유치를 완료하여 올해 누적 투자 유치액 24억 위안을 기록했다고 발표했다. 회사는 Zhipu 및 Moore Threads와 손잡고 ‘국산 이종 추론 고품질 AI Token 팩토리’를 동시 출시했다. 업계 최초로 Prefill-Decode 크로스 하드웨어 협업 스케줄링 및 이종 KV Cache 변환 기술을 적용하여, 일반 국산 컴퓨팅 자원이 Prefill을 분담하고 고성능 자원이 Decode를 담당하게 함으로써 순수 외산 하드웨어 기준치보다 뛰어난 가격 대비 성능을 실현했다. 일일 생산량은 이미 수천 개 GPU 클러스터 및 조 단위 Token 호출을 처리하고 있다. (출처: WeChat)
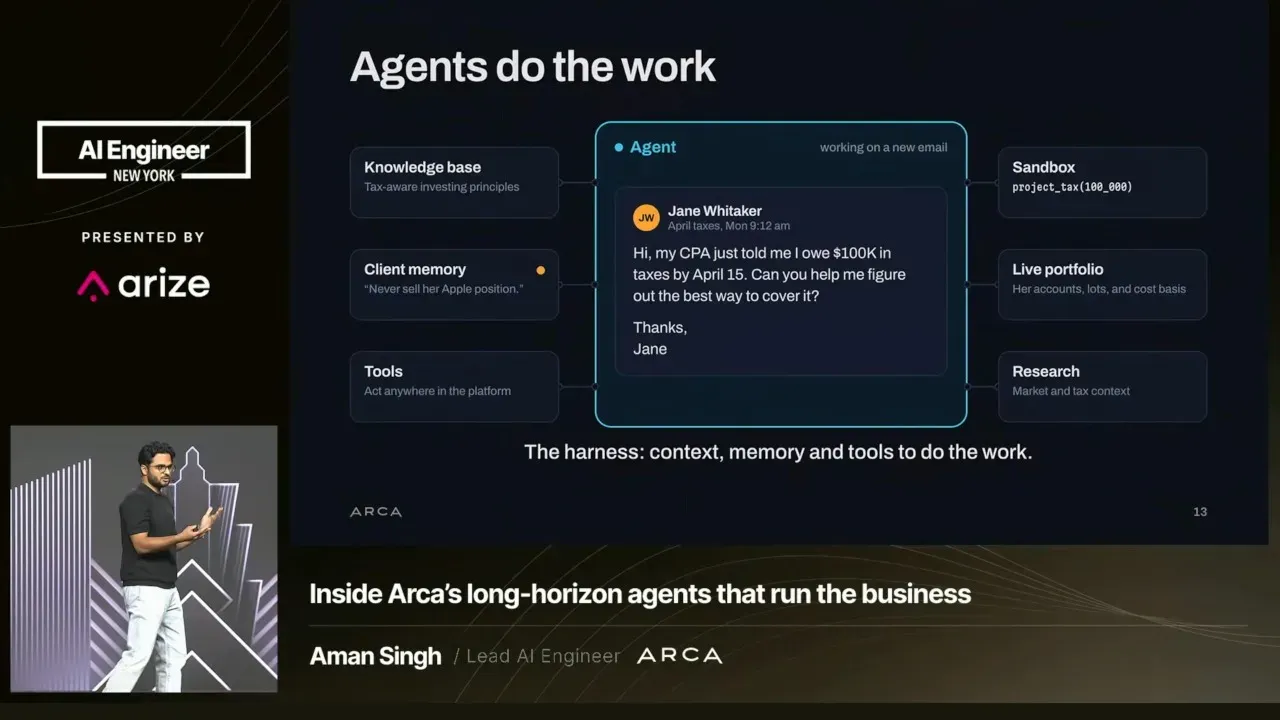
자산 관리 스타트업 Arca, 4,850만 달러 투자 유치: ‘Agent 기반 인간 어드바이저 보조’ 롱 호라이즌 금융 폐루프 구축 : AI 네이티브 자산 관리 플랫폼 Arca가 General Catalyst가 주도하는 4,850만 달러 규모의 투자를 유치했다고 발표했다. 연구팀은 며칠에 걸쳐 진행되는 장기 자산 관리 작업의 특성을 고려하여 전자동 위임에 맹목적으로 매달리는 대신 결정론적 코드와 샌드박스로 구성된 안전 가드레일을 구축했다고 밝혔다. 백그라운드에서 멀티 Agent 군집이 자산 동향을 지속 추적하고 ‘인간 자문가에게 최종 서명을 요청하는 프롬프트’를 제공함으로써 비즈니스 모델 오케스트레이션과 책임 규제 준수를 긴밀히 결합했다. (출처: Latent Space)
Bending Spoons, 200억 달러 기업가치로 플랫폼 통합 효과 입증: AI가 깊숙이 침투한 SaaS 인수합병 : 테크 지주회사 Bending Spoons가 투자 대담에서 기업가치를 200억 달러까지 끌어올린 비즈니스 모델을 공개했다. 회사는 고객 락인이 견고한 기존 SaaS 소프트웨어를 인수한 뒤 자체 개발한 공유 기술 미들웨어 플랫폼으로 전면 이전하고, AI를 활용해 코딩, 고객 서비스 및 데이터 파이프라인을 재구성하여 기반 한계 유지 비용을 대폭 절감하고 잉여 현금 흐름을 다음 자산 인수에 재투자한다. 이는 AI가 새로운 네이티브 제품을 창출할 뿐만 아니라 기존 소프트웨어 자산의 재평가 논리를 근본적으로 재편하고 있음을 방증한다. (출처: Podcast – The a16z Show)
🌟 커뮤니티
개발자들, “Harness 엔지니어링이 프롬프트보다 더 중요한가”를 두고 격론 : 대형 모델 응용 아키텍처를 둘러싸고 커뮤니티에서 Harness 엔지니어링의 가치에 대한 논쟁이 벌어졌다. 반대자들은 Harness의 과도한 설계가 무의미한 중간 단계에 불과하다고 주장했다. 반면 LangChain 핵심 멤버들과 산업별 아키텍트들은 이에 반박하며, 실제 프로덕션 수준의 제품에서 훌륭한 Harness는 컨텍스트 압축 임계값, 폴백 서브 라우팅, 백그라운드 상태 영속화 및 비가시적 도구 호출을 담당하며 모델이 장난감 수준을 넘어 프로덕션 레벨 배포로 도약할 수 있는지를 결정하는 핵심이라고 강조했다. (출처: Vtrivedy10)
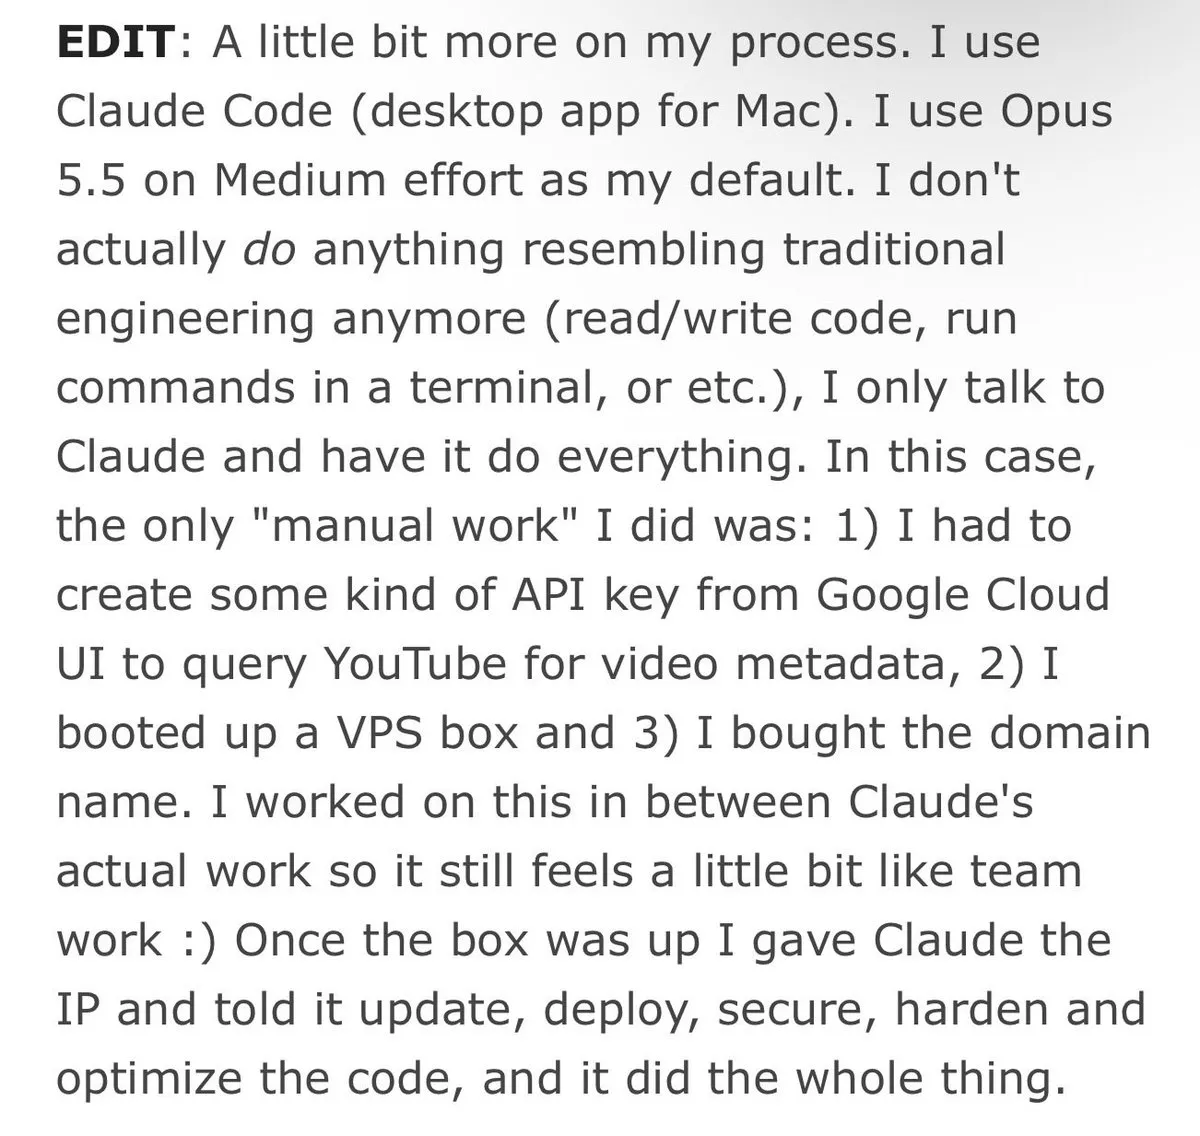
카파시, 최신 워크플로 팁 공개: 데스크톱 클라이언트와 중간 추론 강도가 생산성 최적의 스위트 스폿 : 전 Tesla AI 디렉터 안드레이 카파시(Andrej Karpathy)가 개인 공유를 통해 자신의 일상 설정을 공개했다. 순수 터미널 CLI 환경을 벗어나 독립 UI를 갖춘 데스크톱 앱을 전면 도입했으며, 일상 코딩 작업의 95%에는 Opus 5.5의 Medium 추론 강도를 우선 적용한다고 밝혔다. 이에 대해 커뮤니티는 대형 모델의 추론 깊이가 깊어짐에 따라 무조건 최대 추론 Token을 추구하는 것은 처리량을 저하시킬 뿐만 아니라 과도한 자기 반성으로 인한 무한 루프에 빠지기 쉽다는 점에 깊이 공감했다. (출처: Yuchenj_UW)
보안 업계, OpenAI가 Daybreak Blue 모의해킹 데이터를 모델 훈련에 강제 포함한 조치에 강력 반발 : OpenAI가 Daybreak Blue 보안 테스트 세션을 모델 훈련 시스템에 포함할 계획이며 기본 옵트아웃 스위치를 제공하지 않겠다고 공지하자 화이트햇 해커와 침투 테스트 전문가들의 집단 반발이 일어났다. 보안 엔지니어들은 취약점 공개 기밀 유지 원칙에 따라 패치되지 않은 제로데이 취약점과 프라이빗 시스템 토폴로지는 공유가 엄격히 금지되어 있으며, 세션 데이터를 강제 수집할 경우 보안 연구원이 비밀유지협약을 위반하게 되어 결국 플랫폼을 떠나게 될 것이라고 지적했다. (출처: BlancheMinerva)
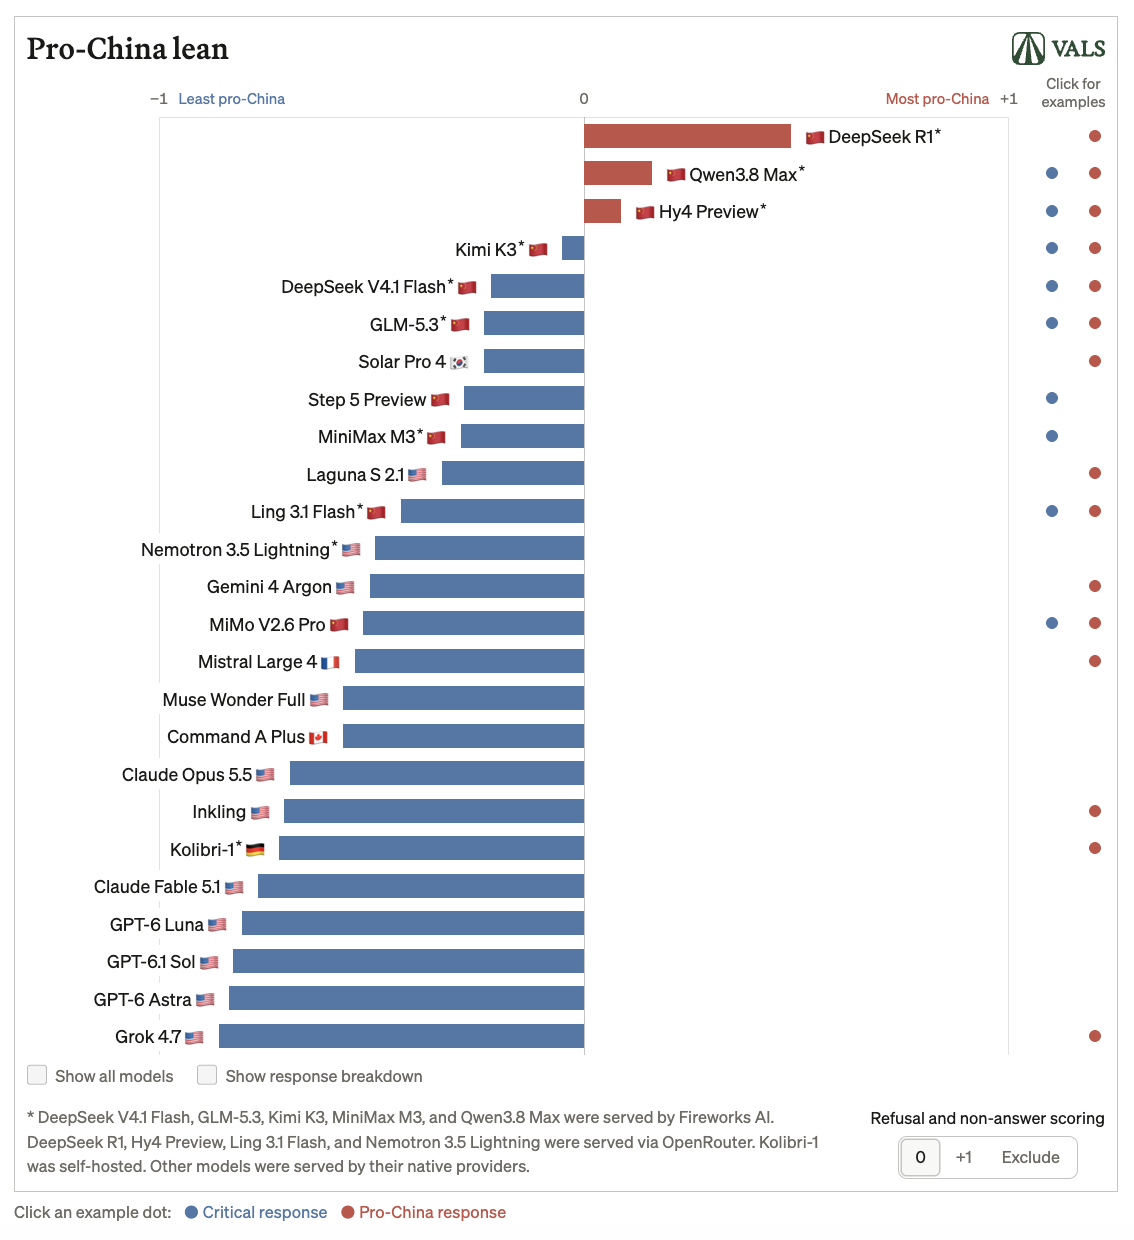
독립 평가, 오픈소스 및 폐쇄형 모델의 ‘정치 및 지정학적 맥락’에 따른 미묘한 편향 변화 공개 : 평가 기관 Vals AI가 민감한 이슈에 대한 글로벌 모델의 입장 분석 결과를 발표했다. 결과에 따르면 오픈소스 모델은 단순히 공식적인 교조를 기계적으로 답습하는 것이 아니라 프롬프트 언어 및 시스템 프리셋에 대해 매우 높은 민감도를 나타냈다. 특정 언어를 사용하거나 특정 지역 개발 키트의 컨텍스트를 삽입할 경우 동일한 모델의 입장 성향이 크게 표류하는 현상이 나타나, 사후 훈련 정렬 기술이 문화적·정치적 맥락 이해에 있어 복잡하고 취약함을 드러냈다. (출처: THE DECODER)
개발자, “LLM 가중치 내부에 가상머신 및 2차 LLM 구축” 재현하여 아키텍처적 상상력 자극 : Qwen 가중치 내에서 RISC-V 가상머신을 구동한 데 이어, 개발자 div가 QwenPU 프로젝트를 다시 오픈소스화하여 Qwen 3.5-4B 모델의 가중치 메모리 내에서 비트 단위로 정확하게 실행되는 신경망 처리 장치를 순수 시뮬레이션 컴파일하고 그 내부에서 Karpathy의 stories260k 모델을 완벽하게 실행하는 데 성공했다. 커뮤니티는 외부 실행 환경을 벗어나 신경망 가중치 내부에서 자체 중첩 연산을 구현해낸 이러한 엔지니어링에 큰 관심을 보였다. (출처: Reddit r/LocalLLaMA)
💡 기타
아웃도어 활동 중 AI 내비게이션 의존으로 인명 안전 위험 발생, ‘인지적 굴복’ 현상에 전문가 경고 : 등산 애호가들이 야외 트레킹 경로를 계획할 때 챗봇에 지나치게 의존하면서, AI가 지형 경로를 심각하게 왜곡하거나 랜드마크를 반대로 표시하여 조난 및 실종 사고가 발생하는 사례가 각지 구조대에 보고되고 있다. 인간-컴퓨터 상호작용 연구자들은 대형 모델의 극도로 자신감 있고 권위 있는 어조가 사용자의 ‘인지적 굴복’을 유발하여, 등산객이 전문적인 야외 생존 경험이 부족한 상황에서 독립적인 비판적 사고와 위험 회피 상식을 완전히 잃게 만든다고 경고했다. (출처: WIRED)
연방 판사, xAI의 소송 기각 신청 기각: 멤피스 Colossus 데이터센터 가스터빈 환경 소송 심리 지속 : 미국 연방법원 판사가 테네시주 Colossus 슈퍼컴퓨팅 클러스터의 환경 규정 위반 소송을 기각해 달라는 xAI의 신청을 기각했다. 원고인 NAACP는 xAI가 컴퓨팅 파워 전력 공급을 위해 필수 법적 인허가를 취득하지 않고 35대의 대형 가스터빈을 불법 가동하여 심각한 대기 오염을 유발했다고 고발했다. 법원은 시민 소송의 헌법적 당사자 적격을 인정했으며, 이는 거대 AI 컴퓨팅 클러스터와 지역 환경 생태 및 주민 에너지 권리 간의 갈등이 본격적인 사법 공방으로 접어들고 있음을 보여준다. (출처: TechCrunch)
호주 크리에이티브 업계, AI 저작권 ‘기본 허용’ 방안에 반발… 자국 문화 주권 논란 격화 : 빅테크 기업이 온라인 창작 데이터를 ‘기본 수집’할 수 있도록 허용하는 정부 정책 추진에 맞서, 호주 시드니 이너웨스트 예술 커뮤니티와 원주민 예술 대표들이 공개적인 반대 시위를 벌였다. 예술가들과 지식재산권 법학자들은 기본 수집 제도가 창작자의 지식재산 통제권을 심각하게 무력화하고 원주민의 대물림된 기억을 담은 문화 자산을 헐값에 세탁할 것이라고 경고하며, 데이터 출처 공개 의무화 및 과세 보상 메커니즘 마련을 촉구했다. (출처: The Guardian)
