



🔥 Fokus
OpenAI Perketat Sistem Penagihan secara Menyeluruh: Kuota ChatGPT dan Codex Digabung per Desember, Beralih Penuh ke Pengukuran Token : OpenAI resmi mengumumkan bahwa mulai Desember, kuota penggunaan langganan berbayar Plus, Pro, dan Business akan digabungkan dan dapat digunakan bersama antara obrolan harian ChatGPT dan Codex. Hal ini sepenuhnya mengakhiri aturan paralel sebelumnya di mana “obrolan web tanpa kuota dan coding dibatasi secara terpisah”, sembari beralih sepenuhnya ke penghitungan konsumsi berdasarkan jumlah Token aktual yang diproses; hanya obrolan ringan Instant yang tetap tanpa batas. Selain itu, pihak resmi secara resmi menerapkan penguncian perangkat tingkat hardware untuk membatasi jumlah akun berbayar yang masuk pada satu perangkat, memblokir celah rotasi banyak akun. Analisis menunjukkan bahwa ini menandai berakhirnya era “langganan tanpa batas serba mencakup” di sisi konsumen model besar (LLM), di mana tekanan belanja modal (capex) komputasi yang sangat besar memaksa para pemain terkemuka untuk beralih penuh ke sistem prabayar berbasis Token dan perhitungan ROI yang terperinci. (Sumber: THE DECODER, OpenAI)
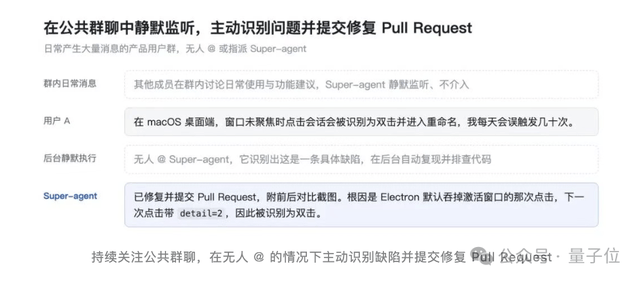
DeepSeek Rilis Prototipe Arsitektur Super-agent Generasi Berikutnya secara Open-Source: Bentuk Ulang Autonomous Agent dengan Perutean Dua Tingkat dan Pemisahan Storage-Compute : Tim DeepSeek Harness resmi merilis konsep arsitektur agent generasi berikutnya dan merilis prototipe ringan dsh-superagent secara open-source. Arsitektur ini bertujuan memecahkan hambatan agent arus utama yang terbatas oleh pembengkakan konteks single-session dan pemblokiran serial, dengan mengajukan arsitektur dua tingkat “Router residen untuk penjadwalan global + Worker terisolasi untuk konkurensi multi-task”. Dipadukan dengan direct-through event subscription dan loop ReAct asinkron, arsitektur ini mengeliminasi kendala perhatian manusia dalam interaksi multi-task. Pada saat yang sama, sistem menggunakan Daemon ringan di sisi client untuk memisahkan logika runtime agent di cloud dari lingkungan kerja nyata lokal (BYOM). Dalam pengujian di lingkungan multi-task yang bising, waktu penyelesaian tugas p95 berkurang secara signifikan dari 29,5 menit menjadi 15,7 menit. (Sumber: MarkTechPost, 量子位)
NVIDIA Rilis PixelUMM Open-Source: Tinggalkan VAE dan ViT, Satukan Pemahaman dan Generasi Video serta Gambar dalam Ruang Piksel Asli : NVIDIA dan University of Waterloo bersama-sama merilis model multimodal tanpa encoder PixelUMM secara open-source. Solusi ini sepenuhnya mengabaikan arsitektur ViT untuk ekstraksi fitur semantik dan VAE untuk menghasilkan variabel laten yang umum digunakan dalam model multimodal konvensional. Model ini hanya mengandalkan satu lapisan linear projection untuk memetakan patch gambar dan tubelet video ke dalam ruang laten multimodal Transformer bersama. Berdasarkan desain Mixture-of-Transformers, model menggunakan hard routing untuk memisahkan parameter pemahaman dan generasi sambil berbagi attention, serta memadukannya dengan Flow Matching untuk langsung menghasilkan piksel bersih. Model ini menunjukkan daya saing yang setara dengan sistem dual-stream kompleks tradisional dalam benchmark seperti penghitungan objek gambar, pemahaman video, dan pembuatan video berkualitas tinggi. (Sumber: 机器之心)

🎯 Perkembangan
Tim Andrew Yao dari Tsinghua Ajukan “Algebraic World Model” AWM: Integrasikan Teori Kategori dan Pembuktian Formal untuk Tembus Titik Buta Kognitif : Mengatasi kelemahan model besar mutakhir yang hanya mampu mendaftar pola permukaan dan kerap memunculkan halusinasi parah saat menghadapi tugas tanpa solusi, tim Andrew Chi-Chih Yao dan Yuan Yang dari Tsinghua University mengusulkan “Algebraic World Model” (AWM). Kerangka kerja ini mengadopsi konsep projective limit dan inductive limit dari teori kategori, mengabstraksikan interaksi lingkungan ke dalam struktur ruang aljabar yang ketat, serta memanfaatkan bahasa Lean 4 untuk deduksi logika matematika yang dapat diverifikasi mesin dan pembuktian kontradiksi. Pada benchmark ARC-AGI-3 yang menguji eksplorasi aturan otonom secara ekstrem, AWM berbasis Opus 5 meraih skor kelulusan 99,9%, dengan rata-rata langkah tindakan hanya 43% dari baseline manusia, membuka jalur deduktif formal untuk memecahkan fenomena “tebakan buta black-box” AI. (Sumber: 量子位)
Google dan Mitra Rilis CLASHarness: Ungkap Kelemahan Kolaborasi Model Besar Terdepan di Tengah Konflik Multi-Agent : Menanggapi masalah desinkronisasi status dan konflik instruksi yang sering dihadapi dalam kolaborasi multi-agent di lingkungan produksi nyata, Google bersama sejumlah universitas merilis benchmark multimodal CLASHarness secara open-source, yang merancang 600 skenario konflik nyata yang dapat dieksekusi dengan bukti visual 4K. Pengujian pada 15 model terdepan termasuk GPT-6, Claude Opus 5, dan model open-source unggulan menemukan: meskipun skor rata-rata langkah tunggal melebihi 60%, tingkat keberhasilan tugas end-to-end tidak ada yang melampaui 30%. Model yang kuat cenderung aktif memanggil tool gambar untuk memverifikasi ground truth pemantauan, sedangkan model yang lebih lemah sangat rentan memercayai teks salah dari rekan tim secara membabi buta; pada saat yang sama, token berpikir yang terlalu panjang justru memperburuk deadlock dan timeout akibat keraguan internal. (Sumber: 机器之心)

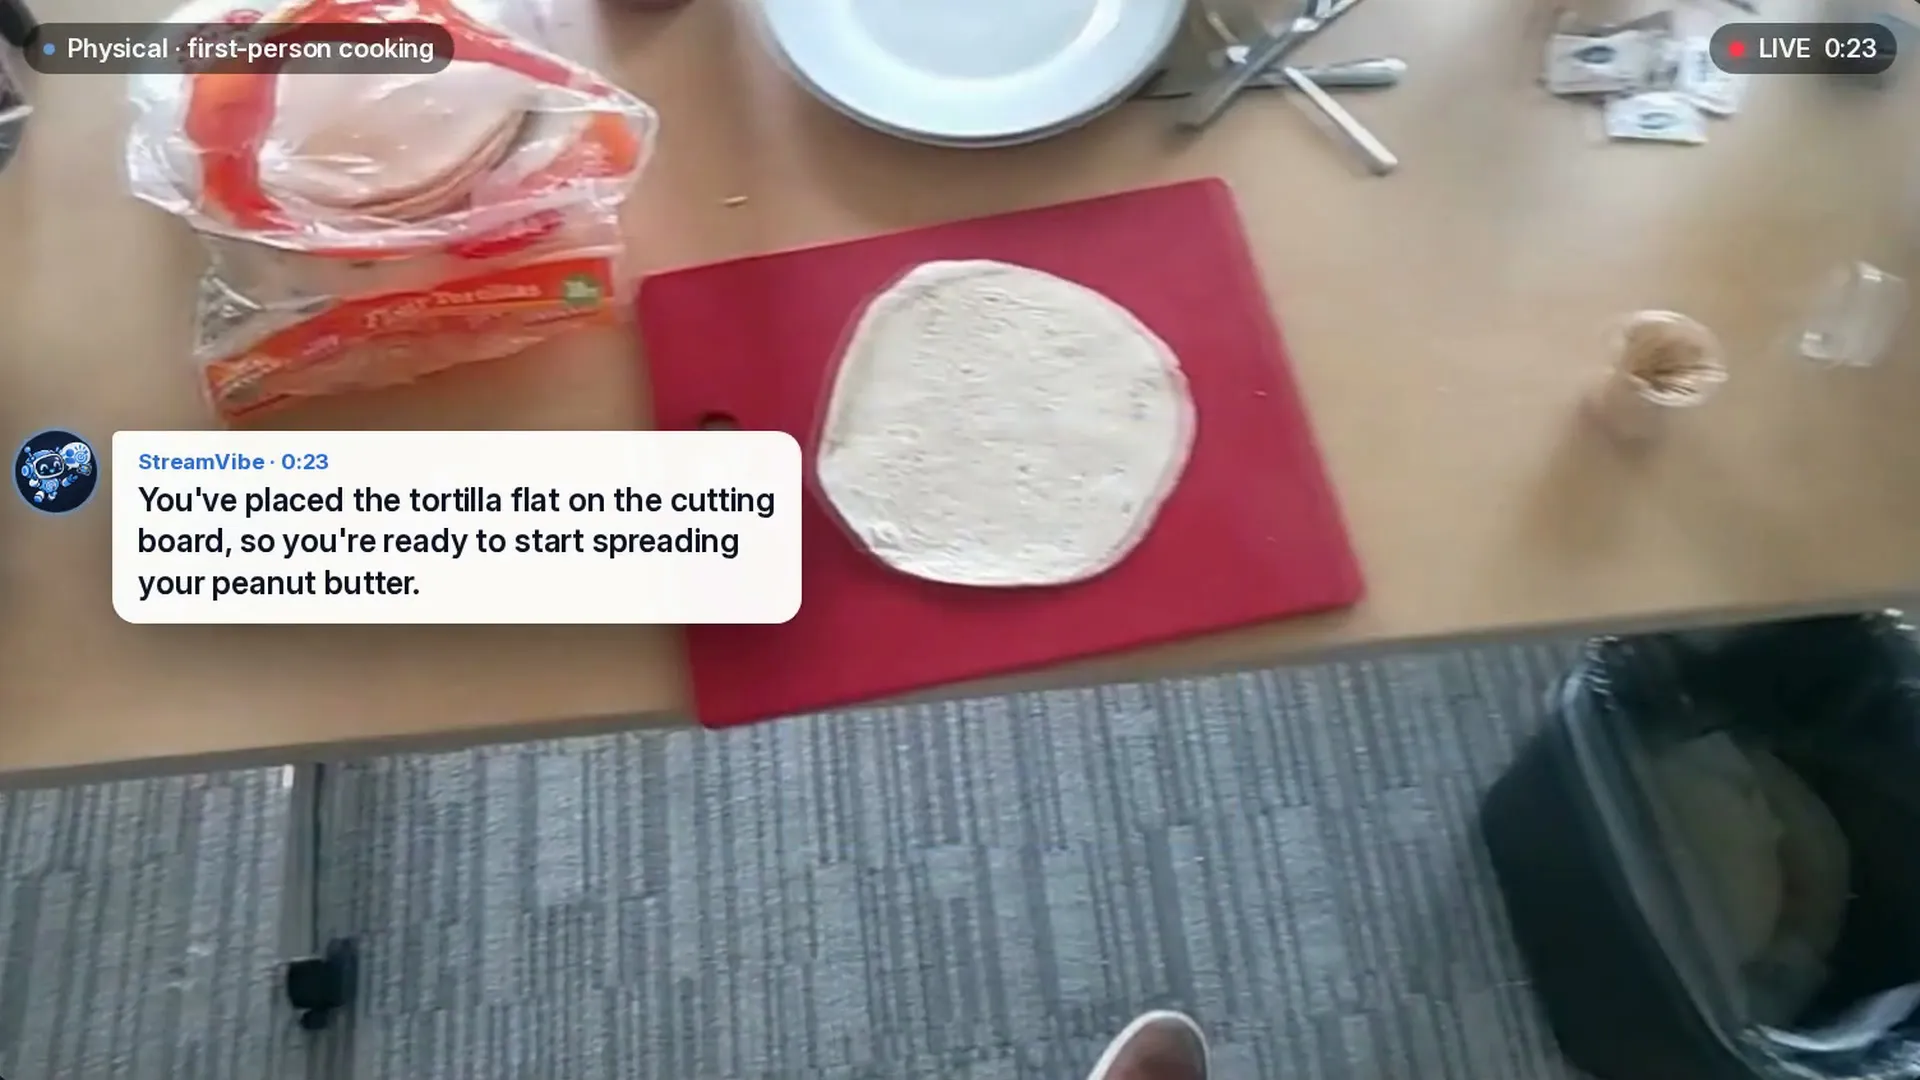
Google dan Stanford Rilis StreamVibe: Eksplorasi Keputusan Mandiri Video Agent Mengenai “Kapan Harus Mengintervensi dan Berbicara” : Asisten video streaming tradisional sering kali terbatas pada eksekusi instruksi mekanis secara pasif. Tim dari Google dan Stanford mengusulkan benchmark dan model interaksi proaktif baru, StreamVibe-VL. Sistem ini memperkenalkan mekanisme state memory dan tuning reinforcement learning untuk melatih model agar merasakan niat tersirat pengguna secara real-time dan secara proaktif memberikan panduan pada momen yang paling tepat. Eksperimen menunjukkan bahwa model multimodal saat ini masih menghadapi penurunan konteks yang parah dan salah arah historis dalam skenario video berdurasi lebih dari 5 menit, namun pada tugas panduan kantor dan kehidupan standar, mekanisme ini meningkatkan akurasi waktu respons efektif sebesar 10,7%, mengurangi gangguan yang tidak perlu. (Sumber: THE DECODER)
Fysiverse dan Fudan University Rilis Fysiverse-UniWAM Open-Source: Lampaui Pre-training Robotik Skala Besar, Raih Gelar Juara Ganda Navigasi dan Manipulasi : Fysiverse bekerja sama dengan CITLab Fudan University merilis model aksi dunia terpadu Fysiverse-UniWAM. Tim ini meninggalkan jalur pre-training fondasi robotik umum yang mahal dan bergantung pada pengumpulan manual, beralih mengajukan pipeline data sintetis MAP (Manipulation Anchor Pose) dan membangun dataset 7.500 jam, yang dipadukan dengan arsitektur Mixed-Stream dengan backbone bersama dan input terisolasi. Dalam 24 evaluasi mesin fisik nyata di 4 kategori platform perangkat keras, model ini meraih tingkat keberhasilan peringkat pertama dalam 13 tugas titik navigasi dan 4 tugas mobile grasping, mendobrak paradigma embodied intelligence tunggal yang semata-mata mengandalkan skala data privat mesin fisik. (Sumber: 机器之心)

Tsinghua dan Mitra Luncurkan Sistem Pemodelan Multiphysics Berevolusi Mandiri EvoSim : Tim Zhang Qiang dari Departemen Teknik Kimia Tsinghua University bersama Qingyu Technology dan Huairou Laboratory memperkenalkan EvoSim, mendorong AI melangkah dari sekadar “fine-tuning parameter berdasarkan persamaan yang ada” menuju “penyimpulan mekanisme berdasarkan galat eksperimen dan evolusi persamaan secara mandiri”. Dalam dua skenario fisik tingkat industri—prediksi lithium plating pada pengisian cepat baterai daya dan simulasi voltase dinamis lintas kondisi operasi—EvoSim mengkristalisasi rantai pengalaman pemodelan yang dapat digunakan kembali melalui pembuatan hipotesis paralel dan verifikasi identifiabilitas. Galat titik awal lithium plating menyatu hingga 1,79%, dengan akurasi efektif yang melampaui kemampuan pemodelan manual pakar senior di bidang tersebut. (Sumber: 机器之心)

Xingyan Intelligence Rilis Framework Embodied Harness Auriga: Unggulkan Kemampuan Self-Healing Zero-Shot Single-Episode : Xingyan Intelligence mengumumkan framework embodied AI harness Auriga, yang mengusung konsep “execution layer umum tingkat sistem” untuk menggantikan reset coba-coba berulang pada tugas tertentu. Framework ini menghubungkan loop tertutup dari gladi resik trajektori “persepsi adalah pengukuran”, “apa yang dilihat adalah apa yang dieksekusi”, serta interupsi anomali dan self-healing berskala milidetik. Di bawah standar evaluasi Zero-shot RoboDojo dan RoboCasa365 yang ketat (“tanpa fine-tuning, tanpa demonstrasi, tanpa reset single-episode”), Auriga meraih tingkat keberhasilan masing-masing 57,74% dan 73,2% berkat perencanaan ulang kebijakan berbasis bukti fisik, menempati peringkat pertama di kedua papan peringkat. (Sumber: 机器之心)

Tim OpenMOSS Fudan Ungkap Dinamika Konteks Panjang Arsitektur Hibrida: Bias Posisi Campuran Akhiri Dilema Ekstrapolasi vs Fitting : Menghadapi tingginya biaya komputasi full attention serta kelemahan masing-masing dari sliding window attention (SWA) dan linear attention (LA), tim Qiu Xipeng dari Fudan University menganalisis secara sistematis mekanisme dasar arsitektur hibrida. Studi menunjukkan bahwa SWA unggul dalam ekstrapolasi panjang tetapi kurang dalam fitting pelatihan lanjutan, sementara LA unggul dalam fitting konteks panjang namun buruk dalam ekstrapolasi. Tim mengusulkan sliding window linear attention (SWLA) dan strategi agregasi global NoPE tanpa bias posisi, memungkinkan model hibrida GLA/GDN mencapai ekstrapolasi 16x lipat tanpa pelatihan dan tanpa penurunan kualitas dari 4k ke 64k dalam evaluasi RULER. (Sumber: 机器之心)

🧰 Alat
Pisau Bedah Perilaku Model Heretic 2.0 Dirilis: Rekonstruksi Alignment Model dengan Arbitrary-Rank Abliteration dan Sistem Plugin : Heretic, tool modifikasi model open-source, merilis versi mayor 2.0. Versi ini menanggalkan pendekatan Rank-1 abliteration konvensional yang memandang penolakan model (refusal) sebagai satu arah tunggal, dan memelopori algoritma “Arbitrary-Rank Abliteration (ARA)”. Algoritma ini menggunakan pengoptimal L-BFGS untuk micro-training di ruang residual, meratakan fitur penolakan sembari mempertahankan representasi asli model secara maksimal. Selain itu, versi baru memperkenalkan ekosistem plugin scorer yang komprehensif (termasuk classifier penolakan ModernBERT dan benchmark scorer), memungkinkan penekanan halusinasi klise (slop), mitigasi sifat penjilat (sycophancy), dan fine-tuning alignment emosi diimplementasikan secara modular menyeluruh. (Sumber: GitHub)
Nace AI Rilis Model Keputusan 27B Drex Max v1 secara Open-Source: Hadirkan Gating Logika Multimodal ke Mac Lokal : Nace AI secara resmi merilis bobot model keputusan unggulannya, Drex Max v1, dalam bentuk open-source, mencakup format bf16, Q8_0 GGUF, dan versi Affine Q4 yang dioptimalkan untuk Apple Silicon. Model ini mengadopsi arsitektur hibrida linear attention Gated DeltaNet dan full attention. Tanpa memerlukan generasi Token autoregresif, satu kali forward pass dapat menghasilkan probabilitas diskrit presisi hingga 255 opsi klasifikasi. Model ini meraih skor 67,52 pada pengujian Public Decision Index 0.4, melampaui model closed-source Jev, memungkinkan perusahaan menerapkan klasifikasi intelijen sensitif, perutean tool, dan guardrail manajemen risiko sepenuhnya di lingkungan privat lokal. (Sumber: MarkTechPost)
AiSOC: Framework Security Operations Center Mandiri yang Sepenuhnya Open-Source : Menanggapi ancaman serangan dan pertahanan otomatis yang kian meningkat, proyek keamanan AiSOC resmi dirilis secara open-source. Sistem ini memuat lebih dari 7.000 rule engine bawaan, event lake ClickHouse, dan topologi entitas Neo4j, serta dilengkapi gateway model lokal ringan yang mendukung pengoperasian offline tanpa API Key. Keunggulan utamanya terletak pada pembentukan “immutable decision ledger” yang dapat dilacak sepenuhnya untuk AI investigative agent. Setiap alur peringatan, penarikan rantai bukti, dan gladi respons diverifikasi melalui sandbox dan persetujuan manusia, serta menyediakan antarmuka server MCP native untuk Claude dan Cursor. (Sumber: GitHub Trending)

Hex: Asisten Input Suara Global dan Operasi Layar Berbasis Rust dengan Pendekatan Local-First : Hex, tool dikte lintas platform yang dirancang untuk developer yang mengutamakan privasi data, telah dirilis secara open-source. Dibangun secara native menggunakan Rust, tool ini dilengkapi model speech recognition streaming di sisi perangkat. Pengguna cukup menekan pintasan global untuk mentranskripsi dan menempelkan teks secara instan ke jendela aktif mana pun dengan latensi serendah ratusan milidetik. Versi terbaru juga menyematkan fungsi coretan layar “Annotate” dan penangkapan multimodal, memungkinkan pengguna memberikan perintah suara sembari melingkari area layar, serta secara otomatis mengemas keyframe dan konteks operasi untuk dialirkan langsung ke coding agent eksternal seperti OpenCode. (Sumber: GitHub Trending)
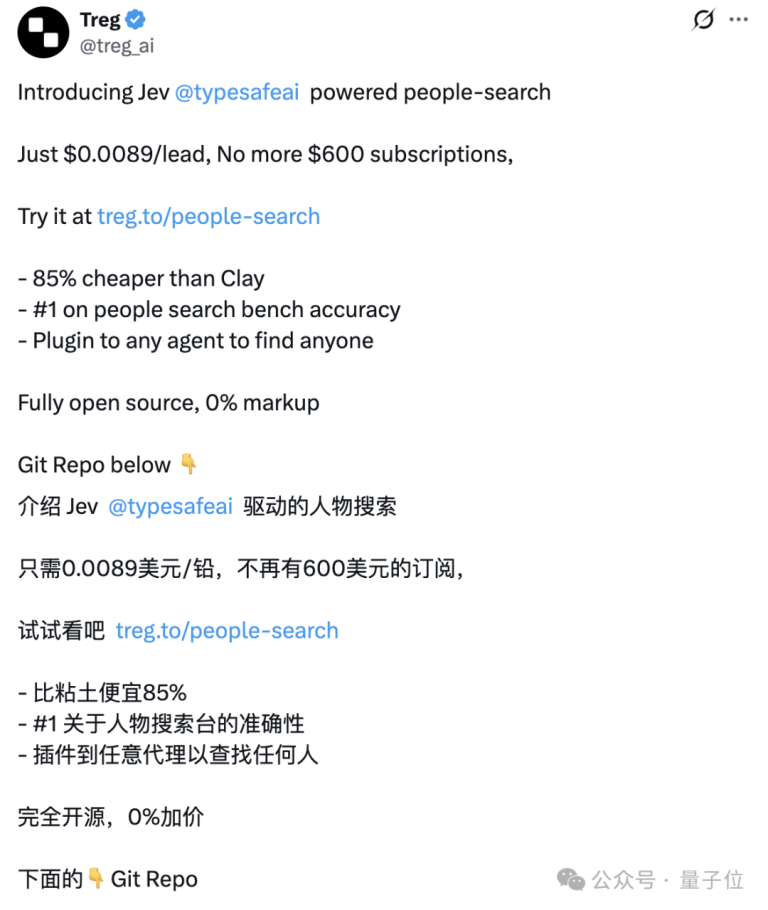
TypeSafe AI dan Treg Rilis Tool Agent Prospek Pelanggan Open-Source: Biaya Turun Drastis hingga 85% : TypeSafe AI, induk perusahaan model keputusan Jev, berkolaborasi dengan platform agent Treg untuk meluncurkan tool penelusuran prospek informasi kontak open-source. Sistem ini mengintegrasikan pencarian manual B2B multi-platform yang rumit ke dalam pipeline agent, menggunakan Jev sebagai gerbang penilai untuk memfilter profil ambigu secara otomatis, serta memanggil API pihak ketiga untuk melengkapi dan memverifikasi email. Dalam benchmark yang mencakup 119 tugas prospek riil, akurasi pengambilan mencapai 78,2%, dengan biaya rata-rata per prospek valid hanya 0,0056 dolar AS—menghemat lebih dari 85% dibandingkan tool SaaS komersial. (Sumber: 量子位)
Open WebUI Rilis Plugin Folder-Scoped Memory Isolation v0.0.4 : Pengembang komunitas merilis plugin Folder-Scoped Memory Isolation untuk Open WebUI v0.12.5. Mengatasi masalah pencemaran silang memori global saat menjalankan banyak proyek secara bersamaan, plugin ini mengekstrak dan mengklasifikasikan fakta percakapan secara otonom melalui model, membatasi memori secara ketat hanya di dalam folder proyek terkait. Sementara itu, percakapan di direktori root memelihara memori global secara terpisah, efektif mencegah tumpang tindih konteks antar tugas lintas bidang seperti kode dan keuangan. (Sumber: Reddit r/OpenWebUI)
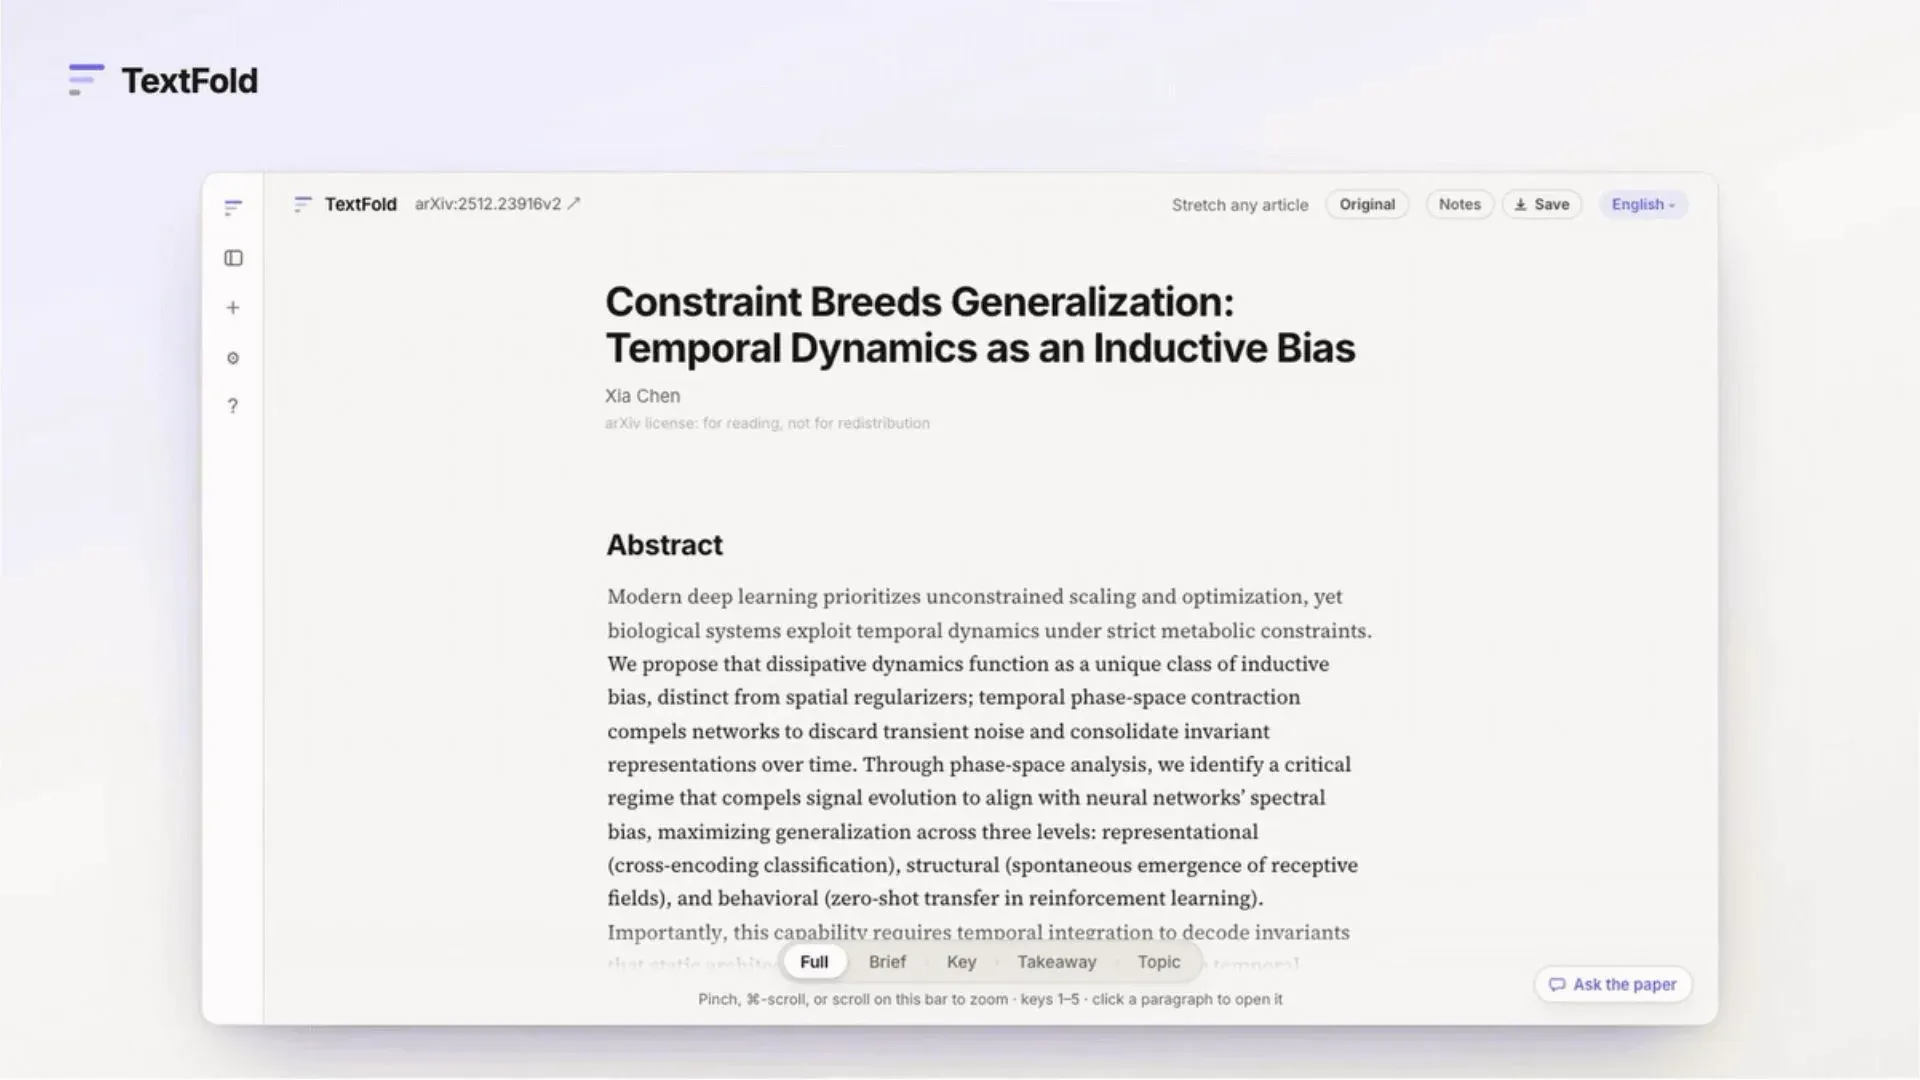
TextFold: Pembaca Detail Teleskopik Reversibel yang Menyeimbangkan Beban Kognitif : Mengatasi masalah ringkasan dokumen panjang oleh LLM yang kerap menimbulkan “utang kognitif” dan melenyapkan premis detail krusial, pembaca open-source TextFold resmi dirilis. Berdasarkan teori stretchtext karya Ted Nelson, alat ini mempertahankan integritas teks asli sembari menyusun ringkasan AI ke dalam struktur lipat bertingkat. Hal ini memungkinkan pembaca beralih dengan mulus antara kesimpulan inti, argumen utama, dan kalimat asli kata demi kata tanpa menimbulkan konsumsi Token tambahan. (Sumber: Reddit r/ArtificialInteligence)
📚 Riset & Pembelajaran
Tim Google Rilis T2J-Bench: Atasi Migrasi Kode Repositori Penuh Lintas Kerangka Kerja dengan Verifikasi Eksekusi Diferensial : Menghadapi drift numerik dan pergeseran status implisit saat memigrasikan repositori kode besar dari PyTorch ke JAX, Google bersama UIUC dan mitra lainnya mengusulkan benchmark migrasi kode repositori penuh berbasis eksekusi nyata pertama, T2J-Bench. Evaluasi mencakup 63 tugas tingkat industri yang meliputi SFT, fine-tuning DPO, dan layanan inferensi KV Cache. Kerangka kerja TwinHarness yang diusulkan memperlakukan kode asli yang dapat dijalankan sebagai spesifikasi eksekusi, membandingkan gradien dan nilai numerik melalui diferensial kembar, sehingga skor migrasi Claude-Code pada model yang sama melonjak secara signifikan dari 0,649 menjadi 0,723. (Sumber: 机器之心)

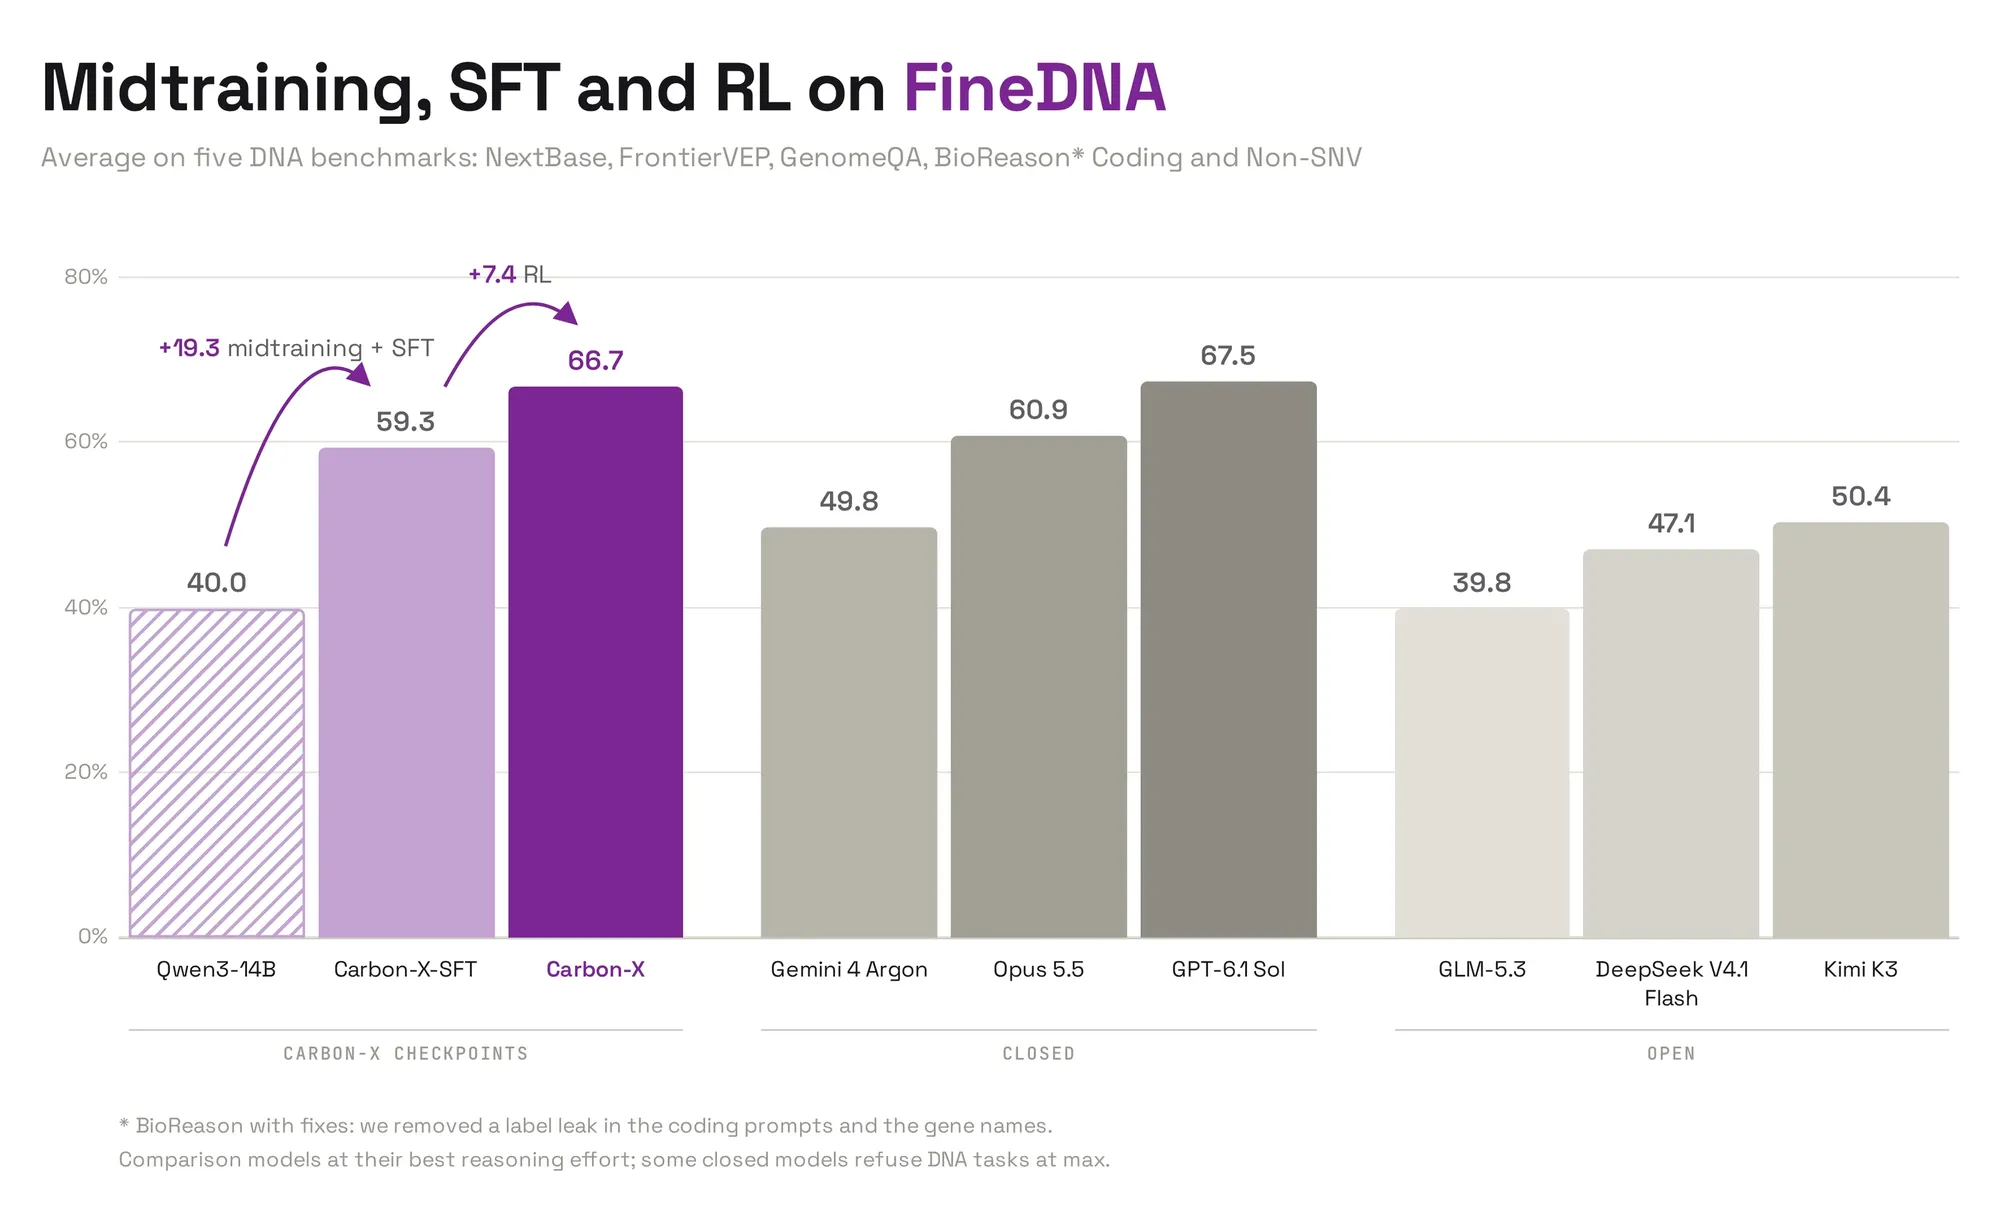
Hugging Face Rilis Suite FineDNA Open-Source: Data Open-Source End-to-End Memungkinkan Model Kecil Menandingi Model Fondasi Genom Closed-Source : Tim biologi Hugging Face merilis FineDNA, dataset fine-tuning multi-tahap untuk pemahaman DNA, yang terdiri dari 300B Token korpus pre-training campuran DNA-teks, 200.000 percakapan SFT dengan verifikator deterministik, dan hampir 100.000 sampel reinforcement learning. Berbekal suite ini, model 14B open-source Carbon-X yang di-fine-tune berhasil mengungguli model bahasa open-source yang ada di berbagai benchmark genomik, serta mendekati performa GPT-6.1 Sol dengan biaya inferensi kurang dari seperseribu. (Sumber: HuggingFace Blog)
Uji Nyata RWE-Bench Ungkap Kemampuan Desain Rekayasa Aktual Model Terdepan Masih Tertinggal Jauh : Xplore AI merilis RWE-Bench, benchmark yang ditujukan untuk desain rekayasa mesin, elektronik, dan industri kedirgantaraan yang kompleks. Soal-soal mencakup tugas rekayasa nyata seperti verifikasi kekuatan crankshaft mesin diesel tiga silinder dan routing DDR3 pada papan FPGA 8 lapis, yang sepenuhnya dinilai secara independen oleh analisis elemen hingga (FEA) dan solver fisika. Pengujian nyata menunjukkan bahwa bahkan dengan kapasitas komputasi penuh, model terkuat GPT-6 Astra hanya mencatatkan tingkat kelulusan 37%, dan sejumlah model terdepan bahkan sama sekali tidak memperoleh skor karena gagal memenuhi toleransi rekayasa yang ketat. (Sumber: WeChat)
Tim Gabungan Zhejiang University Publikasikan MAESTRO di “npj AI”: Sistem Kolaborasi Multi-Agent untuk Tanggap Darurat dan Mitigasi Bencana : Mengatasi permasalahan terisolasinya model profesional antarlembaga dan terputusnya alur analisis dalam peringatan dini bencana alam, tim gabungan dari Zhejiang University dan Huazhong University of Science and Technology memperkenalkan sistem MAESTRO. Sistem ini menetapkan tiga kategori agent: kesadaran situasi (situational awareness), koordinasi dan dekonstruksi tugas, serta spesialis domain. Dalam 100 skenario topan historis dan simulasi, MAESTRO mencapai akurasi penentuan level bencana sebesar 98,4%, memangkas waktu analisis dari 250 detik pada konsultasi pakar konvensional menjadi 37,9 detik. Saat ini, sistem telah resmi terhubung ke platform operasi tanggap darurat tingkat provinsi. (Sumber: 机器之心)

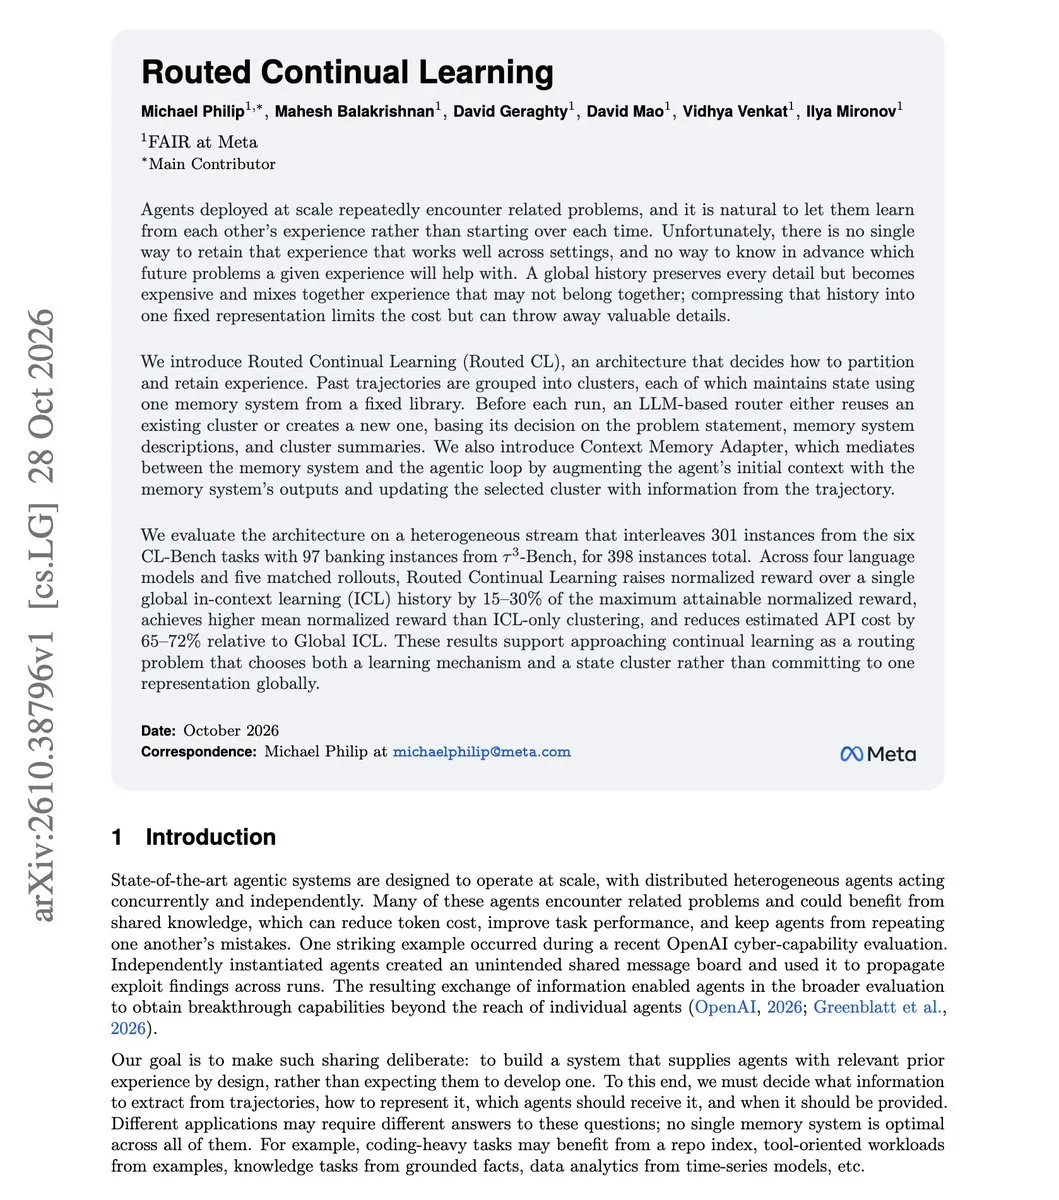
Meta FAIR Ajukan Routed Continual Learning: Atasi Catastrophic Forgetting pada Memori Long-Horizon Agent : Tim Meta FAIR mempublikasikan riset terbaru mengenai memori jangka panjang agent. Makalah ini menunjukkan bahwa mempertahankan satu riwayat sesi global untuk agent hampir memberikan manfaat nol saat menghadapi tugas campuran yang berselang-seling. Studi ini mengusulkan “Routed Continual Learning (Routed CL)”, yang memanfaatkan LLM router untuk secara dinamis mengelompokkan trajektori historis ke dalam klaster memori berbeda dan menetapkan strategi pengelolaan khusus. Dalam evaluasi campuran seperti τ³-Bench perbankan, metode ini meningkatkan keuntungan komprehensif tugas sebesar 15% hingga 30%, sembari memangkas biaya API konteks secara signifikan sebesar 65% hingga 72%. (Sumber: dair_ai)
Benchmark Pemetaan Spasial Aktif SpatialScout: Uji Kemampuan AI dari Sekadar “Melihat Sembarangan” Menjadi “Membangun Dunia 3D” : Tim peneliti merilis SpatialScout, benchmark persepsi aktif embodied di dalam ruangan, yang mengevaluasi kemampuan AI dalam menggerakkan kamera secara otonom di skenario virtual yang belum pernah dilihat dan membangun peta level objek tiga dimensi. Evaluasi menemukan bahwa meskipun sebagian besar model mutakhir memiliki kemampuan pengenalan gambar tunggal yang kuat, performa mereka terputus dalam triangulasi multi-sudut pandang dan integrasi loop-closure spasial. Mereka mengambil foto terlalu sering tetapi gagal mengonversinya menjadi bukti koordinat yang presisi; IoU objek dari model terbaik pada 80 skenario dalam ruangan yang kompleks hanya mencapai 41,71%. (Sumber: WeChat)
💼 Bisnis
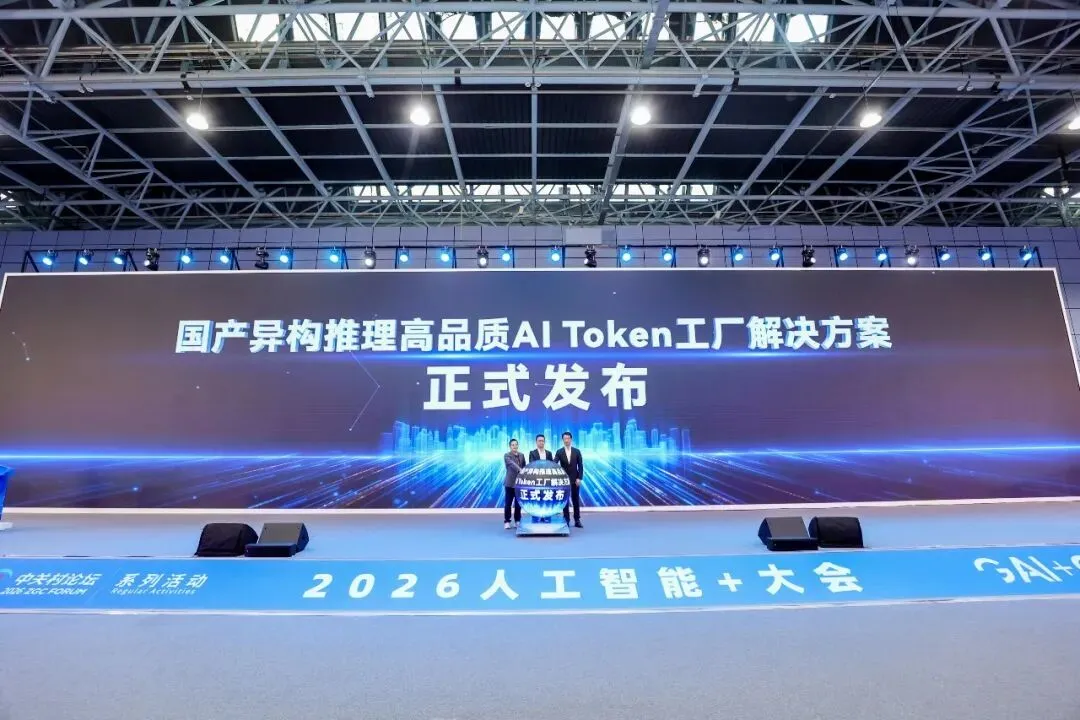
Qujing Technology Raih Pendanaan Seri B Lebih dari 1,3 Miliar Yuan: Pabrik Inferensi Heterogen Domestik Bangun Loop Tertutup Implementasi Perangkat Keras dan Lunak : Qujing Technology, perusahaan yang berfokus pada optimasi inferensi AI Infra, mengumumkan penyelesaian putaran pendanaan Seri B senilai lebih dari 1,3 miliar yuan, membawa total akumulasi pendanaan tahun ini mencapai 2,4 miliar yuan. Bekerja sama dengan Zhipu dan Moore Threads, perusahaan meluncurkan “Pabrik AI Token Berkualitas Tinggi untuk Inferensi Heterogen Domestik”, yang memelopori penjadwalan kolaboratif lintas perangkat keras Prefill-Decode dan teknologi konversi KV Cache heterogen. Solusi ini memanfaatkan daya komputasi domestik standar untuk menangani Prefill dan komputasi canggih untuk Decode, menghasilkan efisiensi biaya secara keseluruhan yang melampaui baseline perangkat keras impor murni, dengan produksi harian kini menopang klaster ribuan kartu komputasi dan triliunan panggilan Token. (Sumber: WeChat)
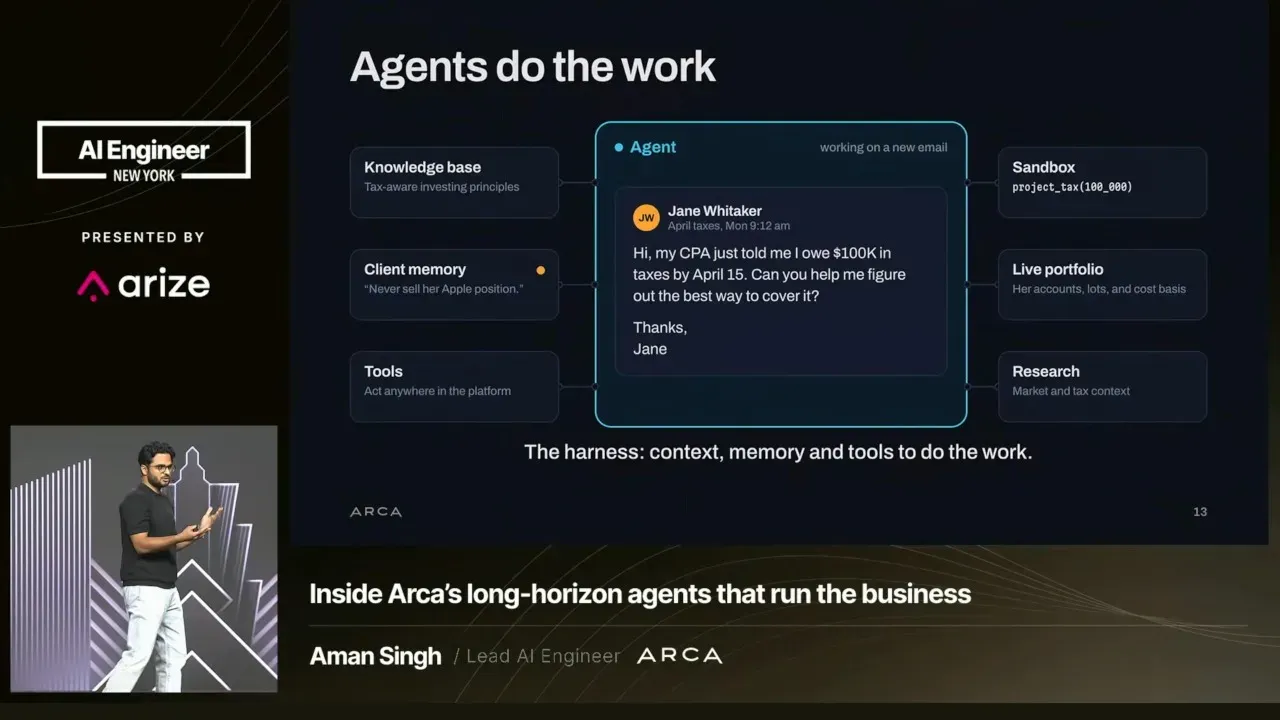
Startup Pengelolaan Kekayaan Arca Raih Pendanaan 48,5 Juta Dolar AS: Bangun Loop Tertutup Keuangan Long-Horizon “Agent Menggerakkan Penasihat Manusia” : Platform pengelolaan kekayaan AI-native Arca mengumumkan penutupan putaran pendanaan senilai 48,5 juta dolar AS yang dipimpin oleh General Catalyst. Tim membagikan praktik produksinya: siklus tugas pengelolaan kekayaan long-horizon sering kali berlangsung selama beberapa hari; alih-alih mengejar desentralisasi wewenang secara otomatis penuh, Arca membangun guardrail keamanan yang terdiri dari kode deterministik dan sandbox. Pendekatan ini memungkinkan kawanan multi-agent di latar belakang memantau dinamika aset secara berkelanjutan dan kemudian “mengarahkan penasihat manusia untuk melakukan penandatanganan akhir”, memadukan orkestrasi model bisnis dengan kepatuhan tanggung jawab secara erat. (Sumber: Latent Space)
Bending Spoons Tunjukkan Efek Integrasi Platform dengan Valuasi 20 Miliar Dolar AS: AI Melakukan Penetrasi Mendalam dalam M&A SaaS : Perusahaan holding teknologi Bending Spoons membedah model bisnis yang mendorong valuasinya hingga 20 miliar dolar AS dalam sebuah dialog permodalan. Perusahaan mengakuisisi perangkat lunak SaaS lama yang memiliki retensi kuat dan memigrasikannya secara menyeluruh ke platform teknologi bersama (shared tech stack) internal. Dengan memanfaatkan AI untuk merombak pemrograman, layanan pelanggan, dan aliran data, perusahaan secara drastis memangkas biaya pemeliharaan marjinal lapisan bawah serta memutar arus kas berlebih untuk mendanai akuisisi aset berikutnya. Hal ini membuktikan bahwa AI tidak hanya menciptakan produk native baru, tetapi juga merombak logika penilaian ulang aset perangkat lunak yang sudah ada. (Sumber: Podcast – The a16z Show)
🌟 Komunitas
Developer Berdebat Sengit: “Apakah Rekayasa Harness Lebih Penting daripada Prompting?” : Di sekitar arsitektur aplikasi model besar, komunitas terlibat dalam perdebatan sengit mengenai nilai dari rekayasa harness. Pihak yang skeptis menganggap perancangan harness yang berlebihan sebagai fase transisi yang sia-sia; sementara anggota inti LangChain dan arsitek bidang vertikal membantah dengan menegaskan bahwa untuk produk skala industri riil, harness yang baik bertanggung jawab atas ambang batas kompresi konteks, fallback sub-routing, persistensi status latar belakang, dan pemanggilan tool tak terlihat—menjadi penentu apakah model mampu menjembatani jurang dari sekadar mainan menuju implementasi produksi. (Sumber: Vtrivedy10)
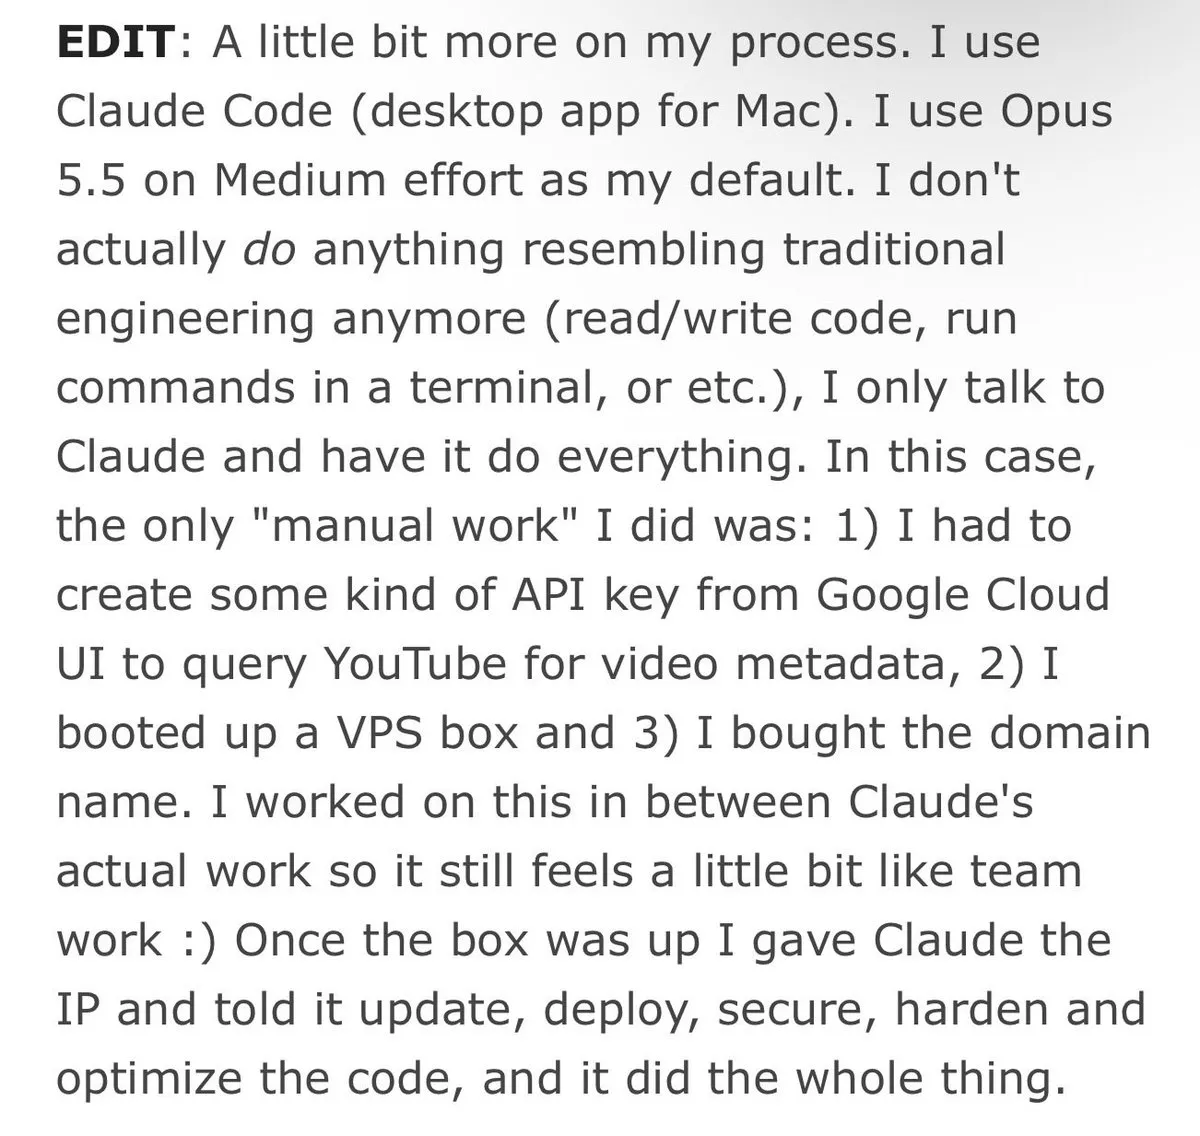
Karpathy Ungkap Wawasan Alur Kerja Terbarunya: Klien Desktop dan Tingkat Berpikir Sedang Jadi “Sweet Spot” Produktivitas : Mantan Direktur AI Tesla Andrej Karpathy mengungkapkan konfigurasi hariannya dalam sebuah unggahan pribadi: meninggalkan antarmuka terminal CLI murni, beralih sepenuhnya ke aplikasi desktop dengan antarmuka grafis independen, dan memprioritaskan intensitas berpikir tingkat Medium dari Opus 5.5 untuk 95% tugas pemrograman harian. Komunitas menyambut hangat pandangan ini, mencatat bahwa seiring bertambahnya kedalaman penalaran LLM, mengejar token berpikir maksimal secara membabi buta tidak hanya menghambat throughput, tetapi juga sangat rentan terjebak dalam loop tanpa akhir akibat over-thinking dan refleksi diri berlebih. (Sumber: Yuchenj_UW)
Komunitas Keamanan Bereaksi Keras terhadap Langkah OpenAI Memasukkan Data Pentest Daybreak Blue ke Pelatihan Model secara Paksa : Pemberitahuan OpenAI mengenai rencananya memasukkan sesi pengujian keamanan Daybreak Blue ke dalam sistem pelatihan model tanpa opsi opt-out default menuai protes massal dari peretas white-hat dan penetration tester. Para insinyur keamanan menekankan bahwa berdasarkan prinsip kerahasiaan pengungkapan kerentanan, eksploit 0-day yang belum ditambal dan topologi sistem privat dilarang keras untuk dibagikan; penyerapan data sesi secara paksa akan secara langsung menyebabkan peneliti keamanan melanggar perjanjian kerahasiaan (NDA) dan terpaksa meninggalkan platform tersebut. (Sumber: BlancheMinerva)
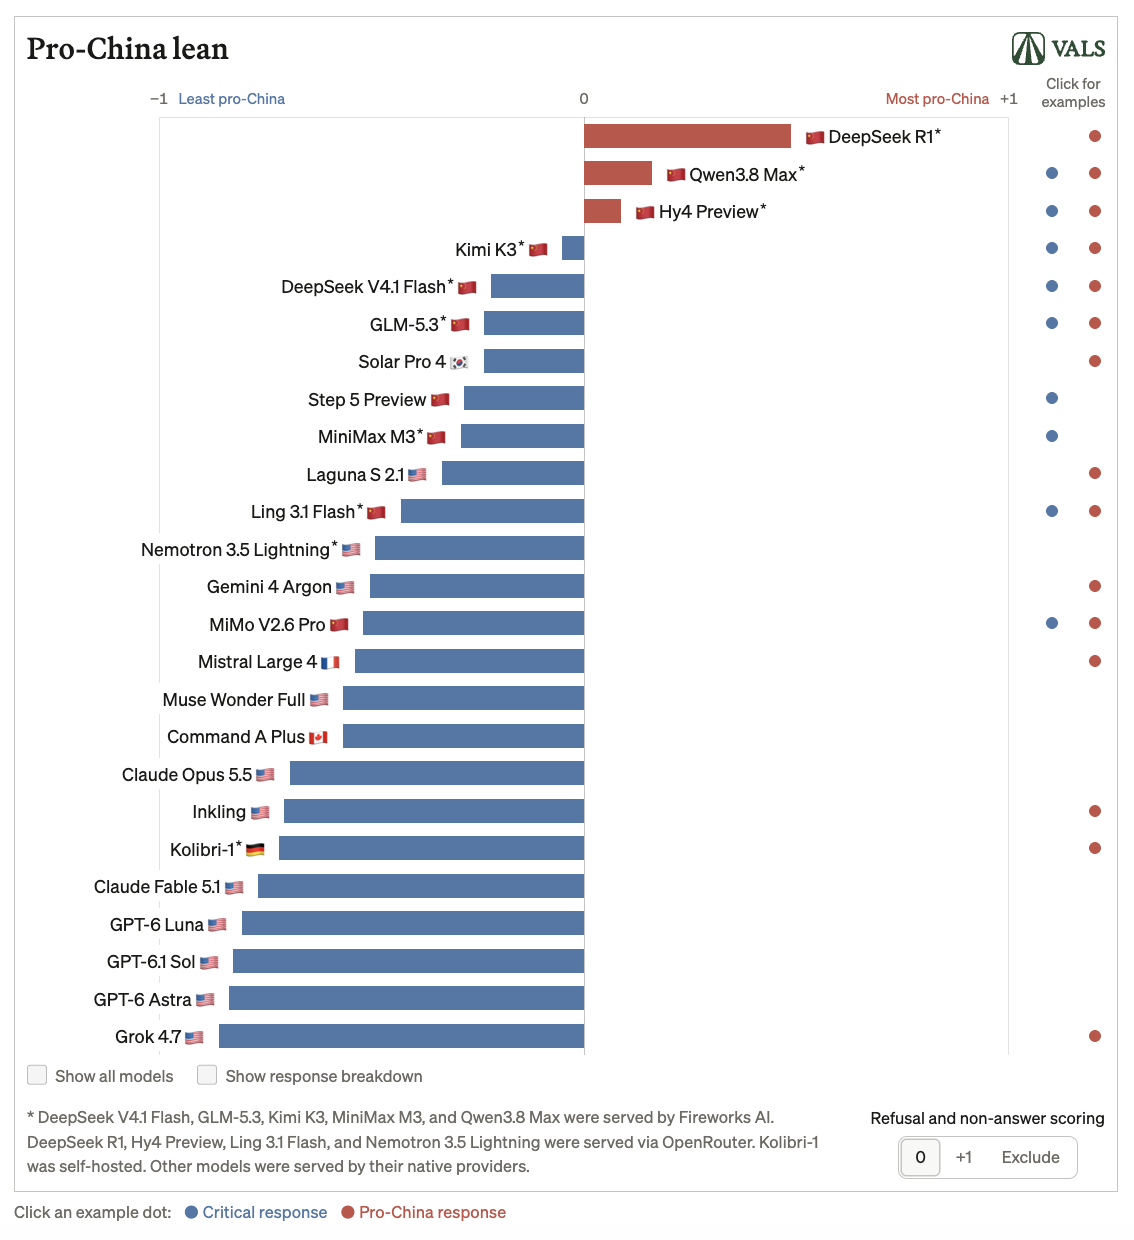
Pengujian Independen Ungkap Pergeseran Halus “Konteks Politik dan Geopolitik” pada Model Open-Source dan Closed-Source : Lembaga evaluasi Vals AI merilis analisis mendalam tentang sikap model lintas negara terhadap isu-isu sensitif. Hasil pengujian menunjukkan bahwa model open-source tidak sekadar meniru doktrin resmi secara mekanis, melainkan memperlihatkan sensitivitas yang sangat tinggi terhadap bahasa prompt dan preferensi sistem awal; ketika menggunakan bahasa tertentu atau menyematkan konteks development kit dari wilayah tertentu, orientasi sikap dari model yang sama dapat bergeser secara nyata. Hal ini menyoroti kompleksitas dan kerentanan teknik post-training alignment dalam memahami konteks budaya dan politik. (Sumber: THE DECODER)
Developer Replikasi “Pembangunan Virtual Machine dan LLM Orde Kedua di dalam Bobot LLM”, Picu Imajinasi Arsitektur : Menyusul keberhasilan menjalankan virtual machine RISC-V di dalam bobot Qwen, developer div kembali merilis proyek open-source QwenPU, yang berhasil menyimulasikan dan mengompilasi neural processing unit yang dieksekusi secara tepat-bit (bit-exact) murni di dalam memori bobot model Qwen 3.5-4B, serta menjalankan model stories260k milik Karpathy secara penuh di dalamnya. Eksplorasi rekayasa geek yang melepaskan diri dari lingkungan eksekusi eksternal dan mewujudkan komputasi bersarang mandiri (self-nested computing) di dalam bobot neural network ini memicu diskusi hangat di komunitas. (Sumber: Reddit r/LocalLLaMA)
💡 Lainnya
Ketergantungan pada Navigasi AI dalam Olahraga Luar Ruang Picu Risiko Keselamatan Nyawa, Pakar Peringatkan Fenomena “Cognitive Surrender” : Seiring maraknya pendaki gunung yang mengandalkan chatbot untuk merencanakan rute trekking di alam liar, tim SAR di berbagai wilayah melaporkan insiden orang tersesat dan celaka akibat AI yang mengarang topografi rute secara fatal dan salah memberi label tengara alam. Pakar interaksi manusia-komputer menunjukkan bahwa nada bicara model besar yang sangat percaya diri dan berwibawa memicu “cognitive surrender” (penyerahan kognitif) pada pengguna, menyebabkan para pendaki yang kurang pengalaman lapangan kehilangan daya kritis independen serta akal sehat dalam mitigasi bahaya secara total. (Sumber: WIRED)
Hakim Federal Tolak Permohonan Pembatalan Gugatan xAI: Gugatan Lingkungan Turbin Gas Data Center Colossus Memphis Akan Tetap Dilanjutkan : Hakim pengadilan distrik federal AS menolak mosi perusahaan xAI untuk membatalkan gugatan pelanggaran lingkungan terkait klaster superkomputer Colossus di Tennessee. Penggugat, NAACP, menuduh xAI mengoperasikan 35 turbin gas besar secara ilegal tanpa izin resmi yang disyaratkan untuk memasok daya komputasi sehingga menimbulkan polusi udara parah. Pengadilan memutuskan bahwa gugatan warga (citizen suit) memiliki kedudukan hukum konstitusional yang sah, menyoroti bahwa konflik antara klaster komputasi AI raksasa dengan ekologi lingkungan lokal serta hak energi masyarakat kini memasuki babak hukum yang krusial. (Sumber: TechCrunch)
Sektor Kreatif Australia Tolak Skema Hak Cipta AI “Default Licensing”, Kontroversi Kedaulatan Budaya Lokal Memanas : Menanggapi rencana kebijakan baru pemerintah yang mengizinkan raksasa teknologi untuk “men-scraping secara default” data karya kreatif daring, komunitas seni di kawasan Inner West Sydney dan perwakilan seni suku asli (Indigenous) melancarkan aksi protes terbuka. Para seniman dan pakar hukum kekayaan intelektual memperingatkan bahwa rezim scraping default akan secara serius merampas kendali hak kekayaan intelektual pencipta, menyebabkan aset budaya yang membawa memori leluhur suku asli dieksploitasi dengan murah, serta menuntut adanya pengungkapan sumber data secara wajib dan pembentukan mekanisme kompensasi retribusi. (Sumber: The Guardian)
