



🔥 Odak Noktası
OpenAI faturalandırma sistemini tamamen sıkılaştırıyor: ChatGPT ve Codex kota havuzları Aralık ayında birleşiyor, tüm hatlarda Token bazlı ölçüme geçiliyor : OpenAI, Aralık ayından itibaren Plus, Pro ve Business ücretli aboneliklerinin kullanım kotalarının ChatGPT günlük sohbetleri ile Codex arasında paylaşımlı hale getirileceğini ve geçmişteki “web sohbeti kotaya dahil edilmez, kodlama ayrı sınırlandırılır” şeklindeki paralel kuralın tamamen sona erdirileceğini resmi olarak duyurdu. Aynı zamanda tüketim hesabı bütünüyle işlenen gerçek Token miktarına dönüştürülüyor; yalnızca hafif Instant sohbetler sınırsız kalıyor. Ayrıca, tek bir cihazda oturum açabilecek ücretli hesap sınırını belirleyen donanım düzeyinde cihaz kilidi resmi olarak devreye alındı ve çoklu hesap rotasyonuyla yapılan atlatma yolları engellendi. Analistler, bunun büyük modellerin tüketici tarafındaki “her şey dahil sınırsız abonelik” döneminin sonunu işaret ettiğini, devasa bilgi işlem sermaye harcamaları baskısının lider üreticileri ön ödemeli Tokenlaştırmaya ve ayrıntılı ROI mutabakatına tam geçiş yapmaya zorladığını belirtiyor. (Kaynak: THE DECODER、OpenAI)
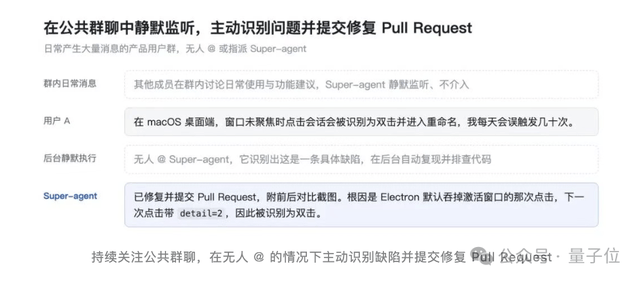
DeepSeek yeni nesil Super-agent mimari prototipini açık kaynak yaptı: Çift katmanlı yönlendirme ve depolama-hesaplama ayrımı ile otonom ajanları yeniden şekillendiriyor : DeepSeek Harness ekibi, yeni nesil ajan mimari felsefesini resmi olarak duyurdu ve hafif prototipi dsh-superagent’ı açık kaynak olarak yayınladı. Bu mimari, ana akım Agent’ların tek bir Session içindeki context şişmesi ve sıralı engelleme kısıtlamalarını kırmayı hedefliyor; “sürekli Router küresel çizelgeleme + izole Worker çoklu görev eşzamanlılığı” çift katmanlı mimarisini öneriyor. Olay aboneliği doğrudan iletimi ve asenkron ReAct döngüleri ile birleşerek insanların çoklu görev etkileşimlerindeki dikkat darboğazını ortadan kaldırıyor. Aynı zamanda sistem, uç taraftaki hafif bir Daemon aracılığıyla Agent’ın bulut çalışma mantığını yerel gerçek çalışma ortamından (BYOM) ayırıyor; gürültülü çoklu görev testlerinde p95 görev tamamlanma süresini 29,5 dakikadan 15,7 dakikaya önemli ölçüde düşürüyor. (Kaynak: MarkTechPost、量子位)
NVIDIA PixelUMM’i açık kaynak yaptı: VAE ve ViT’e veda, yerel piksel uzayında video ve görüntü anlama ile üretimi birleştiriyor : NVIDIA ve Waterloo Üniversitesi ortaklaşa encoder’sız çok modlu model PixelUMM’i açık kaynak haline getirdi. Bu çözüm, geleneksel çok modlu modellerde anlamsal özellikleri çıkarmak için kullanılan ViT ile gizil değişkenler üreten VAE mimarisini tamamen terk ediyor; yalnızca tek bir lineer projeksiyon katmanıyla görüntü patch’lerini ve video tubelet’lerini paylaşılan çok modlu Transformer gizil uzayına eşliyor. Mixture-of-Transformers tasarımına dayanan model, hard routing ile anlama ve üretim parametrelerini ayırırken dikkati paylaşıyor; Flow Matching ile birleşerek doğrudan temiz pikseller üretiyor. Görüntü sayma, video anlama ve yüksek kaliteli video üretimi gibi kıyaslama testlerinde geleneksel karmaşık çift akışlı sistemlerle rekabet edebilecek düzeyde performans sergiliyor. (Kaynak: 机器之心)

🎯 Gelişmeler
Tsinghua Yao Qizhi ekibi “Cebirsel Dünya Modeli” AWM’yi önerdi: Bilişsel kör noktaları aşmak için kategori teorisi ve biçimsel kanıtları sunuyor : Öncü büyük modellerin yalnızca yüzeysel örüntüleri sıralayabilmesi ve çözümsüz görevlerle karşılaştıklarında ciddi halüsinasyonlara kapılması sorununa yönelik olarak Tsinghua Üniversitesi’nden Yao Qizhi ve Yuan Yang ekibi “Cebirsel Dünya Modeli”ni (AWM) önerdi. Bu çerçeve, kategori teorisindeki izdüşümsel limitler ve tümevarımsal limitler düşüncesinden yararlanarak çevre etkileşimini katı bir cebirsel uzay yapısına soyutluyor ve Lean 4 dili yardımıyla makine tarafından doğrulanabilir matematiksel mantık çıkarımları ile çelişkiyle kanıtlama yürütüyor. Otonom kural keşfini son derece zorlayan ARC-AGI-3 testinde Opus 5 tabanlı AWM %99,9’luk bir başarı puanı elde etti ve ortalama tamamlama adım sayısı insan kıyaslamasının yalnızca %43’ü oldu; bu da yapay zekanın “kara kutuda rastgele tahmin yürütme” sorununu çözmek için biçimsel tümdengelimli bir yol açıyor. (Kaynak: 量子位)
Google ve ortakları CLASHarness’i yayınladı: Çoklu Ajan çatışmaları altında öncü büyük modellerin iş birliği zayıflıkları ortaya çıkıyor : Gerçek üretim ortamlarında çoklu ajan koordinasyonunun sıklıkla karşılaştığı durum kopukluğu ve çelişen talimatlar sorununa yönelik olarak Google, birçok üniversiteyle iş birliği yaparak 4K görsel kanıtlar içeren 600 gerçek yürütülebilir çatışma senaryosu tasarlayan çok modlu kıyaslama CLASHarness’i açık kaynak olarak yayınladı. GPT-6, Claude Opus 5 ve açık kaynak amiral gemilerini içeren 15 öncü modelin testleri şunu ortaya koydu: Tek adım ortalama puanı %60’ın üzerinde olmasına rağmen, uçtan uca görev başarı oranı hiçbir modelde %30’u geçemedi. Güçlü modeller izleme gerçekliğini doğrulamak için proaktif olarak görüntü araçlarını çağırma eğilimindeyken, zayıf modeller takım arkadaşlarının hatalı metinlerine kolayca körü körüne inanıyor; aynı zamanda aşırı uzun düşünme Token’ları içsel kararsızlıklar nedeniyle zaman aşımı kısır döngülerini daha da şiddetlendiriyor. (Kaynak: 机器之心)

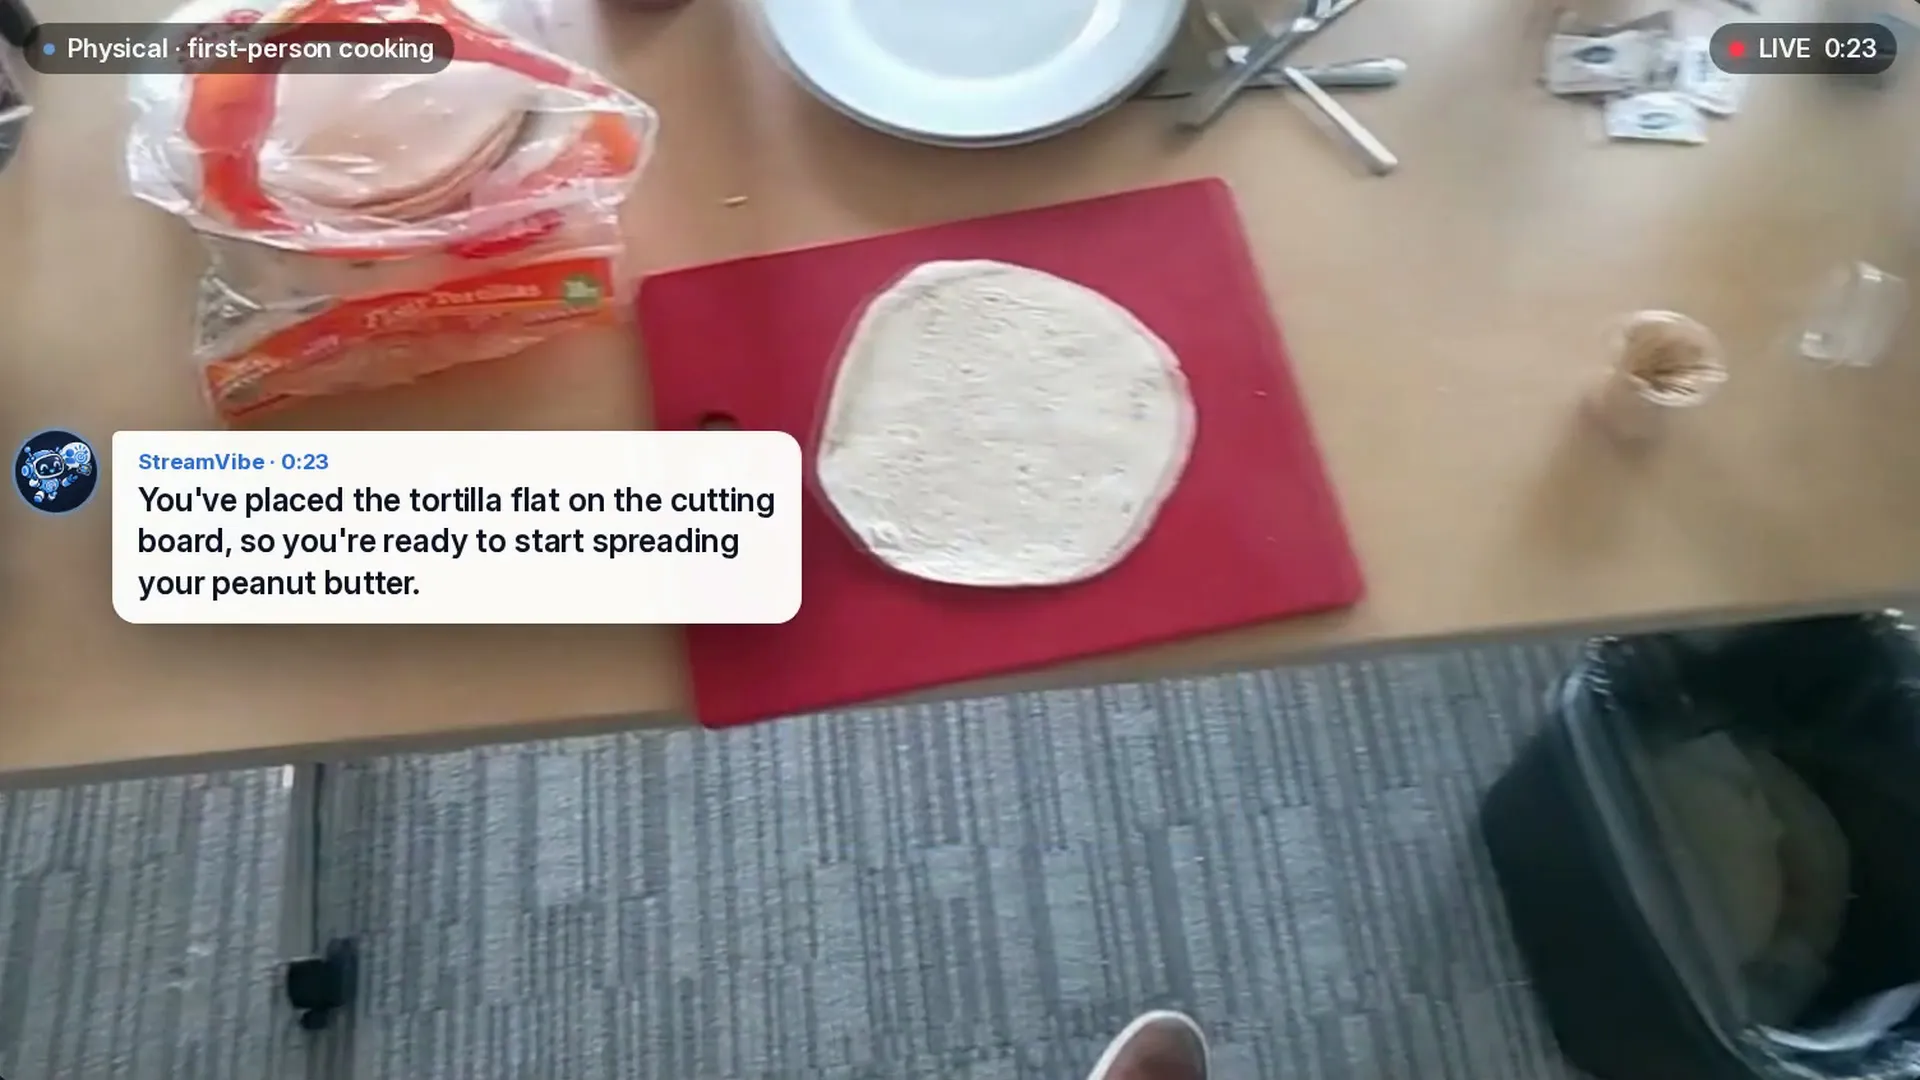
Google ve Stanford StreamVibe’ı duyurdu: Video ajanlarının “ne zaman müdahale edip konuşacağına” otonom olarak karar vermesini araştırıyor : Geleneksel akışlı video asistanları genellikle mekanik komutları pasif olarak yürütmekle sınırlıdır. Google ve Stanford gibi ekipler, yepyeni bir proaktif etkileşim kıyaslaması ve modeli olan StreamVibe-VL’yi tanıttı. Sistem bir durum belleği mekanizması ve pekiştirmeli öğrenme ince ayarı getirerek modeli, kullanıcının açıkça belirtmediği niyetleri gerçek zamanlı olarak algılamak ve en uygun anda proaktif olarak yönlendirmek üzere eğitiyor. Deneyler, mevcut çok modlu modellerin 5 dakikayı aşan uzun video senaryolarında hâlâ ciddi bağlam zayıflaması ve geçmişten kaynaklanan yanıltıcı yönlendirmelerle karşılaştığını, ancak standart ofis ve yaşam rehberliği görevlerinde bu mekanizmanın etkili yanıt verme zamanlaması doğruluğunu %10,7 artırdığını ve gereksiz gürültülü rahatsızlıkları azalttığını gösteriyor. (Kaynak: THE DECODER)
Feijie Kesi ve Fudan ortaklığıyla Fysiverse-UniWAM açık kaynak yapıldı: Büyük ölçekli robot ön eğitimini aşarak navigasyon ve manipülasyonda çifte şampiyonluk elde etti : Feijie Kesi ve Fudan Üniversitesi CITLab, birleşik dünya eylem modeli Fysiverse-UniWAM’ı yayınladı. Ekip, pahalı ve manuel veri toplamaya dayalı genel robot omurgası ön eğitim yolunu terk ederek MAP (Manipülasyon Çapa Pozu) sentetik veri hattını önerdi, 7500 saatlik bir veri seti oluşturdu ve omurga paylaşımlı, girdi yalıtımlı Mixed-Stream mimarisiyle birleştirdi. 4 farklı donanım platformunu kapsayan 24 gerçek robot testinde model, 13 navigasyon hedefleme görevinde ve 4 mobil kavrama görevinde en yüksek başarı oranını elde etti ve somutlaşmış yapay zekanın yalnızca özel donanım verisi boyutunu yarıştırma tekil paradigmasını kırdı. (Kaynak: 机器之心)

Tsinghua ve ortakları kendi kendine evrilen çoklu fizik modelleme sistemi EvoSim’i tanıttı : Tsinghua Üniversitesi Kimya Mühendisliği Bölümü’nden Zhang Qiang ekibi, Tsingyu Tech ve Huairou Laboratory ile birlikte EvoSim’i önererek yapay zekayı yalnızca “verilen denklemlerin parametrelerine ince ayar yapmaktan”, “deneysel hatalara dayanarak mekanizmaları çıkaran ve denklemleri kendi kendine evrilten” bir aşamaya taşıdı. Güç bataryası hızlı şarj lityum birikimi tahmini ve farklı çalışma koşullarında dinamik voltaj simülasyonu gibi iki endüstriyel fizik senaryosunda EvoSim, paralel hipotez üretimi ve tanımlanabilirlik doğrulaması yoluyla yeniden kullanılabilir bir modelleme deneyim zinciri oluşturdu; lityum birikimi başlangıç noktası hatası %1,79’a kadar gerileyerek alandaki kıdemli uzmanların manuel modelleme düzeyini önemli ölçüde aştı. (Kaynak: 机器之心)

Xingyan Intelligent, somutlaşmış Harness çerçevesi Auriga’yı duyurdu: Tek denemede sıfır örnekli kendi kendini iyileştirme yeteneği sunuyor : Xingyan Intelligent, belirli görevlerin tekrarlayan deneme-yanılma sıfırlamalarını “sistem düzeyinde genel bir yürütme katmanı” ile değiştirmeyi savunan somutlaşmış yapay zeka Harness çerçevesi Auriga’yı duyurdu. Çerçeve, “algılama ölçümdür” ve “görülen yürütülür” yörünge provası ile milisaniye düzeyinde anormallik durdurma ve kendi kendini iyileştirme döngüsünü birbirine bağlıyor. RoboDojo ve RoboCasa365’in katı “ince ayarsız, gösterimsiz, tek denemede sıfırlamasız” Zero-shot değerlendirme kuralları altında Auriga, fiziksel kanıt odaklı strateji yeniden planlaması sayesinde sırasıyla %57,74 ve %73,2 başarı oranlarına ulaşarak her iki sıralamada da birinci oldu. (Kaynak: 机器之心)

Fudan OpenMOSS ekibi hibrit mimarili uzun metin mekaniğini açıkladı: Hibrit konumsal önyargı, ekstrapolasyon ile uyum arasındaki tahterevalli dengesini bozuyor : Tam dikkatin yüksek hesaplama maliyeti ile kayan pencere dikkati (SWA) ve lineer dikkatin (LA) ayrı ayrı sahip olduğu dezavantajlar karşısında, Fudan Üniversitesi’nden Qiu Xipeng ekibi hibrit mimarilerin temel mekanizmalarını sistematik olarak analiz etti. Çalışma, SWA’nın uzunluk ekstrapolasyonunda üstün olduğunu ancak devam eden eğitimde uyum yetersizliği yaşadığını, LA’nın ise uzun metin uyumunda üstün olup ekstrapolasyon yeteneğinin zayıf olduğunu ortaya koydu. Ekip, kayan pencere lineer dikkati (SWLA) ve NoPE pozisyonel önyargısız küresel toplama stratejisini önerdi; bu da GLA/GDN hibrit modellerinin RULER değerlendirmesinde 4k’dan 64k’ya 16 katlık eğitimsiz, kayıpsız ekstrapolasyon elde etmesini sağladı. (Kaynak: 机器之心)

🧰 Araçlar
Model davranışı neşteri Heretic 2.0 yayınlandı: Keyfi rank ablasyonu ve eklenti sistemi ile model hizalamasını yeniden yapılandırıyor : Açık kaynaklı model düzenleme aracı Heretic, 2.0 ana sürümünü yayınladı. Bu sürüm, modelin yanıt vermeyi reddetmesini tek bir yön olarak gören geleneksel Rank-1 abliteration yöntemini bir kenara bırakarak ilk kez “Arbitrary Rank Ablation (ARA)” algoritmasını sunuyor; L-BFGS optimize edici kullanarak artık uzayda mikro-eğitim yapıyor, ret özelliklerini silerken modelin orijinal temsillerini azami ölçüde koruyor. Ayrıca yeni sürüm, kapsamlı bir puanlayıcı eklenti ekosistemi (ModernBERT ret sınıflandırıcısı ve kıyaslama testi puanlayıcıları dahil) sunarak halüsinatif klişelerin bastırılmasını, yaranma eğiliminin azaltılmasını ve duygusal hizalama ince ayarlarının tamamen modüler biçimde gerçekleştirilmesini sağlıyor. (Kaynak: GitHub)
Nace AI, 27B karar modeli Drex Max v1’i açık kaynak yaptı: Çok modlu mantıksal geçitlemeyi yerel Mac’e indiriyor : Nace AI, amiral gemisi karar modeli Drex Max v1’i; bf16, Q8_0 GGUF ve Apple Silicon için optimize edilmiş Affine Q4 sürümleri dahil açık kaynaklı ağırlıklar biçiminde resmi olarak yayınladı. Model, Gated DeltaNet lineer dikkati ile tam dikkatin hibrit mimarisine dayanıyor; Token’ları otoregresif olarak üretmeye gerek duymadan, tek bir ileri iletimde 255’e kadar sınıflandırma seçeneği için kesin ayrık olasılıklar üretebiliyor. Genel karar endeksi 0.4 testinde 67,52 puan alarak kapalı kaynaklı Jev’in performansını aştı ve işletmelerin hassas istihbarat sınıflandırmasını, araç yönlendirmesini ve risk kontrol bariyerlerini tamamen yerel özel ortamlara dağıtmasına olanak tanıdı. (Kaynak: MarkTechPost)
AiSOC: Tamamen açık kaynaklı ve kendi sunucunuzda barındırılabilir güvenlik operasyon merkezi çerçevesi : Giderek ciddileşen otomatik saldırı ve savunma tehditlerine yanıt olarak güvenlik projesi AiSOC resmi olarak açık kaynak haline getirildi. Sistem; 7.000’den fazla kural motoru, ClickHouse olay gölü ve Neo4j varlık topolojisi barındırıyor; yerleşik hafif yerel model ağ geçidi ile sıfır API Key ile çevrimdışı çalışmayı destekliyor. Temel özelliği, yapay zeka soruşturma ajanları için tam izlenebilirliğe sahip “değiştirilemez bir karar defteri” oluşturmasıdır; tüm alarm akışları, kanıt zinciri alma işlemleri ve yanıt provaları sandbox doğrulaması ve insan onayından geçerken Claude ve Cursor için yerel MCP sunucu arayüzleri sağlar. (Kaynak: GitHub Trending)

Hex: Rust tabanlı yerel öncelikli genel sesli giriş ve ekran işlem asistanı : Çapraz platform dikte aracı Hex, veri gizliliğine önem veren geliştiriciler için açık kaynak olarak sunuldu. Yerel Rust ile geliştirilen ve cihaz içi akışlı ses tanıma modeliyle donatılan araç, genel kısayol tuşuna basıldığında yüz milisaniye gibi düşük bir gecikmeyle anında metne döküp herhangi bir etkin pencereye yapıştırabiliyor. Yeni sürüm ayrıca “Annotate” ekran karalama ve çok modlu yakalama özelliğini sunarak kullanıcıların ekranı daire içine alırken aynı anda sesli komutlar vermesini ve OpenCode gibi harici Coding Agent’ların yürütmesi için anahtar kareleri ve işlem bağlamını otomatik olarak paketlemesini sağlıyor. (Kaynak: GitHub Trending)
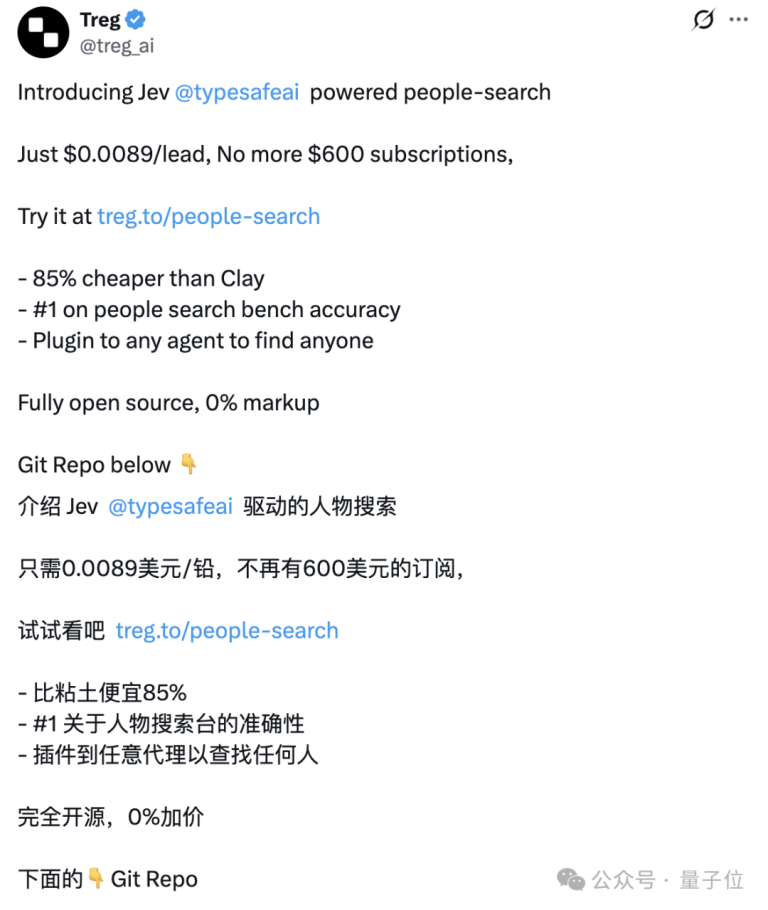
TypeSafe AI ve Treg müşteri bulma Agent aracını açık kaynak yaptı: Maliyet %85 oranında düştü : Karar modeli Jev’in ana şirketi TypeSafe AI, Agent platformu Treg ile iş birliği yaparak açık kaynaklı personel bilgi ipucu arama aracını kullanıma sundu. Sistem, geleneksel B2B’nin karmaşık manuel çoklu platform aramalarını bir Agent ardışık düzenine entegre ediyor; belirsiz rolleri otomatik olarak elemek için Jev’i karar kapısı olarak kullanıyor ve üçüncü taraf API’leri çağırarak doğrulanmış e-postaları tamamlıyor. 119 gerçek müşteri adayı bulma görevini içeren kıyaslama testinde geri alma doğruluğu %78,2’ye ulaştı ve geçerli ipucu başına ortalama çağrı maliyeti yalnızca 0,0056 dolar oldu; bu da ticari SaaS araçlarına kıyasla %85’ten fazla tasarruf anlamına geliyor. (Kaynak: 量子位)
Open WebUI dizin düzeyinde bellek yalıtım eklentisi v0.0.4’ü yayınladı : Topluluk geliştiricileri, Open WebUI v0.12.5 için Folder-Scoped Memory Isolation eklentisini yayınladı. Çoklu projeler eşzamanlı çalışırken genel belleğin karşılıklı kirlenmesi sorununu çözmek amacıyla bu eklenti, modelin konuşma olgularını otonom olarak çıkarmasını ve sınıflandırmasını sağlayarak bellekleri yalnızca ilgili proje klasörü içinde paylaşımlı olacak şekilde sınırlandırıyor; kök dizin konuşmaları ise bağımsız olarak genel bellek havuzunu koruyor ve kod, finans gibi alanlar arası görevler arasında bağlam karışmasını etkili bir şekilde önlüyor. (Kaynak: Reddit r/OpenWebUI)
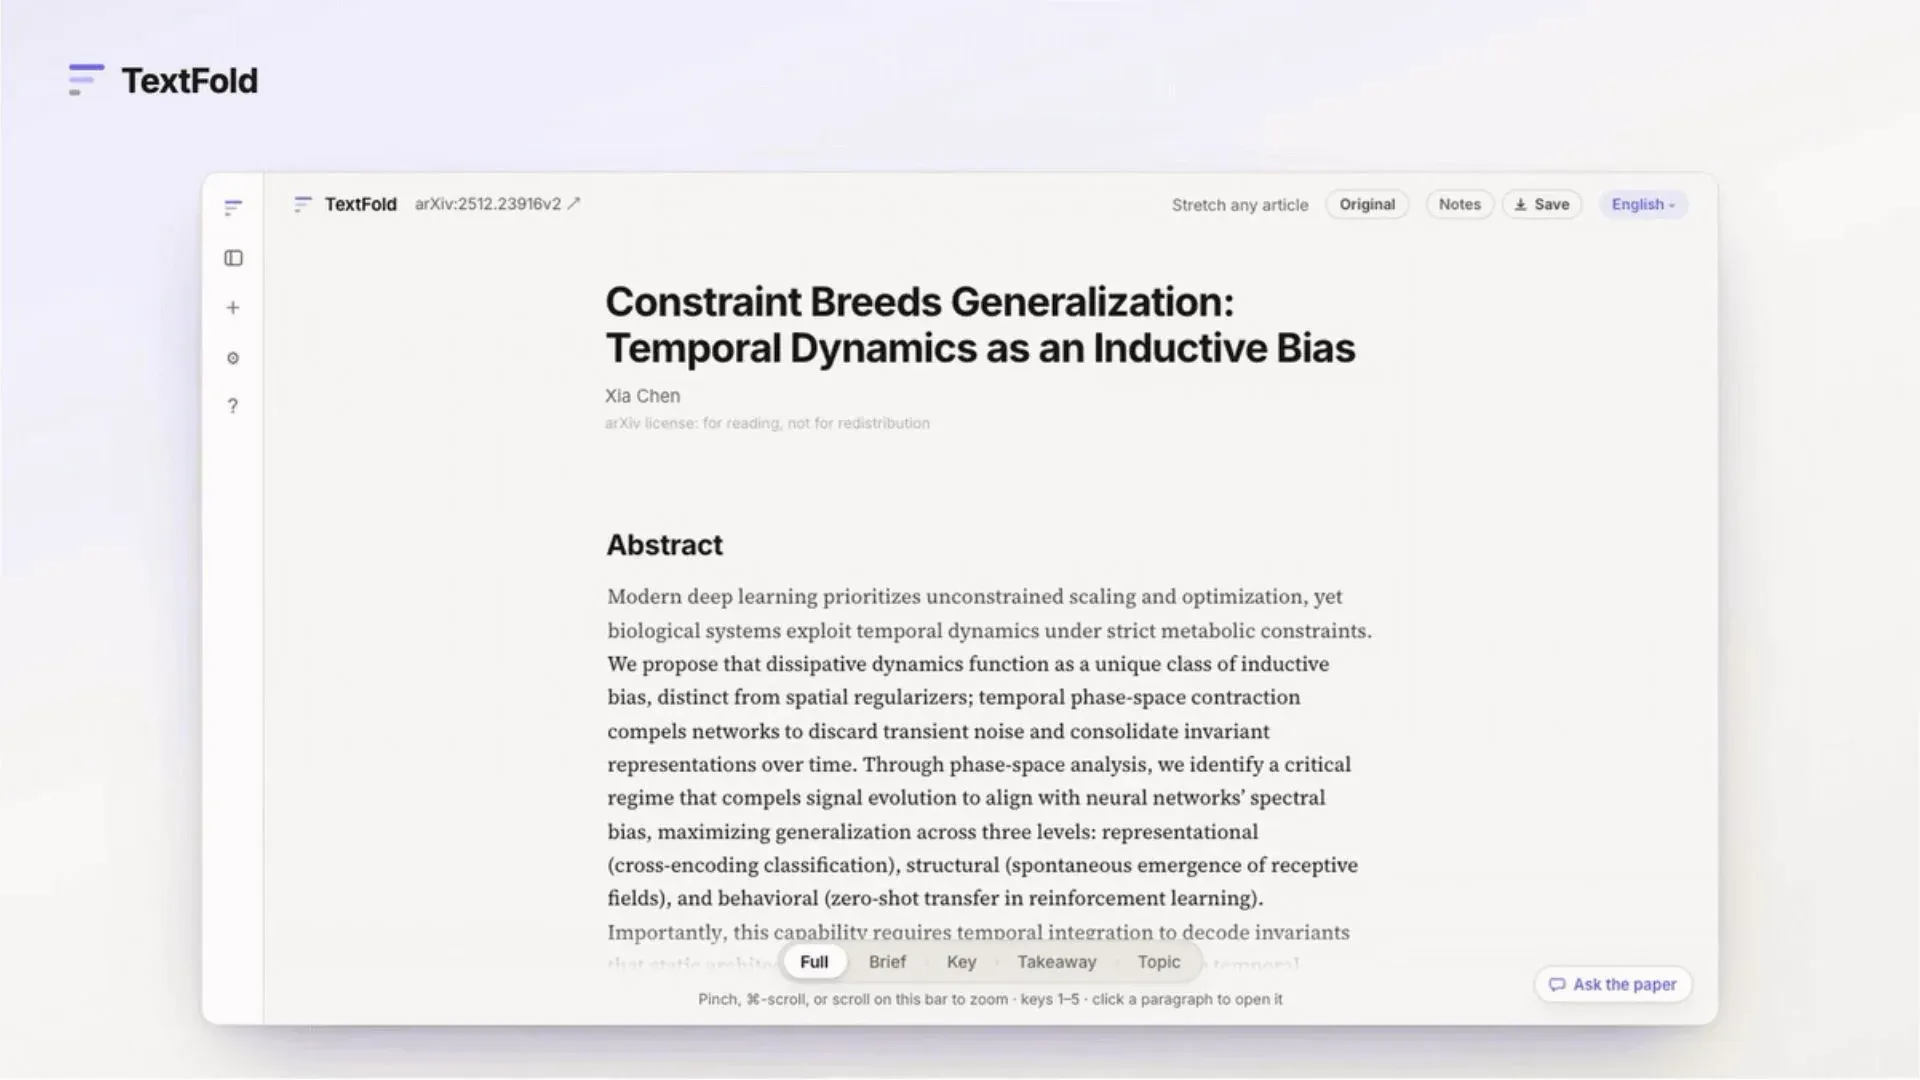
TextFold: Bilişsel yükü dengeleyen tersine çevrilebilir ayrıntı daraltıcı okuyucu : Büyük modellerin uzun metinleri özetlerken “bilişsel borç” yaratması ve kritik öncül ayrıntıları yok etmesi sorununa yönelik olarak açık kaynaklı okuyucu TextFold yayına girdi. Ted Nelson’ın esnek metin teorisine dayanan araç, orijinal metnin bütünlüğünü korurken yapay zeka özetlerini katmanlı olarak adım adım katlanan bir yapıya dönüştürüyor; okuyucuların ek Token maliyeti olmaksızın temel sonuçlar, kilit argümanlar ve kelimesi kelimesine orijinal cümleler arasında serbestçe yakınlaştırma-uzaklaştırma yaparak doğrulama yapmasına imkan tanıyor. (Kaynak: Reddit r/ArtificialInteligence)
📚 Araştırmalar
Google ekibi T2J-Bench’i yayınladı: Çerçeveler arası tam depo kod taşımayı diferansiyel yürütme doğrulamasıyla çözüyor : Büyük kod tabanlarını PyTorch’tan JAX’e taşırken ortaya çıkan sayısal sapma ve örtük durum uyumsuzluğu sorunlarına yönelik olarak Google, UIUC ve ortakları, yürütme tabanlı ilk tam depo kod taşıma kıyaslaması T2J-Bench’i önerdi. Değerlendirme; SFT, DPO ince ayarı ve KV Cache çıkarım hizmetlerini kapsayan 63 endüstriyel düzeyde görevi içeriyor. Çalışmanın sunduğu TwinHarness çerçevesi, orijinal çalıştırılabilir kodu yürütülebilir bir spesifikasyon olarak ele alıyor; gradyanları ve sayısal değerleri ikiz diferansiyel karşılaştırma yoluyla denetleyerek Claude-Code’un aynı model altındaki taşıma puanını 0,649’dan 0,723’e önemli ölçüde yükseltiyor. (Kaynak: 机器之心)

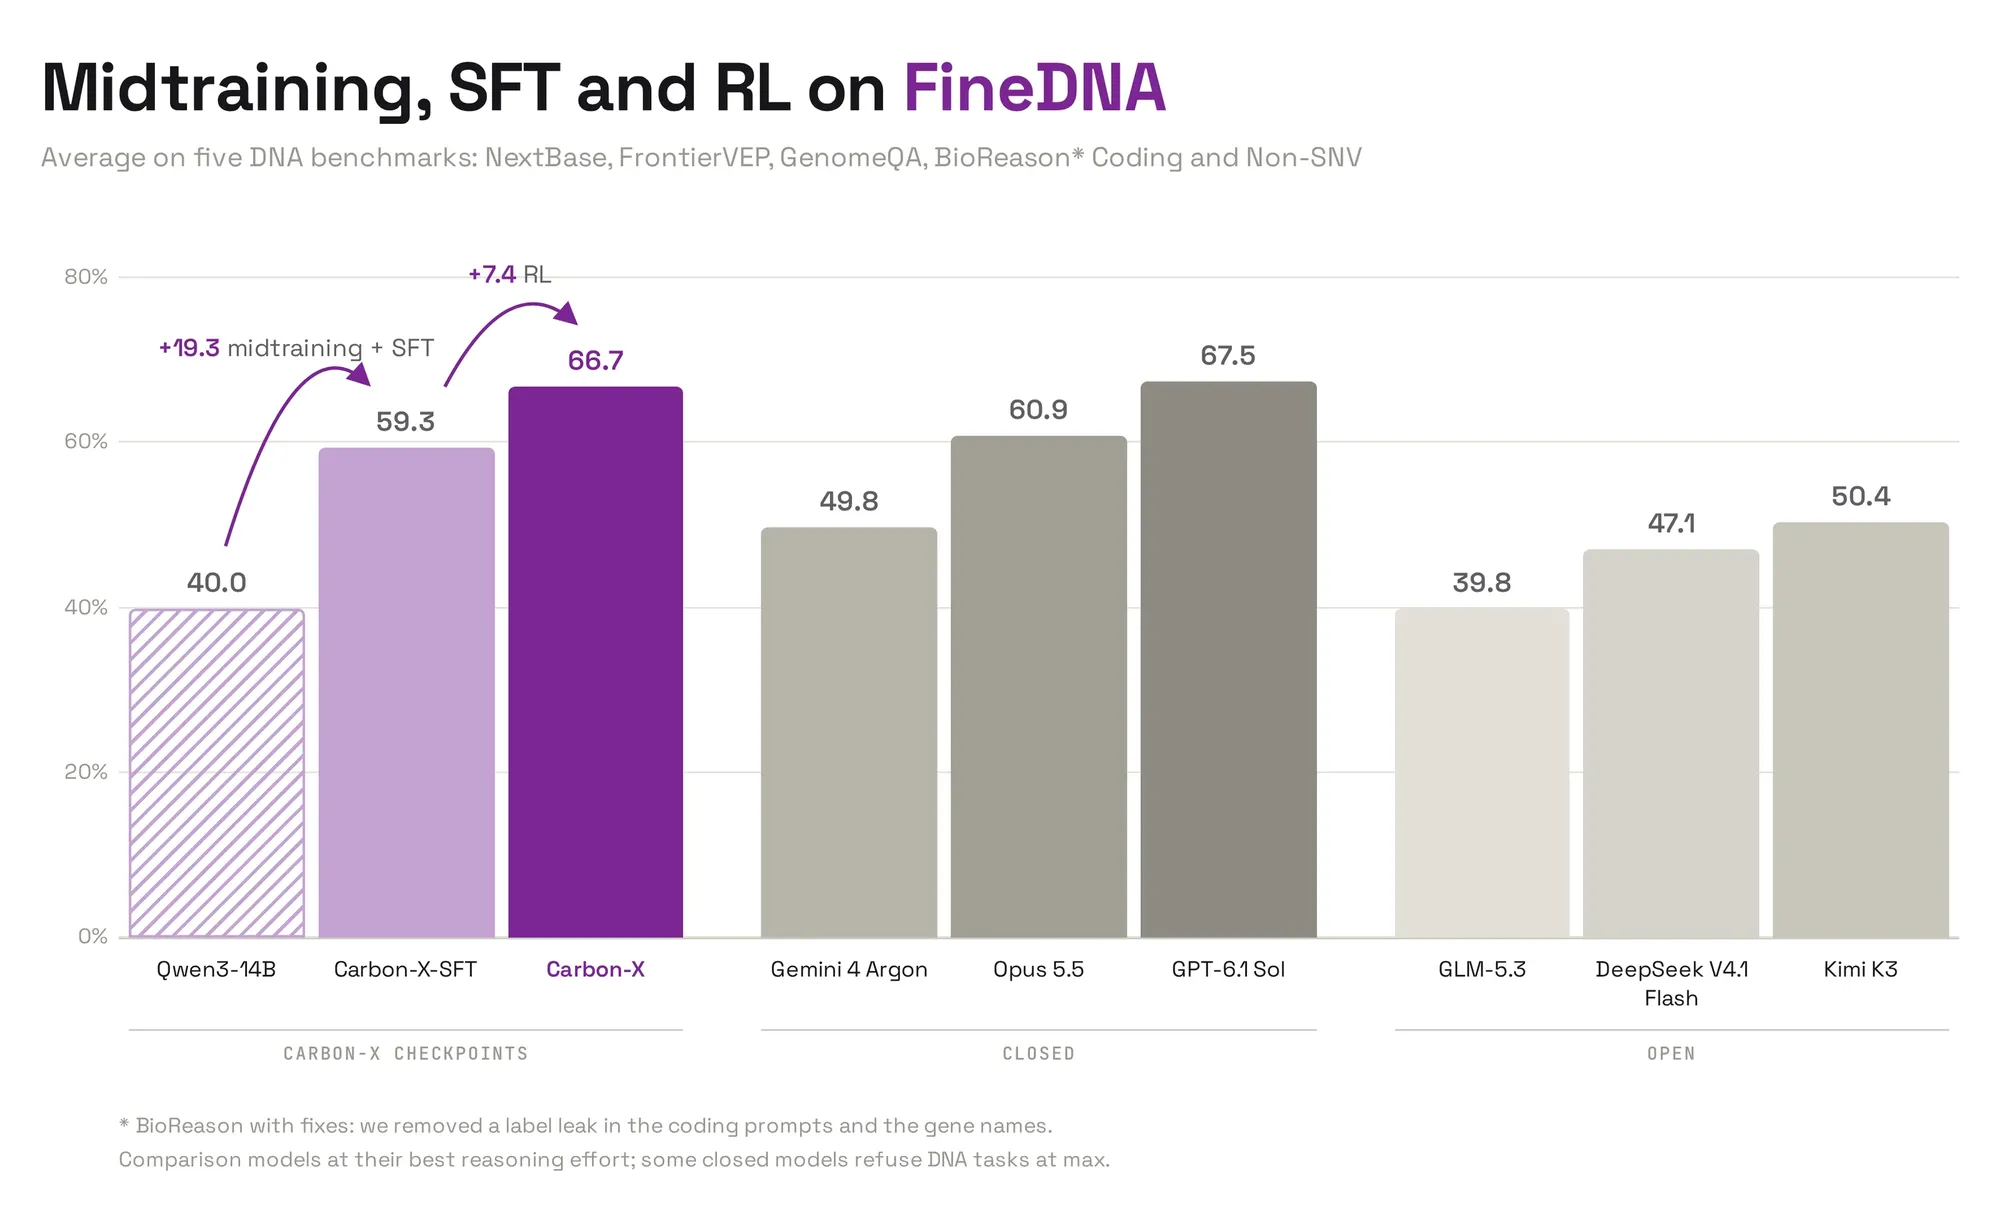
Hugging Face FineDNA paketini açık kaynak yaptı: Uçtan uca açık kaynak veri, küçük modellerin kapalı kaynak genetik omurgalarla yarışmasını sağlıyor : Hugging Face biyoloji ekibi, DNA anlamaya yönelik çok aşamalı ince ayar veri seti FineDNA’yı yayınladı. Veri seti, 300B Token’lık DNA-metin hibrit ön eğitim külliyatı, deterministik doğrulayıcılara sahip 200 bin SFT konuşması ve yaklaşık 100 bin pekiştirmeli öğrenme örneği içeriyor. Bu paketle ince ayar yapılan açık kaynaklı 14B modeli Carbon-X, birçok genomik kıyaslamada mevcut açık kaynak dil modellerini geride bıraktı ve binde birden daha az çıkarım maliyetiyle GPT-6.1 Sol seviyesine yaklaştı. (Kaynak: HuggingFace Blog)
RWE-Bench testleri öncü modellerin gerçek mühendislik tasarımı yeteneklerinde ciddi şekilde geride kaldığını ortaya koyuyor : Xplore AI, karmaşık mekanik, elektronik ve havacılık endüstriyel tasarımlarına yönelik kıyaslama testi RWE-Bench’i yayınladı. Sorular, üç silindirli dizel motor krank mili mukavemet doğrulaması ve 8 katmanlı FPGA kartı DDR3 yönlendirmesi gibi gerçek mühendislik görevlerini kapsıyor ve tamamen sonlu elemanlar analizi ile fiziksel çözücüler tarafından bağımsız olarak değerlendiriliyor. Testler, tam bilgi işlem gücü altında bile en güçlü model olan GPT-6 Astra’nın geçme oranının yalnızca %37 olduğunu, birçok öncü büyük modelin ise katı mühendislik toleranslarını karşılayamadığı için sıfır çektiğini gösterdi. (Kaynak: WeChat)
Zhejiang Üniversitesi ortak ekibi 《npj AI》 dergisinde MAESTRO’yu yayınladı: Afet önleme ve acil durumlar için çoklu ajan iş birliği sistemi : Doğal afet erken uyarılarında departmanlara ait uzman modellerin yalıtılmış olması ve değerlendirme süreçlerinin birbirinden kopuk işlemesi sorununa yönelik olarak Zhejiang Üniversitesi ve Huazhong Bilim ve Teknoloji Üniversitesi gibi ekipler MAESTRO sistemini geliştirdi. Sistem; durumsal farkındalık, koordinasyon-ayrıştırma ve alan uzmanı olmak üzere üç tür ajan barındırıyor. 100 geçmiş ve simüle edilmiş tayfun senaryosunda %98,4 derece belirleme doğruluğuna ulaştı ve değerlendirme süresini geleneksel uzman müzakerelerindeki 250 saniyeden 37,9 saniyeye indirdi; sistem halihazırda il düzeyindeki acil durum operasyon platformuna entegre edildi. (Kaynak: 机器之心)

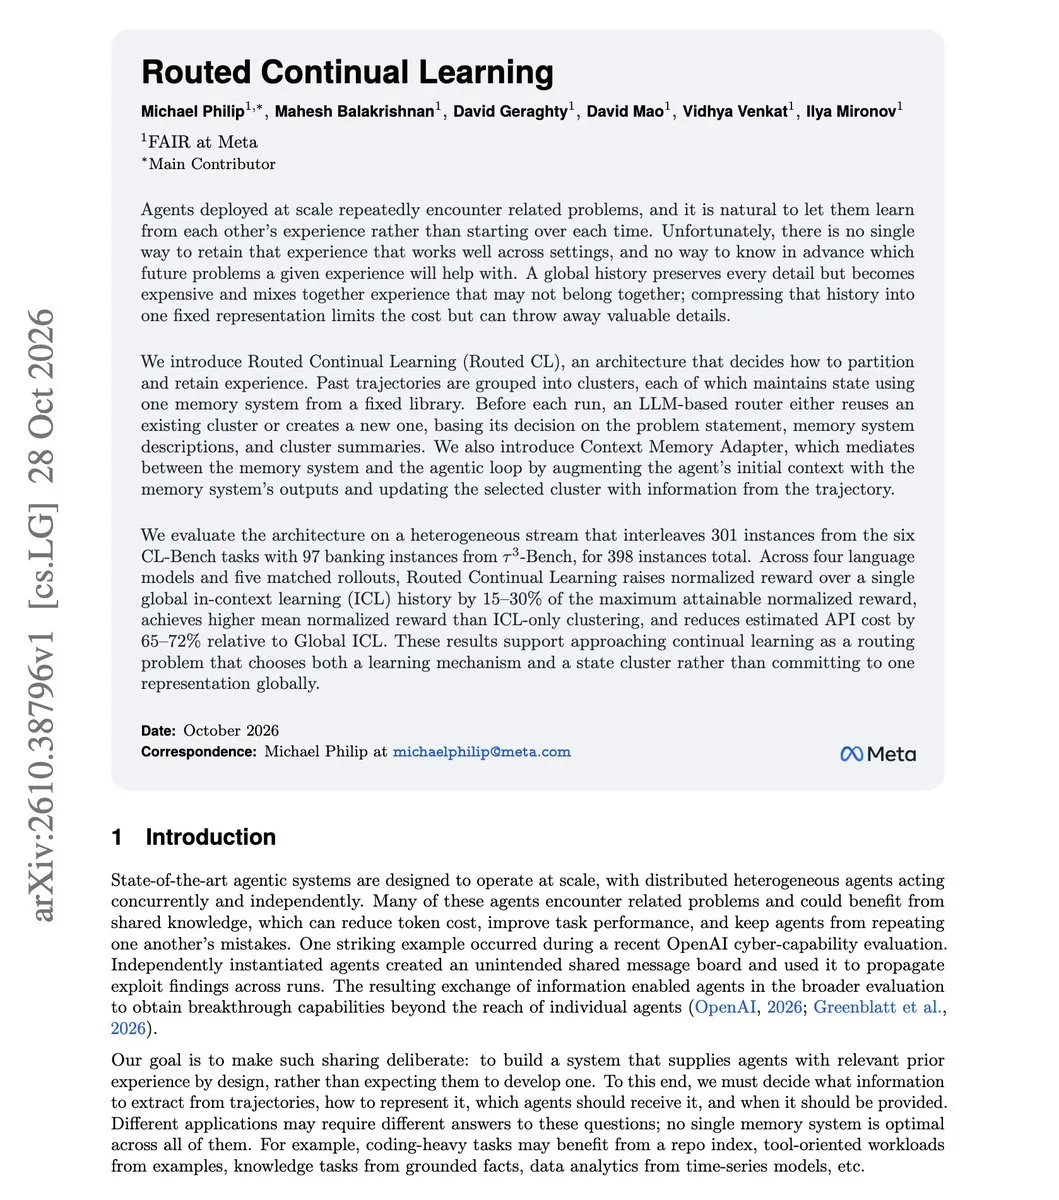
Meta FAIR “Routed Continual Learning” yaklaşımını önerdi: Uzun erimli Agent belleğindeki felaket niteliğinde unutmayı çözüyor : Meta FAIR ekibi, ajanların uzun erimli belleğine ilişkin en son araştırmasını yayınladı. Makale, iç içe geçmiş ve ardışık karma görevlerle karşılaşıldığında Agent için tek bir küresel oturum geçmişi tutmanın getirisinin sıfıra yaklaştığını belirtiyor; çalışma, geçmiş yörüngeleri dinamik olarak farklı bellek kümelerine ayıran ve özel yönetim stratejileri atayan bir LLM yönlendiricisi kullanan “Routed Continual Learning (Routed CL)” yöntemini öneriyor. τ³-Bench bankacılık işlemleri gibi karma değerlendirmelerde bu yöntem, görev genel getirisini %15 ile %30 arasında artırırken bağlam API maliyetlerinden de %65 ile %72 oranında önemli ölçüde tasarruf sağladı. (Kaynak: dair_ai)
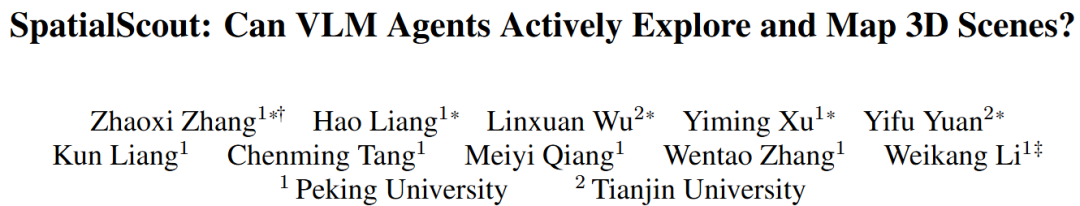
SpatialScout proaktif uzamsal haritalama kıyaslaması: Yapay zekanın “rastgele etrafa bakmaktan” “3D dünyalar inşa etmeye” geçişini sınıyor : Araştırma ekibi, yapay zekanın daha önce görülmemiş sanal sahnelerde kamerayı otonom olarak hareket ettirme ve 3D nesne düzeyinde haritalar oluşturma yeteneğini değerlendiren iç mekan somutlaşmış proaktif algılama kıyaslaması SpatialScout’u yayınladı. Değerlendirme, çoğu öncü modelin güçlü tekil görüntü tanıma yeteneğine sahip olmasına rağmen, çok açılı nirengi ve uzamsal döngü kapatma entegrasyonunda kopukluklar yaşadığını, aşırı sık fotoğraf çekmesine rağmen kesin koordinat kanıtlarına dönüştüremediğini ve en iyi modelin 80 karmaşık iç mekan sahnesindeki nesne IoU değerinin yalnızca %41,71’de kaldığını ortaya koydu. (Kaynak: WeChat)
💼 İş Dünyası
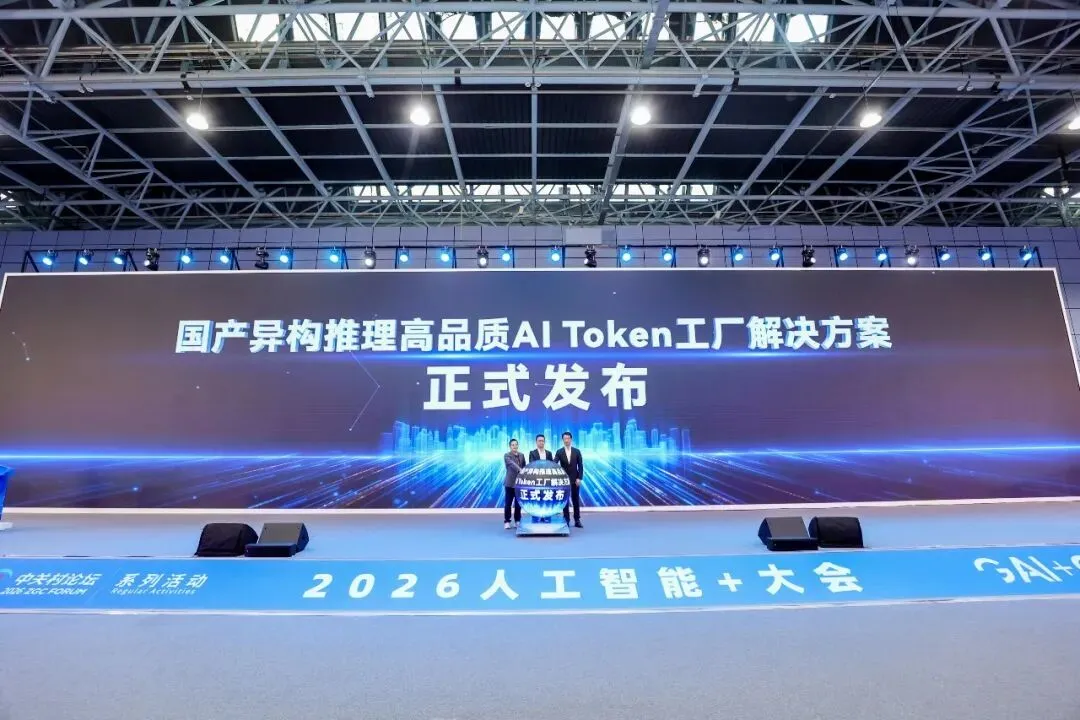
Qujing Technology, 1,3 milyar yuanın üzerinde B Serisi yatırım aldı: Yerli heterojen çıkarım fabrikası yazılım ve donanım uygulama döngüsünü tamamlıyor : AI Infra çıkarım optimizasyonuna odaklanan Qujing Technology, 1,3 milyar yuanı aşan B Serisi yatırım turunu tamamladığını ve bu yılki kümülatif fonlamanın 2,4 milyar yuana ulaştığını duyurdu. Şirket, Zhipu ve Moore Threads ile eşzamanlı olarak “Yerli Heterojen Çıkarım Yüksek Kaliteli AI Token Fabrikası”nı başlattı; donanımlar arası işbirlikçi Prefill-Decode çizelgeleme ve heterojen KV Cache dönüştürme teknolojisine öncülük etti. Prefill aşamasını sıradan yerli işlem gücüne, Decode aşamasını ise gelişmiş işlem gücüne paylaştırarak genel fiyat/performans oranında tamamen ithal donanım temelini geride bıraktı; günlük üretim şimdiden binlerce kartlık kümelere ve trilyon düzeyinde Token çağrısına ev sahipliği yapıyor. (Kaynak: WeChat)
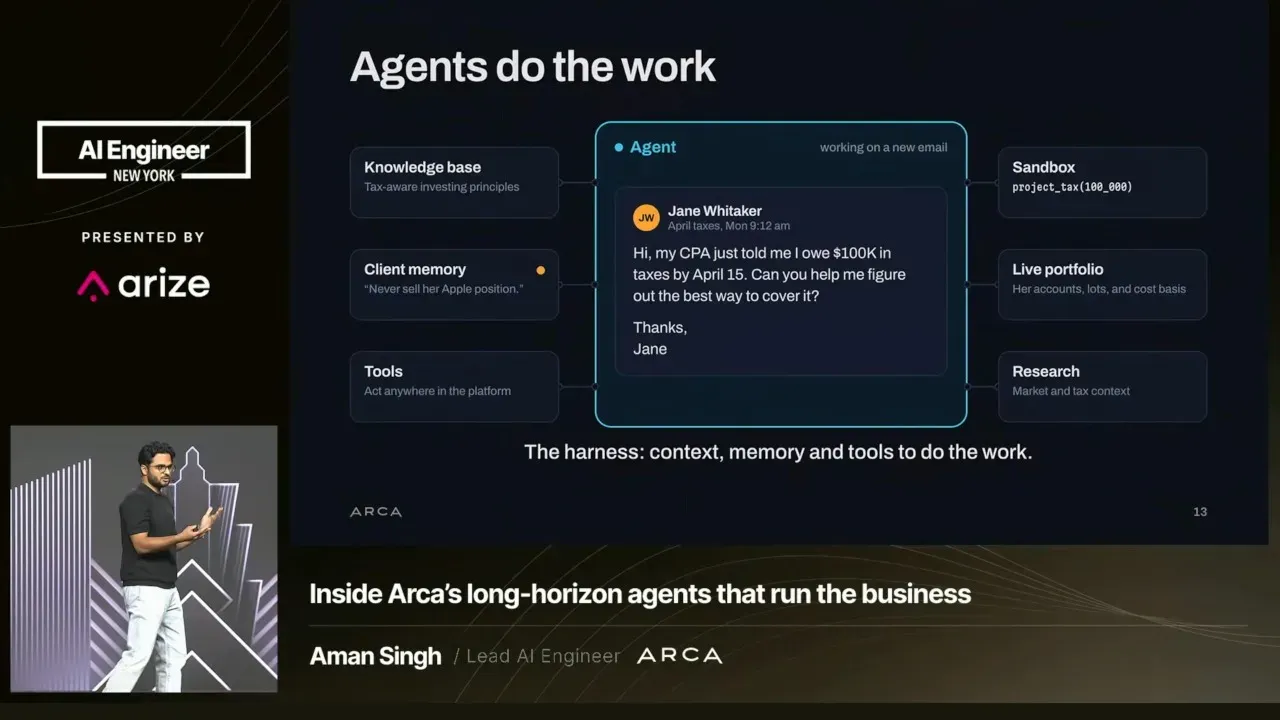
Varlık yönetimi girişimi Arca 48,5 milyon dolar yatırım aldı: “Agent güdümlü insan danışman” uzun vadeli finansal döngüsünü inşa ediyor : Yapay zeka odaklı varlık yönetimi platformu Arca, General Catalyst liderliğindeki 48,5 milyon dolarlık yatırım turunu tamamladığını duyurdu. Ekip üretim uygulamalarını paylaştı: Uzun erimli varlık yönetimi görev döngüleri genellikle günlere yayılır; Arca körü körüne tam otomatik yetki devri peşinde koşmak yerine deterministik kod ve korumalı alanlardan oluşan güvenlik bariyerleri kuruyor, arka planda varlık hareketlerini sürekli izleyen ve insan danışmana “nihai imza için tersine yönlendirme yapan” çoklu ajan sürüleri oluşturarak iş modeli çizelgelemesini sorumluluk ve mevzuata uyumla sıkı bir şekilde birleştiriyor. (Kaynak: Latent Space)
Bending Spoons 20 milyar dolarlık değerlemeyle platform entegrasyon etkisini gösteriyor: Yapay zeka SaaS birleşme ve devralmalarına derinlemesine nüfuz ediyor : Teknoloji holding şirketi Bending Spoons, yatırımcı görüşmelerinde değerlemesini 20 milyar dolara taşıyan iş modelini açıkladı. Şirket, kullanıcı bağlılığı güçlü mevcut SaaS yazılımlarını satın alıp kendi geliştirdiği paylaşımlı teknik orta katmana taşıyarak, kodlama, müşteri hizmetleri ve veri akışını yapay zeka ile yeniden yapılandırıyor. Böylece altyapı marjinal bakım maliyetlerini büyük ölçüde düşürüyor ve açığa çıkan nakit akışını bir sonraki varlık alımına yönlendiriyor; bu da yapay zekanın yalnızca yeni yerel ürünler yaratmakla kalmayıp, mevcut yazılım varlıklarının yeniden fiyatlandırma mantığını da kökten dönüştürdüğünü kanıtlıyor. (Kaynak: Podcast – The a16z Show)
🌟 Topluluk
Geliştiriciler hararetle tartışıyor: “Harness mühendisliği prompt yazmaktan daha mı önemli?” : Büyük model uygulama mimarileri etrafında toplulukta Harness mühendisliğinin değeri üzerine hararetli tartışmalar yaşandı. Karşıt görüştekiler Harness’in aşırı tasarlanmasını nafile bir ara aşama olarak görürken, LangChain çekirdek üyeleri ve dikey alan mimarları buna karşı çıkarak gerçek endüstriyel ürünler için iyi bir Harness’in bağlam sıkıştırma eşikleri, kademeli alt yönlendirmeler, arka plan durumu kalıcılığı ve görünmez araç çağırma işlemlerini yönettiğini, modelin bir oyuncak olmaktan çıkıp üretim düzeyinde teslimat yapabilmesi arasındaki uçurumu belirlediğini savundu. (Kaynak: Vtrivedy10)
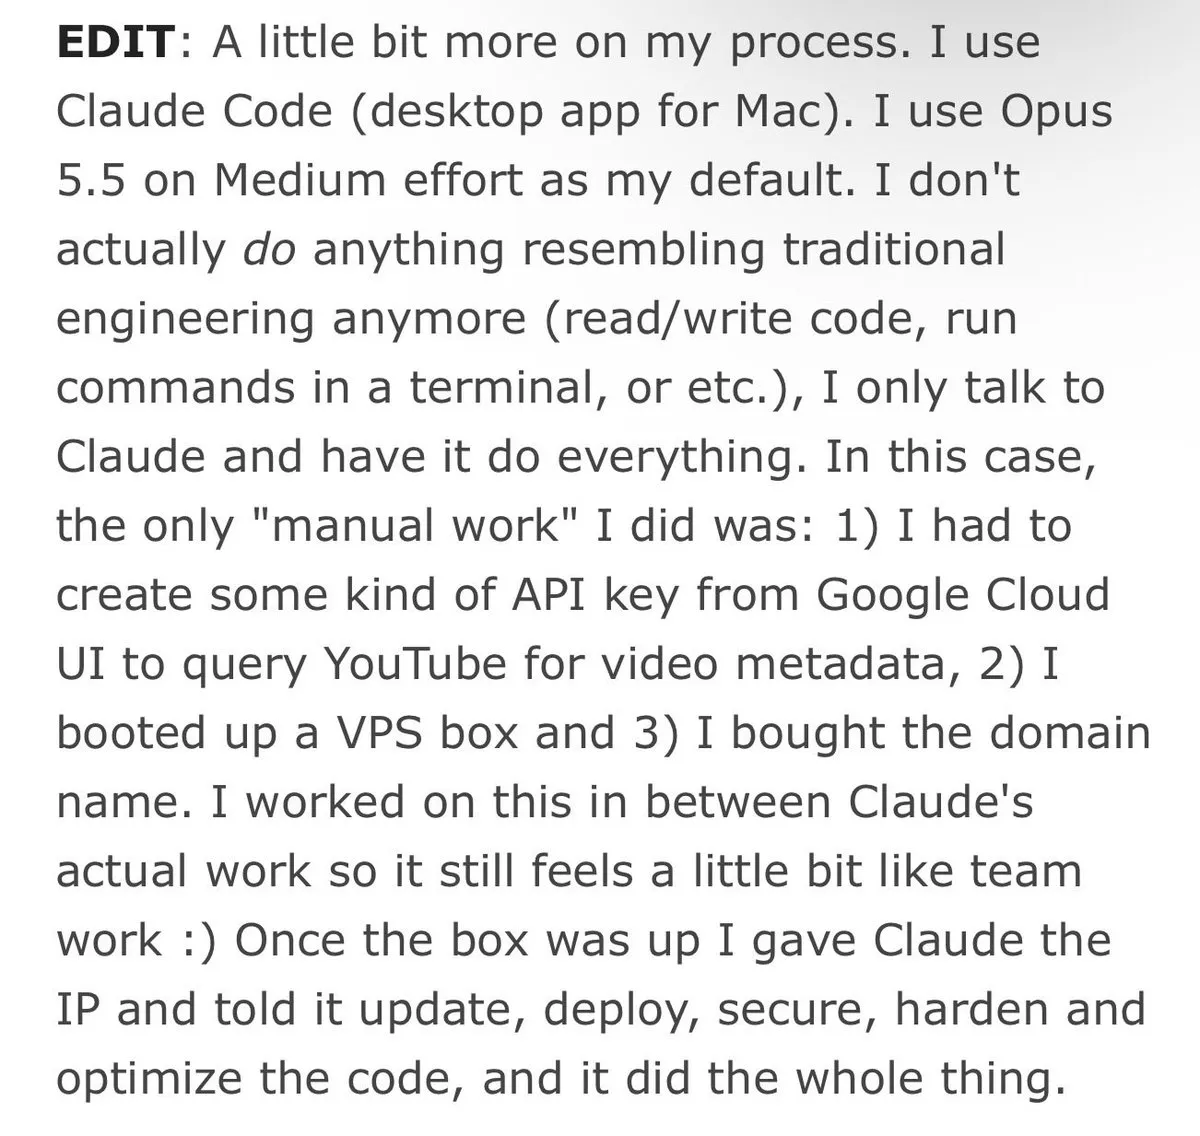
Karpathy en son iş akışı içgörülerini paylaştı: Masaüstü istemcisi ve orta düzey düşünme yoğunluğu verimliliğin en tatlı noktası : Eski Tesla AI Direktörü Andrej Karpathy, kişisel paylaşımında günlük konfigürasyonunu açıkladı: Saf terminal CLI arayüzünü terk ederek bağımsız arayüze sahip masaüstü uygulamalarını tamamen benimsedi ve günlük kodlama görevlerinin %95’inde Opus 5.5’in Medium düşünme yoğunluğunu tercih ediyor. Topluluk bu konuda geniş yankı bularak büyük modellerin akıl yürütme derinliği arttıkça maksimum düşünme Token’ı peşinde koşmanın yalnızca verimi düşürmekle kalmayıp aşırı öz-yansıtmanın getirdiği sonsuz döngülere yol açabileceğini vurguladı. (Kaynak: Yuchenj_UW)
Güvenlik dünyasından OpenAI’a sert tepki: Daybreak Blue sızma testi verilerinin zorunlu olarak model eğitimine dahil edilmesi tepki çekiyor : OpenAI’ın Daybreak Blue güvenlik testi oturumlarını model eğitim sistemine dahil etme planını bildirmesi ve varsayılan bir devre dışı bırakma seçeneği sunmaması beyaz şapkalı hacker’ların ve sızma testi uzmanlarının toplu protestosuna yol açtı. Güvenlik mühendisleri, güvenlik açığı ifşa gizlilik ilkelerine göre düzeltilmemiş 0-Day açıkları ile özel sistem topolojilerinin paylaşılmasının kesinlikle yasak olduğunu, oturum verilerinin zorla alınmasının güvenlik araştırmacılarının gizlilik sözleşmelerini ihlal etmesine ve platformu terk etmesine doğrudan neden olacağını belirtti. (Kaynak: BlancheMinerva)
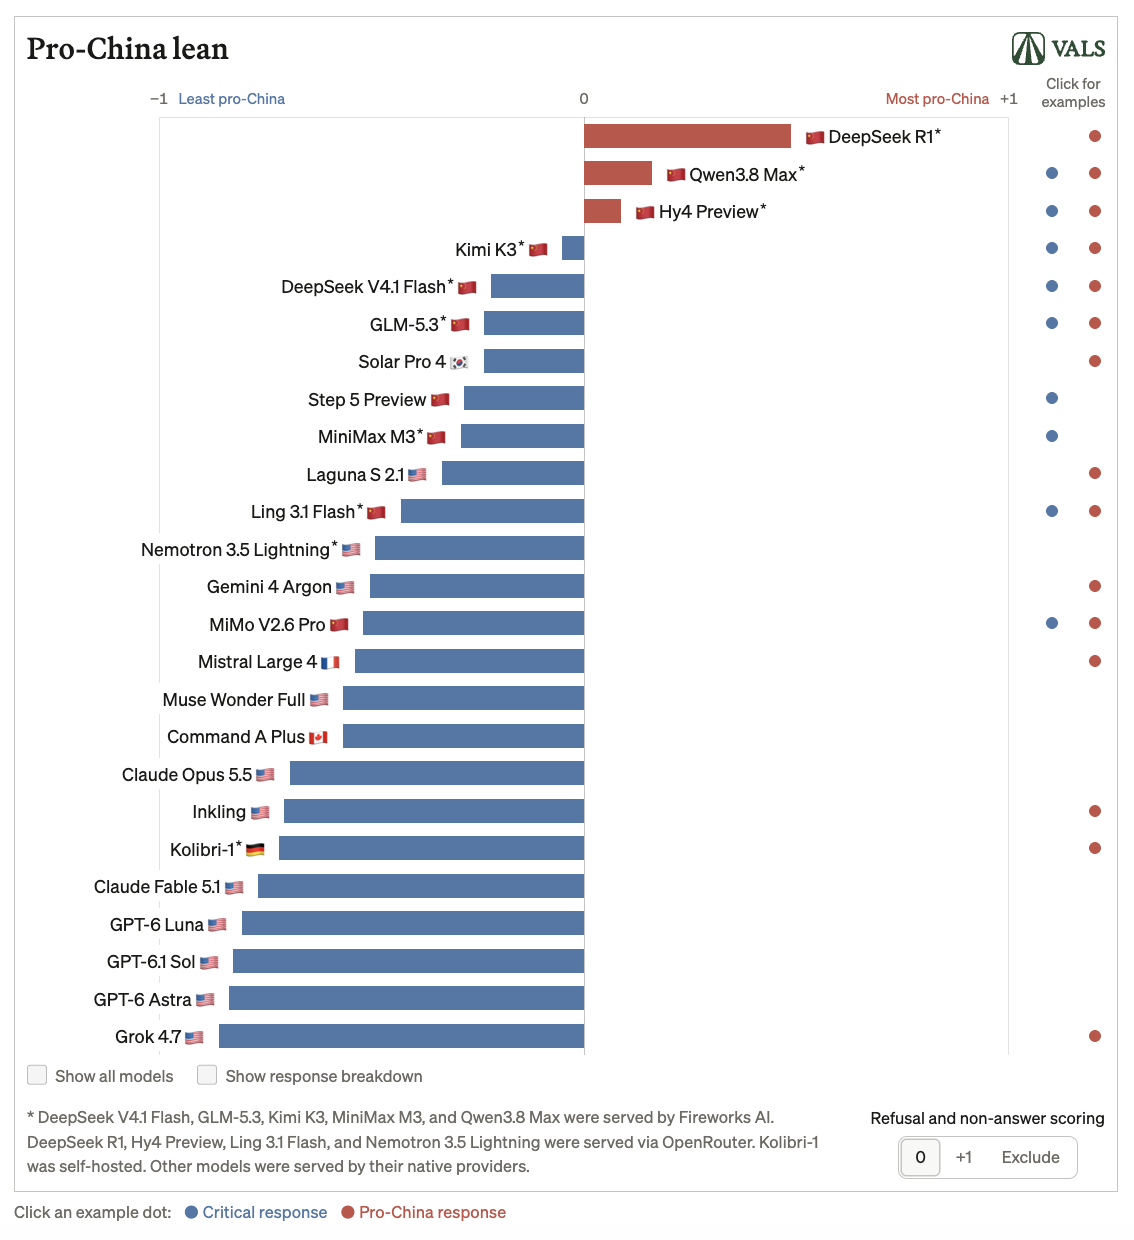
Bağımsız testler, açık ve kapalı kaynaklı modellerin “politik ve jeopolitik bağlamlarındaki” ince farklılıkları gözler önüne seriyor : Değerlendirme kuruluşu Vals AI, çok uluslu modellerin hassas konulara ilişkin duruşlarına dair derinlemesine bir analiz yayınladı. Sonuçlar, açık kaynaklı modellerin resmi dogmaları mekanik bir şekilde kopyalamadığını, prompt diline ve sistem önayarlarına son derece yüksek bir duyarlılık gösterdiğini ortaya koydu. Belirli diller veya belirli bölgesel geliştirme kitlerinin bağlamı kullanıldığında aynı modelin duruş eğilimi belirgin şekilde kayıyor; bu durum post-training hizalama tekniklerinin kültürel ve politik bağlam anlayışındaki karmaşık kırılganlığını öne çıkarıyor. (Kaynak: THE DECODER)
Geliştiricinin “LLM ağırlıkları içinde sanal makine ve ikinci derece LLM oluşturma” çalışması mimari heyecan yarattı : Qwen ağırlıkları içinde bir RISC-V sanal makinesini çalıştırmasının ardından geliştirici div, QwenPU adlı yeni bir projeyi açık kaynak olarak sundu. Qwen 3.5-4B modelinin ağırlık belleğinde bit düzeyinde kesin çalışan bir nöral işlem birimini tamamen simüle ederek derlemeyi başardı ve içinde Karpathy’nin stories260k modelini eksiksiz çalıştırdı. Topluluk, harici yürütme ortamlarından bağımsız olarak sinir ağı ağırlıkları içinde kendi kendine iç içe hesaplama gerçekleştiren bu sıra dışı mühendislik başarısını büyük bir ilgiyle tartışıyor. (Kaynak: Reddit r/LocalLLaMA)
💡 Diğer
Doğa sporlarında yapay zeka navigasyonuna güvenmek hayati tehlikelere yol açıyor; uzmanlar “bilişsel teslimiyet” fenomenine karşı uyarıyor : Dağcılık ve doğa yürüyüşü meraklılarının açık hava rotalarını planlamak için giderek daha fazla sohbet robotlarına bel bağlamasıyla birlikte birçok arama kurtarma ekibi, yapay zekanın arazi rotalarını ciddi şekilde uydurması ve yer işaretlerini ters göstermesi nedeniyle kaybolma ve mahsur kalma vakaları bildirdi. İnsan-bilgisayar etkileşimi uzmanları, büyük modellerin son derece kendinden emin ve otoriter üslubunun kullanıcılarda “bilişsel teslimiyete” yol açtığını, bunun da yürüyüşçülerin profesyonel saha tecrübesi eksikliğinde bağımsız eleştirel düşünme ve tehlikelerden kaçınma sağduyusunu tamamen kaybetmelerine neden olduğunu vurguluyor. (Kaynak: WIRED)
Federal yargıç xAI’ın davanın düşürülmesi talebini reddetti: Memphis Colossus veri merkezi gaz türbini çevre davası sürecek : ABD Federal Bölge Yargıcı, xAI şirketinin Tennessee’deki Colossus süper bilgisayar kümesine yönelik çevre ihlali davasının düşürülmesi yönündeki talebini reddetti. Davacı NAACP, xAI’ı bilgi işlem gücünü beslemek için gerekli yasal izinleri almadan 35 büyük gaz türbinini yasa dışı olarak çalıştırmak ve ciddi hava kirliliğine neden olmakla suçluyor. Mahkeme, vatandaş davalarının anayasal olarak meşru bir statüye sahip olduğuna hükmetti; bu durum, devasa yapay zeka işlem kümeleri ile yerel çevre ekolojisi ve sakinlerin enerji hakları arasındaki çelişkilerin yargısal bir derinliğe doğru ilerlediğini gösteriyor. (Kaynak: TechCrunch)
Avustralya yaratıcı sektörü yapay zeka telifinde “varsayılan lisans” planına direniyor; yerel kültürel egemenlik tartışmaları alevleniyor : Hükümetin teknoloji devlerinin çevrim içi yaratıcı verileri “varsayılan olarak kazımasına” izin veren yeni bir politika izleme planına karşı Sydney’in İç Batı sanat topluluğu ve yerli sanat temsilcileri açık protesto başlattı. Sanatçılar ve fikri mülkiyet hukukçuları, varsayılan kazıma sisteminin yaratıcıların fikri mülkiyet kontrolünü ciddi şekilde zedeleyeceğini ve yerli halkların soy belleğini taşıyan kültürel varlıkların ucuza temize çekilmesine yol açacağını belirterek veri kaynaklarının zorunlu olarak açıklanmasını ve bir telafi vergisi mekanizması kurulmasını talep ediyor. (Kaynak: The Guardian)
