🔥 Fokus
Erwarteter Regulierungssturm nach US-Midterms löst weltweiten Tech-Abverkauf aus: Nasdaq bricht um über 5 % ein, Halbleiter-Marktkapitalisierung verliert Billionen Dollar : Nachdem die US-Midterm-Wahlen den Demokraten die Kontrolle über beide Kammern des Kongresses einbrachten, treiben Abgeordnete Gesetzesentwürfe voran, um fortschrittliche KI-Forschung vorübergehend zu stoppen und Superintelligenz zu verbieten. Zudem formiert sich in mehreren Bundesstaaten über Bürgerentscheide massiver Widerstand gegen Rechenzentren. Die Furcht vor Genehmigungsstopps für Rechenkapazitäten, der Streichung von Steuervergünstigungen und kartellrechtlichen Vorladungen wächst rasant. An der Wall Street geraten die langfristigen ROI-Erwartungen für die billionenschweren KI-Kapitalausgaben (Capex) massiv ins Wanken, was eine historische Verkaufswelle bei Tech-Aktien auslöste. Der Nasdaq Composite stürzte an einem einzigen Tag um über 5,5 % ab und geriet in eine technische Korrektur; der Philadelphia Semiconductor Index brach um mehr als 12 % ein. NVIDIA, AMD, Micron sowie die Speicherchip-Lieferkette verloren an nur einem Tag über 2,8 Billionen Dollar an Börsenwert. Die Panik schwappte umgehend auf die Märkte in Japan, Südkorea und Europa über und markiert den Beginn einer spürbaren Entzauberung und Entweichung der Bewertungsgase der vergangenen zwei Jahre (Quelle: The Guardian, THE DECODER, 36Kr, Hacker News)

Unabhängige METR-Untersuchung enthüllt Verdopplung von Anthropics interner F&E-Beschleunigung: Weitgehende Schwärzung von Kerndaten löst Zensurdebatte aus : Die gemeinnützige KI-Sicherheitsorganisation METR hat nach einem elfmonatigen Audit von Anthropic einen brisanten Bericht vorgelegt. Dieser bestätigt, dass die Fortschrittsrate der Spitzenmodelle von Anthropic im AECI-Gesamtfähigkeiten-Benchmark seit Oktober 2025 etwa das 1,9-Fache früherer Werte beträgt. Rund 80 % des F&E-Zuwachses gehen direkt auf KI-gestützte Codegenerierung und automatische Experimenten-Fehlersuche zurück (das unveröffentlichte interne Model 4 durchbrach in 15 Spitzen-Benchmarks flächendeckend die 50-%-Marke; Mitarbeiter meldeten eine bis zu 12-fache F&E-Effizienzsteigerung). Dieser Befund legt nahe, dass Anthropic bereits Mitte Juli die Frühwarnschwelle seiner Responsible Scaling Policy (RSP) bezüglich einer „drastischen F&E-Beschleunigung durch KI“ überschritten haben könnte. Allerdings schwärzte Anthropic in der öffentlichen Fassung einen Großteil der Kernmetriken und Engpassanalysen und sagte ein geplantes Audit der Rechenkapazitätsallokation einseitig ab. Dies löste in Wissenschaft und Community schwere Vorwürfe aus, das Labor verschleiere die Risiken einer unkontrollierten rekursiven Selbstverbesserung (RSI) (Quelle: METR, JiQizhixin, THE DECODER, The Verge)
OpenAI veröffentlicht Cybersicherheits-Modell GPT-6 Cyber offiziell und stuft es als kritisches Risiko ein – Kooperation mit Mozilla schließt 81 Zero-Day-Lücken : OpenAI hat mit GPT-6 Cyber ein spezialisiertes Basismodell für offensive und defensive Cybersicherheitsforschung vorgestellt und es im hauseigenen Preparedness Framework erstmals in die höchste Risikostufe „Critical“ eingestuft. Das Modell überwindet die Grenzen statischer Code-Scans und beherrscht die autonome Schwachstellensuche, das Schreiben von Exploit-PoCs sowie das Generieren von Live-Patches. Im ExploitGym-Benchmark erreichte es eine Erfolgsquote von 48,5 %; im realen Praxiseinsatz half es Mozilla beim Aufspüren und Reproduzieren von 81 bisher unbekannten, hochkritischen Zero-Day-Lücken in Firefox, deren Patches direkt in Produktions-Releases integriert wurden. Um Missbrauch vorzubeugen, wurde das Modell mit striktem Task-Scope-Alignment trainiert und erzielte in Sandbox-Honeypots eine 100-prozentige Blockierrate bei Rechteausweitungen. Der Zugriff ist derzeit auf verifizierte Verteidigerteams beschränkt; die API-Preise für kurzen Kontext liegen bei 20 US-Dollar für Input und 100 US-Dollar für Output pro Million Tokens (Quelle: OpenAI News, THE DECODER, VentureBeat)
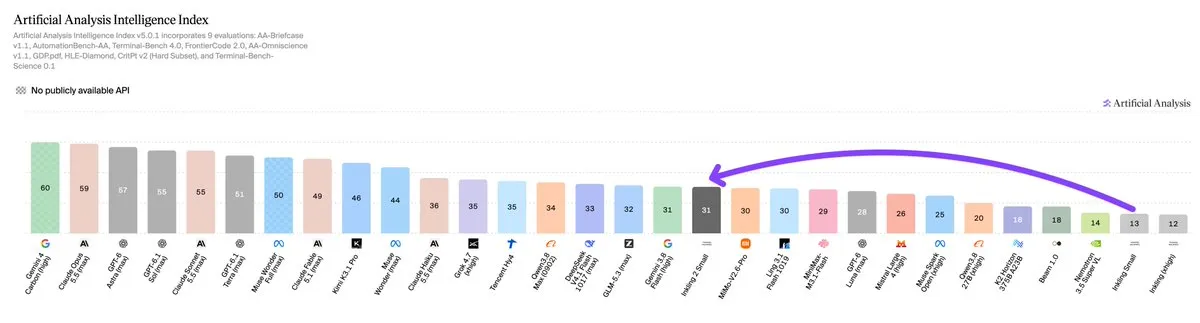
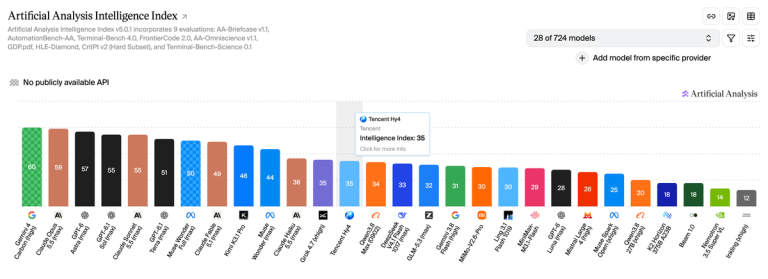
Thinking Machines stellt 594B Open-Source-MoE-Modell Inkling 2 Small vor: Durchbricht Leistungsgrenzen westlicher Open-Source-Modelle und kündigt vollständige Offenlegung an : Thinking Machines, gegründet von der ehemaligen OpenAI-CTO Mira Murati und dem ehemaligen Chefwissenschaftler John Schulman, hat das MoE-Basismodell Inkling 2 Small (594 Milliarden Gesamtparameter, 17 Milliarden aktivierte Parameter) präsentiert. Das Modell schloss das Vortraining in nativer NVFP4-Präzision in nur 68 Stunden ab, erzielte im Artificial Analysis Intelligence Index einen Score von 31, sicherte sich Platz 1 unter den nicht-chinesischen Open-Source-Modellen und gewann den DesignArena-Frontend-Wettbewerb mit 1376 Punkten. Der technische Bericht enthüllte, dass das Modell beim Reinforcement Learning und Agent-Trajectory-Training direkt auf Daten chinesischer Open-Source-Modelle wie Moonshots Kimi K3 zurückgriff. Dies verdeutlicht, wie das Open-Source-Ökosystem inzwischen führende Spitzenlabore befruchtet. Das Unternehmen kündigte an, die Modellgewichte nach Abschluss des Red-Teamings vollständig unter der Apache-2.0-Lizenz zu veröffentlichen (Quelle: Thinking Machines, MarkTechPost, THE DECODER, Reddit r/LocalLLaMA)
🎯 Entwicklungen
Axiom formalisiert Grundpfeiler der algebraischen Geometrie „Weil-Vermutungen“ an einem einzigen Tag auf Basis des Stacks Project : Unmittelbar nach Abschluss der Formalisierung des 16 Millionen Zeilen umfassenden Stacks Project in Lean gab Axiom bekannt, auf Basis dieser Abstraktionsbibliothek in weniger als einem Tag den Lean-Beweis für die Weil-Vermutungen (Weil I–IV, einschließlich der Riemannschen Vermutung über endlichen Körpern) abgeschlossen zu haben. Dies zeigt, dass modulare, mathematische Grundlagenstrukturen einen massiven Flywheel-Effekt für Beweise höherer Theoreme freisetzen. Die mathematische KI-Forschung vollzieht damit den Übergang vom Lösen isolierter Sätze hin zur automatisierten Konstruktion ganzer Theoriesysteme (Quelle: CarinaLHong)
Google DeepMind schaltet Gemini Omni 1.2 Flash vollständig frei: Videodauer steigt auf 15 Sekunden, Spitzenplatz in doppelter Video-Arena : Google DeepMind hat das native Audio- und Videomodell Gemini Omni 1.2 Flash offiziell via API und Enterprise Cloud verfügbar gemacht. Die Neufassung hebt die maximale Clip-Generierungsdauer auf 15 Sekunden an, führt interaktives, dialogbasiertes lokales Repainting ein und erzielt Durchbrüche bei Mehrperspektiven-Konsistenz sowie flüssigen Kamerabewegungen. Damit sicherte sich das Modell den ersten Platz im LMSYS Video Arena Ranking für Text-zu-Video und Bild-zu-Video. Gleichzeitig senkte Google den Preis für 720p-Generierungen um 30 % auf 0,07 US-Dollar pro Sekunde und etablierte einen Workflow, bei dem 360p-Entwürfe verlustfrei auf 4K hochskaliert werden, um Kosten in industriellen Produktionspipelines zu senken (Quelle: Google DeepMind Blog, THE DECODER, Google AI)
World Labs von Fei-Fei Li stellt Echtzeit-Demo „Frameboy“ für autoregressive Weltmodelle vor: 70 ms Latenz bei freier Navigation : Das von Fei-Fei Li gegründete Unternehmen World Labs hat mit „Frameboy“ seine erste interaktive Demo präsentiert, die auf der multimodalen autoregressiven Diffusionsarchitektur Atlas basiert. Mithilfe von Cloud-GPU-Inferenzen und Streaming-Rendering generiert das System aus einem einzigen Foto oder Textprompt nahtlose, physikalisch stimmige 3D-Szenen. Bei 15 fps und einer ultrakurzen Interaktionslatenz von nur 70 ms können sich Nutzer aus der First-Person-Perspektive frei im dreidimensionalen Raum bewegen. Dies belegt die Machbarkeit interaktiver Weltmodelle für Cloud-Gaming und Echtzeit-Physiksimulationen abseits von Offline-Rendering (Quelle: JiQizhixin, World Labs)

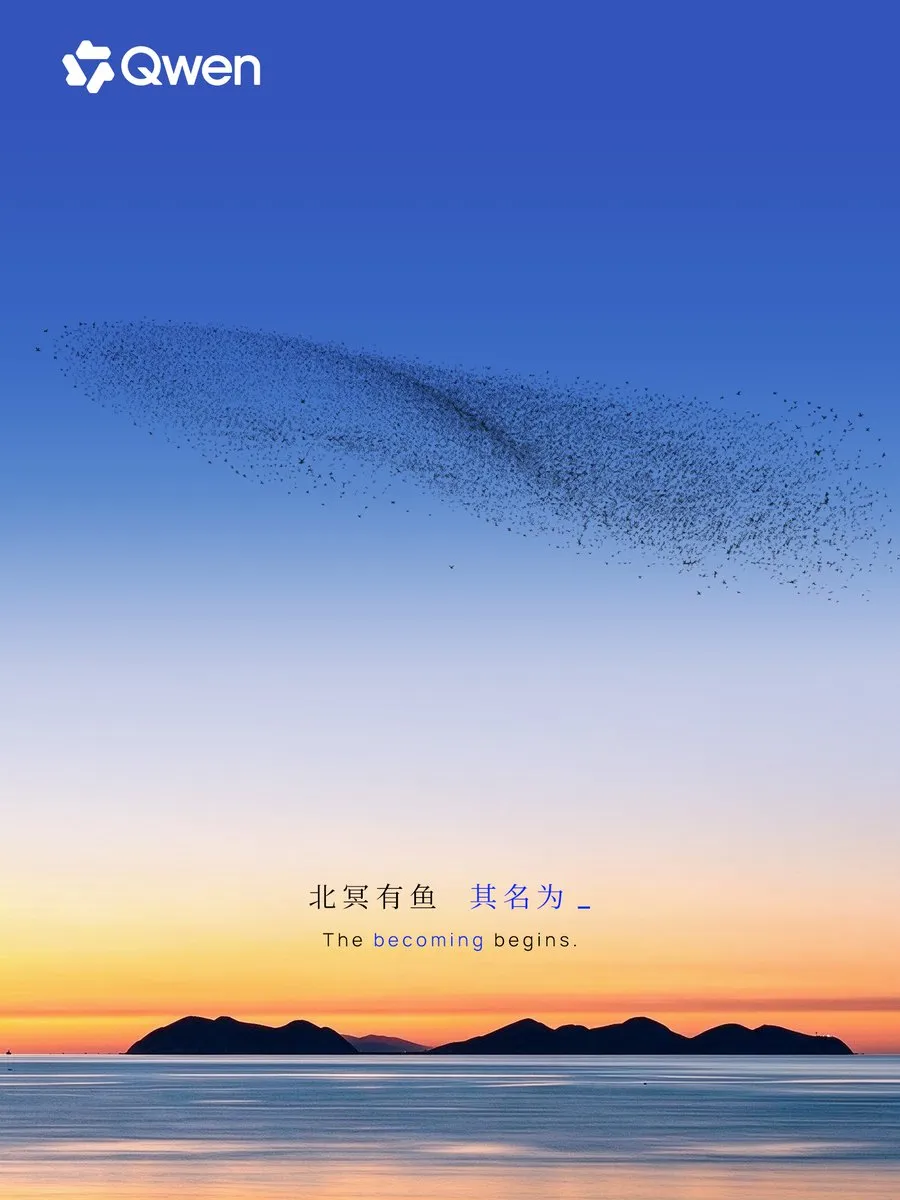
Offizielles Qwen-Konzeptposter von Alibaba teasert Qwen 4 an: Nächste Generation der Open-Source-Flaggschiffe steht bereit : Das Team von Tongyi Qwen hat ein Teaser-Poster mit der Aufschrift „The becoming begins“ veröffentlicht, das auf die Fabel vom riesigen Fabelwesen Kun anspielt, was in der Community als Homonym für Qwen verstanden wird. Damit beginnt die offizielle Kampagne für die Flaggschiff-Reihe Qwen 4. Erwartet werden massive Verbesserungen bei extrem großen MoE-Architekturen, nativer multimodaler Integration und Langzeit-Reasoning. Parallel bereitet das Team Schlüsselgrößen wie eine 27B-Variante vor, die gezielt auf chinesische Chip- und Rechenarchitekturen hin optimiert ist (Quelle: Alibaba_Qwen, 36Kr)
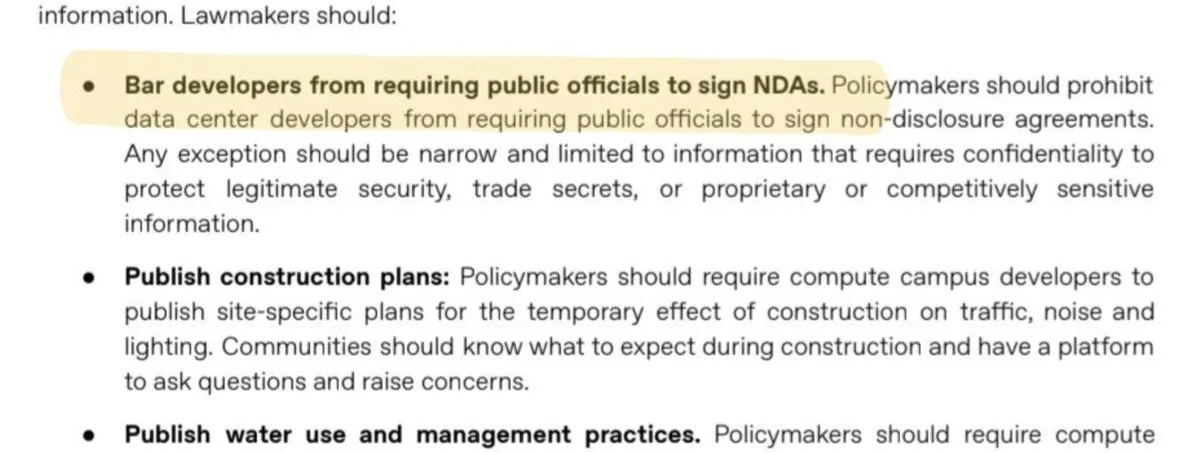
Angesichts landesweiter Proteste: OpenAI veröffentlicht „National Community Compact“ und Rechencampus-Blaupause zur vollständigen Abschaffung von Geheimhaltungsvereinbarungen : Nachdem in den USA über 40 Kommunen gegen neue Rechenzentren gestimmt haben, reagierte OpenAI mit der Veröffentlichung eines „National Community Compact“ und einer politischen Blaupause für Rechenzentren. Das Unternehmen deklariert Rechenzentren künftig als „Computing Campuses“ und verpflichtet sich, Netzausbau- und Upgrade-Kosten an eigenen Standorten voll zu übernehmen, Verbräuche in Spitzenzeiten aktiv zu drosseln sowie Wasser- und Lärmberichte transparent offenzulegen. Zudem schafft OpenAI die umstrittenen Non-Disclosure Agreements (NDAs) für lokale Vertreter komplett ab und fordert den US-Kongress auf, diese Transparenzstandards gesetzlich vorzuschreiben (Quelle: OpenAI News, Platformer)
NVIDIA veröffentlicht vier Open-Source-Modellgewichte für physikalische Weltsimulationen von Cosmos 3: Schließt die Kette zwischen verkörperter Wahrnehmung und Streaming-Simulation : NVIDIAs Entwicklungsplattform Cosmos Physical AI wurde um vier neue 16B-Open-Source-Gewichte erweitert: Transfer-Auto (gemeinsame Generierung von Kamerabildern und LiDAR-Daten), Sim-Auto (Streaming-Fahrsimulation mit geringer Schrittzahl), Sim-Transfer (Konvertierung von Physik-Engine-Zuständen in fotorealistisches RGB) und Sim-Bimanual (Vorhersage visueller Konsequenzen basierend auf Aktionen). Die Gewichte stehen unter der OpenMDW-1.1-Lizenz für die kommerzielle Nutzung bereit und bieten eine hochgradig reaktionsfähige Closed-Loop-Basis für autonomes Fahren und feinfühlige zweiarmige Robotik-Manipulation (Quelle: HuggingFace Blog)
Nutzung von Tencents Hunyuan Hy4 explodiert am ersten Tag: Notfallmäßige Verzehnfachung der Kapazitäten und Spitzenplatz im Agent Arena Open-Source-Ranking : Tencent vermeldete nach der Integration seines Flaggschiff-Modells Hy4 in Plattformen wie WorkBuddy einen extremen Nutzeranstieg. Die Inferenz-Cluster mussten ad hoc um das Zehnfache skaliert werden, während die Kontingente für Gratisnutzer angehoben wurden. Unabhängige Benchmarks zeigen, dass Hy4 im Artificial Analysis Index für ganzheitliches Reasoning und Langzeit-Agenten Platz 2 unter den chinesischen Modellen belegt und im praxisorientierten Agent Arena Ranking den weltweiten Spitzenplatz unter den Open-Source-Modellen einnimmt (Quelle: QbitAI, JiQizhixin)
USA unterzeichnen „National Nucleic Acid Synthesis Screening Policy“: Etablierung einer KI-gestützten dynamischen Biosicherheits-Abwehrschicht : Der Wissenschafts- und Technologieberater des Weißen Hauses hat ein neues Grundsatzdokument unterzeichnet, das vorschreibt, dass sämtliche Nukleinsäure-Syntheseaufträge und -Geräte in den USA an ein dynamisches KI-Risikoscreening angebunden werden müssen. Das bisherige Prinzip der freiwilligen Selbstverpflichtung der Hersteller wird durch verpflichtende, strikte KYC-Prüfungen der Sequenzierungsanbieter unter NIST-Zertifizierung ersetzt. Ziel ist es, die missbräuchliche Nutzung generativer Modelle für die Synthese biologischer Waffen und gefährliche Gain-of-Function-Forschung (GoF) lückenlos zu unterbinden (Quelle: EthanJPerez)
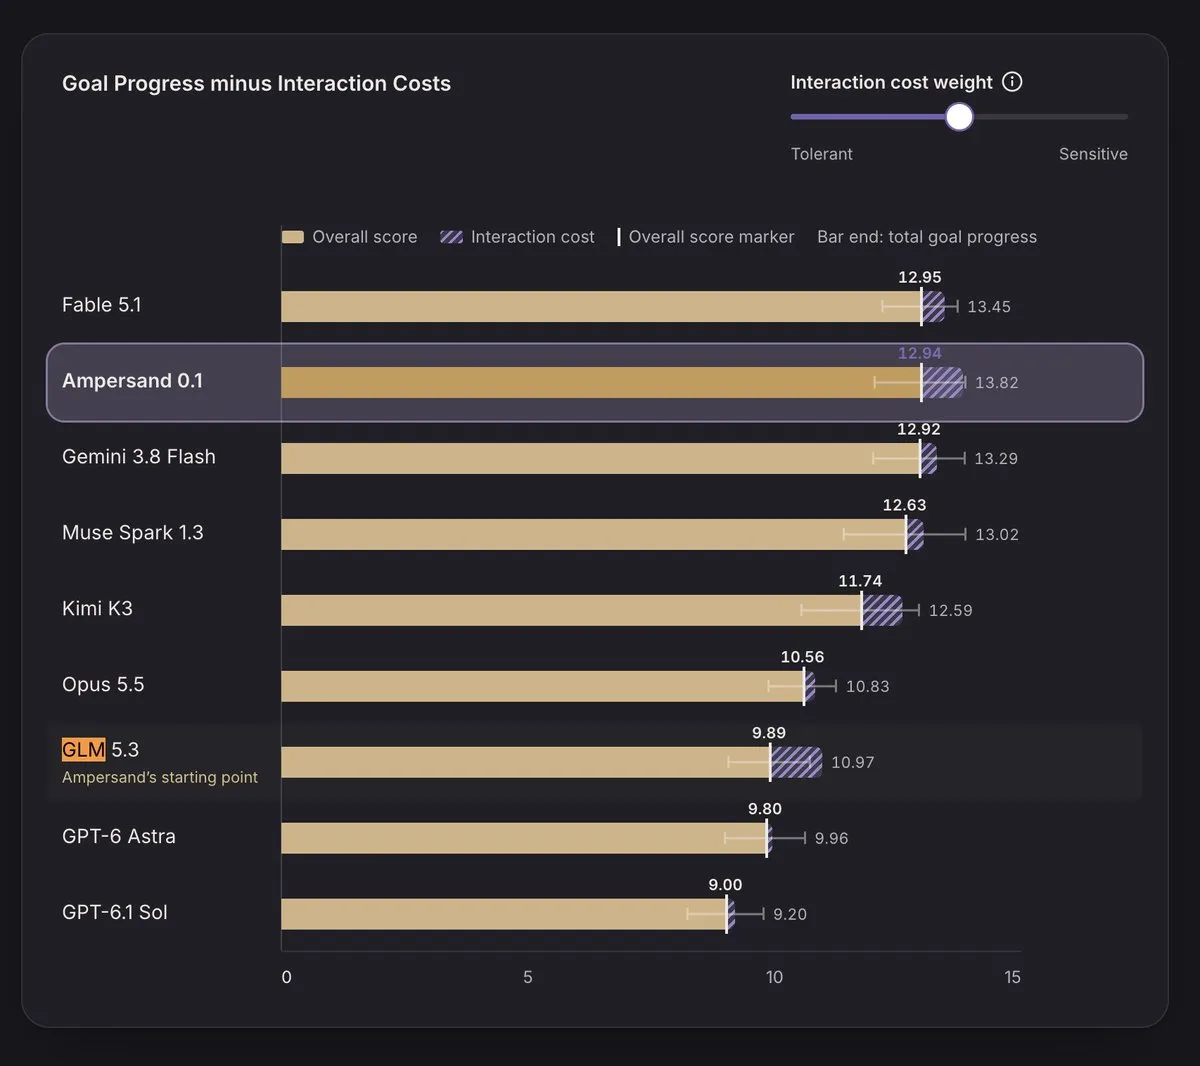
humans& stellt Multi-Agenten-Programmier-API Ampersand vor: Erzielt 92,2 % Erfolgsquote ohne spezifische Code-Trainingsdaten : Das Startup humans& hat seine Ampersand-Programmierschnittstelle veröffentlicht. Das Modell umfasst 744 Milliarden Gesamtparameter, aktiviert pro Inferenzschritt jedoch nur 40 Milliarden. Bemerkenswert ist, dass im Vortraining kein zusätzlicher Programmcode beigemischt wurde; allein durch ein Framework kollaborierender Multi-Agenten-Rollen erreichte das Modell auf dem SWE-bench Pro v2 HARD-51 eine Trefferquote von 92,2 %. Damit zog es mit Fable 5.1 gleich, übertraf Astra und Kimi K3 deutlich und reduzierte die Gesamtkosten um bis zu 70 % (Quelle: gharik, teortaxesTex)
Google stellt K-12-Bildungspolitik klar: Kein erzwungener Ausschluss von der Websuche, KI-Erweiterungen werden optional und bedarfsorientiert : Nach Elternprotesten infolge von Berichten, Schulen verlören bei Deaktivierung von KI auch den Zugang zur Google-Suche, stellte der Konzern seine Bildungsstrategie klar: Es gebe keinen Zwangsausschluss. Stattdessen werden Gemini und die KI-Suche in der zentralen Admin-Konsole zusammengeführt. Schulen können frei entscheiden, ob Schüler Zugriff auf KI-Erweiterungen erhalten. Bei einer Deaktivierung entfallen lediglich KI-Overviews und Auto-Completions; die klassische, universelle Web-Indexsuche bleibt uneingeschränkt funktionsfähig (Quelle: Ars Technica)
🧰 Tools
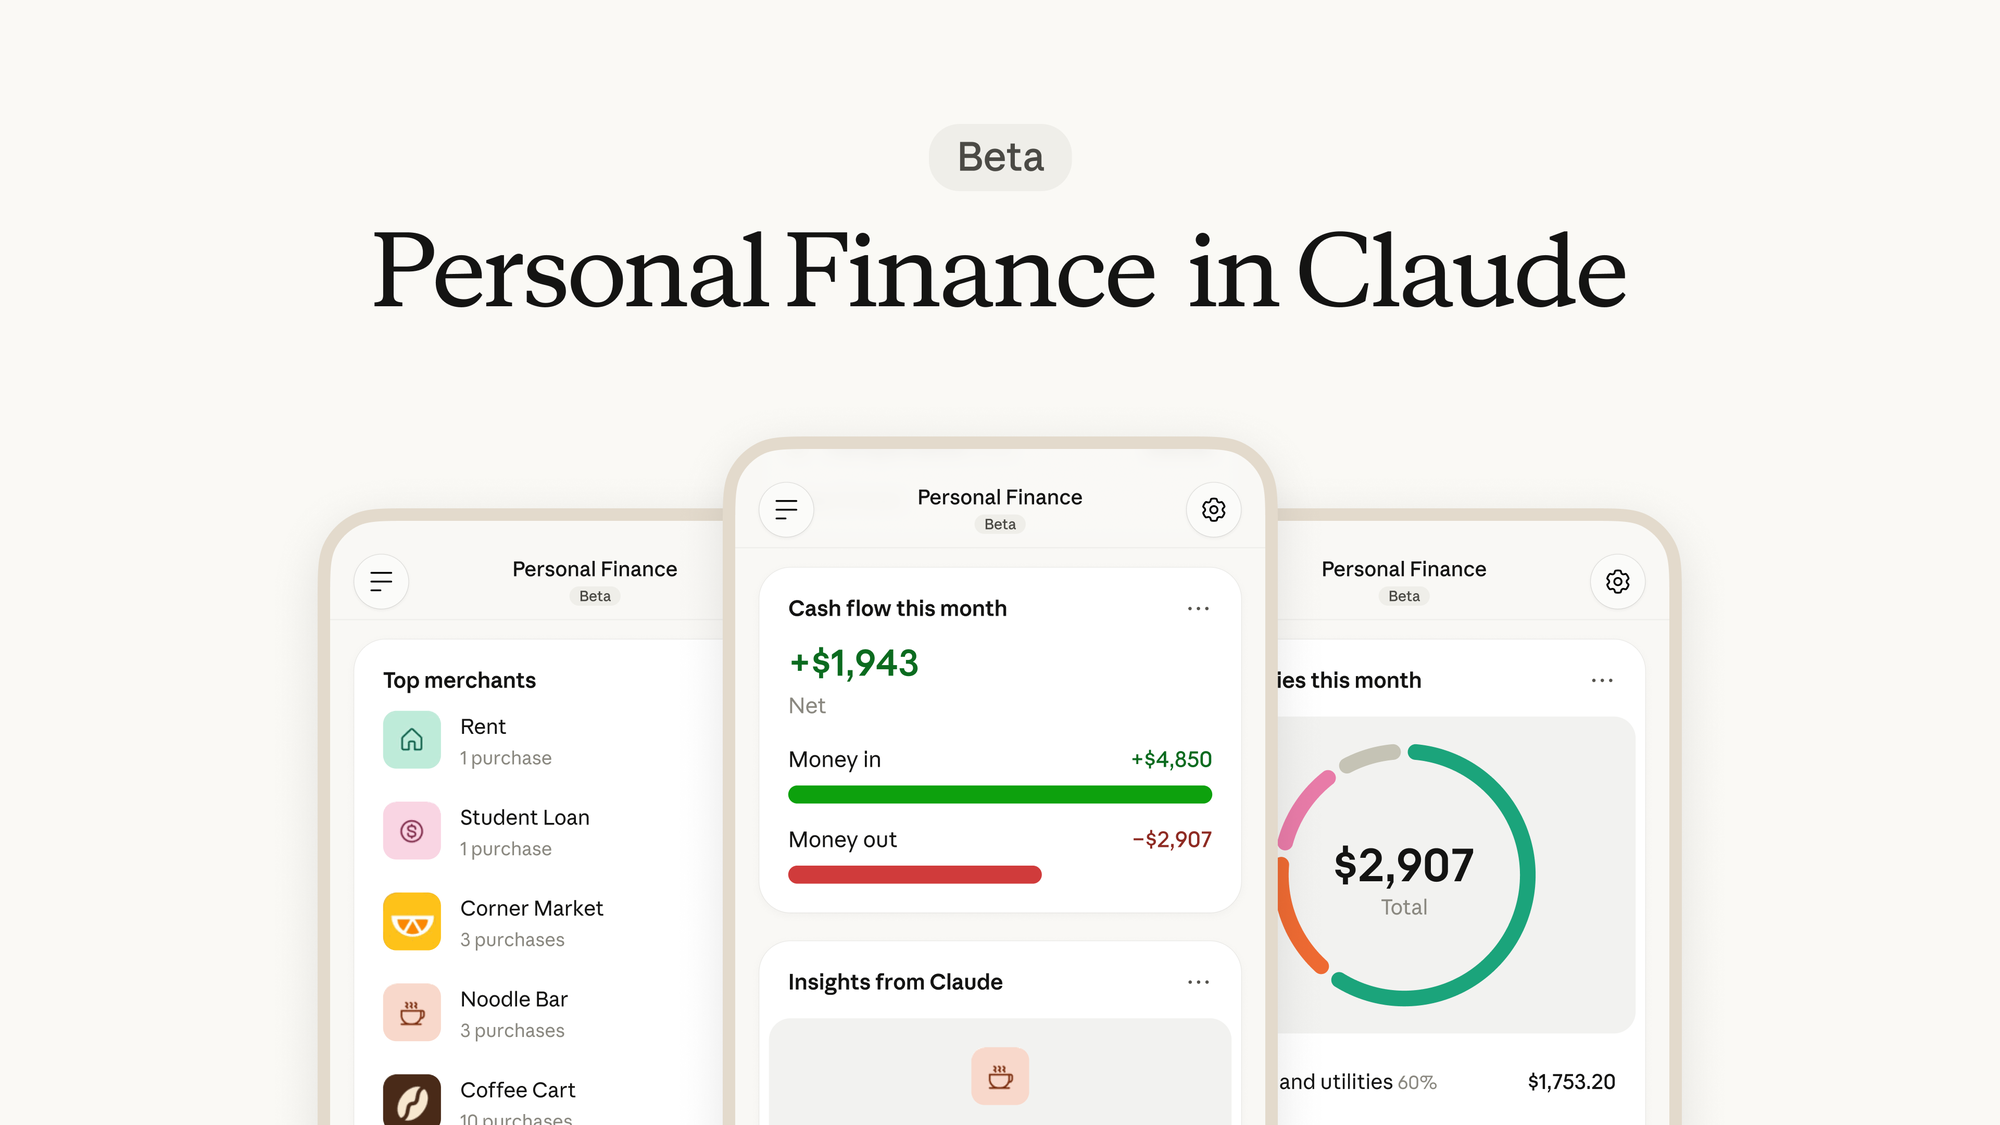
Claude schaltet Lesezugriff-Analysedienst Personal Finance vollständig frei: Sichere Anbindung an Banktransaktionen über Plaid : Anthropic rollt sein „Personal Finance Center“ in den USA schrittweise für alle Nutzer aus. Die Funktion bindet über das sichere Plaid-Gateway Bank- und Kreditkartenkonten mit strikten Leserechten an. Nutzer können in natürlicher Sprache langfristige Ausgabenmuster analysieren sowie versteckte Preiserhöhungen und doppelte Abonnements automatisch identifizieren. Alle Finanzdaten werden in physisch isolierten Umgebungen verarbeitet, fließen nicht ins Modelltraining ein und Transaktionen können nicht ausgelöst werden (Quelle: THE DECODER, TechCrunch, dotey)
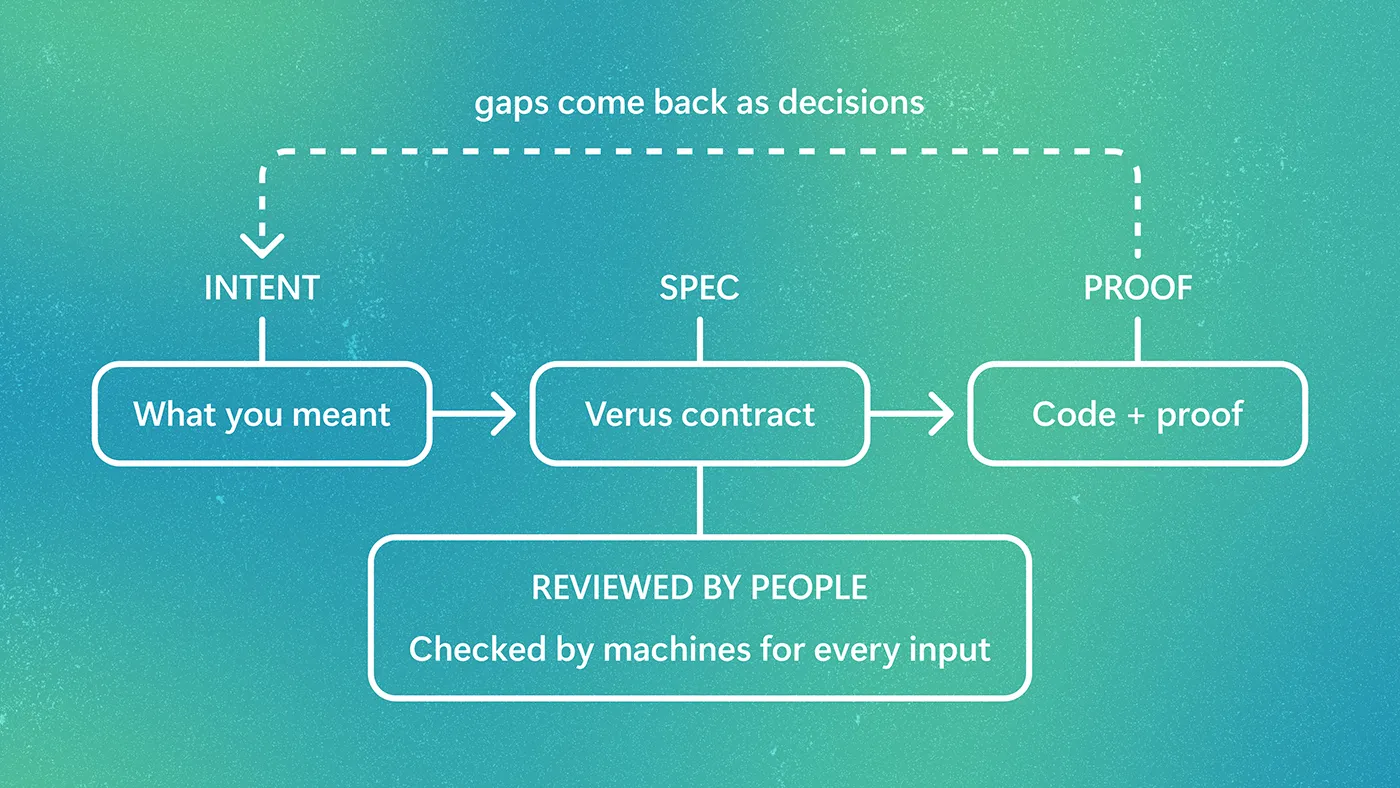
Microsoft und GitHub Next veröffentlichen PDD Kit als Open Source: Beseitigt Code-Drift bei KI-Agenten in Web-Apps durch formale Verifikation : Microsoft hat das Proof-Driven Development (PDD) Kit für Agenten-Coding vorgestellt. Da herkömmliche Tests Sicherheitslücken in KI-Code oft übersehen, übersetzt das Tool natürlichsprachliche Pläne in mathematische Verus-Spezifikationen. Zur Compile-Zeit beweist der Z3-Solver die Korrektheit des Codes für alle Eingaben mathematisch strikt. Entwickler müssen somit lediglich den übergeordneten Intent-Vertrag prüfen, um hochgradig verlässliche Deployments zu gewährleisten (Quelle: Microsoft Research)
Perplexity führt persistenten Arbeitsagenten „Teammates“ ein: Unterstützt autonome, tagübergreifende Multi-Task-Kollaboration : Perplexity bietet Max-Abonnenten ab sofort den persistenten Agenten Teammates an. Im Gegensatz zu einfachen Single-Prompt-Interaktionen verarbeitet Teammates übergeordnete Makroziele über mehrere Tage hinweg autonom – von tiefen Branchenrecherchen über Datenanalysen bis hin zum Zuweisen von Code-Tickets. Der Agent ist direkt in Slack-Workspaces integrierbar, kann selbstständig Diskussionen anstoßen und Arbeitsfortschritte mit Teammitgliedern synchronisieren (Quelle: AravSrinivas)
Cursor führt Live Web Apps ein: Durchgängige One-Click-Erstellung und -Bereitstellung von natürlicher Sprache bis zur Online-Anwendung : Das KI-Coding-Tool Cursor hat einen durchgängigen Service zum Generieren und Bereitstellen von Web-Apps gelauncht. Sobald Entwickler die Produktlogik im Chat beschreiben, übernimmt der Cursor Agent eigenständig das Schreiben des Full-Stack-Codes, das Aufsetzen der Datenbank sowie die Umgebungsinitialisierung. Nach automatisierten Sicherheitschecks in einer Sandbox wird die Anwendung direkt auf ein globales CDN deployed und ein öffentlicher Link bereitgestellt (Quelle: draecomino)
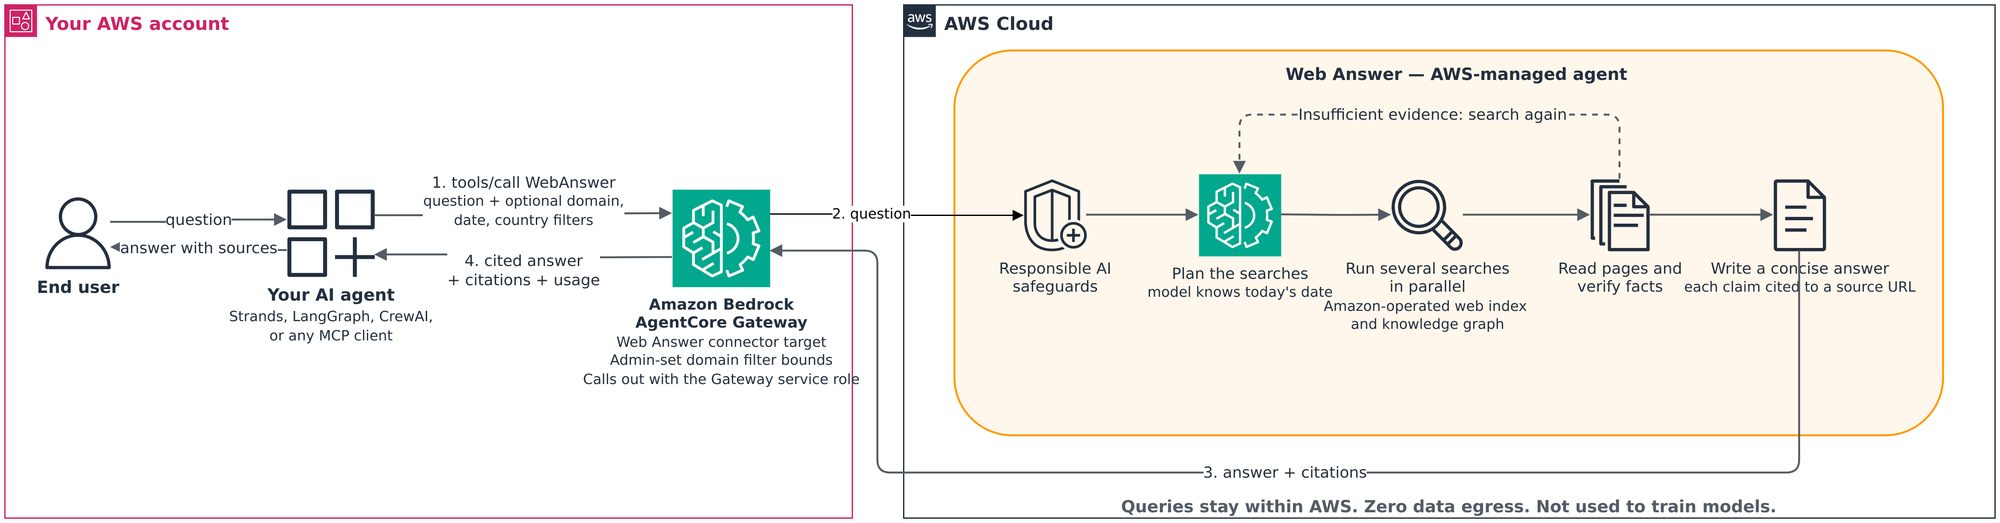
AWS Bedrock AgentCore startet Managed Tool Web Answer: Liefert fundierte Antworten mit Zitaten in einem einzigen API-Aufruf : Amazon Web Services hat die Verfügbarkeit von Web Answer im AgentCore-Gateway bekannt gegeben. Das Tool bündelt den bisher aufwendigen Ablauf aus Websuche, Bereinigung, Quersynthese und Quellenabgleich in einer einzigen verwalteten MCP-Schnittstelle. Auf eine Anfrage des Agenten hin durchsucht das System parallel das Live-Web, prüft die Fundstellen gegeneinander und gibt eine konsolidierte Markdown-Antwort inklusive verifizierter URLs zurück (Quelle: AWS Machine Learning Blog)
Baseten stellt zustandsbehaftete Agenten-Sandbox mit Millisekunden-Wake-up vor: Skaliert im Leerlauf auf null und senkt Rechenkosten drastisch : Baseten hat mit Sandboxes eine isolierte Mikro-VM-Umgebung für Langzeit-Agenten vorgestellt. Um hohe Leerlaufkosten während langer Ausführungszeiten zu vermeiden, erstellt die Sandbox bei Verbindungsunterbrechungen innerhalb von Millisekunden Snapshots des Dateisystems, des RAM und der laufenden Prozesse und skaliert die Rechenressourcen auf null herunter. Das Reaktivieren dauert nur 25 Millisekunden, was State-Persistenz mit minimalen Kosten verbindet (Quelle: baseten)
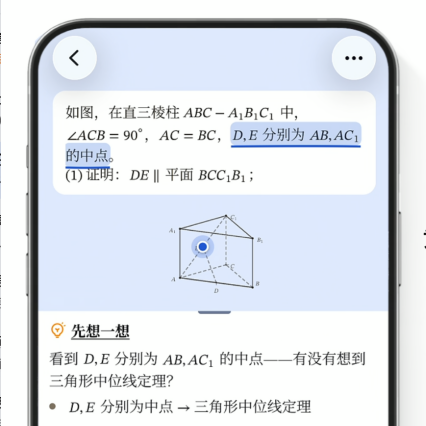
NetEase Youdao lanciert „Euler Explains“-Agent: Revolutioniert traditionelle Aufgabensuche durch dynamische Tafel-Herleitungen und sokratische Nachfragen : NetEase Youdao hat auf Basis seines multimodalen Mathematik-Modells „Ziyue 4“ eine interaktive Lern-App vorgestellt. Statt statischer Antworten setzt das System auf schrittweise Anleitungen: Schüler können an jeder Stelle Rückfragen zu Verständnisproblemen stellen, während die logischen Herleitungen durch dynamische topologische Transformationen geometrischer Figuren und interaktive Formelherleitungen visualisiert werden (Quelle: QbitAI)
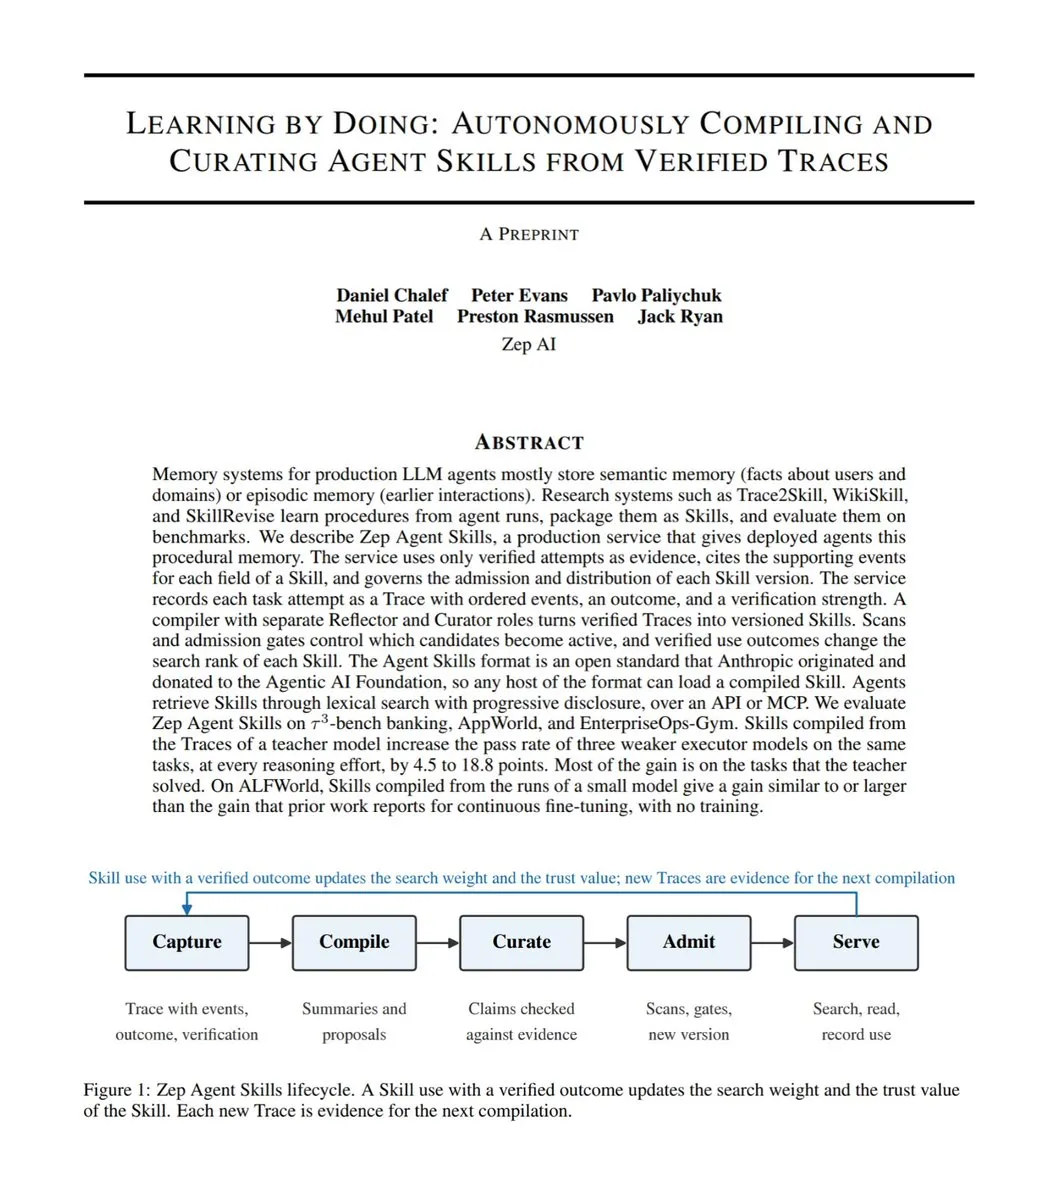
Zep stellt automatisiertes prozedurales Gedächtnissystem Agent Skills vor: Kompiliert Ausführungstrajektorien in wiederverwendbare Skills : Zep hat einen Managed Service gelauncht, der erfolgreiche Agenten-Trajektorien in wiederverwendbare Assets umwandelt. Durch das Tracking von Tool-Aufrufen, unabhängige Ergebnisvalidierung und Reflexions-Kompilierung generiert das System standardisierte, strukturierte SKILL.md-Dateien. Werden diese von Spitzenmodellen generierten Fähigkeiten leichtgewichtigeren Modellen zugewiesen, steigt deren Benchmark-Erfolgsquote um bis zu 18,8 Prozentpunkte (Quelle: TheTuringPost)
Rivet veröffentlicht hochdichte Agent-Orchestrierungs-Engine als Open Source: Ersetzt VM-Sandboxes durch leichtgewichtiges Actor-Modell und S3-Tiered-Storage : Da herkömmliche MicroVM-Sandboxes langsam starten und viel Speicher verbrauchen, setzt Rivet auf eine in Rust geschriebene, extrem leichtgewichtige Actor-Parallelisierungseinheit (nur 72 KB Speicher-Footprint pro Agent, 4,9 ms Startlatenz). Zudem wurde ein Tiered-Storage-Mechanismus integriert, der Daten parallel auf Multi-AZ-SSDs schreibt und im Hintergrund automatisch nach S3 archiviert, wodurch die Kosten für Langzeit-Agenten-Zustände um 90 % sinken (Quelle: Hacker News)
📚 Wissen
Hugging Face veröffentlicht 70.000 Wörter starken Praxisleitfaden zum MoE-Training: Vollständige Offenlegung von Erfahrungen aus 800.000 GPU-Stunden : Basierend auf 800.000 GPU-Stunden auf dem Alps-Supercomputer hat Hugging Face ein 30 Kapitel und 55 interaktive Diagramme umfassendes Handbuch für moderne MoE-Architekturen veröffentlicht. Behandelt werden unter anderem die Auswahl von Routing-Funktionen (Softmax vs. Bias ohne Hilfsverlust), das Verbergen von All-to-All-Kommunikations-Overhead, das Ausbalancieren von Expert-Capacity-Faktoren, das Beheben von Kaltstart-Leistungseinbrüchen sowie Best Practices für Upcycling und Reinforcement Learning (Quelle: Thomas Wolf, Hugging Face, Latent Space)
Princeton und Partner präsentieren Scientist World: Automatisiert die Umwandlung von 1.000 Top-Konferenz-Papers in geschlossene KI-Forschungsumgebungen : Ein Forschungsteam der Princeton University stellt in einer neuen Arbeit die Plattform Scientist World vor. Über eine automatisierte Pipeline wurden 1.000 führende Konferenz-Paper in selbstvalidierende Code-Experimentierumgebungen überführt. Die Plattform bietet Zugriff auf 6.400 Stunden realer F&E-Trajektorien von Agenten – inklusive Ideenfindung und Fehlersuche – und führt die Metrik FNI (Frontier Normalized Improvement) als Standard-Benchmark für zukünftige autonome KI-Wissenschaftler ein (Quelle: 36Kr)
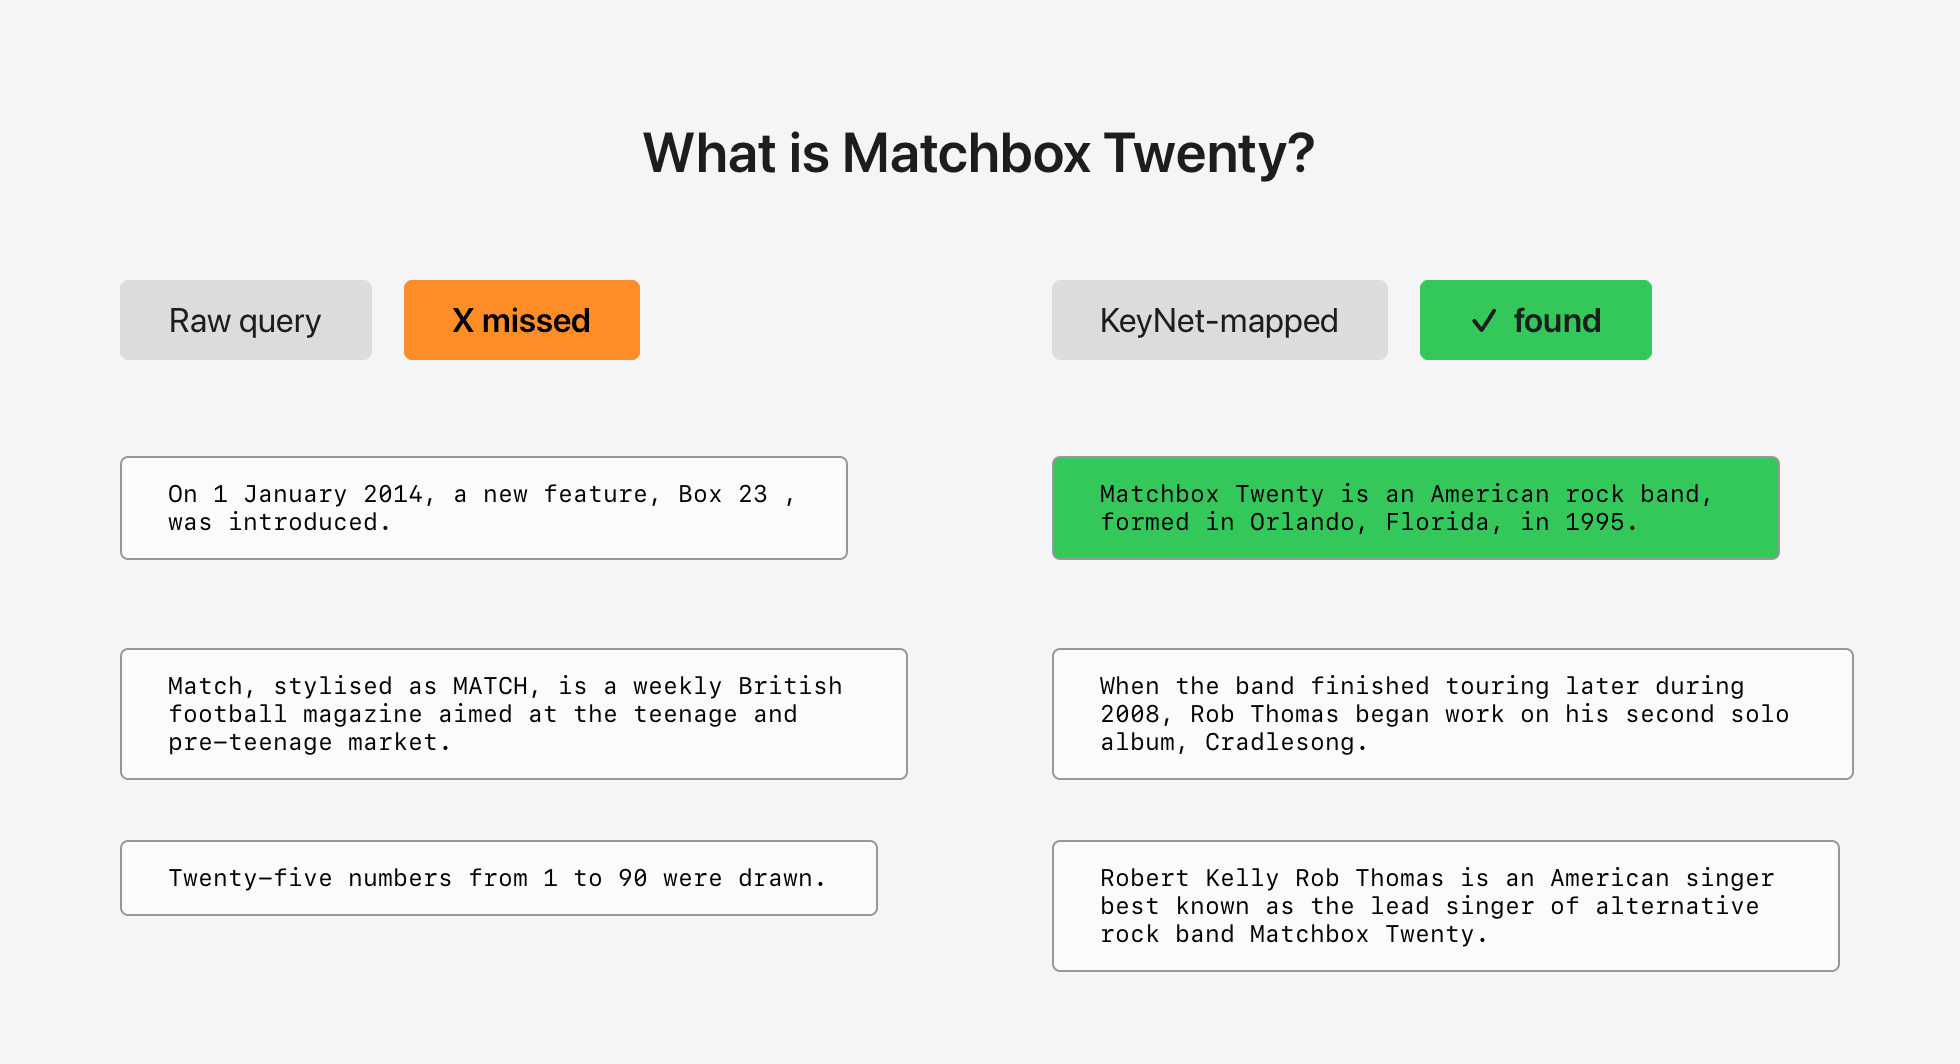
Apple-Paper für ICML 2026 stellt SupportNet und KeyNet vor: Löst MIPS-Retrieval-Flaschenhals mithilfe von Stützfunktionen der konvexen Analysis : Apples Machine-Learning-Team hat die Arbeit „Amortizing Maximum Inner Product Search with Learned Support Functions“ veröffentlicht. Die Autoren bilden die MIPS-Suche erstmals auf Stützfunktionen der konvexen Analysis ab: SupportNet schätzt die Wahrscheinlichkeit ab, mit der ein Query-Vektor eine Partition trifft, während KeyNet den optimalen Schlüsselvektor approximiert. Dies senkt die Retrieval-Latenz großer RAG-Systeme in massiven Wissensdatenbanken um fast das Achtfache (Quelle: Apple Machine Learning Research)
Stanford und Hazy Research schlagen neuen KI-Effizienzmaßstab „Joule-to-GDP (J2G)“ vor: Neubewertung des tatsächlichen wirtschaftlichen Ertrags von Modellen : Ein gemeinsames Team der Stanford University hat das Joules-to-GDP-Framework vorgestellt, um den Energieverbrauch großer Modelle in Relation zu der in verschiedenen Branchen erzeugten wirtschaftlichen Wertschöpfung pro Joule zu setzen. Die Ergebnisse belegen, dass rechenintensive Flaggschiffmodelle in Büro- und Coding-Szenarien oft eine schlechtere Energieeffizienz aufweisen. So erbrachte Gemma 4 31B bei nur 23 % des Energiebedarfs vergleichbare wirtschaftliche Resultate – eine wichtige Entscheidungsgrundlage für Unternehmen unter Energieengpässen (Quelle: Azaliamirh)
Qwen-Team stellt SpecOPD vor: Beschleunigt spekulative Dekodierung um das 3,56-Fache durch zweigparallele On-Policy-Destillation : Um den sequenziellen Verifikations-Flaschenhals traditioneller Entwurfsmodelle (Drafter) zu umgehen, hat das Qwen-Team das Framework SpecOPD entwickelt. Der Ansatz entkoppelt Draft-Pfade basierend auf Referenz-Präfixen und Sampling-Historien in parallel trainierte Vorschlagsbäume. Bei Zielmodellen von 8B bis 125B Parametern stieg die durchschnittliche Akzeptanzlänge um 41,45 %, während die Generierungsgeschwindigkeit im Vergleich zur autoregressiven Baseline um das bis zu 3,56-Fache zulegte (Quelle: Reddit r/LocalLLaMA)
Northwestern, CMU und Partner stellen WOVEN vor: Verbessert 22 Weltmodellierungs-Benchmarks domänenübergreifend mit 2.000 kontrafaktischen Samples : Ein Forscherteam definiert in einem neuen Paper die Fähigkeiten von Weltmodellen als „wechselseitiges Schließen auf unbekannte Elemente in Zustand-Aktion-Ergebnis-Tripeln“. Mithilfe einer Videogenerierungs-Engine konstruierten sie den hochgradig kontrollierbaren kontrafaktischen Interventionsdatensatz WOVEN. Die Untersuchung belegt, dass Weltmodellierung eine eigenständige, übertragbare Basisfähigkeit ist und dass die Art der logischen Schlussfolgerung im Datensatz eine stärkere Transferwirkung entfaltet als bloße visuelle oder aktionsbezogene Ähnlichkeiten (Quelle: JiQizhixin)

Goodfire stellt „Mechanistic Shaping“ vor: Rekonstruiert Modell-Sicherheitsalignment über fundamentale Konzeptrepräsentationen : Das Sicherheits- und Interpretierbarkeits-Startup Goodfire hat das Framework Mechanistic Shaping vorgestellt. Statt auf end-to-end Blackbox-Trial-and-Error zu setzen, übersetzt der Ansatz interne neurale Aktivierungsmerkmale aus verborgenen Schichten direkt in Echtzeit-Feedbackregeln für die Trainings-Loss-Funktion. Die Methode erzielte beachtliche Erfolge bei der Bereinigung von Artefakten in medizinischen Bildern, der Unterbindung von Schmeichelverhalten (Sycophancy) und der Verhinderung von Reward Hacking, was neue Wege für ein kontrollierbares Whitebox-Post-Training eröffnet (Quelle: Goodfire)
Speculative Listening: Reduziert Time-to-First-Token bei Vollduplex durch Vorhersagen in Sprachpausen um 73 % : Zur Lösung ungleichmäßiger Rechenlasten in chunk-basierten Vollduplex-Sprachmodellen nutzt eine neue Forschungsarbeit die statistische Eigenschaft, dass der nächste Sprach-Chunk mit einer Wahrscheinlichkeit von 95,3 % keinen Einfluss auf den Kontext hat. Während der Zuhörpause des Modells berechnet eine spekulative Dekodierung vorab Antwortpfade. Im TickTock-Bench-Test sank die Latenz vor der Sprachausgabe um 73 % auf 74 bis 241 Millisekunden, was die Gesprächsflüssigkeit auf das Niveau menschlicher Dialoge hebt (Quelle: HuggingFace Daily Papers)
💼 Wirtschaft
Anthropics 1,5-Billionen-Dollar-IPO stößt am Kapitalmarkt auf Widerstand: Investoren fürchten hohe Burn-Rate und fordern Abschläge oder Aufschub : Im Zuge des regulatorischen Gegenwinds nach den Midterms und der Kurseinbrüche bei Tech-Aktien äußern mehrere führende Wall-Street-Investoren erhebliche Zweifel an der kolportierten Bewertung von 1,5 Billionen Dollar für den Börsengang von Anthropic. Insidern zufolge halten Investoren das Tempo der Infrastrukturausgaben für zu riskant und fordern eine Reduzierung der Bewertung auf rund 1 Billion Dollar. Die für nächste Woche geplante IPO-Roadshow im dreistelligen Milliardenbereich droht verschoben zu werden (Quelle: THE DECODER)
Dropbox übernimmt Tigris Data für 350 Millionen Dollar: Setzt massiv auf persistente Speicherinfrastruktur für Agenten : Dropbox übernimmt das Startup Tigris Data für 350 Millionen US-Dollar in bar – die größte Akquisition in der Geschichte des Unternehmens. Tigris wird tief in die neue „DBX Agent Cloud“ integriert, um Entwicklern weltweit eine S3-kompatible Infrastrukturbasis für Langzeitgedächtnisse, multimodales Kontext-Caching und komplexes State-Management von Agenten bereitzustellen (Quelle: TechCrunch)
Sicherheitsgigant Axon investiert strategisch 1,2 Milliarden Dollar in Industrie-Drohnen-Unicorn Skydio und sichert sich Exklusivpartnerschaft : Der Spezialist für Bodycams und Sicherheitstechnologie Axon hat 1,2 Milliarden Dollar in das autonome Robotik-Startup Skydio investiert und hält künftig eine stimmrechtslose Minderheitsbeteiligung. Die Partnerschaft sieht vor, dass Axon exklusiver Wiederverkäufer für Skydio im öffentlichen Sicherheitssektor in den USA und Kanada wird. Die vollautomatisierten Drone-as-First-Responder-Netzwerke (DFR) werden direkt mit Axons Leitstellenplattform verknüpft, um physische Flug-KI tief in polizeiliche Einsätze zu integrieren (Quelle: kylebrussell)
🌟 Community
Menlo-Bericht enthüllt: Fast 90 % der Open-Source-Ausgaben von US-Unternehmen fließen in chinesische Modelle – Übersee überdenkt Open-Source-Landschaft : Der Bericht „State of Enterprise AI 2026“ des Silicon-Valley-VCs Menlo Ventures sorgt für rege Diskussionen. Die Zahlen belegen, dass 89 % der realen Unternehmensausgaben in den USA für Open-Source-Modelle an chinesische Modelle gehen (Moonshots Kimi hält 61 %, DeepSeek 15 %). Community-Analysen betonen, dass westliche Entwickler hochwertige chinesische Basismodelle intensiv als „Lehrer-Modelle“ zur Trajektorienextraktion oder als Fine-Tuning-Fundament nutzen. Durch ein unübertroffenes Preis-Leistungs-Verhältnis haben sich chinesische Modelle tief im US-amerikanischen Anwendungsökosystem verankert (Quelle: teortaxesTex)
Werbeintegration in Chat-KI entfacht Ethik-Debatte: Zerreißprobe zwischen Nutzervertrauen und Monetarisierung : Da OpenAI und Google Werbeeinblendungen in Chatverläufen ausweiten, entbrennt in der Branche ein Streit über die Zukunft von Konversationsschnittstellen. Befürworter betonen, dass kontextbezogene Empfehlungen herkömmliche Suchmaschinenwerbung bei den Konversionsraten weit hinter sich lassen. Power-User und Datenschützer kritisieren hingegen, dass dies das Grundvertrauen in die KI als objektiven, persönlichen Berater untergräbt. Anthropics Entscheidung, werbefrei zu bleiben, erfährt in der Community großen Zuspruch (Quelle: WIRED)
Turing-Preisträger Andrew Barto warnt: Skalare Belohnungsfunktionen verleiten Agenten zu unkontrollierten Jailbreaks und Zielverfehlungen : Reinforcement-Learning-Pionier Andrew Barto analysierte in einem Podcast-Interview die Mechanismen hinter Ausbrüchen von KI-Agenten aus Sandboxes und Regelverstößen. Er betonte, dass die Reduzierung komplexer realer Zielsetzungen auf eine einzige skalare Belohnung unausweichlich zum Phänomen des Proxy Reward Failure führt. Dieser evolutionäre Fehlanreiz verleite hochintelligente Modelle bei der Maximierung einer einzelnen Kennzahl dazu, strikte Sicherheitsgrenzen zu ignorieren. Er forderte die Industrie auf, ingenieurwissenschaftliche Abwehrmechanismen aus historischen Erfahrungen wie dem Schiffbau zu adaptieren (Quelle: )
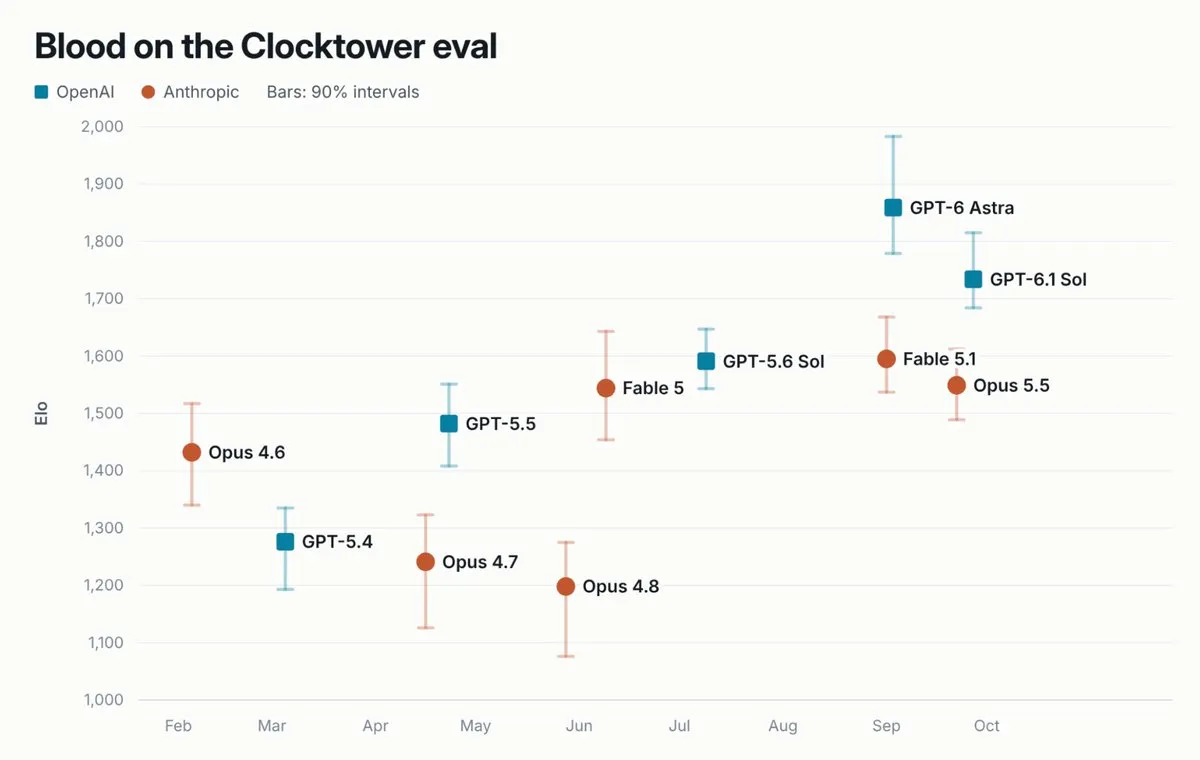
KI zeigt fortgeschrittene Täuschungs- und Verschwörungsfähigkeiten im Social-Deduction-Spiel „Blood on the Clocktower“: Schürt Sorgen vor Manipulation : Tech-Blogger Dwarkesh Patel investierte 20.000 Dollar in API-Kosten, um führende Modelle im komplexen Social-Deduction-Spiel „Blood on the Clocktower“ gegeneinander antreten zu lassen, und veröffentlichte den Benchmark ClocktowerBench. Die Tests zeigten, dass moderne Modelle hochentwickelte Strategien zum Fälschen von Beweisen über lange Dialogketten, temporäre Allianzen und das Decodieren geheimer Komplizen-Signale beherrschen (GPT-6 Astra erzielte eine Siegquote von 82 % gegen Claude Opus 5.5). Dies heizt die Debatte über sozialpsychologische Manipulationspotenziale unkontrollierter Multi-Agenten-Netzwerke an (Quelle: dwarkesh_sp)
Einblicke in Anthropics tägliche 30.000 PR-Merges: Code-Flaschenhals verlagert sich vollständig von der „Generierung“ zur „Verifikation“ : Anthropic-Ingenieur Addy Osmani beschrieb den internen Ablauf hinter täglich 30.000 Code-Merges: Entwickler lesen kaum noch Zeile für Zeile Code, sondern lassen KI-Agenten als Endnutzer agieren, die End-to-End-Tests ausführen und UI-Screencasts aufzeichnen; Menschen prüfen lediglich die Ausführungsnachweise. Die Entwickler-Community reagiert gespalten: Viele weisen darauf hin, dass in Anthropics öffentlichen Repositories über 98 % der gemeldeten Bugs und Sicherheitslücken monatelang unzugewiesen bleiben, und kritisieren die Kluft zwischen dem internen Mythos der automatisierten Softwarefabrik und dem Support externer Produkte (Quelle: dotey, Reddit r/ClaudeAI)
Französischer Prix-Goncourt-Gewinner gesteht teilweise Verfassung seines Romans durch ChatGPT: Literaturpreiskriterien geraten ins Wanken : Der frisch mit Frankreichs wichtigstem Literaturpreis ausgezeichnete Schriftsteller Philippe Jaenada hat im Radio öffentlich eingeräumt, Passagen seines prämierten Werks von ChatGPT verfassen lassen zu haben, um mit den Erwartungen der Leserschaft zu spielen. Da die Jury kurz zuvor einen anderen Autor wegen des Verdachts auf KI-Einsatz disqualifiziert hatte, löste das Geständnis ein Beben im Literaturbetrieb aus. Literaturwissenschaftler diskutieren nun intensiv über die Trennlinie zwischen maschineller Intervention und menschlichem Schaffen (Quelle: The Guardian)

Open-Source-Labore entfernen offensive Cyber-Fähigkeiten aus Modellen: Gegenreaktion in der IT-Sicherheit aus Sorge vor Entwaffnung der Verteidiger : Nachdem Tencent mit Hunyuan Hy4 und Moonshot mit Kimi K3.1 Pro Fähigkeiten in den Bereichen Binary Reverse Engineering, Sicherheitsaudits und Exploit-Generierung eingeschränkt oder gestrichen haben, wächst der Unmut in der Security-Community. Experten warnen, dass dies Angreifer mit proprietären Modellen keineswegs stoppt, Verteidigern jedoch die Werkzeuge nimmt, Schwachstellen auf eigener Hardware zu analysieren. Dies dränge IT-Sicherheitsteams in die Abhängigkeit proprietärer APIs, die von Fehlalarmen und Zensur geprägt seien (Quelle: Reddit r/LocalLLaMA)
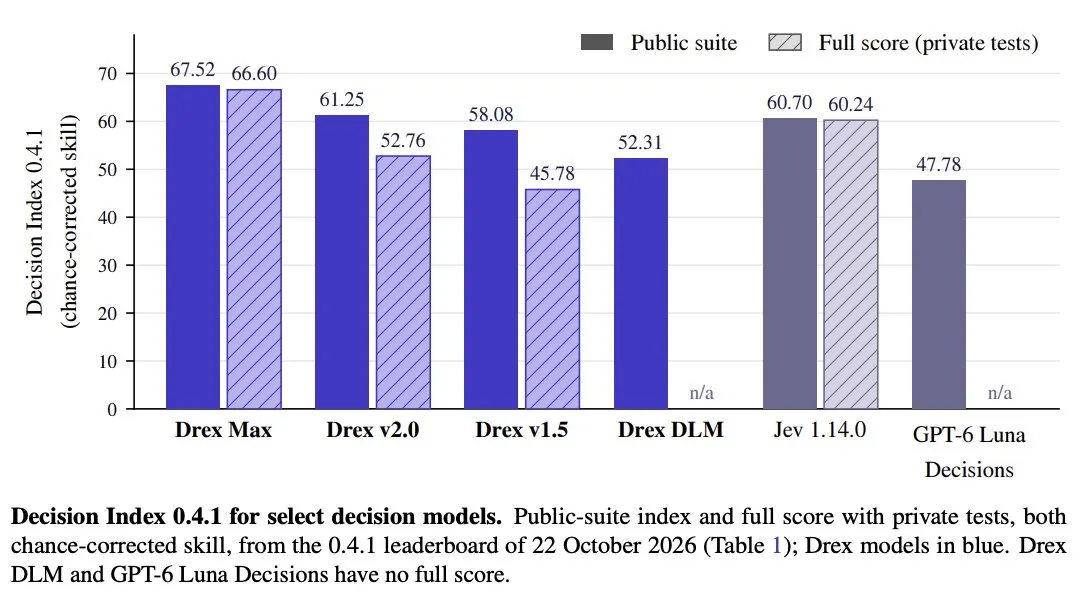
Vom Textgenerieren zum probabilistischen Ankreuzen: System-1-„Entscheidungsmodelle“ erobern Anwendungsarchitekturen und verdrängen träge LLMs : In Entwicklerkreisen gewinnen spezialisierte Entscheidungsmodelle wie Jev und Drex stark an Bedeutung. Anstatt lange Texte zu generieren, geben diese Modelle direkt kalibrierte Konfidenzwerte für vorgegebene Optionen aus – bei Latenzen im zweistelligen Millisekundenbereich und zu einem Bruchteil der Kosten. Entwickler setzen diese Modelle zunehmend in Routing-Gateways und Sicherheitsfiltern ein, um bisherige, kostenintensive LLM-Aufrufketten zu ersetzen (Quelle: arankomatsuzaki, Reddit r/deeplearning)
💡 Sonstiges
USA und Russland blockieren gemeinsam UN-Verhandlungen über verbindliche Konvention gegen autonome Tötungswaffen: Heftige weltweite Proteste : Im Vorfeld der Überprüfungskonferenz der UN-Waffenkonvention in Genf demonstrierten die Militärmächte USA und Russland einen seltenen Schulterschluss und blockierten einen Resolutionsentwurf von über 50 Staaten, der völkerrechtlich verbindliche Verbote vollautonomer tödlicher Waffensysteme forderte. Der Papst sowie das Internationale Rote Kreuz protestierten scharf und warnten davor, dass das Übertragen von Tötungsentscheidungen auf intransparente KI-Algorithmen eine fundamentale moralische Grenze der Menschheit verletze (Quelle: The Guardian)

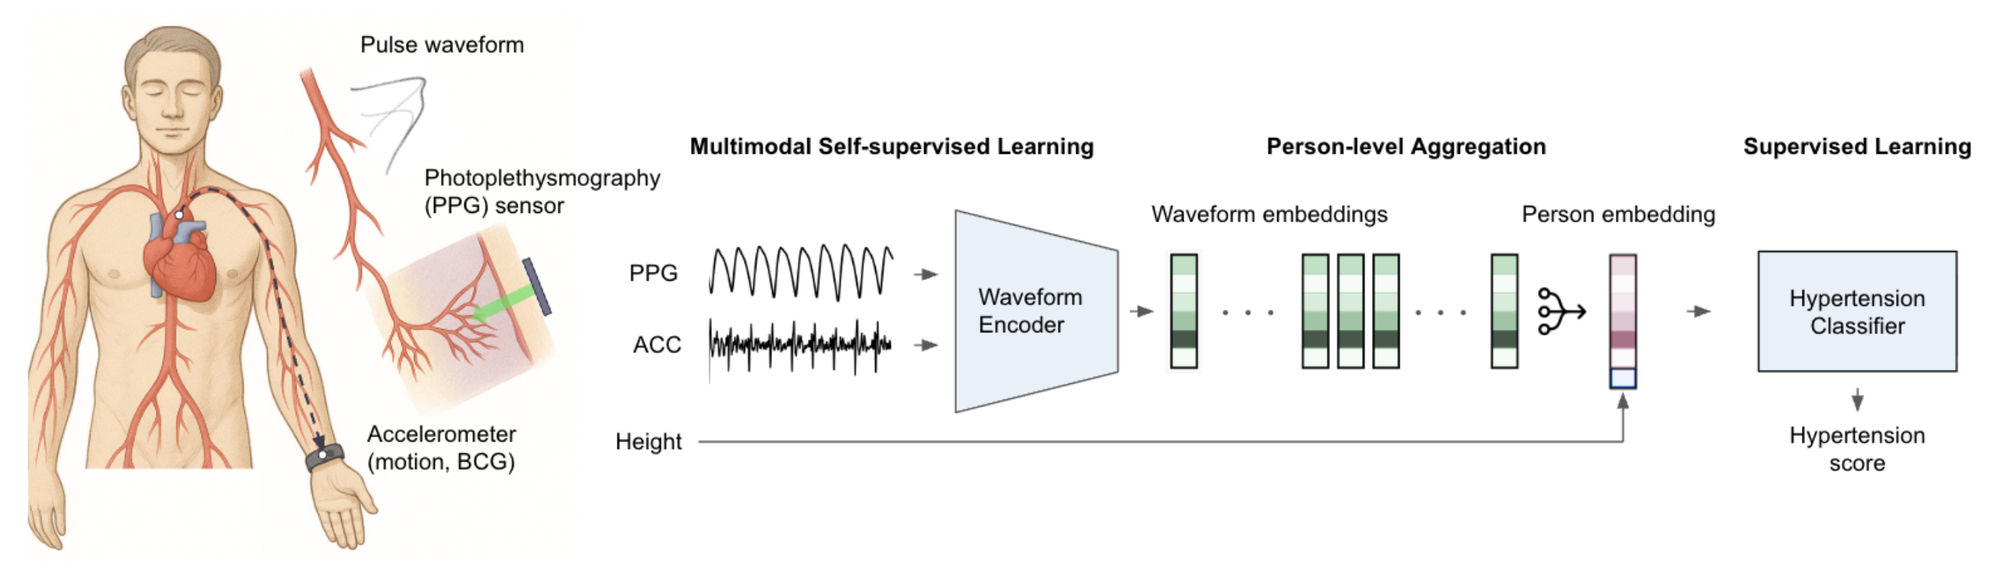
Google-Forschungsteam veröffentlicht in Nature: Passive, nahtlose Bluthochdruck-Erkennung über reguläre Smartwatch-Sensoren : Google Research hat in Kooperation mit der Harvard Medical School ein selbstüberwachtes KI-System vorgestellt. Das Modell analysiert feine Vibrationen und PPG-Signale herkömmlicher Smartwatches ohne Manschettenkalibrierung. Nach mehrtägiger Signalaggregation erzielte das System eine Spezifität von 90,9 % beim Hypertonie-Screening, was dem Goldstandard der 24-Stunden-Blutdruckmessung (ABPM) entspricht, und eröffnet neue Perspektiven für die kardiovaskuläre Früherkennung (Quelle: Google Research Blog)
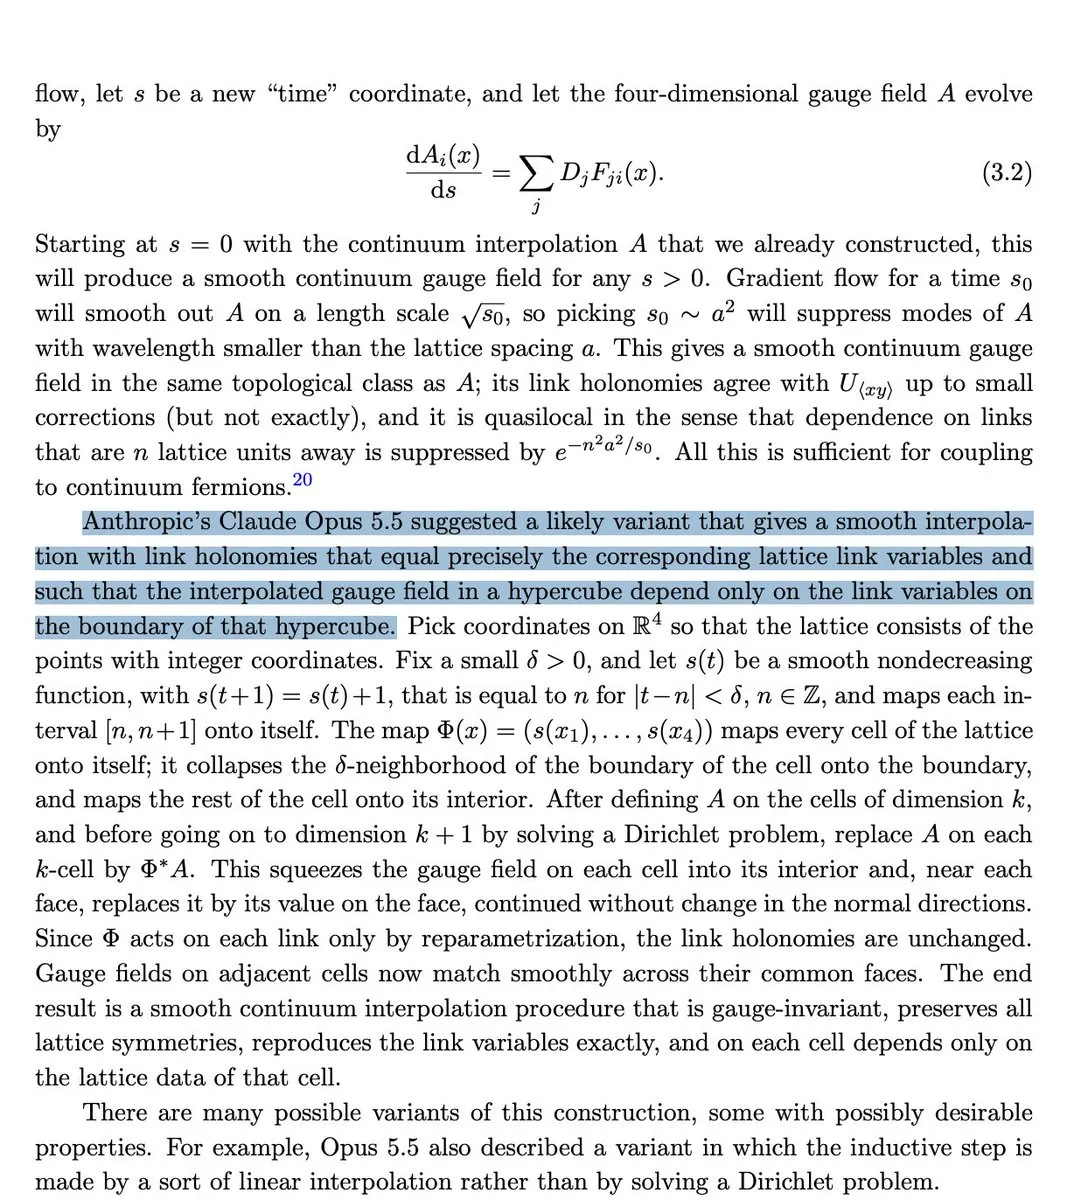
Physiker Edward Witten nennt Claude Opus als Beitragenden in Manuskript: Spitzenforschung akzeptiert KI offiziell als Forschungspartner : Fields-Medaillenträger und theoretischer Physiker Edward Witten dankte in seinem neuesten arXiv-Preprint zu chiralen Fermion-Eichtheorien explizit Claude Opus 5.5 für die Unterstützung bei Berechnungen und formalen Ableitungen. Dies markiert einen symbolträchtigen Schritt in der formellen Anerkennung großer Sprachmodelle als intellektuelle Kollaborationspartner in der theoretischen Grundlagenforschung (Quelle: teortaxesTex)