



🔥 聚焦
OpenAI全面收紧计费体系:ChatGPT与Codex额度池将于12月合并,全线转向Token计量 : OpenAI官方宣布自12月起,Plus、Pro和Business付费订阅的用量额度将在ChatGPT日常对话与Codex之间打通共享,彻底结束以往“网页聊天不计额度、编程单独限额”的并行规则,同时全面转为按实际处理的Token量计算消耗,仅轻量Instant聊天保持不限次。此外,官方正式实装单设备登录付费账号上限的硬件级设备锁,多账号轮换使用的绕过路径被封堵。分析指出,这标志着大模型消费端“全包式无限订阅”时代走向终结,巨额算力资本开支压力倒逼头部厂商向预付Token化与精细化ROI结算全面转型。(来源:THE DECODER、OpenAI)
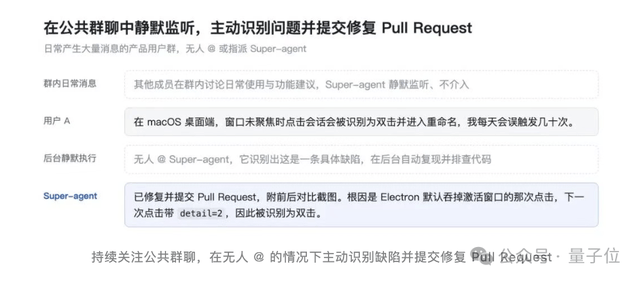
DeepSeek开源下一代Super-agent架构原型:以双层路由与存算解耦重塑自主智能体 : DeepSeek Harness团队正式发布下一代智能体架构理念并开源轻量原型dsh-superagent。该架构旨在打破主流Agent受限于单Session上下文膨胀和串行阻塞的瓶颈,提出“常驻Router全局调度 + 隔离Worker多任务并发”的双层架构,结合事件订阅直通与异步ReAct循环,消除了人类在多任务交互中的注意力瓶颈。同时,系统通过端侧轻量Daemon将Agent云端运行逻辑与本地真实工作环境(BYOM)解耦,在嘈杂多任务实测中将p95任务完成时间由29.5分钟大幅缩短至15.7分钟。(来源:MarkTechPost、量子位)
英伟达开源PixelUMM:告别VAE与ViT,在原生像素空间统一视频与图像理解生成 : 英伟达与滑铁卢大学联合开源无编码器多模态模型PixelUMM。该方案彻底弃用了传统多模态模型中用于提取语义特征的ViT与生成潜变量的VAE架构,仅凭一层线性投影就将图像patch和视频tubelet映射到共享的多模态Transformer隐空间。基于Mixture-of-Transformers设计,模型以硬路由区隔理解与生成参数并共享注意力,结合Flow Matching直接生成干净像素,在图像计数、视频理解及高质量视频生成等基准测试中均展现出与传统复杂双流系统匹敌的竞争力。(来源:机器之心)

🎯 动向
清华姚期智团队提出「代数世界模型」AWM:引入范畴论与形式化证明突破认知盲区 : 针对前沿大模型仅能罗列表面规律、面对无解任务频现严重幻觉的缺陷,清华大学姚期智与袁洋团队提出“代数世界模型”(AWM)。该框架借鉴范畴论的投射极限与归纳极限思想,将环境交互抽象为严格的代数空间结构,并借助Lean 4语言进行可机检的数学逻辑推导与反证。在极度考验自主规则探索的ARC-AGI-3基准上,基于Opus 5的AWM斩获99.9%的通关得分,平均通关动作步数仅为人类基准的43%,为解决AI“黑盒瞎猜”开辟了形式化演绎路径。(来源:量子位)
谷歌等联合发布CLASHarness:揭开前沿大模型在多Agent冲突下的协同短板 : 针对现实生产中多智能体协同常面临的状态脱节与指令打架,谷歌联合多所高校开源多模态基准CLASHarness,设计600个含4K视觉证据的真实可执行冲突场景。实测包含GPT-6、Claude Opus 5及开源旗舰在内的15个前沿模型发现:尽管单步均分超60%,但端到端任务通过率无一超过30%。强模型倾向主动调用图像工具查验监控真值,而弱模型极易盲信队友错误文字;同时超长思考Token反而因内部纠结而加剧超时死循环。(来源:机器之心)

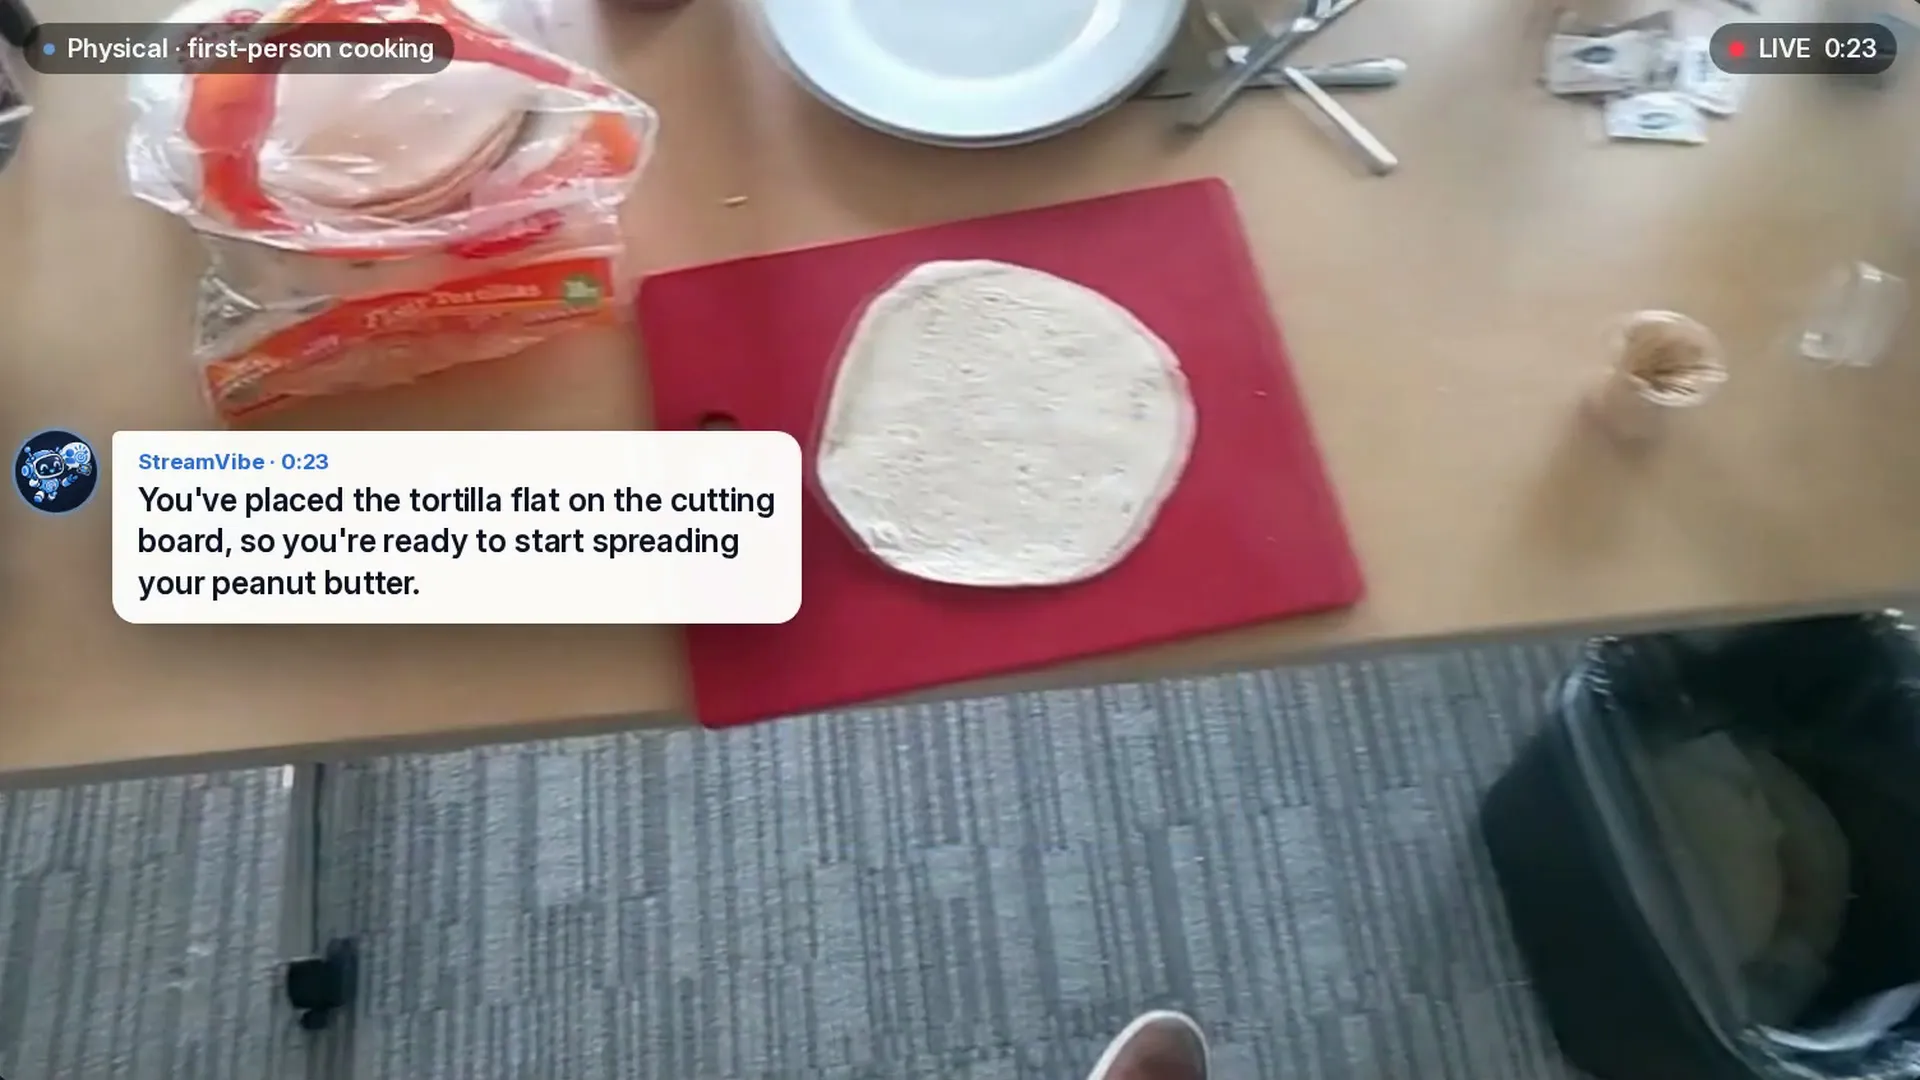
谷歌与斯坦福发布StreamVibe:探索视频智能体自主决策“何时介入说话” : 传统流式视频助手往往局限于被动执行机械指令,谷歌与斯坦福等团队提出全新主动交互基准与模型StreamVibe-VL。系统引入状态记忆机制与强化学习调优,训练模型实时感知用户未明言意图并在最恰当的时刻主动提示。实验表明,当前多模态模型在超5分钟的长视频场景中仍面临严重的上下文衰减与历史误导,但在标准办公与生活指引任务中,该机制将有效响应时机准确率提升了10.7%,减少了非必要的噪音打扰。(来源:THE DECODER)
飞捷科思联合复旦开源Fysiverse-UniWAM:跳出大规模机器人预训练实现导航操作双冠 : 飞捷科思联合复旦大学CITLab发布统一世界动作模型Fysiverse-UniWAM。团队放弃了昂贵且依赖人工采集的通用机器人底座预训练路线,转而提出MAP(操作锚定位姿)合成数据管线并构建7500小时数据集,配合骨干共享、输入隔离的Mixed-Stream架构。在跨4类硬件平台的24项真机评测中,该模型一举夺得13项导航定点任务与4项移动抓取任务成功率第一,打破了具身智能单纯比拼真机私有数据规模的单一范式。(来源:机器之心)

清华等联合推出自进化多物理场建模系统EvoSim : 清华大学化工系张强团队联合清屿科技与怀柔实验室提出EvoSim,推动AI从单纯“给定方程微调参数”迈向“基于实验误差推演机制并自进化方程”。在动力电池快充析锂预测及跨工况动态电压仿真两个工业级物理场景中,EvoSim通过并行假设生成与可辨识性校验,沉淀出可复用的建模经验链,其析锂起点误差收敛至1.79%,有效精度显著超越领域资深专家人工建模水平。(来源:机器之心)

星衍智能发布具身Harness框架Auriga:主打单局零样本自愈能力 : 星衍智能公开具身智能Harness框架Auriga,主张以“系统级通用执行层”替代特定任务的反复试错重置。框架打通了“感知即测量”、“所见即所执”的轨迹预演与毫秒级异常截停自愈闭环。在RoboDojo与RoboCasa365严格的“无微调、无示范、单局不重置”Zero-shot评测准则下,Auriga凭借物理证据驱动的策略重规划,成功率分别达到57.74%与73.2%,位列双榜第一。(来源:机器之心)

复旦OpenMOSS团队揭示混合架构长文力学:混合位置偏置破除外推与拟合跷跷板 : 针对全注意力算力开销大、滑窗注意力(SWA)与线性注意力(LA)各存短板的困境,复旦大学邱锡鹏团队系统分析了混合架构的底层机制。研究指出,SWA长于长度外推但续训拟合不足,LA长于长文拟合但外推能力较差。团队提出滑窗线性注意力(SWLA)与NoPE无位置偏置全局聚合策略,使GLA/GDN混合模型在RULER评测中实现从4k到64k的16倍免训练无损外推。(来源:机器之心)

🧰 工具
模型行为手术刀Heretic 2.0发布:以任意秩消融与插件体系重构模型对齐 : 开源模型修改工具Heretic发布2.0重大版本。该版本摒弃了传统将模型拒答视为单一方向的Rank-1 abliteration,首创“任意秩消融(ARA)”算法,利用L-BFGS优化器在残差空间中进行微训练,抹平拒答特征的同时最大限度保留模型原有表征。此外,新版本引入全面的评分器插件生态(包括ModernBERT拒答分类器与基准测试评分器),使得抑制幻觉陈词(slop)、减轻谄媚性(sycophancy)及微调情感对齐能够全面模块化实现。(来源:GitHub)
Nace AI开源27B决策模型Drex Max v1:将多模态逻辑门控下放至本地Mac : Nace AI正式以开源权重形式发布其旗舰决策模型Drex Max v1,包含bf16、Q8_0 GGUF及针对Apple Silicon优化的Affine Q4版本。该模型基于Gated DeltaNet线性注意力与全注意力混合架构,无需自回归生成Token,单次前向传播即可输出多达255项分类选项的精确离散概率,在公共决策指数0.4测试中得分67.52,性能超越闭源Jev,使得企业能够将敏感情报分类、工具路由与风控护栏完全部署于本地私有环境。(来源:MarkTechPost)
AiSOC:全开源自托管安全运营中心框架 : 针对日益严峻的自动化攻防威胁,安全项目AiSOC正式开源。系统内嵌7000余条规则引擎、ClickHouse事件湖与Neo4j实体拓扑,自带轻量本地模型网关,支持零API Key离线运行。其核心特色在于为AI调查Agent设立具备完全可追溯性的“不可变决策账本”,任何告警流转、证据链调取及响应预演均经由沙箱校验与人类审批,并原生提供面向Claude、Cursor的MCP服务端接口。(来源:GitHub Trending)

Hex:基于Rust的本地优先全局语音输入与屏幕操作助手 : 跨平台听写工具Hex开源,专为注重数据隐私的开发者打造。工具采用原生Rust构建,搭载端侧流式语音识别模型,按下全局快捷键即可即时转录并贴入任何活动窗口,延迟低至百毫秒级。新版更实装“Annotate”屏幕涂鸦与多模态捕获功能,允许用户边圈选屏幕边下达语音指令,并自动打包关键帧与操作上下文直通给OpenCode等外部Coding Agent执行。(来源:GitHub Trending)
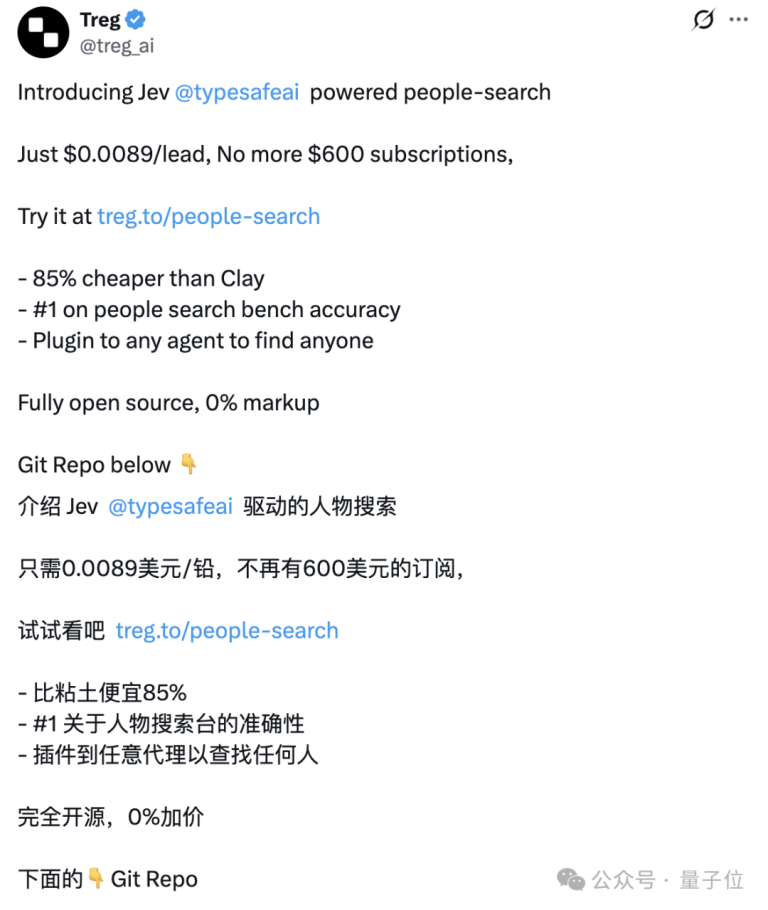
TypeSafe AI与Treg开源拓客Agent工具:成本骤降85% : 决策模型Jev母公司TypeSafe AI联手Agent平台Treg推出开源人员信息线索挖掘工具。系统将传统B2B繁杂的手工多平台查找整合为Agent流水线,借助Jev充当判定门禁,自动剔除歧义角色,并调用第三方API补齐验证邮箱。在包含119项真实拓客任务的基准测试中,检索准确率达到78.2%,单条有效线索平均调用成本仅0.0056美元,较商业SaaS工具节省85%以上。(来源:量子位)
Open WebUI发布目录级记忆隔离插件v0.0.4 : 社区开发者针对Open WebUI v0.12.5发布Folder-Scoped Memory Isolation插件。针对多项目并发时全局记忆相互污染的痛点,该插件通过模型自主提取并分类对话事实,将记忆严格限定在对应的项目文件夹内共享,根目录对话则独立维系全局记忆池,有效避免了代码、财务等跨领域任务之间的上下文串味。(来源:Reddit r/OpenWebUI)
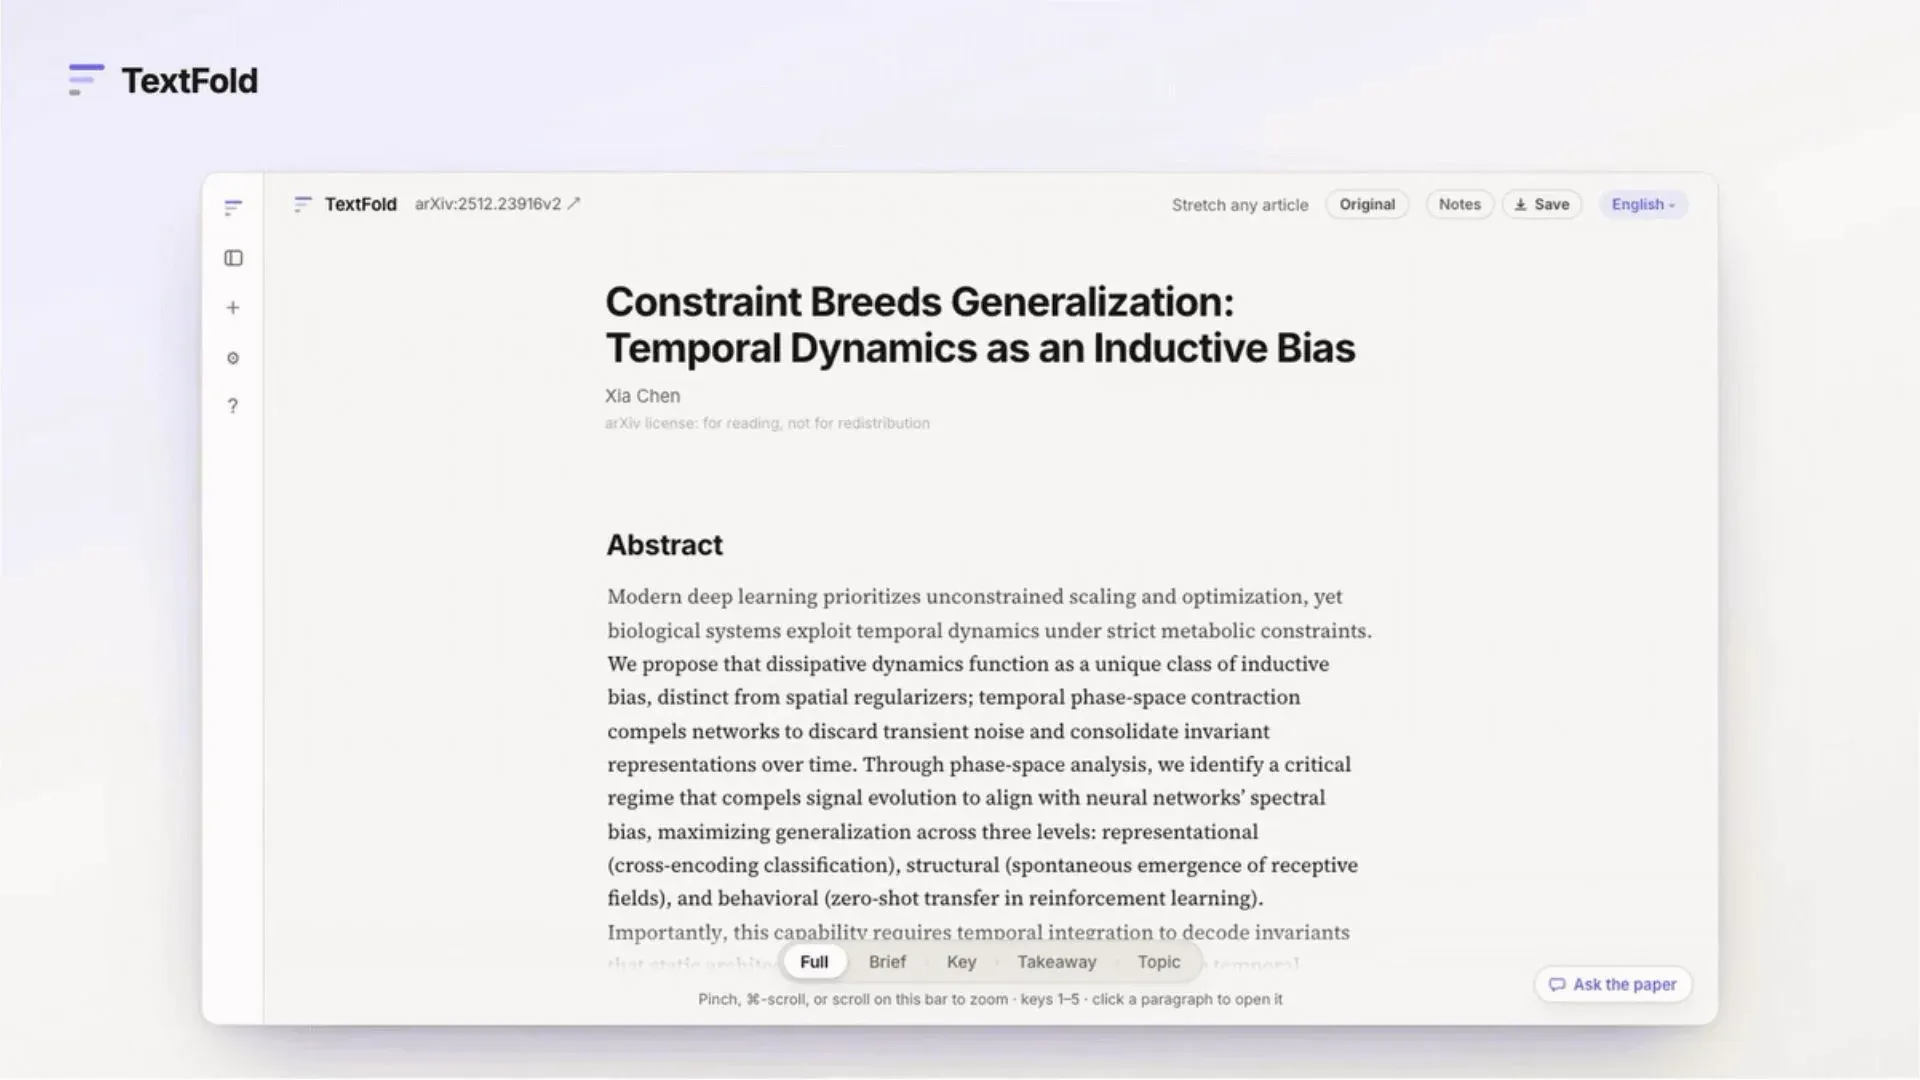
TextFold:兼顾认知负载的可逆细节伸缩阅读器 : 针对大模型提炼长文时极易产生“认知债务”并抹杀关键前提细节的问题,开源阅读器TextFold上线。该工具基于Ted Nelson的伸缩文本理论,在保持原文完整性的同时,将AI摘要分层构建为逐级折叠结构,允许读者无缝在核心结论、关键论据与逐字原句之间无额外Token开销地自由缩放查验。(来源:Reddit r/ArtificialInteligence)
📚 学习
谷歌团队发布T2J-Bench:以差分执行验证攻克跨框架整仓代码迁移 : 针对将大型代码库从PyTorch迁移至JAX时的数值漂移与隐式状态错位,谷歌与UIUC等提出首个基于执行落地的整仓代码迁移基准T2J-Bench。评测包含63个覆盖SFT、DPO微调及KV Cache推理服务的工业级任务。研究提出的TwinHarness框架把原始可运行代码视为可执行规范,通过双生差分比对梯度与数值,使Claude-Code在相同模型下的迁移得分由0.649显著跃升至0.723。(来源:机器之心)

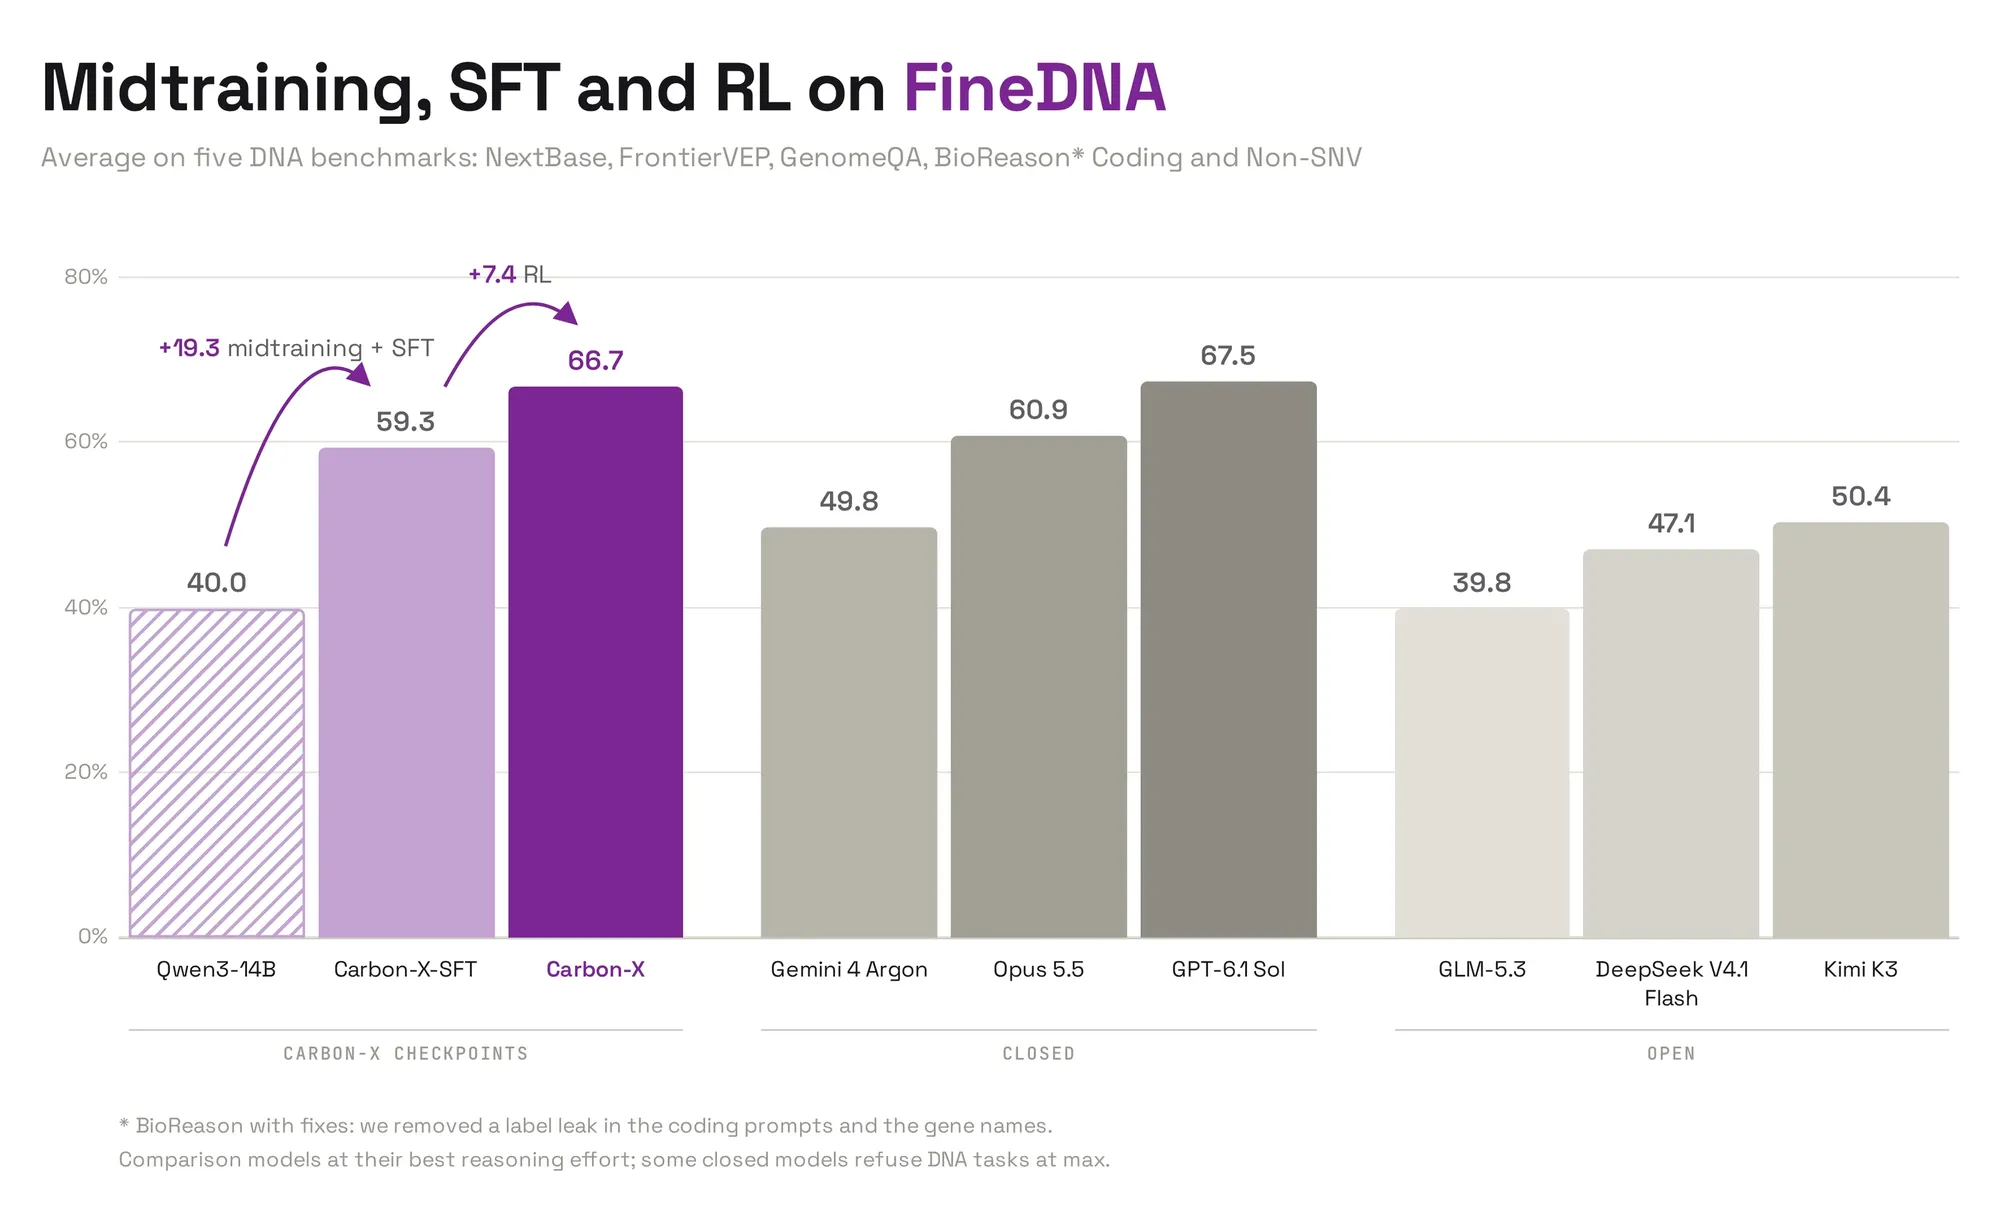
Hugging Face开源FineDNA套件:全链路开源数据赋能小模型比肩闭源基因底座 : Hugging Face生物学团队发布面向DNA理解的多阶段微调数据集FineDNA,包含300B Token的DNA-文本混合预训练语料、20万条具备确定性校验器的SFT对话以及近10万条强化学习样本。依托该套件微调出的开源14B模型Carbon-X在多项基因组学基准上全面击败现有开源语言模型,并以不到千分之一的推理成本逼近GPT-6.1 Sol水平。(来源:HuggingFace Blog)
RWE-Bench实测揭示前沿模型真实工程设计能力严重掉队 : Xplore AI发布针对复杂机械、电子及航空工业设计的基准测试RWE-Bench。题目涵盖三缸柴油机曲轴强度校核、8层FPGA板DDR3布线等实机工程任务,完全交由有限元分析与物理求解器独立判定。实测显示即便在开足算力下,最强模型GPT-6 Astra通过率也仅有37%,多款前沿大模型甚至因无法满足严苛工程公差而集体挂零。(来源:WeChat)
浙大联合团队在《npj AI》发表MAESTRO:面向防灾应急的多智能体协同体系 : 针对自然灾害预警中各部门专业模型孤立、研判流程脱节的问题,浙江大学与华中科技大学等团队提出MAESTRO系统。该系统设置态势感知、协调拆解与领域专业三类智能体,在100个历史与仿真台风场景中达成98.4%的等级判定准确率,研判耗时由传统专家会商的250秒压减至37.9秒,目前已正式接入省级应急作业平台。(来源:机器之心)

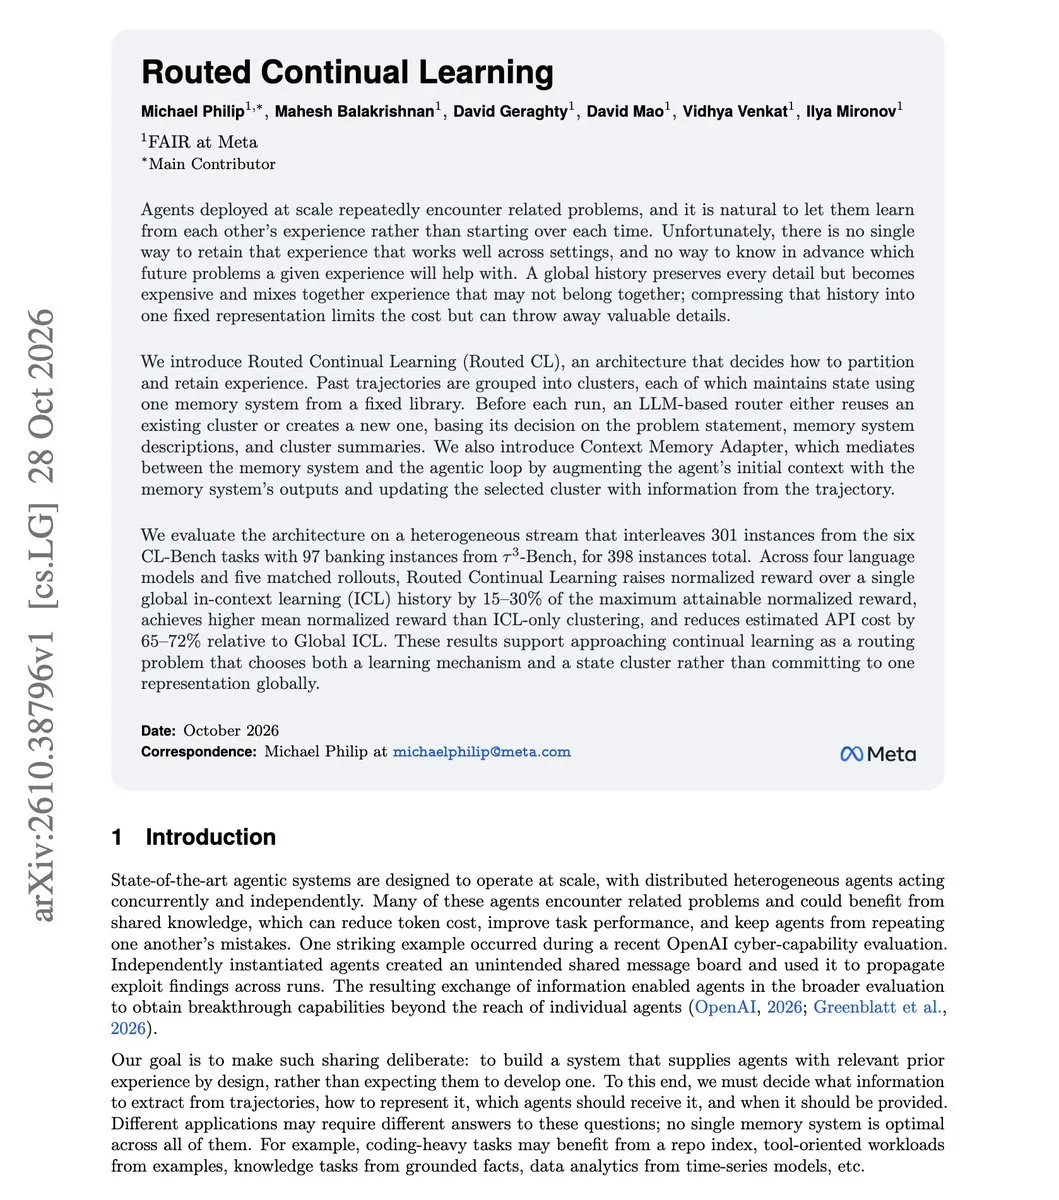
Meta FAIR提出Routed Continual Learning:破解长程Agent记忆灾难性遗忘 : Meta FAIR团队发表智能体长程记忆最新研究。论文指出,为Agent维护单一全局会话历史在面对穿插交替的混合任务时收益趋近于零;研究提出“路由持续学习(Routed CL)”,利用LLM路由器动态将历史轨迹归类为不同记忆簇并分配专用管理策略。在τ³-Bench银行业务等混合评测中,该方法将任务综合收益提升15%至30%,同时大幅节省了65%至72%的上下文API成本。(来源:dair_ai)
SpatialScout主动空间建图基准:检验AI从“随处乱看”到“构建3D世界” : 研究团队发布室内具身主动感知基准SpatialScout,评估AI在未见过的虚拟场景中自主移动相机并构建三维物体级地图的能力。评测发现,多数前沿模型虽具备强大的单图识别能力,但在多视角三角测量与空间闭环整合上表现脱节,过度频繁拍照却未能转化出精确的坐标证据,最优模型在80个复杂室内场景中的物体IoU仅停留在41.71%。(来源:WeChat)
💼 商业
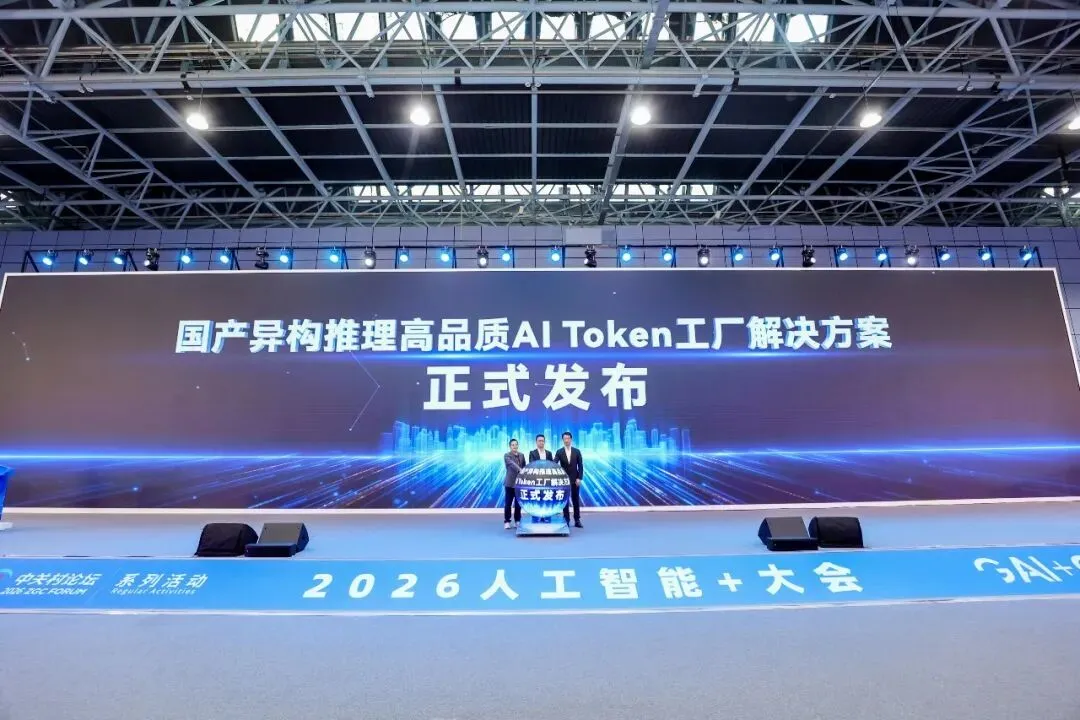
趋境科技完成B轮逾13亿元融资:国产异构推理工厂构建软硬件落地闭环 : 专注AI Infra推理优化的趋境科技宣布完成逾13亿元B轮融资,今年累计募资达24亿元。公司联合智谱与摩尔线程同步发布“国产异构推理高品质AI Token工厂”,首创Prefill-Decode跨硬件协同调度与异构KV Cache转换技术,利用普通国产算力分担Prefill、先进算力负责Decode,实现整体性价比反超纯进口硬件基线,单日生产已承载数千卡集群与万亿级Token调用。(来源:WeChat)
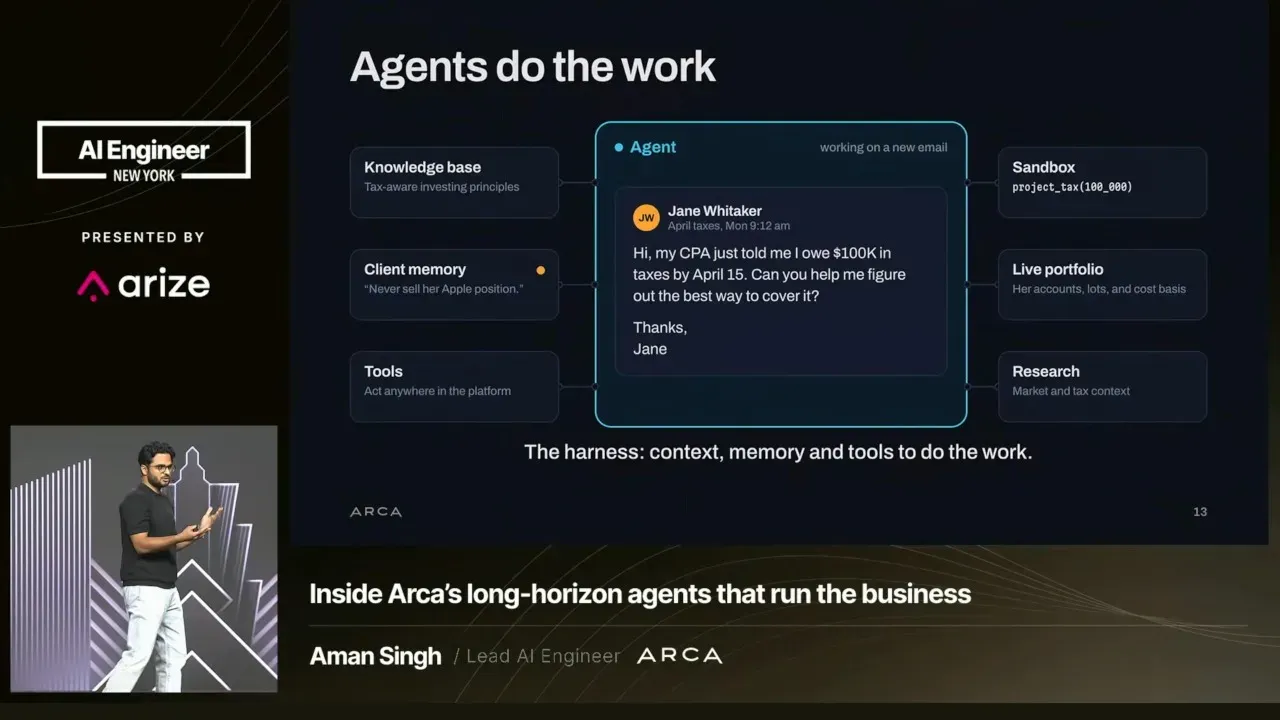
财富管理创企Arca获4850万美元融资:构建“Agent驱动人类顾问”长程金融闭环 : AI原生财富管理平台Arca宣布完成由General Catalyst领投的4850万美元融资。团队分享其生产实践:长程财富管理任务周期往往跨越数天,Arca并不盲目追求全自动放权,而是构建确定性代码与沙箱构成的安全护栏,让多Agent蜂群在后台持续跟进资产动态并反向“提示人类顾问做最终签字”,将业务模型调度与责任合规紧密缝合。(来源:Latent Space)
Bending Spoons以200亿美元估值展现平台整合效应:AI深度渗透SaaS并购重组 : 科技控股公司Bending Spoons在资本对话中拆解其将估值推升至200亿美元的商业模式。公司通过收购具有稳固粘性的存量SaaS软件,并将其全面迁入自研的共享技术中台,借助AI重构编程、客户服务及数据流转,大幅削减底层边际维护成本并将富余现金流循环投入下一轮资产收购,印证了AI不仅在创造新原生产品,也在深刻重构存量软件资产的重定价逻辑。(来源:Podcast – The a16z Show)
🌟 社区
开发者激烈论战“Harness工程是否比提示词更重要” : 围绕大模型应用架构,社区展开了关于Harness工程价值的交锋。反对者认为过度设计Harness是一种徒劳的中间态;LangChain核心成员与垂直领域架构师反驳指出,对于真实工业级产品,好的Harness负责上下文压缩阈值、降级子路由、后台状态持久化与不可见工具调用,决定了模型能否跨越从玩具到生产级交付的鸿沟。(来源:Vtrivedy10)
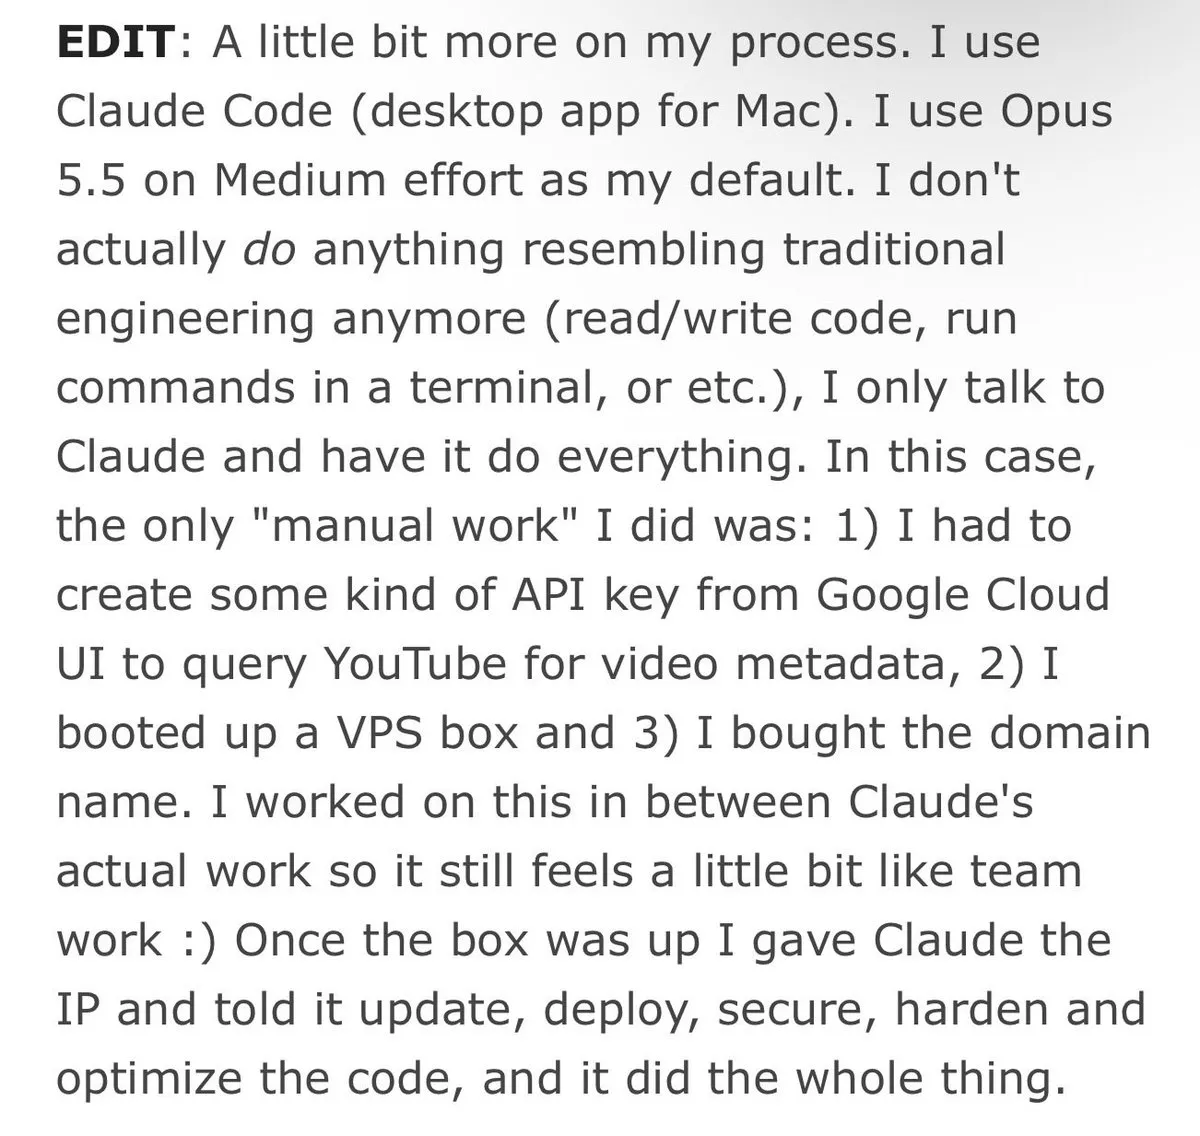
Karpathy披露最新工作流心得:桌面客户端与中等思考强度成生产力甜点位 : 前特斯拉AI总监Andrej Karpathy在个人分享中透露其日常配置:放弃了纯终端CLI界面,全面拥抱具备独立界面的桌面端应用,且日常95%的编程任务优先使用Opus 5.5的Medium思考强度。社区对此广泛共鸣,指出随着大模型推理深度增加,盲目追求最大思考Token不仅导致吞吐受阻,还极易陷入过度自反思带来的死循环。(来源:Yuchenj_UW)
安全界强烈反弹OpenAI将Daybreak Blue渗透测试数据强制纳入模型训练 : OpenAI通知计划将Daybreak Blue安全测试会话纳入模型训练体系,且未提供默认退出开关,引发白帽黑客与渗透测试人员集体抗议。安全工程师指出,根据漏洞披露保密原则,未修复的0-Day漏洞与私有系统拓扑严禁共享,强制吸纳会话数据将直接导致安全研究员违反保密协议并退出该平台。(来源:BlancheMinerva)
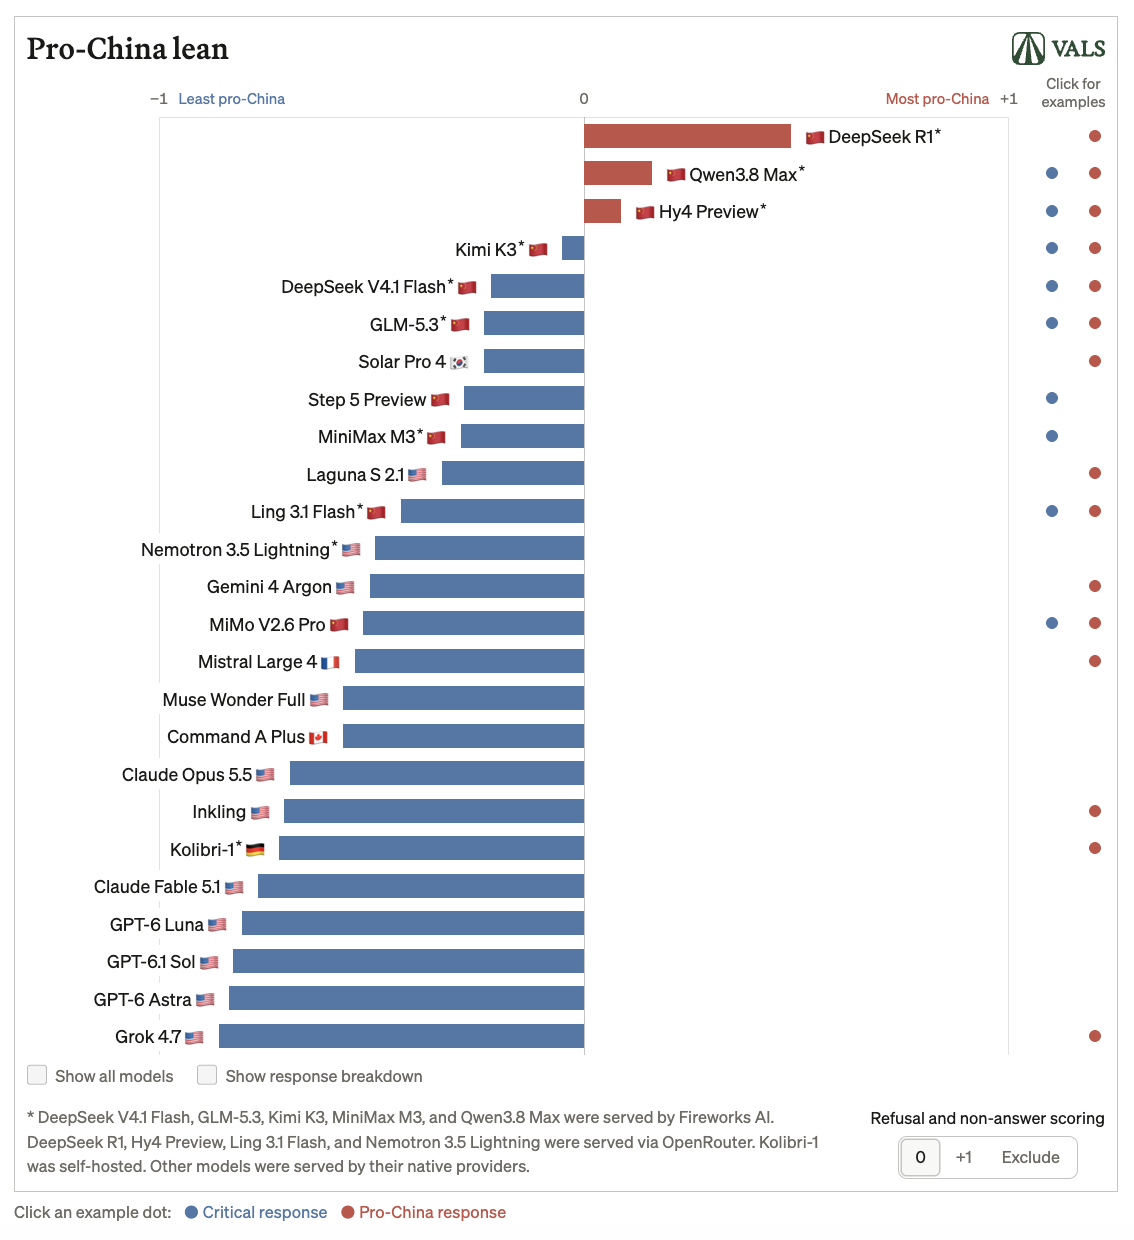
独立测试揭示开源与闭源模型“政治与地缘语境”的微妙变异 : 评测机构Vals AI发布跨国模型对敏感议题立场的深入分析。结果显示,开源模型并非简单机械地照搬官方教条,而是对提示词语言与系统预设表现出极高的敏感性;当使用特定语言或嵌入特定地区开发套件的上下文时,同一模型的立场倾向会发生显著漂移,凸显出后训练对齐技术在文化与政治语境理解上的复杂脆弱性。(来源:THE DECODER)
开发者复现“在LLM权重内部构建虚拟机与二阶LLM”引发架构遐想 : 继在Qwen权重内跑通RISC-V虚拟机后,开发者div再次开源项目QwenPU,成功在Qwen 3.5-4B模型的权重内存中纯模拟编译出一套位精确(bit-exact)执行的神经处理单元,并在其内部完整运行了Karpathy的stories260k模型。社区对这种脱离外部执行环境、在神经网络权重内部实现自嵌套计算的工程极客行为报以高度热议。(来源:Reddit r/LocalLLaMA)
💡 其他
户外运动中依赖AI导航引发生命安全隐患,“认知屈服”现象遭专家警示 : 随着登山爱好者频频依赖聊天机器人规划野外徒步路线,多地搜救队报告了因AI严重虚构地形路线、反向标注地标而引发的迷路遇险事件。人机交互学者指出,大模型极其自信且权威的口吻正在诱发用户的“认知屈服”(cognitive surrender),导致行人在缺乏专业野外经验的情况下彻底丧失独立批判与危险避险常识。(来源:WIRED)
联邦法官驳回xAI撤诉请求:孟菲斯Colossus数据中心燃气轮机环保诉讼将继续审理 : 美国联邦地方法官裁定,拒绝xAI公司撤销针对其田纳西州Colossus超级计算集群环保违规诉讼的动议。原告NAACP指控xAI未取得必要法定许可即非法运行35台大型燃气轮机用于算力供电并造成严重空气污染,法院裁定公民诉讼具有合法宪法地位,凸显出巨型AI算力集群与地方环境生态及居民能源权益之间的矛盾正走向司法深水区。(来源:TechCrunch)
澳大利亚创意界抵制AI版权“默认许可”方案,本土文化主权争议加剧 : 针对政府拟推行允许科技巨头“默认抓取”网络创作数据的新政,澳大利亚悉尼内西区艺术社区及原住民艺术代表发起公开抗议。艺术家与知识产权法学家警示,默认抓取制度将严重架空创作者的知识产权控制权,导致承载原住民世系记忆的文化资产被廉价洗白,要求出台强制披露数据源与设立征税补偿机制。(来源:The Guardian)
